# AnimateDiff를 활용한 텍스트-비디오 생성
## 개요
Yuwei Guo, Ceyuan Yang, Anyi Rao, Yaohui Wang, Yu Qiao, Dahua Lin, Bo Dai의 [AnimateDiff: Animate Your Personalized Text-to-Image Diffusion Models without Specific Tuning](https://huggingface.co/papers/2307.04725)
해당 논문의 초록은 다음과 같습니다:
*텍스트-이미지 모델(예: Stable Diffusion)과 DreamBooth, LoRA와 같은 개인화 기법의 발전으로, 누구나 합리적인 비용으로 상상력을 고품질 이미지로 구현할 수 있게 되었습니다. 이에 따라 생성된 정적 이미지에 움직임 역학을 결합하기 위한 이미지 애니메이션 기법에 대한 수요가 크게 증가하고 있습니다. 본 보고서에서는 모델별 튜닝에 드는 노력을 절감하기 위해, 기존 대부분의 개인화 텍스트-이미지 모델을 한 번에 애니메이션화할 수 있는 실용적인 프레임워크를 제안합니다. 제안된 프레임워크의 핵심은 동결된 텍스트-이미지 모델에 새로 초기화된 움직임 모델링 모듈을 삽입하고, 비디오 클립으로 이를 학습하여 합리적인 움직임 선행 지식을 증류하는 것입니다. 학습이 완료되면, 이 움직임 모델링 모듈을 단순히 주입하기만 하면 동일한 기반 T2I에서 파생된 모든 개인화 버전이 다양한 개인화 애니메이션 이미지를 생성하는 텍스트 기반 모델로 즉시 전환됩니다. 애니메이션 이미지와 실사 사진에 걸쳐 여러 공개 대표 개인화 텍스트-이미지 모델을 대상으로 평가를 수행했으며, 제안된 프레임워크가 이러한 모델이 출력의 도메인과 다양성을 유지하면서 시간적으로 매끄러운 애니메이션 클립을 생성하는 데 도움이 됨을 입증했습니다. 코드와 사전 학습된 가중치는 [이 https URL](https://animatediff.github.io/)에서 공개될 예정입니다.*
## 사용 가능한 파이프라인
| Pipeline | 작업 | 데모
|---|---|:---:|
| [AnimateDiffPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py) | *AnimateDiff를 활용한 텍스트-비디오 생성* |
| [AnimateDiffControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py) | *ControlNet을 사용한 AnimateDiff 기반 제어형 비디오-투-비디오 생성* |
| [AnimateDiffSparseControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py) | *SparseCtrl를 사용한 AnimateDiff 기반 제어형 비디오-투-비디오 생성* |
| [AnimateDiffSDXLPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py) | *AnimateDiff를 활용한 비디오-투-비디오 생성* |
| [AnimateDiffVideoToVideoPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py) | *AnimateDiff를 활용한 비디오-투-비디오 생성* |
| [AnimateDiffVideoToVideoControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py) | *ControlNet을 사용한 AnimateDiff로 비디오-투-비디오 생성* |
## 사용 가능한 체크포인트
Motion Adapter 체크포인트는 [guoyww](https://huggingface.co/guoyww/) 아래에서 찾을 수 있습니다. 이 체크포인트는 Stable Diffusion 1.4/1.5 기반의 모든 모델과 함께 작동하도록 설계되었습니다.
## 사용 예시
### AnimateDiffPipeline
AnimateDiff는 MotionAdapter 체크포인트와 Stable Diffusion 모델 체크포인트와 함께 작동합니다. MotionAdapter는 이미지 프레임 간에 일관된 모션을 추가하는 역할을 하는 Motion Modules의 집합입니다. 이러한 모듈은 Stable Diffusion UNet의 Resnet 및 Attention 블록 이후에 적용됩니다.
다음 예제는 StableDiffusion-1.4/1.5 기반의 Diffusers 추론에 *MotionAdapter* 체크포인트를 사용하는 방법을 보여줍니다.
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
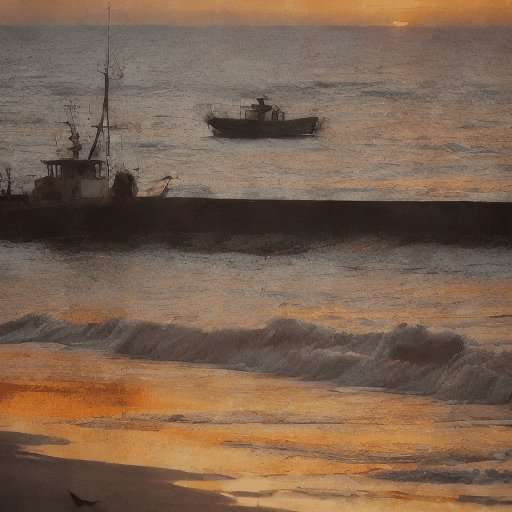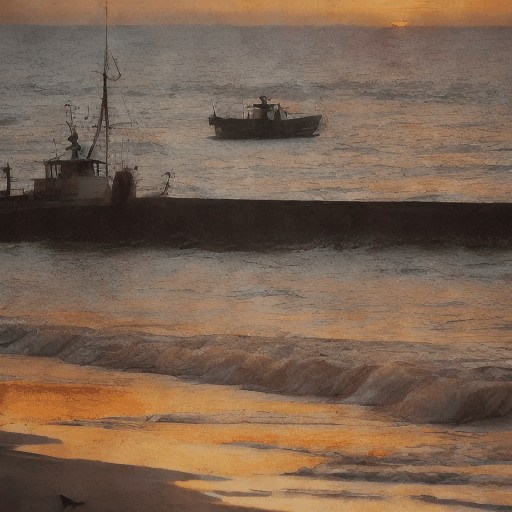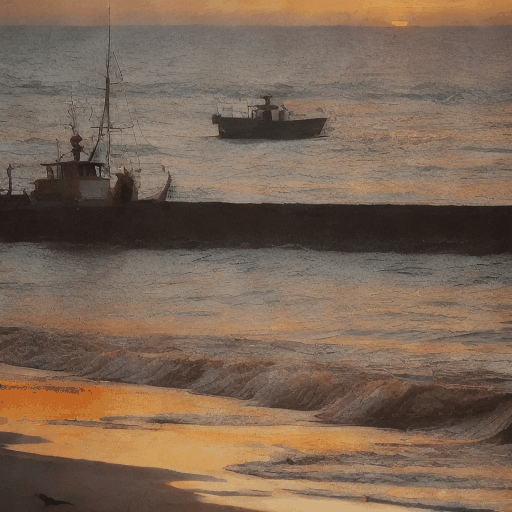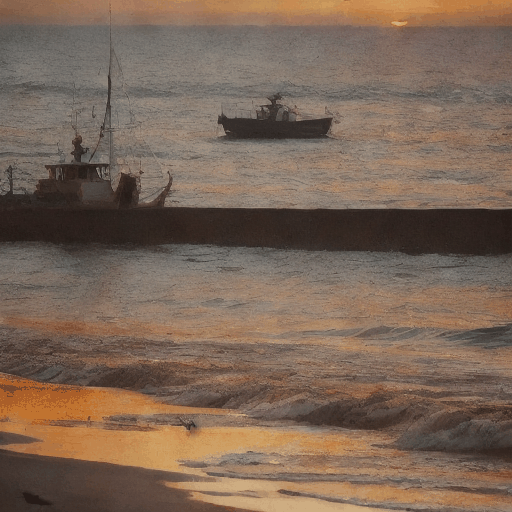
다음은 샘플 출력입니다:
masterpiece, bestquality, sunset.
 > [!TIP]
> AnimateDiff은 미세 조정된 Stable Diffusion 모델과 함께 사용할 때 더 잘 작동하는 경향이 있습니다. 샘플을 클리핑할 수 있는 스케줄러를 사용할 계획이라면, 생성된 샘플에 부정적인 영향을 미칠 수 있으므로 스케줄러에서 `clip_sample=False`를 설정하여 이를 비활성화해야 합니다. 또한, AnimateDiff 체크포인트는 스케줄러의 베타 스케줄에 민감할 수 있습니다. 이를 `linear`로 설정하는 것을 권장합니다.
### AnimateDiffControlNetPipeline
AnimateDiff는 ControlNet과 함께 사용할 수도 있습니다. ControlNet은 Lvmin Zhang, Anyi Rao, Maneesh Agrawala가 [Adding Conditional Control to Text-to-Image Diffusion Models](https://huggingface.co/papers/2302.05543)에서 소개했습니다. ControlNet 모델을 사용하면 추가적인 제어 이미지를 제공하여 Stable Diffusion 생성을 조건화하고 제어할 수 있습니다. 예를 들어, 깊이 맵을 제공하면 ControlNet 모델이 깊이 맵의 공간 정보를 보존하는 비디오를 생성합니다. 이는 비디오 생성 과정을 제어하는 더 유연하고 정확한 방법입니다.
```python
import torch
from diffusers import AnimateDiffControlNetPipeline, AutoencoderKL, ControlNetModel, MotionAdapter, LCMScheduler
from diffusers.utils import export_to_gif, load_video
# Additionally, you will need a preprocess videos before they can be used with the ControlNet
# HF maintains just the right package for it: `pip install controlnet_aux`
from controlnet_aux.processor import ZoeDetector
# Download controlnets from https://huggingface.co/lllyasviel/ControlNet-v1-1 to use .from_single_file
# Download Diffusers-format controlnets, such as https://huggingface.co/lllyasviel/sd-controlnet-depth, to use .from_pretrained()
controlnet = ControlNetModel.from_single_file("control_v11f1p_sd15_depth.pth", dtype=torch.float16)
# We use AnimateLCM for this example but one can use the original motion adapters as well (for example, https://huggingface.co/guoyww/animatediff-motion-adapter-v1-5-3)
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=torch.float16)
pipe: AnimateDiffControlNetPipeline = AnimateDiffControlNetPipeline.from_pretrained(
"SG161222/Realistic_Vision_V5.1_noVAE",
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
).to(device="cuda", dtype=torch.float16) # or "mps", "xpu", "cpu"
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm-lora")
pipe.set_adapters(["lcm-lora"], [0.8])
depth_detector = ZoeDetector.from_pretrained("lllyasviel/Annotators").to("cuda")
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-vid2vid-input-1.gif")
conditioning_frames = []
with pipe.progress_bar(total=len(video)) as progress_bar:
for frame in video:
conditioning_frames.append(depth_detector(frame))
progress_bar.update()
prompt = "a panda, playing a guitar, sitting in a pink boat, in the ocean, mountains in background, realistic, high quality"
negative_prompt = "bad quality, worst quality"
video = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_frames=len(video),
num_inference_steps=10,
guidance_scale=2.0,
conditioning_frames=conditioning_frames,
generator=torch.Generator().manual_seed(42),
).frames[0]
export_to_gif(video, "animatediff_controlnet.gif", fps=8)
```
다음은 샘플 출력입니다:
Source Video Output Video
기타를 치는 라쿤
판다, 기타 연주, 분홍색 보트 위에 앉아 있음, 바다, 배경에 산, 사실적, 고품질
### AnimateDiffSparseControlNetPipeline
Yuwei Guo, Ceyuan Yang, Anyi Rao, Maneesh Agrawala, Dahua Lin, Bo Dai의 [SparseCtrl: Adding Sparse Controls to Text-to-Video Diffusion Models](https://huggingface.co/papers/2311.16933)은 텍스트-비디오 확산 모델에서 제어 가능한 생성을 달성하기 위한 방법입니다.
해당 논문의 초록은 다음과 같습니다:
*텍스트에서 비디오로 변환(T2V), 즉 주어진 텍스트 프롬프트로 비디오를 생성하는 기술은 최근 몇 년간 크게 발전했습니다. 그러나 텍스트 프롬프트에만 의존하면 공간적 불확실성으로 인해 프레임 구성이 모호해지기 쉽습니다. 이에 연구 커뮤니티는 프레임별 깊이/엣지 시퀀스와 같은 밀집된 구조 신호를 활용하여 제어 가능성을 높이고자 하지만, 이로 인해 추론 시 수집해야 할 부하가 증가합니다. 본 연구에서는 Figure 1에 제시된 바와 같이, 시간적으로 희소(sparse)한 신호를 사용하여 유연한 구조 제어를 가능하게 하는 SparseCtrl을 제안합니다. 이 방법은 입력으로 하나 또는 소수의 신호만 필요로 하며, 사전 학습된 T2V 모델은 그대로 유지하면서 이러한 희소 신호를 처리하기 위한 추가 조건 인코더를 통합합니다. 제안된 접근법은 스케치, 깊이 맵, RGB 이미지 등 다양한 모달리티와 호환되어 비디오 생성에 보다 실용적인 제어를 제공하며, 스토리보딩, 깊이 렌더링, 키프레임 애니메이션, 보간과 같은 응용 분야를 촉진합니다. 광범위한 실험을 통해 SparseCtrl이 원래의 T2V 생성기 및 개인화된 T2V 생성기 모두에서 일반화됨을 입증했습니다. 코드와 모델은 [이 https URL](https://guoyww.github.io/projects/SparseCtrl)에서 공개될 예정입니다.*
SparseCtrl는 제어 가능한 텍스트-비디오 생성을 위해 다음 체크포인트를 소개합니다:
- [SparseCtrl Scribble](https://huggingface.co/guoyww/animatediff-sparsectrl-scribble)
- [SparseCtrl RGB](https://huggingface.co/guoyww/animatediff-sparsectrl-rgb)
#### SparseCtrl Scribble 사용
```python
import torch
from diffusers import AnimateDiffSparseControlNetPipeline
from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
from diffusers.schedulers import DPMSolverMultistepScheduler
from diffusers.utils import export_to_gif, load_image
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
controlnet_id = "guoyww/animatediff-sparsectrl-scribble"
lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
vae_id = "stabilityai/sd-vae-ft-mse"
device = "cuda" # or "mps", "xpu", "cpu"
motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, dtype=torch.float16).to(device)
controlnet = SparseControlNetModel.from_pretrained(controlnet_id, dtype=torch.float16).to(device)
vae = AutoencoderKL.from_pretrained(vae_id, dtype=torch.float16).to(device)
scheduler = DPMSolverMultistepScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
algorithm_type="dpmsolver++",
use_karras_sigmas=True,
)
pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
model_id,
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
scheduler=scheduler,
dtype=torch.float16,
).to(device)
pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
pipe.fuse_lora(lora_scale=1.0)
prompt = "an aerial view of a cyberpunk city, night time, neon lights, masterpiece, high quality"
negative_prompt = "low quality, worst quality, letterboxed"
image_files = [
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-1.png",
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-2.png",
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-3.png"
]
condition_frame_indices = [0, 8, 15]
conditioning_frames = [load_image(img_file) for img_file in image_files]
video = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_inference_steps=25,
conditioning_frames=conditioning_frames,
controlnet_conditioning_scale=1.0,
controlnet_frame_indices=condition_frame_indices,
generator=torch.Generator().manual_seed(1337),
).frames[0]
export_to_gif(video, "output.gif")
```
다음은 샘플 출력입니다:
사이버펑크 도시의 항공 사진, 야경, 네온 라이트, 마스터피스, 고품질
#### SparseCtrl RGB 사용
```python
import torch
from diffusers import AnimateDiffSparseControlNetPipeline
from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
from diffusers.schedulers import DPMSolverMultistepScheduler
from diffusers.utils import export_to_gif, load_image
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
controlnet_id = "guoyww/animatediff-sparsectrl-rgb"
lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
vae_id = "stabilityai/sd-vae-ft-mse"
device = "cuda" # or "mps", "xpu", "cpu"
motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, dtype=torch.float16).to(device)
controlnet = SparseControlNetModel.from_pretrained(controlnet_id, dtype=torch.float16).to(device)
vae = AutoencoderKL.from_pretrained(vae_id, dtype=torch.float16).to(device)
scheduler = DPMSolverMultistepScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
algorithm_type="dpmsolver++",
use_karras_sigmas=True,
)
pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
model_id,
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
scheduler=scheduler,
dtype=torch.float16,
).to(device)
pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-firework.png")
video = pipe(
prompt="closeup face photo of man in black clothes, night city street, bokeh, fireworks in background",
negative_prompt="low quality, worst quality",
num_inference_steps=25,
conditioning_frames=image,
controlnet_frame_indices=[0],
controlnet_conditioning_scale=1.0,
generator=torch.Generator().manual_seed(42),
).frames[0]
export_to_gif(video, "output.gif")
```
다음은 샘플 출력입니다:
검은 옷을 입은 남성의 클로즈업 얼굴 사진, 밤거리, 보케, 배경의 불꽃놀이
### AnimateDiffSDXLPipeline
AnimateDiff는 SDXL 모델과 함께 사용할 수도 있습니다. 현재 이는 실험적 기능이며, motion adapter checkpoint의 베타 버전만 사용 가능합니다.
```python
import torch
from diffusers.models import MotionAdapter
from diffusers import AnimateDiffSDXLPipeline, DDIMScheduler
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-sdxl-beta", dtype=torch.float16)
model_id = "stabilityai/stable-diffusion-xl-base-1.0"
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe = AnimateDiffSDXLPipeline.from_pretrained(
model_id,
motion_adapter=adapter,
scheduler=scheduler,
dtype=torch.float16,
variant="fp16",
).to("cuda") # or "mps", "xpu", "cpu"
# enable memory savings
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()
output = pipe(
prompt="a panda surfing in the ocean, realistic, high quality",
negative_prompt="low quality, worst quality",
num_inference_steps=20,
guidance_scale=8,
width=1024,
height=1024,
num_frames=16,
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
### AnimateDiffVideoToVideoPipeline
AnimateDiff는 초기 비디오를 기반으로 시각적으로 유사한 비디오를 생성하거나 스타일/캐릭터/배경 등 다른 편집을 수행할 수 있어, 창의적 가능성을 매끄럽게 탐색할 수 있습니다.
```python
import imageio
import requests
import torch
from diffusers import AnimateDiffVideoToVideoPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
from io import BytesIO
from PIL import Image
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffVideoToVideoPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
# helper function to load videos
def load_video(file_path: str):
images = []
if file_path.startswith(('http://', 'https://')):
# If the file_path is a URL
response = requests.get(file_path)
response.raise_for_status()
content = BytesIO(response.content)
vid = imageio.get_reader(content)
else:
# Assuming it's a local file path
vid = imageio.get_reader(file_path)
for frame in vid:
pil_image = Image.fromarray(frame)
images.append(pil_image)
return images
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-vid2vid-input-1.gif")
output = pipe(
video = video,
prompt="panda playing a guitar, on a boat, in the ocean, high quality",
negative_prompt="bad quality, worse quality",
guidance_scale=7.5,
num_inference_steps=25,
strength=0.5,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
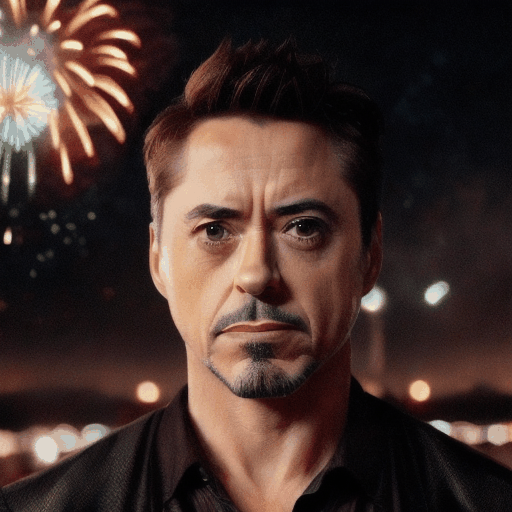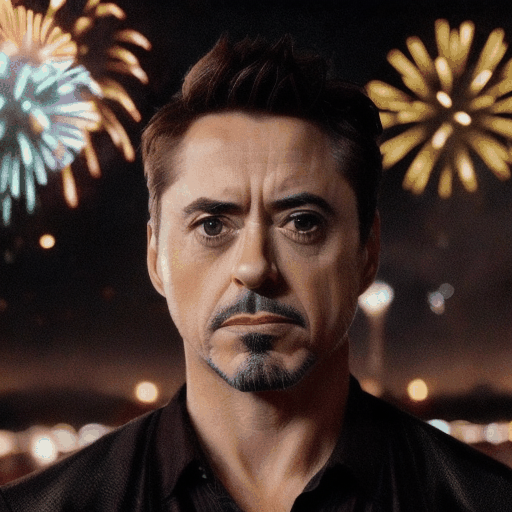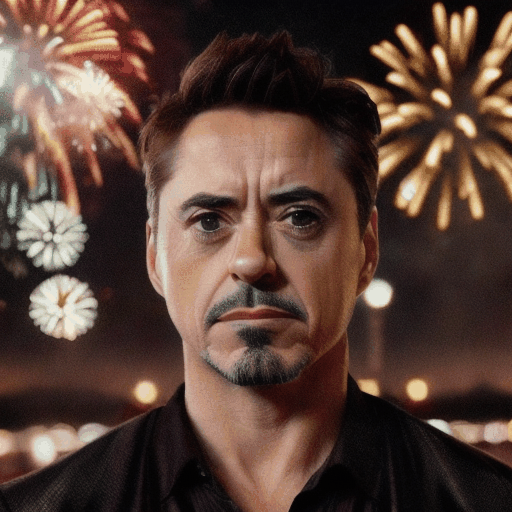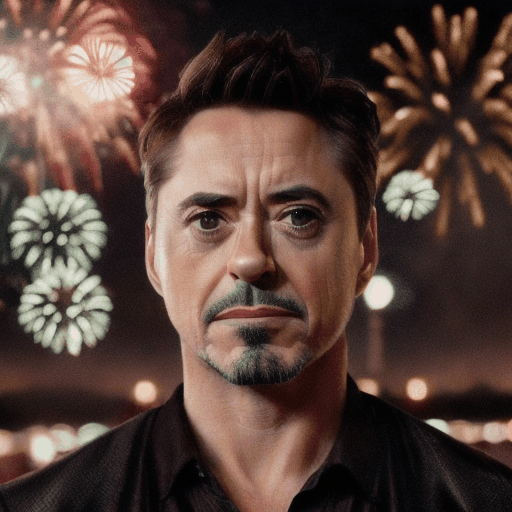
다음은 샘플 출력입니다:
Source Video Output Video
기타를 치는 라쿤
 기타를 치는 판다
 마고 로비의 클로즈업, 배경에 불꽃놀이, 고품질
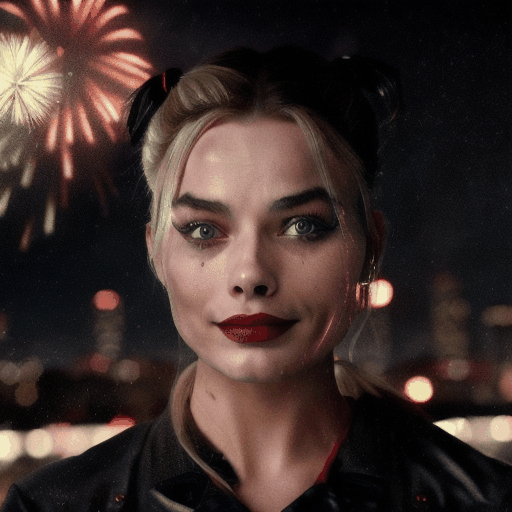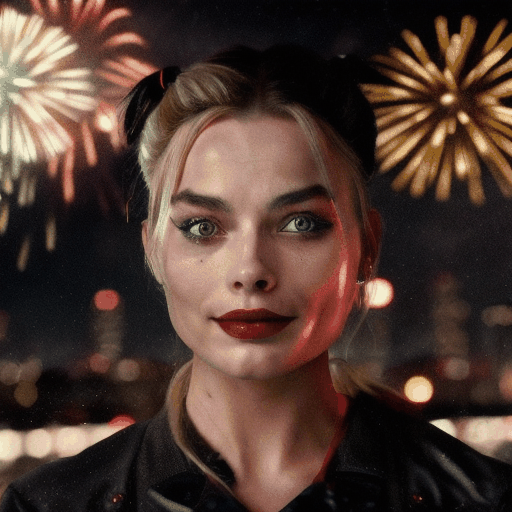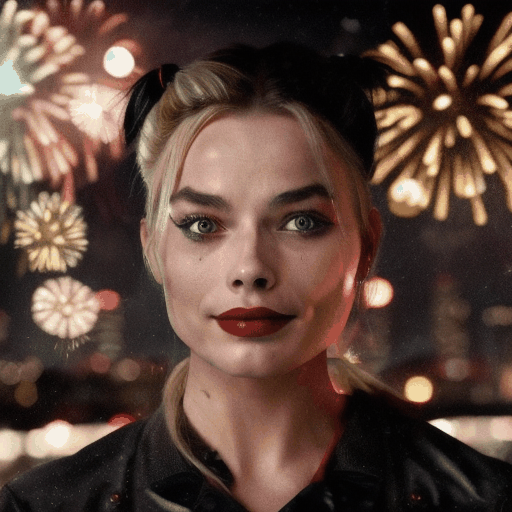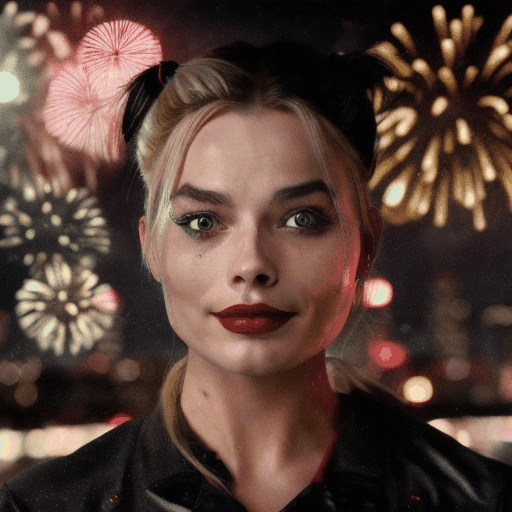 토니 스타크, 로버트 다우니 주니어, 불꽃놀이 클로즈업
 ### AnimateDiffVideoToVideoControlNetPipeline
AnimateDiff는 ControlNet과 함께 사용하여 출력에 대한 정밀한 제어를 가능하게 함으로써 video-to-video 생성을 향상시킬 수 있습니다. ControlNet은 Lvmin Zhang, Anyi Rao, Maneesh Agrawala가 [Adding Conditional Control to Text-to-Image Diffusion Models](https://huggingface.co/papers/2302.05543)에서 소개했으며, 추가적인 제어 이미지를 통해 Stable Diffusion을 조건화하여 비디오 전체에 걸쳐 공간 정보가 보존되도록 합니다.
이 파이프라인을 사용하면 원본 비디오와 제어 이미지 시퀀스 모두를 기반으로 생성을 조건화할 수 있습니다.
```python
import torch
from PIL import Image
from tqdm.auto import tqdm
from controlnet_aux.processor import OpenposeDetector
from diffusers import AnimateDiffVideoToVideoControlNetPipeline
from diffusers.utils import export_to_gif, load_video
from diffusers import AutoencoderKL, ControlNetModel, MotionAdapter, LCMScheduler
# Load the ControlNet
controlnet = ControlNetModel.from_pretrained("lllyasviel/sd-controlnet-openpose", dtype=torch.float16)
# Load the motion adapter
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
# Load SD 1.5 based finetuned model
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=torch.float16)
pipe = AnimateDiffVideoToVideoControlNetPipeline.from_pretrained(
"SG161222/Realistic_Vision_V5.1_noVAE",
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
).to(device="cuda", dtype=torch.float16) # or "mps", "xpu", "cpu"
# Enable LCM to speed up inference
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm-lora")
pipe.set_adapters(["lcm-lora"], [0.8])
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/dance.gif")
video = [frame.convert("RGB") for frame in video]
prompt = "astronaut in space, dancing"
negative_prompt = "bad quality, worst quality, jpeg artifacts, ugly"
# Create controlnet preprocessor
open_pose = OpenposeDetector.from_pretrained("lllyasviel/Annotators").to("cuda")
# Preprocess controlnet images
conditioning_frames = []
for frame in tqdm(video):
conditioning_frames.append(open_pose(frame))
strength = 0.8
with torch.inference_mode():
video = pipe(
video=video,
prompt=prompt,
negative_prompt=negative_prompt,
num_inference_steps=10,
guidance_scale=2.0,
controlnet_conditioning_scale=0.75,
conditioning_frames=conditioning_frames,
strength=strength,
generator=torch.Generator().manual_seed(42),
).frames[0]
video = [frame.resize(conditioning_frames[0].size) for frame in video]
export_to_gif(video, f"animatediff_vid2vid_controlnet.gif", fps=8)
```
다음은 샘플 출력입니다:
Source Video Output Video
애니메이션 소녀, 춤
우주에서 춤추는 우주비행사
**조명과 구도는 소스 비디오에서 가져왔습니다.**
## Motion LoRA 사용
Motion LoRA는 `guoyww/animatediff-motion-adapter-v1-5-2` 체크포인트와 함께 작동하는 LoRA 모음입니다. 이러한 LoRA는 애니메이션에 특정 유형의 모션을 추가하는 역할을 합니다.
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
pipe.load_lora_weights(
"guoyww/animatediff-motion-lora-zoom-out", adapter_name="zoom-out"
)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
beta_schedule="linear",
timestep_spacing="linspace",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
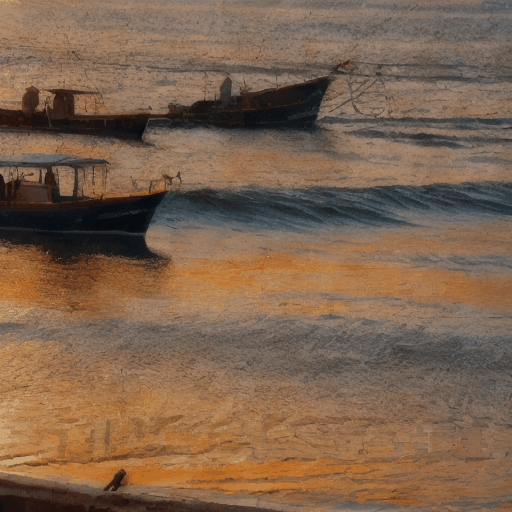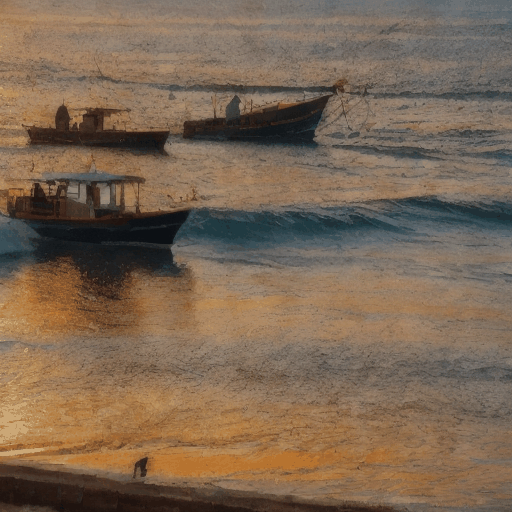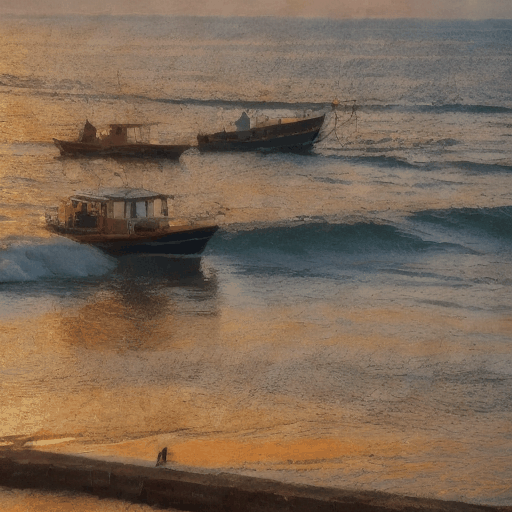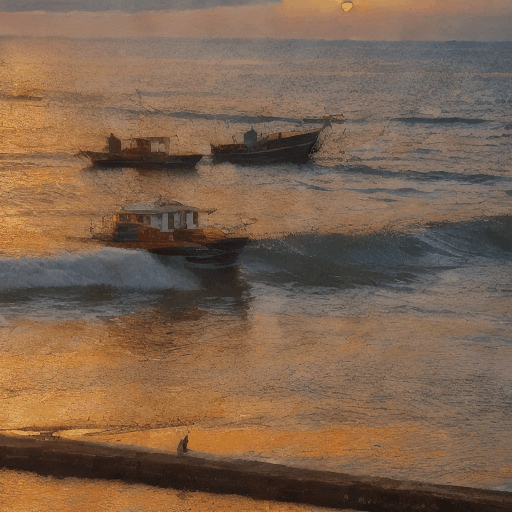
masterpiece, bestquality, sunset.
 ## PEFT와 함께 Motion LoRA 사용
[PEFT](https://github.com/huggingface/peft) 백엔드를 활용하여 Motion LoRA를 결합하고 더 복잡한 애니메이션을 만들 수도 있습니다.
먼저 PEFT를 설치합니다
```shell
pip install peft
```
이후 다음 코드를 사용하여 Motion LoRA를 결합할 수 있습니다.
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
pipe.load_lora_weights(
"diffusers/animatediff-motion-lora-zoom-out", adapter_name="zoom-out",
)
pipe.load_lora_weights(
"diffusers/animatediff-motion-lora-pan-left", adapter_name="pan-left",
)
pipe.set_adapters(["zoom-out", "pan-left"], adapter_weights=[1.0, 1.0])
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
masterpiece, bestquality, sunset.
 ## FreeInit 사용
Tianxing Wu, Chenyang Si, Yuming Jiang, Ziqi Huang, Ziwei Liu의 [FreeInit: Bridging Initialization Gap in Video Diffusion Models](https://huggingface.co/papers/2312.07537)
FreeInit은 추가 학습 없이 video-diffusion-models를 사용하여 생성된 비디오의 시간적 일관성과 전반적인 품질을 향상시키는 효과적인 방법입니다. 추론 시점에 AnimateDiff, ModelScope, VideoCrafter 및 기타 다양한 비디오 생성 모델에 원활하게 적용할 수 있으며, 잠재 초기화 노이즈를 반복적으로 정제하는 방식으로 작동합니다. 자세한 내용은 해당 논문에서 확인할 수 있습니다.
다음 예제는 FreeInit의 사용법을 보여줍니다.
```python
import torch
from diffusers import MotionAdapter, AnimateDiffPipeline, DDIMScheduler
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2")
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16).to("cuda") # or "mps", "xpu", "cpu"
pipe.scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
clip_sample=False,
timestep_spacing="linspace",
steps_offset=1
)
# enable memory savings
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()
# enable FreeInit
# Refer to the enable_free_init documentation for a full list of configurable parameters
pipe.enable_free_init(method="butterworth", use_fast_sampling=True)
# run inference
output = pipe(
prompt="a panda playing a guitar, on a boat, in the ocean, high quality",
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=20,
generator=torch.Generator("cpu").manual_seed(666),
)
# disable FreeInit
pipe.disable_free_init()
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
> [!WARNING]
> FreeInit은 실제로 무료가 아닙니다 - 향상된 품질은 추가 계산 비용으로 얻어집니다. 활성화 시 설정하는 `num_iters` 파라미터에 따라 몇 번의 추가 샘플링이 필요합니다. `use_fast_sampling` 파라미터를 `True`로 설정하면 전반적인 성능을 향상시킬 수 있습니다(`use_fast_sampling=False`인 경우보다 품질은 낮지만, 여전히 일반 비디오 생성 모델보다 나은 결과를 제공합니다).
> [!TIP]
> Scheduler의 [가이드](../../using-diffusers/schedulers)를 확인하여 스케줄러의 속도와 품질 사이의 트레이드오프를 탐색하는 방법을 배우고, [파이프라인 간 구성 요소 재사용](../../using-diffusers/loading#reusing-models-in-multiple-pipelines) 섹션을 확인하여 동일한 구성 요소를 여러 파이프라인에 효율적으로 로드하는 방법을 배워보세요.
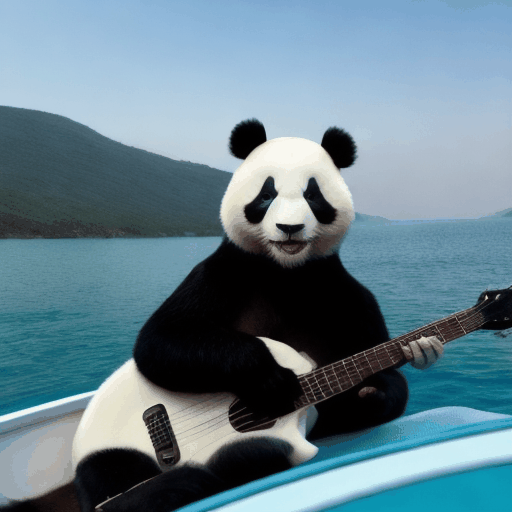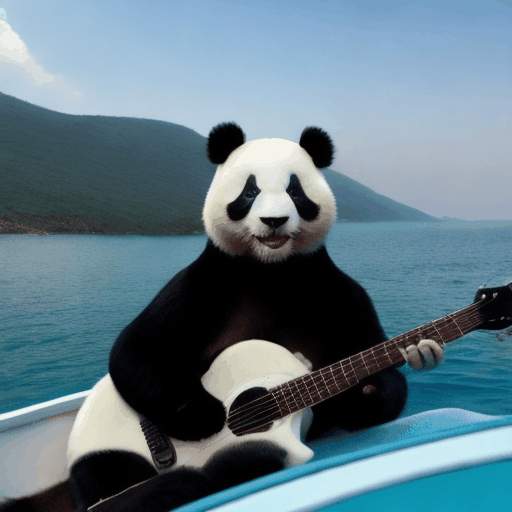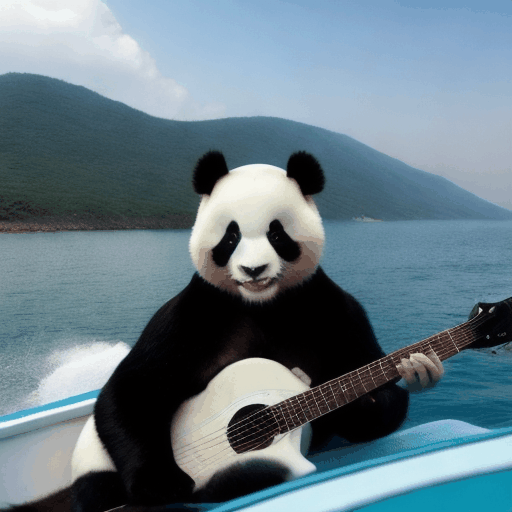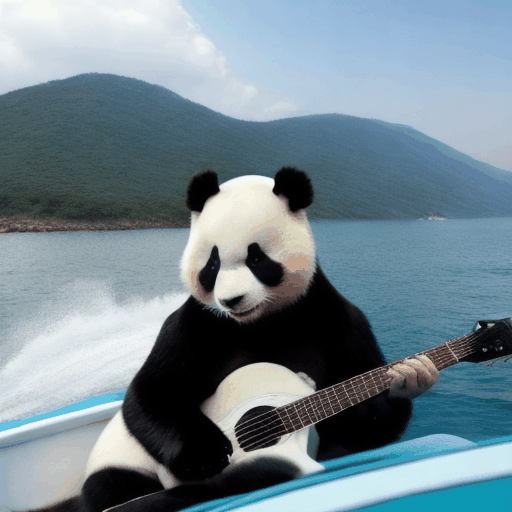
FreeInit 비활성화 FreeInit 활성화
기타를 치는 판다
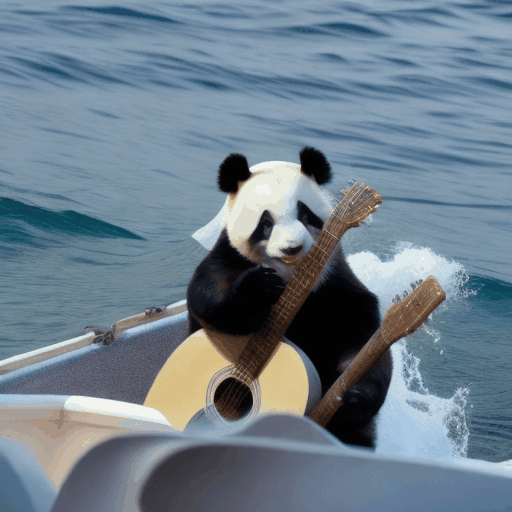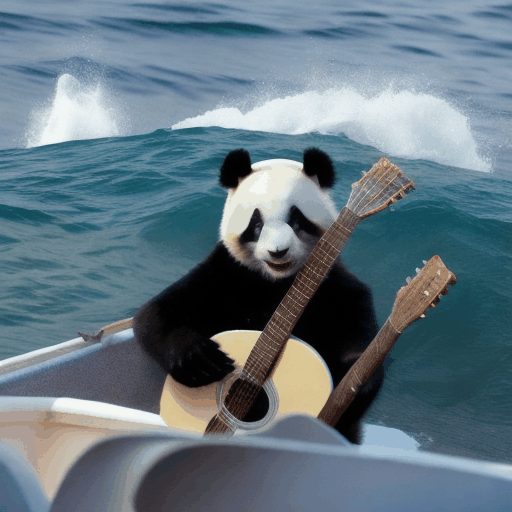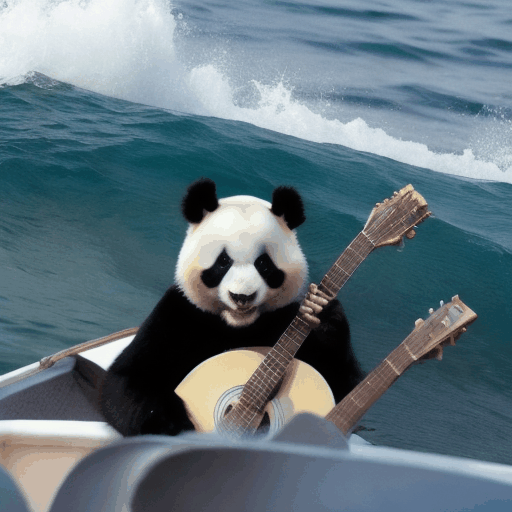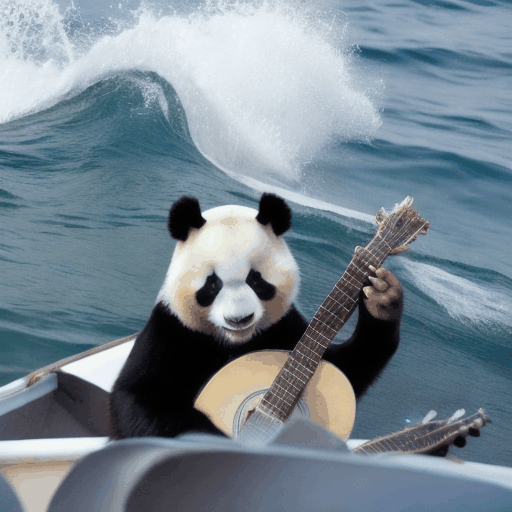 기타를 치는 판다
 ## AnimateLCM 사용
[AnimateLCM](https://animatelcm.github.io/)는 이미지 생성 사전 지식과 모션 생성 사전 지식의 증류를 분리하는 일관성 학습 전략을 사용하여 생성된 모션 모듈 체크포인트와 [LCM LoRA](https://huggingface.co/docs/diffusers/using-diffusers/inference_with_lcm_lora)입니다.
```python
import torch
from diffusers import AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="sd15_lora_beta.safetensors", adapter_name="lcm-lora")
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt="A space rocket with trails of smoke behind it launching into space from the desert, 4k, high resolution",
negative_prompt="bad quality, worse quality, low resolution",
num_frames=16,
guidance_scale=1.5,
num_inference_steps=6,
generator=torch.Generator("cpu").manual_seed(0),
)
frames = output.frames[0]
export_to_gif(frames, "animatelcm.gif")
```
우주 로켓, 4K.
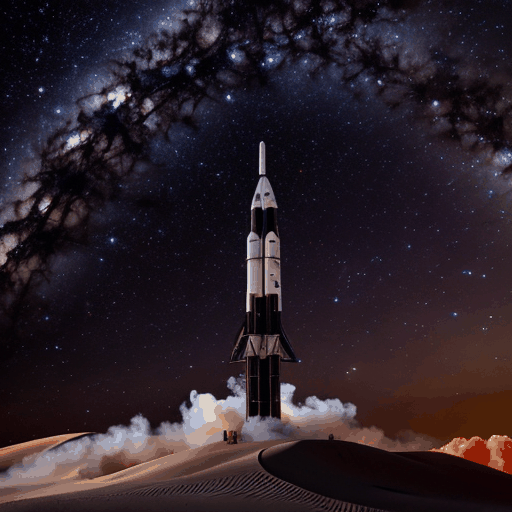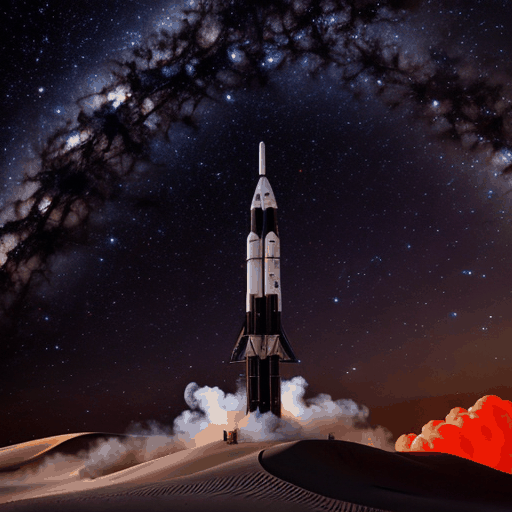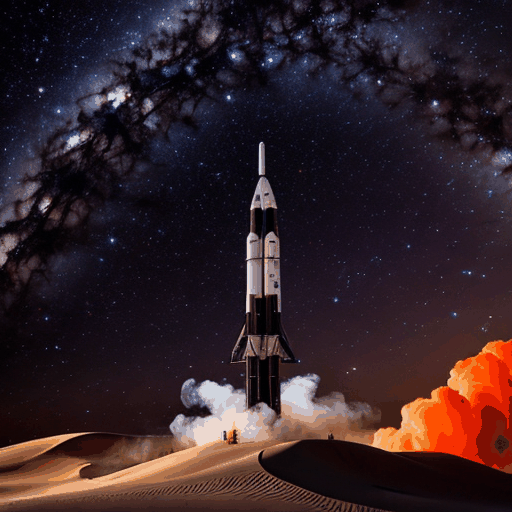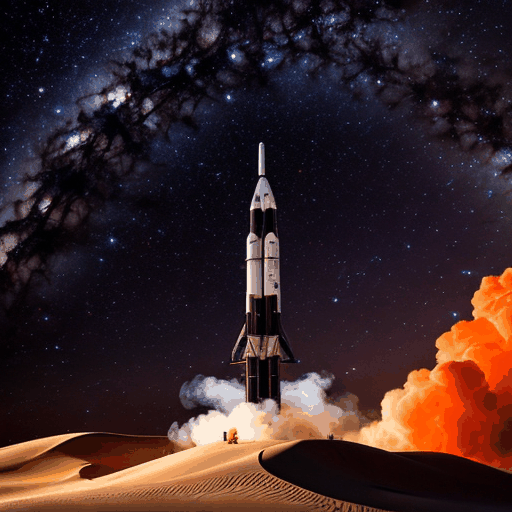 AnimateLCM은 기존 [Motion LoRA](https://huggingface.co/collections/dn6/animatediff-motion-loras-654cb8ad732b9e3cf4d3c17e)와도 호환됩니다.
```python
import torch
from diffusers import AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="sd15_lora_beta.safetensors", adapter_name="lcm-lora")
pipe.load_lora_weights("guoyww/animatediff-motion-lora-tilt-up", adapter_name="tilt-up")
pipe.set_adapters(["lcm-lora", "tilt-up"], [1.0, 0.8])
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt="A space rocket with trails of smoke behind it launching into space from the desert, 4k, high resolution",
negative_prompt="bad quality, worse quality, low resolution",
num_frames=16,
guidance_scale=1.5,
num_inference_steps=6,
generator=torch.Generator("cpu").manual_seed(0),
)
frames = output.frames[0]
export_to_gif(frames, "animatelcm-motion-lora.gif")
```
우주 로켓, 4K.
 ## FreeNoise 사용
Haonan Qiu, Menghan Xia, Yong Zhang, Yingqing He, Xintao Wang, Ying Shan, Ziwei Liu의 [FreeNoise: Tuning-Free Longer Video Diffusion via Noise Rescheduling](https://huggingface.co/papers/2310.15169)
FreeNoise는 노이즈 재스케줄링, 슬라이딩 윈도우에 대한 시간적 어텐션, 잠재 프레임의 가중 평균을 활용하여 짧은 영상 생성 모델로 더 긴 영상을 생성할 수 있는 샘플링 메커니즘입니다. 또한 여러 프롬프트와 함께 사용하여 보간된 영상 생성을 허용합니다. 자세한 내용은 논문에서 확인할 수 있습니다.
FreeNoise와 함께 사용할 수 있는 현재 지원되는 AnimateDiff 파이프라인은 다음과 같습니다:
- [AnimateDiffPipeline](/docs/diffusers/main/ko/api/pipelines/animatediff#diffusers.AnimateDiffPipeline)
- [AnimateDiffControlNetPipeline](/docs/diffusers/main/ko/api/pipelines/animatediff#diffusers.AnimateDiffControlNetPipeline)
- [AnimateDiffVideoToVideoPipeline](/docs/diffusers/main/ko/api/pipelines/animatediff#diffusers.AnimateDiffVideoToVideoPipeline)
- [AnimateDiffVideoToVideoControlNetPipeline](/docs/diffusers/main/ko/api/pipelines/animatediff#diffusers.AnimateDiffVideoToVideoControlNetPipeline)
FreeNoise를 사용하려면 파이프라인을 로드한 후 추론 코드에 한 줄을 추가해야 합니다.
```diff
+ pipe.enable_free_noise()
```
이후 단일 프롬프트를 사용하거나, 정수-문자열 쌍의 딕셔너리로 여러 프롬프트를 전달할 수 있습니다. 딕셔너리의 정수 키는 해당 프롬프트의 영향이 최대가 되는 프레임 인덱스에 대응합니다. 각 프레임 인덱스는 단일 문자열 프롬프트에 매핑되어야 합니다. 딕셔너리에 전달되지 않은 중간 프레임 인덱스의 프롬프트는 전달된 프레임 프롬프트 사이를 보간하여 생성됩니다. 기본적으로 단순 선형 보간이 사용됩니다. 그러나 FreeNoise를 활성화할 때 `prompt_interpolation_callback` 매개변수에 콜백을 전달하여 이 동작을 사용자 정의할 수 있습니다.
전체 예시:
```python
import torch
from diffusers import AutoencoderKL, AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_video, load_image
# Load pipeline
dtype = torch.float16
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM", dtype=dtype)
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=dtype)
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=motion_adapter, vae=vae, dtype=dtype)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights(
"wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm_lora"
)
pipe.set_adapters(["lcm_lora"], [0.8])
# Enable FreeNoise for long prompt generation
pipe.enable_free_noise(context_length=16, context_stride=4)
pipe.to("cuda") # or "mps", "xpu", "cpu"
# Can be a single prompt, or a dictionary with frame timesteps
prompt = {
0: "A caterpillar on a leaf, high quality, photorealistic",
40: "A caterpillar transforming into a cocoon, on a leaf, near flowers, photorealistic",
80: "A cocoon on a leaf, flowers in the background, photorealistic",
120: "A cocoon maturing and a butterfly being born, flowers and leaves visible in the background, photorealistic",
160: "A beautiful butterfly, vibrant colors, sitting on a leaf, flowers in the background, photorealistic",
200: "A beautiful butterfly, flying away in a forest, photorealistic",
240: "A cyberpunk butterfly, neon lights, glowing",
}
negative_prompt = "bad quality, worst quality, jpeg artifacts"
# Run inference
output = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_frames=256,
guidance_scale=2.5,
num_inference_steps=10,
generator=torch.Generator("cpu").manual_seed(0),
)
# Save video
frames = output.frames[0]
export_to_video(frames, "output.mp4", fps=16)
```
### FreeNoise 메모리 절약
FreeNoise는 여러 프레임을 함께 처리하기 때문에, 모델링의 일부에서는 일반 소비자용 GPU에서 사용 가능한 메모리를 초과하는 메모리가 필요합니다. 우리가 식별한 주요 메모리 병목은 공간 및 시간 주의 블록, 업샘플링 및 다운샘플링 블록, resnet 블록, 피드포워드 레이어입니다. 이러한 블록의 대부분은 실제로 채널/임베딩 차원에서만 작동하므로, 배치 차원을 따라 청크 분할 추론을 수행할 수 있습니다. AnimateDiff의 배치 차원은 공간적(`[B x F, H x W, C]`)이거나 시간적(`B x H x W, F, C`)인 성격을 가집니다(반직관적으로 보일 수 있지만, 공간 블록은 `B x F` 차원을 따라 처리하고 시간 블록은 `B x H x W` 차원을 따라 처리하기 때문에 여기의 배치 차원은 정확합니다). 우리는 `SplitInferenceModule`을 도입하여 어떤 차원이든 따라 청크를 나누고 추론을 수행하는 것을 더 쉽게 만들었습니다. 이는 많은 양의 메모리를 절약하지만, 추론에 더 많은 시간이 소요되는 비용이 따릅니다.
```diff
# Load pipeline and adapters
# ...
+ pipe.enable_free_noise_split_inference()
+ pipe.unet.enable_forward_chunking(16)
```
`pipe.enable_free_noise_split_inference` 메서드 호출은 두 개의 매개변수를 받습니다: `spatial_split_size`(기본값 `256`)과 `temporal_split_size`(기본값 `16`). 이 값들은 사용 가능한 VRAM 용량에 따라 설정할 수 있습니다. 분할 크기가 작을수록 메모리 사용량은 줄지만 추론 속도는 느려지고, 분할 크기가 클수록 추론 속도는 빨라지지만 더 많은 메모리가 필요합니다.
## MotionAdapter와 함께 `from_single_file` 사용
`diffusers>=0.30.0`은 `from_single_file`를 통해 AnimateDiff 체크포인트를 원래 형식으로 `MotionAdapter`에 로드하는 것을 지원합니다.
```python
from diffusers import MotionAdapter
ckpt_path = "https://huggingface.co/Lightricks/LongAnimateDiff/blob/main/lt_long_mm_32_frames.ckpt"
adapter = MotionAdapter.from_single_file(ckpt_path, dtype=torch.float16)
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
```
## AnimateDiffPipeline[[diffusers.AnimateDiffPipeline]]
#### diffusers.AnimateDiffPipeline[[diffusers.AnimateDiffPipeline]]
```python
diffusers.AnimateDiffPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L78)
**매개변수:**
vae ([AutoencoderKL](/docs/diffusers/main/ko/api/models/autoencoderkl#diffusers.AutoencoderKL)) : 이미지를 잠재 표현으로 인코딩하고 잠재 표현에서 이미지로 디코딩하는 Variational Auto-Encoder (VAE) 모델입니다.
text_encoder (`CLIPTextModel`) : 고정된 텍스트 인코더 ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : 텍스트를 토큰화하기 위한 [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer)입니다.
unet ([UNet2DConditionModel](/docs/diffusers/main/ko/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : 인코딩된 비디오 latents의 노이즈를 제거하기 위해 UNetMotionModel을 생성하는 데 사용되는 [UNet2DConditionModel](/docs/diffusers/main/ko/api/models/unet2d-cond#diffusers.UNet2DConditionModel)입니다.
motion_adapter (`MotionAdapter`) : `unet`와 함께 사용되어 인코딩된 비디오 latents의 노이즈를 제거하는 `MotionAdapter`입니다.
scheduler ([SchedulerMixin](/docs/diffusers/main/ko/api/schedulers/overview#diffusers.SchedulerMixin)) : `unet`와 함께 사용되어 인코딩된 이미지 latents의 노이즈를 제거하는 스케줄러입니다. [DDIMScheduler](/docs/diffusers/main/ko/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/ko/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler), 또는 [PNDMScheduler](/docs/diffusers/main/ko/api/schedulers/pndm#diffusers.PNDMScheduler) 중 하나일 수 있습니다.
텍스트-투-비디오 생성을 위한 Pipeline입니다.
이 모델은 [DiffusionPipeline](/docs/diffusers/main/ko/api/pipelines/overview#diffusers.DiffusionPipeline)에서 상속됩니다. 모든 파이프라인에 대해 구현된 일반적 메서드(다운로드, 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
파이프라인은 다음 로딩 메서드도 상속합니다:
- 텍스트 인버전 임베딩을 로드하는 [load_textual_inversion()](/docs/diffusers/main/ko/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion)
- LoRA 가중치를 로드하는 [load_lora_weights()](/docs/diffusers/main/ko/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights)
- LoRA 가중치를 저장하는 [save_lora_weights()](/docs/diffusers/main/ko/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights)
- IP Adapter를 로드하기 위한 [load_ip_adapter()](/docs/diffusers/main/ko/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter)
#### __호출__[[diffusers.AnimateDiffPipeline.__call__]]
```python
__call__(prompt: str | list[str] | None = None, num_frames: int | None = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'], decode_chunk_size: int = 16, **kwargs)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L571)
**매개변수:**
prompt (`str` 또는 `list[str]`, *선택 사항*) : 이미지 생성을 안내할 프롬프트입니다. 정의되지 않은 경우 `prompt_embeds`를 전달해야 합니다.
height (`int`, *선택 사항*, 기본값은 `self.unet.config.sample_size * self.vae_scale_factor`) : 생성된 비디오의 픽셀 단위 높이.
width (`int`, *선택 사항*, 기본값은 `self.unet.config.sample_size * self.vae_scale_factor`) : 생성된 비디오의 픽셀 단위 너비입니다.
num_frames (`int`, *선택 사항*, 기본값 16) : 생성되는 비디오 프레임의 수입니다. 기본값은 16프레임이며, 초당 8프레임 기준 2초 분량의 비디오에 해당합니다.
num_inference_steps (`int`, *선택 사항*, 기본값 50) : 디노이징 단계의 수입니다. 디노이징 단계를 늘리면 일반적으로 더 높은 품질의 비디오를 얻을 수 있지만, 추론 속도가 느려집니다.
guidance_scale (`float`, *선택 사항*, 기본값 7.5) : guidance scale 값이 높을수록 모델은 이미지 품질이 낮아지는 대신 텍스트 `prompt`와 밀접하게 연결된 이미지를 생성하도록 유도됩니다. `guidance_scale > 1`일 때 guidance scale이 활성화됩니다.
negative_prompt (`str` 또는 `list[str]`, *선택*) : 이미지 생성에서 포함하지 않을 내용을 안내하는 프롬프트입니다. 정의되지 않은 경우 대신 `negative_prompt_embeds`를 전달해야 합니다. 가이던스를 사용하지 않을 때(`guidance_scale < 1`)에는 무시됩니다.
num_videos_per_prompt (`int`, *선택 사항*, 기본값 1) : 프롬프트당 생성할 비디오의 수입니다.
eta (`float`, *선택 사항*, 기본값 0.0) : [DDIM](https://huggingface.co/papers/2010.02502) 논문에서 정의한 파라미터 eta (η)에 해당합니다. [DDIMScheduler](/docs/diffusers/main/ko/api/schedulers/ddim#diffusers.DDIMScheduler)에만 적용되며, 다른 스케줄러에서는 무시됩니다.
generator (`torch.Generator` 또는 `list[torch.Generator]`, *선택 사항*) : 생성을 결정적으로 만들기 위한 [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html)입니다.
latents (`torch.Tensor`, *선택 사항*) : 가우시안 분포에서 샘플링된 사전 생성된 노이즈된 latents로, 비디오 생성의 입력으로 사용됩니다. 동일한 생성을 다른 프롬프트로 조정하는 데 사용할 수 있습니다. 제공되지 않으면, 제공된 랜덤 `generator`를 사용하여 샘플링하여 latents 텐서를 생성합니다. Latents의 shape은 `(batch_size, num_channel, num_frames, height, width)`여야 합니다.
prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 텍스트 임베딩입니다. 텍스트 입력(프롬프트 가중치)을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `prompt` 입력 인자에서 텍스트 임베딩이 생성됩니다.
negative_prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 부정 텍스트 임베딩입니다. 텍스트 입력(프롬프트 가중치)을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `negative_prompt` 입력 인수에서 `negative_prompt_embeds`가 생성됩니다.
ip_adapter_image : (`PipelineImageInput`, *선택 사항*): IP Adapters와 함께 사용할 선택적 이미지 입력입니다.
ip_adapter_image_embeds (`list[torch.Tensor]`, *선택*) : IP-Adapter를 위한 사전 생성된 이미지 임베딩입니다. IP-Adapter의 수와 동일한 길이의 리스트여야 합니다. 각 요소는 `(batch_size, num_images, emb_dim)` 형태의 텐서여야 합니다. `do_classifier_free_guidance`가 `True`로 설정된 경우, 음의 이미지 임베딩을 포함해야 합니다. 제공되지 않으면 `ip_adapter_image` 입력 인자로부터 임베딩이 계산됩니다.
output_type (`str`, *선택 사항*, 기본값 `"pil"`) : 생성된 비디오의 출력 형식입니다. `torch.Tensor`, `PIL.Image` 또는 `np.array` 중 하나를 선택합니다.
return_dict (`bool`, *선택 사항*, 기본값 `True`) : 일반 튜플 대신 `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput`을 반환할지 여부.
cross_attention_kwargs (`dict`, *선택 사항*) : 지정된 경우 [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py)에서 정의된 `AttentionProcessor`로 전달되는 kwargs 사전입니다.
clip_skip (`int`, *선택 사항*) : 프롬프트 임베딩을 계산할 때 CLIP에서 건너뛸 레이어 수. 값이 1이면 최종 레이어 바로 이전 레이어의 출력을 프롬프트 임베딩 계산에 사용합니다.
callback_on_step_end (`Callable`, *선택 사항*) : 추론 중 각 디노이징 단계의 끝에서 호출되는 함수입니다. 이 함수는 다음 인수를 받아 호출됩니다: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs`에는 `callback_on_step_end_tensor_inputs`로 지정된 모든 텐서 목록이 포함됩니다.
callback_on_step_end_tensor_inputs (`list`, *선택 사항*) : `callback_on_step_end` 함수의 텐서 입력 목록입니다. 목록에 지정된 텐서는 `callback_kwargs` 인수로 전달됩니다. 파이프라인 클래스의 `._callback_tensor_inputs` 속성에 나열된 변수만 포함할 수 있습니다.
decode_chunk_size (`int`, 기본값 `16`) : `decode_latents` 메서드를 호출할 때 한 번에 디코딩할 프레임 수입니다.
**반환값:** [AnimateDiffPipelineOutput](/docs/diffusers/main/ko/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) 또는 `tuple`
`return_dict`가 `True`인 경우 [AnimateDiffPipelineOutput](/docs/diffusers/main/ko/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput)가 반환되고, 그렇지 않으면 첫 번째 요소가 생성된 프레임 목록인 `tuple`이 반환됩니다.
생성을 위한 pipeline의 호출 함수.
예:
```py
>>> import torch
>>> from diffusers import MotionAdapter, AnimateDiffPipeline, DDIMScheduler
>>> from diffusers.utils import export_to_gif
>>> adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2")
>>> pipe = AnimateDiffPipeline.from_pretrained("frankjoshua/toonyou_beta6", motion_adapter=adapter)
>>> pipe.scheduler = DDIMScheduler(beta_schedule="linear", steps_offset=1, clip_sample=False)
>>> output = pipe(prompt="A corgi walking in the park")
>>> frames = output.frames[0]
>>> export_to_gif(frames, "animation.gif")
```
#### encode_prompt[[diffusers.AnimateDiffPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L154)
**매개변수:**
prompt (`str` 또는 `list[str]`, *선택 사항*) : 인코딩할 프롬프트
device : (`torch.device`): torch 디바이스
num_images_per_prompt (`int`) : 프롬프트당 생성할 이미지 수
do_classifier_free_guidance (`bool`) : classifier free guidance를 사용할지 여부
negative_prompt (`str` 또는 `list[str]`, *선택 사항*) : 이미지 생성을 안내하지 않을 프롬프트입니다. 정의되지 않은 경우 대신 `negative_prompt_embeds`를 전달해야 합니다. 가이던스를 사용하지 않는 경우 무시됩니다(즉, `guidance_scale`이 `1`보다 작은 경우 무시됩니다).
prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 텍스트 임베딩입니다. *예를 들어* 프롬프트 가중치와 같은 텍스트 입력을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `prompt` 입력 인자에서 텍스트 임베딩이 생성됩니다.
negative_prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 부정 텍스트 임베딩입니다. 텍스트 입력을 쉽게 조정하는 데 사용할 수 있으며, *예를 들어* 프롬프트 가중치 설정에 활용할 수 있습니다. 제공되지 않으면 `negative_prompt` 입력 인수에서 negative_prompt_embeds가 생성됩니다.
lora_scale (`float`, *선택 사항*) : LoRA 레이어가 로드된 경우 텍스트 인코더의 모든 LoRA 레이어에 적용될 LoRA 스케일입니다.
clip_skip (`int`, *선택 사항*) : 프롬프트 임베딩을 계산할 때 CLIP에서 건너뛸 레이어 수. 값이 1이면 최종 레이어 바로 이전 레이어의 출력을 프롬프트 임베딩 계산에 사용합니다.
프롬프트를 텍스트 인코더의 히든 상태로 인코딩합니다.
## AnimateDiffControlNetPipeline[[diffusers.AnimateDiffControlNetPipeline]]
#### diffusers.AnimateDiffControlNetPipeline[[diffusers.AnimateDiffControlNetPipeline]]
```python
diffusers.AnimateDiffControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: diffusers.models.controlnets.controlnet.ControlNetModel | list[diffusers.models.controlnets.controlnet.ControlNetModel] | tuple[diffusers.models.controlnets.controlnet.ControlNetModel] | diffusers.models.controlnets.multicontrolnet.MultiControlNetModel, scheduler: KarrasDiffusionSchedulers, feature_extractor: transformers.models.clip.image_processing_pil_clip.CLIPImageProcessorPil | None = None, image_encoder: transformers.models.clip.modeling_clip.CLIPVisionModelWithProjection | None = None)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L120)
**매개변수:**
vae ([AutoencoderKL](/docs/diffusers/main/ko/api/models/autoencoderkl#diffusers.AutoencoderKL)) : 이미지를 잠재 표현으로 인코딩하고 잠재 표현에서 이미지로 디코딩하는 Variational Auto-Encoder (VAE) 모델입니다.
text_encoder (`CLIPTextModel`) : 고정된 텍스트 인코더 ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : 텍스트를 토큰화하기 위한 [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer)입니다.
unet ([UNet2DConditionModel](/docs/diffusers/main/ko/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : 인코딩된 비디오 latents의 노이즈를 제거하기 위해 UNetMotionModel을 생성하는 데 사용되는 [UNet2DConditionModel](/docs/diffusers/main/ko/api/models/unet2d-cond#diffusers.UNet2DConditionModel)입니다.
motion_adapter (`MotionAdapter`) : `unet`와 함께 사용되어 인코딩된 비디오 latents의 노이즈를 제거하는 `MotionAdapter`입니다.
scheduler ([SchedulerMixin](/docs/diffusers/main/ko/api/schedulers/overview#diffusers.SchedulerMixin)) : `unet`와 함께 사용되어 인코딩된 이미지 latents의 노이즈를 제거하는 스케줄러입니다. [DDIMScheduler](/docs/diffusers/main/ko/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/ko/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler), 또는 [PNDMScheduler](/docs/diffusers/main/ko/api/schedulers/pndm#diffusers.PNDMScheduler) 중 하나일 수 있습니다.
ControlNet 가이던스를 활용한 텍스트-비디오 생성을 위한 Pipeline입니다.
이 모델은 [DiffusionPipeline](/docs/diffusers/main/ko/api/pipelines/overview#diffusers.DiffusionPipeline)에서 상속됩니다. 모든 파이프라인에 대해 구현된 일반적 메서드(다운로드, 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
파이프라인은 다음 로딩 메서드도 상속합니다:
- 텍스트 인버전 임베딩을 로드하는 [load_textual_inversion()](/docs/diffusers/main/ko/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion)
- LoRA 가중치를 로드하는 [load_lora_weights()](/docs/diffusers/main/ko/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights)
- LoRA 가중치를 저장하는 [save_lora_weights()](/docs/diffusers/main/ko/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights)
- IP Adapter를 로드하기 위한 [load_ip_adapter()](/docs/diffusers/main/ko/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter)
#### __호출__[[diffusers.AnimateDiffControlNetPipeline.__call__]]
```python
__call__(prompt: str | list[str] = None, num_frames: int | None = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, guess_mode: bool = False, control_guidance_start: float | list[float] = 0.0, control_guidance_end: float | list[float] = 1.0, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'], decode_chunk_size: int = 16)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L721)
**매개변수:**
prompt (`str` 또는 `list[str]`, *선택 사항*) : 이미지 생성을 안내할 프롬프트입니다. 정의되지 않은 경우 `prompt_embeds`를 전달해야 합니다.
height (`int`, *선택 사항*, 기본값은 `self.unet.config.sample_size * self.vae_scale_factor`) : 생성된 비디오의 픽셀 단위 높이.
width (`int`, *선택 사항*, 기본값은 `self.unet.config.sample_size * self.vae_scale_factor`) : 생성된 비디오의 픽셀 단위 너비입니다.
num_frames (`int`, *선택 사항*, 기본값 16) : 생성되는 비디오 프레임의 수입니다. 기본값은 16프레임이며, 초당 8프레임 기준 2초 분량의 비디오에 해당합니다.
num_inference_steps (`int`, *선택 사항*, 기본값 50) : 디노이징 단계의 수입니다. 디노이징 단계를 늘리면 일반적으로 더 높은 품질의 비디오를 얻을 수 있지만, 추론 속도가 느려집니다.
guidance_scale (`float`, *선택 사항*, 기본값 7.5) : guidance scale 값이 높을수록 모델은 이미지 품질이 낮아지는 대신 텍스트 `prompt`와 밀접하게 연결된 이미지를 생성하도록 유도됩니다. `guidance_scale > 1`일 때 guidance scale이 활성화됩니다.
negative_prompt (`str` 또는 `list[str]`, *선택*) : 이미지 생성에서 포함하지 않을 내용을 안내하는 프롬프트입니다. 정의되지 않은 경우 대신 `negative_prompt_embeds`를 전달해야 합니다. 가이던스를 사용하지 않을 때(`guidance_scale < 1`)에는 무시됩니다.
num_videos_per_prompt (`int`, *선택 사항*, 기본값 1) : 프롬프트당 생성할 비디오의 수입니다.
eta (`float`, *선택 사항*, 기본값 0.0) : [DDIM](https://huggingface.co/papers/2010.02502) 논문에서 정의한 파라미터 eta (η)에 해당합니다. [DDIMScheduler](/docs/diffusers/main/ko/api/schedulers/ddim#diffusers.DDIMScheduler)에만 적용되며, 다른 스케줄러에서는 무시됩니다.
generator (`torch.Generator` 또는 `list[torch.Generator]`, *선택 사항*) : 생성을 결정적으로 만들기 위한 [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html)입니다.
latents (`torch.Tensor`, *선택 사항*) : 가우시안 분포에서 샘플링된 사전 생성된 노이즈된 latents로, 비디오 생성의 입력으로 사용됩니다. 동일한 생성을 다른 프롬프트로 조정하는 데 사용할 수 있습니다. 제공되지 않으면, 제공된 랜덤 `generator`를 사용하여 샘플링하여 latents 텐서를 생성합니다. Latents의 shape은 `(batch_size, num_channel, num_frames, height, width)`여야 합니다.
prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 텍스트 임베딩입니다. 텍스트 입력(프롬프트 가중치)을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `prompt` 입력 인자에서 텍스트 임베딩이 생성됩니다.
negative_prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 부정 텍스트 임베딩입니다. 텍스트 입력(프롬프트 가중치)을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `negative_prompt` 입력 인수에서 `negative_prompt_embeds`가 생성됩니다.
ip_adapter_image (`PipelineImageInput`, *선택 사항*) : IP Adapters와 함께 사용할 선택적 이미지 입력입니다.
ip_adapter_image_embeds (`list[torch.Tensor]`, *선택*) : IP-Adapter를 위한 사전 생성된 이미지 임베딩입니다. IP-Adapter의 수와 동일한 길이의 리스트여야 합니다. 각 요소는 `(batch_size, num_images, emb_dim)` 형태의 텐서여야 합니다. `do_classifier_free_guidance`가 `True`로 설정된 경우, 음의 이미지 임베딩을 포함해야 합니다. 제공되지 않으면 `ip_adapter_image` 입력 인자로부터 임베딩이 계산됩니다.
conditioning_frames (`list[PipelineImageInput]`, *선택*) : 생성을 위해 `unet`에 가이드를 제공하기 위한 ControlNet 입력 조건입니다. 여러 ControlNet이 지정된 경우, 각 ControlNet에 대한 입력이 올바르게 배치되도록 각 요소가 하나의 ControlNet에 전달될 수 있도록 이미지 목록을 전달해야 합니다.
output_type (`str`, *선택 사항*, 기본값 `"pil"`) : 생성된 비디오의 출력 형식입니다. `torch.Tensor`, `PIL.Image` 또는 `np.array` 중 하나를 선택합니다.
return_dict (`bool`, *선택 사항*, 기본값 `True`) : 일반 튜플 대신 `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput`을 반환할지 여부.
cross_attention_kwargs (`dict`, *선택 사항*) : 지정된 경우 [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py)에서 정의된 `AttentionProcessor`로 전달되는 kwargs 사전입니다.
controlnet_conditioning_scale (`float` 또는 `list[float]`, *선택 사항*, 기본값 1.0) : ControlNet의 출력은 원래 `unet`의 잔차에 더해지기 전에 `controlnet_conditioning_scale`과 곱해집니다. `init`에 여러 ControlNet이 지정된 경우, 해당 스케일을 리스트로 설정할 수 있습니다.
guess_mode (`bool`, *선택 사항*, 기본값 `False`) : 프롬프트를 모두 제거하더라도 ControlNet 인코더는 입력 이미지의 내용을 인식하려고 시도합니다. `guidance_scale` 값은 3.0에서 5.0 사이를 권장합니다.
control_guidance_start (`float` 또는 `list[float]`, *선택 사항*, 기본값 0.0) : ControlNet이 적용을 시작하는 전체 스텝의 비율입니다.
control_guidance_end (`float` 또는 `list[float]`, *선택 사항*, 기본값 1.0) : ControlNet이 적용을 중단하는 전체 스텝의 비율입니다.
clip_skip (`int`, *선택 사항*) : 프롬프트 임베딩을 계산할 때 CLIP에서 건너뛸 레이어 수. 값이 1이면 최종 레이어 바로 이전 레이어의 출력을 프롬프트 임베딩 계산에 사용합니다.
callback_on_step_end (`Callable`, *선택 사항*) : 추론 중 각 디노이징 단계의 끝에서 호출되는 함수입니다. 이 함수는 다음 인수를 받아 호출됩니다: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs`에는 `callback_on_step_end_tensor_inputs`로 지정된 모든 텐서 목록이 포함됩니다.
callback_on_step_end_tensor_inputs (`list`, *선택 사항*) : `callback_on_step_end` 함수의 텐서 입력 목록입니다. 목록에 지정된 텐서는 `callback_kwargs` 인수로 전달됩니다. 파이프라인 클래스의 `._callback_tensor_inputs` 속성에 나열된 변수만 포함할 수 있습니다.
decode_chunk_size (`int`, 기본값 `16`) : `decode_latents` 메서드를 호출할 때 한 번에 디코딩할 프레임 수입니다.
**반환값:** [AnimateDiffPipelineOutput](/docs/diffusers/main/ko/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) 또는 `tuple`
`return_dict`가 `True`인 경우 [AnimateDiffPipelineOutput](/docs/diffusers/main/ko/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput)가 반환되고, 그렇지 않으면 첫 번째 요소가 생성된 프레임 목록인 `tuple`이 반환됩니다.
생성을 위한 pipeline의 호출 함수.
예:
#### encode_prompt[[diffusers.AnimateDiffControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L199)
**매개변수:**
prompt (`str` 또는 `list[str]`, *선택 사항*) : 인코딩할 프롬프트
device : (`torch.device`): torch 디바이스
num_images_per_prompt (`int`) : 프롬프트당 생성할 이미지 수
do_classifier_free_guidance (`bool`) : classifier free guidance를 사용할지 여부
negative_prompt (`str` 또는 `list[str]`, *선택 사항*) : 이미지 생성을 안내하지 않을 프롬프트입니다. 정의되지 않은 경우 대신 `negative_prompt_embeds`를 전달해야 합니다. 가이던스를 사용하지 않는 경우 무시됩니다(즉, `guidance_scale`이 `1`보다 작은 경우 무시됩니다).
prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 텍스트 임베딩입니다. *예를 들어* 프롬프트 가중치와 같은 텍스트 입력을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `prompt` 입력 인자에서 텍스트 임베딩이 생성됩니다.
negative_prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 부정 텍스트 임베딩입니다. 텍스트 입력을 쉽게 조정하는 데 사용할 수 있으며, *예를 들어* 프롬프트 가중치 설정에 활용할 수 있습니다. 제공되지 않으면 `negative_prompt` 입력 인수에서 negative_prompt_embeds가 생성됩니다.
lora_scale (`float`, *선택 사항*) : LoRA 레이어가 로드된 경우 텍스트 인코더의 모든 LoRA 레이어에 적용될 LoRA 스케일입니다.
clip_skip (`int`, *선택 사항*) : 프롬프트 임베딩을 계산할 때 CLIP에서 건너뛸 레이어 수. 값이 1이면 최종 레이어 바로 이전 레이어의 출력을 프롬프트 임베딩 계산에 사용합니다.
프롬프트를 텍스트 인코더의 히든 상태로 인코딩합니다.
## AnimateDiffSparseControlNetPipeline[[diffusers.AnimateDiffSparseControlNetPipeline]]
#### diffusers.AnimateDiffSparseControlNetPipeline[[diffusers.AnimateDiffSparseControlNetPipeline]]
```python
diffusers.AnimateDiffSparseControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: SparseControlNetModel, scheduler: KarrasDiffusionSchedulers, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L132)
**매개변수:**
vae ([AutoencoderKL](/docs/diffusers/main/ko/api/models/autoencoderkl#diffusers.AutoencoderKL)) : 이미지를 잠재 표현으로 인코딩하고 잠재 표현에서 이미지로 디코딩하는 Variational Auto-Encoder (VAE) 모델입니다.
text_encoder (`CLIPTextModel`) : 고정된 텍스트 인코더 ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : 텍스트를 토큰화하기 위한 [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer)입니다.
unet ([UNet2DConditionModel](/docs/diffusers/main/ko/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : 인코딩된 비디오 latents의 노이즈를 제거하기 위해 UNetMotionModel을 생성하는 데 사용되는 [UNet2DConditionModel](/docs/diffusers/main/ko/api/models/unet2d-cond#diffusers.UNet2DConditionModel)입니다.
motion_adapter (`MotionAdapter`) : `unet`와 함께 사용되어 인코딩된 비디오 latents의 노이즈를 제거하는 `MotionAdapter`입니다.
scheduler ([SchedulerMixin](/docs/diffusers/main/ko/api/schedulers/overview#diffusers.SchedulerMixin)) : `unet`와 함께 사용되어 인코딩된 이미지 latents의 노이즈를 제거하는 스케줄러입니다. [DDIMScheduler](/docs/diffusers/main/ko/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/ko/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler), 또는 [PNDMScheduler](/docs/diffusers/main/ko/api/schedulers/pndm#diffusers.PNDMScheduler) 중 하나일 수 있습니다.
Pipeline for controlled text-to-video generation using the method described in [SparseCtrl: Adding Sparse Controls to Text-to-Video Diffusion Models](https://huggingface.co/papers/2311.16933).
이 모델은 [DiffusionPipeline](/docs/diffusers/main/ko/api/pipelines/overview#diffusers.DiffusionPipeline)에서 상속됩니다. 모든 파이프라인에 대해 구현된 일반적 메서드(다운로드, 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
파이프라인은 다음 로딩 메서드도 상속합니다:
- 텍스트 인버전 임베딩을 로드하는 [load_textual_inversion()](/docs/diffusers/main/ko/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion)
- LoRA 가중치를 로드하는 [load_lora_weights()](/docs/diffusers/main/ko/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights)
- LoRA 가중치를 저장하는 [save_lora_weights()](/docs/diffusers/main/ko/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights)
- IP Adapter를 로드하기 위한 [load_ip_adapter()](/docs/diffusers/main/ko/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter)
#### __호출__[[diffusers.AnimateDiffSparseControlNetPipeline.__call__]]
```python
__call__(prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_frames: int = 16, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, controlnet_frame_indices: list = [0], guess_mode: bool = False, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'])
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L712)
**매개변수:**
prompt (`str` 또는 `list[str]`, *선택 사항*) : 이미지 생성을 안내할 프롬프트입니다. 정의되지 않은 경우 `prompt_embeds`를 전달해야 합니다.
height (`int`, *선택 사항*, 기본값은 `self.unet.config.sample_size * self.vae_scale_factor`) : 생성된 비디오의 픽셀 단위 높이.
width (`int`, *선택 사항*, 기본값은 `self.unet.config.sample_size * self.vae_scale_factor`) : 생성된 비디오의 픽셀 단위 너비입니다.
num_frames (`int`, *선택 사항*, 기본값 16) : 생성되는 비디오 프레임의 수입니다. 기본값은 16프레임이며, 초당 8프레임 기준 2초 분량의 비디오에 해당합니다.
num_inference_steps (`int`, *선택 사항*, 기본값 50) : 디노이징 단계의 수입니다. 디노이징 단계를 늘리면 일반적으로 더 높은 품질의 비디오를 얻을 수 있지만, 추론 속도가 느려집니다.
guidance_scale (`float`, *선택 사항*, 기본값 7.5) : guidance scale 값이 높을수록 모델은 이미지 품질이 낮아지는 대신 텍스트 `prompt`와 밀접하게 연결된 이미지를 생성하도록 유도됩니다. `guidance_scale > 1`일 때 guidance scale이 활성화됩니다.
negative_prompt (`str` 또는 `list[str]`, *선택*) : 이미지 생성에서 포함하지 않을 내용을 안내하는 프롬프트입니다. 정의되지 않은 경우 대신 `negative_prompt_embeds`를 전달해야 합니다. 가이던스를 사용하지 않을 때(`guidance_scale < 1`)에는 무시됩니다.
num_videos_per_prompt (`int`, *선택 사항*, 기본값 1) : 프롬프트당 생성할 비디오의 수입니다.
eta (`float`, *선택 사항*, 기본값 0.0) : [DDIM](https://huggingface.co/papers/2010.02502) 논문에서 정의한 파라미터 eta (η)에 해당합니다. [DDIMScheduler](/docs/diffusers/main/ko/api/schedulers/ddim#diffusers.DDIMScheduler)에만 적용되며, 다른 스케줄러에서는 무시됩니다.
generator (`torch.Generator` 또는 `list[torch.Generator]`, *선택 사항*) : 생성을 결정적으로 만들기 위한 [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html)입니다.
latents (`torch.Tensor`, *선택 사항*) : 가우시안 분포에서 샘플링된 사전 생성된 노이즈된 latents로, 비디오 생성의 입력으로 사용됩니다. 동일한 생성을 다른 프롬프트로 조정하는 데 사용할 수 있습니다. 제공되지 않으면, 제공된 랜덤 `generator`를 사용하여 샘플링하여 latents 텐서를 생성합니다. Latents의 shape은 `(batch_size, num_channel, num_frames, height, width)`여야 합니다.
prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 텍스트 임베딩입니다. 텍스트 입력(프롬프트 가중치)을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `prompt` 입력 인자에서 텍스트 임베딩이 생성됩니다.
negative_prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 부정 텍스트 임베딩입니다. 텍스트 입력(프롬프트 가중치)을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `negative_prompt` 입력 인수에서 `negative_prompt_embeds`가 생성됩니다.
ip_adapter_image : (`PipelineImageInput`, *선택 사항*): IP Adapters와 함께 사용할 선택적 이미지 입력입니다.
ip_adapter_image_embeds (`list[torch.Tensor]`, *선택*) : IP-Adapter를 위한 사전 생성된 이미지 임베딩입니다. IP-Adapter의 수와 동일한 길이의 리스트여야 합니다. 각 요소는 `(batch_size, num_images, emb_dim)` 형태의 텐서여야 합니다. `do_classifier_free_guidance`가 `True`로 설정된 경우, 음의 이미지 임베딩을 포함해야 합니다. 제공되지 않으면 `ip_adapter_image` 입력 인자로부터 임베딩이 계산됩니다.
conditioning_frames (`list[PipelineImageInput]`, *선택 사항*) : 생성을 위해 `unet`에 가이던스를 제공하기 위한 SparseControlNet 입력입니다.
output_type (`str`, *선택 사항*, 기본값 `"pil"`) : 생성된 비디오의 출력 형식입니다. `torch.Tensor`, `PIL.Image` 또는 `np.array` 중 하나를 선택합니다.
return_dict (`bool`, *선택 사항*, 기본값 `True`) : 일반 튜플 대신 `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput`을 반환할지 여부.
cross_attention_kwargs (`dict`, *선택 사항*) : 지정된 경우 [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py)에서 정의된 `AttentionProcessor`로 전달되는 kwargs 사전입니다.
controlnet_conditioning_scale (`float` 또는 `list[float]`, *선택 사항*, 기본값 1.0) : ControlNet의 출력은 원래 `unet`의 잔차에 더해지기 전에 `controlnet_conditioning_scale`과 곱해집니다. `init`에 여러 ControlNet이 지정된 경우, 해당 스케일을 리스트로 설정할 수 있습니다.
controlnet_frame_indices (`list[int]`) : 생성 시 조건 프레임이 적용되어야 하는 인덱스입니다. 모델이 유사한 구조의 출력을 생성하도록 안내하기 위해 여러 프레임을 제공할 수 있으며, 이 경우 `unet`가 보간 비디오의 "빈칸을 채우는" 역할을 하거나, 일반적인 예상 구조를 위해 단일 프레임을 제공할 수 있습니다. `conditioning_frames`와 동일한 길이를 가져야 합니다.
guess_mode (`bool`, *선택 사항*, 기본값 `False`) : 프롬프트를 모두 제거하더라도 ControlNet 인코더는 입력 이미지의 내용을 인식하려고 시도합니다. `guidance_scale` 값은 3.0에서 5.0 사이를 권장합니다.
clip_skip (`int`, *선택 사항*) : 프롬프트 임베딩을 계산할 때 CLIP에서 건너뛸 레이어 수. 값이 1이면 최종 레이어 바로 이전 레이어의 출력을 프롬프트 임베딩 계산에 사용합니다.
callback_on_step_end (`Callable`, *선택 사항*) : 추론 중 각 디노이징 단계의 끝에서 호출되는 함수입니다. 이 함수는 다음 인수를 받아 호출됩니다: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs`에는 `callback_on_step_end_tensor_inputs`로 지정된 모든 텐서 목록이 포함됩니다.
callback_on_step_end_tensor_inputs (`list`, *선택 사항*) : `callback_on_step_end` 함수의 텐서 입력 목록입니다. 목록에 지정된 텐서는 `callback_kwargs` 인수로 전달됩니다. 파이프라인 클래스의 `._callback_tensor_inputs` 속성에 나열된 변수만 포함할 수 있습니다.
**반환값:** [AnimateDiffPipelineOutput](/docs/diffusers/main/ko/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) 또는 `tuple`
`return_dict`가 `True`인 경우 [AnimateDiffPipelineOutput](/docs/diffusers/main/ko/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput)가 반환되고, 그렇지 않으면 첫 번째 요소가 생성된 프레임 목록인 `tuple`이 반환됩니다.
생성을 위한 pipeline의 호출 함수.
예:
```python
>>> import torch
>>> from diffusers import AnimateDiffSparseControlNetPipeline
>>> from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
>>> from diffusers.schedulers import DPMSolverMultistepScheduler
>>> from diffusers.utils import export_to_gif, load_image
>>> model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
>>> motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
>>> controlnet_id = "guoyww/animatediff-sparsectrl-scribble"
>>> lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
>>> vae_id = "stabilityai/sd-vae-ft-mse"
>>> device = "cuda"
>>> motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, torch_dtype=torch.float16).to(device)
>>> controlnet = SparseControlNetModel.from_pretrained(controlnet_id, torch_dtype=torch.float16).to(device)
>>> vae = AutoencoderKL.from_pretrained(vae_id, torch_dtype=torch.float16).to(device)
>>> scheduler = DPMSolverMultistepScheduler.from_pretrained(
... model_id,
... subfolder="scheduler",
... beta_schedule="linear",
... algorithm_type="dpmsolver++",
... use_karras_sigmas=True,
... )
>>> pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
... model_id,
... motion_adapter=motion_adapter,
... controlnet=controlnet,
... vae=vae,
... scheduler=scheduler,
... torch_dtype=torch.float16,
... ).to(device)
>>> pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
>>> pipe.fuse_lora(lora_scale=1.0)
>>> prompt = "an aerial view of a cyberpunk city, night time, neon lights, masterpiece, high quality"
>>> negative_prompt = "low quality, worst quality, letterboxed"
>>> image_files = [
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-1.png",
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-2.png",
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-3.png",
... ]
>>> condition_frame_indices = [0, 8, 15]
>>> conditioning_frames = [load_image(img_file) for img_file in image_files]
>>> video = pipe(
... prompt=prompt,
... negative_prompt=negative_prompt,
... num_inference_steps=25,
... conditioning_frames=conditioning_frames,
... controlnet_conditioning_scale=1.0,
... controlnet_frame_indices=condition_frame_indices,
... generator=torch.Generator().manual_seed(1337),
... ).frames[0]
>>> export_to_gif(video, "output.gif")
```
#### encode_prompt[[diffusers.AnimateDiffSparseControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L208)
**매개변수:**
prompt (`str` 또는 `list[str]`, *선택 사항*) : 인코딩할 프롬프트
device : (`torch.device`): torch 디바이스
num_images_per_prompt (`int`) : 프롬프트당 생성할 이미지 수
do_classifier_free_guidance (`bool`) : classifier free guidance를 사용할지 여부
negative_prompt (`str` 또는 `list[str]`, *선택 사항*) : 이미지 생성을 안내하지 않을 프롬프트입니다. 정의되지 않은 경우 대신 `negative_prompt_embeds`를 전달해야 합니다. 가이던스를 사용하지 않는 경우 무시됩니다(즉, `guidance_scale`이 `1`보다 작은 경우 무시됩니다).
prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 텍스트 임베딩입니다. *예를 들어* 프롬프트 가중치와 같은 텍스트 입력을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `prompt` 입력 인자에서 텍스트 임베딩이 생성됩니다.
negative_prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 부정 텍스트 임베딩입니다. 텍스트 입력을 쉽게 조정하는 데 사용할 수 있으며, *예를 들어* 프롬프트 가중치 설정에 활용할 수 있습니다. 제공되지 않으면 `negative_prompt` 입력 인수에서 negative_prompt_embeds가 생성됩니다.
lora_scale (`float`, *선택 사항*) : LoRA 레이어가 로드된 경우 텍스트 인코더의 모든 LoRA 레이어에 적용될 LoRA 스케일입니다.
clip_skip (`int`, *선택 사항*) : 프롬프트 임베딩을 계산할 때 CLIP에서 건너뛸 레이어 수. 값이 1이면 최종 레이어 바로 이전 레이어의 출력을 프롬프트 임베딩 계산에 사용합니다.
프롬프트를 텍스트 인코더의 히든 상태로 인코딩합니다.
## AnimateDiffSDXLPipeline[[diffusers.AnimateDiffSDXLPipeline]]
#### diffusers.AnimateDiffSDXLPipeline[[diffusers.AnimateDiffSDXLPipeline]]
```python
diffusers.AnimateDiffSDXLPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, text_encoder_2: CLIPTextModelWithProjection, tokenizer: CLIPTokenizer, tokenizer_2: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, image_encoder: CLIPVisionModelWithProjection = None, feature_extractor: CLIPImageProcessorPil = None, force_zeros_for_empty_prompt: bool = True)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L210)
**매개변수:**
vae ([AutoencoderKL](/docs/diffusers/main/ko/api/models/autoencoderkl#diffusers.AutoencoderKL)) : 이미지를 잠재 표현으로 인코딩하고 잠재 표현에서 이미지로 디코딩하는 Variational Auto-Encoder (VAE) 모델입니다.
text_encoder (`CLIPTextModel`) : 고정된 텍스트 인코더입니다. Stable Diffusion XL은 [CLIP](https://huggingface.co/docs/transformers/model_doc/clip#transformers.CLIPTextModel)의 텍스트 부분을 사용하며, 구체적으로 [clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14) 변형을 사용합니다.
text_encoder_2 (` CLIPTextModelWithProjection`) : 두 번째 고정된 텍스트 인코더입니다. Stable Diffusion XL은 [CLIP](https://huggingface.co/docs/transformers/model_doc/clip#transformers.CLIPTextModelWithProjection)의 텍스트 및 풀링 부분을 사용하며, 구체적으로 [laion/CLIP-ViT-bigG-14-laion2B-39B-b160k](https://huggingface.co/laion/CLIP-ViT-bigG-14-laion2B-39B-b160k) 변형을 사용합니다.
tokenizer (`CLIPTokenizer`) : [CLIPTokenizer](https://huggingface.co/docs/transformers/v4.21.0/en/model_doc/clip#transformers.CLIPTokenizer) 클래스의 토크나이저.
tokenizer_2 (`CLIPTokenizer`) : [CLIPTokenizer](https://huggingface.co/docs/transformers/v4.21.0/en/model_doc/clip#transformers.CLIPTokenizer) 클래스의 두 번째 Tokenizer.
unet ([UNet2DConditionModel](/docs/diffusers/main/ko/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : 인코딩된 이미지 레이턴트를 디노이즈하기 위한 조건부 U-Net 아키텍처.
scheduler ([SchedulerMixin](/docs/diffusers/main/ko/api/schedulers/overview#diffusers.SchedulerMixin)) : `unet`와 함께 사용되어 인코딩된 이미지 latents의 노이즈를 제거하는 스케줄러입니다. [DDIMScheduler](/docs/diffusers/main/ko/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/ko/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler), 또는 [PNDMScheduler](/docs/diffusers/main/ko/api/schedulers/pndm#diffusers.PNDMScheduler) 중 하나일 수 있습니다.
force_zeros_for_empty_prompt (`bool`, *선택 사항*, 기본값 `"True"`) : negative prompt embeddings가 항상 0으로 설정되도록 강제할지 여부입니다. 또한 `stabilityai/stable-diffusion-xl-base-1-0`의 config를 참고하세요.
Stable Diffusion XL을 사용한 텍스트-비디오 생성을 위한 Pipeline입니다.
이 모델은 [DiffusionPipeline](/docs/diffusers/main/ko/api/pipelines/overview#diffusers.DiffusionPipeline)에서 상속됩니다. 라이브러리가 모든 파이프라인에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
파이프라인은 다음 로딩 메서드도 상속합니다:
- 텍스트 인버전 임베딩을 로드하는 [load_textual_inversion()](/docs/diffusers/main/ko/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion)
- `.ckpt` 파일을 로드하기 위한 [from_single_file()](/docs/diffusers/main/ko/api/loaders/single_file#diffusers.loaders.FromSingleFileMixin.from_single_file)
- LoRA 가중치를 로드하는 [load_lora_weights()](/docs/diffusers/main/ko/api/loaders/lora#diffusers.loaders.StableDiffusionXLLoraLoaderMixin.load_lora_weights)
- LoRA 가중치를 저장하는 [save_lora_weights()](/docs/diffusers/main/ko/api/loaders/lora#diffusers.loaders.StableDiffusionXLLoraLoaderMixin.save_lora_weights)
- IP Adapter를 로드하기 위한 [load_ip_adapter()](/docs/diffusers/main/ko/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter)
#### __호출__[[diffusers.AnimateDiffSDXLPipeline.__call__]]
```python
__call__(prompt: str | list[str] = None, prompt_2: str | list[str] | None = None, num_frames: int = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, timesteps: list = None, sigmas: list = None, denoising_end: float | None = None, guidance_scale: float = 5.0, negative_prompt: str | list[str] | None = None, negative_prompt_2: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, negative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, guidance_rescale: float = 0.0, original_size: tuple[int, int] | None = None, crops_coords_top_left: tuple = (0, 0), target_size: tuple[int, int] | None = None, negative_original_size: tuple[int, int] | None = None, negative_crops_coords_top_left: tuple = (0, 0), negative_target_size: tuple[int, int] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'])
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L869)
**매개변수:**
prompt (`str` 또는 `list[str]`, *선택 사항*) : 비디오 생성을 안내할 프롬프트입니다. 정의되지 않은 경우 `prompt_embeds`를 대신 전달해야 합니다.
prompt_2 (`str` 또는 `list[str]`, *선택 사항*) : `tokenizer_2` 및 `text_encoder_2`에 전송할 프롬프트입니다. 정의되지 않은 경우, 두 텍스트 인코더 모두에 `prompt`가 사용됩니다.
num_frames : 생성되는 비디오 프레임의 수입니다. 기본값은 16프레임이며, 초당 8프레임 기준 2초 분량의 비디오에 해당합니다.
height (`int`, *선택 사항*, 기본값은 self.unet.config.sample_size * self.vae_scale_factor) : 생성된 비디오의 픽셀 단위 높이입니다. 최적의 결과를 위해 기본값은 1024로 설정되어 있습니다. [stabilityai/stable-diffusion-xl-base-1.0](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0)와 낮은 해상도로 특별히 미세 조정되지 않은 체크포인트의 경우 512픽셀 미만에서는 제대로 작동하지 않습니다.
width (`int`, *선택 사항*, 기본값은 self.unet.config.sample_size * self.vae_scale_factor) : 생성된 비디오의 픽셀 단위 너비입니다. 최적의 결과를 위해 기본값은 1024로 설정되어 있습니다. [stabilityai/stable-diffusion-xl-base-1.0](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0)와 저해상도에 대해 특별히 파인튜닝되지 않은 체크포인트의 경우 512픽셀 미만에서는 제대로 작동하지 않습니다.
num_inference_steps (`int`, *선택 사항*, 기본값 50) : 디노이징 단계의 수입니다. 디노이징 단계를 늘리면 추론 속도가 느려지는 대신 일반적으로 더 높은 품질의 비디오를 얻을 수 있습니다.
timesteps (`list[int]`, *선택 사항*) : `set_timesteps` 메서드에 `timesteps` 인수를 지원하는 스케줄러의 노이즈 제거 과정에 사용할 커스텀 타임스텝입니다. 정의되지 않은 경우, `num_inference_steps`가 전달될 때의 기본 동작이 사용됩니다. 내림차순으로 정렬되어 있어야 합니다.
sigmas (`list[float]`, *선택 사항*) : `set_timesteps` 메서드에 `sigmas` 인수를 지원하는 스케줄러의 노이즈 제거 과정에 사용할 커스텀 시그마입니다. 정의되지 않은 경우, `num_inference_steps`가 전달될 때의 기본 동작이 사용됩니다.
denoising_end (`float`, *선택 사항*) : 지정된 경우, 전체 디노이징 과정 중 의도적으로 조기 종료되기 전에 완료될 비율(0.0에서 1.0 사이)을 결정합니다. 그 결과, 스케줄러가 선택한 이산 시간 단계에 따라 반환되는 샘플에는 상당한 양의 노이즈가 여전히 남아 있게 됩니다. [**이미지 출력 개선**](https://huggingface.co/docs/diffusers/api/pipelines/stable_diffusion/stable_diffusion_xl#refining-the-image-output)에서 자세히 설명된 바와 같이, 이 파이프라인이 "Mixture of Denoisers" 멀티 파이프라인 구성의 일부로 사용되는 경우 denoising_end 매개변수를 이상적으로 활용해야 합니다.
guidance_scale (`float`, *선택 사항*, 기본값 5.0) : [Classifier-Free Diffusion Guidance](https://huggingface.co/papers/2207.12598)에서 정의한 가이던스 스케일입니다. `guidance_scale`은 [Imagen Paper](https://huggingface.co/papers/2205.11487)의 2번 식의 `w`로 정의됩니다. `guidance_scale > 1`을 설정하여 가이던스 스케일을 활성화합니다. 가이던스 스케일이 높을수록 `prompt` 텍스트와 밀접하게 연결된 이미지를 생성하도록 장려하지만, 일반적으로 비디오 품질이 낮아지는 대가를 치릅니다.
negative_prompt (`str` 또는 `list[str]`, *선택 사항*) : 비디오 생성을 안내하지 않을 프롬프트입니다. 정의되지 않은 경우 대신 `negative_prompt_embeds`를 전달해야 합니다. 가이던스를 사용하지 않는 경우 무시됩니다(즉, `guidance_scale`이 `1`보다 작은 경우 무시됩니다).
negative_prompt_2 (`str` 또는 `list[str]`, *선택*) : `tokenizer_2`와 `text_encoder_2`에 전송할 비디오 생성을 유도하지 않을 프롬프트입니다. 정의되지 않은 경우, `negative_prompt`가 두 텍스트 인코더 모두에 사용됩니다.
num_videos_per_prompt (`int`, *선택 사항*, 기본값 1) : 프롬프트당 생성할 비디오의 수입니다.
eta (`float`, *선택 사항*, 기본값 0.0) : DDIM 논문(https://huggingface.co/papers/2010.02502)의 파라미터 eta (η)에 해당합니다. [schedulers.DDIMScheduler](/docs/diffusers/main/ko/api/schedulers/ddim#diffusers.DDIMScheduler)에만 적용되며, 다른 스케줄러에서는 무시됩니다.
generator (`torch.Generator` 또는 `list[torch.Generator]`, *선택 사항*) : 생성을 결정적으로 만들기 위한 [torch generator](https://pytorch.org/docs/stable/generated/torch.Generator.html) 하나 또는 목록.
latents (`torch.Tensor`, *선택 사항*) : 비디오 생성의 입력으로 사용할 가우시안 분포에서 샘플링된 사전 생성된 노이즈된 latents입니다. 동일한 생성을 다른 프롬프트로 조정하는 데 사용할 수 있습니다. 제공되지 않으면, 제공된 랜덤 `generator`를 사용하여 샘플링하여 latents 텐서가 생성됩니다.
prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 텍스트 임베딩입니다. *예를 들어* 프롬프트 가중치와 같은 텍스트 입력을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `prompt` 입력 인자에서 텍스트 임베딩이 생성됩니다.
negative_prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 부정 텍스트 임베딩입니다. 텍스트 입력을 쉽게 조정하는 데 사용할 수 있으며, *예를 들어* 프롬프트 가중치 설정에 활용할 수 있습니다. 제공되지 않으면 `negative_prompt` 입력 인수에서 negative_prompt_embeds가 생성됩니다.
pooled_prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 풀링된 텍스트 임베딩입니다. 텍스트 입력을 쉽게 조정하는 데 사용할 수 있으며, *예를 들어* 프롬프트 가중치 설정에 활용할 수 있습니다. 제공되지 않으면 `prompt` 입력 인자로부터 풀링된 텍스트 임베딩이 생성됩니다.
negative_pooled_prompt_embeds (`torch.Tensor`, *선택*) : 미리 생성된 negative pooled text embeddings입니다. 텍스트 입력을 쉽게 조정하는 데 사용할 수 있으며, *예를 들어* 프롬프트 가중치 설정에 활용할 수 있습니다. 제공되지 않으면 `negative_prompt` 입력 인수로부터 pooled negative_prompt_embeds가 생성됩니다.
ip_adapter_image : (`PipelineImageInput`, *선택 사항*): IP Adapters와 함께 사용할 선택적 이미지 입력입니다.
ip_adapter_image_embeds (`list[torch.Tensor]`, *선택 사항*) : IP-Adapter용 사전 생성된 이미지 임베딩입니다. 제공되지 않으면 `ip_adapter_image` 입력 인자로부터 임베딩이 계산됩니다.
output_type (`str`, *선택 사항*, 기본값 `"pil"`) : 생성된 비디오의 출력 형식입니다. [PIL](https://pillow.readthedocs.io/en/stable/): `PIL.Image.Image` 또는 `np.array` 중 하나를 선택합니다.
return_dict (`bool`, *선택 사항*, 기본값 `True`) : 일반 튜플 대신 `~pipelines.stable_diffusion_xl.AnimateDiffPipelineOutput`을 반환할지 여부.
cross_attention_kwargs (`dict`, *선택 사항*) : 지정된 경우 [diffusers.models.attention_processor](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py)의 `self.processor` 아래에서 정의된 `AttentionProcessor`로 전달되는 kwargs 사전입니다.
guidance_rescale (`float`, *선택 사항*, 기본값 0.0) : [Common Diffusion Noise Schedules and Sample Steps are Flawed](https://huggingface.co/papers/2305.08891)에서 제안한 Guidance rescale factor입니다. `guidance_scale`은 [Common Diffusion Noise Schedules and Sample Steps are Flawed](https://huggingface.co/papers/2305.08891)의 16번 식에서 `φ`로 정의됩니다. Guidance rescale factor는 zero terminal SNR을 사용할 때 과노출 문제를 해결해야 합니다.
original_size (`tuple[int]`, *선택 사항*, 기본값 (1024, 1024)) : `original_size`가 `target_size`와 같지 않으면 이미지가 다운샘플링 또는 업샘플링된 것처럼 보입니다. `original_size`는 지정되지 않은 경우 기본값이 `(height, width)`입니다. [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952)의 2.2절에서 설명된 SDXL의 마이크로 컨디셔닝(micro-conditioning)의 일부입니다.
crops_coords_top_left (`tuple[int]`, *선택 사항*, 기본값 (0, 0)) : `crops_coords_top_left`를 사용하면 `crops_coords_top_left` 위치에서 아래쪽으로 "잘린" 것처럼 보이는 이미지를 생성할 수 있습니다. (0, 0)으로 `crops_coords_top_left`를 설정하면 일반적으로 잘 중앙 정렬된 이미지를 얻을 수 있습니다. [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952)의 2.2절에서 설명된 SDXL의 micro-conditioning의 일부입니다.
target_size (`tuple[int]`, *선택 사항*, 기본값 (1024, 1024)) : 대부분의 경우 `target_size`는 생성된 이미지의 원하는 높이와 너비로 설정해야 합니다. 지정되지 않으면 기본값으로 `(height, width)`가 사용됩니다. [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952)의 2.2절에서 설명된 SDXL의 마이크로 컨디션닝(micro-conditioning)의 일부입니다.
negative_original_size (`tuple[int]`, *선택 사항*, 기본값 (1024, 1024)) : 특정 이미지 해상도를 기반으로 생성 과정을 부정적으로 조건부 설정합니다. [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952)의 2.2절에서 설명된 SDXL의 micro-conditioning의 일부입니다. 자세한 내용은 이 이슈 스레드를 참조하세요: https://github.com/huggingface/diffusers/issues/4208.
negative_crops_coords_top_left (`tuple[int]`, *선택 사항*, 기본값 (0, 0)) : 특정 crop 좌표를 기반으로 생성 과정을 부정적으로 조건부화합니다. [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952)의 2.2절에서 설명된 SDXL의 micro-conditioning의 일부입니다. 자세한 내용은 이 이슈 스레드를 참조하세요: https://github.com/huggingface/diffusers/issues/4208.
negative_target_size (`tuple[int]`, *선택 사항*, 기본값 (1024, 1024)) : 대상 이미지 해상도를 기반으로 생성 과정을 부정적으로 조건부 설정합니다. 대부분의 경우 `target_size`와 동일해야 합니다. [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952)의 2.2절에서 설명된 SDXL의 마이크로 컨디션잉(micro-conditioning)의 일부입니다. 자세한 내용은 이 이슈 스레드를 참조하세요: https://github.com/huggingface/diffusers/issues/4208.
clip_skip (`int`, *선택 사항*) : 프롬프트 임베딩을 계산할 때 CLIP에서 건너뛸 레이어 수. 값이 1이면 최종 레이어 바로 이전 레이어의 출력을 프롬프트 임베딩 계산에 사용합니다.
callback_on_step_end (`Callable`, *선택 사항*) : 추론 중 각 디노이징 단계의 끝에서 호출되는 함수입니다. 이 함수는 다음 인수를 받아 호출됩니다: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs`에는 `callback_on_step_end_tensor_inputs`로 지정된 모든 텐서 목록이 포함됩니다.
callback_on_step_end_tensor_inputs (`list`, *선택 사항*) : `callback_on_step_end` 함수의 텐서 입력 목록입니다. 목록에 지정된 텐서는 `callback_kwargs` 인수로 전달됩니다. 파이프라인 클래스의 `._callback_tensor_inputs` 속성에 나열된 변수만 포함할 수 있습니다.
**반환값:** [AnimateDiffPipelineOutput](/docs/diffusers/main/ko/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) 또는 `tuple`
`return_dict`가 `True`인 경우 [AnimateDiffPipelineOutput](/docs/diffusers/main/ko/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput)가 반환되고, 그렇지 않으면 첫 번째 요소가 생성된 프레임 목록인 `tuple`이 반환됩니다.
생성을 위해 파이프라인을 호출할 때 호출되는 함수.
예:
```py
>>> import torch
>>> from diffusers.models import MotionAdapter
>>> from diffusers import AnimateDiffSDXLPipeline, DDIMScheduler
>>> from diffusers.utils import export_to_gif
>>> adapter = MotionAdapter.from_pretrained(
... "a-r-r-o-w/animatediff-motion-adapter-sdxl-beta", torch_dtype=torch.float16
... )
>>> model_id = "stabilityai/stable-diffusion-xl-base-1.0"
>>> scheduler = DDIMScheduler.from_pretrained(
... model_id,
... subfolder="scheduler",
... clip_sample=False,
... timestep_spacing="linspace",
... beta_schedule="linear",
... steps_offset=1,
... )
>>> pipe = AnimateDiffSDXLPipeline.from_pretrained(
... model_id,
... motion_adapter=adapter,
... scheduler=scheduler,
... torch_dtype=torch.float16,
... variant="fp16",
... ).to("cuda")
>>> # enable memory savings
>>> pipe.vae.enable_slicing()
>>> pipe.vae.enable_tiling()
>>> output = pipe(
... prompt="a panda surfing in the ocean, realistic, high quality",
... negative_prompt="low quality, worst quality",
... num_inference_steps=20,
... guidance_scale=8,
... width=1024,
... height=1024,
... num_frames=16,
... )
>>> frames = output.frames[0]
>>> export_to_gif(frames, "animation.gif")
```
#### encode_prompt[[diffusers.AnimateDiffSDXLPipeline.encode_prompt]]
```python
encode_prompt(prompt: str, prompt_2: str | None = None, device: typing.Optional[torch.device] = None, num_videos_per_prompt: int = 1, do_classifier_free_guidance: bool = True, negative_prompt: str | None = None, negative_prompt_2: str | None = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, negative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L327)
**매개변수:**
prompt (`str` 또는 `list[str]`, *선택 사항*) : 인코딩할 프롬프트
prompt_2 (`str` 또는 `list[str]`, *선택 사항*) : `tokenizer_2` 및 `text_encoder_2`에 전송할 프롬프트입니다. 정의되지 않은 경우, 두 텍스트 인코더 모두에 `prompt`가 사용됩니다.
device : (`torch.device`): torch 디바이스
num_videos_per_prompt (`int`) : 프롬프트당 생성할 이미지 수
do_classifier_free_guidance (`bool`) : classifier free guidance를 사용할지 여부
negative_prompt (`str` 또는 `list[str]`, *선택 사항*) : 이미지 생성을 안내하지 않을 프롬프트입니다. 정의되지 않은 경우 대신 `negative_prompt_embeds`를 전달해야 합니다. 가이던스를 사용하지 않는 경우 무시됩니다(즉, `guidance_scale`이 `1`보다 작은 경우 무시됩니다).
negative_prompt_2 (`str` 또는 `list[str]`, *선택*) : 이미지 생성을 유도하지 않기 위해 `tokenizer_2`와 `text_encoder_2`에 전송할 프롬프트입니다. 정의되지 않은 경우, `negative_prompt`가 두 텍스트 인코더 모두에 사용됩니다.
prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 텍스트 임베딩입니다. *예를 들어* 프롬프트 가중치와 같은 텍스트 입력을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `prompt` 입력 인자에서 텍스트 임베딩이 생성됩니다.
negative_prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 부정 텍스트 임베딩입니다. 텍스트 입력을 쉽게 조정하는 데 사용할 수 있으며, *예를 들어* 프롬프트 가중치 설정에 활용할 수 있습니다. 제공되지 않으면 `negative_prompt` 입력 인수에서 negative_prompt_embeds가 생성됩니다.
pooled_prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 풀링된 텍스트 임베딩입니다. 텍스트 입력을 쉽게 조정하는 데 사용할 수 있으며, *예를 들어* 프롬프트 가중치 설정에 활용할 수 있습니다. 제공되지 않으면 `prompt` 입력 인자로부터 풀링된 텍스트 임베딩이 생성됩니다.
negative_pooled_prompt_embeds (`torch.Tensor`, *선택*) : 미리 생성된 negative pooled text embeddings입니다. 텍스트 입력을 쉽게 조정하는 데 사용할 수 있으며, *예를 들어* 프롬프트 가중치 설정에 활용할 수 있습니다. 제공되지 않으면 `negative_prompt` 입력 인수로부터 pooled negative_prompt_embeds가 생성됩니다.
lora_scale (`float`, *선택 사항*) : LoRA 레이어가 로드된 경우, 텍스트 인코더의 모든 LoRA 레이어에 적용될 LoRA 스케일입니다.
clip_skip (`int`, *선택 사항*) : 프롬프트 임베딩을 계산할 때 CLIP에서 건너뛸 레이어 수. 값이 1이면 최종 레이어 바로 이전 레이어의 출력을 프롬프트 임베딩 계산에 사용합니다.
프롬프트를 텍스트 인코더의 히든 상태로 인코딩합니다.
#### get_guidance_scale_embedding[[diffusers.AnimateDiffSDXLPipeline.get_guidance_scale_embedding]]
```python
get_guidance_scale_embedding(w: Tensor, embedding_dim: int = 512, dtype: dtype = torch.float32)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L804)
**매개변수:**
w (`torch.Tensor`) : 지정된 guidance scale을 사용하여 임베딩 벡터를 생성하고, 이를 통해 timestep 임베딩을 풍부하게 만듭니다.
embedding_dim (`int`, *선택 사항*, 기본값 512) : 생성할 임베딩의 차원.
dtype (`torch.dtype`, *선택 사항*, 기본값 `torch.float32`) : 생성된 임베딩의 데이터 유형입니다.
**반환값:** `torch.Tensor`
`(len(w), embedding_dim)` 형태의 임베딩 벡터.
https://github.com/google-research/vdm/blob/dc27b98a554f65cdc654b800da5aa1846545d41b/model_vdm.py#L298 를 참조하세요.
## AnimateDiffVideoToVideoPipeline[[diffusers.AnimateDiffVideoToVideoPipeline]]
#### diffusers.AnimateDiffVideoToVideoPipeline[[diffusers.AnimateDiffVideoToVideoPipeline]]
```python
diffusers.AnimateDiffVideoToVideoPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L181)
**매개변수:**
vae ([AutoencoderKL](/docs/diffusers/main/ko/api/models/autoencoderkl#diffusers.AutoencoderKL)) : 이미지를 잠재 표현으로 인코딩하고 잠재 표현에서 이미지로 디코딩하는 Variational Auto-Encoder (VAE) 모델입니다.
text_encoder (`CLIPTextModel`) : 고정된 텍스트 인코더 ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : 텍스트를 토큰화하기 위한 [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer)입니다.
unet ([UNet2DConditionModel](/docs/diffusers/main/ko/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : 인코딩된 비디오 latents의 노이즈를 제거하기 위해 UNetMotionModel을 생성하는 데 사용되는 [UNet2DConditionModel](/docs/diffusers/main/ko/api/models/unet2d-cond#diffusers.UNet2DConditionModel)입니다.
motion_adapter (`MotionAdapter`) : `unet`와 함께 사용되어 인코딩된 비디오 latents의 노이즈를 제거하는 `MotionAdapter`입니다.
scheduler ([SchedulerMixin](/docs/diffusers/main/ko/api/schedulers/overview#diffusers.SchedulerMixin)) : `unet`와 함께 사용되어 인코딩된 이미지 latents의 노이즈를 제거하는 스케줄러입니다. [DDIMScheduler](/docs/diffusers/main/ko/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/ko/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler), 또는 [PNDMScheduler](/docs/diffusers/main/ko/api/schedulers/pndm#diffusers.PNDMScheduler) 중 하나일 수 있습니다.
비디오-투-비디오 생성을 위한 Pipeline입니다.
이 모델은 [DiffusionPipeline](/docs/diffusers/main/ko/api/pipelines/overview#diffusers.DiffusionPipeline)에서 상속됩니다. 모든 파이프라인에 대해 구현된 일반적 메서드(다운로드, 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
파이프라인은 다음 로딩 메서드도 상속합니다:
- 텍스트 인버전 임베딩을 로드하는 [load_textual_inversion()](/docs/diffusers/main/ko/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion)
- LoRA 가중치를 로드하는 [load_lora_weights()](/docs/diffusers/main/ko/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights)
- LoRA 가중치를 저장하는 [save_lora_weights()](/docs/diffusers/main/ko/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights)
- IP Adapter를 로드하기 위한 [load_ip_adapter()](/docs/diffusers/main/ko/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter)
#### __호출__[[diffusers.AnimateDiffVideoToVideoPipeline.__call__]]
```python
__call__(video: list = None, prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, enforce_inference_steps: bool = False, timesteps: list[int] | None = None, sigmas: list[float] | None = None, guidance_scale: float = 7.5, strength: float = 0.8, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'], decode_chunk_size: int = 16)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L744)
**매개변수:**
video (`list[PipelineImageInput]`) : 생성을 조건으로 사용할 입력 비디오. 비디오의 이미지/프레임 목록이어야 합니다.
prompt (`str` 또는 `list[str]`, *선택 사항*) : 이미지 생성을 안내할 프롬프트입니다. 정의되지 않은 경우 `prompt_embeds`를 전달해야 합니다.
height (`int`, *선택 사항*, 기본값은 `self.unet.config.sample_size * self.vae_scale_factor`) : 생성된 비디오의 픽셀 단위 높이.
width (`int`, *선택 사항*, 기본값은 `self.unet.config.sample_size * self.vae_scale_factor`) : 생성된 비디오의 픽셀 단위 너비입니다.
num_inference_steps (`int`, *선택 사항*, 기본값 50) : 디노이징 단계의 수입니다. 디노이징 단계를 늘리면 일반적으로 더 높은 품질의 비디오를 얻을 수 있지만, 추론 속도가 느려집니다.
enforce_inference_steps (`bool`, *선택 사항*, 기본값 `False`) : `strength` 매개변수에 관계없이 `num_inference_steps` 디노이징 단계를 강제할지 여부입니다. `False`인 경우, `strength`에 따라 실제 추론 단계 수가 줄어듭니다.
timesteps (`list[int]`, *선택 사항*) : `set_timesteps` 메서드에 `timesteps` 인수를 지원하는 스케줄러의 노이즈 제거 과정에 사용할 커스텀 타임스텝입니다. 정의되지 않은 경우, `num_inference_steps`가 전달될 때의 기본 동작이 사용됩니다. 내림차순으로 정렬되어 있어야 합니다.
sigmas (`list[float]`, *선택 사항*) : `set_timesteps` 메서드에 `sigmas` 인수를 지원하는 스케줄러의 노이즈 제거 과정에 사용할 커스텀 시그마입니다. 정의되지 않은 경우, `num_inference_steps`가 전달될 때의 기본 동작이 사용됩니다.
strength (`float`, *선택 사항*, 기본값 0.8) : 값이 높을수록 원본 비디오와 생성된 비디오 간의 차이가 커집니다.
guidance_scale (`float`, *선택 사항*, 기본값 7.5) : guidance scale 값이 높을수록 모델은 이미지 품질이 낮아지는 대신 텍스트 `prompt`와 밀접하게 연결된 이미지를 생성하도록 유도됩니다. `guidance_scale > 1`일 때 guidance scale이 활성화됩니다.
negative_prompt (`str` 또는 `list[str]`, *선택*) : 이미지 생성에서 포함하지 않을 내용을 안내하는 프롬프트입니다. 정의되지 않은 경우 대신 `negative_prompt_embeds`를 전달해야 합니다. 가이던스를 사용하지 않을 때(`guidance_scale < 1`)에는 무시됩니다.
num_videos_per_prompt (`int`, *선택 사항*, 기본값 1) : 프롬프트당 생성할 비디오의 수입니다.
eta (`float`, *선택 사항*, 기본값 0.0) : [DDIM](https://huggingface.co/papers/2010.02502) 논문에서 정의한 파라미터 eta (η)에 해당합니다. [DDIMScheduler](/docs/diffusers/main/ko/api/schedulers/ddim#diffusers.DDIMScheduler)에만 적용되며, 다른 스케줄러에서는 무시됩니다.
generator (`torch.Generator` 또는 `list[torch.Generator]`, *선택 사항*) : 생성을 결정적으로 만들기 위한 [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html)입니다.
latents (`torch.Tensor`, *선택 사항*) : 가우시안 분포에서 샘플링된 사전 생성된 노이즈된 latents로, 비디오 생성의 입력으로 사용됩니다. 동일한 생성을 다른 프롬프트로 조정하는 데 사용할 수 있습니다. 제공되지 않으면, 제공된 랜덤 `generator`를 사용하여 샘플링하여 latents 텐서를 생성합니다. Latents의 shape은 `(batch_size, num_channel, num_frames, height, width)`여야 합니다.
prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 텍스트 임베딩입니다. 텍스트 입력(프롬프트 가중치)을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `prompt` 입력 인자에서 텍스트 임베딩이 생성됩니다.
negative_prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 부정 텍스트 임베딩입니다. 텍스트 입력(프롬프트 가중치)을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `negative_prompt` 입력 인수에서 `negative_prompt_embeds`가 생성됩니다.
ip_adapter_image : (`PipelineImageInput`, *선택 사항*): IP Adapters와 함께 사용할 선택적 이미지 입력입니다.
ip_adapter_image_embeds (`list[torch.Tensor]`, *선택*) : IP-Adapter를 위한 사전 생성된 이미지 임베딩입니다. IP-Adapter의 수와 동일한 길이의 리스트여야 합니다. 각 요소는 `(batch_size, num_images, emb_dim)` 형태의 텐서여야 합니다. `do_classifier_free_guidance`가 `True`로 설정된 경우, 음의 이미지 임베딩을 포함해야 합니다. 제공되지 않으면 `ip_adapter_image` 입력 인자로부터 임베딩이 계산됩니다.
output_type (`str`, *선택 사항*, 기본값 `"pil"`) : 생성된 비디오의 출력 형식입니다. `torch.Tensor`, `PIL.Image` 또는 `np.array` 중 하나를 선택합니다.
return_dict (`bool`, *선택 사항*, 기본값 `True`) : 일반 튜플 대신 `AnimateDiffPipelineOutput`을 반환할지 여부.
cross_attention_kwargs (`dict`, *선택 사항*) : 지정된 경우 [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py)에서 정의된 `AttentionProcessor`로 전달되는 kwargs 사전입니다.
clip_skip (`int`, *선택 사항*) : 프롬프트 임베딩을 계산할 때 CLIP에서 건너뛸 레이어 수. 값이 1이면 최종 레이어 바로 이전 레이어의 출력을 프롬프트 임베딩 계산에 사용합니다.
callback_on_step_end (`Callable`, *선택 사항*) : 추론 중 각 디노이징 단계의 끝에서 호출되는 함수입니다. 이 함수는 다음 인수를 받아 호출됩니다: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs`에는 `callback_on_step_end_tensor_inputs`로 지정된 모든 텐서 목록이 포함됩니다.
callback_on_step_end_tensor_inputs (`list`, *선택 사항*) : `callback_on_step_end` 함수의 텐서 입력 목록입니다. 목록에 지정된 텐서는 `callback_kwargs` 인수로 전달됩니다. 파이프라인 클래스의 `._callback_tensor_inputs` 속성에 나열된 변수만 포함할 수 있습니다.
decode_chunk_size (`int`, 기본값 `16`) : `decode_latents` 메서드를 호출할 때 한 번에 디코딩할 프레임 수입니다.
**반환값:** [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/main/ko/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) 또는 `tuple`
`return_dict`가 `True`인 경우 [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/main/ko/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput)가 반환되고, 그렇지 않으면 첫 번째 요소가 생성된 프레임 목록인 `tuple`이 반환됩니다.
생성을 위한 pipeline의 호출 함수.
예:
#### encode_prompt[[diffusers.AnimateDiffVideoToVideoPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L256)
**매개변수:**
prompt (`str` 또는 `list[str]`, *선택 사항*) : 인코딩할 프롬프트
device : (`torch.device`): torch 디바이스
num_images_per_prompt (`int`) : 프롬프트당 생성할 이미지 수
do_classifier_free_guidance (`bool`) : classifier free guidance를 사용할지 여부
negative_prompt (`str` 또는 `list[str]`, *선택 사항*) : 이미지 생성을 안내하지 않을 프롬프트입니다. 정의되지 않은 경우 대신 `negative_prompt_embeds`를 전달해야 합니다. 가이던스를 사용하지 않는 경우 무시됩니다(즉, `guidance_scale`이 `1`보다 작은 경우 무시됩니다).
prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 텍스트 임베딩입니다. *예를 들어* 프롬프트 가중치와 같은 텍스트 입력을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `prompt` 입력 인자에서 텍스트 임베딩이 생성됩니다.
negative_prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 부정 텍스트 임베딩입니다. 텍스트 입력을 쉽게 조정하는 데 사용할 수 있으며, *예를 들어* 프롬프트 가중치 설정에 활용할 수 있습니다. 제공되지 않으면 `negative_prompt` 입력 인수에서 negative_prompt_embeds가 생성됩니다.
lora_scale (`float`, *선택 사항*) : LoRA 레이어가 로드된 경우 텍스트 인코더의 모든 LoRA 레이어에 적용될 LoRA 스케일입니다.
clip_skip (`int`, *선택 사항*) : 프롬프트 임베딩을 계산할 때 CLIP에서 건너뛸 레이어 수. 값이 1이면 최종 레이어 바로 이전 레이어의 출력을 프롬프트 임베딩 계산에 사용합니다.
프롬프트를 텍스트 인코더의 히든 상태로 인코딩합니다.
## AnimateDiffVideoToVideoControlNetPipeline[[diffusers.AnimateDiffVideoToVideoControlNetPipeline]]
#### diffusers.AnimateDiffVideoToVideoControlNetPipeline[[diffusers.AnimateDiffVideoToVideoControlNetPipeline]]
```python
diffusers.AnimateDiffVideoToVideoControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: diffusers.models.controlnets.controlnet.ControlNetModel | list[diffusers.models.controlnets.controlnet.ControlNetModel] | tuple[diffusers.models.controlnets.controlnet.ControlNetModel] | diffusers.models.controlnets.multicontrolnet.MultiControlNetModel, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L199)
**매개변수:**
vae ([AutoencoderKL](/docs/diffusers/main/ko/api/models/autoencoderkl#diffusers.AutoencoderKL)) : 이미지를 잠재 표현으로 인코딩하고 잠재 표현에서 이미지로 디코딩하는 Variational Auto-Encoder (VAE) 모델입니다.
text_encoder (`CLIPTextModel`) : 고정된 텍스트 인코더 ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : 텍스트를 토큰화하기 위한 [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer)입니다.
unet ([UNet2DConditionModel](/docs/diffusers/main/ko/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : 인코딩된 비디오 latents의 노이즈를 제거하기 위해 UNetMotionModel을 생성하는 데 사용되는 [UNet2DConditionModel](/docs/diffusers/main/ko/api/models/unet2d-cond#diffusers.UNet2DConditionModel)입니다.
motion_adapter (`MotionAdapter`) : `unet`와 함께 사용되어 인코딩된 비디오 latents의 노이즈를 제거하는 `MotionAdapter`입니다.
controlnet ([ControlNetModel](/docs/diffusers/main/ko/api/models/controlnet#diffusers.ControlNetModel) 또는 `list[ControlNetModel]` 또는 `tuple[ControlNetModel]` 또는 `MultiControlNetModel`) : 노이즈 제거 과정에서 `unet`에 추가 조건을 제공합니다. 여러 ControlNet을 리스트로 설정하면 각 ControlNet의 출력을 합산하여 하나의 통합된 추가 조건을 생성합니다.
scheduler ([SchedulerMixin](/docs/diffusers/main/ko/api/schedulers/overview#diffusers.SchedulerMixin)) : `unet`와 함께 사용되어 인코딩된 이미지 latents의 노이즈를 제거하는 스케줄러입니다. [DDIMScheduler](/docs/diffusers/main/ko/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/ko/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler), 또는 [PNDMScheduler](/docs/diffusers/main/ko/api/schedulers/pndm#diffusers.PNDMScheduler) 중 하나일 수 있습니다.
ControlNet 가이던스를 활용한 비디오-투-비디오 생성을 위한 Pipeline입니다.
이 모델은 [DiffusionPipeline](/docs/diffusers/main/ko/api/pipelines/overview#diffusers.DiffusionPipeline)에서 상속됩니다. 모든 파이프라인에 대해 구현된 일반적 메서드(다운로드, 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
파이프라인은 다음 로딩 메서드도 상속합니다:
- 텍스트 인버전 임베딩을 로드하는 [load_textual_inversion()](/docs/diffusers/main/ko/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion)
- LoRA 가중치를 로드하는 [load_lora_weights()](/docs/diffusers/main/ko/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights)
- LoRA 가중치를 저장하는 [save_lora_weights()](/docs/diffusers/main/ko/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights)
- IP Adapter를 로드하기 위한 [load_ip_adapter()](/docs/diffusers/main/ko/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter)
#### __호출__[[diffusers.AnimateDiffVideoToVideoControlNetPipeline.__call__]]
```python
__call__(video: list = None, prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, enforce_inference_steps: bool = False, timesteps: list[int] | None = None, sigmas: list[float] | None = None, guidance_scale: float = 7.5, strength: float = 0.8, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, guess_mode: bool = False, control_guidance_start: float | list[float] = 0.0, control_guidance_end: float | list[float] = 1.0, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'], decode_chunk_size: int = 16)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L909)
**매개변수:**
video (`list[PipelineImageInput]`) : 생성을 조건으로 사용할 입력 비디오. 비디오의 이미지/프레임 목록이어야 합니다.
prompt (`str` 또는 `list[str]`, *선택 사항*) : 이미지 생성을 안내할 프롬프트입니다. 정의되지 않은 경우 `prompt_embeds`를 전달해야 합니다.
height (`int`, *선택 사항*, 기본값은 `self.unet.config.sample_size * self.vae_scale_factor`) : 생성된 비디오의 픽셀 단위 높이.
width (`int`, *선택 사항*, 기본값은 `self.unet.config.sample_size * self.vae_scale_factor`) : 생성된 비디오의 픽셀 단위 너비입니다.
num_inference_steps (`int`, *선택 사항*, 기본값 50) : 디노이징 단계의 수입니다. 디노이징 단계를 늘리면 일반적으로 더 높은 품질의 비디오를 얻을 수 있지만, 추론 속도가 느려집니다.
enforce_inference_steps (`bool`, *선택 사항*, 기본값 `False`) : `strength` 매개변수에 관계없이 `num_inference_steps` 디노이징 단계를 강제할지 여부입니다. `False`인 경우, `strength`에 따라 실제 추론 단계 수가 줄어듭니다.
timesteps (`list[int]`, *선택 사항*) : `set_timesteps` 메서드에 `timesteps` 인수를 지원하는 스케줄러의 노이즈 제거 과정에 사용할 커스텀 타임스텝입니다. 정의되지 않은 경우, `num_inference_steps`가 전달될 때의 기본 동작이 사용됩니다. 내림차순으로 정렬되어 있어야 합니다.
sigmas (`list[float]`, *선택 사항*) : `set_timesteps` 메서드에 `sigmas` 인수를 지원하는 스케줄러의 노이즈 제거 과정에 사용할 커스텀 시그마입니다. 정의되지 않은 경우, `num_inference_steps`가 전달될 때의 기본 동작이 사용됩니다.
strength (`float`, *선택 사항*, 기본값 0.8) : 값이 높을수록 원본 비디오와 생성된 비디오 간의 차이가 커집니다.
guidance_scale (`float`, *선택 사항*, 기본값 7.5) : guidance scale 값이 높을수록 모델은 이미지 품질이 낮아지는 대신 텍스트 `prompt`와 밀접하게 연결된 이미지를 생성하도록 유도됩니다. `guidance_scale > 1`일 때 guidance scale이 활성화됩니다.
negative_prompt (`str` 또는 `list[str]`, *선택*) : 이미지 생성에서 포함하지 않을 내용을 안내하는 프롬프트입니다. 정의되지 않은 경우 대신 `negative_prompt_embeds`를 전달해야 합니다. 가이던스를 사용하지 않을 때(`guidance_scale < 1`)에는 무시됩니다.
num_videos_per_prompt (`int`, *선택 사항*, 기본값 1) : 프롬프트당 생성할 비디오의 수입니다.
eta (`float`, *선택 사항*, 기본값 0.0) : [DDIM](https://huggingface.co/papers/2010.02502) 논문에서 정의한 파라미터 eta (η)에 해당합니다. [DDIMScheduler](/docs/diffusers/main/ko/api/schedulers/ddim#diffusers.DDIMScheduler)에만 적용되며, 다른 스케줄러에서는 무시됩니다.
generator (`torch.Generator` 또는 `list[torch.Generator]`, *선택 사항*) : 생성을 결정적으로 만들기 위한 [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html)입니다.
latents (`torch.Tensor`, *선택 사항*) : 가우시안 분포에서 샘플링된 사전 생성된 노이즈된 latents로, 비디오 생성의 입력으로 사용됩니다. 동일한 생성을 다른 프롬프트로 조정하는 데 사용할 수 있습니다. 제공되지 않으면, 제공된 랜덤 `generator`를 사용하여 샘플링하여 latents 텐서를 생성합니다. Latents의 shape은 `(batch_size, num_channel, num_frames, height, width)`여야 합니다.
prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 텍스트 임베딩입니다. 텍스트 입력(프롬프트 가중치)을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `prompt` 입력 인자에서 텍스트 임베딩이 생성됩니다.
negative_prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 부정 텍스트 임베딩입니다. 텍스트 입력(프롬프트 가중치)을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `negative_prompt` 입력 인수에서 `negative_prompt_embeds`가 생성됩니다.
ip_adapter_image : (`PipelineImageInput`, *선택 사항*): IP Adapters와 함께 사용할 선택적 이미지 입력입니다.
ip_adapter_image_embeds (`list[torch.Tensor]`, *선택*) : IP-Adapter를 위한 사전 생성된 이미지 임베딩입니다. IP-Adapter의 수와 동일한 길이의 리스트여야 합니다. 각 요소는 `(batch_size, num_images, emb_dim)` 형태의 텐서여야 합니다. `do_classifier_free_guidance`가 `True`로 설정된 경우, 음의 이미지 임베딩을 포함해야 합니다. 제공되지 않으면 `ip_adapter_image` 입력 인자로부터 임베딩이 계산됩니다.
conditioning_frames (`list[PipelineImageInput]`, *선택*) : 생성을 위해 `unet`에 가이드를 제공하기 위한 ControlNet 입력 조건입니다. 여러 ControlNet이 지정된 경우, 각 ControlNet에 대한 입력이 올바르게 배치되도록 각 요소가 하나의 ControlNet에 전달될 수 있도록 이미지 목록을 전달해야 합니다.
output_type (`str`, *선택 사항*, 기본값 `"pil"`) : 생성된 비디오의 출력 형식입니다. `torch.Tensor`, `PIL.Image` 또는 `np.array` 중 하나를 선택합니다.
return_dict (`bool`, *선택 사항*, 기본값 `True`) : 일반 튜플 대신 `AnimateDiffPipelineOutput`을 반환할지 여부.
cross_attention_kwargs (`dict`, *선택 사항*) : 지정된 경우 [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py)에서 정의된 `AttentionProcessor`로 전달되는 kwargs 사전입니다.
controlnet_conditioning_scale (`float` 또는 `list[float]`, *선택 사항*, 기본값 1.0) : ControlNet의 출력은 원래 `unet`의 잔차에 더해지기 전에 `controlnet_conditioning_scale`과 곱해집니다. `init`에 여러 ControlNet이 지정된 경우, 해당 스케일을 리스트로 설정할 수 있습니다.
guess_mode (`bool`, *선택 사항*, 기본값 `False`) : 프롬프트를 모두 제거하더라도 ControlNet 인코더는 입력 이미지의 내용을 인식하려고 시도합니다. `guidance_scale` 값은 3.0에서 5.0 사이를 권장합니다.
control_guidance_start (`float` 또는 `list[float]`, *선택 사항*, 기본값 0.0) : ControlNet이 적용을 시작하는 전체 스텝의 비율입니다.
control_guidance_end (`float` 또는 `list[float]`, *선택 사항*, 기본값 1.0) : ControlNet이 적용을 중단하는 전체 스텝의 비율입니다.
clip_skip (`int`, *선택 사항*) : 프롬프트 임베딩을 계산할 때 CLIP에서 건너뛸 레이어 수. 값이 1이면 최종 레이어 바로 이전 레이어의 출력을 프롬프트 임베딩 계산에 사용합니다.
callback_on_step_end (`Callable`, *선택 사항*) : 추론 중 각 디노이징 단계의 끝에서 호출되는 함수입니다. 이 함수는 다음 인수를 받아 호출됩니다: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs`에는 `callback_on_step_end_tensor_inputs`로 지정된 모든 텐서 목록이 포함됩니다.
callback_on_step_end_tensor_inputs (`list`, *선택 사항*) : `callback_on_step_end` 함수의 텐서 입력 목록입니다. 목록에 지정된 텐서는 `callback_kwargs` 인수로 전달됩니다. 파이프라인 클래스의 `._callback_tensor_inputs` 속성에 나열된 변수만 포함할 수 있습니다.
decode_chunk_size (`int`, 기본값 `16`) : `decode_latents` 메서드를 호출할 때 한 번에 디코딩할 프레임 수입니다.
**반환값:** [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/main/ko/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) 또는 `tuple`
`return_dict`가 `True`인 경우 [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/main/ko/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput)가 반환되고, 그렇지 않으면 첫 번째 요소가 생성된 프레임 목록인 `tuple`이 반환됩니다.
생성을 위한 pipeline의 호출 함수.
예:
#### encode_prompt[[diffusers.AnimateDiffVideoToVideoControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L287)
**매개변수:**
prompt (`str` 또는 `list[str]`, *선택 사항*) : 인코딩할 프롬프트
device : (`torch.device`): torch 디바이스
num_images_per_prompt (`int`) : 프롬프트당 생성할 이미지 수
do_classifier_free_guidance (`bool`) : classifier free guidance를 사용할지 여부
negative_prompt (`str` 또는 `list[str]`, *선택 사항*) : 이미지 생성을 안내하지 않을 프롬프트입니다. 정의되지 않은 경우 대신 `negative_prompt_embeds`를 전달해야 합니다. 가이던스를 사용하지 않는 경우 무시됩니다(즉, `guidance_scale`이 `1`보다 작은 경우 무시됩니다).
prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 텍스트 임베딩입니다. *예를 들어* 프롬프트 가중치와 같은 텍스트 입력을 쉽게 조정하는 데 사용할 수 있습니다. 제공되지 않으면 `prompt` 입력 인자에서 텍스트 임베딩이 생성됩니다.
negative_prompt_embeds (`torch.Tensor`, *선택 사항*) : 미리 생성된 부정 텍스트 임베딩입니다. 텍스트 입력을 쉽게 조정하는 데 사용할 수 있으며, *예를 들어* 프롬프트 가중치 설정에 활용할 수 있습니다. 제공되지 않으면 `negative_prompt` 입력 인수에서 negative_prompt_embeds가 생성됩니다.
lora_scale (`float`, *선택 사항*) : LoRA 레이어가 로드된 경우 텍스트 인코더의 모든 LoRA 레이어에 적용될 LoRA 스케일입니다.
clip_skip (`int`, *선택 사항*) : 프롬프트 임베딩을 계산할 때 CLIP에서 건너뛸 레이어 수. 값이 1이면 최종 레이어 바로 이전 레이어의 출력을 프롬프트 임베딩 계산에 사용합니다.
프롬프트를 텍스트 인코더의 히든 상태로 인코딩합니다.
## AnimateDiffPipelineOutput[[diffusers.pipelines.animatediff.AnimateDiffPipelineOutput]]
#### diffusers.pipelines.animatediff.AnimateDiffPipelineOutput[[diffusers.pipelines.animatediff.AnimateDiffPipelineOutput]]
```python
diffusers.pipelines.animatediff.AnimateDiffPipelineOutput(frames: typing.Union[torch.Tensor, numpy.ndarray, list[list[PIL.Image.Image]]])
```
[소스](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_output.py#L11)
**매개변수:**
frames (`torch.Tensor`, `np.ndarray`, or list[list[PIL.Image.Image]]) : list of video outputs - It can be a nested list of length `batch_size,` with each sub-list containing denoised
AnimateDiff 파이프라인의 출력 클래스입니다.
길이가 `num_frames.`인 PIL 이미지 시퀀스입니다. 또한 `(batch_size, num_frames, channels, height, width)` 모양의 NumPy 배열 또는 Torch 텐서일 수도 있습니다.