# Geração de Texto para Vídeo com AnimateDiff
## Visão geral
[AnimateDiff: Animate seus modelos personalizados de difusão de texto para imagem sem ajuste específico](https://huggingface.co/papers/2307.04725) por Yuwei Guo, Ceyuan Yang, Anyi Rao, Yaohui Wang, Yu Qiao, Dahua Lin, Bo Dai.
O resumo do artigo é o seguinte:
*Com o avanço dos modelos de texto para imagem (por exemplo, Stable Diffusion) e das técnicas de personalização correspondentes, como DreamBooth e LoRA, qualquer pessoa pode materializar sua imaginação em imagens de alta qualidade a um custo acessível. Em seguida, surge uma grande demanda por técnicas de animação de imagens para combinar ainda mais as imagens estáticas geradas com a dinâmica do movimento. Neste relatório, propomos um framework prático para animar, de uma vez por todas, a maioria dos modelos de texto para imagem personalizados existentes, economizando esforços no ajuste específico de cada modelo. O núcleo do framework proposto consiste em inserir um módulo de modelagem de movimento recém-inicializado no modelo de texto para imagem congelado e treiná-lo em clipes de vídeo para destilar priors de movimento razoáveis. Uma vez treinado, ao simplesmente injetar esse módulo de modelagem de movimento, todas as versões personalizadas derivadas do mesmo T2I base se tornam prontamente modelos guiados por texto que produzem imagens animadas diversas e personalizadas. Realizamos nossa avaliação em vários modelos públicos e representativos de texto para imagem personalizados, abrangendo imagens de anime e fotografias realistas, e demonstramos que nosso framework proposto ajuda esses modelos a gerar clipes de animação temporalmente suaves, preservando o domínio e a diversidade de suas saídas. O código e os pesos pré-treinados estarão publicamente disponíveis em [este URL https](https://animatediff.github.io/).*
## Pipelines Disponíveis
| Pipeline | Tarefas | Demonstração
|---|---|:---:|
| [AnimateDiffPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py) | *Geração de Texto para Vídeo com AnimateDiff* |
| [AnimateDiffControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py) | *Geração controlada de vídeo-para-vídeo com AnimateDiff usando ControlNet* |
| [AnimateDiffSparseControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py) | *Geração controlada de vídeo-para-vídeo com AnimateDiff usando SparseCtrl* |
| [AnimateDiffSDXLPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py) | *Geração de Vídeo para Vídeo com AnimateDiff* |
| [AnimateDiffVideoToVideoPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py) | *Geração de Vídeo para Vídeo com AnimateDiff* |
| [AnimateDiffVideoToVideoControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py) | *Geração de vídeo para vídeo com AnimateDiff usando ControlNet* |
## Checkpoints disponíveis
Os checkpoints do Motion Adapter podem ser encontrados em [guoyww](https://huggingface.co/guoyww/). Esses checkpoints foram projetados para funcionar com qualquer modelo baseado no Stable Diffusion 1.4/1.5.
## Exemplo de uso
### AnimateDiffPipeline
O AnimateDiff funciona com um checkpoint de MotionAdapter e um checkpoint de modelo Stable Diffusion. O MotionAdapter é uma coleção de Motion Modules responsáveis por adicionar movimento coerente entre os quadros de imagem. Esses módulos são aplicados após os blocos Resnet e Attention no UNet do Stable Diffusion.
O exemplo a seguir demonstra como usar um checkpoint de *MotionAdapter* com o Diffusers para inferência com base no StableDiffusion-1.4/1.5.
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
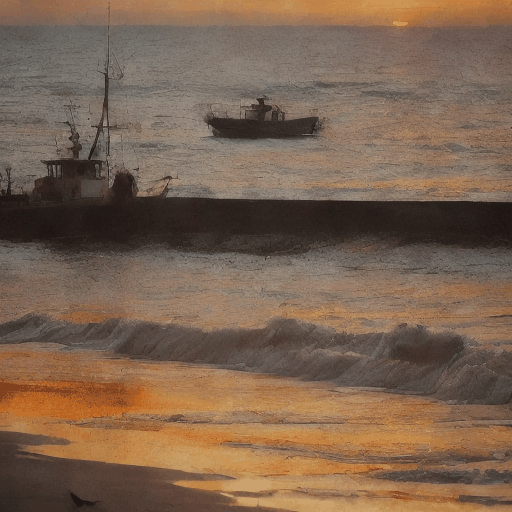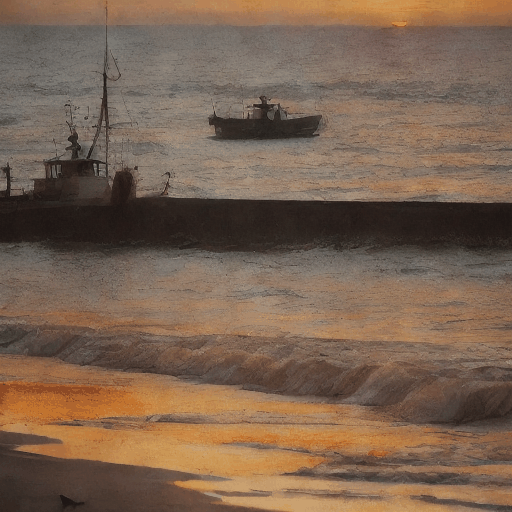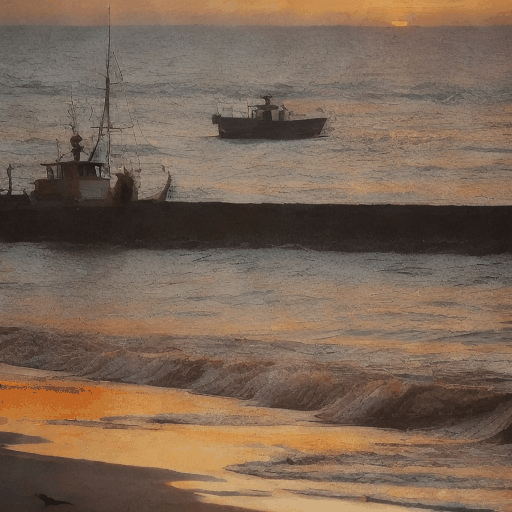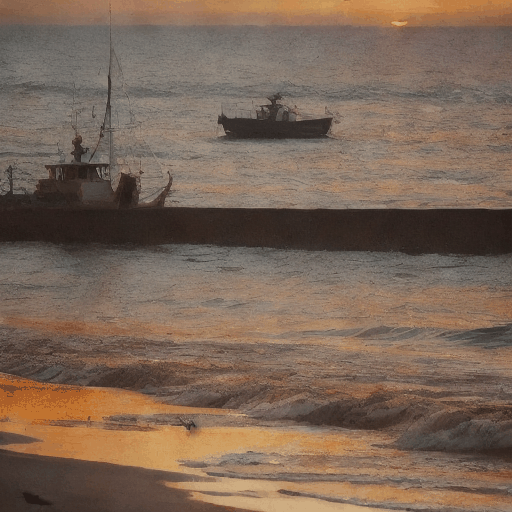
Aqui estão alguns exemplos de saída:
masterpiece, bestquality, sunset.
 > [!TIP]
> O AnimateDiff tende a funcionar melhor com modelos Stable Diffusion finetunados. Se você planeja usar um scheduler que pode clipar amostras, certifique-se de desativá-lo definindo `clip_sample=False` no scheduler, pois isso também pode ter um efeito adverso nas amostras geradas. Além disso, os checkpoints do AnimateDiff podem ser sensíveis ao beta schedule do scheduler. Recomendamos definir isso como `linear`.
### AnimateDiffControlNetPipeline
O AnimateDiff também pode ser usado com ControlNets. O ControlNet foi introduzido em [Adding Conditional Control to Text-to-Image Diffusion Models](https://huggingface.co/papers/2302.05543) por Lvmin Zhang, Anyi Rao e Maneesh Agrawala. Com um modelo ControlNet, você pode fornecer uma imagem de controle adicional para condicionar e controlar a geração do Stable Diffusion. Por exemplo, se você fornecer mapas de profundidade, o modelo ControlNet gera um vídeo que preservará as informações espaciais dos mapas de profundidade. É uma maneira mais flexível e precisa de controlar o processo de geração de vídeo.
```python
import torch
from diffusers import AnimateDiffControlNetPipeline, AutoencoderKL, ControlNetModel, MotionAdapter, LCMScheduler
from diffusers.utils import export_to_gif, load_video
# Additionally, you will need a preprocess videos before they can be used with the ControlNet
# HF maintains just the right package for it: `pip install controlnet_aux`
from controlnet_aux.processor import ZoeDetector
# Download controlnets from https://huggingface.co/lllyasviel/ControlNet-v1-1 to use .from_single_file
# Download Diffusers-format controlnets, such as https://huggingface.co/lllyasviel/sd-controlnet-depth, to use .from_pretrained()
controlnet = ControlNetModel.from_single_file("control_v11f1p_sd15_depth.pth", dtype=torch.float16)
# We use AnimateLCM for this example but one can use the original motion adapters as well (for example, https://huggingface.co/guoyww/animatediff-motion-adapter-v1-5-3)
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=torch.float16)
pipe: AnimateDiffControlNetPipeline = AnimateDiffControlNetPipeline.from_pretrained(
"SG161222/Realistic_Vision_V5.1_noVAE",
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
).to(device="cuda", dtype=torch.float16) # or "mps", "xpu", "cpu"
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm-lora")
pipe.set_adapters(["lcm-lora"], [0.8])
depth_detector = ZoeDetector.from_pretrained("lllyasviel/Annotators").to("cuda")
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-vid2vid-input-1.gif")
conditioning_frames = []
with pipe.progress_bar(total=len(video)) as progress_bar:
for frame in video:
conditioning_frames.append(depth_detector(frame))
progress_bar.update()
prompt = "a panda, playing a guitar, sitting in a pink boat, in the ocean, mountains in background, realistic, high quality"
negative_prompt = "bad quality, worst quality"
video = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_frames=len(video),
num_inference_steps=10,
guidance_scale=2.0,
conditioning_frames=conditioning_frames,
generator=torch.Generator().manual_seed(42),
).frames[0]
export_to_gif(video, "animatediff_controlnet.gif", fps=8)
```
Aqui estão alguns exemplos de saída:
Vídeo de Origem Vídeo de Saída
guaxinim tocando violão
um panda, tocando violão, sentado em um barco rosa, no oceano, montanhas ao fundo, realista, alta qualidade
### AnimateDiffSparseControlNetPipeline
[SparseCtrl: Adding Sparse Controls to Text-to-Video Diffusion Models](https://huggingface.co/papers/2311.16933) para alcançar geração controlada em modelos de difusão de texto para vídeo, por Yuwei Guo, Ceyuan Yang, Anyi Rao, Maneesh Agrawala, Dahua Lin e Bo Dai.
O resumo do artigo é:
*O desenvolvimento de text-to-video (T2V), ou seja, a geração de vídeos a partir de um prompt de texto, avançou significativamente nos últimos anos. No entanto, a dependência exclusiva de prompts de texto frequentemente resulta em composição de quadros ambígua devido à incerteza espacial. A comunidade de pesquisa, portanto, utiliza sinais de estrutura densos, por exemplo, sequências de profundidade/bordas por quadro, para aprimorar a controlabilidade, cuja coleta aumenta correspondentemente a carga de inferência. Neste trabalho, apresentamos o SparseCtrl para permitir controle de estrutura flexível com sinais temporalmente esparsos, exigindo apenas uma ou poucas entradas, conforme mostrado na Figura 1. Ele incorpora um codificador de condição adicional para processar esses sinais esparsos, mantendo o modelo T2V pré-treinado intacto. A abordagem proposta é compatível com várias modalidades, incluindo esboços, mapas de profundidade e imagens RGB, fornecendo controle mais prático para a geração de vídeos e promovendo aplicações como storyboarding, renderização de profundidade, animação de quadros-chave e interpolação. Experimentos extensos demonstram a generalização do SparseCtrl em geradores T2V originais e personalizados. Os códigos e modelos estarão publicamente disponíveis em [this https URL](https://guoyww.github.io/projects/SparseCtrl).*
SparseCtrl introduz os seguintes checkpoints para geração controlada de texto para vídeo:
- [SparseCtrl Scribble](https://huggingface.co/guoyww/animatediff-sparsectrl-scribble)
- [SparseCtrl RGB](https://huggingface.co/guoyww/animatediff-sparsectrl-rgb)
#### Usando SparseCtrl Scribble
```python
import torch
from diffusers import AnimateDiffSparseControlNetPipeline
from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
from diffusers.schedulers import DPMSolverMultistepScheduler
from diffusers.utils import export_to_gif, load_image
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
controlnet_id = "guoyww/animatediff-sparsectrl-scribble"
lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
vae_id = "stabilityai/sd-vae-ft-mse"
device = "cuda" # or "mps", "xpu", "cpu"
motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, dtype=torch.float16).to(device)
controlnet = SparseControlNetModel.from_pretrained(controlnet_id, dtype=torch.float16).to(device)
vae = AutoencoderKL.from_pretrained(vae_id, dtype=torch.float16).to(device)
scheduler = DPMSolverMultistepScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
algorithm_type="dpmsolver++",
use_karras_sigmas=True,
)
pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
model_id,
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
scheduler=scheduler,
dtype=torch.float16,
).to(device)
pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
pipe.fuse_lora(lora_scale=1.0)
prompt = "an aerial view of a cyberpunk city, night time, neon lights, masterpiece, high quality"
negative_prompt = "low quality, worst quality, letterboxed"
image_files = [
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-1.png",
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-2.png",
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-3.png"
]
condition_frame_indices = [0, 8, 15]
conditioning_frames = [load_image(img_file) for img_file in image_files]
video = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_inference_steps=25,
conditioning_frames=conditioning_frames,
controlnet_conditioning_scale=1.0,
controlnet_frame_indices=condition_frame_indices,
generator=torch.Generator().manual_seed(1337),
).frames[0]
export_to_gif(video, "output.gif")
```
Aqui estão alguns exemplos de saída:
uma vista aérea de uma cidade cyberpunk, à noite, luzes de neon, obra-prima, alta qualidade
#### Usando SparseCtrl RGB
```python
import torch
from diffusers import AnimateDiffSparseControlNetPipeline
from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
from diffusers.schedulers import DPMSolverMultistepScheduler
from diffusers.utils import export_to_gif, load_image
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
controlnet_id = "guoyww/animatediff-sparsectrl-rgb"
lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
vae_id = "stabilityai/sd-vae-ft-mse"
device = "cuda" # or "mps", "xpu", "cpu"
motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, dtype=torch.float16).to(device)
controlnet = SparseControlNetModel.from_pretrained(controlnet_id, dtype=torch.float16).to(device)
vae = AutoencoderKL.from_pretrained(vae_id, dtype=torch.float16).to(device)
scheduler = DPMSolverMultistepScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
algorithm_type="dpmsolver++",
use_karras_sigmas=True,
)
pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
model_id,
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
scheduler=scheduler,
dtype=torch.float16,
).to(device)
pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-firework.png")
video = pipe(
prompt="closeup face photo of man in black clothes, night city street, bokeh, fireworks in background",
negative_prompt="low quality, worst quality",
num_inference_steps=25,
conditioning_frames=image,
controlnet_frame_indices=[0],
controlnet_conditioning_scale=1.0,
generator=torch.Generator().manual_seed(42),
).frames[0]
export_to_gif(video, "output.gif")
```
Aqui estão alguns exemplos de saída:
foto de close-up do rosto de um homem de roupas pretas, rua de cidade à noite, bokeh, fogos de artifício ao fundo
### AnimateDiffSDXLPipeline
O AnimateDiff também pode ser usado com modelos SDXL. Este é atualmente um recurso experimental, pois apenas uma versão beta do checkpoint do adaptador de movimento está disponível.
```python
import torch
from diffusers.models import MotionAdapter
from diffusers import AnimateDiffSDXLPipeline, DDIMScheduler
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-sdxl-beta", dtype=torch.float16)
model_id = "stabilityai/stable-diffusion-xl-base-1.0"
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe = AnimateDiffSDXLPipeline.from_pretrained(
model_id,
motion_adapter=adapter,
scheduler=scheduler,
dtype=torch.float16,
variant="fp16",
).to("cuda") # or "mps", "xpu", "cpu"
# enable memory savings
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()
output = pipe(
prompt="a panda surfing in the ocean, realistic, high quality",
negative_prompt="low quality, worst quality",
num_inference_steps=20,
guidance_scale=8,
width=1024,
height=1024,
num_frames=16,
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
### AnimateDiffVideoToVideoPipeline
O AnimateDiff também pode ser usado para gerar visualmente vídeos semelhantes ou permitir edições de estilo/personagem/fundo ou outras, a partir de um vídeo inicial, permitindo explorar possibilidades criativas de forma contínua.
```python
import imageio
import requests
import torch
from diffusers import AnimateDiffVideoToVideoPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
from io import BytesIO
from PIL import Image
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffVideoToVideoPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
# helper function to load videos
def load_video(file_path: str):
images = []
if file_path.startswith(('http://', 'https://')):
# If the file_path is a URL
response = requests.get(file_path)
response.raise_for_status()
content = BytesIO(response.content)
vid = imageio.get_reader(content)
else:
# Assuming it's a local file path
vid = imageio.get_reader(file_path)
for frame in vid:
pil_image = Image.fromarray(frame)
images.append(pil_image)
return images
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-vid2vid-input-1.gif")
output = pipe(
video = video,
prompt="panda playing a guitar, on a boat, in the ocean, high quality",
negative_prompt="bad quality, worse quality",
guidance_scale=7.5,
num_inference_steps=25,
strength=0.5,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
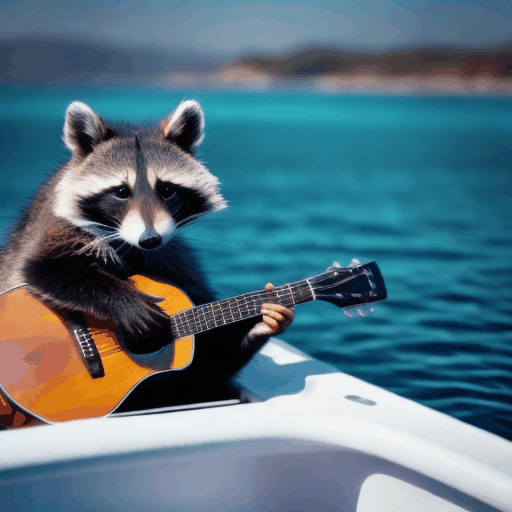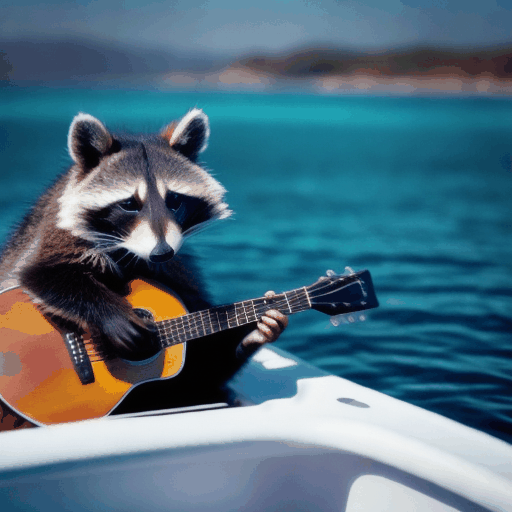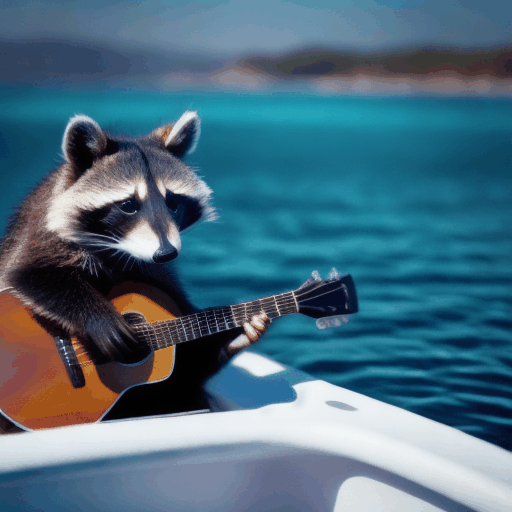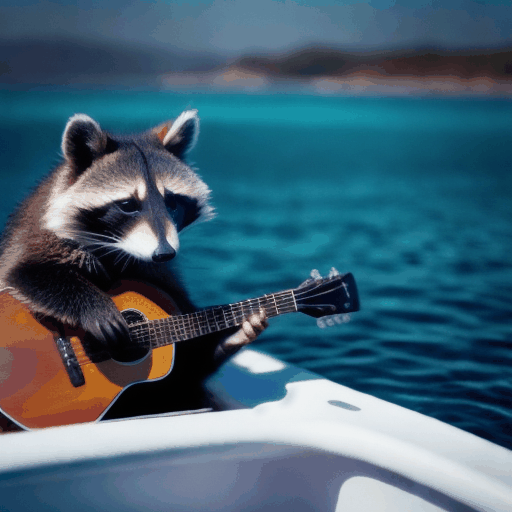
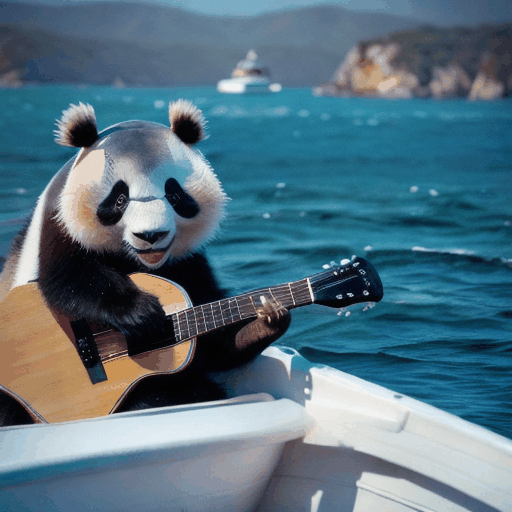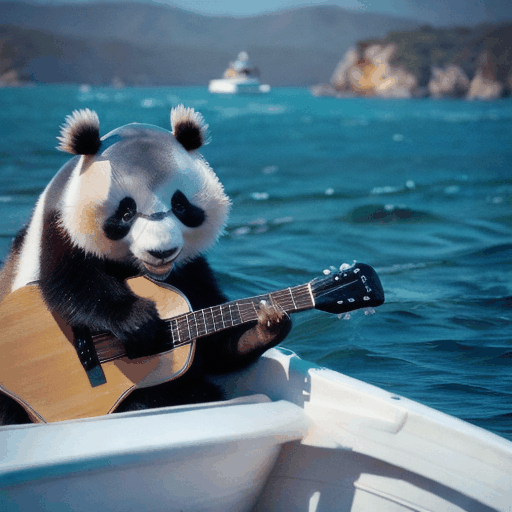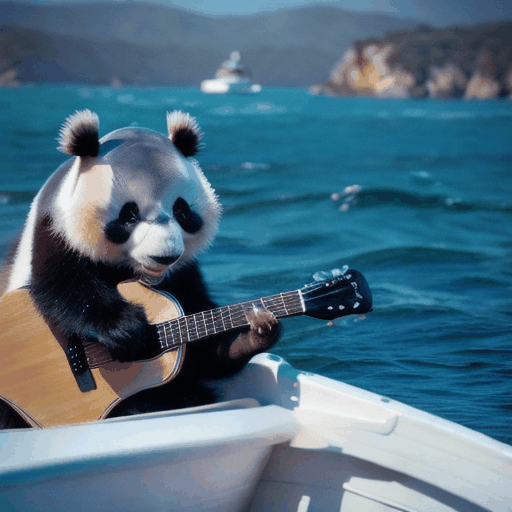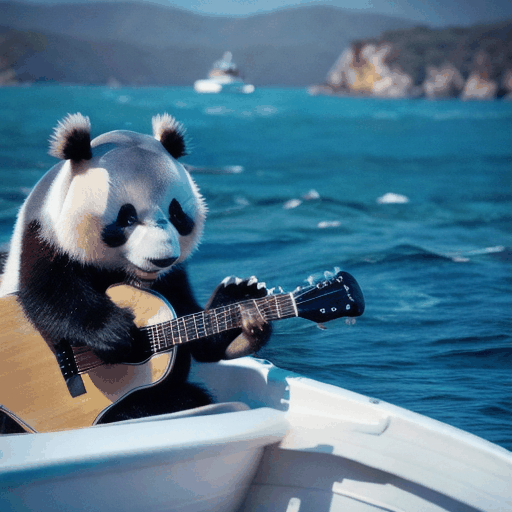
Aqui estão alguns exemplos de saída:
Vídeo de Origem Vídeo de Saída
guaxinim tocando violão
 panda tocando violão
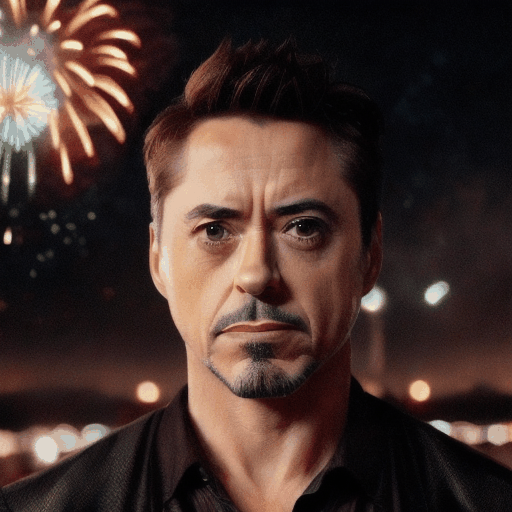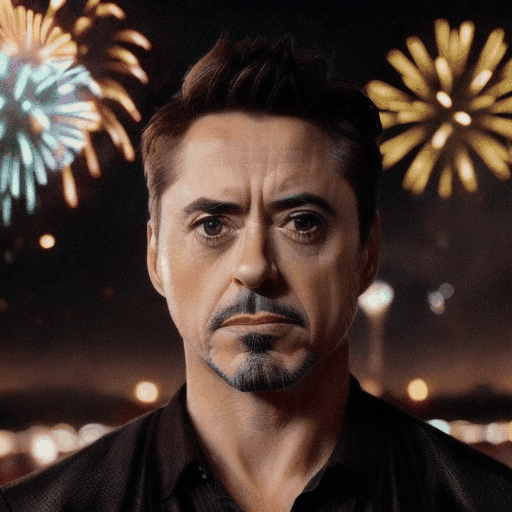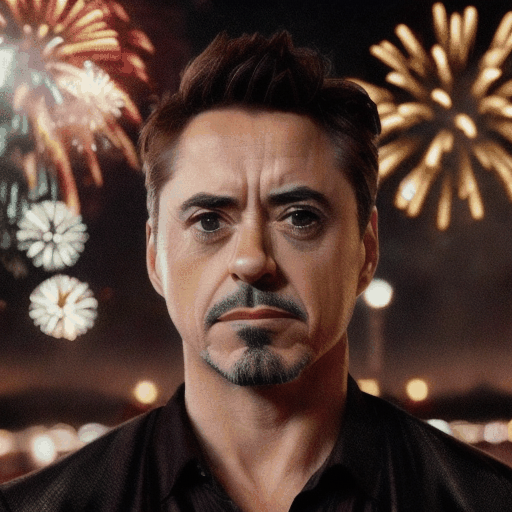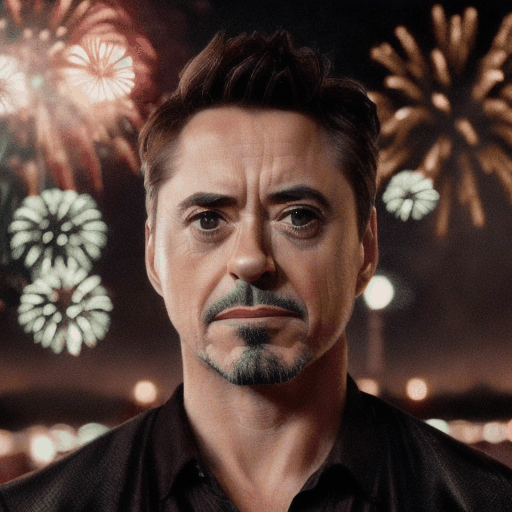
 closeup de margot robbie, fogos de artifício ao fundo, alta qualidade
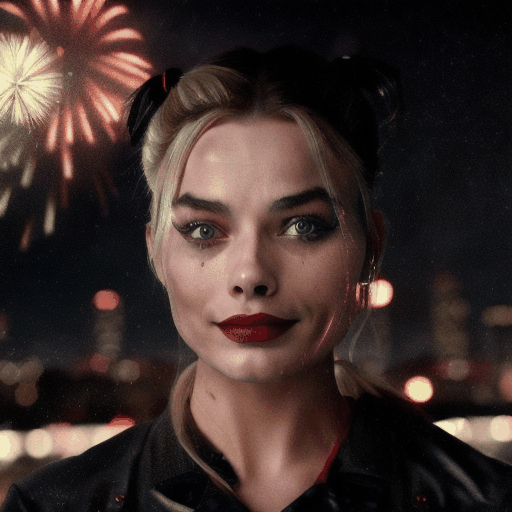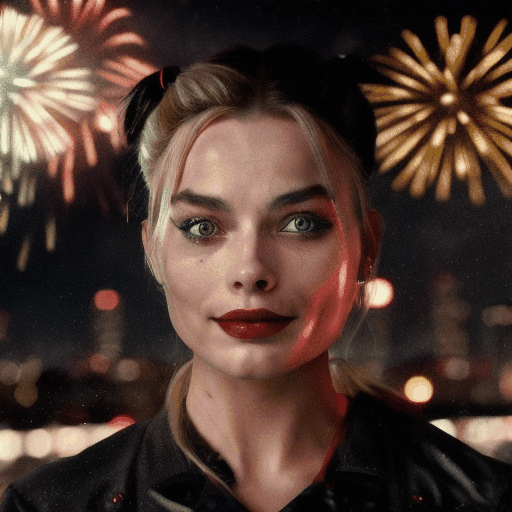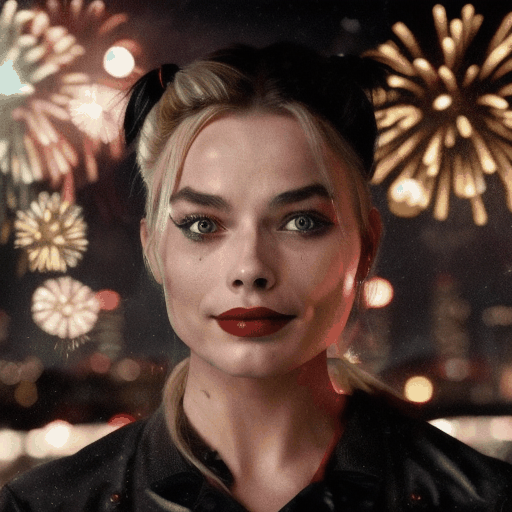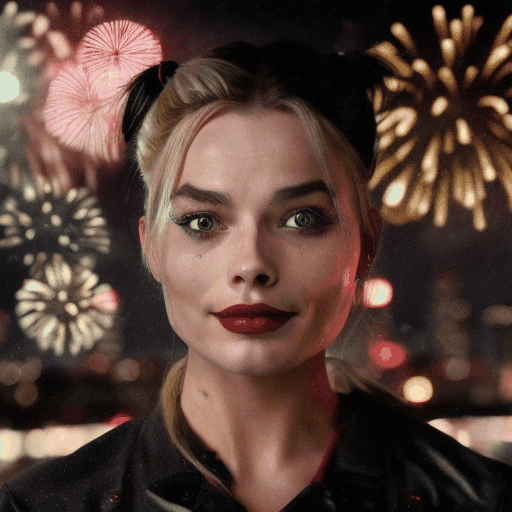 closeup de tony stark, robert downey jr, fogos de artifício
 ### AnimateDiffVideoToVideoControlNetPipeline
O AnimateDiff pode ser usado em conjunto com ControlNets para aprimorar a geração de vídeo-para-vídeo, permitindo um controle preciso sobre a saída. O ControlNet foi introduzido em [Adding Conditional Control to Text-to-Image Diffusion Models](https://huggingface.co/papers/2302.05543) por Lvmin Zhang, Anyi Rao e Maneesh Agrawala, e permite condicionar o Stable Diffusion com uma imagem de controle adicional para garantir que as informações espaciais sejam preservadas ao longo do vídeo.
Este pipeline permite condicionar sua geração tanto no vídeo original quanto em uma sequência de imagens de controle.
```python
import torch
from PIL import Image
from tqdm.auto import tqdm
from controlnet_aux.processor import OpenposeDetector
from diffusers import AnimateDiffVideoToVideoControlNetPipeline
from diffusers.utils import export_to_gif, load_video
from diffusers import AutoencoderKL, ControlNetModel, MotionAdapter, LCMScheduler
# Load the ControlNet
controlnet = ControlNetModel.from_pretrained("lllyasviel/sd-controlnet-openpose", dtype=torch.float16)
# Load the motion adapter
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
# Load SD 1.5 based finetuned model
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=torch.float16)
pipe = AnimateDiffVideoToVideoControlNetPipeline.from_pretrained(
"SG161222/Realistic_Vision_V5.1_noVAE",
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
).to(device="cuda", dtype=torch.float16) # or "mps", "xpu", "cpu"
# Enable LCM to speed up inference
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm-lora")
pipe.set_adapters(["lcm-lora"], [0.8])
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/dance.gif")
video = [frame.convert("RGB") for frame in video]
prompt = "astronaut in space, dancing"
negative_prompt = "bad quality, worst quality, jpeg artifacts, ugly"
# Create controlnet preprocessor
open_pose = OpenposeDetector.from_pretrained("lllyasviel/Annotators").to("cuda")
# Preprocess controlnet images
conditioning_frames = []
for frame in tqdm(video):
conditioning_frames.append(open_pose(frame))
strength = 0.8
with torch.inference_mode():
video = pipe(
video=video,
prompt=prompt,
negative_prompt=negative_prompt,
num_inference_steps=10,
guidance_scale=2.0,
controlnet_conditioning_scale=0.75,
conditioning_frames=conditioning_frames,
strength=strength,
generator=torch.Generator().manual_seed(42),
).frames[0]
video = [frame.resize(conditioning_frames[0].size) for frame in video]
export_to_gif(video, f"animatediff_vid2vid_controlnet.gif", fps=8)
```
Aqui estão alguns exemplos de saída:
Vídeo de Origem Vídeo de Saída
garota de anime, dançando
astronauta no espaço, dançando
**As luzes e a composição foram transferidas do Vídeo de Origem.**
## Usando Motion LoRAs
Motion LoRAs são uma coleção de LoRAs que funcionam com o checkpoint `guoyww/animatediff-motion-adapter-v1-5-2`. Esses LoRAs são responsáveis por adicionar tipos específicos de movimento às animações.
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
pipe.load_lora_weights(
"guoyww/animatediff-motion-lora-zoom-out", adapter_name="zoom-out"
)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
beta_schedule="linear",
timestep_spacing="linspace",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
masterpiece, bestquality, sunset.
 ## Usando Motion LoRAs com PEFT
Você também pode aproveitar o backend [PEFT](https://github.com/huggingface/peft) para combinar Motion LoRAs e criar animações mais complexas.
Primeiro, instale o PEFT com
```shell
pip install peft
```
Em seguida, você pode usar o código a seguir para combinar Motion LoRAs.
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
pipe.load_lora_weights(
"diffusers/animatediff-motion-lora-zoom-out", adapter_name="zoom-out",
)
pipe.load_lora_weights(
"diffusers/animatediff-motion-lora-pan-left", adapter_name="pan-left",
)
pipe.set_adapters(["zoom-out", "pan-left"], adapter_weights=[1.0, 1.0])
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
masterpiece, bestquality, sunset.
 ## Usando FreeInit
[FreeInit: Bridging Initialization Gap in Video Diffusion Models](https://huggingface.co/papers/2312.07537) de Tianxing Wu, Chenyang Si, Yuming Jiang, Ziqi Huang, Ziwei Liu.
FreeInit é um método eficaz que melhora a consistência temporal e a qualidade geral dos vídeos gerados usando video-diffusion-models, sem nenhum treinamento adicional. Ele pode ser aplicado de forma transparente em tempo de inferência a AnimateDiff, ModelScope, VideoCrafter e diversos outros modelos de geração de vídeo, e funciona refinando iterativamente o ruído de inicialização latente. Mais detalhes podem ser encontrados no paper.
O exemplo a seguir demonstra o uso do FreeInit.
```python
import torch
from diffusers import MotionAdapter, AnimateDiffPipeline, DDIMScheduler
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2")
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16).to("cuda") # or "mps", "xpu", "cpu"
pipe.scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
clip_sample=False,
timestep_spacing="linspace",
steps_offset=1
)
# enable memory savings
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()
# enable FreeInit
# Refer to the enable_free_init documentation for a full list of configurable parameters
pipe.enable_free_init(method="butterworth", use_fast_sampling=True)
# run inference
output = pipe(
prompt="a panda playing a guitar, on a boat, in the ocean, high quality",
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=20,
generator=torch.Generator("cpu").manual_seed(666),
)
# disable FreeInit
pipe.disable_free_init()
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
> [!WARNING]
> FreeInit não é realmente gratuito - a qualidade aprimorada vem ao custo de computação extra. É necessário amostrar algumas vezes extras, dependendo do parâmetro `num_iters` definido ao ativá-lo. Definir o parâmetro `use_fast_sampling` como `True` pode melhorar o desempenho geral (ao custo de uma qualidade inferior em comparação com `use_fast_sampling=False`, mas ainda assim com resultados melhores do que os modelos de geração de vídeo convencionais).
> [!TIP]
> Certifique-se de consultar o [guia](../../using-diffusers/schedulers) de Schedulers para aprender a explorar o compromisso entre a velocidade e a qualidade do scheduler, e veja a seção [reutilização de componentes entre pipelines](../../using-diffusers/loading#reusing-models-in-multiple-pipelines) para aprender a carregar eficientemente os mesmos componentes em vários pipelines.
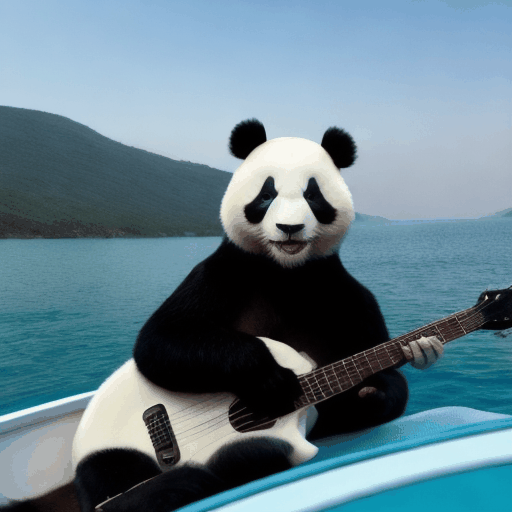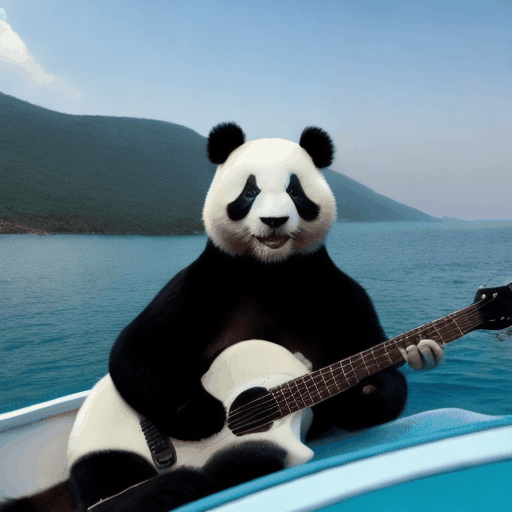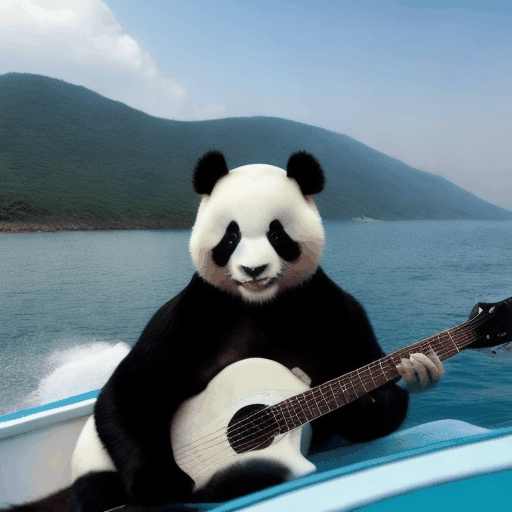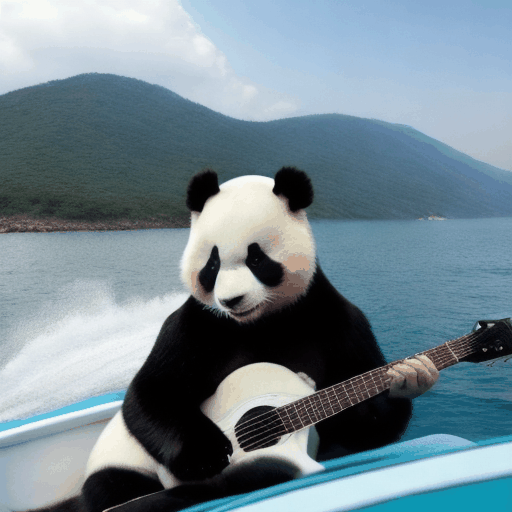
Sem o FreeInit ativado Com o FreeInit ativado
panda tocando violão
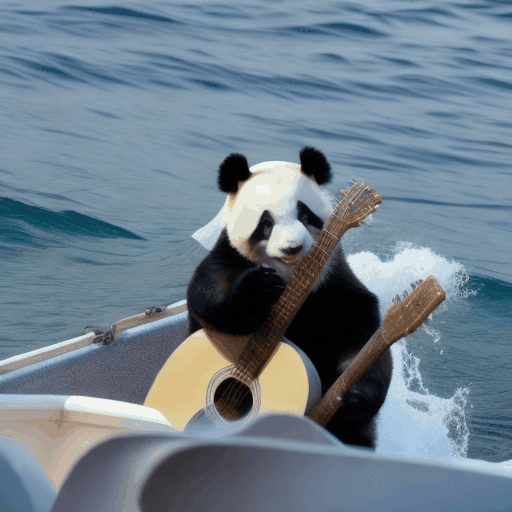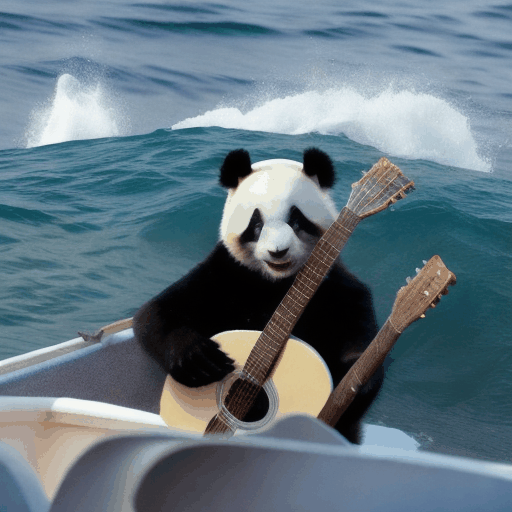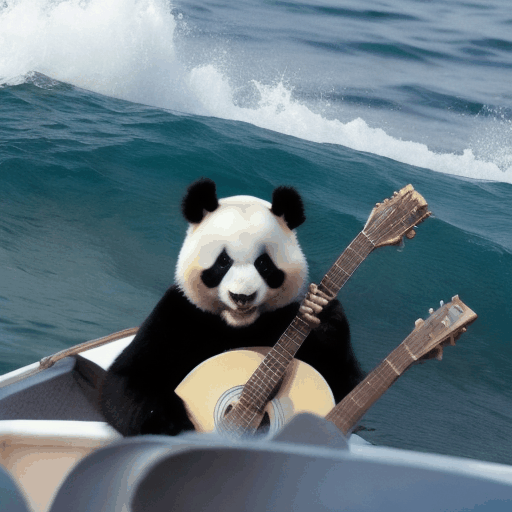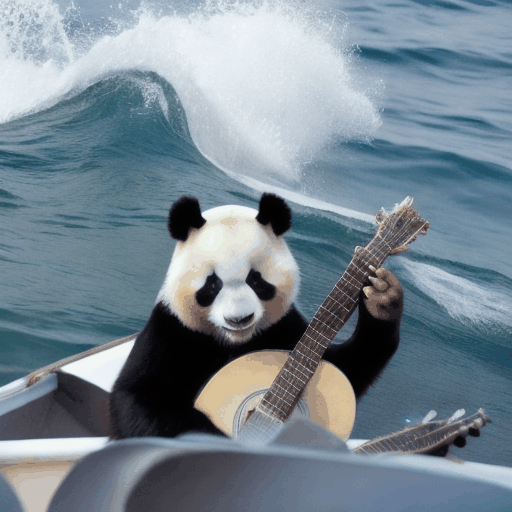 panda tocando violão
 ## Usando AnimateLCM
[AnimateLCM](https://animatelcm.github.io/) é um checkpoint de módulo de movimento e um LCM LoRA que foram criados usando uma estratégia de aprendizado de consistência que desacopla a destilação dos pré-requisitos de geração de imagem e dos pré-requisitos de geração de movimento.
```python
import torch
from diffusers import AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="sd15_lora_beta.safetensors", adapter_name="lcm-lora")
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt="A space rocket with trails of smoke behind it launching into space from the desert, 4k, high resolution",
negative_prompt="bad quality, worse quality, low resolution",
num_frames=16,
guidance_scale=1.5,
num_inference_steps=6,
generator=torch.Generator("cpu").manual_seed(0),
)
frames = output.frames[0]
export_to_gif(frames, "animatelcm.gif")
```
Um foguete espacial, 4K.
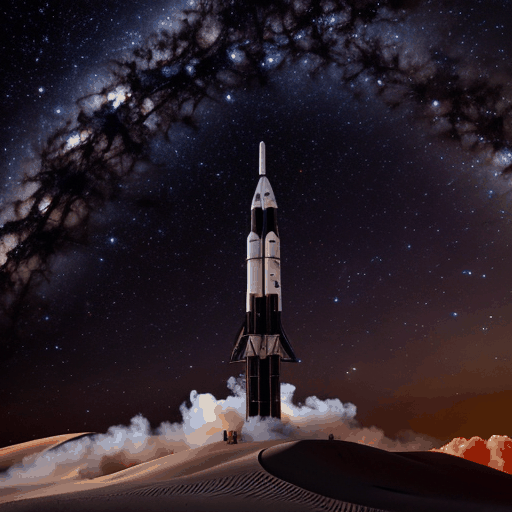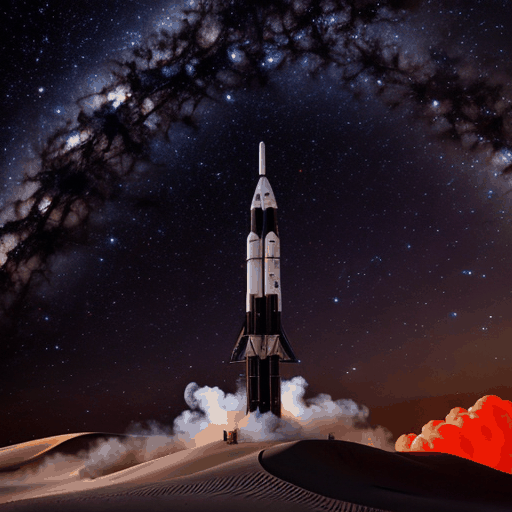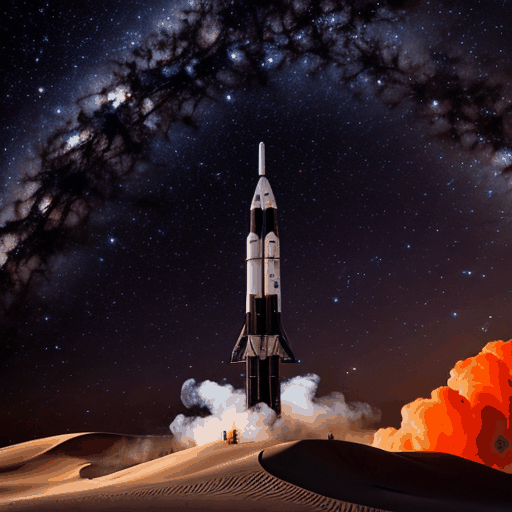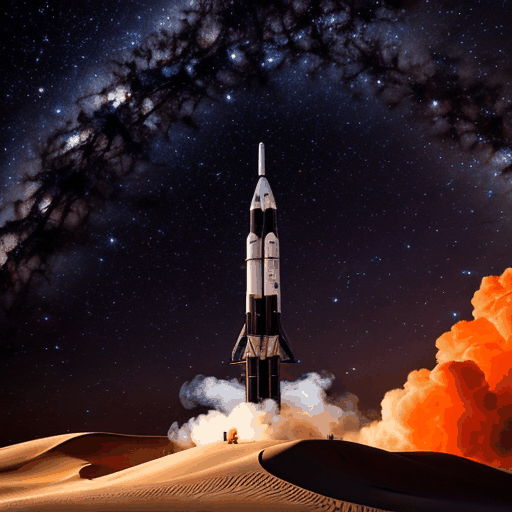 O AnimateLCM também é compatível com [Motion LoRAs](https://huggingface.co/collections/dn6/animatediff-motion-loras-654cb8ad732b9e3cf4d3c17e) existentes.
```python
import torch
from diffusers import AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="sd15_lora_beta.safetensors", adapter_name="lcm-lora")
pipe.load_lora_weights("guoyww/animatediff-motion-lora-tilt-up", adapter_name="tilt-up")
pipe.set_adapters(["lcm-lora", "tilt-up"], [1.0, 0.8])
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt="A space rocket with trails of smoke behind it launching into space from the desert, 4k, high resolution",
negative_prompt="bad quality, worse quality, low resolution",
num_frames=16,
guidance_scale=1.5,
num_inference_steps=6,
generator=torch.Generator("cpu").manual_seed(0),
)
frames = output.frames[0]
export_to_gif(frames, "animatelcm-motion-lora.gif")
```
Um foguete espacial, 4K.
 ## Usando FreeNoise
[FreeNoise: Tuning-Free Longer Video Diffusion via Noise Rescheduling](https://huggingface.co/papers/2310.15169) de Haonan Qiu, Menghan Xia, Yong Zhang, Yingqing He, Xintao Wang, Ying Shan, Ziwei Liu.
FreeNoise é um mecanismo de amostragem que pode gerar vídeos mais longos com modelos de geração de vídeos curtos, empregando reprogramação de ruído, atenção temporal sobre janelas deslizantes e média ponderada de quadros latentes. Ele também pode ser usado com múltiplos prompts para permitir gerações de vídeos interpolados. Mais detalhes estão disponíveis no artigo.
Os pipelines do AnimateDiff atualmente suportados que podem ser usados com FreeNoise são:
- [AnimateDiffPipeline](/docs/diffusers/main/pt/api/pipelines/animatediff#diffusers.AnimateDiffPipeline)
- [AnimateDiffControlNetPipeline](/docs/diffusers/main/pt/api/pipelines/animatediff#diffusers.AnimateDiffControlNetPipeline)
- [AnimateDiffVideoToVideoPipeline](/docs/diffusers/main/pt/api/pipelines/animatediff#diffusers.AnimateDiffVideoToVideoPipeline)
- [AnimateDiffVideoToVideoControlNetPipeline](/docs/diffusers/main/pt/api/pipelines/animatediff#diffusers.AnimateDiffVideoToVideoControlNetPipeline)
Para usar o FreeNoise, é necessário adicionar uma única linha ao código de inferência após carregar seus pipelines.
```diff
+ pipe.enable_free_noise()
```
Depois disso, é possível usar um único prompt ou passar múltiplos prompts como um dicionário de pares inteiro-string. As chaves inteiras do dicionário correspondem ao índice do quadro em que a influência daquele prompt seria máxima. Cada índice de quadro deve mapear para um único prompt em string. Os prompts para os índices de quadro intermediários, que não são passados no dicionário, são criados por interpolação entre os prompts de quadro que são passados. Por padrão, a interpolação linear simples é usada. No entanto, você pode personalizar esse comportamento com um callback para o parâmetro `prompt_interpolation_callback` ao habilitar o FreeNoise.
Exemplo completo:
```python
import torch
from diffusers import AutoencoderKL, AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_video, load_image
# Load pipeline
dtype = torch.float16
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM", dtype=dtype)
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=dtype)
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=motion_adapter, vae=vae, dtype=dtype)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights(
"wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm_lora"
)
pipe.set_adapters(["lcm_lora"], [0.8])
# Enable FreeNoise for long prompt generation
pipe.enable_free_noise(context_length=16, context_stride=4)
pipe.to("cuda") # or "mps", "xpu", "cpu"
# Can be a single prompt, or a dictionary with frame timesteps
prompt = {
0: "A caterpillar on a leaf, high quality, photorealistic",
40: "A caterpillar transforming into a cocoon, on a leaf, near flowers, photorealistic",
80: "A cocoon on a leaf, flowers in the background, photorealistic",
120: "A cocoon maturing and a butterfly being born, flowers and leaves visible in the background, photorealistic",
160: "A beautiful butterfly, vibrant colors, sitting on a leaf, flowers in the background, photorealistic",
200: "A beautiful butterfly, flying away in a forest, photorealistic",
240: "A cyberpunk butterfly, neon lights, glowing",
}
negative_prompt = "bad quality, worst quality, jpeg artifacts"
# Run inference
output = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_frames=256,
guidance_scale=2.5,
num_inference_steps=10,
generator=torch.Generator("cpu").manual_seed(0),
)
# Save video
frames = output.frames[0]
export_to_video(frames, "output.mp4", fps=16)
```
### Economia de memória do FreeNoise
Como o FreeNoise processa múltiplos frames juntos, há partes no modelamento em que a memória necessária excede a disponível em GPUs de consumo comuns. Os principais gargalos de memória que identificamos são os blocos de atenção espacial e temporal, os blocos de upsampling e downsampling, os blocos resnet e as camadas feed-forward. Como a maioria desses blocos opera efetivamente apenas na dimensão de canal/embedding, é possível realizar inferência em blocos (chunked inference) ao longo das dimensões de lote (batch). A dimensão de lote no AnimateDiff é de natureza espacial (`[B x F, H x W, C]`) ou temporal (`B x H x W, F, C`) (note que pode parecer contra-intuitivo, mas as dimensões de lote aqui estão corretas, pois os blocos espaciais processam ao longo da dimensão `B x F`, enquanto os blocos temporais processam ao longo da dimensão `B x H x W`). Introduzimos um `SplitInferenceModule` que facilita a divisão em blocos ao longo de qualquer dimensão e a execução da inferência. Isso economiza bastante memória, mas ao custo de exigir mais tempo para a inferência.
```diff
# Load pipeline and adapters
# ...
+ pipe.enable_free_noise_split_inference()
+ pipe.unet.enable_forward_chunking(16)
```
A chamada ao método `pipe.enable_free_noise_split_inference` aceita dois parâmetros: `spatial_split_size` (padrão `256`) e `temporal_split_size` (padrão `16`). Eles podem ser configurados com base na quantidade de VRAM disponível. Um tamanho de divisão menor resulta em menor uso de memória, mas em inferência mais lenta, enquanto um tamanho de divisão maior resulta em inferência mais rápida, ao custo de mais memória.
## Usando `from_single_file` com o MotionAdapter
`diffusers>=0.30.0` suporta o carregamento dos checkpoints do AnimateDiff no `MotionAdapter` em seu formato original por meio de `from_single_file`
```python
from diffusers import MotionAdapter
ckpt_path = "https://huggingface.co/Lightricks/LongAnimateDiff/blob/main/lt_long_mm_32_frames.ckpt"
adapter = MotionAdapter.from_single_file(ckpt_path, dtype=torch.float16)
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
```
## AnimateDiffPipeline[[diffusers.AnimateDiffPipeline]]
#### diffusers.AnimateDiffPipeline[[diffusers.AnimateDiffPipeline]]
```python
diffusers.AnimateDiffPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L78)
**Parâmetros:**
vae ([AutoencoderKL](/docs/diffusers/main/pt/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
text_encoder (`CLIPTextModel`) : Codificador de texto congelado ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : Um [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer) para tokenizar texto.
unet ([UNet2DConditionModel](/docs/diffusers/main/pt/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Um [UNet2DConditionModel](/docs/diffusers/main/pt/api/models/unet2d-cond#diffusers.UNet2DConditionModel) usado para criar um UNetMotionModel a fim de desruidar os latentes de vídeo codificados.
motion_adapter (`MotionAdapter`) : Um `MotionAdapter` a ser usado em combinação com `unet` para desruidar os latentes de vídeo codificados.
scheduler ([SchedulerMixin](/docs/diffusers/main/pt/api/schedulers/overview#diffusers.SchedulerMixin)) : Um scheduler para ser usado em combinação com `unet` para desruidar os latentes da imagem codificada. Pode ser um de [DDIMScheduler](/docs/diffusers/main/pt/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/pt/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) ou [PNDMScheduler](/docs/diffusers/main/pt/api/schedulers/pndm#diffusers.PNDMScheduler).
Pipeline para geração de texto para vídeo.
Este modelo herda de [DiffusionPipeline](/docs/diffusers/main/pt/api/pipelines/overview#diffusers.DiffusionPipeline). Consulte a documentação da superclasse para os métodos genéricos implementados para todos os pipelines (download, salvamento, execução em um dispositivo específico, etc.).
O pipeline também herda os seguintes métodos de carregamento:
- [load_textual_inversion()](/docs/diffusers/main/pt/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) para carregar embeddings de inversão textual
- [load_lora_weights()](/docs/diffusers/main/pt/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) para carregar os pesos do LoRA
- [save_lora_weights()](/docs/diffusers/main/pt/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) para salvar os pesos do LoRA
- [load_ip_adapter()](/docs/diffusers/main/pt/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) para carregar IP Adapters
#### __call__[[diffusers.AnimateDiffPipeline.__call__]]
```python
__call__(prompt: str | list[str] | None = None, num_frames: int | None = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'], decode_chunk_size: int = 16, **kwargs)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L571)
**Parâmetros:**
prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts para orientar a geração de imagens. Se não definido, você precisa passar `prompt_embeds`.
height (`int`, *opcional*, padrão `self.unet.config.sample_size * self.vae_scale_factor`) : A altura em pixels do vídeo gerado.
width (`int`, *opcional*, padrão `self.unet.config.sample_size * self.vae_scale_factor`) : A largura, em pixels, do vídeo gerado.
num_frames (`int`, *opcional*, padrão 16) : O número de quadros de vídeo que são gerados. O padrão é 16 quadros, que a 8 quadros por segundo equivalem a 2 segundos de vídeo.
num_inference_steps (`int`, *opcional*, padrão 50) : O número de etapas de remoção de ruído. Mais etapas de remoção de ruído geralmente resultam em vídeos de maior qualidade, à custa de uma inferência mais lenta.
guidance_scale (`float`, *opcional*, padrão 7.5) : Um valor mais alto de guidance scale incentiva o modelo a gerar imagens fortemente ligadas ao `prompt` de texto, em detrimento de uma menor qualidade de imagem. O guidance scale é ativado quando `guidance_scale > 1`.
negative_prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts para orientar o que não incluir na geração de imagem. Se não definido, você precisa passar `negative_prompt_embeds` em vez disso. Ignorado quando não está usando orientação (`guidance_scale < 1`).
num_videos_per_prompt (`int`, *opcional*, padrão 1) : O número de vídeos a serem gerados por prompt.
eta (`float`, *opcional*, padrão 0.0) : Corresponde ao parâmetro eta (η) do paper [DDIM](https://huggingface.co/papers/2010.02502). Aplica-se apenas ao [DDIMScheduler](/docs/diffusers/main/pt/api/schedulers/ddim#diffusers.DDIMScheduler) e é ignorado em outros agendadores.
generator (`torch.Generator` ou `list[torch.Generator]`, *opcional*) : Um [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) para tornar a geração determinística.
latents (`torch.Tensor`, *opcional*) : Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de vídeo. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes é gerado por amostragem usando o `generator` aleatório fornecido. Os latentes devem ter a forma `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`, *opcional*) : Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto (ponderação do prompt). Se não forem fornecidas, as incorporações de texto são geradas a partir do argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativo pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto (ponderação do prompt). Se não forem fornecidos, `negative_prompt_embeds` são gerados a partir do argumento de entrada `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`, *opcional*): Entrada de imagem opcional para trabalhar com IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opcional*) : Embebimentos de imagem pré-gerados para IP-Adapter. Deve ser uma lista com o mesmo comprimento que o número de IP-adapters. Cada elemento deve ser um tensor de forma `(batch_size, num_images, emb_dim)`. Deve conter o embebimento de imagem negativo se `do_classifier_free_guidance` estiver definido como `True`. Se não for fornecido, os embebimentos são calculados a partir do argumento de entrada `ip_adapter_image`.
output_type (`str`, *opcional*, padrão `"pil"`) : O formato de saída do vídeo gerado. Escolha entre `torch.Tensor`, `PIL.Image` ou `np.array`.
return_dict (`bool`, *opcional*, padrão `True`) : Se deve ou não retornar um `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput` em vez de uma tupla simples.
cross_attention_kwargs (`dict`, *opcional*) : Um dicionário de kwargs que, se especificado, é passado ao `AttentionProcessor` conforme definido em [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
clip_skip (`int`, *opcional*) : Número de camadas a serem ignoradas do CLIP ao calcular os embeddings do prompt. Um valor de 1 significa que a saída da camada pré-final será usada para calcular os embeddings do prompt.
callback_on_step_end (`Callable`, *opcional*) : Uma função que é chamada no final de cada etapa de desruidamento durante a inferência. A função é chamada com os seguintes argumentos: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` incluirá uma lista de todos os tensores, conforme especificado por `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opcional*) : A lista de entradas de tensor para a função `callback_on_step_end`. Os tensores especificados na lista serão passados como argumento `callback_kwargs`. Você só poderá incluir variáveis listadas no atributo `._callback_tensor_inputs` da sua classe de pipeline.
decode_chunk_size (`int`, padrão `16`) : O número de quadros a decodificar por vez ao chamar o método `decode_latents`.
**Retorna:** [AnimateDiffPipelineOutput](/docs/diffusers/main/pt/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) ou `tuple`
Se `return_dict` for `True`, [AnimateDiffPipelineOutput](/docs/diffusers/main/pt/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) é retornado; caso contrário, uma `tuple` é retornada, em que o primeiro elemento é uma lista com os quadros gerados.
A função de chamada do pipeline para geração.
Exemplos:
```py
>>> import torch
>>> from diffusers import MotionAdapter, AnimateDiffPipeline, DDIMScheduler
>>> from diffusers.utils import export_to_gif
>>> adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2")
>>> pipe = AnimateDiffPipeline.from_pretrained("frankjoshua/toonyou_beta6", motion_adapter=adapter)
>>> pipe.scheduler = DDIMScheduler(beta_schedule="linear", steps_offset=1, clip_sample=False)
>>> output = pipe(prompt="A corgi walking in the park")
>>> frames = output.frames[0]
>>> export_to_gif(frames, "animation.gif")
```
#### encode_prompt[[diffusers.AnimateDiffPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L154)
**Parâmetros:**
prompt (`str` ou `list[str]`, *opcional*) : prompt a ser codificado
device : (`torch.device`): dispositivo torch
num_images_per_prompt (`int`) : número de imagens que devem ser geradas por prompt
do_classifier_free_guidance (`bool`) : se deve ou não usar classifier free guidance
negative_prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts que não devem orientar a geração da imagem. Se não definido, é necessário passar `negative_prompt_embeds` em vez disso. Ignorado quando não se usa orientação (ou seja, ignorado se `guidance_scale` for menor que `1`).
prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não forem fornecidos, os embeddings de texto serão gerados a partir do argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não forem fornecidos, negative_prompt_embeds será gerado a partir do argumento de entrada `negative_prompt`.
lora_scale (`float`, *opcional*) : Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.
clip_skip (`int`, *opcional*) : Número de camadas a serem ignoradas do CLIP ao calcular os embeddings do prompt. Um valor de 1 significa que a saída da camada pré-final será usada para calcular os embeddings do prompt.
Codifica o prompt em estados ocultos do codificador de texto.
## AnimateDiffControlNetPipeline[[diffusers.AnimateDiffControlNetPipeline]]
#### diffusers.AnimateDiffControlNetPipeline[[diffusers.AnimateDiffControlNetPipeline]]
```python
diffusers.AnimateDiffControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: diffusers.models.controlnets.controlnet.ControlNetModel | list[diffusers.models.controlnets.controlnet.ControlNetModel] | tuple[diffusers.models.controlnets.controlnet.ControlNetModel] | diffusers.models.controlnets.multicontrolnet.MultiControlNetModel, scheduler: KarrasDiffusionSchedulers, feature_extractor: transformers.models.clip.image_processing_pil_clip.CLIPImageProcessorPil | None = None, image_encoder: transformers.models.clip.modeling_clip.CLIPVisionModelWithProjection | None = None)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L120)
**Parâmetros:**
vae ([AutoencoderKL](/docs/diffusers/main/pt/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
text_encoder (`CLIPTextModel`) : Codificador de texto congelado ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : Um [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer) para tokenizar texto.
unet ([UNet2DConditionModel](/docs/diffusers/main/pt/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Um [UNet2DConditionModel](/docs/diffusers/main/pt/api/models/unet2d-cond#diffusers.UNet2DConditionModel) usado para criar um UNetMotionModel a fim de desruidar os latentes de vídeo codificados.
motion_adapter (`MotionAdapter`) : Um `MotionAdapter` a ser usado em combinação com `unet` para desruidar os latentes de vídeo codificados.
scheduler ([SchedulerMixin](/docs/diffusers/main/pt/api/schedulers/overview#diffusers.SchedulerMixin)) : Um scheduler para ser usado em combinação com `unet` para desruidar os latentes da imagem codificada. Pode ser um de [DDIMScheduler](/docs/diffusers/main/pt/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/pt/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) ou [PNDMScheduler](/docs/diffusers/main/pt/api/schedulers/pndm#diffusers.PNDMScheduler).
Pipeline para geração de texto para vídeo com orientação do ControlNet.
Este modelo herda de [DiffusionPipeline](/docs/diffusers/main/pt/api/pipelines/overview#diffusers.DiffusionPipeline). Consulte a documentação da superclasse para os métodos genéricos implementados para todos os pipelines (download, salvamento, execução em um dispositivo específico, etc.).
O pipeline também herda os seguintes métodos de carregamento:
- [load_textual_inversion()](/docs/diffusers/main/pt/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) para carregar embeddings de inversão textual
- [load_lora_weights()](/docs/diffusers/main/pt/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) para carregar os pesos do LoRA
- [save_lora_weights()](/docs/diffusers/main/pt/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) para salvar os pesos do LoRA
- [load_ip_adapter()](/docs/diffusers/main/pt/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) para carregar IP Adapters
#### __call__[[diffusers.AnimateDiffControlNetPipeline.__call__]]
```python
__call__(prompt: str | list[str] = None, num_frames: int | None = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, guess_mode: bool = False, control_guidance_start: float | list[float] = 0.0, control_guidance_end: float | list[float] = 1.0, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'], decode_chunk_size: int = 16)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L721)
**Parâmetros:**
prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts para orientar a geração de imagens. Se não definido, você precisa passar `prompt_embeds`.
height (`int`, *opcional*, padrão `self.unet.config.sample_size * self.vae_scale_factor`) : A altura em pixels do vídeo gerado.
width (`int`, *opcional*, padrão `self.unet.config.sample_size * self.vae_scale_factor`) : A largura, em pixels, do vídeo gerado.
num_frames (`int`, *opcional*, padrão 16) : O número de quadros de vídeo que são gerados. O padrão é 16 quadros, que a 8 quadros por segundo equivalem a 2 segundos de vídeo.
num_inference_steps (`int`, *opcional*, padrão 50) : O número de etapas de remoção de ruído. Mais etapas de remoção de ruído geralmente resultam em vídeos de maior qualidade, à custa de uma inferência mais lenta.
guidance_scale (`float`, *opcional*, padrão 7.5) : Um valor mais alto de guidance scale incentiva o modelo a gerar imagens fortemente ligadas ao `prompt` de texto, em detrimento de uma menor qualidade de imagem. O guidance scale é ativado quando `guidance_scale > 1`.
negative_prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts para orientar o que não incluir na geração de imagem. Se não definido, você precisa passar `negative_prompt_embeds` em vez disso. Ignorado quando não está usando orientação (`guidance_scale < 1`).
num_videos_per_prompt (`int`, *opcional*, padrão 1) : O número de vídeos a serem gerados por prompt.
eta (`float`, *opcional*, padrão 0.0) : Corresponde ao parâmetro eta (η) do paper [DDIM](https://huggingface.co/papers/2010.02502). Aplica-se apenas ao [DDIMScheduler](/docs/diffusers/main/pt/api/schedulers/ddim#diffusers.DDIMScheduler) e é ignorado em outros agendadores.
generator (`torch.Generator` ou `list[torch.Generator]`, *opcional*) : Um [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) para tornar a geração determinística.
latents (`torch.Tensor`, *opcional*) : Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de vídeo. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes é gerado por amostragem usando o `generator` aleatório fornecido. Os latentes devem ter a forma `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`, *opcional*) : Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto (ponderação do prompt). Se não forem fornecidas, as incorporações de texto são geradas a partir do argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativo pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto (ponderação do prompt). Se não forem fornecidos, `negative_prompt_embeds` são gerados a partir do argumento de entrada `negative_prompt`.
ip_adapter_image (`PipelineImageInput`, *opcional*) : Entrada de imagem opcional para trabalhar com IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opcional*) : Embebimentos de imagem pré-gerados para IP-Adapter. Deve ser uma lista com o mesmo comprimento que o número de IP-adapters. Cada elemento deve ser um tensor de forma `(batch_size, num_images, emb_dim)`. Deve conter o embebimento de imagem negativo se `do_classifier_free_guidance` estiver definido como `True`. Se não for fornecido, os embebimentos são calculados a partir do argumento de entrada `ip_adapter_image`.
conditioning_frames (`list[PipelineImageInput]`, *opcional*) : A condição de entrada do ControlNet para fornecer orientação ao `unet` para a geração. Se múltiplos ControlNets forem especificados, as imagens devem ser passadas como uma lista, de modo que cada elemento da lista possa ser corretamente agrupado para entrada em um único ControlNet.
output_type (`str`, *opcional*, padrão `"pil"`) : O formato de saída do vídeo gerado. Escolha entre `torch.Tensor`, `PIL.Image` ou `np.array`.
return_dict (`bool`, *opcional*, padrão `True`) : Se deve ou não retornar um `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput` em vez de uma tupla simples.
cross_attention_kwargs (`dict`, *opcional*) : Um dicionário de kwargs que, se especificado, é passado ao `AttentionProcessor` conforme definido em [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
controlnet_conditioning_scale (`float` ou `list[float]`, *opcional*, padrão 1.0) : As saídas do ControlNet são multiplicadas por `controlnet_conditioning_scale` antes de serem adicionadas ao residual no `unet` original. Se múltiplos ControlNets forem especificados em `init`, você pode definir a escala correspondente como uma lista.
guess_mode (`bool`, *opcional*, padrão `False`) : O encoder do ControlNet tenta reconhecer o conteúdo da imagem de entrada mesmo que você remova todos os prompts. Recomenda-se um valor de `guidance_scale` entre 3.0 e 5.0.
control_guidance_start (`float` ou `list[float]`, *opcional*, padrão 0.0) : A porcentagem do total de etapas em que o ControlNet começa a ser aplicado.
control_guidance_end (`float` ou `list[float]`, *opcional*, padrão 1.0) : A porcentagem do total de etapas em que o ControlNet para de ser aplicado.
clip_skip (`int`, *opcional*) : Número de camadas a serem ignoradas do CLIP ao calcular os embeddings do prompt. Um valor de 1 significa que a saída da camada pré-final será usada para calcular os embeddings do prompt.
callback_on_step_end (`Callable`, *opcional*) : Uma função que é chamada no final de cada etapa de desruidamento durante a inferência. A função é chamada com os seguintes argumentos: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` incluirá uma lista de todos os tensores, conforme especificado por `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opcional*) : A lista de entradas de tensor para a função `callback_on_step_end`. Os tensores especificados na lista serão passados como argumento `callback_kwargs`. Você só poderá incluir variáveis listadas no atributo `._callback_tensor_inputs` da sua classe de pipeline.
decode_chunk_size (`int`, padrão `16`) : O número de quadros a decodificar por vez ao chamar o método `decode_latents`.
**Retorna:** [AnimateDiffPipelineOutput](/docs/diffusers/main/pt/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) ou `tuple`
Se `return_dict` for `True`, [AnimateDiffPipelineOutput](/docs/diffusers/main/pt/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) é retornado; caso contrário, uma `tuple` é retornada, em que o primeiro elemento é uma lista com os quadros gerados.
A função de chamada do pipeline para geração.
Exemplos:
#### encode_prompt[[diffusers.AnimateDiffControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L199)
**Parâmetros:**
prompt (`str` ou `list[str]`, *opcional*) : prompt a ser codificado
device : (`torch.device`): dispositivo torch
num_images_per_prompt (`int`) : número de imagens que devem ser geradas por prompt
do_classifier_free_guidance (`bool`) : se deve ou não usar classifier free guidance
negative_prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts que não devem orientar a geração da imagem. Se não definido, é necessário passar `negative_prompt_embeds` em vez disso. Ignorado quando não se usa orientação (ou seja, ignorado se `guidance_scale` for menor que `1`).
prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não forem fornecidos, os embeddings de texto serão gerados a partir do argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não forem fornecidos, negative_prompt_embeds será gerado a partir do argumento de entrada `negative_prompt`.
lora_scale (`float`, *opcional*) : Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.
clip_skip (`int`, *opcional*) : Número de camadas a serem ignoradas do CLIP ao calcular os embeddings do prompt. Um valor de 1 significa que a saída da camada pré-final será usada para calcular os embeddings do prompt.
Codifica o prompt em estados ocultos do codificador de texto.
## AnimateDiffSparseControlNetPipeline[[diffusers.AnimateDiffSparseControlNetPipeline]]
#### diffusers.AnimateDiffSparseControlNetPipeline[[diffusers.AnimateDiffSparseControlNetPipeline]]
```python
diffusers.AnimateDiffSparseControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: SparseControlNetModel, scheduler: KarrasDiffusionSchedulers, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L132)
**Parâmetros:**
vae ([AutoencoderKL](/docs/diffusers/main/pt/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
text_encoder (`CLIPTextModel`) : Codificador de texto congelado ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : Um [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer) para tokenizar texto.
unet ([UNet2DConditionModel](/docs/diffusers/main/pt/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Um [UNet2DConditionModel](/docs/diffusers/main/pt/api/models/unet2d-cond#diffusers.UNet2DConditionModel) usado para criar um UNetMotionModel a fim de desruidar os latentes de vídeo codificados.
motion_adapter (`MotionAdapter`) : Um `MotionAdapter` a ser usado em combinação com `unet` para desruidar os latentes de vídeo codificados.
scheduler ([SchedulerMixin](/docs/diffusers/main/pt/api/schedulers/overview#diffusers.SchedulerMixin)) : Um scheduler para ser usado em combinação com `unet` para desruidar os latentes da imagem codificada. Pode ser um de [DDIMScheduler](/docs/diffusers/main/pt/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/pt/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) ou [PNDMScheduler](/docs/diffusers/main/pt/api/schedulers/pndm#diffusers.PNDMScheduler).
Pipeline para geração controlada de texto para vídeo usando o método descrito em [SparseCtrl: Adding Sparse Controls to Text-to-Video Diffusion Models](https://huggingface.co/papers/2311.16933).
Este modelo herda de [DiffusionPipeline](/docs/diffusers/main/pt/api/pipelines/overview#diffusers.DiffusionPipeline). Consulte a documentação da superclasse para os métodos genéricos implementados para todos os pipelines (download, salvamento, execução em um dispositivo específico, etc.).
O pipeline também herda os seguintes métodos de carregamento:
- [load_textual_inversion()](/docs/diffusers/main/pt/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) para carregar embeddings de inversão textual
- [load_lora_weights()](/docs/diffusers/main/pt/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) para carregar os pesos do LoRA
- [save_lora_weights()](/docs/diffusers/main/pt/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) para salvar os pesos do LoRA
- [load_ip_adapter()](/docs/diffusers/main/pt/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) para carregar IP Adapters
#### __call__[[diffusers.AnimateDiffSparseControlNetPipeline.__call__]]
```python
__call__(prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_frames: int = 16, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, controlnet_frame_indices: list[int] = [0], guess_mode: bool = False, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'])
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L712)
**Parâmetros:**
prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts para orientar a geração de imagens. Se não definido, você precisa passar `prompt_embeds`.
height (`int`, *opcional*, padrão `self.unet.config.sample_size * self.vae_scale_factor`) : A altura em pixels do vídeo gerado.
width (`int`, *opcional*, padrão `self.unet.config.sample_size * self.vae_scale_factor`) : A largura, em pixels, do vídeo gerado.
num_frames (`int`, *opcional*, padrão 16) : O número de quadros de vídeo que são gerados. O padrão é 16 quadros, que a 8 quadros por segundo equivalem a 2 segundos de vídeo.
num_inference_steps (`int`, *opcional*, padrão 50) : O número de etapas de remoção de ruído. Mais etapas de remoção de ruído geralmente resultam em vídeos de maior qualidade, à custa de uma inferência mais lenta.
guidance_scale (`float`, *opcional*, padrão 7.5) : Um valor mais alto de guidance scale incentiva o modelo a gerar imagens fortemente ligadas ao `prompt` de texto, em detrimento de uma menor qualidade de imagem. O guidance scale é ativado quando `guidance_scale > 1`.
negative_prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts para orientar o que não incluir na geração de imagem. Se não definido, você precisa passar `negative_prompt_embeds` em vez disso. Ignorado quando não está usando orientação (`guidance_scale < 1`).
num_videos_per_prompt (`int`, *opcional*, padrão 1) : O número de vídeos a serem gerados por prompt.
eta (`float`, *opcional*, padrão 0.0) : Corresponde ao parâmetro eta (η) do paper [DDIM](https://huggingface.co/papers/2010.02502). Aplica-se apenas ao [DDIMScheduler](/docs/diffusers/main/pt/api/schedulers/ddim#diffusers.DDIMScheduler) e é ignorado em outros agendadores.
generator (`torch.Generator` ou `list[torch.Generator]`, *opcional*) : Um [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) para tornar a geração determinística.
latents (`torch.Tensor`, *opcional*) : Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de vídeo. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes é gerado por amostragem usando o `generator` aleatório fornecido. Os latentes devem ter a forma `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`, *opcional*) : Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto (ponderação do prompt). Se não forem fornecidas, as incorporações de texto são geradas a partir do argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativo pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto (ponderação do prompt). Se não forem fornecidos, `negative_prompt_embeds` são gerados a partir do argumento de entrada `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`, *opcional*): Entrada de imagem opcional para trabalhar com IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opcional*) : Embebimentos de imagem pré-gerados para IP-Adapter. Deve ser uma lista com o mesmo comprimento que o número de IP-adapters. Cada elemento deve ser um tensor de forma `(batch_size, num_images, emb_dim)`. Deve conter o embebimento de imagem negativo se `do_classifier_free_guidance` estiver definido como `True`. Se não for fornecido, os embebimentos são calculados a partir do argumento de entrada `ip_adapter_image`.
conditioning_frames (`list[PipelineImageInput]`, *opcional*) : A entrada do SparseControlNet para fornecer orientação ao `unet` para a geração.
output_type (`str`, *opcional*, padrão `"pil"`) : O formato de saída do vídeo gerado. Escolha entre `torch.Tensor`, `PIL.Image` ou `np.array`.
return_dict (`bool`, *opcional*, padrão `True`) : Se deve ou não retornar um `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput` em vez de uma tupla simples.
cross_attention_kwargs (`dict`, *opcional*) : Um dicionário de kwargs que, se especificado, é passado ao `AttentionProcessor` conforme definido em [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
controlnet_conditioning_scale (`float` ou `list[float]`, *opcional*, padrão 1.0) : As saídas do ControlNet são multiplicadas por `controlnet_conditioning_scale` antes de serem adicionadas ao residual no `unet` original. Se múltiplos ControlNets forem especificados em `init`, você pode definir a escala correspondente como uma lista.
controlnet_frame_indices (`list[int]`) : Os índices onde os quadros de condicionamento devem ser aplicados para a geração. Vários quadros podem ser fornecidos para orientar o modelo a gerar saídas com estrutura semelhante, onde o `unet` pode "preencher as lacunas" para vídeos de interpolação, ou um único quadro pode ser fornecido para a estrutura geral esperada. Deve ter o mesmo comprimento que `conditioning_frames`.
guess_mode (`bool`, *opcional*, padrão `False`) : O encoder do ControlNet tenta reconhecer o conteúdo da imagem de entrada mesmo que você remova todos os prompts. Recomenda-se um valor de `guidance_scale` entre 3.0 e 5.0.
clip_skip (`int`, *opcional*) : Número de camadas a serem ignoradas do CLIP ao calcular os embeddings do prompt. Um valor de 1 significa que a saída da camada pré-final será usada para calcular os embeddings do prompt.
callback_on_step_end (`Callable`, *opcional*) : Uma função que é chamada no final de cada etapa de desruidamento durante a inferência. A função é chamada com os seguintes argumentos: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` incluirá uma lista de todos os tensores, conforme especificado por `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opcional*) : A lista de entradas de tensor para a função `callback_on_step_end`. Os tensores especificados na lista serão passados como argumento `callback_kwargs`. Você só poderá incluir variáveis listadas no atributo `._callback_tensor_inputs` da sua classe de pipeline.
**Retorna:** [AnimateDiffPipelineOutput](/docs/diffusers/main/pt/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) ou `tuple`
Se `return_dict` for `True`, [AnimateDiffPipelineOutput](/docs/diffusers/main/pt/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) é retornado; caso contrário, uma `tuple` é retornada, em que o primeiro elemento é uma lista com os quadros gerados.
A função de chamada do pipeline para geração.
Exemplos:
```python
>>> import torch
>>> from diffusers import AnimateDiffSparseControlNetPipeline
>>> from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
>>> from diffusers.schedulers import DPMSolverMultistepScheduler
>>> from diffusers.utils import export_to_gif, load_image
>>> model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
>>> motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
>>> controlnet_id = "guoyww/animatediff-sparsectrl-scribble"
>>> lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
>>> vae_id = "stabilityai/sd-vae-ft-mse"
>>> device = "cuda"
>>> motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, torch_dtype=torch.float16).to(device)
>>> controlnet = SparseControlNetModel.from_pretrained(controlnet_id, torch_dtype=torch.float16).to(device)
>>> vae = AutoencoderKL.from_pretrained(vae_id, torch_dtype=torch.float16).to(device)
>>> scheduler = DPMSolverMultistepScheduler.from_pretrained(
... model_id,
... subfolder="scheduler",
... beta_schedule="linear",
... algorithm_type="dpmsolver++",
... use_karras_sigmas=True,
... )
>>> pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
... model_id,
... motion_adapter=motion_adapter,
... controlnet=controlnet,
... vae=vae,
... scheduler=scheduler,
... torch_dtype=torch.float16,
... ).to(device)
>>> pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
>>> pipe.fuse_lora(lora_scale=1.0)
>>> prompt = "an aerial view of a cyberpunk city, night time, neon lights, masterpiece, high quality"
>>> negative_prompt = "low quality, worst quality, letterboxed"
>>> image_files = [
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-1.png",
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-2.png",
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-3.png",
... ]
>>> condition_frame_indices = [0, 8, 15]
>>> conditioning_frames = [load_image(img_file) for img_file in image_files]
>>> video = pipe(
... prompt=prompt,
... negative_prompt=negative_prompt,
... num_inference_steps=25,
... conditioning_frames=conditioning_frames,
... controlnet_conditioning_scale=1.0,
... controlnet_frame_indices=condition_frame_indices,
... generator=torch.Generator().manual_seed(1337),
... ).frames[0]
>>> export_to_gif(video, "output.gif")
```
#### encode_prompt[[diffusers.AnimateDiffSparseControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L208)
**Parâmetros:**
prompt (`str` ou `list[str]`, *opcional*) : prompt a ser codificado
device : (`torch.device`): dispositivo torch
num_images_per_prompt (`int`) : número de imagens que devem ser geradas por prompt
do_classifier_free_guidance (`bool`) : se deve ou não usar classifier free guidance
negative_prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts que não devem orientar a geração da imagem. Se não definido, é necessário passar `negative_prompt_embeds` em vez disso. Ignorado quando não se usa orientação (ou seja, ignorado se `guidance_scale` for menor que `1`).
prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não forem fornecidos, os embeddings de texto serão gerados a partir do argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não forem fornecidos, negative_prompt_embeds será gerado a partir do argumento de entrada `negative_prompt`.
lora_scale (`float`, *opcional*) : Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.
clip_skip (`int`, *opcional*) : Número de camadas a serem ignoradas do CLIP ao calcular os embeddings do prompt. Um valor de 1 significa que a saída da camada pré-final será usada para calcular os embeddings do prompt.
Codifica o prompt em estados ocultos do codificador de texto.
## AnimateDiffSDXLPipeline[[diffusers.AnimateDiffSDXLPipeline]]
#### diffusers.AnimateDiffSDXLPipeline[[diffusers.AnimateDiffSDXLPipeline]]
```python
diffusers.AnimateDiffSDXLPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, text_encoder_2: CLIPTextModelWithProjection, tokenizer: CLIPTokenizer, tokenizer_2: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, image_encoder: CLIPVisionModelWithProjection = None, feature_extractor: CLIPImageProcessorPil = None, force_zeros_for_empty_prompt: bool = True)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L210)
**Parâmetros:**
vae ([AutoencoderKL](/docs/diffusers/main/pt/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
text_encoder (`CLIPTextModel`) : Codificador de texto congelado. O Stable Diffusion XL usa a parte de texto do [CLIP](https://huggingface.co/docs/transformers/model_doc/clip#transformers.CLIPTextModel), especificamente a variante [clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14).
text_encoder_2 (` CLIPTextModelWithProjection`) : Segundo codificador de texto congelado. O Stable Diffusion XL usa a parte de texto e pool do [CLIP](https://huggingface.co/docs/transformers/model_doc/clip#transformers.CLIPTextModelWithProjection), especificamente a variante [laion/CLIP-ViT-bigG-14-laion2B-39B-b160k](https://huggingface.co/laion/CLIP-ViT-bigG-14-laion2B-39B-b160k).
tokenizer (`CLIPTokenizer`) : Tokenizer da classe [CLIPTokenizer](https://huggingface.co/docs/transformers/v4.21.0/en/model_doc/clip#transformers.CLIPTokenizer).
tokenizer_2 (`CLIPTokenizer`) : Segundo Tokenizer da classe [CLIPTokenizer](https://huggingface.co/docs/transformers/v4.21.0/en/model_doc/clip#transformers.CLIPTokenizer).
unet ([UNet2DConditionModel](/docs/diffusers/main/pt/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Arquitetura de U-Net condicional para desruidar os latentes da imagem codificada.
scheduler ([SchedulerMixin](/docs/diffusers/main/pt/api/schedulers/overview#diffusers.SchedulerMixin)) : Um scheduler para ser usado em combinação com `unet` para desruidar os latentes da imagem codificada. Pode ser um de [DDIMScheduler](/docs/diffusers/main/pt/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/pt/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) ou [PNDMScheduler](/docs/diffusers/main/pt/api/schedulers/pndm#diffusers.PNDMScheduler).
force_zeros_for_empty_prompt (`bool`, *opcional*, padrão `"True"`) : Se os embeddings do prompt negativo devem ser forçados a sempre serem definidos como 0. Veja também a configuração de `stabilityai/stable-diffusion-xl-base-1-0`.
Pipeline para geração de texto para vídeo usando Stable Diffusion XL.
Este modelo herda de [DiffusionPipeline](/docs/diffusers/main/pt/api/pipelines/overview#diffusers.DiffusionPipeline). Consulte a documentação da superclasse para os métodos genéricos que a biblioteca implementa para todos os pipelines (como download ou salvamento, execução em um dispositivo específico, etc.)
O pipeline também herda os seguintes métodos de carregamento:
- [load_textual_inversion()](/docs/diffusers/main/pt/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) para carregar embeddings de inversão textual
- para carregar arquivos `.ckpt` com [from_single_file()](/docs/diffusers/main/pt/api/loaders/single_file#diffusers.loaders.FromSingleFileMixin.from_single_file)
- [load_lora_weights()](/docs/diffusers/main/pt/api/loaders/lora#diffusers.loaders.StableDiffusionXLLoraLoaderMixin.load_lora_weights) para carregar os pesos do LoRA
- [save_lora_weights()](/docs/diffusers/main/pt/api/loaders/lora#diffusers.loaders.StableDiffusionXLLoraLoaderMixin.save_lora_weights) para salvar os pesos do LoRA
- [load_ip_adapter()](/docs/diffusers/main/pt/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) para carregar IP Adapters
#### __call__[[diffusers.AnimateDiffSDXLPipeline.__call__]]
```python
__call__(prompt: str | list[str] = None, prompt_2: str | list[str] | None = None, num_frames: int = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, timesteps: list[int] = None, sigmas: list[float] = None, denoising_end: float | None = None, guidance_scale: float = 5.0, negative_prompt: str | list[str] | None = None, negative_prompt_2: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, negative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, guidance_rescale: float = 0.0, original_size: tuple[int, int] | None = None, crops_coords_top_left: tuple[int, int] = (0, 0), target_size: tuple[int, int] | None = None, negative_original_size: tuple[int, int] | None = None, negative_crops_coords_top_left: tuple[int, int] = (0, 0), negative_target_size: tuple[int, int] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'])
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L869)
**Parâmetros:**
prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts para orientar a geração do vídeo. Se não definido, é necessário passar `prompt_embeds` em vez disso.
prompt_2 (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts a serem enviados para o `tokenizer_2` e o `text_encoder_2`. Se não definido, `prompt` é usado em ambos os text-encoders
num_frames : O número de quadros de vídeo que são gerados. O padrão é 16 quadros, que a 8 quadros por segundo equivalem a 2 segundos de vídeo.
height (`int`, *opcional*, padrão é self.unet.config.sample_size * self.vae_scale_factor) : A altura em pixels do vídeo gerado. Isso é definido como 1024 por padrão para os melhores resultados. Qualquer valor abaixo de 512 pixels não funcionará bem para [stabilityai/stable-diffusion-xl-base-1.0](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0) e checkpoints que não foram especificamente ajustados em resoluções baixas.
width (`int`, *opcional*, padrão é self.unet.config.sample_size * self.vae_scale_factor) : A largura em pixels do vídeo gerado. Isso é definido como 1024 por padrão para os melhores resultados. Qualquer valor abaixo de 512 pixels não funcionará bem para [stabilityai/stable-diffusion-xl-base-1.0](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0) e checkpoints que não foram especificamente ajustados em resoluções baixas.
num_inference_steps (`int`, *opcional*, padrão 50) : O número de etapas de remoção de ruído. Mais etapas de remoção de ruído geralmente resultam em um vídeo de maior qualidade, em detrimento de uma inferência mais lenta.
timesteps (`list[int]`, *opcional*) : Passos de tempo personalizados para usar no processo de remoção de ruído com agendadores que suportam um argumento `timesteps` em seu método `set_timesteps`. Se não definido, o comportamento padrão quando `num_inference_steps` é passado será usado. Deve estar em ordem decrescente.
sigmas (`list[float]`, *opcional*) : Sigmas personalizados para usar no processo de desruidamento com agendadores que suportam um argumento `sigmas` em seu método `set_timesteps`. Se não definido, o comportamento padrão quando `num_inference_steps` é passado será usado.
denoising_end (`float`, *opcional*) : Quando especificado, determina a fração (entre 0.0 e 1.0) do processo total de remoção de ruído que deve ser concluída antes de ser encerrado prematuramente de forma intencional. Como resultado, a amostra retornada ainda reterá uma quantidade substancial de ruído, conforme determinado pelos passos discretos selecionados pelo agendador. O parâmetro denoising_end deve ser idealmente utilizado quando este pipeline faz parte de uma configuração multi-pipeline de "Mixture of Denoisers", conforme detalhado em [**Refinamento da Saída da Imagem**](https://huggingface.co/docs/diffusers/api/pipelines/stable_diffusion/stable_diffusion_xl#refining-the-image-output)
guidance_scale (`float`, *opcional*, padrão 5.0) : Escala de orientação definida em [Classifier-Free Diffusion Guidance](https://huggingface.co/papers/2207.12598). `guidance_scale` é definido como `w` da equação 2. do [Imagen Paper](https://huggingface.co/papers/2205.11487). A escala de orientação é ativada ao definir `guidance_scale > 1`. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas ao `prompt` de texto, geralmente em detrimento de uma menor qualidade do vídeo.
negative_prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts que não devem orientar a geração do vídeo. Se não definido, é necessário passar `negative_prompt_embeds` em vez disso. Ignorado quando não se usa orientação (ou seja, ignorado se `guidance_scale` for menor que `1`).
negative_prompt_2 (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts que não devem orientar a geração do vídeo a serem enviados para `tokenizer_2` e `text_encoder_2`. Se não definido, `negative_prompt` é usado em ambos os text-encoders
num_videos_per_prompt (`int`, *opcional*, padrão 1) : O número de vídeos a serem gerados por prompt.
eta (`float`, *opcional*, padrão 0.0) : Corresponde ao parâmetro eta (η) no paper DDIM: https://huggingface.co/papers/2010.02502. Aplica-se apenas a [schedulers.DDIMScheduler](/docs/diffusers/main/pt/api/schedulers/ddim#diffusers.DDIMScheduler), será ignorado para os demais.
generator (`torch.Generator` ou `list[torch.Generator]`, *opcional*) : Um ou uma lista de [geradores do torch](https://pytorch.org/docs/stable/generated/torch.Generator.html) para tornar a geração determinística.
latents (`torch.Tensor`, *opcional*) : Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de vídeo. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando o `generator` aleatório fornecido.
prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não forem fornecidos, os embeddings de texto serão gerados a partir do argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não forem fornecidos, negative_prompt_embeds será gerado a partir do argumento de entrada `negative_prompt`.
pooled_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto agrupados pré-gerados. Pode ser usado para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não for fornecido, os embeddings de texto agrupados serão gerados a partir do argumento de entrada `prompt`.
negative_pooled_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativo pré-gerados. Pode ser usado para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não for fornecido, os pooled negative_prompt_embeds serão gerados a partir do argumento de entrada `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`, *opcional*): Entrada de imagem opcional para trabalhar com IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opcional*) : Embebimentos de imagem pré-gerados para IP-Adapter. Se não fornecidos, os embebimentos são calculados a partir do argumento de entrada `ip_adapter_image`.
output_type (`str`, *opcional*, padrão `"pil"`) : O formato de saída do vídeo gerado. Escolha entre [PIL](https://pillow.readthedocs.io/en/stable/): `PIL.Image.Image` ou `np.array`.
return_dict (`bool`, *opcional*, padrão `True`) : Se deve ou não retornar um `~pipelines.stable_diffusion_xl.AnimateDiffPipelineOutput` em vez de uma tupla simples.
cross_attention_kwargs (`dict`, *opcional*) : Um dicionário de kwargs que, se especificado, é passado para o `AttentionProcessor` conforme definido em `self.processor` em [diffusers.models.attention_processor](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
guidance_rescale (`float`, *opcional*, padrão 0.0) : Fator de rescalonamento de orientação proposto por [Common Diffusion Noise Schedules and Sample Steps are Flawed](https://huggingface.co/papers/2305.08891) `guidance_scale` é definido como `φ` na equação 16. de [Common Diffusion Noise Schedules and Sample Steps are Flawed](https://huggingface.co/papers/2305.08891). O fator de rescalonamento de orientação deve corrigir a sobreexposição ao usar SNR terminal zero.
original_size (`tuple[int]`, *opcional*, padrão (1024, 1024)) : Se `original_size` não for o mesmo que `target_size`, a imagem parecerá ter sido reduzida ou ampliada. `original_size` tem como padrão `(height, width)` se não for especificado. Parte do micro-condicionamento do SDXL, conforme explicado na seção 2.2 de [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952).
crops_coords_top_left (`tuple[int]`, *opcional*, padrão (0, 0)) : `crops_coords_top_left` pode ser usado para gerar uma imagem que parece ter sido "recortada" a partir da posição `crops_coords_top_left` para baixo. Imagens favoráveis e bem centralizadas são geralmente obtidas ao definir `crops_coords_top_left` como (0, 0). Parte do micro-condicionamento do SDXL, conforme explicado na seção 2.2 de [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952).
target_size (`tuple[int]`, *opcional*, padrão (1024, 1024)) : Na maioria dos casos, `target_size` deve ser definido para a altura e largura desejadas da imagem gerada. Se não for especificado, o padrão será `(height, width)`. Parte do micro-conditioning do SDXL, conforme explicado na seção 2.2 de [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952).
negative_original_size (`tuple[int]`, *opcional*, padrão (1024, 1024)) : Para condicionar negativamente o processo de geração com base em uma resolução de imagem específica. Parte do micro-condicionamento do SDXL, conforme explicado na seção 2.2 de [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952). Para mais informações, consulte este tópico: https://github.com/huggingface/diffusers/issues/4208.
negative_crops_coords_top_left (`tuple[int]`, *opcional*, padrão (0, 0)) : Para condicionar negativamente o processo de geração com base em coordenadas específicas de recorte. Parte do micro-condicionamento do SDXL, conforme explicado na seção 2.2 de [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952). Para mais informações, consulte este tópico: https://github.com/huggingface/diffusers/issues/4208.
negative_target_size (`tuple[int]`, *opcional*, padrão (1024, 1024)) : Para condicionar negativamente o processo de geração com base em uma resolução de imagem alvo. Deve ser o mesmo que o `target_size` na maioria dos casos. Parte do micro-condicionamento do SDXL, conforme explicado na seção 2.2 de [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952). Para mais informações, consulte este tópico: https://github.com/huggingface/diffusers/issues/4208.
clip_skip (`int`, *opcional*) : Número de camadas a serem ignoradas do CLIP ao calcular os embeddings do prompt. Um valor de 1 significa que a saída da camada pré-final será usada para calcular os embeddings do prompt.
callback_on_step_end (`Callable`, *opcional*) : Uma função que é chamada no final de cada etapa de desruidamento durante a inferência. A função é chamada com os seguintes argumentos: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` incluirá uma lista de todos os tensores, conforme especificado por `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opcional*) : A lista de entradas de tensor para a função `callback_on_step_end`. Os tensores especificados na lista serão passados como argumento `callback_kwargs`. Você só poderá incluir variáveis listadas no atributo `._callback_tensor_inputs` da sua classe de pipeline.
**Retorna:** [AnimateDiffPipelineOutput](/docs/diffusers/main/pt/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) ou `tuple`
Se `return_dict` for `True`, [AnimateDiffPipelineOutput](/docs/diffusers/main/pt/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) é retornado; caso contrário, uma `tuple` é retornada, em que o primeiro elemento é uma lista com os quadros gerados.
Função invocada ao chamar o pipeline para geração.
Exemplos:
```py
>>> import torch
>>> from diffusers.models import MotionAdapter
>>> from diffusers import AnimateDiffSDXLPipeline, DDIMScheduler
>>> from diffusers.utils import export_to_gif
>>> adapter = MotionAdapter.from_pretrained(
... "a-r-r-o-w/animatediff-motion-adapter-sdxl-beta", torch_dtype=torch.float16
... )
>>> model_id = "stabilityai/stable-diffusion-xl-base-1.0"
>>> scheduler = DDIMScheduler.from_pretrained(
... model_id,
... subfolder="scheduler",
... clip_sample=False,
... timestep_spacing="linspace",
... beta_schedule="linear",
... steps_offset=1,
... )
>>> pipe = AnimateDiffSDXLPipeline.from_pretrained(
... model_id,
... motion_adapter=adapter,
... scheduler=scheduler,
... torch_dtype=torch.float16,
... variant="fp16",
... ).to("cuda")
>>> # enable memory savings
>>> pipe.vae.enable_slicing()
>>> pipe.vae.enable_tiling()
>>> output = pipe(
... prompt="a panda surfing in the ocean, realistic, high quality",
... negative_prompt="low quality, worst quality",
... num_inference_steps=20,
... guidance_scale=8,
... width=1024,
... height=1024,
... num_frames=16,
... )
>>> frames = output.frames[0]
>>> export_to_gif(frames, "animation.gif")
```
#### encode_prompt[[diffusers.AnimateDiffSDXLPipeline.encode_prompt]]
```python
encode_prompt(prompt: str, prompt_2: str | None = None, device: typing.Optional[torch.device] = None, num_videos_per_prompt: int = 1, do_classifier_free_guidance: bool = True, negative_prompt: str | None = None, negative_prompt_2: str | None = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, negative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L327)
**Parâmetros:**
prompt (`str` ou `list[str]`, *opcional*) : prompt a ser codificado
prompt_2 (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts a serem enviados para o `tokenizer_2` e o `text_encoder_2`. Se não definido, `prompt` é usado em ambos os text-encoders
device : (`torch.device`): dispositivo torch
num_videos_per_prompt (`int`) : número de imagens que devem ser geradas por prompt
do_classifier_free_guidance (`bool`) : se deve ou não usar classifier free guidance
negative_prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts que não devem orientar a geração da imagem. Se não definido, é necessário passar `negative_prompt_embeds` em vez disso. Ignorado quando não se usa orientação (ou seja, ignorado se `guidance_scale` for menor que `1`).
negative_prompt_2 (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts que não devem orientar a geração da imagem a serem enviados para `tokenizer_2` e `text_encoder_2`. Se não definido, `negative_prompt` é usado em ambos os text-encoders
prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não forem fornecidos, os embeddings de texto serão gerados a partir do argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não forem fornecidos, negative_prompt_embeds será gerado a partir do argumento de entrada `negative_prompt`.
pooled_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto agrupados pré-gerados. Pode ser usado para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não for fornecido, os embeddings de texto agrupados serão gerados a partir do argumento de entrada `prompt`.
negative_pooled_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativo pré-gerados. Pode ser usado para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não for fornecido, os pooled negative_prompt_embeds serão gerados a partir do argumento de entrada `negative_prompt`.
lora_scale (`float`, *opcional*) : Uma escala lora que será aplicada a todas as camadas LoRA do text encoder, caso as camadas LoRA sejam carregadas.
clip_skip (`int`, *opcional*) : Número de camadas a serem ignoradas do CLIP ao calcular os embeddings do prompt. Um valor de 1 significa que a saída da camada pré-final será usada para calcular os embeddings do prompt.
Codifica o prompt em estados ocultos do codificador de texto.
#### get_guidance_scale_embedding[[diffusers.AnimateDiffSDXLPipeline.get_guidance_scale_embedding]]
```python
get_guidance_scale_embedding(w: Tensor, embedding_dim: int = 512, dtype: dtype = torch.float32)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L804)
**Parâmetros:**
w (`torch.Tensor`) : Gera vetores de incorporação com uma escala de orientação especificada para, em seguida, enriquecer as incorporações de passo de tempo.
embedding_dim (`int`, *opcional*, padrão 512) : Dimensão dos embeddings a serem gerados.
dtype (`torch.dtype`, *opcional*, padrão `torch.float32`) : Tipo de dados dos embeddings gerados.
**Retorna:** `torch.Tensor`
Vetores de incorporação com forma `(len(w), embedding_dim)`.
Veja https://github.com/google-research/vdm/blob/dc27b98a554f65cdc654b800da5aa1846545d41b/model_vdm.py#L298
## AnimateDiffVideoToVideoPipeline[[diffusers.AnimateDiffVideoToVideoPipeline]]
#### diffusers.AnimateDiffVideoToVideoPipeline[[diffusers.AnimateDiffVideoToVideoPipeline]]
```python
diffusers.AnimateDiffVideoToVideoPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L181)
**Parâmetros:**
vae ([AutoencoderKL](/docs/diffusers/main/pt/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
text_encoder (`CLIPTextModel`) : Codificador de texto congelado ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : Um [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer) para tokenizar texto.
unet ([UNet2DConditionModel](/docs/diffusers/main/pt/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Um [UNet2DConditionModel](/docs/diffusers/main/pt/api/models/unet2d-cond#diffusers.UNet2DConditionModel) usado para criar um UNetMotionModel a fim de desruidar os latentes de vídeo codificados.
motion_adapter (`MotionAdapter`) : Um `MotionAdapter` a ser usado em combinação com `unet` para desruidar os latentes de vídeo codificados.
scheduler ([SchedulerMixin](/docs/diffusers/main/pt/api/schedulers/overview#diffusers.SchedulerMixin)) : Um scheduler para ser usado em combinação com `unet` para desruidar os latentes da imagem codificada. Pode ser um de [DDIMScheduler](/docs/diffusers/main/pt/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/pt/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) ou [PNDMScheduler](/docs/diffusers/main/pt/api/schedulers/pndm#diffusers.PNDMScheduler).
Pipeline para geração de vídeo-para-vídeo.
Este modelo herda de [DiffusionPipeline](/docs/diffusers/main/pt/api/pipelines/overview#diffusers.DiffusionPipeline). Consulte a documentação da superclasse para os métodos genéricos implementados para todos os pipelines (download, salvamento, execução em um dispositivo específico, etc.).
O pipeline também herda os seguintes métodos de carregamento:
- [load_textual_inversion()](/docs/diffusers/main/pt/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) para carregar embeddings de inversão textual
- [load_lora_weights()](/docs/diffusers/main/pt/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) para carregar os pesos do LoRA
- [save_lora_weights()](/docs/diffusers/main/pt/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) para salvar os pesos do LoRA
- [load_ip_adapter()](/docs/diffusers/main/pt/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) para carregar IP Adapters
#### __call__[[diffusers.AnimateDiffVideoToVideoPipeline.__call__]]
```python
__call__(video: list[list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]]] = None, prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, enforce_inference_steps: bool = False, timesteps: list[int] | None = None, sigmas: list[float] | None = None, guidance_scale: float = 7.5, strength: float = 0.8, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'], decode_chunk_size: int = 16)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L744)
**Parâmetros:**
video (`list[PipelineImageInput]`) : O vídeo de entrada para condicionar a geração. Deve ser uma lista de imagens/quadros do vídeo.
prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts para orientar a geração de imagens. Se não definido, você precisa passar `prompt_embeds`.
height (`int`, *opcional*, padrão `self.unet.config.sample_size * self.vae_scale_factor`) : A altura em pixels do vídeo gerado.
width (`int`, *opcional*, padrão `self.unet.config.sample_size * self.vae_scale_factor`) : A largura, em pixels, do vídeo gerado.
num_inference_steps (`int`, *opcional*, padrão 50) : O número de etapas de remoção de ruído. Mais etapas de remoção de ruído geralmente resultam em vídeos de maior qualidade, à custa de uma inferência mais lenta.
enforce_inference_steps (`bool`, *opcional*, padrão `False`) : Se deve impor `num_inference_steps` etapas de desruido, independentemente do parâmetro `strength`. Quando `False`, o número efetivo de etapas de inferência é reduzido de acordo com `strength`.
timesteps (`list[int]`, *opcional*) : Passos de tempo personalizados para usar no processo de remoção de ruído com agendadores que suportam um argumento `timesteps` em seu método `set_timesteps`. Se não definido, o comportamento padrão quando `num_inference_steps` é passado será usado. Deve estar em ordem decrescente.
sigmas (`list[float]`, *opcional*) : Sigmas personalizados para usar no processo de desruidamento com agendadores que suportam um argumento `sigmas` em seu método `set_timesteps`. Se não definido, o comportamento padrão quando `num_inference_steps` é passado será usado.
strength (`float`, *opcional*, padrão 0.8) : Uma intensidade maior resulta em mais diferenças entre o vídeo original e o vídeo gerado.
guidance_scale (`float`, *opcional*, padrão 7.5) : Um valor mais alto de guidance scale incentiva o modelo a gerar imagens fortemente ligadas ao `prompt` de texto, em detrimento de uma menor qualidade de imagem. O guidance scale é ativado quando `guidance_scale > 1`.
negative_prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts para orientar o que não incluir na geração de imagem. Se não definido, você precisa passar `negative_prompt_embeds` em vez disso. Ignorado quando não está usando orientação (`guidance_scale < 1`).
num_videos_per_prompt (`int`, *opcional*, padrão 1) : O número de vídeos a serem gerados por prompt.
eta (`float`, *opcional*, padrão 0.0) : Corresponde ao parâmetro eta (η) do paper [DDIM](https://huggingface.co/papers/2010.02502). Aplica-se apenas ao [DDIMScheduler](/docs/diffusers/main/pt/api/schedulers/ddim#diffusers.DDIMScheduler) e é ignorado em outros agendadores.
generator (`torch.Generator` ou `list[torch.Generator]`, *opcional*) : Um [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) para tornar a geração determinística.
latents (`torch.Tensor`, *opcional*) : Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de vídeo. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes é gerado por amostragem usando o `generator` aleatório fornecido. Os latentes devem ter a forma `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`, *opcional*) : Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto (ponderação do prompt). Se não forem fornecidas, as incorporações de texto são geradas a partir do argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativo pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto (ponderação do prompt). Se não forem fornecidos, `negative_prompt_embeds` são gerados a partir do argumento de entrada `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`, *opcional*): Entrada de imagem opcional para trabalhar com IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opcional*) : Embebimentos de imagem pré-gerados para IP-Adapter. Deve ser uma lista com o mesmo comprimento que o número de IP-adapters. Cada elemento deve ser um tensor de forma `(batch_size, num_images, emb_dim)`. Deve conter o embebimento de imagem negativo se `do_classifier_free_guidance` estiver definido como `True`. Se não for fornecido, os embebimentos são calculados a partir do argumento de entrada `ip_adapter_image`.
output_type (`str`, *opcional*, padrão `"pil"`) : O formato de saída do vídeo gerado. Escolha entre `torch.Tensor`, `PIL.Image` ou `np.array`.
return_dict (`bool`, *opcional*, padrão `True`) : Se deve ou não retornar um `AnimateDiffPipelineOutput` em vez de uma tupla simples.
cross_attention_kwargs (`dict`, *opcional*) : Um dicionário de kwargs que, se especificado, é passado ao `AttentionProcessor` conforme definido em [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
clip_skip (`int`, *opcional*) : Número de camadas a serem ignoradas do CLIP ao calcular os embeddings do prompt. Um valor de 1 significa que a saída da camada pré-final será usada para calcular os embeddings do prompt.
callback_on_step_end (`Callable`, *opcional*) : Uma função que é chamada no final de cada etapa de desruidamento durante a inferência. A função é chamada com os seguintes argumentos: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` incluirá uma lista de todos os tensores, conforme especificado por `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opcional*) : A lista de entradas de tensor para a função `callback_on_step_end`. Os tensores especificados na lista serão passados como argumento `callback_kwargs`. Você só poderá incluir variáveis listadas no atributo `._callback_tensor_inputs` da sua classe de pipeline.
decode_chunk_size (`int`, padrão `16`) : O número de quadros a decodificar por vez ao chamar o método `decode_latents`.
**Retorna:** [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/main/pt/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) ou `tuple`
Se `return_dict` for `True`, [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/main/pt/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) é retornado; caso contrário, uma `tuple` é retornada, em que o primeiro elemento é uma lista com os quadros gerados.
A função de chamada do pipeline para geração.
Exemplos:
#### encode_prompt[[diffusers.AnimateDiffVideoToVideoPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L256)
**Parâmetros:**
prompt (`str` ou `list[str]`, *opcional*) : prompt a ser codificado
device : (`torch.device`): dispositivo torch
num_images_per_prompt (`int`) : número de imagens que devem ser geradas por prompt
do_classifier_free_guidance (`bool`) : se deve ou não usar classifier free guidance
negative_prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts que não devem orientar a geração da imagem. Se não definido, é necessário passar `negative_prompt_embeds` em vez disso. Ignorado quando não se usa orientação (ou seja, ignorado se `guidance_scale` for menor que `1`).
prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não forem fornecidos, os embeddings de texto serão gerados a partir do argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não forem fornecidos, negative_prompt_embeds será gerado a partir do argumento de entrada `negative_prompt`.
lora_scale (`float`, *opcional*) : Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.
clip_skip (`int`, *opcional*) : Número de camadas a serem ignoradas do CLIP ao calcular os embeddings do prompt. Um valor de 1 significa que a saída da camada pré-final será usada para calcular os embeddings do prompt.
Codifica o prompt em estados ocultos do codificador de texto.
## AnimateDiffVideoToVideoControlNetPipeline[[diffusers.AnimateDiffVideoToVideoControlNetPipeline]]
#### diffusers.AnimateDiffVideoToVideoControlNetPipeline[[diffusers.AnimateDiffVideoToVideoControlNetPipeline]]
```python
diffusers.AnimateDiffVideoToVideoControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: diffusers.models.controlnets.controlnet.ControlNetModel | list[diffusers.models.controlnets.controlnet.ControlNetModel] | tuple[diffusers.models.controlnets.controlnet.ControlNetModel] | diffusers.models.controlnets.multicontrolnet.MultiControlNetModel, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L199)
**Parâmetros:**
vae ([AutoencoderKL](/docs/diffusers/main/pt/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
text_encoder (`CLIPTextModel`) : Codificador de texto congelado ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : Um [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer) para tokenizar texto.
unet ([UNet2DConditionModel](/docs/diffusers/main/pt/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Um [UNet2DConditionModel](/docs/diffusers/main/pt/api/models/unet2d-cond#diffusers.UNet2DConditionModel) usado para criar um UNetMotionModel a fim de desruidar os latentes de vídeo codificados.
motion_adapter (`MotionAdapter`) : Um `MotionAdapter` a ser usado em combinação com `unet` para desruidar os latentes de vídeo codificados.
controlnet ([ControlNetModel](/docs/diffusers/main/pt/api/models/controlnet#diffusers.ControlNetModel) ou `list[ControlNetModel]` ou `tuple[ControlNetModel]` ou `MultiControlNetModel`) : Fornece condicionamento adicional ao `unet` durante o processo de desruidamento. Se você definir múltiplos ControlNets como uma lista, as saídas de cada ControlNet são somadas para criar um único condicionamento adicional combinado.
scheduler ([SchedulerMixin](/docs/diffusers/main/pt/api/schedulers/overview#diffusers.SchedulerMixin)) : Um scheduler para ser usado em combinação com `unet` para desruidar os latentes da imagem codificada. Pode ser um de [DDIMScheduler](/docs/diffusers/main/pt/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/pt/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) ou [PNDMScheduler](/docs/diffusers/main/pt/api/schedulers/pndm#diffusers.PNDMScheduler).
Pipeline para geração de vídeo-para-vídeo com orientação do ControlNet.
Este modelo herda de [DiffusionPipeline](/docs/diffusers/main/pt/api/pipelines/overview#diffusers.DiffusionPipeline). Consulte a documentação da superclasse para os métodos genéricos implementados para todos os pipelines (download, salvamento, execução em um dispositivo específico, etc.).
O pipeline também herda os seguintes métodos de carregamento:
- [load_textual_inversion()](/docs/diffusers/main/pt/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) para carregar embeddings de inversão textual
- [load_lora_weights()](/docs/diffusers/main/pt/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) para carregar os pesos do LoRA
- [save_lora_weights()](/docs/diffusers/main/pt/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) para salvar os pesos do LoRA
- [load_ip_adapter()](/docs/diffusers/main/pt/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) para carregar IP Adapters
#### __call__[[diffusers.AnimateDiffVideoToVideoControlNetPipeline.__call__]]
```python
__call__(video: list[list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]]] = None, prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, enforce_inference_steps: bool = False, timesteps: list[int] | None = None, sigmas: list[float] | None = None, guidance_scale: float = 7.5, strength: float = 0.8, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, guess_mode: bool = False, control_guidance_start: float | list[float] = 0.0, control_guidance_end: float | list[float] = 1.0, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'], decode_chunk_size: int = 16)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L909)
**Parâmetros:**
video (`list[PipelineImageInput]`) : O vídeo de entrada para condicionar a geração. Deve ser uma lista de imagens/quadros do vídeo.
prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts para orientar a geração de imagens. Se não definido, você precisa passar `prompt_embeds`.
height (`int`, *opcional*, padrão `self.unet.config.sample_size * self.vae_scale_factor`) : A altura em pixels do vídeo gerado.
width (`int`, *opcional*, padrão `self.unet.config.sample_size * self.vae_scale_factor`) : A largura, em pixels, do vídeo gerado.
num_inference_steps (`int`, *opcional*, padrão 50) : O número de etapas de remoção de ruído. Mais etapas de remoção de ruído geralmente resultam em vídeos de maior qualidade, à custa de uma inferência mais lenta.
enforce_inference_steps (`bool`, *opcional*, padrão `False`) : Se deve impor `num_inference_steps` etapas de desruido, independentemente do parâmetro `strength`. Quando `False`, o número efetivo de etapas de inferência é reduzido de acordo com `strength`.
timesteps (`list[int]`, *opcional*) : Passos de tempo personalizados para usar no processo de remoção de ruído com agendadores que suportam um argumento `timesteps` em seu método `set_timesteps`. Se não definido, o comportamento padrão quando `num_inference_steps` é passado será usado. Deve estar em ordem decrescente.
sigmas (`list[float]`, *opcional*) : Sigmas personalizados para usar no processo de desruidamento com agendadores que suportam um argumento `sigmas` em seu método `set_timesteps`. Se não definido, o comportamento padrão quando `num_inference_steps` é passado será usado.
strength (`float`, *opcional*, padrão 0.8) : Uma intensidade maior resulta em mais diferenças entre o vídeo original e o vídeo gerado.
guidance_scale (`float`, *opcional*, padrão 7.5) : Um valor mais alto de guidance scale incentiva o modelo a gerar imagens fortemente ligadas ao `prompt` de texto, em detrimento de uma menor qualidade de imagem. O guidance scale é ativado quando `guidance_scale > 1`.
negative_prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts para orientar o que não incluir na geração de imagem. Se não definido, você precisa passar `negative_prompt_embeds` em vez disso. Ignorado quando não está usando orientação (`guidance_scale < 1`).
num_videos_per_prompt (`int`, *opcional*, padrão 1) : O número de vídeos a serem gerados por prompt.
eta (`float`, *opcional*, padrão 0.0) : Corresponde ao parâmetro eta (η) do paper [DDIM](https://huggingface.co/papers/2010.02502). Aplica-se apenas ao [DDIMScheduler](/docs/diffusers/main/pt/api/schedulers/ddim#diffusers.DDIMScheduler) e é ignorado em outros agendadores.
generator (`torch.Generator` ou `list[torch.Generator]`, *opcional*) : Um [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) para tornar a geração determinística.
latents (`torch.Tensor`, *opcional*) : Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de vídeo. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes é gerado por amostragem usando o `generator` aleatório fornecido. Os latentes devem ter a forma `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`, *opcional*) : Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto (ponderação do prompt). Se não forem fornecidas, as incorporações de texto são geradas a partir do argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativo pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto (ponderação do prompt). Se não forem fornecidos, `negative_prompt_embeds` são gerados a partir do argumento de entrada `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`, *opcional*): Entrada de imagem opcional para trabalhar com IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opcional*) : Embebimentos de imagem pré-gerados para IP-Adapter. Deve ser uma lista com o mesmo comprimento que o número de IP-adapters. Cada elemento deve ser um tensor de forma `(batch_size, num_images, emb_dim)`. Deve conter o embebimento de imagem negativo se `do_classifier_free_guidance` estiver definido como `True`. Se não for fornecido, os embebimentos são calculados a partir do argumento de entrada `ip_adapter_image`.
conditioning_frames (`list[PipelineImageInput]`, *opcional*) : A condição de entrada do ControlNet para fornecer orientação ao `unet` para a geração. Se múltiplos ControlNets forem especificados, as imagens devem ser passadas como uma lista, de modo que cada elemento da lista possa ser corretamente agrupado para entrada em um único ControlNet.
output_type (`str`, *opcional*, padrão `"pil"`) : O formato de saída do vídeo gerado. Escolha entre `torch.Tensor`, `PIL.Image` ou `np.array`.
return_dict (`bool`, *opcional*, padrão `True`) : Se deve ou não retornar um `AnimateDiffPipelineOutput` em vez de uma tupla simples.
cross_attention_kwargs (`dict`, *opcional*) : Um dicionário de kwargs que, se especificado, é passado ao `AttentionProcessor` conforme definido em [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
controlnet_conditioning_scale (`float` ou `list[float]`, *opcional*, padrão 1.0) : As saídas do ControlNet são multiplicadas por `controlnet_conditioning_scale` antes de serem adicionadas ao residual no `unet` original. Se múltiplos ControlNets forem especificados em `init`, você pode definir a escala correspondente como uma lista.
guess_mode (`bool`, *opcional*, padrão `False`) : O encoder do ControlNet tenta reconhecer o conteúdo da imagem de entrada mesmo que você remova todos os prompts. Recomenda-se um valor de `guidance_scale` entre 3.0 e 5.0.
control_guidance_start (`float` ou `list[float]`, *opcional*, padrão 0.0) : A porcentagem do total de etapas em que o ControlNet começa a ser aplicado.
control_guidance_end (`float` ou `list[float]`, *opcional*, padrão 1.0) : A porcentagem do total de etapas em que o ControlNet para de ser aplicado.
clip_skip (`int`, *opcional*) : Número de camadas a serem ignoradas do CLIP ao calcular os embeddings do prompt. Um valor de 1 significa que a saída da camada pré-final será usada para calcular os embeddings do prompt.
callback_on_step_end (`Callable`, *opcional*) : Uma função que é chamada no final de cada etapa de desruidamento durante a inferência. A função é chamada com os seguintes argumentos: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` incluirá uma lista de todos os tensores, conforme especificado por `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opcional*) : A lista de entradas de tensor para a função `callback_on_step_end`. Os tensores especificados na lista serão passados como argumento `callback_kwargs`. Você só poderá incluir variáveis listadas no atributo `._callback_tensor_inputs` da sua classe de pipeline.
decode_chunk_size (`int`, padrão `16`) : O número de quadros a decodificar por vez ao chamar o método `decode_latents`.
**Retorna:** [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/main/pt/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) ou `tuple`
Se `return_dict` for `True`, [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/main/pt/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) é retornado; caso contrário, uma `tuple` é retornada, em que o primeiro elemento é uma lista com os quadros gerados.
A função de chamada do pipeline para geração.
Exemplos:
#### encode_prompt[[diffusers.AnimateDiffVideoToVideoControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L287)
**Parâmetros:**
prompt (`str` ou `list[str]`, *opcional*) : prompt a ser codificado
device : (`torch.device`): dispositivo torch
num_images_per_prompt (`int`) : número de imagens que devem ser geradas por prompt
do_classifier_free_guidance (`bool`) : se deve ou não usar classifier free guidance
negative_prompt (`str` ou `list[str]`, *opcional*) : O prompt ou os prompts que não devem orientar a geração da imagem. Se não definido, é necessário passar `negative_prompt_embeds` em vez disso. Ignorado quando não se usa orientação (ou seja, ignorado se `guidance_scale` for menor que `1`).
prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não forem fornecidos, os embeddings de texto serão gerados a partir do argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, *por exemplo*, ponderação de prompts. Se não forem fornecidos, negative_prompt_embeds será gerado a partir do argumento de entrada `negative_prompt`.
lora_scale (`float`, *opcional*) : Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.
clip_skip (`int`, *opcional*) : Número de camadas a serem ignoradas do CLIP ao calcular os embeddings do prompt. Um valor de 1 significa que a saída da camada pré-final será usada para calcular os embeddings do prompt.
Codifica o prompt em estados ocultos do codificador de texto.
## AnimateDiffPipelineOutput[[diffusers.pipelines.animatediff.AnimateDiffPipelineOutput]]
#### diffusers.pipelines.animatediff.AnimateDiffPipelineOutput[[diffusers.pipelines.animatediff.AnimateDiffPipelineOutput]]
```python
diffusers.pipelines.animatediff.AnimateDiffPipelineOutput(frames: typing.Union[torch.Tensor, numpy.ndarray, list[list[PIL.Image.Image]]])
```
[Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_output.py#L11)
**Parâmetros:**
frames (`torch.Tensor`, `np.ndarray` ou list[list[PIL.Image.Image]]) : lista de saídas de vídeo - Pode ser uma lista aninhada de comprimento `batch_size,` em que cada sublista contém
Classe de saída para pipelines do AnimateDiff.
Sequências de imagens PIL de comprimento `num_frames.` Também pode ser um array NumPy ou tensor Torch de forma `(batch_size, num_frames, channels, height, width)`