# Generasi Teks-ke-Video dengan AnimateDiff
## Ikhtisar
[AnimateDiff: Animasikan Model Difusi Teks-ke-Gambar Personal Anda Tanpa Penyetelan Spesifik](https://huggingface.co/papers/2307.04725) oleh Yuwei Guo, Ceyuan Yang, Anyi Rao, Yaohui Wang, Yu Qiao, Dahua Lin, Bo Dai.
Abstrak dari makalah tersebut adalah sebagai berikut:
*Dengan kemajuan model teks-ke-gambar (misalnya, Stable Diffusion) dan teknik personalisasi yang sesuai seperti DreamBooth dan LoRA, siapa pun dapat mewujudkan imajinasi mereka menjadi gambar berkualitas tinggi dengan biaya yang terjangkau. Selanjutnya, terdapat permintaan besar untuk teknik animasi gambar untuk lebih lanjut menggabungkan gambar statis yang dihasilkan dengan dinamika gerakan. Dalam laporan ini, kami mengusulkan kerangka kerja praktis untuk menganimasikan sebagian besar model teks-ke-gambar personalisasi yang ada sekali dan untuk selamanya, menghemat upaya dalam penyetelan yang spesifik model. Inti dari kerangka kerja yang diusulkan adalah menyisipkan modul pemodelan gerakan yang baru diinisialisasi ke dalam model teks-ke-gambar yang dibekukan dan melatihnya pada klip video untuk mendistilkan prior gerakan yang masuk akal. Setelah dilatih, dengan hanya menyuntikkan modul pemodelan gerakan ini, semua versi personalisasi yang diturunkan dari basis T2I yang sama dengan mudah menjadi model yang digerakkan oleh teks yang menghasilkan gambar animasi yang beragam dan personal. Kami melakukan evaluasi kami pada beberapa model teks-ke-gambar personalisasi publik yang representatif di seluruh gambar anime dan foto realistis, dan menunjukkan bahwa kerangka kerja yang kami usulkan membantu model-model ini menghasilkan klip animasi yang halus secara temporal sambil mempertahankan domain dan keragaman output mereka. Kode dan bobot pra-dilatih akan tersedia secara publik di [URL https ini](https://animatediff.github.io/).*
## Pipeline yang Tersedia
| Pipeline | Tugas | Demo
|---|---|:---:|
| [AnimateDiffPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py) | *Generasi Teks-ke-Video dengan AnimateDiff* |
| [AnimateDiffControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py) | *Generasi Video-ke-Video Terkontrol dengan AnimateDiff menggunakan ControlNet* |
| [AnimateDiffSparseControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py) | *Generasi Video-ke-Video Terkontrol dengan AnimateDiff menggunakan SparseCtrl* |
| [AnimateDiffSDXLPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py) | *Generasi Video-ke-Video dengan AnimateDiff* |
| [AnimateDiffVideoToVideoPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py) | *Generasi Video-ke-Video dengan AnimateDiff* |
| [AnimateDiffVideoToVideoControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py) | *Generasi Video-ke-Video dengan AnimateDiff menggunakan ControlNet* |
## Checkpoint yang tersedia
Checkpoint Motion Adapter dapat ditemukan di bawah [guoyww](https://huggingface.co/guoyww/). Checkpoint ini dimaksudkan untuk bekerja dengan model apa pun yang berbasis Stable Diffusion 1.4/1.5.
## Contoh penggunaan
### AnimateDiffPipeline
AnimateDiff bekerja dengan checkpoint MotionAdapter dan checkpoint model Stable Diffusion. MotionAdapter adalah kumpulan Motion Modules yang bertanggung jawab untuk menambahkan gerakan yang koheren di antara frame gambar. Modul-modul ini diterapkan setelah blok Resnet dan Attention dalam UNet Stable Diffusion.
Contoh berikut menunjukkan cara menggunakan checkpoint *MotionAdapter* dengan Diffusers untuk inferensi berdasarkan StableDiffusion-1.4/1.5.
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
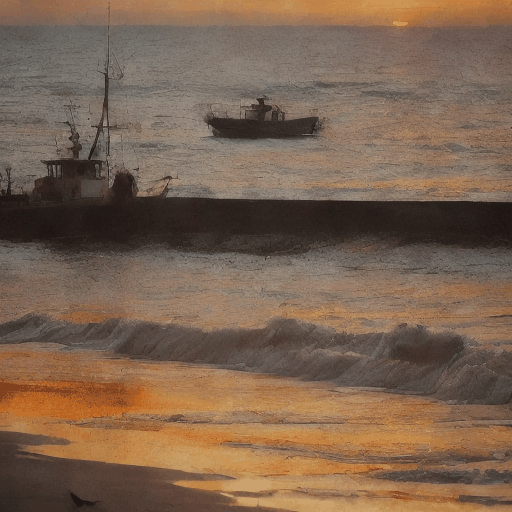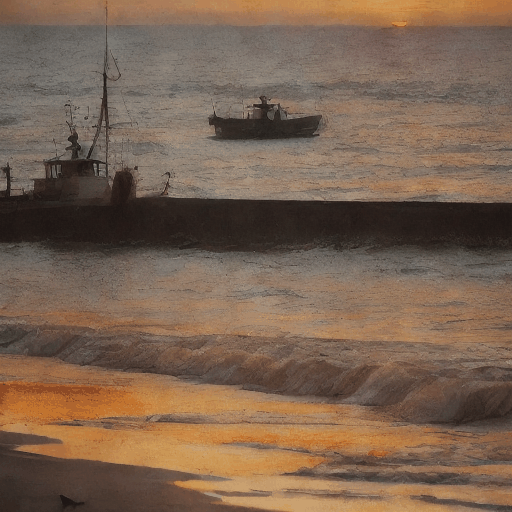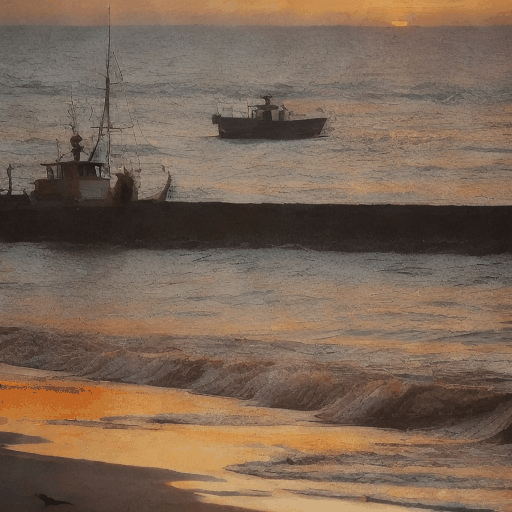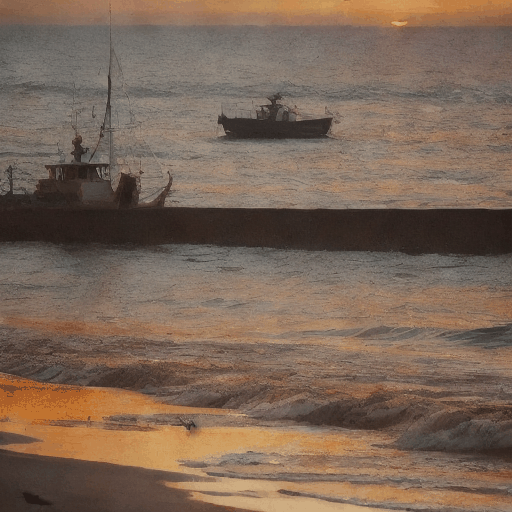
Berikut adalah beberapa contoh output:
masterpiece, bestquality, sunset.
 > [!TIP]
> AnimateDiff cenderung bekerja lebih baik dengan model Stable Diffusion yang telah difinetune. Jika Anda berencana menggunakan scheduler yang dapat memotong sampel, pastikan untuk menonaktifkannya dengan mengatur `clip_sample=False` pada scheduler karena hal ini juga dapat berdampak buruk pada sampel yang dihasilkan. Selain itu, checkpoint AnimateDiff dapat sensitif terhadap jadwal beta dari scheduler. Kami merekomendasikan untuk mengatur ini menjadi `linear`.
### AnimateDiffControlNetPipeline
AnimateDiff juga dapat digunakan dengan ControlNet. ControlNet diperkenalkan dalam [Menambahkan Kontrol Kondisional ke Model Difusi Teks-ke-Gambar](https://huggingface.co/papers/2302.05543) oleh Lvmin Zhang, Anyi Rao, dan Maneesh Agrawala. Dengan model ControlNet, Anda dapat menyediakan gambar kontrol tambahan untuk mengondisikan dan mengendalikan generasi Stable Diffusion. Misalnya, jika Anda menyediakan peta kedalaman, model ControlNet akan menghasilkan video yang mempertahankan informasi spasial dari peta kedalaman tersebut. Ini adalah cara yang lebih fleksibel dan akurat untuk mengendalikan proses generasi video.
```python
import torch
from diffusers import AnimateDiffControlNetPipeline, AutoencoderKL, ControlNetModel, MotionAdapter, LCMScheduler
from diffusers.utils import export_to_gif, load_video
# Additionally, you will need a preprocess videos before they can be used with the ControlNet
# HF maintains just the right package for it: `pip install controlnet_aux`
from controlnet_aux.processor import ZoeDetector
# Download controlnets from https://huggingface.co/lllyasviel/ControlNet-v1-1 to use .from_single_file
# Download Diffusers-format controlnets, such as https://huggingface.co/lllyasviel/sd-controlnet-depth, to use .from_pretrained()
controlnet = ControlNetModel.from_single_file("control_v11f1p_sd15_depth.pth", dtype=torch.float16)
# We use AnimateLCM for this example but one can use the original motion adapters as well (for example, https://huggingface.co/guoyww/animatediff-motion-adapter-v1-5-3)
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=torch.float16)
pipe: AnimateDiffControlNetPipeline = AnimateDiffControlNetPipeline.from_pretrained(
"SG161222/Realistic_Vision_V5.1_noVAE",
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
).to(device="cuda", dtype=torch.float16) # or "mps", "xpu", "cpu"
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm-lora")
pipe.set_adapters(["lcm-lora"], [0.8])
depth_detector = ZoeDetector.from_pretrained("lllyasviel/Annotators").to("cuda")
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-vid2vid-input-1.gif")
conditioning_frames = []
with pipe.progress_bar(total=len(video)) as progress_bar:
for frame in video:
conditioning_frames.append(depth_detector(frame))
progress_bar.update()
prompt = "a panda, playing a guitar, sitting in a pink boat, in the ocean, mountains in background, realistic, high quality"
negative_prompt = "bad quality, worst quality"
video = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_frames=len(video),
num_inference_steps=10,
guidance_scale=2.0,
conditioning_frames=conditioning_frames,
generator=torch.Generator().manual_seed(42),
).frames[0]
export_to_gif(video, "animatediff_controlnet.gif", fps=8)
```
Berikut adalah beberapa contoh output:
Video Sumber Video Output
raccoon bermain gitar
seorang panda, bermain gitar, duduk di perahu berwarna pink, di lautan, pegunungan di latar belakang, realistis, kualitas tinggi
### AnimateDiffSparseControlNetPipeline
[SparseCtrl: Menambahkan Kontrol Spars ke Model Difusi Teks-ke-Video](https://huggingface.co/papers/2311.16933) untuk mencapai generasi terkendali dalam model difusi teks-ke-video oleh Yuwei Guo, Ceyuan Yang, Anyi Rao, Maneesh Agrawala, Dahua Lin, dan Bo Dai.
Abstrak dari makalah tersebut adalah:
*Pengembangan text-to-video (T2V), yaitu menghasilkan video dengan prompt teks tertentu, telah mengalami kemajuan signifikan dalam beberapa tahun terakhir. Namun, ketergantungan hanya pada prompt teks sering kali menghasilkan komposisi frame yang ambigu karena ketidakpastian spasial. Oleh karena itu, komunitas riset memanfaatkan sinyal struktur yang padat, misalnya urutan kedalaman/tepi per frame, untuk meningkatkan keterkendalian, yang secara bersamaan meningkatkan beban inferensi. Dalam karya ini, kami memperkenalkan SparseCtrl untuk memungkinkan kontrol struktur yang fleksibel dengan sinyal yang jarang secara temporal, yang hanya memerlukan satu atau beberapa input, seperti yang ditunjukkan pada Gambar 1. Pendekatan ini mengintegrasikan encoder kondisi tambahan untuk memproses sinyal-sparse tersebut sambil membiarkan model T2V yang telah dilatih sebelumnya tetap utuh. Pendekatan yang diusulkan kompatibel dengan berbagai modalitas, termasuk sketsa, peta kedalaman, dan gambar RGB, sehingga memberikan kontrol yang lebih praktis untuk generasi video dan mendorong aplikasi seperti storyboarding, rendering kedalaman, animasi keyframe, dan interpolasi. Eksperimen ekstensif menunjukkan generalisasi SparseCtrl pada generator T2V asli maupun yang dipersonalisasi. Kode dan model akan tersedia secara publik di [URL https ini](https://guoyww.github.io/projects/SparseCtrl).*
SparseCtrl memperkenalkan checkpoint berikut untuk generasi teks-ke-video yang terkendali:
- [SparseCtrl Scribble](https://huggingface.co/guoyww/animatediff-sparsectrl-scribble)
- [SparseCtrl RGB](https://huggingface.co/guoyww/animatediff-sparsectrl-rgb)
#### Menggunakan SparseCtrl Scribble
```python
import torch
from diffusers import AnimateDiffSparseControlNetPipeline
from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
from diffusers.schedulers import DPMSolverMultistepScheduler
from diffusers.utils import export_to_gif, load_image
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
controlnet_id = "guoyww/animatediff-sparsectrl-scribble"
lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
vae_id = "stabilityai/sd-vae-ft-mse"
device = "cuda" # or "mps", "xpu", "cpu"
motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, dtype=torch.float16).to(device)
controlnet = SparseControlNetModel.from_pretrained(controlnet_id, dtype=torch.float16).to(device)
vae = AutoencoderKL.from_pretrained(vae_id, dtype=torch.float16).to(device)
scheduler = DPMSolverMultistepScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
algorithm_type="dpmsolver++",
use_karras_sigmas=True,
)
pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
model_id,
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
scheduler=scheduler,
dtype=torch.float16,
).to(device)
pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
pipe.fuse_lora(lora_scale=1.0)
prompt = "an aerial view of a cyberpunk city, night time, neon lights, masterpiece, high quality"
negative_prompt = "low quality, worst quality, letterboxed"
image_files = [
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-1.png",
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-2.png",
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-3.png"
]
condition_frame_indices = [0, 8, 15]
conditioning_frames = [load_image(img_file) for img_file in image_files]
video = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_inference_steps=25,
conditioning_frames=conditioning_frames,
controlnet_conditioning_scale=1.0,
controlnet_frame_indices=condition_frame_indices,
generator=torch.Generator().manual_seed(1337),
).frames[0]
export_to_gif(video, "output.gif")
```
Berikut adalah beberapa contoh output:
pandangan udara kota cyberpunk, waktu malam, lampu neon, mahakarya, kualitas tinggi
#### Menggunakan SparseCtrl RGB
```python
import torch
from diffusers import AnimateDiffSparseControlNetPipeline
from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
from diffusers.schedulers import DPMSolverMultistepScheduler
from diffusers.utils import export_to_gif, load_image
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
controlnet_id = "guoyww/animatediff-sparsectrl-rgb"
lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
vae_id = "stabilityai/sd-vae-ft-mse"
device = "cuda" # or "mps", "xpu", "cpu"
motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, dtype=torch.float16).to(device)
controlnet = SparseControlNetModel.from_pretrained(controlnet_id, dtype=torch.float16).to(device)
vae = AutoencoderKL.from_pretrained(vae_id, dtype=torch.float16).to(device)
scheduler = DPMSolverMultistepScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
algorithm_type="dpmsolver++",
use_karras_sigmas=True,
)
pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
model_id,
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
scheduler=scheduler,
dtype=torch.float16,
).to(device)
pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-firework.png")
video = pipe(
prompt="closeup face photo of man in black clothes, night city street, bokeh, fireworks in background",
negative_prompt="low quality, worst quality",
num_inference_steps=25,
conditioning_frames=image,
controlnet_frame_indices=[0],
controlnet_conditioning_scale=1.0,
generator=torch.Generator().manual_seed(42),
).frames[0]
export_to_gif(video, "output.gif")
```
Berikut adalah beberapa contoh output:
foto close-up wajah pria berpakaian hitam, jalanan kota malam, bokeh, kembang api di latar belakang
### AnimateDiffSDXLPipeline
AnimateDiff juga dapat digunakan dengan model SDXL. Saat ini, ini adalah fitur eksperimental karena hanya checkpoint motion adapter versi beta yang tersedia.
```python
import torch
from diffusers.models import MotionAdapter
from diffusers import AnimateDiffSDXLPipeline, DDIMScheduler
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-sdxl-beta", dtype=torch.float16)
model_id = "stabilityai/stable-diffusion-xl-base-1.0"
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe = AnimateDiffSDXLPipeline.from_pretrained(
model_id,
motion_adapter=adapter,
scheduler=scheduler,
dtype=torch.float16,
variant="fp16",
).to("cuda") # or "mps", "xpu", "cpu"
# enable memory savings
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()
output = pipe(
prompt="a panda surfing in the ocean, realistic, high quality",
negative_prompt="low quality, worst quality",
num_inference_steps=20,
guidance_scale=8,
width=1024,
height=1024,
num_frames=16,
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
### AnimateDiffVideoToVideoPipeline
AnimateDiff juga dapat digunakan untuk menghasilkan video yang secara visual mirip atau memungkinkan pengeditan gaya/karakter/latar belakang atau lainnya yang dimulai dari video awal, sehingga Anda dapat menjelajahi kemungkinan kreatif secara mulus.
```python
import imageio
import requests
import torch
from diffusers import AnimateDiffVideoToVideoPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
from io import BytesIO
from PIL import Image
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffVideoToVideoPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
# helper function to load videos
def load_video(file_path: str):
images = []
if file_path.startswith(('http://', 'https://')):
# If the file_path is a URL
response = requests.get(file_path)
response.raise_for_status()
content = BytesIO(response.content)
vid = imageio.get_reader(content)
else:
# Assuming it's a local file path
vid = imageio.get_reader(file_path)
for frame in vid:
pil_image = Image.fromarray(frame)
images.append(pil_image)
return images
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-vid2vid-input-1.gif")
output = pipe(
video = video,
prompt="panda playing a guitar, on a boat, in the ocean, high quality",
negative_prompt="bad quality, worse quality",
guidance_scale=7.5,
num_inference_steps=25,
strength=0.5,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
Berikut adalah beberapa contoh output:
Video Sumber Video Output
raccoon bermain gitar
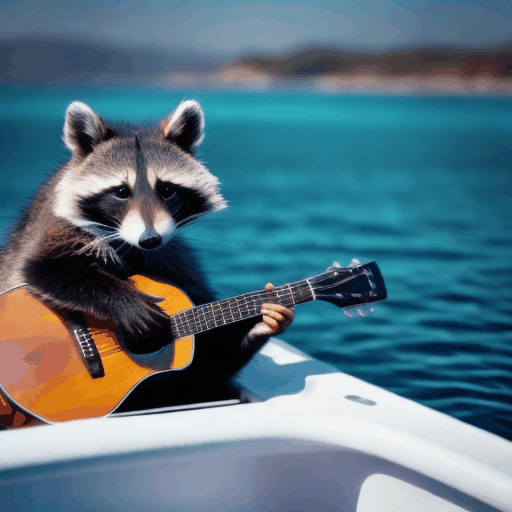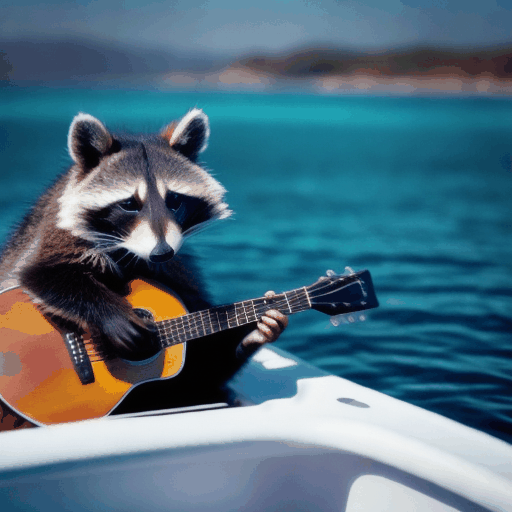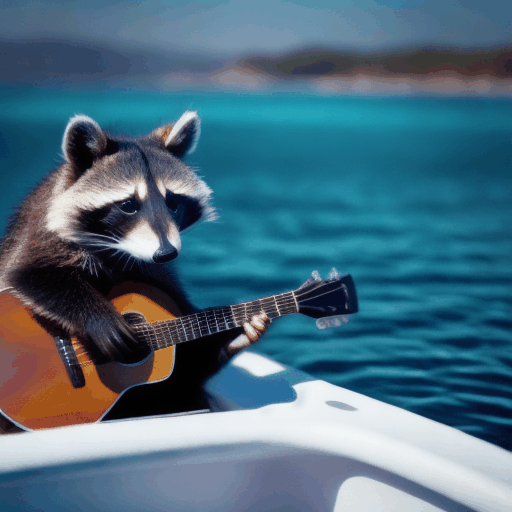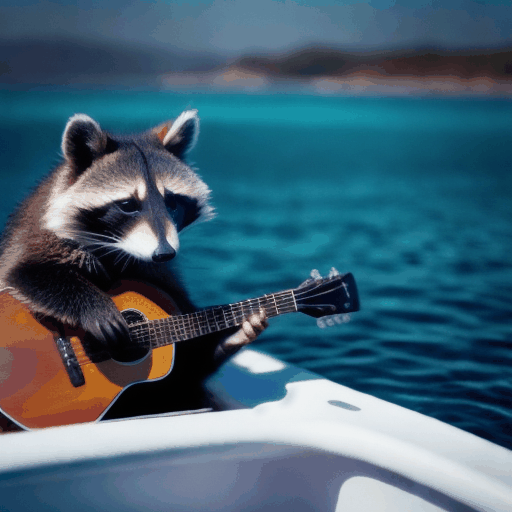 panda bermain gitar
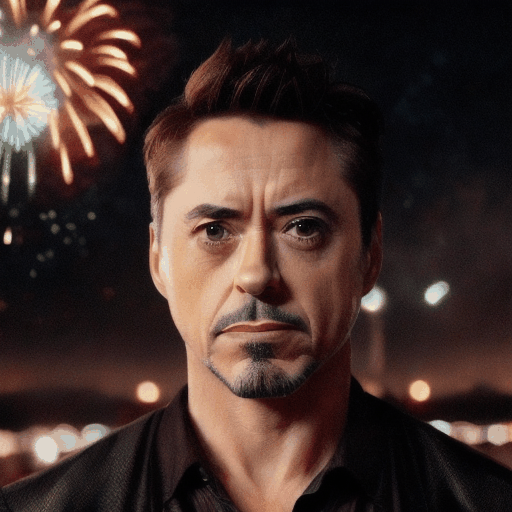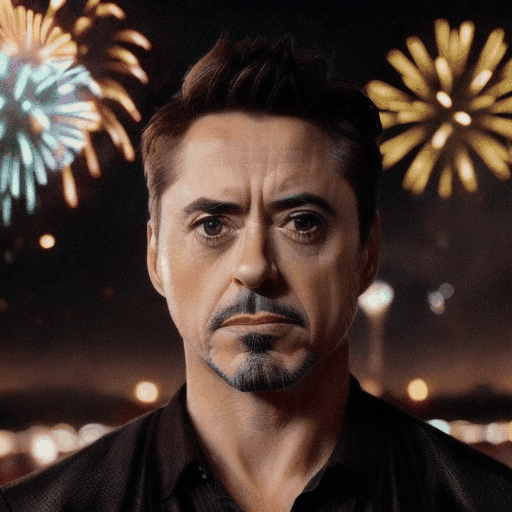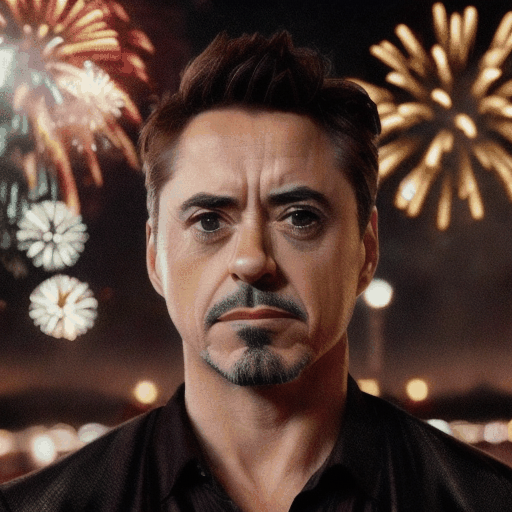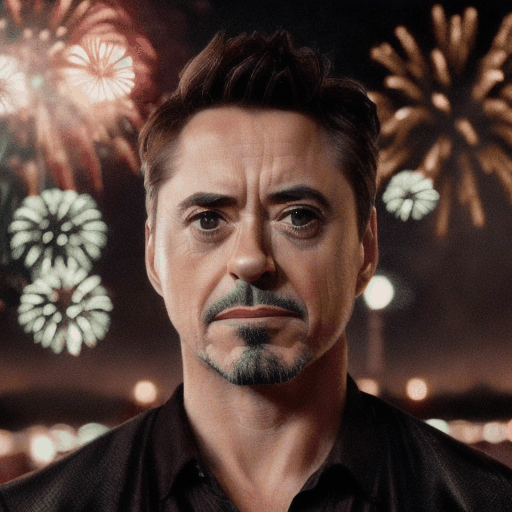
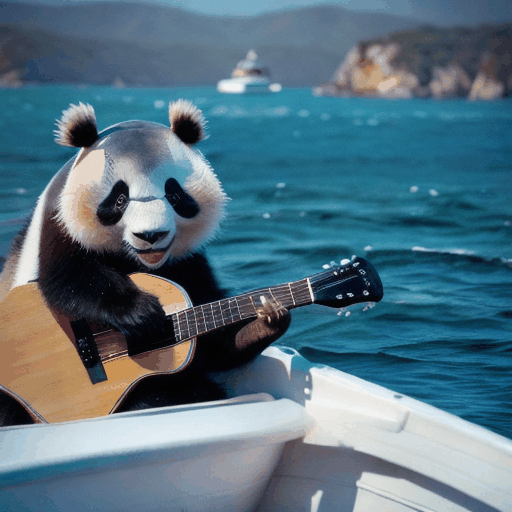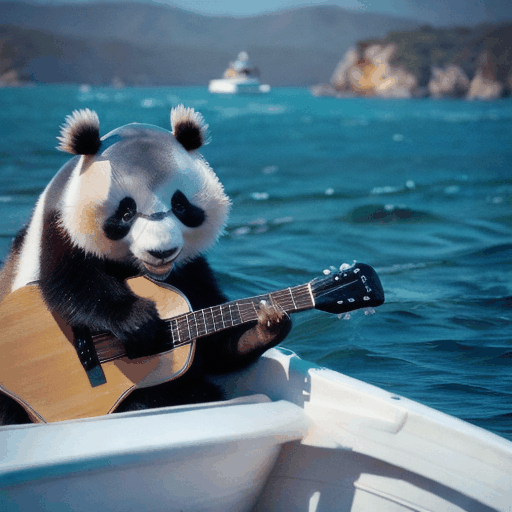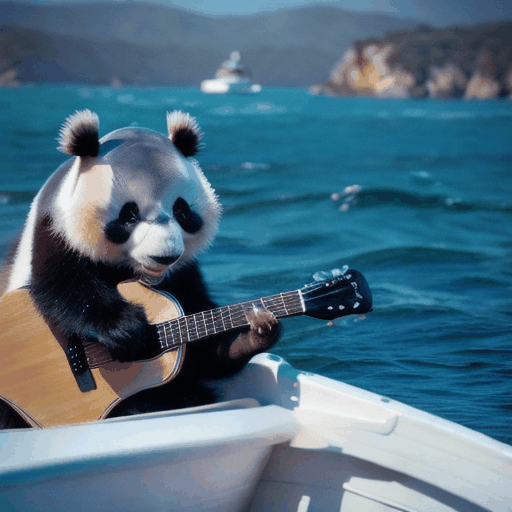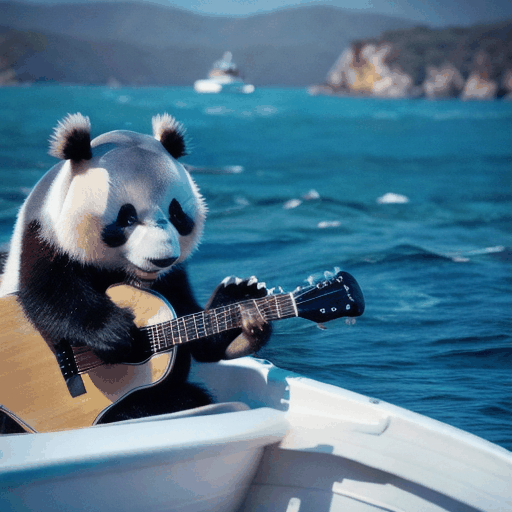 closeup dari margot robbie, kembang api di latar belakang, kualitas tinggi
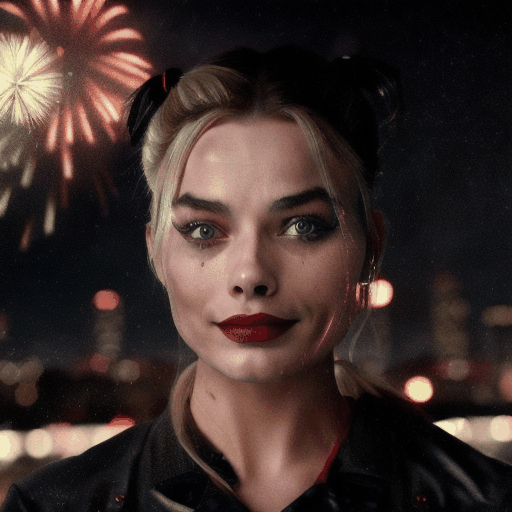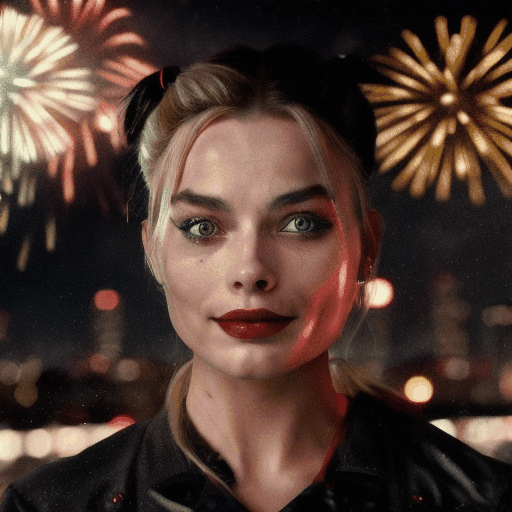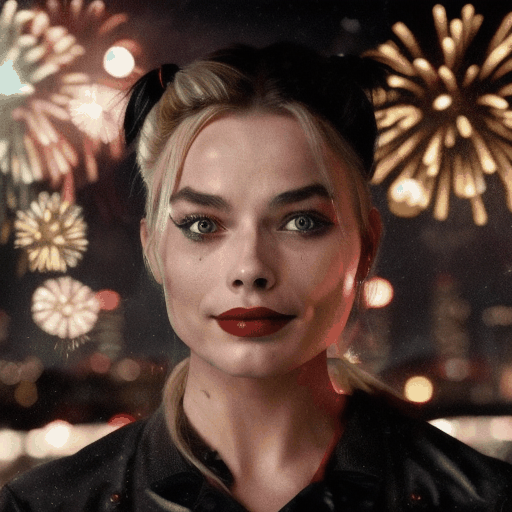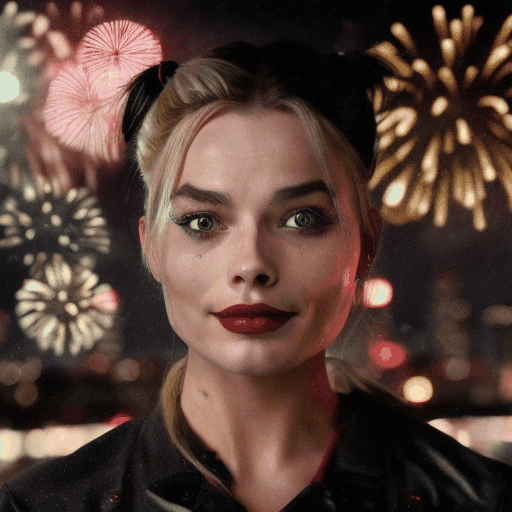 closeup dari tony stark, robert downey jr, kembang api
 ### AnimateDiffVideoToVideoControlNetPipeline
AnimateDiff dapat digunakan bersama ControlNet untuk meningkatkan generasi video-ke-video dengan memungkinkan kontrol yang presisi atas output. ControlNet diperkenalkan dalam [Menambahkan Kontrol Kondisional ke Model Difusi Teks-ke-Gambar](https://huggingface.co/papers/2302.05543) oleh Lvmin Zhang, Anyi Rao, dan Maneesh Agrawala, dan memungkinkan Anda mengondisikan Stable Diffusion dengan gambar kontrol tambahan untuk memastikan bahwa informasi spasial dipertahankan di seluruh video.
Pipeline ini memungkinkan Anda untuk mengondisikan generasi Anda baik pada video asli maupun pada urutan gambar kontrol.
```python
import torch
from PIL import Image
from tqdm.auto import tqdm
from controlnet_aux.processor import OpenposeDetector
from diffusers import AnimateDiffVideoToVideoControlNetPipeline
from diffusers.utils import export_to_gif, load_video
from diffusers import AutoencoderKL, ControlNetModel, MotionAdapter, LCMScheduler
# Load the ControlNet
controlnet = ControlNetModel.from_pretrained("lllyasviel/sd-controlnet-openpose", dtype=torch.float16)
# Load the motion adapter
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
# Load SD 1.5 based finetuned model
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=torch.float16)
pipe = AnimateDiffVideoToVideoControlNetPipeline.from_pretrained(
"SG161222/Realistic_Vision_V5.1_noVAE",
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
).to(device="cuda", dtype=torch.float16) # or "mps", "xpu", "cpu"
# Enable LCM to speed up inference
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm-lora")
pipe.set_adapters(["lcm-lora"], [0.8])
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/dance.gif")
video = [frame.convert("RGB") for frame in video]
prompt = "astronaut in space, dancing"
negative_prompt = "bad quality, worst quality, jpeg artifacts, ugly"
# Create controlnet preprocessor
open_pose = OpenposeDetector.from_pretrained("lllyasviel/Annotators").to("cuda")
# Preprocess controlnet images
conditioning_frames = []
for frame in tqdm(video):
conditioning_frames.append(open_pose(frame))
strength = 0.8
with torch.inference_mode():
video = pipe(
video=video,
prompt=prompt,
negative_prompt=negative_prompt,
num_inference_steps=10,
guidance_scale=2.0,
controlnet_conditioning_scale=0.75,
conditioning_frames=conditioning_frames,
strength=strength,
generator=torch.Generator().manual_seed(42),
).frames[0]
video = [frame.resize(conditioning_frames[0].size) for frame in video]
export_to_gif(video, f"animatediff_vid2vid_controlnet.gif", fps=8)
```
Berikut adalah beberapa contoh output:
Video Sumber Video Output
gadis anime, menari
astronaut di luar angkasa, menari
**Lampu dan komposisi dipindahkan dari Video Sumber.**
## Menggunakan Motion LoRAs
Motion LoRAs adalah kumpulan LoRAs yang bekerja dengan checkpoint `guoyww/animatediff-motion-adapter-v1-5-2`. LoRAs ini bertanggung jawab untuk menambahkan jenis gerakan tertentu ke dalam animasi.
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
pipe.load_lora_weights(
"guoyww/animatediff-motion-lora-zoom-out", adapter_name="zoom-out"
)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
beta_schedule="linear",
timestep_spacing="linspace",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
masterpiece, bestquality, sunset.
 ## Menggunakan Motion LoRAs dengan PEFT
Anda juga dapat memanfaatkan backend [PEFT](https://github.com/huggingface/peft) untuk menggabungkan Motion LoRA dan membuat animasi yang lebih kompleks.
Pertama, instal PEFT dengan
```shell
pip install peft
```
Lalu Anda dapat menggunakan kode berikut untuk menggabungkan Motion LoRAs.
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
pipe.load_lora_weights(
"diffusers/animatediff-motion-lora-zoom-out", adapter_name="zoom-out",
)
pipe.load_lora_weights(
"diffusers/animatediff-motion-lora-pan-left", adapter_name="pan-left",
)
pipe.set_adapters(["zoom-out", "pan-left"], adapter_weights=[1.0, 1.0])
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
masterpiece, bestquality, sunset.
 ## Menggunakan FreeInit
[FreeInit: Menjembatani Kesenjangan Inisialisasi pada Model Difusi Video](https://huggingface.co/papers/2312.07537) oleh Tianxing Wu, Chenyang Si, Yuming Jiang, Ziqi Huang, Ziwei Liu.
FreeInit adalah metode efektif yang meningkatkan konsistensi temporal dan kualitas keseluruhan video yang dihasilkan menggunakan video-diffusion-models tanpa pelatihan tambahan. Metode ini dapat diterapkan pada AnimateDiff, ModelScope, VideoCrafter, dan berbagai model generasi video lainnya secara mulus pada saat inferensi, dan bekerja dengan cara menyempurnakan noise inisialisasi laten secara iteratif. Detail lebih lanjut dapat ditemukan di makalah tersebut.
Contoh berikut menunjukkan penggunaan FreeInit.
```python
import torch
from diffusers import MotionAdapter, AnimateDiffPipeline, DDIMScheduler
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2")
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16).to("cuda") # or "mps", "xpu", "cpu"
pipe.scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
clip_sample=False,
timestep_spacing="linspace",
steps_offset=1
)
# enable memory savings
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()
# enable FreeInit
# Refer to the enable_free_init documentation for a full list of configurable parameters
pipe.enable_free_init(method="butterworth", use_fast_sampling=True)
# run inference
output = pipe(
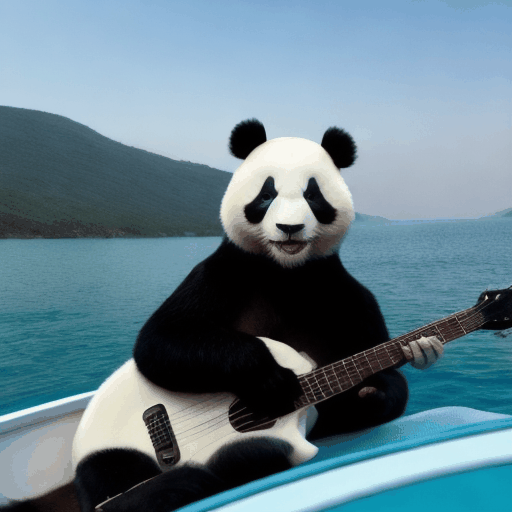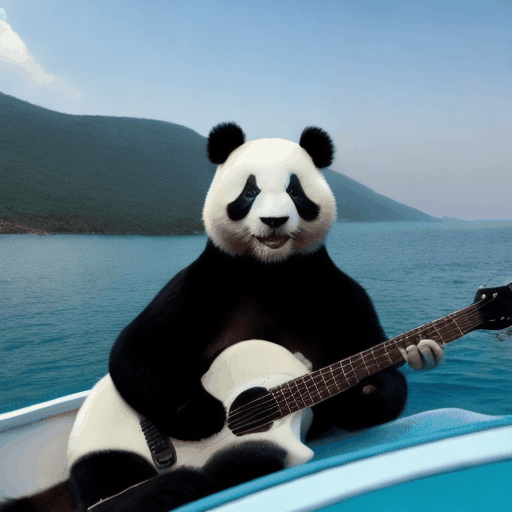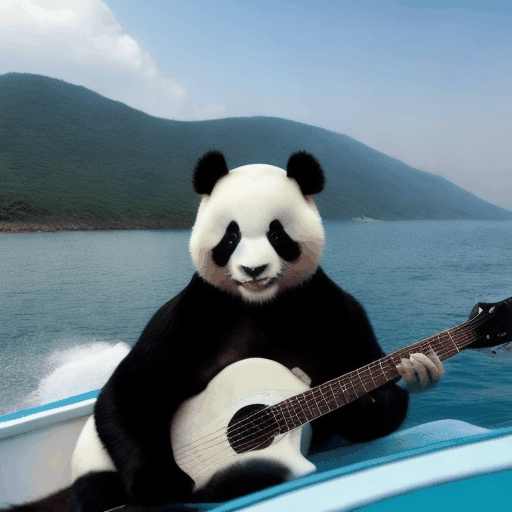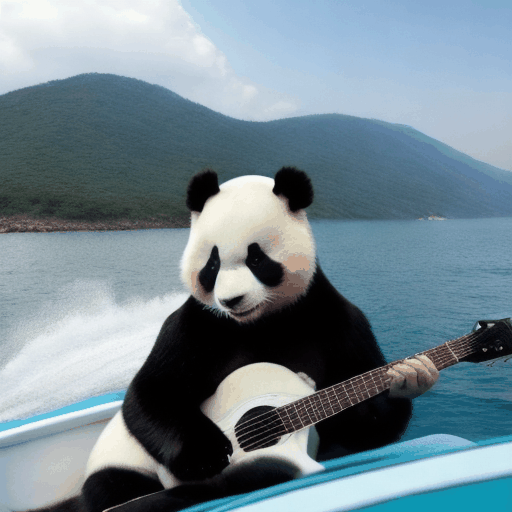
prompt="a panda playing a guitar, on a boat, in the ocean, high quality",
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=20,
generator=torch.Generator("cpu").manual_seed(666),
)
# disable FreeInit
pipe.disable_free_init()
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
> [!WARNING]
> FreeInit sebenarnya tidak benar-benar gratis - peningkatan kualitas datang dengan biaya komputasi tambahan. Metode ini memerlukan beberapa kali sampling ekstra tergantung pada parameter `num_iters` yang diatur saat mengaktifkannya. Mengatur parameter `use_fast_sampling` menjadi `True` dapat meningkatkan kinerja keseluruhan (dengan mengorbankan kualitas yang lebih rendah dibandingkan saat `use_fast_sampling=False` tetapi masih memberikan hasil yang lebih baik daripada model generasi video biasa).
> [!TIP]
> Pastikan untuk melihat [panduan](../../using-diffusers/schedulers) Schedulers untuk mempelajari cara mengeksplorasi tradeoff antara kecepatan dan kualitas scheduler, serta lihat bagian [reuse components across pipelines](../../using-diffusers/loading#reusing-models-in-multiple-pipelines) untuk mempelajari cara memuat komponen yang sama secara efisien ke dalam beberapa pipeline.
Tanpa FreeInit diaktifkan Dengan FreeInit diaktifkan
panda bermain gitar
 panda bermain gitar
 ## Menggunakan AnimateLCM
[AnimateLCM](https://animatelcm.github.io/) adalah checkpoint modul gerak dan [LCM LoRA](https://huggingface.co/docs/diffusers/using-diffusers/inference_with_lcm_lora) yang dibuat menggunakan strategi pembelajaran konsistensi yang memisahkan distilasi prior generasi gambar dan prior generasi gerak.
```python
import torch
from diffusers import AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="sd15_lora_beta.safetensors", adapter_name="lcm-lora")
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
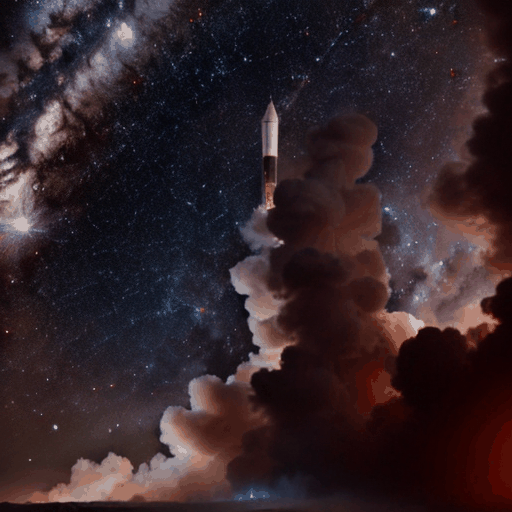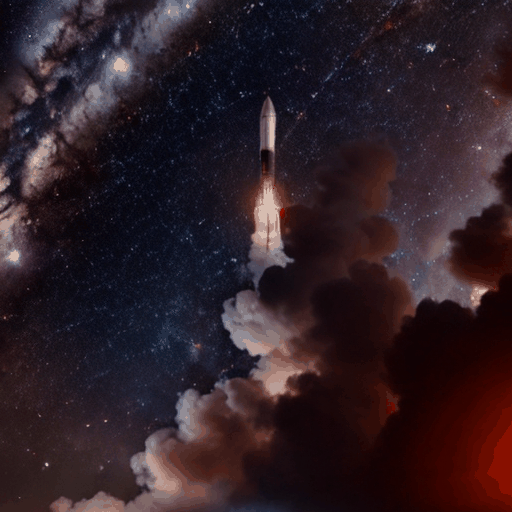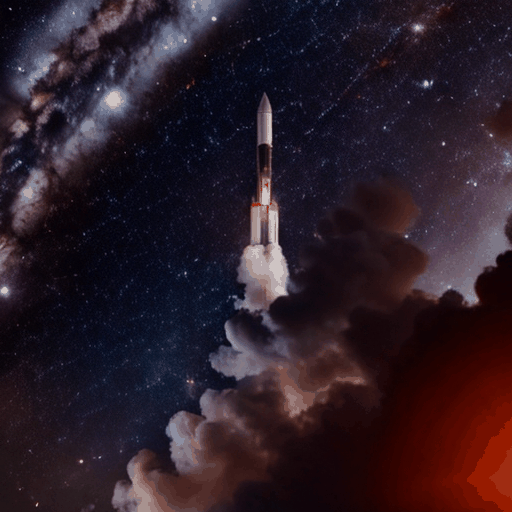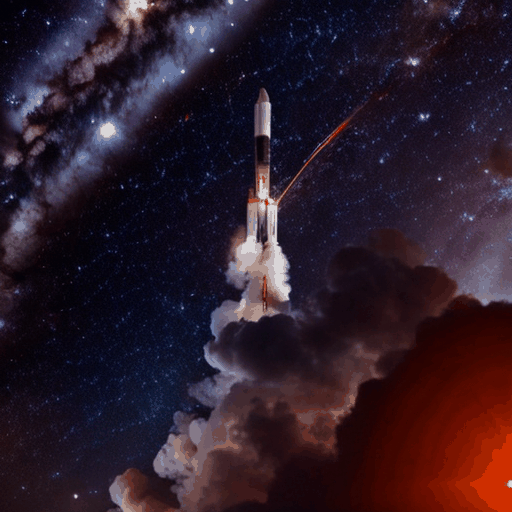
prompt="A space rocket with trails of smoke behind it launching into space from the desert, 4k, high resolution",
negative_prompt="bad quality, worse quality, low resolution",
num_frames=16,
guidance_scale=1.5,
num_inference_steps=6,
generator=torch.Generator("cpu").manual_seed(0),
)
frames = output.frames[0]
export_to_gif(frames, "animatelcm.gif")
```
Roket antariksa, 4K.
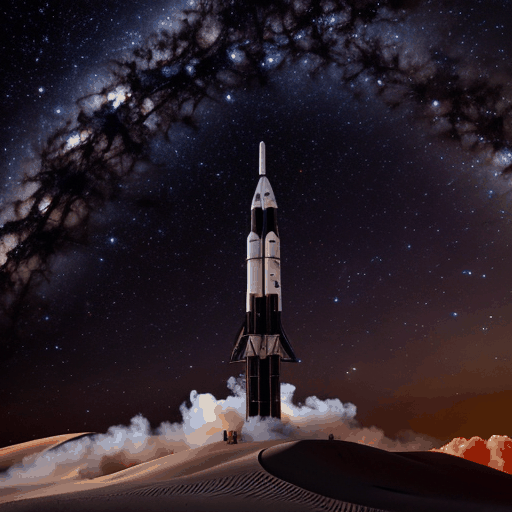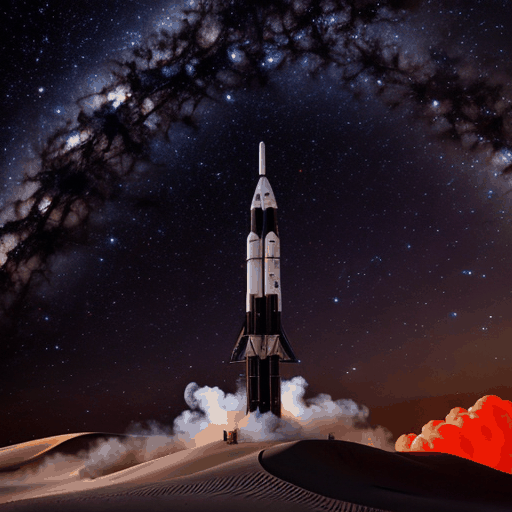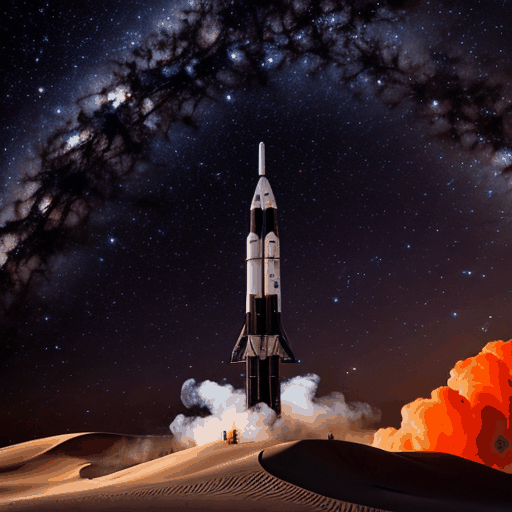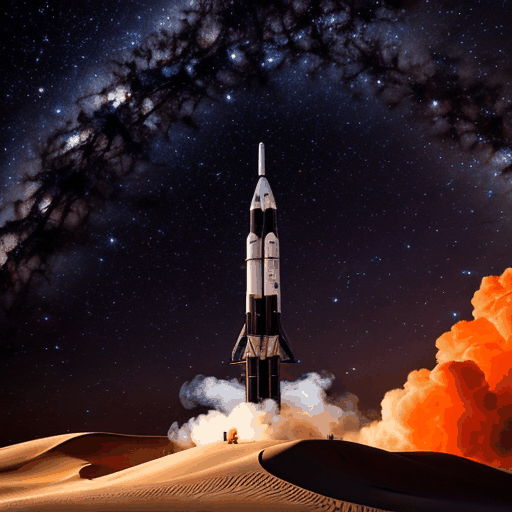 AnimateLCM juga kompatibel dengan [Motion LoRAs](https://huggingface.co/collections/dn6/animatediff-motion-loras-654cb8ad732b9e3cf4d3c17e) yang sudah ada.
```python
import torch
from diffusers import AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="sd15_lora_beta.safetensors", adapter_name="lcm-lora")
pipe.load_lora_weights("guoyww/animatediff-motion-lora-tilt-up", adapter_name="tilt-up")
pipe.set_adapters(["lcm-lora", "tilt-up"], [1.0, 0.8])
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt="A space rocket with trails of smoke behind it launching into space from the desert, 4k, high resolution",
negative_prompt="bad quality, worse quality, low resolution",
num_frames=16,
guidance_scale=1.5,
num_inference_steps=6,
generator=torch.Generator("cpu").manual_seed(0),
)
frames = output.frames[0]
export_to_gif(frames, "animatelcm-motion-lora.gif")
```
Roket antariksa, 4K.
 ## Menggunakan FreeNoise
[FreeNoise: Tuning-Free Longer Video Diffusion via Noise Rescheduling](https://huggingface.co/papers/2310.15169) oleh Haonan Qiu, Menghan Xia, Yong Zhang, Yingqing He, Xintao Wang, Ying Shan, Ziwei Liu.
FreeNoise adalah mekanisme sampling yang dapat menghasilkan video lebih panjang dengan model generasi video pendek melalui penerapan penjadwalan ulang noise, perhatian temporal di atas jendela geser, dan rata-rata berbobot dari frame laten. Mekanisme ini juga dapat digunakan dengan beberapa prompt untuk memungkinkan generasi video yang diinterpolasi. Detail lebih lanjut tersedia di makalah tersebut.
Pipeline AnimateDiff yang saat ini didukung dan dapat digunakan dengan FreeNoise adalah:
- [AnimateDiffPipeline](/docs/diffusers/v0.43.0/id/api/pipelines/animatediff#diffusers.AnimateDiffPipeline)
- [AnimateDiffControlNetPipeline](/docs/diffusers/v0.43.0/id/api/pipelines/animatediff#diffusers.AnimateDiffControlNetPipeline)
- [AnimateDiffVideoToVideoPipeline](/docs/diffusers/v0.43.0/id/api/pipelines/animatediff#diffusers.AnimateDiffVideoToVideoPipeline)
- [AnimateDiffVideoToVideoControlNetPipeline](/docs/diffusers/v0.43.0/id/api/pipelines/animatediff#diffusers.AnimateDiffVideoToVideoControlNetPipeline)
Untuk menggunakan FreeNoise, satu baris perlu ditambahkan ke kode inferensi setelah memuat pipeline Anda.
```diff
+ pipe.enable_free_noise()
```
Setelah ini, satu prompt dapat digunakan, atau beberapa prompt dapat diteruskan sebagai kamus pasangan integer-string. Kunci integer dari kamus tersebut sesuai dengan indeks frame di mana pengaruh prompt tersebut akan maksimal. Setiap indeks frame harus dipetakan ke satu prompt string. Prompt untuk indeks frame antara, yang tidak diteruskan dalam kamus, dibuat dengan interpolasi antara prompt frame yang diteruskan. Secara default, interpolasi linear sederhana digunakan. Namun, Anda dapat menyesuaikan perilaku ini dengan callback ke parameter `prompt_interpolation_callback` saat mengaktifkan FreeNoise.
Contoh lengkap:
```python
import torch
from diffusers import AutoencoderKL, AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_video, load_image
# Load pipeline
dtype = torch.float16
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM", dtype=dtype)
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=dtype)
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=motion_adapter, vae=vae, dtype=dtype)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights(
"wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm_lora"
)
pipe.set_adapters(["lcm_lora"], [0.8])
# Enable FreeNoise for long prompt generation
pipe.enable_free_noise(context_length=16, context_stride=4)
pipe.to("cuda") # or "mps", "xpu", "cpu"
# Can be a single prompt, or a dictionary with frame timesteps
prompt = {
0: "A caterpillar on a leaf, high quality, photorealistic",
40: "A caterpillar transforming into a cocoon, on a leaf, near flowers, photorealistic",
80: "A cocoon on a leaf, flowers in the background, photorealistic",
120: "A cocoon maturing and a butterfly being born, flowers and leaves visible in the background, photorealistic",
160: "A beautiful butterfly, vibrant colors, sitting on a leaf, flowers in the background, photorealistic",
200: "A beautiful butterfly, flying away in a forest, photorealistic",
240: "A cyberpunk butterfly, neon lights, glowing",
}
negative_prompt = "bad quality, worst quality, jpeg artifacts"
# Run inference
output = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_frames=256,
guidance_scale=2.5,
num_inference_steps=10,
generator=torch.Generator("cpu").manual_seed(0),
)
# Save video
frames = output.frames[0]
export_to_video(frames, "output.mp4", fps=16)
```
### Penghematan memori FreeNoise
Karena FreeNoise memproses beberapa frame secara bersamaan, ada bagian dalam pemodelan di mana memori yang dibutuhkan melebihi yang tersedia pada GPU konsumen biasa. Botol leher memori utama yang kami identifikasi adalah blok perhatian spasial dan temporal, blok upsampling dan downsampling, blok resnet, serta lapisan feed-forward. Karena sebagian besar blok ini beroperasi secara efektif hanya pada dimensi channel/embedding, seseorang dapat melakukan inferensi chunked melintasi dimensi batch. Dimensi batch dalam AnimateDiff bersifat spasial (`[B x F, H x W, C]`) atau temporal (`B x H x W, F, C`) (perhatikan bahwa ini mungkin tampak kontra-intuitif, tetapi dimensi batch di sini benar, karena blok spasial memproses melintasi dimensi `B x F` sementara blok temporal memproses melintasi dimensi `B x H x W`). Kami memperkenalkan `SplitInferenceModule` yang memudahkan untuk melakukan chunking melintasi dimensi apa pun dan menjalankan inferensi. Ini menghemat banyak memori tetapi datang dengan biaya waktu inferensi yang lebih lama.
```diff
# Load pipeline and adapters
# ...
+ pipe.enable_free_noise_split_inference()
+ pipe.unet.enable_forward_chunking(16)
```
Pemanggilan metode `pipe.enable_free_noise_split_inference` menerima dua parameter: `spatial_split_size` (default `256`) dan `temporal_split_size` (default `16`). Nilai-nilai ini dapat dikonfigurasi berdasarkan jumlah VRAM yang tersedia. Ukuran split yang lebih kecil menghasilkan penggunaan memori yang lebih rendah tetapi inferensi yang lebih lambat, sedangkan ukuran split yang lebih besar menghasilkan inferensi yang lebih cepat dengan biaya penggunaan memori yang lebih tinggi.
## Menggunakan `from_single_file` dengan MotionAdapter
`diffusers>=0.30.0` mendukung pemuatan checkpoint AnimateDiff ke dalam `MotionAdapter` dalam format aslinya melalui `from_single_file`
```python
from diffusers import MotionAdapter
ckpt_path = "https://huggingface.co/Lightricks/LongAnimateDiff/blob/main/lt_long_mm_32_frames.ckpt"
adapter = MotionAdapter.from_single_file(ckpt_path, dtype=torch.float16)
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
```
## AnimateDiffPipeline[[diffusers.AnimateDiffPipeline]]
#### diffusers.AnimateDiffPipeline[[diffusers.AnimateDiffPipeline]]
```python
diffusers.AnimateDiffPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L78)
**Parameter:**
vae ([AutoencoderKL](/docs/diffusers/v0.43.0/id/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Model Variational Auto-Encoder (VAE) untuk mengodekan dan mendekodekan gambar ke dan dari representasi laten.
text_encoder (`CLIPTextModel`) : text-encoder beku ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : Sebuah [CLIPTokenizer](https://huggingface.co/docs/transformers/v5.22.2/en/model_doc/clip#transformers.CLIPTokenizer) untuk melakukan tokenisasi teks.
unet ([UNet2DConditionModel](/docs/diffusers/v0.43.0/id/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Sebuah [UNet2DConditionModel](/docs/diffusers/v0.43.0/id/api/models/unet2d-cond#diffusers.UNet2DConditionModel) yang digunakan untuk membuat UNetMotionModel guna mendenois latens video yang telah dikodekan.
motion_adapter (`MotionAdapter`) : Sebuah `MotionAdapter` yang digunakan bersama dengan `unet` untuk menghilangkan noise pada latens video yang telah dikodekan.
scheduler ([SchedulerMixin](/docs/diffusers/v0.43.0/id/api/schedulers/overview#diffusers.SchedulerMixin)) : Penjadwal yang digunakan bersama `unet` untuk menghilangkan noise pada latens gambar yang telah dikodekan. Bisa berupa [DDIMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler), atau [PNDMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/pndm#diffusers.PNDMScheduler).
Pipeline untuk generasi teks-ke-video.
Model ini mewarisi dari [DiffusionPipeline](/docs/diffusers/v0.43.0/id/api/pipelines/overview#diffusers.DiffusionPipeline). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan untuk semua pipeline (mengunduh, menyimpan, menjalankan pada perangkat tertentu, dll.).
Pipeline juga mewarisi metode pemuatan berikut:
- [load_textual_inversion()](/docs/diffusers/v0.43.0/id/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) untuk memuat embedding textual inversion
- [load_lora_weights()](/docs/diffusers/v0.43.0/id/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) untuk memuat bobot LoRA
- [save_lora_weights()](/docs/diffusers/v0.43.0/id/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) untuk menyimpan bobot LoRA
- [load_ip_adapter()](/docs/diffusers/v0.43.0/id/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) untuk memuat IP Adapter
#### __call__[[diffusers.AnimateDiffPipeline.__call__]]
```python
__call__(prompt: str | list[str] | None = None, num_frames: int | None = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'], decode_chunk_size: int = 16, **kwargs)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L571)
**Parameter:**
prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt untuk memandu generasi gambar. Jika tidak didefinisikan, Anda perlu meneruskan `prompt_embeds`.
height (`int`, *opsional*, defaultnya `self.unet.config.sample_size * self.vae_scale_factor`) : Tinggi video yang dihasilkan dalam piksel.
width (`int`, *opsional*, defaultnya `self.unet.config.sample_size * self.vae_scale_factor`) : Lebar video yang dihasilkan dalam piksel.
num_frames (`int`, *opsional*, default 16) : Jumlah bingkai video yang dihasilkan. Defaultnya adalah 16 bingkai, yang pada 8 bingkai per detik setara dengan 2 detik video.
num_inference_steps (`int`, *opsional*, defaultnya 50) : Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan video dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat.
guidance_scale (`float`, *opsional*, default 7.5) : Nilai guidance scale yang lebih tinggi mendorong model untuk menghasilkan gambar yang sangat terkait dengan `prompt` teks, dengan mengorbankan kualitas gambar yang lebih rendah. Guidance scale diaktifkan ketika `guidance_scale > 1`.
negative_prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt untuk mengarahkan apa yang tidak boleh disertakan dalam pembuatan gambar. Jika tidak didefinisikan, Anda perlu meneruskan `negative_prompt_embeds` sebagai gantinya. Diabaikan saat tidak menggunakan panduan (`guidance_scale < 1`).
num_videos_per_prompt (`int`, *opsional*, default 1) : Jumlah video yang akan dihasilkan per prompt.
eta (`float`, *opsional*, default 0.0) : Bersesuaian dengan parameter eta (η) dari paper [DDIM](https://huggingface.co/papers/2010.02502). Hanya berlaku untuk [DDIMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/ddim#diffusers.DDIMScheduler), dan diabaikan pada scheduler lainnya.
generator (`torch.Generator` atau `list[torch.Generator]`, *opsional*) : Sebuah [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) untuk membuat proses generasi menjadi deterministik.
latents (`torch.Tensor`, *opsional*) : Laten berisik yang telah dibuat sebelumnya, diambil dari distribusi Gaussian, untuk digunakan sebagai input untuk generasi video. Dapat digunakan untuk menyesuaikan generasi yang sama dengan prompt yang berbeda. Jika tidak disediakan, tensor laten akan dibuat dengan pengambilan sampel menggunakan `generator` acak yang diberikan. Laten harus memiliki bentuk `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks (pemberian bobot pada prompt). Jika tidak disediakan, embedding teks akan dihasilkan dari argumen input `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks negatif yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks (pemberian bobot pada prompt). Jika tidak disediakan, `negative_prompt_embeds` akan dibuat dari argumen input `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`, *opsional*): Input gambar opsional untuk bekerja dengan IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opsional*) : Embedding gambar yang telah dibuat sebelumnya untuk IP-Adapter. Ini harus berupa daftar dengan panjang yang sama dengan jumlah IP-adapter. Setiap elemen harus berupa tensor dengan bentuk `(batch_size, num_images, emb_dim)`. Embedding gambar negatif harus disertakan jika `do_classifier_free_guidance` diatur ke `True`. Jika tidak disediakan, embedding dihitung dari argumen input `ip_adapter_image`.
output_type (`str`, *opsional*, defaultnya `"pil"`) : Format output dari video yang dihasilkan. Pilih antara `torch.Tensor`, `PIL.Image` atau `np.array`.
return_dict (`bool`, *opsional*, defaultnya `True`) : Apakah akan mengembalikan `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput` alih-alih tuple biasa.
cross_attention_kwargs (`dict`, *opsional*) : Kamus kwargs yang jika ditentukan akan diteruskan ke `AttentionProcessor` seperti yang didefinisikan dalam [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
clip_skip (`int`, *opsional*) : Jumlah lapisan yang akan dilewati dari CLIP saat menghitung prompt embeddings. Nilai 1 berarti bahwa output dari lapisan sebelum terakhir akan digunakan untuk menghitung prompt embeddings.
callback_on_step_end (`Callable`, *opsional*) : Fungsi yang dipanggil di akhir setiap langkah denoising selama inferensi. Fungsi ini dipanggil dengan argumen berikut: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` akan berisi daftar semua tensor sesuai yang ditentukan oleh `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opsional*) : Daftar input tensor untuk fungsi `callback_on_step_end`. Tensor yang ditentukan dalam daftar akan diteruskan sebagai argumen `callback_kwargs`. Anda hanya dapat menyertakan variabel yang tercantum dalam atribut `._callback_tensor_inputs` dari kelas pipeline Anda.
decode_chunk_size (`int`, defaultnya `16`) : Jumlah frame yang akan didekode sekaligus saat memanggil metode `decode_latents`.
**Mengembalikan:** [AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/id/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) atau `tuple`
Jika `return_dict` adalah `True`, [AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/id/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) dikembalikan, selain itu sebuah `tuple` dikembalikan di mana elemen pertama adalah daftar dengan frame yang dihasilkan.
Fungsi panggilan untuk pipeline pada generasi.
Contoh:
```py
>>> import torch
>>> from diffusers import MotionAdapter, AnimateDiffPipeline, DDIMScheduler
>>> from diffusers.utils import export_to_gif
>>> adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2")
>>> pipe = AnimateDiffPipeline.from_pretrained("frankjoshua/toonyou_beta6", motion_adapter=adapter)
>>> pipe.scheduler = DDIMScheduler(beta_schedule="linear", steps_offset=1, clip_sample=False)
>>> output = pipe(prompt="A corgi walking in the park")
>>> frames = output.frames[0]
>>> export_to_gif(frames, "animation.gif")
```
#### encode_prompt[[diffusers.AnimateDiffPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L154)
**Parameter:**
prompt (`str` atau `list[str]`, *opsional*) : prompt yang akan dienkod
device : (`torch.device`): perangkat torch
num_images_per_prompt (`int`) : jumlah gambar yang harus dihasilkan per prompt
do_classifier_free_guidance (`bool`) : apakah akan menggunakan classifier free guidance atau tidak
negative_prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt yang tidak akan memandu generasi gambar. Jika tidak didefinisikan, Anda harus meneruskan `negative_prompt_embeds` sebagai gantinya. Diabaikan saat tidak menggunakan guidance (yaitu, diabaikan jika `guidance_scale` kurang dari `1`).
prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks yang sudah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* penimbangan prompt. Jika tidak disediakan, embedding teks akan dihasilkan dari argumen input `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks negatif yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* penimbangan prompt. Jika tidak disediakan, negative_prompt_embeds akan dibuat dari argumen input `negative_prompt`.
lora_scale (`float`, *opsional*) : Skala LoRA yang akan diterapkan ke semua lapisan LoRA dari text encoder jika lapisan LoRA dimuat.
clip_skip (`int`, *opsional*) : Jumlah lapisan yang akan dilewati dari CLIP saat menghitung prompt embeddings. Nilai 1 berarti bahwa output dari lapisan sebelum terakhir akan digunakan untuk menghitung prompt embeddings.
Mengkodekan prompt menjadi hidden states dari text encoder.
## AnimateDiffControlNetPipeline[[diffusers.AnimateDiffControlNetPipeline]]
#### diffusers.AnimateDiffControlNetPipeline[[diffusers.AnimateDiffControlNetPipeline]]
```python
diffusers.AnimateDiffControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: diffusers.models.controlnets.controlnet.ControlNetModel | list[diffusers.models.controlnets.controlnet.ControlNetModel] | tuple[diffusers.models.controlnets.controlnet.ControlNetModel] | diffusers.models.controlnets.multicontrolnet.MultiControlNetModel, scheduler: KarrasDiffusionSchedulers, feature_extractor: transformers.models.clip.image_processing_pil_clip.CLIPImageProcessorPil | None = None, image_encoder: transformers.models.clip.modeling_clip.CLIPVisionModelWithProjection | None = None)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L120)
**Parameter:**
vae ([AutoencoderKL](/docs/diffusers/v0.43.0/id/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Model Variational Auto-Encoder (VAE) untuk mengodekan dan mendekodekan gambar ke dan dari representasi laten.
text_encoder (`CLIPTextModel`) : text-encoder beku ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : Sebuah [CLIPTokenizer](https://huggingface.co/docs/transformers/v5.22.2/en/model_doc/clip#transformers.CLIPTokenizer) untuk melakukan tokenisasi teks.
unet ([UNet2DConditionModel](/docs/diffusers/v0.43.0/id/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Sebuah [UNet2DConditionModel](/docs/diffusers/v0.43.0/id/api/models/unet2d-cond#diffusers.UNet2DConditionModel) yang digunakan untuk membuat UNetMotionModel guna mendenois latens video yang telah dikodekan.
motion_adapter (`MotionAdapter`) : Sebuah `MotionAdapter` yang digunakan bersama dengan `unet` untuk menghilangkan noise pada latens video yang telah dikodekan.
scheduler ([SchedulerMixin](/docs/diffusers/v0.43.0/id/api/schedulers/overview#diffusers.SchedulerMixin)) : Penjadwal yang digunakan bersama `unet` untuk menghilangkan noise pada latens gambar yang telah dikodekan. Bisa berupa [DDIMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler), atau [PNDMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/pndm#diffusers.PNDMScheduler).
Pipeline untuk generasi teks-ke-video dengan panduan ControlNet.
Model ini mewarisi dari [DiffusionPipeline](/docs/diffusers/v0.43.0/id/api/pipelines/overview#diffusers.DiffusionPipeline). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan untuk semua pipeline (mengunduh, menyimpan, menjalankan pada perangkat tertentu, dll.).
Pipeline juga mewarisi metode pemuatan berikut:
- [load_textual_inversion()](/docs/diffusers/v0.43.0/id/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) untuk memuat embedding textual inversion
- [load_lora_weights()](/docs/diffusers/v0.43.0/id/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) untuk memuat bobot LoRA
- [save_lora_weights()](/docs/diffusers/v0.43.0/id/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) untuk menyimpan bobot LoRA
- [load_ip_adapter()](/docs/diffusers/v0.43.0/id/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) untuk memuat IP Adapter
#### __call__[[diffusers.AnimateDiffControlNetPipeline.__call__]]
```python
__call__(prompt: str | list[str] = None, num_frames: int | None = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, guess_mode: bool = False, control_guidance_start: float | list[float] = 0.0, control_guidance_end: float | list[float] = 1.0, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'], decode_chunk_size: int = 16)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L721)
**Parameter:**
prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt untuk memandu generasi gambar. Jika tidak didefinisikan, Anda perlu meneruskan `prompt_embeds`.
height (`int`, *opsional*, defaultnya `self.unet.config.sample_size * self.vae_scale_factor`) : Tinggi video yang dihasilkan dalam piksel.
width (`int`, *opsional*, defaultnya `self.unet.config.sample_size * self.vae_scale_factor`) : Lebar video yang dihasilkan dalam piksel.
num_frames (`int`, *opsional*, default 16) : Jumlah bingkai video yang dihasilkan. Defaultnya adalah 16 bingkai, yang pada 8 bingkai per detik setara dengan 2 detik video.
num_inference_steps (`int`, *opsional*, defaultnya 50) : Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan video dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat.
guidance_scale (`float`, *opsional*, default 7.5) : Nilai guidance scale yang lebih tinggi mendorong model untuk menghasilkan gambar yang sangat terkait dengan `prompt` teks, dengan mengorbankan kualitas gambar yang lebih rendah. Guidance scale diaktifkan ketika `guidance_scale > 1`.
negative_prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt untuk mengarahkan apa yang tidak boleh disertakan dalam pembuatan gambar. Jika tidak didefinisikan, Anda perlu meneruskan `negative_prompt_embeds` sebagai gantinya. Diabaikan saat tidak menggunakan panduan (`guidance_scale < 1`).
num_videos_per_prompt (`int`, *opsional*, default 1) : Jumlah video yang akan dihasilkan per prompt.
eta (`float`, *opsional*, default 0.0) : Bersesuaian dengan parameter eta (η) dari paper [DDIM](https://huggingface.co/papers/2010.02502). Hanya berlaku untuk [DDIMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/ddim#diffusers.DDIMScheduler), dan diabaikan pada scheduler lainnya.
generator (`torch.Generator` atau `list[torch.Generator]`, *opsional*) : Sebuah [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) untuk membuat proses generasi menjadi deterministik.
latents (`torch.Tensor`, *opsional*) : Laten berisik yang telah dibuat sebelumnya, diambil dari distribusi Gaussian, untuk digunakan sebagai input untuk generasi video. Dapat digunakan untuk menyesuaikan generasi yang sama dengan prompt yang berbeda. Jika tidak disediakan, tensor laten akan dibuat dengan pengambilan sampel menggunakan `generator` acak yang diberikan. Laten harus memiliki bentuk `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks (pemberian bobot pada prompt). Jika tidak disediakan, embedding teks akan dihasilkan dari argumen input `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks negatif yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks (pemberian bobot pada prompt). Jika tidak disediakan, `negative_prompt_embeds` akan dibuat dari argumen input `negative_prompt`.
ip_adapter_image (`PipelineImageInput`, *opsional*) : Input gambar opsional untuk bekerja dengan IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opsional*) : Embedding gambar yang telah dibuat sebelumnya untuk IP-Adapter. Ini harus berupa daftar dengan panjang yang sama dengan jumlah IP-adapter. Setiap elemen harus berupa tensor dengan bentuk `(batch_size, num_images, emb_dim)`. Embedding gambar negatif harus disertakan jika `do_classifier_free_guidance` diatur ke `True`. Jika tidak disediakan, embedding dihitung dari argumen input `ip_adapter_image`.
conditioning_frames (`list[PipelineImageInput]`, *opsional*) : Kondisi input ControlNet untuk memberikan panduan kepada `unet` dalam proses generasi. Jika beberapa ControlNet ditentukan, gambar harus diberikan sebagai daftar sehingga setiap elemen dalam daftar dapat di-batch dengan benar untuk input ke satu ControlNet.
output_type (`str`, *opsional*, defaultnya `"pil"`) : Format output dari video yang dihasilkan. Pilih antara `torch.Tensor`, `PIL.Image` atau `np.array`.
return_dict (`bool`, *opsional*, defaultnya `True`) : Apakah akan mengembalikan `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput` alih-alih tuple biasa.
cross_attention_kwargs (`dict`, *opsional*) : Kamus kwargs yang jika ditentukan akan diteruskan ke `AttentionProcessor` seperti yang didefinisikan dalam [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
controlnet_conditioning_scale (`float` atau `list[float]`, *opsional*, default 1.0) : Output dari ControlNet dikalikan dengan `controlnet_conditioning_scale` sebelum ditambahkan ke residual di `unet` asli. Jika beberapa ControlNet ditentukan di `init`, Anda dapat mengatur skala yang sesuai sebagai list.
guess_mode (`bool`, *opsional*, defaultnya `False`) : Encoder ControlNet mencoba mengenali konten gambar input bahkan jika Anda menghapus semua prompt. Nilai `guidance_scale` antara 3.0 dan 5.0 direkomendasikan.
control_guidance_start (`float` atau `list[float]`, *opsional*, default 0.0) : Persentase dari total langkah di mana ControlNet mulai diterapkan.
control_guidance_end (`float` atau `list[float]`, *opsional*, default 1.0) : Persentase dari total langkah di mana ControlNet berhenti diterapkan.
clip_skip (`int`, *opsional*) : Jumlah lapisan yang akan dilewati dari CLIP saat menghitung prompt embeddings. Nilai 1 berarti bahwa output dari lapisan sebelum terakhir akan digunakan untuk menghitung prompt embeddings.
callback_on_step_end (`Callable`, *opsional*) : Fungsi yang dipanggil di akhir setiap langkah denoising selama inferensi. Fungsi ini dipanggil dengan argumen berikut: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` akan berisi daftar semua tensor sesuai yang ditentukan oleh `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opsional*) : Daftar input tensor untuk fungsi `callback_on_step_end`. Tensor yang ditentukan dalam daftar akan diteruskan sebagai argumen `callback_kwargs`. Anda hanya dapat menyertakan variabel yang tercantum dalam atribut `._callback_tensor_inputs` dari kelas pipeline Anda.
decode_chunk_size (`int`, defaultnya `16`) : Jumlah frame yang akan didekode sekaligus saat memanggil metode `decode_latents`.
**Mengembalikan:** [AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/id/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) atau `tuple`
Jika `return_dict` adalah `True`, [AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/id/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) dikembalikan, selain itu sebuah `tuple` dikembalikan di mana elemen pertama adalah daftar dengan frame yang dihasilkan.
Fungsi panggilan untuk pipeline pada generasi.
Contoh:
#### encode_prompt[[diffusers.AnimateDiffControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L199)
**Parameter:**
prompt (`str` atau `list[str]`, *opsional*) : prompt yang akan dienkod
device : (`torch.device`): perangkat torch
num_images_per_prompt (`int`) : jumlah gambar yang harus dihasilkan per prompt
do_classifier_free_guidance (`bool`) : apakah akan menggunakan classifier free guidance atau tidak
negative_prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt yang tidak akan memandu generasi gambar. Jika tidak didefinisikan, Anda harus meneruskan `negative_prompt_embeds` sebagai gantinya. Diabaikan saat tidak menggunakan guidance (yaitu, diabaikan jika `guidance_scale` kurang dari `1`).
prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks yang sudah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* penimbangan prompt. Jika tidak disediakan, embedding teks akan dihasilkan dari argumen input `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks negatif yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* penimbangan prompt. Jika tidak disediakan, negative_prompt_embeds akan dibuat dari argumen input `negative_prompt`.
lora_scale (`float`, *opsional*) : Skala LoRA yang akan diterapkan ke semua lapisan LoRA dari text encoder jika lapisan LoRA dimuat.
clip_skip (`int`, *opsional*) : Jumlah lapisan yang akan dilewati dari CLIP saat menghitung prompt embeddings. Nilai 1 berarti bahwa output dari lapisan sebelum terakhir akan digunakan untuk menghitung prompt embeddings.
Mengkodekan prompt menjadi hidden states dari text encoder.
## AnimateDiffSparseControlNetPipeline[[diffusers.AnimateDiffSparseControlNetPipeline]]
#### diffusers.AnimateDiffSparseControlNetPipeline[[diffusers.AnimateDiffSparseControlNetPipeline]]
```python
diffusers.AnimateDiffSparseControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: SparseControlNetModel, scheduler: KarrasDiffusionSchedulers, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L132)
**Parameter:**
vae ([AutoencoderKL](/docs/diffusers/v0.43.0/id/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Model Variational Auto-Encoder (VAE) untuk mengodekan dan mendekodekan gambar ke dan dari representasi laten.
text_encoder (`CLIPTextModel`) : text-encoder beku ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : Sebuah [CLIPTokenizer](https://huggingface.co/docs/transformers/v5.22.2/en/model_doc/clip#transformers.CLIPTokenizer) untuk melakukan tokenisasi teks.
unet ([UNet2DConditionModel](/docs/diffusers/v0.43.0/id/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Sebuah [UNet2DConditionModel](/docs/diffusers/v0.43.0/id/api/models/unet2d-cond#diffusers.UNet2DConditionModel) yang digunakan untuk membuat UNetMotionModel guna mendenois latens video yang telah dikodekan.
motion_adapter (`MotionAdapter`) : Sebuah `MotionAdapter` yang digunakan bersama dengan `unet` untuk menghilangkan noise pada latens video yang telah dikodekan.
scheduler ([SchedulerMixin](/docs/diffusers/v0.43.0/id/api/schedulers/overview#diffusers.SchedulerMixin)) : Penjadwal yang digunakan bersama `unet` untuk menghilangkan noise pada latens gambar yang telah dikodekan. Bisa berupa [DDIMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler), atau [PNDMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/pndm#diffusers.PNDMScheduler).
Pipeline untuk generasi teks-ke-video terkendali menggunakan metode yang dijelaskan dalam [SparseCtrl: Adding Sparse Controls to Text-to-Video Diffusion Models](https://huggingface.co/papers/2311.16933).
Model ini mewarisi dari [DiffusionPipeline](/docs/diffusers/v0.43.0/id/api/pipelines/overview#diffusers.DiffusionPipeline). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan untuk semua pipeline (mengunduh, menyimpan, menjalankan pada perangkat tertentu, dll.).
Pipeline juga mewarisi metode pemuatan berikut:
- [load_textual_inversion()](/docs/diffusers/v0.43.0/id/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) untuk memuat embedding textual inversion
- [load_lora_weights()](/docs/diffusers/v0.43.0/id/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) untuk memuat bobot LoRA
- [save_lora_weights()](/docs/diffusers/v0.43.0/id/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) untuk menyimpan bobot LoRA
- [load_ip_adapter()](/docs/diffusers/v0.43.0/id/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) untuk memuat IP Adapter
#### __call__[[diffusers.AnimateDiffSparseControlNetPipeline.__call__]]
```python
__call__(prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_frames: int = 16, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, controlnet_frame_indices: list[int] = [0], guess_mode: bool = False, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'])
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L712)
**Parameter:**
prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt untuk memandu generasi gambar. Jika tidak didefinisikan, Anda perlu meneruskan `prompt_embeds`.
height (`int`, *opsional*, defaultnya `self.unet.config.sample_size * self.vae_scale_factor`) : Tinggi video yang dihasilkan dalam piksel.
width (`int`, *opsional*, defaultnya `self.unet.config.sample_size * self.vae_scale_factor`) : Lebar video yang dihasilkan dalam piksel.
num_frames (`int`, *opsional*, default 16) : Jumlah bingkai video yang dihasilkan. Defaultnya adalah 16 bingkai, yang pada 8 bingkai per detik setara dengan 2 detik video.
num_inference_steps (`int`, *opsional*, defaultnya 50) : Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan video dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat.
guidance_scale (`float`, *opsional*, default 7.5) : Nilai guidance scale yang lebih tinggi mendorong model untuk menghasilkan gambar yang sangat terkait dengan `prompt` teks, dengan mengorbankan kualitas gambar yang lebih rendah. Guidance scale diaktifkan ketika `guidance_scale > 1`.
negative_prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt untuk mengarahkan apa yang tidak boleh disertakan dalam pembuatan gambar. Jika tidak didefinisikan, Anda perlu meneruskan `negative_prompt_embeds` sebagai gantinya. Diabaikan saat tidak menggunakan panduan (`guidance_scale < 1`).
num_videos_per_prompt (`int`, *opsional*, default 1) : Jumlah video yang akan dihasilkan per prompt.
eta (`float`, *opsional*, default 0.0) : Bersesuaian dengan parameter eta (η) dari paper [DDIM](https://huggingface.co/papers/2010.02502). Hanya berlaku untuk [DDIMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/ddim#diffusers.DDIMScheduler), dan diabaikan pada scheduler lainnya.
generator (`torch.Generator` atau `list[torch.Generator]`, *opsional*) : Sebuah [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) untuk membuat proses generasi menjadi deterministik.
latents (`torch.Tensor`, *opsional*) : Laten berisik yang telah dibuat sebelumnya, diambil dari distribusi Gaussian, untuk digunakan sebagai input untuk generasi video. Dapat digunakan untuk menyesuaikan generasi yang sama dengan prompt yang berbeda. Jika tidak disediakan, tensor laten akan dibuat dengan pengambilan sampel menggunakan `generator` acak yang diberikan. Laten harus memiliki bentuk `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks (pemberian bobot pada prompt). Jika tidak disediakan, embedding teks akan dihasilkan dari argumen input `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks negatif yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks (pemberian bobot pada prompt). Jika tidak disediakan, `negative_prompt_embeds` akan dibuat dari argumen input `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`, *opsional*): Input gambar opsional untuk bekerja dengan IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opsional*) : Embedding gambar yang telah dibuat sebelumnya untuk IP-Adapter. Ini harus berupa daftar dengan panjang yang sama dengan jumlah IP-adapter. Setiap elemen harus berupa tensor dengan bentuk `(batch_size, num_images, emb_dim)`. Embedding gambar negatif harus disertakan jika `do_classifier_free_guidance` diatur ke `True`. Jika tidak disediakan, embedding dihitung dari argumen input `ip_adapter_image`.
conditioning_frames (`list[PipelineImageInput]`, *opsional*) : Input SparseControlNet untuk memberikan panduan ke `unet` untuk generasi.
output_type (`str`, *opsional*, defaultnya `"pil"`) : Format output dari video yang dihasilkan. Pilih antara `torch.Tensor`, `PIL.Image` atau `np.array`.
return_dict (`bool`, *opsional*, defaultnya `True`) : Apakah akan mengembalikan `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput` alih-alih tuple biasa.
cross_attention_kwargs (`dict`, *opsional*) : Kamus kwargs yang jika ditentukan akan diteruskan ke `AttentionProcessor` seperti yang didefinisikan dalam [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
controlnet_conditioning_scale (`float` atau `list[float]`, *opsional*, default 1.0) : Output dari ControlNet dikalikan dengan `controlnet_conditioning_scale` sebelum ditambahkan ke residual di `unet` asli. Jika beberapa ControlNet ditentukan di `init`, Anda dapat mengatur skala yang sesuai sebagai list.
controlnet_frame_indices (`list[int]`) : Indeks tempat frame kondisioning harus diterapkan untuk generasi. Beberapa frame dapat diberikan untuk memandu model menghasilkan output dengan struktur serupa, di mana `unet` dapat “mengisi celah” untuk video interpolasi, atau satu frame dapat diberikan untuk struktur yang diharapkan secara umum. Harus memiliki panjang yang sama dengan `conditioning_frames`.
guess_mode (`bool`, *opsional*, defaultnya `False`) : Encoder ControlNet mencoba mengenali konten gambar input bahkan jika Anda menghapus semua prompt. Nilai `guidance_scale` antara 3.0 dan 5.0 direkomendasikan.
clip_skip (`int`, *opsional*) : Jumlah lapisan yang akan dilewati dari CLIP saat menghitung prompt embeddings. Nilai 1 berarti bahwa output dari lapisan sebelum terakhir akan digunakan untuk menghitung prompt embeddings.
callback_on_step_end (`Callable`, *opsional*) : Fungsi yang dipanggil di akhir setiap langkah denoising selama inferensi. Fungsi ini dipanggil dengan argumen berikut: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` akan berisi daftar semua tensor sesuai yang ditentukan oleh `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opsional*) : Daftar input tensor untuk fungsi `callback_on_step_end`. Tensor yang ditentukan dalam daftar akan diteruskan sebagai argumen `callback_kwargs`. Anda hanya dapat menyertakan variabel yang tercantum dalam atribut `._callback_tensor_inputs` dari kelas pipeline Anda.
**Mengembalikan:** [AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/id/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) atau `tuple`
Jika `return_dict` adalah `True`, [AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/id/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) dikembalikan, selain itu sebuah `tuple` dikembalikan di mana elemen pertama adalah daftar dengan frame yang dihasilkan.
Fungsi panggilan untuk pipeline pada generasi.
Contoh:
```python
>>> import torch
>>> from diffusers import AnimateDiffSparseControlNetPipeline
>>> from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
>>> from diffusers.schedulers import DPMSolverMultistepScheduler
>>> from diffusers.utils import export_to_gif, load_image
>>> model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
>>> motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
>>> controlnet_id = "guoyww/animatediff-sparsectrl-scribble"
>>> lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
>>> vae_id = "stabilityai/sd-vae-ft-mse"
>>> device = "cuda"
>>> motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, torch_dtype=torch.float16).to(device)
>>> controlnet = SparseControlNetModel.from_pretrained(controlnet_id, torch_dtype=torch.float16).to(device)
>>> vae = AutoencoderKL.from_pretrained(vae_id, torch_dtype=torch.float16).to(device)
>>> scheduler = DPMSolverMultistepScheduler.from_pretrained(
... model_id,
... subfolder="scheduler",
... beta_schedule="linear",
... algorithm_type="dpmsolver++",
... use_karras_sigmas=True,
... )
>>> pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
... model_id,
... motion_adapter=motion_adapter,
... controlnet=controlnet,
... vae=vae,
... scheduler=scheduler,
... torch_dtype=torch.float16,
... ).to(device)
>>> pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
>>> pipe.fuse_lora(lora_scale=1.0)
>>> prompt = "an aerial view of a cyberpunk city, night time, neon lights, masterpiece, high quality"
>>> negative_prompt = "low quality, worst quality, letterboxed"
>>> image_files = [
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-1.png",
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-2.png",
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-3.png",
... ]
>>> condition_frame_indices = [0, 8, 15]
>>> conditioning_frames = [load_image(img_file) for img_file in image_files]
>>> video = pipe(
... prompt=prompt,
... negative_prompt=negative_prompt,
... num_inference_steps=25,
... conditioning_frames=conditioning_frames,
... controlnet_conditioning_scale=1.0,
... controlnet_frame_indices=condition_frame_indices,
... generator=torch.Generator().manual_seed(1337),
... ).frames[0]
>>> export_to_gif(video, "output.gif")
```
#### encode_prompt[[diffusers.AnimateDiffSparseControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L208)
**Parameter:**
prompt (`str` atau `list[str]`, *opsional*) : prompt yang akan dienkod
device : (`torch.device`): perangkat torch
num_images_per_prompt (`int`) : jumlah gambar yang harus dihasilkan per prompt
do_classifier_free_guidance (`bool`) : apakah akan menggunakan classifier free guidance atau tidak
negative_prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt yang tidak akan memandu generasi gambar. Jika tidak didefinisikan, Anda harus meneruskan `negative_prompt_embeds` sebagai gantinya. Diabaikan saat tidak menggunakan guidance (yaitu, diabaikan jika `guidance_scale` kurang dari `1`).
prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks yang sudah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* penimbangan prompt. Jika tidak disediakan, embedding teks akan dihasilkan dari argumen input `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks negatif yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* penimbangan prompt. Jika tidak disediakan, negative_prompt_embeds akan dibuat dari argumen input `negative_prompt`.
lora_scale (`float`, *opsional*) : Skala LoRA yang akan diterapkan ke semua lapisan LoRA dari text encoder jika lapisan LoRA dimuat.
clip_skip (`int`, *opsional*) : Jumlah lapisan yang akan dilewati dari CLIP saat menghitung prompt embeddings. Nilai 1 berarti bahwa output dari lapisan sebelum terakhir akan digunakan untuk menghitung prompt embeddings.
Mengkodekan prompt menjadi hidden states dari text encoder.
## AnimateDiffSDXLPipeline[[diffusers.AnimateDiffSDXLPipeline]]
#### diffusers.AnimateDiffSDXLPipeline[[diffusers.AnimateDiffSDXLPipeline]]
```python
diffusers.AnimateDiffSDXLPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, text_encoder_2: CLIPTextModelWithProjection, tokenizer: CLIPTokenizer, tokenizer_2: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, image_encoder: CLIPVisionModelWithProjection = None, feature_extractor: CLIPImageProcessorPil = None, force_zeros_for_empty_prompt: bool = True)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L210)
**Parameter:**
vae ([AutoencoderKL](/docs/diffusers/v0.43.0/id/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Model Variational Auto-Encoder (VAE) untuk mengodekan dan mendekodekan gambar ke dan dari representasi laten.
text_encoder (`CLIPTextModel`) : Text-encoder yang dibekukan. Stable Diffusion XL menggunakan bagian teks dari [CLIP](https://huggingface.co/docs/transformers/model_doc/clip#transformers.CLIPTextModel), khususnya varian [clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14).
text_encoder_2 (` CLIPTextModelWithProjection`) : Text-encoder beku kedua. Stable Diffusion XL menggunakan bagian teks dan pool dari [CLIP](https://huggingface.co/docs/transformers/model_doc/clip#transformers.CLIPTextModelWithProjection), khususnya varian [laion/CLIP-ViT-bigG-14-laion2B-39B-b160k](https://huggingface.co/laion/CLIP-ViT-bigG-14-laion2B-39B-b160k).
tokenizer (`CLIPTokenizer`) : Tokenizer dari kelas [CLIPTokenizer](https://huggingface.co/docs/transformers/v4.21.0/en/model_doc/clip#transformers.CLIPTokenizer).
tokenizer_2 (`CLIPTokenizer`) : Tokenizer kedua dari kelas [CLIPTokenizer](https://huggingface.co/docs/transformers/v4.21.0/en/model_doc/clip#transformers.CLIPTokenizer).
unet ([UNet2DConditionModel](/docs/diffusers/v0.43.0/id/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Arsitektur U-Net bersyarat untuk mendenoise latens gambar yang telah dikodekan.
scheduler ([SchedulerMixin](/docs/diffusers/v0.43.0/id/api/schedulers/overview#diffusers.SchedulerMixin)) : Penjadwal yang digunakan bersama `unet` untuk menghilangkan noise pada latens gambar yang telah dikodekan. Bisa berupa [DDIMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler), atau [PNDMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/pndm#diffusers.PNDMScheduler).
force_zeros_for_empty_prompt (`bool`, *opsional*, defaultnya `"True"`) : Apakah embedding prompt negatif harus dipaksa selalu diatur ke 0. Lihat juga konfigurasi dari `stabilityai/stable-diffusion-xl-base-1-0`.
Pipeline untuk generasi teks-ke-video menggunakan Stable Diffusion XL.
Model ini mewarisi dari [DiffusionPipeline](/docs/diffusers/v0.43.0/id/api/pipelines/overview#diffusers.DiffusionPipeline). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua pipeline (seperti mengunduh atau menyimpan, menjalankan pada perangkat tertentu, dll.)
Pipeline juga mewarisi metode pemuatan berikut:
- [load_textual_inversion()](/docs/diffusers/v0.43.0/id/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) untuk memuat embedding textual inversion
- untuk memuat file `.ckpt` dengan [from_single_file()](/docs/diffusers/v0.43.0/id/api/loaders/single_file#diffusers.loaders.FromSingleFileMixin.from_single_file)
- [load_lora_weights()](/docs/diffusers/v0.43.0/id/api/loaders/lora#diffusers.loaders.StableDiffusionXLLoraLoaderMixin.load_lora_weights) untuk memuat bobot LoRA
- [save_lora_weights()](/docs/diffusers/v0.43.0/id/api/loaders/lora#diffusers.loaders.StableDiffusionXLLoraLoaderMixin.save_lora_weights) untuk menyimpan bobot LoRA
- [load_ip_adapter()](/docs/diffusers/v0.43.0/id/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) untuk memuat IP Adapter
#### __call__[[diffusers.AnimateDiffSDXLPipeline.__call__]]
```python
__call__(prompt: str | list[str] = None, prompt_2: str | list[str] | None = None, num_frames: int = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, timesteps: list[int] = None, sigmas: list[float] = None, denoising_end: float | None = None, guidance_scale: float = 5.0, negative_prompt: str | list[str] | None = None, negative_prompt_2: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, negative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, guidance_rescale: float = 0.0, original_size: tuple[int, int] | None = None, crops_coords_top_left: tuple[int, int] = (0, 0), target_size: tuple[int, int] | None = None, negative_original_size: tuple[int, int] | None = None, negative_crops_coords_top_left: tuple[int, int] = (0, 0), negative_target_size: tuple[int, int] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'])
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L869)
**Parameter:**
prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt untuk mengarahkan generasi video. Jika tidak didefinisikan, Anda harus meneruskan `prompt_embeds` sebagai gantinya.
prompt_2 (`str` atau `list[str]`, *opsional*) : Prompt atau prompt yang akan dikirim ke `tokenizer_2` dan `text_encoder_2`. Jika tidak didefinisikan, `prompt` digunakan di kedua text-encoder
num_frames : Jumlah bingkai video yang dihasilkan. Secara bawaan, 16 bingkai, yang pada 8 bingkai per detik setara dengan 2 detik video.
height (`int`, *opsional*, defaultnya self.unet.config.sample_size * self.vae_scale_factor) : Tinggi video yang dihasilkan dalam piksel. Ini diatur ke 1024 secara default untuk hasil terbaik. Apa pun di bawah 512 piksel tidak akan berfungsi dengan baik untuk [stabilityai/stable-diffusion-xl-base-1.0](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0) dan checkpoint yang tidak secara khusus dihaluskan pada resolusi rendah.
width (`int`, *opsional*, defaultnya self.unet.config.sample_size * self.vae_scale_factor) : Lebar video yang dihasilkan dalam piksel. Ini diatur ke 1024 secara default untuk hasil terbaik. Apa pun di bawah 512 piksel tidak akan berfungsi dengan baik untuk [stabilityai/stable-diffusion-xl-base-1.0](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0) dan checkpoint yang tidak secara khusus dihaluskan pada resolusi rendah.
num_inference_steps (`int`, *opsional*, defaultnya 50) : Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan video dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat.
timesteps (`list[int]`, *opsional*) : Timesteps kustom untuk digunakan dalam proses denoising dengan scheduler yang mendukung argumen `timesteps` di metode `set_timesteps` mereka. Jika tidak didefinisikan, perilaku default saat `num_inference_steps` diteruskan akan digunakan. Harus dalam urutan menurun.
sigmas (`list[float]`, *opsional*) : Sigmas kustom untuk digunakan dalam proses denoising dengan scheduler yang mendukung argumen `sigmas` di metode `set_timesteps` mereka. Jika tidak didefinisikan, perilaku default saat `num_inference_steps` diteruskan akan digunakan.
denoising_end (`float`, *opsional*) : Jika ditentukan, menentukan fraksi (antara 0.0 dan 1.0) dari total proses denoising yang harus diselesaikan sebelum proses tersebut dihentikan secara dini secara sengaja. Akibatnya, sampel yang dikembalikan masih akan mempertahankan sejumlah besar noise, sebagaimana ditentukan oleh langkah-langkah diskrit yang dipilih oleh scheduler. Parameter denoising_end sebaiknya digunakan ketika pipeline ini merupakan bagian dari setup multi-pipeline "Mixture of Denoisers", seperti yang diuraikan dalam [**Refining the Image Output**](https://huggingface.co/docs/diffusers/api/pipelines/stable_diffusion/stable_diffusion_xl#refining-the-image-output)
guidance_scale (`float`, *opsional*, default 5.0) : Skala panduan seperti yang didefinisikan dalam [Classifier-Free Diffusion Guidance](https://huggingface.co/papers/2207.12598). `guidance_scale` didefinisikan sebagai `w` dari persamaan 2. pada [Imagen Paper](https://huggingface.co/papers/2205.11487). Skala panduan diaktifkan dengan mengatur `guidance_scale > 1`. Skala panduan yang lebih tinggi mendorong generasi gambar yang sangat terkait dengan `prompt` teks, biasanya dengan mengorbankan kualitas video yang lebih rendah.
negative_prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt yang tidak akan memandu generasi video. Jika tidak didefinisikan, Anda harus meneruskan `negative_prompt_embeds` sebagai gantinya. Diabaikan saat tidak menggunakan guidance (yaitu, diabaikan jika `guidance_scale` kurang dari `1`).
negative_prompt_2 (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt yang tidak akan memandu generasi video untuk dikirim ke `tokenizer_2` dan `text_encoder_2`. Jika tidak didefinisikan, `negative_prompt` digunakan di kedua text-encoder
num_videos_per_prompt (`int`, *opsional*, default 1) : Jumlah video yang akan dihasilkan per prompt.
eta (`float`, *opsional*, default 0.0) : Bersesuaian dengan parameter eta (η) dalam paper DDIM: https://huggingface.co/papers/2010.02502. Hanya berlaku untuk [schedulers.DDIMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/ddim#diffusers.DDIMScheduler), akan diabaikan untuk yang lain.
generator (`torch.Generator` atau `list[torch.Generator]`, *opsional*) : Satu atau daftar [generator torch](https://pytorch.org/docs/stable/generated/torch.Generator.html) untuk membuat proses generasi menjadi deterministik.
latents (`torch.Tensor`, *opsional*) : Laten berisik yang telah dibuat sebelumnya, diambil dari distribusi Gaussian, untuk digunakan sebagai input untuk generasi video. Dapat digunakan untuk menyesuaikan generasi yang sama dengan prompt yang berbeda. Jika tidak disediakan, tensor laten akan dibuat dengan pengambilan sampel menggunakan `generator` acak yang diberikan.
prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks yang sudah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* penimbangan prompt. Jika tidak disediakan, embedding teks akan dihasilkan dari argumen input `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks negatif yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* penimbangan prompt. Jika tidak disediakan, negative_prompt_embeds akan dibuat dari argumen input `negative_prompt`.
pooled_prompt_embeds (`torch.Tensor`, *opsional*) : Pooled text embeddings yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* pembobotan prompt. Jika tidak disediakan, pooled text embeddings akan dihasilkan dari argumen input `prompt`.
negative_pooled_prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks negatif yang sudah dipooling sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* penimbangan prompt. Jika tidak disediakan, pooled negative_prompt_embeds akan dihasilkan dari argumen input `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`, *opsional*): Input gambar opsional untuk bekerja dengan IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opsional*) : Embedding gambar yang telah dibuat sebelumnya untuk IP-Adapter. Jika tidak disediakan, embedding dihitung dari argumen input `ip_adapter_image`.
output_type (`str`, *opsional*, defaultnya `"pil"`) : Format output dari video yang dihasilkan. Pilih antara [PIL](https://pillow.readthedocs.io/en/stable/): `PIL.Image.Image` atau `np.array`.
return_dict (`bool`, *opsional*, defaultnya `True`) : Apakah akan mengembalikan `~pipelines.stable_diffusion_xl.AnimateDiffPipelineOutput` alih-alih tuple biasa.
cross_attention_kwargs (`dict`, *opsional*) : Kamus kwargs yang jika ditentukan akan diteruskan ke `AttentionProcessor` seperti yang didefinisikan di bawah `self.processor` dalam [diffusers.models.attention_processor](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
guidance_rescale (`float`, *opsional*, default 0.0) : Faktor rescale guidance yang diusulkan oleh [Common Diffusion Noise Schedules and Sample Steps are Flawed](https://huggingface.co/papers/2305.08891) `guidance_scale` didefinisikan sebagai `φ` dalam persamaan 16. dari [Common Diffusion Noise Schedules and Sample Steps are Flawed](https://huggingface.co/papers/2305.08891). Faktor rescale guidance harus memperbaiki overexposure saat menggunakan zero terminal SNR.
original_size (`tuple[int]`, *opsional*, defaultnya (1024, 1024)) : Jika `original_size` tidak sama dengan `target_size`, gambar akan tampak di-downsample atau di-upsample. `original_size` defaultnya `(height, width)` jika tidak ditentukan. Bagian dari micro-conditioning SDXL seperti dijelaskan di bagian 2.2 dari [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952).
crops_coords_top_left (`tuple[int]`, *opsional*, defaultnya (0, 0)) : `crops_coords_top_left` dapat digunakan untuk menghasilkan gambar yang tampak "dipotong" dari posisi `crops_coords_top_left` ke bawah. Gambar yang bagus dan terpusat biasanya dicapai dengan mengatur `crops_coords_top_left` ke (0, 0). Bagian dari micro-conditioning SDXL seperti yang dijelaskan di bagian 2.2 dari [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952).
target_size (`tuple[int]`, *opsional*, defaultnya (1024, 1024)) : Untuk sebagian besar kasus, `target_size` sebaiknya diatur ke tinggi dan lebar yang diinginkan dari gambar yang dihasilkan. Jika tidak ditentukan, nilainya akan default ke `(height, width)`. Bagian dari micro-conditioning SDXL seperti yang dijelaskan di bagian 2.2 dari [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952).
negative_original_size (`tuple[int]`, *opsional*, defaultnya (1024, 1024)) : Untuk mengondisikan proses generasi secara negatif berdasarkan resolusi gambar tertentu. Bagian dari micro-conditioning SDXL seperti yang dijelaskan di bagian 2.2 dari [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952). Untuk informasi lebih lanjut, lihat thread issue ini: https://github.com/huggingface/diffusers/issues/4208.
negative_crops_coords_top_left (`tuple[int]`, *opsional*, defaultnya (0, 0)) : Untuk mengondisikan proses generasi secara negatif berdasarkan koordinat crop tertentu. Bagian dari micro-conditioning SDXL seperti yang dijelaskan di bagian 2.2 dari [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952). Untuk informasi lebih lanjut, lihat thread issue ini: https://github.com/huggingface/diffusers/issues/4208.
negative_target_size (`tuple[int]`, *opsional*, defaultnya (1024, 1024)) : Untuk mengondisikan proses generasi secara negatif berdasarkan resolusi gambar target. Sebaiknya sama dengan `target_size` untuk sebagian besar kasus. Bagian dari micro-conditioning SDXL seperti yang dijelaskan di bagian 2.2 dari [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952). Untuk informasi lebih lanjut, lihat thread issue ini: https://github.com/huggingface/diffusers/issues/4208.
clip_skip (`int`, *opsional*) : Jumlah lapisan yang akan dilewati dari CLIP saat menghitung prompt embeddings. Nilai 1 berarti bahwa output dari lapisan sebelum terakhir akan digunakan untuk menghitung prompt embeddings.
callback_on_step_end (`Callable`, *opsional*) : Fungsi yang dipanggil di akhir setiap langkah denoising selama inferensi. Fungsi ini dipanggil dengan argumen berikut: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` akan berisi daftar semua tensor sesuai yang ditentukan oleh `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opsional*) : Daftar input tensor untuk fungsi `callback_on_step_end`. Tensor yang ditentukan dalam daftar akan diteruskan sebagai argumen `callback_kwargs`. Anda hanya dapat menyertakan variabel yang tercantum dalam atribut `._callback_tensor_inputs` dari kelas pipeline Anda.
**Mengembalikan:** [AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/id/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) atau `tuple`
Jika `return_dict` adalah `True`, [AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/id/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) dikembalikan, selain itu sebuah `tuple` dikembalikan di mana elemen pertama adalah daftar dengan frame yang dihasilkan.
Fungsi yang dipanggil saat memanggil pipeline untuk generasi.
Contoh:
```py
>>> import torch
>>> from diffusers.models import MotionAdapter
>>> from diffusers import AnimateDiffSDXLPipeline, DDIMScheduler
>>> from diffusers.utils import export_to_gif
>>> adapter = MotionAdapter.from_pretrained(
... "a-r-r-o-w/animatediff-motion-adapter-sdxl-beta", torch_dtype=torch.float16
... )
>>> model_id = "stabilityai/stable-diffusion-xl-base-1.0"
>>> scheduler = DDIMScheduler.from_pretrained(
... model_id,
... subfolder="scheduler",
... clip_sample=False,
... timestep_spacing="linspace",
... beta_schedule="linear",
... steps_offset=1,
... )
>>> pipe = AnimateDiffSDXLPipeline.from_pretrained(
... model_id,
... motion_adapter=adapter,
... scheduler=scheduler,
... torch_dtype=torch.float16,
... variant="fp16",
... ).to("cuda")
>>> # enable memory savings
>>> pipe.vae.enable_slicing()
>>> pipe.vae.enable_tiling()
>>> output = pipe(
... prompt="a panda surfing in the ocean, realistic, high quality",
... negative_prompt="low quality, worst quality",
... num_inference_steps=20,
... guidance_scale=8,
... width=1024,
... height=1024,
... num_frames=16,
... )
>>> frames = output.frames[0]
>>> export_to_gif(frames, "animation.gif")
```
#### encode_prompt[[diffusers.AnimateDiffSDXLPipeline.encode_prompt]]
```python
encode_prompt(prompt: str, prompt_2: str | None = None, device: typing.Optional[torch.device] = None, num_videos_per_prompt: int = 1, do_classifier_free_guidance: bool = True, negative_prompt: str | None = None, negative_prompt_2: str | None = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, negative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L327)
**Parameter:**
prompt (`str` atau `list[str]`, *opsional*) : prompt yang akan dienkod
prompt_2 (`str` atau `list[str]`, *opsional*) : Prompt atau prompt yang akan dikirim ke `tokenizer_2` dan `text_encoder_2`. Jika tidak didefinisikan, `prompt` digunakan di kedua text-encoder
device : (`torch.device`): perangkat torch
num_videos_per_prompt (`int`) : jumlah gambar yang harus dihasilkan per prompt
do_classifier_free_guidance (`bool`) : apakah akan menggunakan classifier free guidance atau tidak
negative_prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt yang tidak akan memandu generasi gambar. Jika tidak didefinisikan, Anda harus meneruskan `negative_prompt_embeds` sebagai gantinya. Diabaikan saat tidak menggunakan guidance (yaitu, diabaikan jika `guidance_scale` kurang dari `1`).
negative_prompt_2 (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt yang tidak akan memandu generasi gambar untuk dikirim ke `tokenizer_2` dan `text_encoder_2`. Jika tidak didefinisikan, `negative_prompt` digunakan di kedua text-encoder
prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks yang sudah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* penimbangan prompt. Jika tidak disediakan, embedding teks akan dihasilkan dari argumen input `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks negatif yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* penimbangan prompt. Jika tidak disediakan, negative_prompt_embeds akan dibuat dari argumen input `negative_prompt`.
pooled_prompt_embeds (`torch.Tensor`, *opsional*) : Pooled text embeddings yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* pembobotan prompt. Jika tidak disediakan, pooled text embeddings akan dihasilkan dari argumen input `prompt`.
negative_pooled_prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks negatif yang sudah dipooling sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* penimbangan prompt. Jika tidak disediakan, pooled negative_prompt_embeds akan dihasilkan dari argumen input `negative_prompt`.
lora_scale (`float`, *opsional*) : Skala lora yang akan diterapkan ke semua lapisan LoRA dari text encoder jika lapisan LoRA dimuat.
clip_skip (`int`, *opsional*) : Jumlah lapisan yang akan dilewati dari CLIP saat menghitung prompt embeddings. Nilai 1 berarti bahwa output dari lapisan sebelum terakhir akan digunakan untuk menghitung prompt embeddings.
Mengkodekan prompt menjadi hidden states dari text encoder.
#### get_guidance_scale_embedding[[diffusers.AnimateDiffSDXLPipeline.get_guidance_scale_embedding]]
```python
get_guidance_scale_embedding(w: Tensor, embedding_dim: int = 512, dtype: dtype = torch.float32)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L804)
**Parameter:**
w (`torch.Tensor`) : Menghasilkan vektor embedding dengan skala panduan yang ditentukan untuk selanjutnya memperkaya embedding timestep.
embedding_dim (`int`, *opsional*, default 512) : Dimensi dari embedding yang akan dihasilkan.
dtype (`torch.dtype`, *opsional*, defaultnya `torch.float32`) : Tipe data dari embedding yang dihasilkan.
**Mengembalikan:** `torch.Tensor`
Vektor embedding dengan bentuk `(len(w), embedding_dim)`.
Lihat https://github.com/google-research/vdm/blob/dc27b98a554f65cdc654b800da5aa1846545d41b/model_vdm.py#L298
## AnimateDiffVideoToVideoPipeline[[diffusers.AnimateDiffVideoToVideoPipeline]]
#### diffusers.AnimateDiffVideoToVideoPipeline[[diffusers.AnimateDiffVideoToVideoPipeline]]
```python
diffusers.AnimateDiffVideoToVideoPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L181)
**Parameter:**
vae ([AutoencoderKL](/docs/diffusers/v0.43.0/id/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Model Variational Auto-Encoder (VAE) untuk mengodekan dan mendekodekan gambar ke dan dari representasi laten.
text_encoder (`CLIPTextModel`) : text-encoder beku ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : Sebuah [CLIPTokenizer](https://huggingface.co/docs/transformers/v5.22.2/en/model_doc/clip#transformers.CLIPTokenizer) untuk melakukan tokenisasi teks.
unet ([UNet2DConditionModel](/docs/diffusers/v0.43.0/id/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Sebuah [UNet2DConditionModel](/docs/diffusers/v0.43.0/id/api/models/unet2d-cond#diffusers.UNet2DConditionModel) yang digunakan untuk membuat UNetMotionModel guna mendenois latens video yang telah dikodekan.
motion_adapter (`MotionAdapter`) : Sebuah `MotionAdapter` yang digunakan bersama dengan `unet` untuk menghilangkan noise pada latens video yang telah dikodekan.
scheduler ([SchedulerMixin](/docs/diffusers/v0.43.0/id/api/schedulers/overview#diffusers.SchedulerMixin)) : Penjadwal yang digunakan bersama `unet` untuk menghilangkan noise pada latens gambar yang telah dikodekan. Bisa berupa [DDIMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler), atau [PNDMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/pndm#diffusers.PNDMScheduler).
Pipeline untuk generasi video-ke-video.
Model ini mewarisi dari [DiffusionPipeline](/docs/diffusers/v0.43.0/id/api/pipelines/overview#diffusers.DiffusionPipeline). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan untuk semua pipeline (mengunduh, menyimpan, menjalankan pada perangkat tertentu, dll.).
Pipeline juga mewarisi metode pemuatan berikut:
- [load_textual_inversion()](/docs/diffusers/v0.43.0/id/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) untuk memuat embedding textual inversion
- [load_lora_weights()](/docs/diffusers/v0.43.0/id/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) untuk memuat bobot LoRA
- [save_lora_weights()](/docs/diffusers/v0.43.0/id/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) untuk menyimpan bobot LoRA
- [load_ip_adapter()](/docs/diffusers/v0.43.0/id/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) untuk memuat IP Adapter
#### __call__[[diffusers.AnimateDiffVideoToVideoPipeline.__call__]]
```python
__call__(video: list[list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]]] = None, prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, enforce_inference_steps: bool = False, timesteps: list[int] | None = None, sigmas: list[float] | None = None, guidance_scale: float = 7.5, strength: float = 0.8, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'], decode_chunk_size: int = 16)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L744)
**Parameter:**
video (`list[PipelineImageInput]`) : Video input untuk mengondisikan generasi. Harus berupa daftar gambar/frame dari video.
prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt untuk memandu generasi gambar. Jika tidak didefinisikan, Anda perlu meneruskan `prompt_embeds`.
height (`int`, *opsional*, defaultnya `self.unet.config.sample_size * self.vae_scale_factor`) : Tinggi video yang dihasilkan dalam piksel.
width (`int`, *opsional*, defaultnya `self.unet.config.sample_size * self.vae_scale_factor`) : Lebar video yang dihasilkan dalam piksel.
num_inference_steps (`int`, *opsional*, defaultnya 50) : Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan video dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat.
enforce_inference_steps (`bool`, *opsional*, defaultnya `False`) : Apakah akan menegakkan langkah denoising `num_inference_steps` terlepas dari parameter `strength`. Ketika `False`, jumlah langkah inferensi efektif dikurangi sesuai dengan `strength`.
timesteps (`list[int]`, *opsional*) : Timesteps kustom untuk digunakan dalam proses denoising dengan scheduler yang mendukung argumen `timesteps` di metode `set_timesteps` mereka. Jika tidak didefinisikan, perilaku default saat `num_inference_steps` diteruskan akan digunakan. Harus dalam urutan menurun.
sigmas (`list[float]`, *opsional*) : Sigmas kustom untuk digunakan dalam proses denoising dengan scheduler yang mendukung argumen `sigmas` di metode `set_timesteps` mereka. Jika tidak didefinisikan, perilaku default saat `num_inference_steps` diteruskan akan digunakan.
strength (`float`, *opsional*, default 0.8) : Kekuatan yang lebih tinggi menghasilkan lebih banyak perbedaan antara video asli dan video yang dihasilkan.
guidance_scale (`float`, *opsional*, default 7.5) : Nilai guidance scale yang lebih tinggi mendorong model untuk menghasilkan gambar yang sangat terkait dengan `prompt` teks, dengan mengorbankan kualitas gambar yang lebih rendah. Guidance scale diaktifkan ketika `guidance_scale > 1`.
negative_prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt untuk mengarahkan apa yang tidak boleh disertakan dalam pembuatan gambar. Jika tidak didefinisikan, Anda perlu meneruskan `negative_prompt_embeds` sebagai gantinya. Diabaikan saat tidak menggunakan panduan (`guidance_scale < 1`).
num_videos_per_prompt (`int`, *opsional*, default 1) : Jumlah video yang akan dihasilkan per prompt.
eta (`float`, *opsional*, default 0.0) : Bersesuaian dengan parameter eta (η) dari paper [DDIM](https://huggingface.co/papers/2010.02502). Hanya berlaku untuk [DDIMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/ddim#diffusers.DDIMScheduler), dan diabaikan pada scheduler lainnya.
generator (`torch.Generator` atau `list[torch.Generator]`, *opsional*) : Sebuah [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) untuk membuat proses generasi menjadi deterministik.
latents (`torch.Tensor`, *opsional*) : Laten berisik yang telah dibuat sebelumnya, diambil dari distribusi Gaussian, untuk digunakan sebagai input untuk generasi video. Dapat digunakan untuk menyesuaikan generasi yang sama dengan prompt yang berbeda. Jika tidak disediakan, tensor laten akan dibuat dengan pengambilan sampel menggunakan `generator` acak yang diberikan. Laten harus memiliki bentuk `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks (pemberian bobot pada prompt). Jika tidak disediakan, embedding teks akan dihasilkan dari argumen input `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks negatif yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks (pemberian bobot pada prompt). Jika tidak disediakan, `negative_prompt_embeds` akan dibuat dari argumen input `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`, *opsional*): Input gambar opsional untuk bekerja dengan IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opsional*) : Embedding gambar yang telah dibuat sebelumnya untuk IP-Adapter. Ini harus berupa daftar dengan panjang yang sama dengan jumlah IP-adapter. Setiap elemen harus berupa tensor dengan bentuk `(batch_size, num_images, emb_dim)`. Embedding gambar negatif harus disertakan jika `do_classifier_free_guidance` diatur ke `True`. Jika tidak disediakan, embedding dihitung dari argumen input `ip_adapter_image`.
output_type (`str`, *opsional*, defaultnya `"pil"`) : Format output dari video yang dihasilkan. Pilih antara `torch.Tensor`, `PIL.Image` atau `np.array`.
return_dict (`bool`, *opsional*, defaultnya `True`) : Apakah akan mengembalikan `AnimateDiffPipelineOutput` alih-alih tuple biasa.
cross_attention_kwargs (`dict`, *opsional*) : Kamus kwargs yang jika ditentukan akan diteruskan ke `AttentionProcessor` seperti yang didefinisikan dalam [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
clip_skip (`int`, *opsional*) : Jumlah lapisan yang akan dilewati dari CLIP saat menghitung prompt embeddings. Nilai 1 berarti bahwa output dari lapisan sebelum terakhir akan digunakan untuk menghitung prompt embeddings.
callback_on_step_end (`Callable`, *opsional*) : Fungsi yang dipanggil di akhir setiap langkah denoising selama inferensi. Fungsi ini dipanggil dengan argumen berikut: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` akan berisi daftar semua tensor sesuai yang ditentukan oleh `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opsional*) : Daftar input tensor untuk fungsi `callback_on_step_end`. Tensor yang ditentukan dalam daftar akan diteruskan sebagai argumen `callback_kwargs`. Anda hanya dapat menyertakan variabel yang tercantum dalam atribut `._callback_tensor_inputs` dari kelas pipeline Anda.
decode_chunk_size (`int`, defaultnya `16`) : Jumlah frame yang akan didekode sekaligus saat memanggil metode `decode_latents`.
**Mengembalikan:** [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/id/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) atau `tuple`
Jika `return_dict` adalah `True`, [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/id/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) dikembalikan, selain itu sebuah `tuple` dikembalikan di mana elemen pertama adalah daftar dengan frame yang dihasilkan.
Fungsi panggilan untuk pipeline pada generasi.
Contoh:
#### encode_prompt[[diffusers.AnimateDiffVideoToVideoPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L256)
**Parameter:**
prompt (`str` atau `list[str]`, *opsional*) : prompt yang akan dienkod
device : (`torch.device`): perangkat torch
num_images_per_prompt (`int`) : jumlah gambar yang harus dihasilkan per prompt
do_classifier_free_guidance (`bool`) : apakah akan menggunakan classifier free guidance atau tidak
negative_prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt yang tidak akan memandu generasi gambar. Jika tidak didefinisikan, Anda harus meneruskan `negative_prompt_embeds` sebagai gantinya. Diabaikan saat tidak menggunakan guidance (yaitu, diabaikan jika `guidance_scale` kurang dari `1`).
prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks yang sudah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* penimbangan prompt. Jika tidak disediakan, embedding teks akan dihasilkan dari argumen input `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks negatif yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* penimbangan prompt. Jika tidak disediakan, negative_prompt_embeds akan dibuat dari argumen input `negative_prompt`.
lora_scale (`float`, *opsional*) : Skala LoRA yang akan diterapkan ke semua lapisan LoRA dari text encoder jika lapisan LoRA dimuat.
clip_skip (`int`, *opsional*) : Jumlah lapisan yang akan dilewati dari CLIP saat menghitung prompt embeddings. Nilai 1 berarti bahwa output dari lapisan sebelum terakhir akan digunakan untuk menghitung prompt embeddings.
Mengkodekan prompt menjadi hidden states dari text encoder.
## AnimateDiffVideoToVideoControlNetPipeline[[diffusers.AnimateDiffVideoToVideoControlNetPipeline]]
#### diffusers.AnimateDiffVideoToVideoControlNetPipeline[[diffusers.AnimateDiffVideoToVideoControlNetPipeline]]
```python
diffusers.AnimateDiffVideoToVideoControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: diffusers.models.controlnets.controlnet.ControlNetModel | list[diffusers.models.controlnets.controlnet.ControlNetModel] | tuple[diffusers.models.controlnets.controlnet.ControlNetModel] | diffusers.models.controlnets.multicontrolnet.MultiControlNetModel, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L199)
**Parameter:**
vae ([AutoencoderKL](/docs/diffusers/v0.43.0/id/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Model Variational Auto-Encoder (VAE) untuk mengodekan dan mendekodekan gambar ke dan dari representasi laten.
text_encoder (`CLIPTextModel`) : text-encoder beku ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : Sebuah [CLIPTokenizer](https://huggingface.co/docs/transformers/v5.22.2/en/model_doc/clip#transformers.CLIPTokenizer) untuk melakukan tokenisasi teks.
unet ([UNet2DConditionModel](/docs/diffusers/v0.43.0/id/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Sebuah [UNet2DConditionModel](/docs/diffusers/v0.43.0/id/api/models/unet2d-cond#diffusers.UNet2DConditionModel) yang digunakan untuk membuat UNetMotionModel guna mendenois latens video yang telah dikodekan.
motion_adapter (`MotionAdapter`) : Sebuah `MotionAdapter` yang digunakan bersama dengan `unet` untuk menghilangkan noise pada latens video yang telah dikodekan.
controlnet ([ControlNetModel](/docs/diffusers/v0.43.0/id/api/models/controlnet#diffusers.ControlNetModel) atau `list[ControlNetModel]` atau `tuple[ControlNetModel]` atau `MultiControlNetModel`) : Menyediakan kondisioning tambahan untuk `unet` selama proses denoising. Jika Anda mengatur beberapa ControlNet sebagai list, output dari masing-masing ControlNet akan dijumlahkan untuk membuat satu kondisioning tambahan yang digabungkan.
scheduler ([SchedulerMixin](/docs/diffusers/v0.43.0/id/api/schedulers/overview#diffusers.SchedulerMixin)) : Penjadwal yang digunakan bersama `unet` untuk menghilangkan noise pada latens gambar yang telah dikodekan. Bisa berupa [DDIMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler), atau [PNDMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/pndm#diffusers.PNDMScheduler).
Pipeline untuk generasi video-ke-video dengan panduan ControlNet.
Model ini mewarisi dari [DiffusionPipeline](/docs/diffusers/v0.43.0/id/api/pipelines/overview#diffusers.DiffusionPipeline). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan untuk semua pipeline (mengunduh, menyimpan, menjalankan pada perangkat tertentu, dll.).
Pipeline juga mewarisi metode pemuatan berikut:
- [load_textual_inversion()](/docs/diffusers/v0.43.0/id/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) untuk memuat embedding textual inversion
- [load_lora_weights()](/docs/diffusers/v0.43.0/id/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) untuk memuat bobot LoRA
- [save_lora_weights()](/docs/diffusers/v0.43.0/id/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) untuk menyimpan bobot LoRA
- [load_ip_adapter()](/docs/diffusers/v0.43.0/id/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) untuk memuat IP Adapter
#### __call__[[diffusers.AnimateDiffVideoToVideoControlNetPipeline.__call__]]
```python
__call__(video: list[list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]]] = None, prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, enforce_inference_steps: bool = False, timesteps: list[int] | None = None, sigmas: list[float] | None = None, guidance_scale: float = 7.5, strength: float = 0.8, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, guess_mode: bool = False, control_guidance_start: float | list[float] = 0.0, control_guidance_end: float | list[float] = 1.0, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list[str] = ['latents'], decode_chunk_size: int = 16)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L909)
**Parameter:**
video (`list[PipelineImageInput]`) : Video input untuk mengondisikan generasi. Harus berupa daftar gambar/frame dari video.
prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt untuk memandu generasi gambar. Jika tidak didefinisikan, Anda perlu meneruskan `prompt_embeds`.
height (`int`, *opsional*, defaultnya `self.unet.config.sample_size * self.vae_scale_factor`) : Tinggi video yang dihasilkan dalam piksel.
width (`int`, *opsional*, defaultnya `self.unet.config.sample_size * self.vae_scale_factor`) : Lebar video yang dihasilkan dalam piksel.
num_inference_steps (`int`, *opsional*, defaultnya 50) : Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan video dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat.
enforce_inference_steps (`bool`, *opsional*, defaultnya `False`) : Apakah akan menegakkan langkah denoising `num_inference_steps` terlepas dari parameter `strength`. Ketika `False`, jumlah langkah inferensi efektif dikurangi sesuai dengan `strength`.
timesteps (`list[int]`, *opsional*) : Timesteps kustom untuk digunakan dalam proses denoising dengan scheduler yang mendukung argumen `timesteps` di metode `set_timesteps` mereka. Jika tidak didefinisikan, perilaku default saat `num_inference_steps` diteruskan akan digunakan. Harus dalam urutan menurun.
sigmas (`list[float]`, *opsional*) : Sigmas kustom untuk digunakan dalam proses denoising dengan scheduler yang mendukung argumen `sigmas` di metode `set_timesteps` mereka. Jika tidak didefinisikan, perilaku default saat `num_inference_steps` diteruskan akan digunakan.
strength (`float`, *opsional*, default 0.8) : Kekuatan yang lebih tinggi menghasilkan lebih banyak perbedaan antara video asli dan video yang dihasilkan.
guidance_scale (`float`, *opsional*, default 7.5) : Nilai guidance scale yang lebih tinggi mendorong model untuk menghasilkan gambar yang sangat terkait dengan `prompt` teks, dengan mengorbankan kualitas gambar yang lebih rendah. Guidance scale diaktifkan ketika `guidance_scale > 1`.
negative_prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt untuk mengarahkan apa yang tidak boleh disertakan dalam pembuatan gambar. Jika tidak didefinisikan, Anda perlu meneruskan `negative_prompt_embeds` sebagai gantinya. Diabaikan saat tidak menggunakan panduan (`guidance_scale < 1`).
num_videos_per_prompt (`int`, *opsional*, default 1) : Jumlah video yang akan dihasilkan per prompt.
eta (`float`, *opsional*, default 0.0) : Bersesuaian dengan parameter eta (η) dari paper [DDIM](https://huggingface.co/papers/2010.02502). Hanya berlaku untuk [DDIMScheduler](/docs/diffusers/v0.43.0/id/api/schedulers/ddim#diffusers.DDIMScheduler), dan diabaikan pada scheduler lainnya.
generator (`torch.Generator` atau `list[torch.Generator]`, *opsional*) : Sebuah [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) untuk membuat proses generasi menjadi deterministik.
latents (`torch.Tensor`, *opsional*) : Laten berisik yang telah dibuat sebelumnya, diambil dari distribusi Gaussian, untuk digunakan sebagai input untuk generasi video. Dapat digunakan untuk menyesuaikan generasi yang sama dengan prompt yang berbeda. Jika tidak disediakan, tensor laten akan dibuat dengan pengambilan sampel menggunakan `generator` acak yang diberikan. Laten harus memiliki bentuk `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks (pemberian bobot pada prompt). Jika tidak disediakan, embedding teks akan dihasilkan dari argumen input `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks negatif yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks (pemberian bobot pada prompt). Jika tidak disediakan, `negative_prompt_embeds` akan dibuat dari argumen input `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`, *opsional*): Input gambar opsional untuk bekerja dengan IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opsional*) : Embedding gambar yang telah dibuat sebelumnya untuk IP-Adapter. Ini harus berupa daftar dengan panjang yang sama dengan jumlah IP-adapter. Setiap elemen harus berupa tensor dengan bentuk `(batch_size, num_images, emb_dim)`. Embedding gambar negatif harus disertakan jika `do_classifier_free_guidance` diatur ke `True`. Jika tidak disediakan, embedding dihitung dari argumen input `ip_adapter_image`.
conditioning_frames (`list[PipelineImageInput]`, *opsional*) : Kondisi input ControlNet untuk memberikan panduan kepada `unet` dalam proses generasi. Jika beberapa ControlNet ditentukan, gambar harus diberikan sebagai daftar sehingga setiap elemen dalam daftar dapat di-batch dengan benar untuk input ke satu ControlNet.
output_type (`str`, *opsional*, defaultnya `"pil"`) : Format output dari video yang dihasilkan. Pilih antara `torch.Tensor`, `PIL.Image` atau `np.array`.
return_dict (`bool`, *opsional*, defaultnya `True`) : Apakah akan mengembalikan `AnimateDiffPipelineOutput` alih-alih tuple biasa.
cross_attention_kwargs (`dict`, *opsional*) : Kamus kwargs yang jika ditentukan akan diteruskan ke `AttentionProcessor` seperti yang didefinisikan dalam [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
controlnet_conditioning_scale (`float` atau `list[float]`, *opsional*, default 1.0) : Output dari ControlNet dikalikan dengan `controlnet_conditioning_scale` sebelum ditambahkan ke residual di `unet` asli. Jika beberapa ControlNet ditentukan di `init`, Anda dapat mengatur skala yang sesuai sebagai list.
guess_mode (`bool`, *opsional*, defaultnya `False`) : Encoder ControlNet mencoba mengenali konten gambar input bahkan jika Anda menghapus semua prompt. Nilai `guidance_scale` antara 3.0 dan 5.0 direkomendasikan.
control_guidance_start (`float` atau `list[float]`, *opsional*, default 0.0) : Persentase dari total langkah di mana ControlNet mulai diterapkan.
control_guidance_end (`float` atau `list[float]`, *opsional*, default 1.0) : Persentase dari total langkah di mana ControlNet berhenti diterapkan.
clip_skip (`int`, *opsional*) : Jumlah lapisan yang akan dilewati dari CLIP saat menghitung prompt embeddings. Nilai 1 berarti bahwa output dari lapisan sebelum terakhir akan digunakan untuk menghitung prompt embeddings.
callback_on_step_end (`Callable`, *opsional*) : Fungsi yang dipanggil di akhir setiap langkah denoising selama inferensi. Fungsi ini dipanggil dengan argumen berikut: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` akan berisi daftar semua tensor sesuai yang ditentukan oleh `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opsional*) : Daftar input tensor untuk fungsi `callback_on_step_end`. Tensor yang ditentukan dalam daftar akan diteruskan sebagai argumen `callback_kwargs`. Anda hanya dapat menyertakan variabel yang tercantum dalam atribut `._callback_tensor_inputs` dari kelas pipeline Anda.
decode_chunk_size (`int`, defaultnya `16`) : Jumlah frame yang akan didekode sekaligus saat memanggil metode `decode_latents`.
**Mengembalikan:** [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/id/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) atau `tuple`
Jika `return_dict` adalah `True`, [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/v0.43.0/id/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) dikembalikan, selain itu sebuah `tuple` dikembalikan di mana elemen pertama adalah daftar dengan frame yang dihasilkan.
Fungsi panggilan untuk pipeline pada generasi.
Contoh:
#### encode_prompt[[diffusers.AnimateDiffVideoToVideoControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L287)
**Parameter:**
prompt (`str` atau `list[str]`, *opsional*) : prompt yang akan dienkod
device : (`torch.device`): perangkat torch
num_images_per_prompt (`int`) : jumlah gambar yang harus dihasilkan per prompt
do_classifier_free_guidance (`bool`) : apakah akan menggunakan classifier free guidance atau tidak
negative_prompt (`str` atau `list[str]`, *opsional*) : Prompt atau prompt-prompt yang tidak akan memandu generasi gambar. Jika tidak didefinisikan, Anda harus meneruskan `negative_prompt_embeds` sebagai gantinya. Diabaikan saat tidak menggunakan guidance (yaitu, diabaikan jika `guidance_scale` kurang dari `1`).
prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks yang sudah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* penimbangan prompt. Jika tidak disediakan, embedding teks akan dihasilkan dari argumen input `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opsional*) : Embedding teks negatif yang telah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, *misalnya* penimbangan prompt. Jika tidak disediakan, negative_prompt_embeds akan dibuat dari argumen input `negative_prompt`.
lora_scale (`float`, *opsional*) : Skala LoRA yang akan diterapkan ke semua lapisan LoRA dari text encoder jika lapisan LoRA dimuat.
clip_skip (`int`, *opsional*) : Jumlah lapisan yang akan dilewati dari CLIP saat menghitung prompt embeddings. Nilai 1 berarti bahwa output dari lapisan sebelum terakhir akan digunakan untuk menghitung prompt embeddings.
Mengkodekan prompt menjadi hidden states dari text encoder.
## AnimateDiffPipelineOutput[[diffusers.pipelines.animatediff.AnimateDiffPipelineOutput]]
#### diffusers.pipelines.animatediff.AnimateDiffPipelineOutput[[diffusers.pipelines.animatediff.AnimateDiffPipelineOutput]]
```python
diffusers.pipelines.animatediff.AnimateDiffPipelineOutput(frames: typing.Union[torch.Tensor, numpy.ndarray, list[list[PIL.Image.Image]]])
```
[Sumber](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/animatediff/pipeline_output.py#L11)
**Parameter:**
frames (`torch.Tensor`, `np.ndarray`, atau list[list[PIL.Image.Image]]) : daftar output video - Dapat berupa daftar bersarang dengan panjang `batch_size,` di mana setiap sub-daftar berisi hasil denoising
Kelas output untuk pipeline AnimateDiff.
Sequences gambar PIL dengan panjang `num_frames.` Bisa juga berupa array NumPy atau tensor Torch dengan bentuk `(batch_size, num_frames, channels, height, width)`