# GIT
## نظرة عامة
قُدِّم نموذج GIT في [GIT: A Generative Image-to-text Transformer for Vision and Language](https://huggingface.co/papers/2205.14100) من قِبل Jianfeng Wang و Zhengyuan Yang و Xiaowei Hu و Linjie Li و Kevin Lin و Zhe Gan و Zicheng Liu و Ce Liu و Lijuan Wang. يعتمد GIT على مُحوِّل (Transformer) مُفكِّك (decoder-only) يستفيد من مُشفِّر الرؤية الخاص بـ [CLIP](clip) لتكييف النموذج على مدخلات الرؤية إلى جانب النص. يحقق النموذج نتائج متقدمة من الطراز الأول (state-of-the-art) في معايير تقييم وصف الصور والإجابة على الأسئلة البصرية.
المستخلص من الورقة البحثية هو كالتالي:
*في هذه الورقة، نصمّم وندرّب محوّلاً توليدياً من الصورة إلى النص، GIT، لتوحيد مهام الرؤية واللغة مثل وصف الصور/الفيديوهات والإجابة عن الأسئلة. في حين أن النماذج التوليدية توفر بنية شبكة متسقة بين التدريب المسبق والتدريب الدقيق، فإن الأعمال القائمة تحتوي عادةً على هياكل معقدة (مشفّر/مفكك أحادي/متعدد الوسائط) وتعتمد على وحدات خارجية مثل كاشفات/وسّامي الكائنات والتعرف الضوئي على الحروف (OCR). في GIT، نبسّط البنية إلى مشفّر صورة واحد ومفكك نص واحد تحت مهمة نمذجة لغة واحدة. كما نوسّع نطاق بيانات التدريب المسبق وحجم النموذج لتعزيز أداء النموذج. دون أي إضافات معقدة، يرسّخ GIT الخاص بنا مستويات جديدة من الأداء على 12 معياراً صعباً بفارق كبير. على سبيل المثال، يتفوق نموذجنا على الأداء البشري لأول مرة في TextCaps (138.2 مقابل 125.5 في CIDEr). علاوة على ذلك، نعرض مخططاً جديداً لتصنيف الصور والتعرف على نص المشهد القائم على التوليد، محققاً أداءً مقبولاً على المعايير القياسية.*
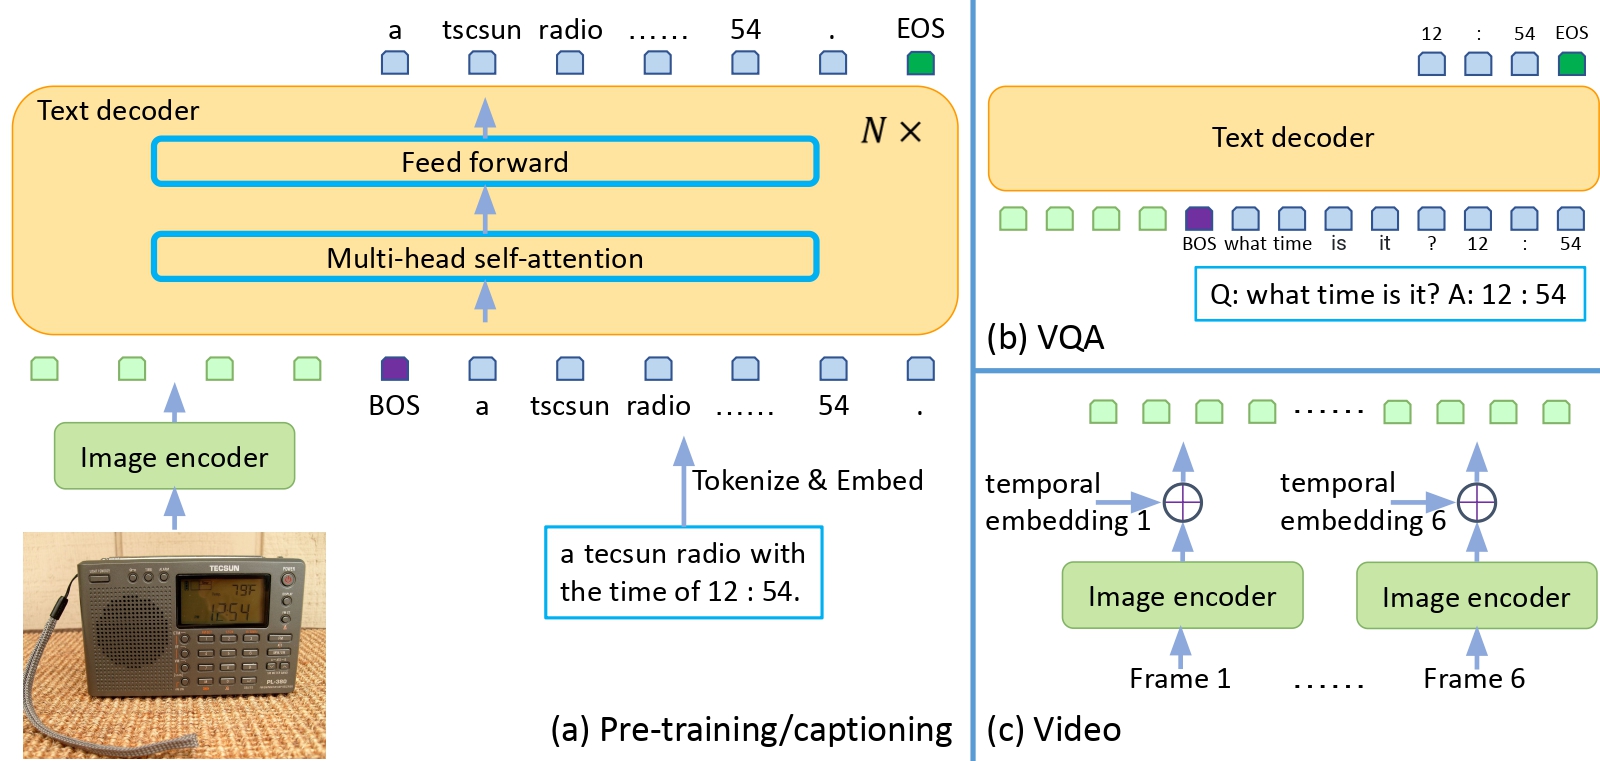 بنية GIT. مأخوذة من الورقة الأصلية.
تمت مساهمة هذا النموذج من قِبل [nielsr](https://huggingface.co/nielsr). يمكن العثور على الكود الأصلي [هنا](https://github.com/microsoft/GenerativeImage2Text).
## نصائح للاستخدام
- يُنفَّذ GIT بطريقة مشابهة جداً لطريقة GPT-2، والفرق الوحيد هو أن النموذج مشروط أيضاً بـ`pixel_values`.
## الموارد
قائمة بموارد رسمية من Hugging Face وموارد مجتمعية (مشار إليها بـ 🌎) لمساعدتك على البدء باستخدام GIT.
- يمكن العثور على دفاتر ملاحظات تجريبية تتعلق بالاستدلال + الضبط الدقيق لـ GIT على بيانات مخصصة [هنا](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/GIT).
- انظر أيضاً: [دليل مهمة نمذجة اللغة السببية](../tasks/language_modeling)
إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب وسنقوم بمراجعته. ينبغي أن يُظهر المورد شيئًا جديدًا بشكل مثالي بدلاً من تكرار مورد موجود مسبقًا.
## GitVisionConfig[[transformers.GitVisionConfig]]
#### transformers.GitVisionConfig[[transformers.GitVisionConfig]]
```python
transformers.GitVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/configuration_git.py#L27)
**المعاملات:**
hidden_size (`int`، *اختياري*، القيمة الافتراضية `768`) : بُعد التمثيلات المخفية.
intermediate_size (`int`، *اختياري*، القيمة الافتراضية `3072`) : بُعد تمثيلات MLP.
num_hidden_layers (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد الطبقات المخفية في مُفكِّك Transformer.
num_attention_heads (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد رؤوس الانتباه في كل طبقة انتباه داخل مُفكِّك Transformer.
num_channels (`int`، *اختياري*، القيمة الافتراضية `3`) : عدد قنوات الإدخال.
image_size (`Union[int, list[int], tuple[int, int]]`، *اختياري*، القيمة الافتراضية `224`) : حجم (دقة) كل صورة.
patch_size (`Union[int, list[int], tuple[int, int]]`، *اختياري*، القيمة الافتراضية `16`) : حجم (دقة) كل رقعة.
hidden_act (`str`، *اختياري*، القيمة الافتراضية `quick_gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
layer_norm_eps (`float`، *اختياري*، القيمة الافتراضية `1e-05`) : قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
attention_dropout (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.0`) : نسبة الإسقاط (dropout) لاحتمالات الانتباه.
initializer_range (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
هذه فئة الإعدادات المخزنة لإعدادات GitModel. تُستخدم لاستحداث نموذج Git وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [microsoft/git-base](https://huggingface.co/microsoft/git-base)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
مثال:
```python
>>> from transformers import GitVisionConfig, GitVisionModel
>>> # Initializing a GitVisionConfig with microsoft/git-base style configuration
>>> configuration = GitVisionConfig()
>>> # Initializing a GitVisionModel (with random weights) from the microsoft/git-base style configuration
>>> model = GitVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## GitVisionModel[[transformers.GitVisionModel]]
#### transformers.GitVisionModel[[transformers.GitVisionModel]]
```python
transformers.GitVisionModel(config: GitVisionConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L634)
**المعاملات:**
config ([GitVisionConfig](/docs/transformers/main/ar/model_doc/git#transformers.GitVisionConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج الرؤية من CLIP، المستخدم في GIT، دون أي رأس أو إسقاط في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.GitVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L652)
**المعاملات:**
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام [CLIPImageProcessor](/docs/transformers/main/ar/model_doc/clip#transformers.CLIPImageProcessor). راجع [CLIPImageProcessor.__call__()](/docs/transformers/main/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([GitProcessor](/docs/transformers/main/ar/model_doc/git#transformers.GitProcessor) يستخدم [CLIPImageProcessor](/docs/transformers/main/ar/model_doc/clip#transformers.CLIPImageProcessor) لمعالجة الصور).
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
**يعيد:** [BaseModelOutput](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutput) أو `tuple(torch.Tensor)`
[BaseModelOutput](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutput) أو مجموعة مرتبة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([GitConfig](/docs/transformers/main/ar/model_doc/git#transformers.GitConfig)) والمدخلات.
تتجاوز طريقة [GitVisionModel](/docs/transformers/main/ar/model_doc/git#transformers.GitVisionModel) الخاصة بـ forward الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, GitVisionModel
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base")
>>> model = GitVisionModel.from_pretrained("microsoft/git-base")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
```
## GitConfig[[transformers.GitConfig]]
#### transformers.GitConfig[[transformers.GitConfig]]
```python
transformers.GitConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.models.git.configuration_git.GitVisionConfig | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 6, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 1024, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, use_cache: bool = True, tie_word_embeddings: bool = False, bos_token_id: int | None = 101, eos_token_id: int | list[int] | None = 102, num_image_with_embedding: int | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/configuration_git.py#L62)
**المعاملات:**
vision_config (`Union[dict, ~models.git.configuration_git.GitVisionConfig]`، *اختياري*) : كائن الإعدادات أو قاموس العمود الفقري البصري.
vocab_size (`int`، *اختياري*، القيمة الافتراضية `30522`) : حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطة `input_ids`.
hidden_size (`int`، *اختياري*، القيمة الافتراضية `768`) : بُعد التمثيلات المخفية.
num_hidden_layers (`int`, *اختياري*, الافتراضي هو `6`) : عدد الطبقات المخفية في مُفكِّك Transformer.
num_attention_heads (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد رؤوس الانتباه في كل طبقة انتباه داخل مُفكِّك Transformer.
intermediate_size (`int`، *اختياري*، القيمة الافتراضية `3072`) : بُعد تمثيلات MLP.
hidden_act (`str`، *اختياري*، القيمة الافتراضية `gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
hidden_dropout_prob (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.1`) : احتمال الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات (embeddings) والمُشفِّر (encoder) والمُجمِّع (pooler).
attention_probs_dropout_prob (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.1`) : نسبة الإسقاط (dropout) لاحتمالات الانتباه.
max_position_embeddings (`int`، *اختياري*، الافتراضي هو `1024`) : أقصى طول تسلسل قد يُستخدم به هذا النموذج.
initializer_range (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
layer_norm_eps (`float`، *اختياري*، القيمة الافتراضية `1e-12`) : قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
pad_token_id (`int`، *اختياري*، القيمة الافتراضية `0`) : معرّف الرمز المستخدم للتعبئة في المفردات.
use_cache (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب على النموذج إرجاع قيم المفاتيح/القيم الأخيرة للانتباه (لا تستخدمها جميع النماذج). لا ينطبق إلا إذا كان `config.is_decoder=True` أو عندما يكون النموذج نموذجًا توليديًا يعتمد على المُفكِّك فقط.
tie_word_embeddings (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان يجب ربط ترميزات الأوزان وفقاً لخريطة `tied_weights_keys` الخاصة بالنموذج.
bos_token_id (`int`، *اختياري*، القيمة الافتراضية `101`) : معرّف الرمز المستخدم لبدء البث في المفردات.
eos_token_id (`Union[int, list[int]]`، *اختياري*، القيمة الافتراضية `102`) : معرّف الرمز المستخدم لنهاية البث في المفردات.
num_image_with_embedding (`int`, *اختياري*) : عدد التضمينات الزمنية التي يجب إضافتها، في حال استخدام النموذج لوصف الفيديو/الأسئلة والأجوبة.
هذه فئة الإعدادات المخزنة لإعدادات GitModel. تُستخدم لاستحداث نموذج Git وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [microsoft/git-base](https://huggingface.co/microsoft/git-base)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
أمثلة:
```python
>>> from transformers import GitConfig, GitModel
>>> # Initializing a GIT microsoft/git-base style configuration
>>> configuration = GitConfig()
>>> # Initializing a model (with random weights) from the microsoft/git-base style configuration
>>> model = GitModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## GitProcessor[[transformers.GitProcessor]]
#### transformers.GitProcessor[[transformers.GitProcessor]]
```python
transformers.GitProcessor(image_processor, tokenizer)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/processing_git.py#L23)
**المعاملات:**
image_processor (`CLIPImageProcessor`) : مُعالج الصور هو مدخل مطلوب.
tokenizer (`BertTokenizer`) : مُجزِّئ النص (tokenizer) هو مدخل إلزامي.
ينشئ GitProcessor الذي يجمع معالج الصور ومُرمّز الرموز في معالج واحد.
يوفر [GitProcessor](/docs/transformers/main/ar/model_doc/git#transformers.GitProcessor) جميع وظائف [CLIPImageProcessor](/docs/transformers/main/ar/model_doc/clip#transformers.CLIPImageProcessor) و[BertTokenizer](/docs/transformers/main/ar/model_doc/lxmert#transformers.BertTokenizer). راجع [~CLIPImageProcessor](/docs/transformers/main/ar/model_doc/clip#transformers.CLIPImageProcessor) و[~BertTokenizer](/docs/transformers/main/ar/model_doc/lxmert#transformers.BertTokenizer) لمزيد من المعلومات.
#### __call__[[transformers.GitProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L653)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *اختياري*) : الصورة التي سيتم معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`، *اختياري*) : التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُجزَّأ مسبقًا). إذا مررت مدخلات مُجزَّأة مسبقًا، فاضبط `is_split_into_words=True` لتجنب الغموض مع المدخلات المُجمَّعة في دفعات.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`، *اختياري*) : الفيديو المراد معالجته مسبقًا. يتوقع إدخال فيديو واحد أو دفعة من الفيديوهات بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر فيديوهات بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`، *اختياري*) : الصوت أو مجموعة الأصوات التي يجب تجهيزها. يمكن أن يكون كل صوت مصفوفة NumPy أو متجه PyTorch. في حالة استخدام مصفوفة NumPy/متجه PyTorch، يجب أن يكون شكل كل صوت (C, T)، حيث C هو عدد القنوات، وT هو طول العينة للصوت.
return_tensors (`str` أو [TensorType](/docs/transformers/main/ar/internal/file_utils#transformers.TensorType)، *اختياري*) : إذا تم تعيينه، فسيُرجع تينسورات من إطار عمل محدد. القيم المقبولة هي: - `'pt'`: يُرجع كائنات `torch.Tensor` من PyTorch. - `'np'`: يُرجع كائنات `np.ndarray` من NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/ar/main_classes/processors#transformers.ProcessingKwargs)، *اختياري*) : خيارات معالجة إضافية لكل نمط (نص، صور، مقاطع فيديو، صوت). تُدرج المعلمات الخاصة بالنموذج أعلاه؛ راجع فئة TypedDict للحصول على القائمة الكاملة للحجج المدعومة.
## GitModel[[transformers.GitModel]]
#### transformers.GitModel[[transformers.GitModel]]
```python
transformers.GitModel(config: GitConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L707)
**المعاملات:**
config ([GitConfig](/docs/transformers/main/ar/model_doc/git#transformers.GitConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج GIT العاري، وهو محوّل يتكون من مُشفِّر صور CLIP ومُفكِّك نصّ يُخرج حالات مخفية خام
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.GitModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, use_cache: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L738)
**المعاملات:**
input_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/main/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
position_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام [CLIPImageProcessor](/docs/transformers/main/ar/model_doc/clip#transformers.CLIPImageProcessor). راجع [CLIPImageProcessor.__call__()](/docs/transformers/main/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([GitProcessor](/docs/transformers/main/ar/model_doc/git#transformers.GitProcessor) يستخدم [CLIPImageProcessor](/docs/transformers/main/ar/model_doc/clip#transformers.CLIPImageProcessor) لمعالجة الصور).
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
past_key_values (`~cache_utils.Cache`، *اختياري*) : حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكوّن هذا عادةً من `past_key_values` التي يعيدها النموذج في مرحلة سابقة من فك الترميز، عندما يكون `use_cache=True` أو `config.use_cache=True`. يُسمح فقط بتمرير كائن [Cache](/docs/transformers/main/ar/internal/generation_utils#transformers.Cache) كمدخل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache). إذا لم يتم تمرير `past_key_values`، فسيتم تهيئة [DynamicCache](/docs/transformers/main/ar/internal/generation_utils#transformers.DynamicCache) افتراضيًا. سيُخرج النموذج نفس تنسيق الذاكرة المؤقتة المُدخل. إذا تم استخدام `past_key_values`، يُتوقع من المستخدم إدخال `input_ids` غير المعالجة فقط (تلك التي لم تُعطَ حالات مفاتيح وقيم سابقة لها في هذا النموذج) بأبعاد `(batch_size, unprocessed_length)` بدلاً من جميع `input_ids` بأبعاد `(batch_size, sequence_length)`.
use_cache (`bool`، *اختياري*) : إذا تم ضبطه على `True`، تُعاد حالات المفاتيح والقيم `past_key_values` ويمكن استخدامها لتسريع فك الترميز (انظر `past_key_values`).
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
**يعيد:** [BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([GitConfig](/docs/transformers/main/ar/model_doc/git#transformers.GitConfig)) والمدخلات.
تتجاوز طريقة [GitModel](/docs/transformers/main/ar/model_doc/git#transformers.GitModel) الأمامية الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from transformers import AutoProcessor, AutoModel
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base")
>>> model = AutoModel.from_pretrained("microsoft/git-base")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "this is an image of two cats"
>>> inputs = processor(images=image, text=text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
```
## GitForCausalLM[[transformers.GitForCausalLM]]
#### transformers.GitForCausalLM[[transformers.GitForCausalLM]]
```python
transformers.GitForCausalLM(config: GitConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L890)
**المعاملات:**
config ([GitConfig](/docs/transformers/main/ar/model_doc/git#transformers.GitConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج GIT مع رأس `language modeling` في الأعلى لنمذجة اللغة التلقائية.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.GitForCausalLM.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, use_cache: bool | None = None, interpolate_pos_encoding: bool = False, logits_to_keep: typing.Union[int, torch.Tensor] = 0, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L908)
**المعاملات:**
input_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/main/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
position_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام [CLIPImageProcessor](/docs/transformers/main/ar/model_doc/clip#transformers.CLIPImageProcessor). راجع [CLIPImageProcessor.__call__()](/docs/transformers/main/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([GitProcessor](/docs/transformers/main/ar/model_doc/git#transformers.GitProcessor) يستخدم [CLIPImageProcessor](/docs/transformers/main/ar/model_doc/clip#transformers.CLIPImageProcessor) لمعالجة الصور).
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
labels (`torch.LongTensor` بأبعاد `(batch_size, sequence_length)`، *اختياري*) : التسميات لحساب خسارة نمذجة اللغة من اليسار إلى اليمين (توقع الكلمة التالية). يجب أن تكون الفهارس ضمن `[-100, 0, ..., config.vocab_size]` (انظر docstring الخاص بـ`input_ids`). تُتجاهل الرموز التي تكون فهارسها مضبوطة على `-100` (مقنّعة)، وتُحسب الخسارة فقط للرموز التي تسمياتها ضمن `[0, ..., config.vocab_size]`
past_key_values (`~cache_utils.Cache`، *اختياري*) : حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكوّن هذا عادةً من `past_key_values` التي يعيدها النموذج في مرحلة سابقة من فك الترميز، عندما يكون `use_cache=True` أو `config.use_cache=True`. يُسمح فقط بتمرير كائن [Cache](/docs/transformers/main/ar/internal/generation_utils#transformers.Cache) كمدخل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache). إذا لم يتم تمرير `past_key_values`، فسيتم تهيئة [DynamicCache](/docs/transformers/main/ar/internal/generation_utils#transformers.DynamicCache) افتراضيًا. سيُخرج النموذج نفس تنسيق الذاكرة المؤقتة المُدخل. إذا تم استخدام `past_key_values`، يُتوقع من المستخدم إدخال `input_ids` غير المعالجة فقط (تلك التي لم تُعطَ حالات مفاتيح وقيم سابقة لها في هذا النموذج) بأبعاد `(batch_size, unprocessed_length)` بدلاً من جميع `input_ids` بأبعاد `(batch_size, sequence_length)`.
use_cache (`bool`، *اختياري*) : إذا تم ضبطه على `True`، تُعاد حالات المفاتيح والقيم `past_key_values` ويمكن استخدامها لتسريع فك الترميز (انظر `past_key_values`).
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
logits_to_keep (`Union[int, torch.Tensor]`، *اختياري*، القيمة الافتراضية `0`) : إذا كان `int`، يتم حساب القيم اللوجستية (logits) لآخر `logits_to_keep` رموز. إذا كانت `0`، يتم حساب القيم اللوجستية لجميع `input_ids` (حالة خاصة). لا تكون قيم اللوجستيات للرمز الأخير فقط ضرورية للتوليد، ويمكن أن يوفر حسابها لذلك الرمز وحده ذاكرة، وهو ما يصبح ذا أهمية كبيرة للترتيبات الطويلة أو لحجم المفردات الكبير. إذا كان `torch.Tensor`، يجب أن يكون بعدًا واحدًا (1D) ويتوافق مع الفهارس التي يجب الاحتفاظ بها في بُعد طول الترتيب. وهذا مفيد عند استخدام تنسيق المصفوفات المعبأة (packed tensor format) (بعد واحد لكل من الدفعة وطول الترتيب).
**يعيد:** [CausalLMOutputWithPast](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithPast) أو `tuple(torch.Tensor)`
[CausalLMOutputWithPast](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithPast) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([GitConfig](/docs/transformers/main/ar/model_doc/git#transformers.GitConfig)) والمدخلات.
تتجاوز طريقة [GitForCausalLM](/docs/transformers/main/ar/model_doc/git#transformers.GitForCausalLM) الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`، *اختياري*، يُعاد عند توفير `labels`) -- خسارة نمذجة اللغة (لتوقع الرمز التالي).
- **logits** (`torch.Tensor` من الشكل `(batch_size, sequence_length, config.vocab_size)`) -- درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).
- **past_key_values** (`Cache`، *اختياري*، يُعاد عند تمرير `use_cache=True` أو عند تعيين `config.use_cache=True`) -- هو كائن من نوع [Cache](/docs/transformers/main/ar/internal/generation_utils#transformers.Cache). لمزيد من التفاصيل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache).
تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي) يمكن استخدامها (انظر مدخل `past_key_values`) لتسريع فك الترميز التسلسلي.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
مثال على وصف الصور:
```python
>>> from transformers import AutoProcessor, AutoModelForCausalLM
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base-coco")
>>> model = AutoModelForCausalLM.from_pretrained("microsoft/git-base-coco")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> pixel_values = processor(images=image, return_tensors="pt").pixel_values
>>> generated_ids = model.generate(pixel_values=pixel_values, max_length=50)
>>> generated_caption = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
>>> print(generated_caption)
two cats sleeping on a pink blanket next to remotes.
```
مثال على الإجابة البصرية عن الأسئلة (VQA):
```python
>>> from transformers import AutoProcessor, AutoModelForCausalLM
>>> from huggingface_hub import hf_hub_download
>>> from PIL import Image
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base-textvqa")
>>> model = AutoModelForCausalLM.from_pretrained("microsoft/git-base-textvqa")
>>> file_path = hf_hub_download(repo_id="nielsr/textvqa-sample", filename="bus.png", repo_type="dataset")
>>> image = Image.open(file_path).convert("RGB")
>>> pixel_values = processor(images=image, return_tensors="pt").pixel_values
>>> question = "what does the front of the bus say at the top?"
>>> input_ids = processor(text=question, add_special_tokens=False).input_ids
>>> input_ids = [processor.tokenizer.cls_token_id] + input_ids
>>> input_ids = torch.tensor(input_ids).unsqueeze(0)
>>> generated_ids = model.generate(pixel_values=pixel_values, input_ids=input_ids, max_length=50)
>>> print(processor.batch_decode(generated_ids, skip_special_tokens=True))
['what does the front of the bus say at the top? special']
```
مثال على وصف الفيديو:
```python
>>> import av
>>> import numpy as np
>>> from PIL import Image
>>> from huggingface_hub import hf_hub_download
>>> from transformers import AutoProcessor, AutoModelForCausalLM
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base-vatex")
>>> model = AutoModelForCausalLM.from_pretrained("microsoft/git-base-vatex")
>>> # set seed for reproducibility
>>> np.random.seed(45)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # load video
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample frames
>>> num_frames = model.config.num_image_with_embedding
>>> indices = sample_frame_indices(
... clip_len=num_frames, frame_sample_rate=4, seg_len=container.streams.video[0].frames
... )
>>> frames = read_video_pyav(container, indices)
>>> pixel_values = processor(images=list(frames), return_tensors="pt").pixel_values
>>> generated_ids = model.generate(pixel_values=pixel_values, max_length=50)
>>> print("Generated caption:", processor.batch_decode(generated_ids, skip_special_tokens=True))
Generated caption: ['a woman is sitting at a table and she is talking about the food she is holding.']
```