# ImageGPT
## نظرة عامة
قُدِّم نموذج ImageGPT في [Generative Pretraining from Pixels](https://openai.com/blog/image-gpt) بواسطة Mark Chen وAlec Radford وRewon Child وJeffrey Wu وHeewoo Jun وDavid Luan وIlya Sutskever. نموذج ImageGPT (iGPT) هو نموذج مشابه لـ GPT-2 مُدرَّب على التنبؤ بقيمة البكسل التالي، مما يتيح توليد الصور بشكل غير مشروط ومشروط على حد سواء.
المستخلص من [الورقة](https://cdn.openai.com/papers/Generative_Pretraining_from_Pixels_V1_ICML.pdf) هو التالي:
*بإلهام من التقدم المحرز في تعلم التمثيلات غير المُشرَف عليها للغة الطبيعية، نفحص ما إذا كانت نماذج مماثلة قادرة على تعلم تمثيلات مفيدة للصور. نقوم بتدريب مُحوِّل تسلسلي (Sequence Transformer) للتنبؤ بالبكسلات بشكل ذاتي التراجع (auto-regressively)، دون دمج معرفة ببنية الإدخال ثنائية الأبعاد. على الرغم من التدريب على ImageNet بدقة منخفضة وبدون تسميات، نجد أن نموذجًا بمقياس GPT-2 يتعلم تمثيلات قوية للصور كما يُقاس عبر الاستكشاف الخطي (linear probing) والإعداد الدقيق (fine-tuning) والتصنيف ببيانات قليلة. على CIFAR-10، نحقق دقة 96.3% باستخدام الاستكشاف الخطي، متفوقين على Wide ResNet المُشرَف عليه، ودقة 99.0% مع الإعداد الدقيق الكامل، مما يطابق أفضل النماذج المُشرَف عليها المُسبقة التدريب. كما نتنافس مع معايير التعلم الذاتي على ImageNet عند استبدال البكسلات بتشفير VQVAE، حيث نحقق دقة 69.0% لأفضل تنبؤ واحد (top-1) في الاستكشاف الخطي لميزاتنا.*
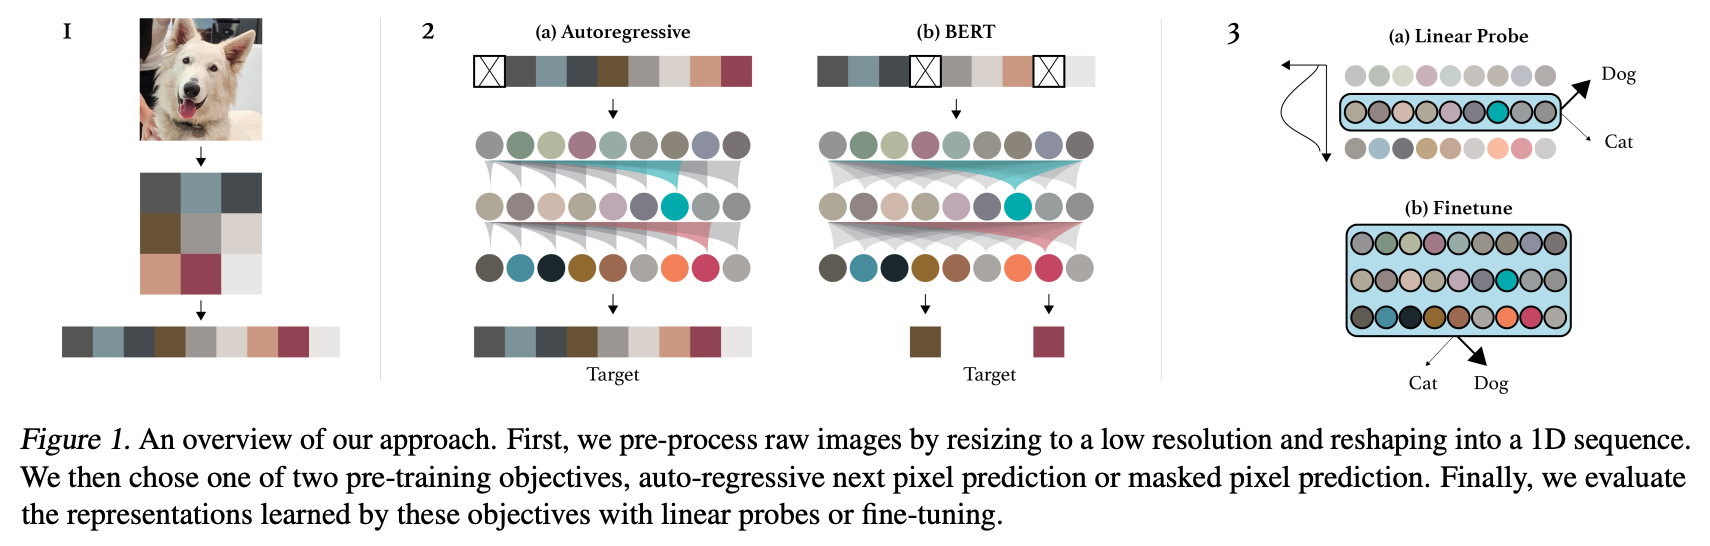 ملخص النهج. مأخوذ من [الورقة الأصلية](https://cdn.openai.com/papers/Generative_Pretraining_from_Pixels_V2.pdf).
تمت مساهمة هذا النموذج من قِبل [nielsr](https://huggingface.co/nielsr)، بناءً على [هذه المشكلة](https://github.com/openai/image-gpt/issues/7). يمكن العثور على الكود الأصلي [هنا](https://github.com/openai/image-gpt).
## نصائح للاستخدام
- ImageGPT هي نفسها تقريبًا تمامًا [GPT-2](gpt2)، باستثناء استخدام دالة تنشيط مختلفة (وهي "quick gelu")، وعدم قيام طبقات تطبيع الطبقة بوسّط المدخلات. كما لا تحتوي ImageGPT على تضمينات مدخلات ومخرجات مرتبطة.
- نظرًا لأن متطلبات الوقت والذاكرة لآلية الانتباه في Transformers تتزايد بشكل تربيعي مع طول التسلسل، قام المؤلفون بتدريب ImageGPT مسبقًا على دقات إدخال أصغر، مثل 32x32 و64x64. ومع ذلك، فإن إدخال تسلسل مكون من 32x32x3=3072 رمزًا من 0..255 إلى Transformer لا يزال كبيرًا بشكل غير مقبول. لذلك، طبّق المؤلفون تجميع k-means على قيم البكسل (R,G,B) مع k=512. بهذه الطريقة، لدينا تسلسل طوله 32*32 = 1024 فقط، لكنه الآن يتكون من أرقام صحيحة في المدى 0..511. لذا فإننا نضغط طول التسلسل على حساب مصفوفة تضمين أكبر. بعبارة أخرى، حجم مفردات ImageGPT هو 512، بالإضافة إلى 1 لرمز خاص "بداية الجملة" (SOS)، يُستخدم في بداية كل تسلسل. يمكن استخدام [ImageGPTImageProcessor](/docs/transformers/main/ar/model_doc/imagegpt#transformers.ImageGPTImageProcessor) لتحضير الصور للنموذج.
- على الرغم من أن نموذج ImageGPT تم تدريبه مسبقًا بشكل غير مُشرَف عليه بالكامل (أي دون استخدام أي تسميات)، إلا أنه ينتج ميزات صور ذات أداء جيد إلى حد ما، وهي مفيدة للمهام اللاحقة مثل تصنيف الصور. أظهر المؤلفون أن الميزات الموجودة في منتصف الشبكة هي الأكثر أداءً، ويمكن استخدامها كما هي لتدريب نموذج خطي (مثل نموذج الانحدار اللوجستي في sklearn على سبيل المثال). يُشار إلى هذا أيضًا باسم "الاستكشاف الخطي" (linear probing). يمكن الحصول على الميزات بسهولة عن طريق تمرير الصورة عبر النموذج أولًا، ثم تحديد `output_hidden_states=True`، ثم أخذ متوسط تجمع (average-pool) لحالات الإخفاء (hidden states) في أي طبقة تختارها.
- بديلًا عن ذلك، يمكن إجراء ضبط دقيق إضافي على النموذج بالكامل على مجموعة بيانات فرعية، على غرار ما يتم مع BERT. ولتحقيق ذلك، يمكنك استخدام [ImageGPTForImageClassification](/docs/transformers/main/ar/model_doc/imagegpt#transformers.ImageGPTForImageClassification).
- يتوفر ImageGPT بأحجام مختلفة: فهناك ImageGPT-small وImageGPT-medium وImageGPT-large. كما قام المؤلفون بتدريب نسخة XL، لكنهم لم ينشروها. وتُلخَّص الفروق في الحجم في الجدول التالي:
| **نموذج متغير** | **العمق** | **حجم المخفي** | **حجم مخفي المُفكِّك** | **المعاملات (مليون)** | **أفضل نتيجة 1 في ImageNet-1k** |
|---|---|---|---|---|---|
| MiT-b0 | [2, 2, 2, 2] | [32, 64, 160, 256] | 256 | 3.7 | 70.5 |
| MiT-b1 | [2, 2, 2, 2] | [64, 128, 320, 512] | 256 | 14.0 | 78.7 |
| MiT-b2 | [3, 4, 6, 3] | [64, 128, 320, 512] | 768 | 25.4 | 81.6 |
| MiT-b3 | [3, 4, 18, 3] | [64, 128, 320, 512] | 768 | 45.2 | 83.1 |
| MiT-b4 | [3, 8, 27, 3] | [64, 128, 320, 512] | 768 | 62.6 | 83.6 |
| MiT-b5 | [3, 6, 40, 3] | [64, 128, 320, 512] | 768 | 82.0 | 83.8 |
## الموارد
قائمة بموارد رسمية من Hugging Face وموارد مجتمعية (مشار إليها بـ 🌎) لمساعدتك على البدء باستخدام ImageGPT.
- يمكن العثور على كراسات العرض الخاصة بـ ImageGPT [هنا](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/ImageGPT).
- يُؤمَّن دعم [ImageGPTForImageClassification](/docs/transformers/main/ar/model_doc/imagegpt#transformers.ImageGPTForImageClassification) من خلال هذا [دفتر ملاحظات](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb).
- انظر أيضاً: [دليل مهمة تصنيف الصور](../tasks/image_classification)
إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب وسنقوم بمراجعته! يُفضَّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
## ImageGPTConfig[[transformers.ImageGPTConfig]]
#### transformers.ImageGPTConfig[[transformers.ImageGPTConfig]]
```python
transformers.ImageGPTConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 513, n_positions: int = 1024, n_embd: int = 512, n_layer: int = 24, n_head: int = 8, n_inner: int | None = None, activation_function: str = 'quick_gelu', resid_pdrop: float | int = 0.1, embd_pdrop: float | int = 0.1, attn_pdrop: float | int = 0.1, layer_norm_epsilon: float = 1e-05, initializer_range: float = 0.02, scale_attn_weights: bool = True, use_cache: bool = True, tie_word_embeddings: bool = False, scale_attn_by_inverse_layer_idx: bool = False, reorder_and_upcast_attn: bool = False, add_cross_attention: bool = False, pad_token_id: int | None = None, bos_token_id: int | None = None, eos_token_id: int | list[int] | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/configuration_imagegpt.py#L24)
**المعاملات:**
vocab_size (`int`، *اختياري*، القيمة الافتراضية `513`) : حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطة `input_ids`.
n_positions (`int`، *اختياري*، الافتراضي هو `1024`) : أقصى طول تسلسل قد يُستخدم به هذا النموذج.
n_embd (`int`، *اختياري*، القيمة الافتراضية `512`) : بُعد التضمينات والحالات المخفية.
n_layer (`int`، *اختياري*، القيمة الافتراضية `24`) : عدد الطبقات المخفية في مُفكِّك Transformer.
n_head (`int`، *اختياري*، القيمة الافتراضية `8`) : عدد رؤوس الانتباه في كل طبقة انتباه داخل مُفكِّك Transformer.
n_inner (`int`، *اختياري*) : بُعد تمثيلات MLP.
activation_function (`str`، *اختياري*، القيمة الافتراضية `quick_gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
resid_pdrop (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.1`) : احتمال الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات (embeddings) والمُشفِّر (encoder) والمُجمِّع (pooler).
embd_pdrop (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.1`) : نسبة الإسقاط (dropout) للتضمينات.
attn_pdrop (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.1`) : نسبة الإسقاط (dropout) لاحتمالات الانتباه.
layer_norm_epsilon (`float`، *اختياري*، القيمة الافتراضية `1e-05`) : قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
initializer_range (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
scale_attn_weights (`bool`، *اختياري*، القيمة الافتراضية `True`) : هل يتم تحجيم التضمينات بقسمة على sqrt(d_model).
use_cache (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب على النموذج إرجاع قيم المفاتيح/القيم الأخيرة للانتباه (لا تستخدمها جميع النماذج). لا ينطبق إلا إذا كان `config.is_decoder=True` أو عندما يكون النموذج نموذجًا توليديًا يعتمد على المُفكِّك فقط.
tie_word_embeddings (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان يجب ربط ترميزات الأوزان وفقاً لخريطة `tied_weights_keys` الخاصة بالنموذج.
scale_attn_by_inverse_layer_idx (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم توسيع أوزان الانتباه بشكل إضافي بمعامل `1 / layer_idx + 1`.
reorder_and_upcast_attn (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم توسيع المفاتيح (K) قبل حساب الانتباه (الجداء النقطي) وترقية جداء الانتباه النقطي/الناعمة (softmax) إلى float() عند التدريب بدقة مختلطة.
add_cross_attention (`bool`, *اختياري*, الافتراضي هو `False`) : ما إذا كان يجب إضافة طبقات الانتباه المتقاطع إلى النموذج.
pad_token_id (`int`, *اختياري*) : معرّف الرمز (Token id) المستخدم للتعبئة (padding) في المفردات.
bos_token_id (`int`, *اختياري*) : معرّف الرمز المستخدم لبدء البث في المفردات.
eos_token_id (`Union[int, list[int]]`، *اختياري*) : معرّف الرمز المستخدم لنهاية البث في المفردات.
هذه فئة الإعدادات المخزنة لإعدادات نموذج ImageGPTModel. تُستخدم لاستحداث نموذج Imagegpt وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [openai/imagegpt-small](https://huggingface.co/openai/imagegpt-small)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
مثال:
```python
>>> from transformers import ImageGPTConfig, ImageGPTModel
>>> # Initializing a ImageGPT configuration
>>> configuration = ImageGPTConfig()
>>> # Initializing a model (with random weights) from the configuration
>>> model = ImageGPTModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ImageGPTImageProcessor[[transformers.ImageGPTImageProcessor]]
#### transformers.ImageGPTImageProcessor[[transformers.ImageGPTImageProcessor]]
```python
transformers.ImageGPTImageProcessor(clusters: typing.Union[list, numpy.ndarray, torch.Tensor, NoneType] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/image_processing_imagegpt.py#L82)
**المعاملات:**
clusters (`np.ndarray` أو `list[list[int]]` أو `torch.Tensor`، *اختياري*) : عناقيد الألوان المستخدمة، من الشكل `(n_clusters, 3)` عند تكميم الألوان. يمكن تجاوزها بواسطة `clusters` في `preprocess`.
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*، الافتراضي هو `True`) : ما إذا كان سيتم تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*، القيمة الافتراضية `{'height' : 256, 'width': 256}`): يصف الأبعاد القصوى للإدخال إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم من نوع عدد صحيح.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`، *kwargs*، القيمة الافتراضية `2`) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعداد `PILImageResampling`. لا يؤثر إلا إذا كانت قيمة `do_resize` هي `True`.
do_rescale (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*، القيمة الافتراضية هي `0.00392156862745098`) : عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطاً على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية هي `[0.5, 0.5, 0.5]`) : متوسط الصورة المستخدم للتطبيع. لا يكون له تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية هي `[0.5, 0.5, 0.5]`) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
clusters (`np.ndarray` أو *kwargs* أو `list[list[int]]` أو `torch.Tensor`، *اختياري*، القيمة الافتراضية هي `self.clusters`) : عناقيد الألوان المستخدمة، من الشكل `(n_clusters, 3)` عند تكميم الألوان. يمكن تجاوزها بواسطة `clusters` في `preprocess`.
do_color_quantize (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية هي `self.do_color_quantize`) : يتحكم في تطبيق تكميم الألوان لتحويل قيم البكسلات المستمرة إلى فهارس عناقيد منفصلة. عند تعيينه إلى True، يُسند كل بكسل إلى أقرب عناقدة ألوان، مما يتيح لنموذج ImageGPT نمذجة الرموز المنفصلة.
ينشئ معالج صور من نوع ImageGPTImageProcessor.
#### preprocess[[transformers.ImageGPTImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : الصورة المراد معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`، *اختياري*) : علم مخصص للمطورين لإدخال مدخلات إضافية تشبه الصور والتي سيتم معالجتها مسبقًا أيضًا. استخدم هذا الخيار فقط إذا لم يعمل تمرير المدخلات كحجة اسمية (kwarg). على سبيل المثال، يُعد `preprocess(images, masks=masks)` الخيار المفضل، لكنه يؤدي إلى مشاكل في أولوية الحجة لبعض النماذج. في تلك الحالات، يمكن استخدام `preprocess(images, image_like_inputs={"masks": masks})` بدلاً منه.
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم عددًا صحيحًا.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كان `do_resize` مضبوطاً على `True`.
do_rescale (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*) : معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطًا على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
معالجة صورة أو دفعة من الصور مسبقًا.
## ImageGPTImageProcessorPil[[transformers.ImageGPTImageProcessorPil]]
#### transformers.ImageGPTImageProcessorPil[[transformers.ImageGPTImageProcessorPil]]
```python
transformers.ImageGPTImageProcessorPil(clusters: list | np.ndarray | torch.Tensor | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/image_processing_pil_imagegpt.py#L69)
**المعاملات:**
clusters (`np.ndarray` أو `list[list[int]]` أو `torch.Tensor`، *اختياري*) : عناقيد الألوان المستخدمة، من الشكل `(n_clusters, 3)` عند تكميم الألوان. يمكن تجاوزها بواسطة `clusters` في `preprocess`.
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*، الافتراضي هو `True`) : ما إذا كان سيتم تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*، القيمة الافتراضية `{'height' : 256, 'width': 256}`): يصف الأبعاد القصوى للإدخال إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم من نوع عدد صحيح.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`، *kwargs*، القيمة الافتراضية `2`) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعداد `PILImageResampling`. لا يؤثر إلا إذا كانت قيمة `do_resize` هي `True`.
do_rescale (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*، القيمة الافتراضية هي `0.00392156862745098`) : عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطاً على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية هي `[0.5, 0.5, 0.5]`) : متوسط الصورة المستخدم للتطبيع. لا يكون له تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية هي `[0.5, 0.5, 0.5]`) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
clusters (`np.ndarray` أو *kwargs* أو `list[list[int]]` أو `torch.Tensor`، *اختياري*، القيمة الافتراضية هي `self.clusters`) : عناقيد الألوان المستخدمة، من الشكل `(n_clusters, 3)` عند تكميم الألوان. يمكن تجاوزها بواسطة `clusters` في `preprocess`.
do_color_quantize (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية هي `self.do_color_quantize`) : يتحكم في تطبيق تكميم الألوان لتحويل قيم البكسلات المستمرة إلى فهارس عناقيد منفصلة. عند تعيينه إلى True، يُسند كل بكسل إلى أقرب عناقدة ألوان، مما يتيح لنموذج ImageGPT نمذجة الرموز المنفصلة.
ينشئ معالج صور من نوع ImageGPTImageProcessor.
#### preprocess[[transformers.ImageGPTImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : الصورة المراد معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`، *اختياري*) : علم مخصص للمطورين لإدخال مدخلات إضافية تشبه الصور والتي سيتم معالجتها مسبقًا أيضًا. استخدم هذا الخيار فقط إذا لم يعمل تمرير المدخلات كحجة اسمية (kwarg). على سبيل المثال، يُعد `preprocess(images, masks=masks)` الخيار المفضل، لكنه يؤدي إلى مشاكل في أولوية الحجة لبعض النماذج. في تلك الحالات، يمكن استخدام `preprocess(images, image_like_inputs={"masks": masks})` بدلاً منه.
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم عددًا صحيحًا.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كان `do_resize` مضبوطاً على `True`.
do_rescale (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*) : معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطًا على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
معالجة صورة أو دفعة من الصور مسبقًا.
## ImageGPTModel[[transformers.ImageGPTModel]]
#### transformers.ImageGPTModel[[transformers.ImageGPTModel]]
```python
transformers.ImageGPTModel(config: ImageGPTConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L393)
**المعاملات:**
config ([ImageGPTConfig](/docs/transformers/main/ar/model_doc/imagegpt#transformers.ImageGPTConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج Imagegpt الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.ImageGPTModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs: Any)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L416)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size, input_ids_length)`) : `input_ids_length` = `sequence_length` إذا كان `past_key_values` هو `None` وإلا `past_key_values.get_seq_length()` (`sequence_length` لحالات المفاتيح والقيم السابقة للإدخال). فهارس رموز تسلسل الإدخال في قاموس الكلمات. إذا تم استخدام `past_key_values`، فيجب تمرير `input_ids` التي لم يتم حساب ماضيها فقط كـ `input_ids`. يمكن الحصول على الفهارس باستخدام [AutoImageProcessor](/docs/transformers/main/ar/model_doc/auto#transformers.AutoImageProcessor). راجع [ImageGPTImageProcessor.__call__()](/docs/transformers/main/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل.
past_key_values (`~cache_utils.Cache`، *اختياري*) : حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكوّن هذا عادةً من `past_key_values` التي يعيدها النموذج في مرحلة سابقة من فك الترميز، عندما يكون `use_cache=True` أو `config.use_cache=True`. يُسمح فقط بتمرير كائن [Cache](/docs/transformers/main/ar/internal/generation_utils#transformers.Cache) كمدخل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache). إذا لم يتم تمرير `past_key_values`، فسيتم تهيئة [DynamicCache](/docs/transformers/main/ar/internal/generation_utils#transformers.DynamicCache) افتراضيًا. سيُخرج النموذج نفس تنسيق الذاكرة المؤقتة المُدخل. إذا تم استخدام `past_key_values`، يُتوقع من المستخدم إدخال `input_ids` غير المعالجة فقط (تلك التي لم تُعطَ حالات مفاتيح وقيم سابقة لها في هذا النموذج) بأبعاد `(batch_size, unprocessed_length)` بدلاً من جميع `input_ids` بأبعاد `(batch_size, sequence_length)`.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
token_type_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار الفهارس من `[0, 1]`: - 0 يقابل رمز *الجملة أ*، - 1 يقابل رمز *الجملة ب*. [ما هي معرّفات أنواع الرموز؟](../glossary#token-type-ids)
position_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
encoder_hidden_states (`torch.Tensor` بأبعاد `(batch_size, sequence_length, hidden_size)`، *اختياري*) : تسلسل من الحالات المخفية عند مخرجات الطبقة الأخيرة من المُشفِّر. يُستخدم في الانتباه المتقاطع إذا كان النموذج مُهيأً كمُفكِّك.
encoder_attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنُّب تنفيذ الانتباه على فهارس رموز الحشو في مدخلات المُشفِّر. يُستخدم هذا القناع في الانتباه المتقاطع إذا كان النموذج مُهيَّأً كمُفكِّك. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنَّعة**، - 0 للرموز التي **مقنَّعة**.
use_cache (`bool`، *اختياري*) : إذا تم ضبطه على `True`، تُعاد حالات المفاتيح والقيم `past_key_values` ويمكن استخدامها لتسريع فك الترميز (انظر `past_key_values`).
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/main/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
**يعيد:** [BaseModelOutputWithPastAndCrossAttentions](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPastAndCrossAttentions) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPastAndCrossAttentions](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPastAndCrossAttentions) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([ImageGPTConfig](/docs/transformers/main/ar/model_doc/imagegpt#transformers.ImageGPTConfig)) والمدخلات.
تتجاوز طريقة [ImageGPTModel](/docs/transformers/main/ar/model_doc/imagegpt#transformers.ImageGPTModel) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
إذا تم استخدام `past_key_values`، فإن الحالة المخفية الأخيرة فقط من التسلسلات ذات الشكل `(batch_size, 1, hidden_size)` هي التي تُخرج.
- **past_key_values** (`Cache`، *اختياري*، يُعاد عند تمرير `use_cache=True` أو عند تعيين `config.use_cache=True`) -- هو كائن من نوع [Cache](/docs/transformers/main/ar/internal/generation_utils#transformers.Cache). لمزيد من التفاصيل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache).
تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي، وفي كتل الانتباه المتقاطع اختياريًا إذا كان `config.is_encoder_decoder=True`) يمكن استخدامها (انظر مدخل `past_key_values`) لتسريع فك الترميز التسلسلي.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple(torch.Tensor)`, *اختياري*, يُعاد عند تمرير `output_attentions=True` مع `config.add_cross_attention=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بشكل `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في طبقة الانتباه المتقاطع للمفكّك، بعد softmax للانتباه، وتُستخدم لحساب المتوسط المرجّح في رؤوس الانتباه المتقاطع.
أمثلة:
```python
>>> from transformers import AutoImageProcessor, ImageGPTModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTModel.from_pretrained("openai/imagegpt-small")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
```
## ImageGPTForCausalImageModeling[[transformers.ImageGPTForCausalImageModeling]]
#### transformers.ImageGPTForCausalImageModeling[[transformers.ImageGPTForCausalImageModeling]]
```python
transformers.ImageGPTForCausalImageModeling(config: ImageGPTConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L594)
**المعاملات:**
config ([ImageGPTConfig](/docs/transformers/main/ar/model_doc/imagegpt#transformers.ImageGPTConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج ImageGPT من نوع transformer مع رأس لنمذجة اللغة في الأعلى (طبقة خطية بأوزان مرتبطة بتضمينات الإدخال).
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.ImageGPTForCausalImageModeling.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs: Any)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L605)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size, input_ids_length)`) : `input_ids_length` = `sequence_length` إذا كان `past_key_values` هو `None` وإلا `past_key_values.get_seq_length()` (`sequence_length` لحالات المفاتيح والقيم السابقة للإدخال). فهارس رموز تسلسل الإدخال في قاموس الكلمات. إذا تم استخدام `past_key_values`، فيجب تمرير `input_ids` التي لم يتم حساب ماضيها فقط كـ `input_ids`. يمكن الحصول على الفهارس باستخدام [AutoImageProcessor](/docs/transformers/main/ar/model_doc/auto#transformers.AutoImageProcessor). راجع [ImageGPTImageProcessor.__call__()](/docs/transformers/main/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل.
past_key_values (`~cache_utils.Cache`، *اختياري*) : حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكوّن هذا عادةً من `past_key_values` التي يعيدها النموذج في مرحلة سابقة من فك الترميز، عندما يكون `use_cache=True` أو `config.use_cache=True`. يُسمح فقط بتمرير كائن [Cache](/docs/transformers/main/ar/internal/generation_utils#transformers.Cache) كمدخل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache). إذا لم يتم تمرير `past_key_values`، فسيتم تهيئة [DynamicCache](/docs/transformers/main/ar/internal/generation_utils#transformers.DynamicCache) افتراضيًا. سيُخرج النموذج نفس تنسيق الذاكرة المؤقتة المُدخل. إذا تم استخدام `past_key_values`، يُتوقع من المستخدم إدخال `input_ids` غير المعالجة فقط (تلك التي لم تُعطَ حالات مفاتيح وقيم سابقة لها في هذا النموذج) بأبعاد `(batch_size, unprocessed_length)` بدلاً من جميع `input_ids` بأبعاد `(batch_size, sequence_length)`.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
token_type_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار الفهارس من `[0, 1]`: - 0 يقابل رمز *الجملة أ*، - 1 يقابل رمز *الجملة ب*. [ما هي معرّفات أنواع الرموز؟](../glossary#token-type-ids)
position_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
encoder_hidden_states (`torch.Tensor` بأبعاد `(batch_size, sequence_length, hidden_size)`، *اختياري*) : تسلسل من الحالات المخفية عند مخرجات الطبقة الأخيرة من المُشفِّر. يُستخدم في الانتباه المتقاطع إذا كان النموذج مُهيأً كمُفكِّك.
encoder_attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنُّب تنفيذ الانتباه على فهارس رموز الحشو في مدخلات المُشفِّر. يُستخدم هذا القناع في الانتباه المتقاطع إذا كان النموذج مُهيَّأً كمُفكِّك. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنَّعة**، - 0 للرموز التي **مقنَّعة**.
labels (`torch.LongTensor` من الشكل `(batch_size, input_ids_length)`، *اختياري*) : تسميات لنمذجة اللغة. لاحظ أن التسميات **مُزاحة** داخل النموذج، أي يمكنك تعيين `labels = input_ids` يتم اختيار الفهارس من `[-100, 0, ..., config.vocab_size]` تُتجاهل (تُقنَّع) جميع التسميات المُعيَّنة إلى `-100`، ولا يُحسب الخسارة إلا للتسميات ضمن `[0, ..., config.vocab_size]`
use_cache (`bool`، *اختياري*) : إذا تم ضبطه على `True`، تُعاد حالات المفاتيح والقيم `past_key_values` ويمكن استخدامها لتسريع فك الترميز (انظر `past_key_values`).
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/main/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
**يعيد:** [CausalLMOutputWithCrossAttentions](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) أو `tuple(torch.Tensor)`
[CausalLMOutputWithCrossAttentions](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([ImageGPTConfig](/docs/transformers/main/ar/model_doc/imagegpt#transformers.ImageGPTConfig)) والمدخلات.
تُعيد طريقة [ImageGPTForCausalImageModeling](/docs/transformers/main/ar/model_doc/imagegpt#transformers.ImageGPTForCausalImageModeling) الخاصة بالتقديم (forward) تعريف الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`، *اختياري*، يُعاد عند توفير `labels`) -- خسارة نمذجة اللغة (لتوقع الرمز التالي).
- **logits** (`torch.Tensor` من الشكل `(batch_size, sequence_length, config.vocab_size)`) -- درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) من الشكل `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه المتقاطع بعد softmax للانتباه، وتُستخدم لحساب المتوسط المرجح في رؤوس الانتباه المتقاطع.
- **past_key_values** (`Cache`، *اختياري*، يُعاد عند تمرير `use_cache=True` أو عند تعيين `config.use_cache=True`) -- هو كائن من نوع [Cache](/docs/transformers/main/ar/internal/generation_utils#transformers.Cache). لمزيد من التفاصيل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache).
تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه) يمكن استخدامها (انظر مدخل `past_key_values`) لتسريع فك الترميز التسلسلي.
أمثلة:
```python
>>> from transformers import AutoImageProcessor, ImageGPTForCausalImageModeling
>>> import torch
>>> import matplotlib.pyplot as plt
>>> import numpy as np
>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTForCausalImageModeling.from_pretrained("openai/imagegpt-small")
>>> device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
>>> model.to(device)
>>> # unconditional generation of 8 images
>>> batch_size = 4
>>> context = torch.full((batch_size, 1), model.config.vocab_size - 1) # initialize with SOS token
>>> context = context.to(device)
>>> output = model.generate(
... input_ids=context, max_length=model.config.n_positions + 1, temperature=1.0, do_sample=True, top_k=40
... )
>>> clusters = image_processor.clusters
>>> height = image_processor.size["height"]
>>> width = image_processor.size["width"]
>>> samples = output[:, 1:].detach().cpu().numpy()
>>> samples_img = [
... np.reshape(np.rint(127.5 * (clusters[s] + 1.0)), [height, width, 3]).astype(np.uint8) for s in samples
... ] # convert color cluster tokens back to pixels
>>> f, axes = plt.subplots(1, batch_size, dpi=300)
>>> for img, ax in zip(samples_img, axes):
... ax.axis("off")
... ax.imshow(img)
```
## ImageGPTForImageClassification[[transformers.ImageGPTForImageClassification]]
#### transformers.ImageGPTForImageClassification[[transformers.ImageGPTForImageClassification]]
```python
transformers.ImageGPTForImageClassification(config: ImageGPTConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L723)
**المعاملات:**
config ([ImageGPTConfig](/docs/transformers/main/ar/model_doc/imagegpt#transformers.ImageGPTConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج ImageGPT المحوّل مع رأس تصنيف الصور في الأعلى (طبقة خطية). يقوم [ImageGPTForImageClassification](/docs/transformers/main/ar/model_doc/imagegpt#transformers.ImageGPTForImageClassification) بجمع متوسط الحالات المخفية من أجل إجراء التصنيف.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.ImageGPTForImageClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs: Any)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L733)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size, input_ids_length)`) : `input_ids_length` = `sequence_length` إذا كان `past_key_values` هو `None` وإلا `past_key_values.get_seq_length()` (`sequence_length` لحالات المفاتيح والقيم السابقة للإدخال). فهارس رموز تسلسل الإدخال في قاموس الكلمات. إذا تم استخدام `past_key_values`، فيجب تمرير `input_ids` التي لم يتم حساب ماضيها فقط كـ `input_ids`. يمكن الحصول على الفهارس باستخدام [AutoImageProcessor](/docs/transformers/main/ar/model_doc/auto#transformers.AutoImageProcessor). راجع [ImageGPTImageProcessor.__call__()](/docs/transformers/main/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل.
past_key_values (`~cache_utils.Cache`، *اختياري*) : حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكوّن هذا عادةً من `past_key_values` التي يعيدها النموذج في مرحلة سابقة من فك الترميز، عندما يكون `use_cache=True` أو `config.use_cache=True`. يُسمح فقط بتمرير كائن [Cache](/docs/transformers/main/ar/internal/generation_utils#transformers.Cache) كمدخل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache). إذا لم يتم تمرير `past_key_values`، فسيتم تهيئة [DynamicCache](/docs/transformers/main/ar/internal/generation_utils#transformers.DynamicCache) افتراضيًا. سيُخرج النموذج نفس تنسيق الذاكرة المؤقتة المُدخل. إذا تم استخدام `past_key_values`، يُتوقع من المستخدم إدخال `input_ids` غير المعالجة فقط (تلك التي لم تُعطَ حالات مفاتيح وقيم سابقة لها في هذا النموذج) بأبعاد `(batch_size, unprocessed_length)` بدلاً من جميع `input_ids` بأبعاد `(batch_size, sequence_length)`.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
token_type_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار الفهارس من `[0, 1]`: - 0 يقابل رمز *الجملة أ*، - 1 يقابل رمز *الجملة ب*. [ما هي معرّفات أنواع الرموز؟](../glossary#token-type-ids)
position_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
labels (`torch.LongTensor` من الشكل `(batch_size,)`، *اختياري*) : تسميات لحساب خسارة تصنيف/انحدار التسلسل. يجب أن تكون الفهارس ضمن `[0, ..., config.num_labels - 1]`. إذا كان `config.num_labels == 1` يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كان `config.num_labels > 1` يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة).
use_cache (`bool`، *اختياري*) : إذا تم ضبطه على `True`، تُعاد حالات المفاتيح والقيم `past_key_values` ويمكن استخدامها لتسريع فك الترميز (انظر `past_key_values`).
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/main/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
**يعيد:** `SequenceClassifierOutputWithPast` أو `tuple(torch.Tensor)`
`SequenceClassifierOutputWithPast` أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([ImageGPTConfig](/docs/transformers/main/ar/model_doc/imagegpt#transformers.ImageGPTConfig)) والمدخلات.
تتجاوز طريقة [ImageGPTForImageClassification](/docs/transformers/main/ar/model_doc/imagegpt#transformers.ImageGPTForImageClassification) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`, *اختياري*، يُعاد عند تقديم `labels`) -- خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).
- **logits** (`torch.Tensor` من الشكل `(batch_size, config.num_labels)`) -- درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).
- **past_key_values** (`Cache`، *اختياري*، يُعاد عند تمرير `use_cache=True` أو عند تعيين `config.use_cache=True`) -- هو كائن من نوع [Cache](/docs/transformers/main/ar/internal/generation_utils#transformers.Cache). لمزيد من التفاصيل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache).
تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي) يمكن استخدامها (انظر مدخل `past_key_values`) لتسريع فك الترميز التسلسلي.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from transformers import AutoImageProcessor, ImageGPTForImageClassification
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTForImageClassification.from_pretrained("openai/imagegpt-small")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> logits = outputs.logits
```