# MarkupLM
## نظرة عامة
قُدِّم نموذج MarkupLM في [MarkupLM: Pre-training of Text and Markup Language for Visually-rich Document Understanding](https://huggingface.co/papers/2110.08518) من قِبل Junlong Li وYiheng Xu وLei Cui وFuru Wei. يُعد MarkupLM نسخة من BERT، لكنه يُطبَّق على صفحات HTML بدلاً من المستندات النصية الخام. يدمج النموذج طبقات تضمين إضافية لتحسين الأداء، على غرار [LayoutLM](layoutlm).
يمكن استخدام النموذج لمهام مثل الإجابة عن الأسئلة على صفحات الويب أو استخراج المعلومات من صفحات الويب. إنه يحقق نتائج متقدمة على معياري تقييم مهمين:
- [WebSRC](https://x-lance.github.io/WebSRC/)، وهو مجموعة بيانات لفهم القراءة البنيوية المعتمدة على الويب (تشبه إلى حد ما SQuAD لكنها مخصصة لصفحات الويب)
- [SWDE](https://www.researchgate.net/publication/221299838_From_one_tree_to_a_forest_a_unified_solution_for_structured_web_data_extraction)، مجموعة بيانات
لاستخراج المعلومات من صفحات الويب (وهو في الأساس التعرف على الكيانات المسمّاة في صفحات الويب)
المستخلص من الورقة البحثية هو كالتالي:
*حقّق التدريب المسبق متعدد الوسائط باستخدام النص والتخطيط والصورة تقدماً كبيراً في فهم المستندات الغنية بصرياً (VrDU)، ولا سيما المستندات ذات التخطيط الثابت مثل صور المستندات الممسوحة ضوئياً. ومع ذلك، لا تزال هناك أعداد كبيرة من المستندات الرقمية التي لا يكون فيها معلومات التخطيط ثابتة، بل تتطلب عرضاً تفاعلياً وديناميكياً للعرض، مما يجعل من الصعب تطبيق أساليب التدريب المسبق القائمة على التخطيط الحالية. في هذه الورقة، نقترح MarkupLM لمهام فهم المستندات التي تستخدم لغات الترميز كهيكل أساسي، مثل المستندات القائمة على HTML/XML، حيث يتم تدريب النص ومعلومات الترميز معاً بشكل مسبق. تُظهر نتائج التجارب أن النموذج المسبق التدريب MarkupLM يتفوق بشكل كبير على نماذج الأساس القوية الحالية في عدة مهام لفهم المستندات. سيكون النموذج المسبق التدريب والكود متاحين للعموم.*
تمت مساهمة هذا النموذج من قِبل [nielsr](https://huggingface.co/nielsr). يمكن العثور على الكود الأصلي [هنا](https://github.com/microsoft/unilm/tree/master/markuplm).
## نصائح للاستخدام
- بالإضافة إلى `input_ids`، يتوقع [forward()](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMModel.forward) مدخلين إضافيين، وهما `xpath_tags_seq` و`xpath_subs_seq`.
هذه هي وسوم XPATH والفهارس الفرعية لكل رمز في تسلسل الإدخال على التوالي.
- يمكن استخدام [MarkupLMProcessor](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMProcessor) لتحضير جميع البيانات للنموذج. راجع [دليل الاستخدام](#usage-markuplmprocessor) لمزيد من المعلومات.
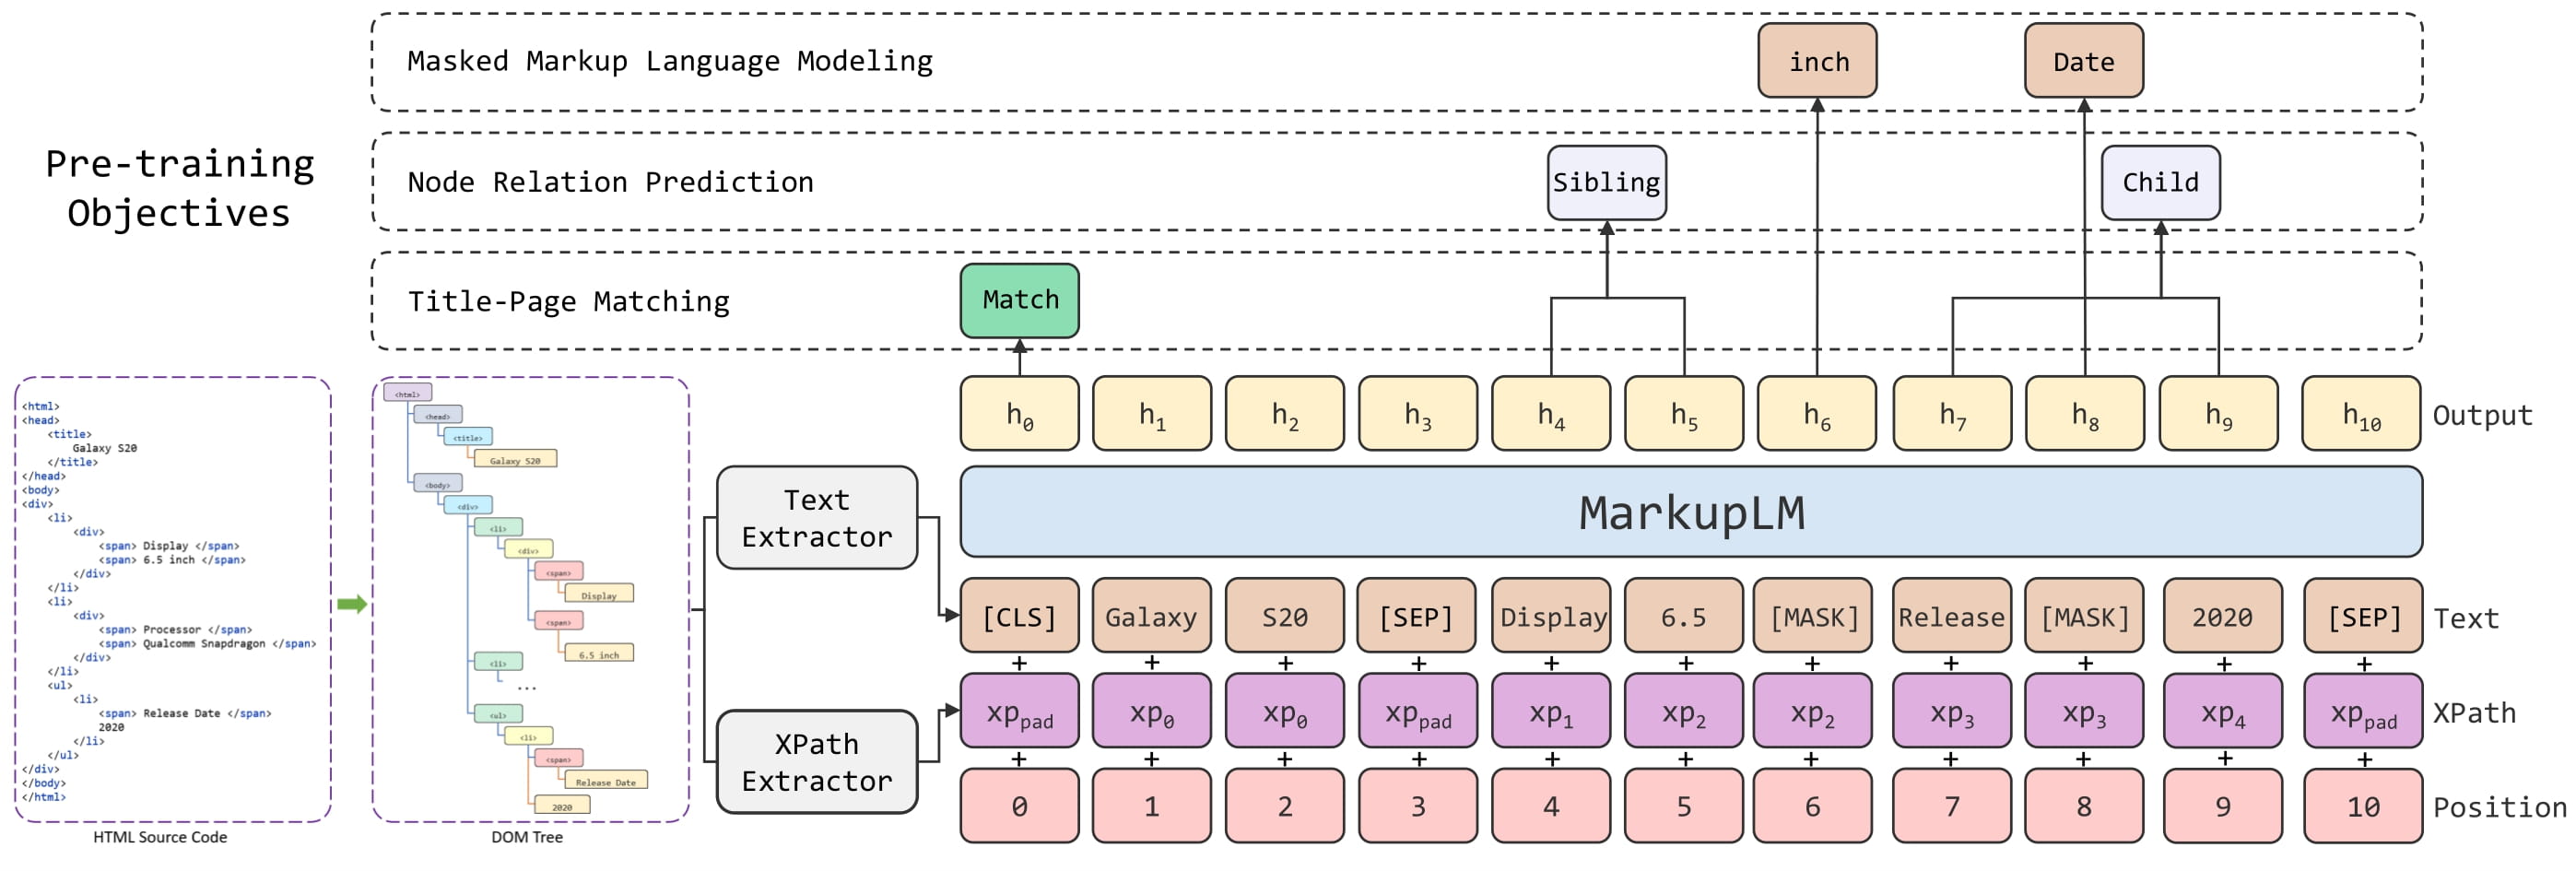 بنية MarkupLM. مأخوذة من الورقة الأصلية.
## الاستخدام: MarkupLMProcessor
أسهل طريقة لتحضير البيانات للنموذج هي استخدام [MarkupLMProcessor](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMProcessor)، والذي يجمع داخليًا بين مستخرج الميزات ([MarkupLMFeatureExtractor](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMFeatureExtractor)) ومجزّئ الرموز ([MarkupLMTokenizer](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMTokenizer) أو [MarkupLMTokenizerFast](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMTokenizer)). يُستخدم مستخرج الميزات لاستخراج جميع العقد ومسارات xpaths من نصوص HTML، ثم تُقدَّم هذه النتائج إلى مجزّئ الرموز الذي يحوّلها إلى مدخلات على مستوى الرموز للنموذج (`input_ids` وما شابه). لاحظ أنه يمكنك ما زال استخدام مستخرج الميزات ومجزّئ الرموز بشكل منفصل، إذا كنت ترغب في التعامل مع إحدى المهمتين فقط.
```python
from transformers import MarkupLMFeatureExtractor, MarkupLMProcessor, MarkupLMTokenizerFast
feature_extractor = MarkupLMFeatureExtractor()
tokenizer = MarkupLMTokenizerFast.from_pretrained("microsoft/markuplm-base")
processor = MarkupLMProcessor(feature_extractor, tokenizer)
```
باختصار، يمكن تقديم نصوص HTML (وإمكانية تقديم بيانات إضافية) إلى [MarkupLMProcessor](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMProcessor)، وسيقوم بإنشاء المدخلات المتوقعة من النموذج. داخلياً، يستخدم المعالج أولاً [MarkupLMFeatureExtractor](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMFeatureExtractor) للحصول على قائمة بالعُقد والمسارات xpaths المقابلة. ثم تُقدَّم العُقد والمسارات xpaths إلى [MarkupLMTokenizer](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMTokenizer) أو [MarkupLMTokenizerFast](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMTokenizer)، والتي تحولها إلى `input_ids` و`attention_mask` و`token_type_ids` و`xpath_subs_seq` و`xpath_tags_seq` على مستوى الرموز. اختيارياً، يمكن تقديم تسميات العُقد إلى المعالج، والتي تُحوَّل إلى `labels` على مستوى الرموز.
يعتمد [MarkupLMFeatureExtractor](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMFeatureExtractor) على [Beautiful Soup](https://www.crummy.com/software/BeautifulSoup/bs4/doc/)، وهي مكتبة بلغة بايثون لاستخراج البيانات من ملفات HTML وXML، في الخلفية. لاحظ أنه يمكنك ما زال استخدام حل التحليل الخاص بك، وتوفير العقد ومسارات xpaths بنفسك إلى [MarkupLMTokenizer](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMTokenizer) أو [MarkupLMTokenizerFast](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMTokenizer).
بشكل إجمالي، هناك 5 حالات استخدام يدعمها المعالج. أدناه، نذكرها جميعًا. لاحظ أن كل حالة من هذه الحالات تعمل مع المدخلات المجمعة وغير المجمعة (نوضحها هنا للمدخلات غير المجمعة).
**حالة الاستخدام 1: تصنيف صفحات الويب (التدريب، الاستدلال) + تصنيف الرموز (الاستدلال)، parse_html = True**
هذا هو أبسط حالة، حيث سيقوم المعالج باستخدام مستخرج الميزات للحصول على جميع العقد ومسارات xpaths من HTML.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
html_string = """
Hello world
Welcome
Here is my website.
"""
# note that you can also add provide all tokenizer parameters here such as padding, truncation
encoding = processor(html_string, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**حالة الاستخدام 2: تصنيف صفحات الويب (التدريب، الاستدلال) + تصنيف الرموز (الاستدلال)، parse_html=False**
في حال كان المرء قد حصل بالفعل على جميع العقد والمسارات (xpaths)، فلا حاجة إلى مستخرج الميزات. في هذه الحالة، يجب على المرء تقديم العقد والمسارات المقابلة بنفسه إلى المعالج، والتأكد من تعيين `parse_html` إلى `False`.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
encoding = processor(nodes=nodes, xpaths=xpaths, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**حالة الاستخدام 3: تصنيف الرموز (التدريب)، parse_html=False**
في مهام تصنيف الرموز (مثل [SWDE](https://paperswithcode.com/dataset/swde))، يمكن أيضًا توفير تسميات العقد المقابلة لتدريب نموذج. سيقوم المعالج بعد ذلك بتحويل هذه التسميات إلى تسميات على مستوى الرموز `labels`. افتراضيًا، سيُسمي فقط أول جزء كلمة (wordpiece) من الكلمة، ويُسمي الأجزاء المتبقية بـ -100، وهو `ignore_index` الخاص بـ CrossEntropyLoss في PyTorch. في حال رغبت في تسمية جميع أجزاء الكلمة (wordpieces) من كلمة ما، يمكنك تهيئة المُقسِّم (tokenizer) مع ضبط `only_label_first_subword` على `False`.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
node_labels = [1, 2, 2, 1]
encoding = processor(nodes=nodes, xpaths=xpaths, node_labels=node_labels, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq', 'labels'])
```
**حالة الاستخدام 4: الإجابة عن أسئلة حول صفحة ويب (استدلال)، parse_html=True**
لمهام الإجابة عن الأسئلة على صفحات الويب، يمكنك تقديم سؤال إلى المعالج. افتراضيًا، سيقوم المعالج باستخدام مستخرج الميزات للحصول على جميع العقد والمسارات (xpaths)، وإنشاء الرموز [CLS] رموز السؤال [SEP] رموز الكلمات [SEP].
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
html_string = """
Hello world
Welcome
My name is Niels.
"""
question = "What's his name?"
encoding = processor(html_string, questions=question, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**حالة الاستخدام 5: الإجابة عن أسئلة صفحة ويب (استدلال)، parse_html=False**
لمهام الإجابة عن الأسئلة (مثل WebSRC)، يمكنك تقديم سؤال إلى المعالج. إذا كنت قد استخرجت جميع العقد ومسارات xpaths بنفسك، يمكنك تقديمها مباشرة إلى المعالج. تأكد من تعيين `parse_html` إلى `False`.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
question = "What's his name?"
encoding = processor(nodes=nodes, xpaths=xpaths, questions=question, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
## الموارد
- [دفاتر العرض التوضيحي](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/MarkupLM)
- [دليل مهمة تصنيف النصوص](../tasks/sequence_classification)
- [دليل مهمة تصنيف الرموز](../tasks/token_classification)
- [دليل مهمة الإجابة عن الأسئلة](../tasks/question_answering)
## MarkupLMConfig[[transformers.MarkupLMConfig]]
#### transformers.MarkupLMConfig[[transformers.MarkupLMConfig]]
```python
transformers.MarkupLMConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 512, type_vocab_size: int = 2, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, max_xpath_tag_unit_embeddings: int = 256, max_xpath_subs_unit_embeddings: int = 1024, tag_pad_id: int = 216, subs_pad_id: int = 1001, xpath_unit_hidden_size: int = 32, max_depth: int = 50, use_cache: bool = True, classifier_dropout: float | int | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/configuration_markuplm.py#L24)
**المعاملات:**
vocab_size (`int`، *اختياري*، القيمة الافتراضية `30522`) : حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطة `input_ids`.
hidden_size (`int`، *اختياري*، القيمة الافتراضية `768`) : بُعد التمثيلات المخفية.
num_hidden_layers (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد الطبقات المخفية في مُفكِّك Transformer.
num_attention_heads (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد رؤوس الانتباه في كل طبقة انتباه داخل مُفكِّك Transformer.
intermediate_size (`int`، *اختياري*، القيمة الافتراضية `3072`) : بُعد تمثيلات MLP.
hidden_act (`str`، *اختياري*، القيمة الافتراضية `gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
hidden_dropout_prob (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.1`) : احتمال الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات (embeddings) والمُشفِّر (encoder) والمُجمِّع (pooler).
attention_probs_dropout_prob (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.1`) : نسبة الإسقاط (dropout) لاحتمالات الانتباه.
max_position_embeddings (`int`، *اختياري*، القيمة الافتراضية `512`) : أقصى طول تسلسل قد يُستخدم مع هذا النموذج.
type_vocab_size (`int`، *اختياري*، القيمة الافتراضية `2`) : حجم مفردات `token_type_ids`.
initializer_range (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
layer_norm_eps (`float`، *اختياري*، القيمة الافتراضية `1e-12`) : قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
pad_token_id (`int`، *اختياري*، القيمة الافتراضية `0`) : معرّف الرمز المستخدم للتعبئة في المفردات.
bos_token_id (`int`، *اختياري*، القيمة الافتراضية `0`) : معرّف الرمز المستخدم لبدء البث في المفردات.
eos_token_id (`Union[int, list[int]]`، *اختياري*، القيمة الافتراضية `2`) : معرّف الرمز المستخدم لنهاية البث في المفردات.
max_xpath_tag_unit_embeddings (`int`، *اختياري*، القيمة الافتراضية 256) : القيمة القصوى التي قد يستخدمها تضمين وحدة وسم xpath. عادةً ما يتم ضبط هذه القيمة على رقم كبير احتياطًا (مثل 256).
max_xpath_subs_unit_embeddings (`int`، *اختياري*، القيمة الافتراضية 1024) : القيمة القصوى التي قد يستخدمها تضمين وحدة فهرس مسار xpath. يُنصح عادةً بإعداد هذه القيمة إلى رقم كبير احتياطًا (مثل 1024).
tag_pad_id (`int`، *اختياري*، القيمة الافتراضية 216) : المعرّف الخاص برموز الحشو في وسوم xpath.
subs_pad_id (`int`، *اختياري*، القيمة الافتراضية 1001) : المعرّف الخاص برموز الحشو في فهارس مسار XPath.
xpath_unit_hidden_size (`int`، *اختياري*، القيمة الافتراضية 32) : حجم المخفي لكل وحدة في xpath.
max_depth (`int`، *اختياري*، القيمة الافتراضية 50) : الحد الأقصى للعمق في xpath.
use_cache (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب على النموذج إرجاع قيم المفاتيح/القيم الأخيرة للانتباه (لا تستخدمها جميع النماذج). لا ينطبق إلا إذا كان `config.is_decoder=True` أو عندما يكون النموذج نموذجًا توليديًا يعتمد على المُفكِّك فقط.
classifier_dropout (`Union[float, int]`، *اختياري*) : نسبة dropout للمصنّف.
هذه فئة الإعدادات المخزنة لإعدادات نموذج MarkupLMModel. تُستخدم لاستحداث نموذج Markuplm وفقًا للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [microsoft/markuplm-base](https://huggingface.co/microsoft/markuplm-base)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
أمثلة:
```python
>>> from transformers import MarkupLMModel, MarkupLMConfig
>>> # Initializing a MarkupLM microsoft/markuplm-base style configuration
>>> configuration = MarkupLMConfig()
>>> # Initializing a model from the microsoft/markuplm-base style configuration
>>> model = MarkupLMModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## MarkupLMFeatureExtractor[[transformers.MarkupLMFeatureExtractor]]
#### transformers.MarkupLMFeatureExtractor[[transformers.MarkupLMFeatureExtractor]]
```python
transformers.MarkupLMFeatureExtractor(**kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/feature_extraction_markuplm.py#L32)
ينشئ مستخرج ميزات MarkupLM. يمكن استخدامه للحصول على قائمة بالعُقد والمسارات xpaths المقابلة من نصوص HTML.
يرث مستخرج الميزات هذا من `PreTrainedFeatureExtractor()` الذي يحتوي على معظم الطرق الرئيسية. ينبغي للمستخدمين الرجوع إلى هذه الفئة الأصلية لمزيد من المعلومات حول تلك الطرق.
#### __call__[[transformers.MarkupLMFeatureExtractor.__call__]]
```python
__call__(html_strings)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/feature_extraction_markuplm.py#L98)
**المعاملات:**
html_strings (`str`, `list[str]`) : نص HTML أو دفعة من نصوص HTML لاستخراج العقد والمسارات xpaths المقابلة لها.
**يعيد:** [BatchFeature](/docs/transformers/main/ar/main_classes/feature_extractor#transformers.BatchFeature)
[BatchFeature](/docs/transformers/main/ar/main_classes/feature_extractor#transformers.BatchFeature) يحتوي على الحقول التالية:
- **nodes** -- العقد.
- **xpaths** -- مسارات xpaths المقابلة.
الطريقة الرئيسية لتحضير سلسلة HTML واحدة أو عدة سلاسل للنموذج.
أمثلة:
```python
>>> from transformers import MarkupLMFeatureExtractor
>>> page_name_1 = "page1.html"
>>> page_name_2 = "page2.html"
>>> page_name_3 = "page3.html"
>>> with open(page_name_1) as f:
... single_html_string = f.read()
>>> feature_extractor = MarkupLMFeatureExtractor()
>>> # single example
>>> encoding = feature_extractor(single_html_string)
>>> print(encoding.keys())
>>> # dict_keys(['nodes', 'xpaths'])
>>> # batched example
>>> multi_html_strings = []
>>> with open(page_name_2) as f:
... multi_html_strings.append(f.read())
>>> with open(page_name_3) as f:
... multi_html_strings.append(f.read())
>>> encoding = feature_extractor(multi_html_strings)
>>> print(encoding.keys())
>>> # dict_keys(['nodes', 'xpaths'])
```
## MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
#### transformers.MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
```python
transformers.MarkupLMTokenizer(tags_dict, vocab: str | dict[str, int] | list[tuple[str, float]] | None = None, merges: str | list[str] | None = None, errors = 'replace', bos_token = '', eos_token = '', sep_token = '', cls_token = '', unk_token = '', pad_token = '', mask_token = '', add_prefix_space = False, max_depth = 50, max_width = 1000, pad_width = 1001, pad_token_label = -100, only_label_first_subword = True, trim_offsets = False, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L91)
**المعاملات:**
vocab (`str` أو `dict[str, int]`، *اختياري*) : قاموس مفردات مخصص. إذا لم يُقدَّم، يتم تحميل المفردات من `vocab_file`.
merges (`str` أو `list[str]`، *اختياري*) : قائمة دمج مخصصة. إذا لم تُقدَّم، يتم تحميل عمليات الدمج من `merges_file`.
errors (`str`، *اختياري*، الافتراضي هو `"replace"`) : المنهج المتّبع عند فكّ ترميز البايتات إلى UTF-8. راجع [bytes.decode](https://docs.python.org/3/library/stdtypes.html#bytes.decode) لمزيد من المعلومات.
bos_token (`str`، *اختياري*، القيمة الافتراضية `""`) : رمز بداية التسلسل الذي تم استخدامه أثناء التدريب المسبق. يمكن استخدامه كرمز مصنف التسلسل. عند بناء تسلسل باستخدام الرموز الخاصة، هذا ليس الرمز المستخدم لبداية التسلسل. الرمز المستخدم هو `cls_token`.
eos_token (`str`، *اختياري*، القيمة الافتراضية `""`) : رمز نهاية التسلسل. عند بناء تسلسل باستخدام الرموز الخاصة، هذا ليس الرمز المستخدم لنهاية التسلسل. الرمز المستخدم هو `sep_token`.
sep_token (`str`، *اختياري*، الافتراضي هو `""`) : رمز الفاصل، الذي يُستخدم عند بناء تسلسل من عدة تسلسلات، مثل تسلسلين لتصنيف التسلسلات، أو نص وسؤال للإجابة على الأسئلة. كما يُستخدم كآخر رمز في تسلسل مبني برموز خاصة.
cls_token (`str`، *اختياري*، القيمة الافتراضية `""`) : رمز التصنيف الذي يُستخدم عند إجراء تصنيف التسلسل (تصنيف التسلسل بأكمله بدلاً من تصنيف كل رمز على حدة). وهو الرمز الأول في التسلسل عند بناؤه باستخدام الرموز الخاصة.
unk_token (`str`، *اختياري*، القيمة الافتراضية `""`) : رمز المجهول. الرمز غير الموجود في قاموس الكلمات لا يمكن تحويله إلى معرّف، لذا يُعيَّن هذا الرمز بدلاً منه.
pad_token (`str`، *اختياري*، القيمة الافتراضية هي `""`) : الرمز المستخدم للتعبئة، على سبيل المثال عند تجميع تسلسلات ذات أطوال مختلفة.
mask_token (`str`، *اختياري*، القيمة الافتراضية `""`) : الرمز المستخدم لإخفاء القيم. هذا هو الرمز المستخدم عند تدريب هذا النموذج باستخدام نمذجة اللغة المقنّعة. وهو الرمز الذي سيحاول النموذج التنبؤ به.
add_prefix_space (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيُضاف فراغ أولي إلى المدخل. يُتيح ذلك معاملة الكلمة الأولى كما تُعامَل أي كلمة أخرى. (يكتشف مُجزِّئ RoBERTa بداية الكلمات من خلال الفراغ الذي يسبقها).
أنشئ مُرمِّز MarkupLM. يعتمد على ترميز الأزواج البايتية على مستوى البايت (BPE).
يمكن استخدام [MarkupLMTokenizer](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMTokenizer) لتحويل نصوص HTML إلى `input_ids` و`attention_mask` و`token_type_ids` و`xpath_tags_seq` و`xpath_tags_seq` على مستوى الرموز. يرث هذا المُرمِّز من [TokenizersBackend](/docs/transformers/main/ar/main_classes/tokenizer#transformers.TokenizersBackend) الذي يحتوي على معظم الطرق الرئيسية ويضمن دائمًا إنشاء واجهة خلفية `tokenizers`.
يجب على المستخدمين الرجوع إلى هذه الفئة الأصلية لمزيد من المعلومات حول تلك الطرق.
#### build_inputs_with_special_tokens[[transformers.MarkupLMTokenizer.build_inputs_with_special_tokens]]
```python
build_inputs_with_special_tokens(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L952)
**المعاملات:**
token_ids_0 (`list[int]`) : قائمة بالمعرّفات التي ستُضاف إليها الرموز الخاصة.
token_ids_1 (`list[int]`، *اختياري*) : قائمة ثانية اختيارية من المعرّفات لأزواج التسلسلات.
**يعيد:** `list[int]`
قائمة [معرفات الإدخال](../glossary#input-ids) مع الرموز الخاصة المناسبة.
build_model_inputs يبني مدخلات النموذج من تسلسل أو زوج من التسلسلات لمهام تصنيف التسلسل عن طريق دمجها وإضافة الرموز الخاصة. يتبع تسلسل RoBERTa التنسيق التالي:
- تسلسل واحد: ` X `
- زوج من التسلسلات: ` A B `
#### get_special_tokens_mask[[transformers.MarkupLMTokenizer.get_special_tokens_mask]]
```python
get_special_tokens_mask(token_ids_0: list[int], token_ids_1: list[int] | None = None, already_has_special_tokens: bool = False)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/tokenization_utils_base.py#L1338)
**المعاملات:**
token_ids_0 : قائمة معرّفات (IDs) للتسلسل (الذي قد يكون منسّقًا بالفعل).
token_ids_1 : غير مستخدم عندما يكون `already_has_special_tokens=True`. يجب أن يكون None في هذه الحالة.
already_has_special_tokens : ما إذا كانت التسلسلة منسّقة مسبقًا باستخدام الرموز الخاصة.
**يعيد:** قائمة من الأعداد الصحيحة في المدى [0, 1]
1 لرمز خاص، 0 لرمز التسلسل.
استرجاع معرّفات التسلسلات من قائمة الرموز التي لم تُضف إليها أي رموز خاصة.
للمُرمِّزات السريعة، تستدعي مُجمِّعات البيانات هذه الدالة مع `already_has_special_tokens=True` لبناء قناع فوق تسلسل منسّق مسبقًا. في هذه الحالة، نحسب القناع عن طريق التحقق من العضوية في `all_special_ids`.
#### create_token_type_ids_from_sequences[[transformers.MarkupLMTokenizer.create_token_type_ids_from_sequences]]
```python
create_token_type_ids_from_sequences(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L975)
**المعاملات:**
token_ids_0 (`list[int]`) : قائمة من المعرّفات.
token_ids_1 (`list[int]`، *اختياري*) : قائمة ثانية اختيارية من المعرّفات لأزواج التسلسلات.
**يعيد:** `list[int]`
قائمة من الأصفار.
أنشئ قناعًا من التسلسلين المُمرَّرين لاستخدامه في مهمة تصنيف أزواج التسلسلات. لا يستخدم RoBERTa معرّفات أنواع الرموز، لذلك يُعاد قائمة من الأصفار.
#### save_vocabulary[[transformers.MarkupLMTokenizer.save_vocabulary]]
```python
save_vocabulary(save_directory: str, filename_prefix: str | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L997)
## MarkupLMTokenizerFast[[transformers.MarkupLMTokenizer]]
#### transformers.MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
```python
transformers.MarkupLMTokenizer(tags_dict, vocab: str | dict[str, int] | list[tuple[str, float]] | None = None, merges: str | list[str] | None = None, errors = 'replace', bos_token = '', eos_token = '', sep_token = '', cls_token = '', unk_token = '', pad_token = '', mask_token = '', add_prefix_space = False, max_depth = 50, max_width = 1000, pad_width = 1001, pad_token_label = -100, only_label_first_subword = True, trim_offsets = False, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L91)
**المعاملات:**
vocab (`str` أو `dict[str, int]`، *اختياري*) : قاموس مفردات مخصص. إذا لم يُقدَّم، يتم تحميل المفردات من `vocab_file`.
merges (`str` أو `list[str]`، *اختياري*) : قائمة دمج مخصصة. إذا لم تُقدَّم، يتم تحميل عمليات الدمج من `merges_file`.
errors (`str`، *اختياري*، الافتراضي هو `"replace"`) : المنهج المتّبع عند فكّ ترميز البايتات إلى UTF-8. راجع [bytes.decode](https://docs.python.org/3/library/stdtypes.html#bytes.decode) لمزيد من المعلومات.
bos_token (`str`، *اختياري*، القيمة الافتراضية `""`) : رمز بداية التسلسل الذي تم استخدامه أثناء التدريب المسبق. يمكن استخدامه كرمز مصنف التسلسل. عند بناء تسلسل باستخدام الرموز الخاصة، هذا ليس الرمز المستخدم لبداية التسلسل. الرمز المستخدم هو `cls_token`.
eos_token (`str`، *اختياري*، القيمة الافتراضية `""`) : رمز نهاية التسلسل. عند بناء تسلسل باستخدام الرموز الخاصة، هذا ليس الرمز المستخدم لنهاية التسلسل. الرمز المستخدم هو `sep_token`.
sep_token (`str`، *اختياري*، الافتراضي هو `""`) : رمز الفاصل، الذي يُستخدم عند بناء تسلسل من عدة تسلسلات، مثل تسلسلين لتصنيف التسلسلات، أو نص وسؤال للإجابة على الأسئلة. كما يُستخدم كآخر رمز في تسلسل مبني برموز خاصة.
cls_token (`str`، *اختياري*، القيمة الافتراضية `""`) : رمز التصنيف الذي يُستخدم عند إجراء تصنيف التسلسل (تصنيف التسلسل بأكمله بدلاً من تصنيف كل رمز على حدة). وهو الرمز الأول في التسلسل عند بناؤه باستخدام الرموز الخاصة.
unk_token (`str`، *اختياري*، القيمة الافتراضية `""`) : رمز المجهول. الرمز غير الموجود في قاموس الكلمات لا يمكن تحويله إلى معرّف، لذا يُعيَّن هذا الرمز بدلاً منه.
pad_token (`str`، *اختياري*، القيمة الافتراضية هي `""`) : الرمز المستخدم للتعبئة، على سبيل المثال عند تجميع تسلسلات ذات أطوال مختلفة.
mask_token (`str`، *اختياري*، القيمة الافتراضية `""`) : الرمز المستخدم لإخفاء القيم. هذا هو الرمز المستخدم عند تدريب هذا النموذج باستخدام نمذجة اللغة المقنّعة. وهو الرمز الذي سيحاول النموذج التنبؤ به.
add_prefix_space (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيُضاف فراغ أولي إلى المدخل. يُتيح ذلك معاملة الكلمة الأولى كما تُعامَل أي كلمة أخرى. (يكتشف مُجزِّئ RoBERTa بداية الكلمات من خلال الفراغ الذي يسبقها).
أنشئ مُرمِّز MarkupLM. يعتمد على ترميز الأزواج البايتية على مستوى البايت (BPE).
يمكن استخدام [MarkupLMTokenizer](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMTokenizer) لتحويل نصوص HTML إلى `input_ids` و`attention_mask` و`token_type_ids` و`xpath_tags_seq` و`xpath_tags_seq` على مستوى الرموز. يرث هذا المُرمِّز من [TokenizersBackend](/docs/transformers/main/ar/main_classes/tokenizer#transformers.TokenizersBackend) الذي يحتوي على معظم الطرق الرئيسية ويضمن دائمًا إنشاء واجهة خلفية `tokenizers`.
يجب على المستخدمين الرجوع إلى هذه الفئة الأصلية لمزيد من المعلومات حول تلك الطرق.
#### batch_encode_plus[[transformers.MarkupLMTokenizer.batch_encode_plus]]
```python
batch_encode_plus(batch_text_or_text_pairs: list[str] | list[tuple[str, str]] | list[list[str]], is_pair: bool | None = None, xpaths: list[list[list[int]]] | None = None, node_labels: list[int] | list[list[int]] | None = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L453)
add_special_tokens (`bool`، *اختياري*، القيمة الافتراضية `True`): ما إذا كان سيتم إضافة الرموز الخاصة عند ترميز التسلسلات أم لا. سيستخدم هذا الدالة الأساسية `PretrainedTokenizerBase.build_inputs_with_special_tokens`، التي تحدد الرموز التي تُضاف تلقائياً إلى معرّفات الإدخال. يكون هذا مفيداً إذا كنت ترغب في إضافة رموز `bos` أو `eos` تلقائياً. padding (`bool`، `str` أو [PaddingStrategy](/docs/transformers/main/ar/internal/file_utils#transformers.utils.PaddingStrategy)، *اختياري*، القيمة الافتراضية `False`): يُفعّل التحكم في الحشو. يقبل القيم التالية:
- `True` أو `'longest'`: يتم ملء التسلسلات حتى أطول تسلسل في الدفعة (أو لا يتم أي ملء إذا تم تقديم تسلسل واحد فقط).
- `'max_length'`: يُكمل النص حتى الطول الأقصى المحدد عبر الحجة `max_length` أو حتى الطول الأقصى المقبول لإدخال النموذج إذا لم تُقدَّم تلك الحجة.
- `False` أو `'do_not_pad'` (الافتراضي): لا يوجد حشو (أي، يمكن إخراج دفعة تحتوي على تسلسلات بطول مختلف).
truncation (`bool` أو `str` أو [TruncationStrategy](/docs/transformers/main/ar/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy)، *اختياري*، القيمة الافتراضية `False`): يُفعّل التحكم في القص. يقبل القيم التالية:
- `True` أو `'longest_first'`: يُقصّ النص إلى الحد الأقصى للطول المحدد عبر الحجة `max_length` أو إلى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. يتم هذا القص رمزًا تلو الآخر، حيث يُزال رمز من أطول تسلسل في الزوج إذا كان قد قُدِّم زوج من التسلسلات (أو دفعة من الأزواج).
- `'only_first'`: يُقصّ النص إلى الحد الأقصى للطول المحدد عبر الحجة `max_length` أو إلى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. لن يُقصّ هذا الخيار سوى التسلسل الأول من الزوج إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج).
- `'only_second'`: يُقصّ النص إلى الحد الأقصى للطول المحدد عبر الحجة `max_length` أو إلى الحد الأقصى لطول الإدخال المقبول للنموذج إذا لم تُقدَّم تلك الحجة. لن يتم قصّ النص الثاني من الزوج إلا إذا قُدِّم زوج من النصوص (أو دفعة من الأزواج).
- `False` أو `'do_not_truncate'` (الافتراضي): لا يوجد اقتطاع (أي، يمكن إخراج دفعة بأطوال تسلسلات أكبر من الحد الأقصى المقبول لحجم الإدخال في النموذج).
max_length (`int`، *اختياري*): يتحكم في الحد الأقصى للطول الذي يستخدمه أحد معاملات القص/الحشو.
If left unset or set to `None`, this will use the predefined model maximum length if a maximum length is required by one of the truncation/padding parameters. If the model has no specific maximum input length (like XLNet) truncation/padding to a maximum length will be deactivated. stride (`int`, *optional*, defaults to 0): If set to a number along with `max_length`, the overflowing tokens returned when `return_overflowing_tokens=True` will contain some tokens from the end of the truncated sequence returned to provide some overlap between truncated and overflowing sequences. The value of this argument defines the number of overlapping tokens. is_split_into_words (`bool`, *optional*, defaults to `False`): Whether or not the input is already pre-tokenized (e.g., split into words). If set to `True`, the tokenizer assumes the input is already split into words (for instance, by splitting it on whitespace) which it will tokenize. This is useful for NER or token classification. pad_to_multiple_of (`int`, *optional*): If set will pad the sequence to a multiple of the provided value. Requires `padding` to be activated. This is especially useful to enable the use of Tensor Cores on NVIDIA hardware with compute capability `>= 7.5` (Volta). padding_side (`str`, *optional*): The side on which the model should have padding applied. Should be selected between ['right', 'left']. Default value is picked from the class attribute of the same name. return_tensors (`str` or [TensorType](/docs/transformers/main/ar/internal/file_utils#transformers.TensorType), *optional*): If set, will return tensors instead of list of python integers. Acceptable values are:
- `'pt'`: إرجاع كائنات `torch.Tensor` من PyTorch.
- `'np'`: إرجاع كائنات `np.ndarray` من نوع Numpy.
add_special_tokens (`bool`، *اختياري*، القيمة الافتراضية `True`): ما إذا كان سيتم ترميز التسلسلات باستخدام الرموز الخاصة الخاصة بنموذجها أم لا. padding (`bool` أو `str` أو [PaddingStrategy](/docs/transformers/main/ar/internal/file_utils#transformers.utils.PaddingStrategy)، *اختياري*، القيمة الافتراضية `False`): يُفعّل التحكم في الحشو. يقبل القيم التالية:
- `True` أو `'longest'`: يتم ملء التسلسلات حتى أطول تسلسل في الدفعة (أو لا يتم أي ملء إذا تم تقديم تسلسل واحد فقط).
- `'max_length'`: يُكمل النص حتى الطول الأقصى المحدد عبر الحجة `max_length` أو حتى الطول الأقصى المقبول لإدخال النموذج إذا لم تُقدَّم تلك الحجة.
- `False` أو `'do_not_pad'` (الافتراضي): لا يوجد حشو (أي، يمكن إخراج دفعة تحتوي على تسلسلات بطول مختلف).
truncation (`bool` أو `str` أو [TruncationStrategy](/docs/transformers/main/ar/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy)، *اختياري*، القيمة الافتراضية `False`): يُفعّل التحكم في القص. يقبل القيم التالية:
- `True` أو `'longest_first'`: يُقصّ النص إلى الحد الأقصى للطول المحدد عبر الحجة `max_length` أو إلى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. يتم هذا القص رمزًا تلو الآخر، حيث يُزال رمز من أطول تسلسل في الزوج إذا كان قد قُدِّم زوج من التسلسلات (أو دفعة من الأزواج).
- `'only_first'`: يُقصّ النص إلى الحد الأقصى للطول المحدد عبر الحجة `max_length` أو إلى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. لن يُقصّ هذا الخيار سوى التسلسل الأول من الزوج إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج).
- `'only_second'`: يُقصّ النص إلى الحد الأقصى للطول المحدد عبر الحجة `max_length` أو إلى الحد الأقصى لطول الإدخال المقبول للنموذج إذا لم تُقدَّم تلك الحجة. لن يتم قصّ النص الثاني من الزوج إلا إذا قُدِّم زوج من النصوص (أو دفعة من الأزواج).
- `False` أو `'do_not_truncate'` (الافتراضي): لا يوجد اقتطاع (أي، يمكن إخراج دفعة بأطوال تسلسلات أكبر من الحد الأقصى المقبول لحجم الإدخال في النموذج).
max_length (`int`, *optional*): Controls the maximum length to use by one of the truncation/padding parameters. If left unset or set to `None`, this will use the predefined model maximum length if a maximum length is required by one of the truncation/padding parameters. If the model has no specific maximum input length (like XLNet) truncation/padding to a maximum length will be deactivated. stride (`int`, *optional*, defaults to 0): If set to a number along with `max_length`, the overflowing tokens returned when `return_overflowing_tokens=True` will contain some tokens from the end of the truncated sequence returned to provide some overlap between truncated and overflowing sequences. The value of this argument defines the number of overlapping tokens. is_split_into_words (`bool`, *optional*, defaults to `False`): Whether or not the input is already pretokenized (e.g. split into words). Set this to `True` if you are passing pretokenized inputs to avoid additional tokenization. pad_to_multiple_of (`int`, *optional*): If set will pad the sequence to a multiple of the provided value. This is especially useful to enable the use of Tensor Cores on NVIDIA hardware with compute capability `>= 7.5` (Volta). return_tensors (`str` or [TensorType](/docs/transformers/main/ar/internal/file_utils#transformers.TensorType), *optional*): If set, will return tensors instead of list of python integers. Acceptable values are:
- `'pt'`: إرجاع كائنات `torch.Tensor` من PyTorch.
- `'np'`: إرجاع كائنات `np.ndarray` من نوع Numpy.
#### build_inputs_with_special_tokens[[transformers.MarkupLMTokenizer.build_inputs_with_special_tokens]]
```python
build_inputs_with_special_tokens(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L952)
**المعاملات:**
token_ids_0 (`list[int]`) : قائمة بالمعرّفات التي ستُضاف إليها الرموز الخاصة.
token_ids_1 (`list[int]`، *اختياري*) : قائمة ثانية اختيارية من المعرّفات لأزواج التسلسلات.
**يعيد:** `list[int]`
قائمة [معرفات الإدخال](../glossary#input-ids) مع الرموز الخاصة المناسبة.
build_model_inputs يبني مدخلات النموذج من تسلسل أو زوج من التسلسلات لمهام تصنيف التسلسل عن طريق دمجها وإضافة الرموز الخاصة. يتبع تسلسل RoBERTa التنسيق التالي:
- تسلسل واحد: ` X `
- زوج من التسلسلات: ` A B `
#### create_token_type_ids_from_sequences[[transformers.MarkupLMTokenizer.create_token_type_ids_from_sequences]]
```python
create_token_type_ids_from_sequences(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L975)
**المعاملات:**
token_ids_0 (`list[int]`) : قائمة من المعرّفات.
token_ids_1 (`list[int]`، *اختياري*) : قائمة ثانية اختيارية من المعرّفات لأزواج التسلسلات.
**يعيد:** `list[int]`
قائمة من الأصفار.
أنشئ قناعًا من التسلسلين المُمرَّرين لاستخدامه في مهمة تصنيف أزواج التسلسلات. لا يستخدم RoBERTa معرّفات أنواع الرموز، لذلك يُعاد قائمة من الأصفار.
#### encode_plus[[transformers.MarkupLMTokenizer.encode_plus]]
```python
encode_plus(text: str | list[str], text_pair: list[str] | None = None, xpaths: list[list[int]] | None = None, node_labels: list[int] | None = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L518)
**المعاملات:**
text (`str`، `list[str]`، `list[list[str]]`) : التسلسل الأول الذي سيتم ترميزه. يمكن أن يكون نصًا، أو قائمة من النصوص، أو قائمة من قوائم النصوص.
text_pair (`list[str]` أو `list[int]`، *اختياري*) : تسلسل ثانٍ اختياري ليتم ترميزه. يمكن أن يكون هذا قائمة من النصوص (كلمات مثال واحد) أو قائمة من قوائم النصوص (كلمات دفعة من الأمثلة).
add_special_tokens (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إضافة الرموز الخاصة عند ترميز التسلسلات أم لا. سيستخدم هذا الدالة الأساسية `PretrainedTokenizerBase.build_inputs_with_special_tokens`، التي تحدد الرموز التي تُضاف تلقائيًا إلى معرّفات الإدخال. وهذا مفيد إذا كنت ترغب في إضافة رموز `bos` أو `eos` تلقائيًا.
padding (`bool` أو `str` أو [PaddingStrategy](/docs/transformers/main/ar/internal/file_utils#transformers.utils.PaddingStrategy)، *اختياري*، القيمة الافتراضية هي `False`) : يُفعّل التحكم في الحشو. يقبل القيم التالية: - `True` أو `'longest'`: حشو حتى أطول تسلسل في الدفعة (أو بدون حشو إذا تم تقديم تسلسل واحد فقط). - `'max_length'`: حشو حتى الحد الأقصى للطول المحدد بواسطة الحجة `max_length` أو حتى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. - `False` أو `'do_not_pad'` (الافتراضي): بدون حشو (أي، يمكنه إخراج دفعة تحتوي على تسلسلات بطول مختلف).
truncation (`bool` أو `str` أو [TruncationStrategy](/docs/transformers/main/ar/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy)، *اختياري*، القيمة الافتراضية `False`) : يُفعّل التحكم في القص. يقبل القيم التالية: - `True` أو `'longest_first'`: يُقصّ إلى الحد الأقصى للطول المحدد عبر الحجة `max_length` أو إلى الحد الأقصى لطول الإدخال المقبول للنموذج إذا لم تُقدَّم تلك الحجة. سيؤدي هذا إلى القص رمزًا تلو الآخر، مع إزالة رمز من أطول تسلسل في الزوج إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج). - `'only_first'`: يُقصّ إلى الحد الأقصى للطول المحدد عبر الحجة `max_length` أو إلى الحد الأقصى لطول الإدخال المقبول للنموذج إذا لم تُقدَّم تلك الحجة. سيؤدي هذا إلى قصّ التسلسل الأول من الزوج فقط إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج). - `'only_second'`: يُقصّ إلى الحد الأقصى للطول المحدد عبر الحجة `max_length` أو إلى الحد الأقصى لطول الإدخال المقبول للنموذج إذا لم تُقدَّم تلك الحجة. سيؤدي هذا إلى قصّ التسلسل الثاني من الزوج فقط إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج). - `False` أو `'do_not_truncate'` (الافتراضي): لا يوجد قص (أي، يمكن إخراج دفعة بأطوال تسلسلات أكبر من الحد الأقصى المقبول لحجم الإدخال للنموذج).
max_length (`int`, *اختياري*) : يتحكم في الحد الأقصى للطول الذي سيستخدمه أحد معاملات القص/الحشو. إذا تُرك غير مضبوط أو ضُبط على `None`، فسيتم استخدام الحد الأقصى للطول المحدد مسبقًا للنموذج إذا كان أحد معاملات القص/الحشو يتطلب حدًا أقصى للطول. إذا لم يكن للنموذج حد أقصى محدد لطول الإدخال (مثل XLNet)، فسيتم تعطيل القص/الحشو إلى حد أقصى للطول.
stride (`int`، *اختياري*، القيمة الافتراضية 0) : إذا تم تعيينه إلى رقم مع `max_length`، فإن الرموز الزائدة المُعاد عند `return_overflowing_tokens=True` ستحتوي على بعض الرموز من نهاية التسلسل المُقتطع المُعاد، لتوفير بعض التداخل بين التسلسلات المُقتطعة والتسلسلات الزائدة. تحدد قيمة هذا الحجة عدد الرموز المتداخلة.
is_split_into_words (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كانت المدخلات مُجزّأة مسبقًا (مثل تقسيمها إلى كلمات) أم لا. إذا تم ضبطها على `True`، يفترض المُجزّئ أن المدخلات مُقسّمة مسبقًا إلى كلمات (على سبيل المثال، عن طريق تقسيمها على المسافات) وسيُجزّئها. هذا مفيد في مهام تحديد الكيانات الاسمية أو تصنيف الرموز.
pad_to_multiple_of (`int`, *اختياري*) : إذا تم ضبطه، سيتم توسيط التسلسل إلى مضاعف للقيمة المُقدَّمة. يتطلب تفعيل `padding`. وهذا مفيد بشكل خاص لتمكين استخدام نوى التENSOR على أجهزة NVIDIA التي تتمتع بقابلية حسابية `>= 7.5` (Volta).
padding_side (`str`، *اختياري*) : الجانب الذي يجب تطبيق الحشو عليه في النموذج. يجب اختياره من بين ['right', 'left']. القيمة الافتراضية تُستخرج من سمة الفئة التي تحمل الاسم نفسه.
return_tensors (`str` أو [TensorType](/docs/transformers/main/ar/internal/file_utils#transformers.TensorType)، *اختياري*) : إذا تم تعيينه، فسيُرجع تينسورات بدلاً من قائمة من الأعداد الصحيحة بلغة بايثون. القيم المقبولة هي: - `'pt'`: يُرجع كائنات `torch.Tensor` من PyTorch. - `'np'`: يُرجع كائنات `np.ndarray` من Numpy.
add_special_tokens (`bool`، *اختياري*، الافتراضي `True`) : ما إذا كان سيتم ترميز التسلسلات باستخدام الرموز الخاصة الخاصة بنموذجها أم لا.
padding (`bool` أو `str` أو [PaddingStrategy](/docs/transformers/main/ar/internal/file_utils#transformers.utils.PaddingStrategy)، *اختياري*، القيمة الافتراضية `False`) : يُفعّل التحكم في الحشو. يقبل القيم التالية: - `True` أو `'longest'`: الحشو حتى أطول تسلسل في الدفعة (أو بدون حشو إذا تم تقديم تسلسل واحد فقط). - `'max_length'`: الحشو حتى الحد الأقصى للطول المحدد بواسطة الحجة `max_length` أو حتى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. - `False` أو `'do_not_pad'` (الافتراضي): بدون حشو (أي، يمكنه إخراج دفعة تحتوي على تسلسلات بطول مختلف).
truncation (`bool` أو `str` أو [TruncationStrategy](/docs/transformers/main/ar/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy)، *اختياري*، القيمة الافتراضية `False`) : يُفعّل التحكم في القص. يقبل القيم التالية: - `True` أو `'longest_first'`: يُقصّ إلى الحد الأقصى للطول المحدد عبر الحجة `max_length` أو إلى الحد الأقصى لطول الإدخال المقبول للنموذج إذا لم تُقدَّم تلك الحجة. سيؤدي هذا إلى القص رمزًا تلو الآخر، مع إزالة رمز من أطول تسلسل في الزوج إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج). - `'only_first'`: يُقصّ إلى الحد الأقصى للطول المحدد عبر الحجة `max_length` أو إلى الحد الأقصى لطول الإدخال المقبول للنموذج إذا لم تُقدَّم تلك الحجة. سيؤدي هذا إلى قصّ التسلسل الأول من الزوج فقط إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج). - `'only_second'`: يُقصّ إلى الحد الأقصى للطول المحدد عبر الحجة `max_length` أو إلى الحد الأقصى لطول الإدخال المقبول للنموذج إذا لم تُقدَّم تلك الحجة. سيؤدي هذا إلى قصّ التسلسل الثاني من الزوج فقط إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج). - `False` أو `'do_not_truncate'` (الافتراضي): لا يوجد قص (أي، يمكن إخراج دفعة بأطوال تسلسلات أكبر من الحد الأقصى المقبول لحجم الإدخال للنموذج).
max_length (`int`, *اختياري*) : يتحكم في الحد الأقصى للطول الذي سيستخدمه أحد معاملات القص/الحشو. إذا تُرك غير مضبوط أو ضُبط على `None`، فسيتم استخدام الحد الأقصى للطول المحدد مسبقًا للنموذج إذا كان أحد معاملات القص/الحشو يتطلب حدًا أقصى للطول. إذا لم يكن للنموذج حد أقصى محدد لطول الإدخال (مثل XLNet)، فسيتم تعطيل القص/الحشو إلى حد أقصى للطول.
stride (`int`، *اختياري*، القيمة الافتراضية 0) : إذا تم تعيينه إلى رقم مع `max_length`، فإن الرموز الزائدة المُعاد عند `return_overflowing_tokens=True` ستحتوي على بعض الرموز من نهاية التسلسل المُقتطع المُعاد، لتوفير بعض التداخل بين التسلسلات المُقتطعة والتسلسلات الزائدة. تحدد قيمة هذا الحجة عدد الرموز المتداخلة.
is_split_into_words (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان الإدخال مُقسّمًا مسبقًا إلى رموز (مثل تقسيمه إلى كلمات). اضبط هذا على `True` إذا كنت تمرر مدخلات مُقسّمة مسبقًا إلى رموز لتجنب التقسيم الإضافي.
pad_to_multiple_of (`int`, *اختياري*) : إذا تم تعيينه، سيتم توسيط التسلسل إلى مضاعف للقيمة المُقدَّمة. وهذا مفيد بشكل خاص لتمكين استخدام نوى التينسور (Tensor Cores) على أجهزة NVIDIA التي تتمتع بقابلية معالجة `>= 7.5` (Volta).
return_tensors (`str` أو [TensorType](/docs/transformers/main/ar/internal/file_utils#transformers.TensorType)، *اختياري*) : إذا تم تعيينه، فسيُرجع تينسورات بدلاً من قائمة من الأعداد الصحيحة بلغة بايثون. القيم المقبولة هي: - `'pt'`: يُرجع كائنات `torch.Tensor` من PyTorch. - `'np'`: يُرجع كائنات `np.ndarray` من Numpy.
تجزئة تسلسل أو زوج من التسلسلات وتجهيزها للنموذج. .. warning:: هذه الطريقة لم تعد مستخدمة، يجب استخدام `__call__` بدلاً منها.
#### get_xpath_seq[[transformers.MarkupLMTokenizer.get_xpath_seq]]
```python
get_xpath_seq(xpath)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L253)
بما أن لديك تعبير xpath لعقدة معينة (مثل "/html/body/div/li[1]/div/span[2]")، فارجع قائمة معرّفات الوسوم والفهارس الفرعية المقابلة لها، مع مراعاة الحد الأقصى للعمق.
## MarkupLMProcessor[[transformers.MarkupLMProcessor]]
#### transformers.MarkupLMProcessor[[transformers.MarkupLMProcessor]]
```python
transformers.MarkupLMProcessor(feature_extractor, tokenizer)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/processing_markuplm.py#L25)
**المعاملات:**
feature_extractor (`feature_extractor_class`) : مُستخرج الميزات هو مدخل مطلوب.
tokenizer (`MarkupLMTokenizer`) : مُجزِّئ النص (tokenizer) هو مدخل مطلوب.
ينشئ كائن MarkupLMProcessor الذي يجمع مستخرج الميزات ومجزئ النص في معالج واحد.
يوفر [MarkupLMProcessor](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMProcessor) جميع وظائف `feature_extractor_class` و[MarkupLMTokenizer](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMTokenizer). راجع `~feature_extractor_class` و[~MarkupLMTokenizer](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMTokenizer) لمزيد من المعلومات.
#### __call__[[transformers.MarkupLMProcessor.__call__]]
```python
__call__(html_strings = None, nodes = None, xpaths = None, node_labels = None, questions = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, return_tensors: str | transformers.utils.generic.TensorType | None = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/processing_markuplm.py#L31)
**المعاملات:**
html_strings (`str` أو `list[str]`، *اختياري*) : نصوص HTML خام للتحويل والمعالجة. عند تعيين `parse_html=True` (الافتراضي)، يتم تحويل هذه النصوص لاستخراج العقد ومسارات xpaths تلقائيًا. إذا تم توفيرها، يجب عدم توفير `nodes` و`xpaths` و`node_labels`. مطلوب عند تعيين `parse_html=True`.
nodes (`list[list[str]]`، *اختياري*) : عُقد HTML مستخرجة مسبقًا على شكل قائمة من القوائم، حيث تحتوي كل قائمة داخلية على المحتوى النصي للعُقد الخاصة بمستند واحد. مطلوب عند `parse_html=False`. يجب عدم تقديمه عند `parse_html=True`.
xpaths (`list[list[str]]`، *اختياري*) : تعبيرات XPath المستخرجة مسبقًا المقابلة للعُقد. يجب أن تكون قائمة من القوائم ذات البنية نفسها لـ`nodes`، حيث يحدد كل تعبير XPath موقع العُقدة المقابلة في شجرة HTML. مطلوب عند `parse_html=False`. يجب عدم تقديمه عند `parse_html=True`.
node_labels (`list[list[int]]`، *اختياري*) : تسميات للعُقد، تُستخدم عادةً لمهام التدريب أو الضبط الدقيق. يجب أن تكون قائمة من القوائم ذات البنية نفسها لـ`nodes`، حيث تتوافق كل تسمية مع عقدة. اختياري ويُستخدم فقط عندما يكون `parse_html=False`.
questions (`str` أو `list[str]`، *اختياري*) : نصوص الأسئلة لمهام الإجابة عن الأسئلة. عند تقديمها، يعالج المُرمِّز الأسئلة كالتسلسل الأول والعُقد كالتسلسل الثاني (text_pair). إذا تم تقديم نص واحد، يتم تحويله إلى قائمة لتطابق بُعد الدفعة (batch dimension) للـ HTML المُحلَّل.
add_special_tokens (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إضافة الرموز الخاصة عند ترميز التسلسلات أم لا. سيستخدم هذا الدالة الأساسية `PretrainedTokenizerBase.build_inputs_with_special_tokens`، التي تحدد الرموز التي تُضاف تلقائيًا إلى معرّفات الإدخال. وهذا مفيد إذا كنت ترغب في إضافة رموز `bos` أو `eos` تلقائيًا.
padding (bool أو str أو [PaddingStrategy](/docs/transformers/main/ar/internal/file_utils#transformers.utils.PaddingStrategy)، *اختياري*، القيمة الافتراضية `False`) : يُفعّل التحكم في الحشو. يقبل القيم التالية: - `True` أو `'longest'`: حشو حتى أطول تسلسل في الدفعة (أو بدون حشو إذا تم تقديم تسلسل واحد فقط). - `'max_length'`: حشو حتى الحد الأقصى للطول المحدد بالحجة `max_length` أو حتى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. - `False` أو `'do_not_pad'` (الافتراضي): بدون حشو (أي، يمكن إخراج دفعة تحتوي على تسلسلات بطول مختلف).
truncation (bool, str or [TruncationStrategy](/docs/transformers/main/ar/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *optional*) : يُفعّل التحكم في القص. يقبل القيم التالية: - `True` أو `'longest_first'`: يُقصّ إلى الحد الأقصى للطول المحدد بالحجة `max_length` أو إلى الحد الأقصى لطول الإدخال المقبول للنموذج إذا لم تُقدَّم تلك الحجة. سيؤدي هذا إلى القص رمزًا تلو الآخر، مع إزالة رمز من أطول تسلسل في الزوج إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج). - `'only_first'`: يُقصّ إلى الحد الأقصى للطول المحدد بالحجة `max_length` أو إلى الحد الأقصى لطول الإدخال المقبول للنموذج إذا لم تُقدَّم تلك الحجة. سيؤدي هذا إلى قصّ التسلسل الأول من الزوج فقط إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج). - `'only_second'`: يُقصّ إلى الحد الأقصى للطول المحدد بالحجة `max_length` أو إلى الحد الأقصى لطول الإدخال المقبول للنموذج إذا لم تُقدَّم تلك الحجة. سيؤدي هذا إلى قصّ التسلسل الثاني من الزوج فقط إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج). - `False` أو `'do_not_truncate'` (الافتراضي): لا يوجد قص (أي، يمكن إخراج دفعة بأطوال تسلسلات أكبر من الحد الأقصى المقبول لحجم الإدخال للنموذج).
max_length (`int`, *اختياري*) : يتحكم في الحد الأقصى للطول الذي سيستخدمه أحد معاملات القص/الحشو. إذا تُرك غير مضبوط أو ضُبط على `None`، فسيتم استخدام الحد الأقصى للطول المحدد مسبقًا للنموذج إذا كان أحد معاملات القص/الحشو يتطلب حدًا أقصى للطول. إذا لم يكن للنموذج حد أقصى محدد لطول الإدخال (مثل XLNet)، فسيتم تعطيل القص/الحشو إلى حد أقصى للطول.
stride (`int`، *اختياري*، القيمة الافتراضية `0`) : إذا تم تعيينه إلى رقم مع `max_length`، فإن الرموز الزائدة المُعاد عند `return_overflowing_tokens=True` ستحتوي على بعض الرموز من نهاية التسلسل المُقتطع المُعاد، لتوفير بعض التداخل بين التسلسلات المُقتطعة والتسلسلات الزائدة. تحدد قيمة هذا الحجة عدد الرموز المتداخلة.
pad_to_multiple_of (`int`, *اختياري*) : إذا تم ضبطه، سيتم ملء التسلسل حتى يصبح مضاعفًا للقيمة المُقدَّمة. يتطلب تفعيل `padding`. وهذا مفيد بشكل خاص لتمكين استخدام Tensor Cores على أجهزة NVIDIA التي تتمتع بقابلية معالجة `>= 7.5` (Volta).
return_token_type_ids (`bool`، *اختياري*) : ما إذا كان يجب إرجاع معرّفات أنواع الرموز. إذا تُركت القيمة الافتراضية، فسيتم إرجاع معرّفات أنواع الرموز وفقًا للقيمة الافتراضية الخاصة بمجزّئ الرموز المحدد، كما تحددها خاصية `return_outputs`. [ما هي معرّفات أنواع الرموز؟](../glossary#token-type-ids)
return_attention_mask (`bool`، *اختياري*) : ما إذا كان يجب إرجاع قناع الانتباه. إذا تُركت القيمة الافتراضية، فسيتم إرجاع قناع الانتباه وفقاً للقيمة الافتراضية الخاصة بمجزّئ الرموز المعني، كما هو معرّف بواسطة الخاصية `return_outputs`. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
return_overflowing_tokens (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم إرجاع تسلسلات الرموز المتجاوزة أم لا. إذا تم تقديم زوج من تسلسلات معرّفات الإدخال (أو دفعة من الأزواج) مع `truncation_strategy = longest_first` أو `True`، فسيتم رفع خطأ بدلاً من إرجاع الرموز المتجاوزة.
return_special_tokens_mask (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم إرجاع معلومات قناع الرموز الخاصة أم لا.
return_offsets_mapping (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان يجب إرجاع `(char_start, char_end)` لكل رمز. هذه الخاصية متاحة فقط في مُرمّزيات fast التي ترث من [PreTrainedTokenizerFast](/docs/transformers/main/ar/main_classes/tokenizer#transformers.TokenizersBackend)، وإذا كنت تستخدم مُرمّزي Python، فسيُطلق هذا الدالة `NotImplementedError`.
return_length (`bool`، *اختياري*، الافتراضي `False`) : ما إذا كان يجب إرجاع أطوال المدخلات المُرمّزة أم لا.
verbose (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب طباعة مزيد من المعلومات والتنبيهات أم لا.
return_tensors (`Union[str, ~utils.generic.TensorType]`، *اختياري*) : إذا تم تعيينه، فسيُرجع تينسورات (Tensors) لإطار عمل معين. القيم المقبولة هي: - `'pt'`: يُرجع كائنات `torch.Tensor` من PyTorch. - `'np'`: يُرجع كائنات `np.ndarray` من NumPy.
**يعيد:** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`، *اختياري*) -- قاموس من القوائم/المصفوفات/الموترات الذي يُعاد عن طريق طرق `__call__`/`encode_plus`/`batch_encode_plus` ('input_ids'، 'attention_mask'، إلخ).
- **encoding** (`tokenizers.Encoding` أو `Sequence[tokenizers.Encoding]`، *اختياري*) -- إذا كان مُجزِّئ الرموز مُجزِّئًا سريعًا يُخرج معلومات إضافية مثل التحويل من فضاء الكلمات/الأحرف إلى فضاء الرموز، فإنّ كائن `tokenizers.Encoding` أو قائمة من الكائنات (للدفّات) تحتفظ بهذه المعلومات.
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
- **prepend_batch_axis** (`bool`, *اختياري*، القيمة الافتراضية `False`) -- ما إذا كان يجب إضافة محور الدفعة عند التحويل إلى المصفوفات (انظر `tensor_type` أعلاه). يُرجى ملاحظة أن لهذا المعامل تأثير إذا تم تعيين المعامل `tensor_type`، *وإلا فلا يكون له أي تأثير*.
- **n_sequences** (`int`, *اختياري*) -- عدد تسلسلات الإدخال التي يمثلها كل ترميز (`None` للمجهول، و`1` لتسلسل واحد، و`2` لزوج من التسلسلات).
## MarkupLMModel[[transformers.MarkupLMModel]]
#### transformers.MarkupLMModel[[transformers.MarkupLMModel]]
```python
transformers.MarkupLMModel(config: MarkupLMConfig, add_pooling_layer = True)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L497)
**المعاملات:**
config ([MarkupLMConfig](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
add_pooling_layer (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إضافة طبقة تجميع
نموذج Markuplm الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.MarkupLMModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, xpath_tags_seq: typing.Optional[torch.LongTensor] = None, xpath_subs_seq: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L521)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/main/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor` من الشكل `(batch_size, sequence_length, config.max_depth)`، *اختياري*) : معرّفات الوسوم لكل رمز في تسلسل الإدخال، مع ملء الفراغات حتى config.max_depth.
xpath_subs_seq (`torch.LongTensor` من الشكل `(batch_size, sequence_length, config.max_depth)`، *اختياري*) : معرّفات الفهارس الفرعية لكل رمز في تسلسل الإدخال، مع ملء الفراغات حتى config.max_depth.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار الفهارس من `[0, 1]`: - 0 يقابل رمز *الجملة أ*، - 1 يقابل رمز *الجملة ب*. [ما هي معرّفات أنواع الرموز؟](../glossary#token-type-ids)
position_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
**يعيد:** [BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([MarkupLMConfig](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMConfig)) والمدخلات.
تتجاوز طريقة [MarkupLMModel](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMModel) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from transformers import AutoProcessor, MarkupLMModel
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> model = MarkupLMModel.from_pretrained("microsoft/markuplm-base")
>>> html_string = " Page Title "
>>> encoding = processor(html_string, return_tensors="pt")
>>> outputs = model(**encoding)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 4, 768]
```
## MarkupLMForSequenceClassification[[transformers.MarkupLMForSequenceClassification]]
#### transformers.MarkupLMForSequenceClassification[[transformers.MarkupLMForSequenceClassification]]
```python
transformers.MarkupLMForSequenceClassification(config: MarkupLMConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L802)
**المعاملات:**
config ([MarkupLMConfig](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج MarkupLM وهو نموذج تحويلي (Transformer) مضاف إليه رأس تصنيف/انحدار تسلسلي (Sequence Classification/Regression Head) في الأعلى (طبقة خطية فوق المخرجات المجمعة) على سبيل المثال لمهام GLUE.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.MarkupLMForSequenceClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L819)
**المعاملات:**
input_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/main/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor` من الشكل `(batch_size, sequence_length, config.max_depth)`، *اختياري*) : معرّفات الوسوم لكل رمز في تسلسل الإدخال، مع ملء الفراغات حتى config.max_depth.
xpath_subs_seq (`torch.LongTensor` من الشكل `(batch_size, sequence_length, config.max_depth)`، *اختياري*) : معرّفات الفهارس الفرعية لكل رمز في تسلسل الإدخال، مع ملء الفراغات حتى config.max_depth.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
token_type_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار الفهارس من `[0, 1]`: - 0 يقابل رمز *الجملة أ*، - 1 يقابل رمز *الجملة ب*. [ما هي معرّفات أنواع الرموز؟](../glossary#token-type-ids)
position_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
labels (`torch.LongTensor` من الشكل `(batch_size,)`، *اختياري*) : تسميات لحساب خسارة تصنيف/انحدار التسلسل. يجب أن تكون الفهارس ضمن `[0, ..., config.num_labels - 1]`. إذا كان `config.num_labels == 1` يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كان `config.num_labels > 1` يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة).
**يعيد:** [SequenceClassifierOutput](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) أو `tuple(torch.Tensor)`
[SequenceClassifierOutput](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) أو مجموعة مرتبة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([MarkupLMConfig](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMConfig)) والمدخلات.
تُعيد طريقة [MarkupLMForSequenceClassification](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMForSequenceClassification) الخاصة بالتقديم (forward) تعريف الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`, *اختياري*، يُعاد عند تقديم `labels`) -- خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).
- **logits** (`torch.Tensor` من الشكل `(batch_size, config.num_labels)`) -- درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from transformers import AutoProcessor, AutoModelForSequenceClassification
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> model = AutoModelForSequenceClassification.from_pretrained("microsoft/markuplm-base", num_labels=7)
>>> html_string = " Page Title "
>>> encoding = processor(html_string, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> loss = outputs.loss
>>> logits = outputs.logits
```
## MarkupLMForTokenClassification[[transformers.MarkupLMForTokenClassification]]
#### transformers.MarkupLMForTokenClassification[[transformers.MarkupLMForTokenClassification]]
```python
transformers.MarkupLMForTokenClassification(config: MarkupLMConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L709)
**المعاملات:**
config ([MarkupLMConfig](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج MarkupLM مع رأس `token_classification` في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.MarkupLMForTokenClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L725)
**المعاملات:**
input_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/main/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor` من الشكل `(batch_size, sequence_length, config.max_depth)`، *اختياري*) : معرّفات الوسوم لكل رمز في تسلسل الإدخال، مع ملء الفراغات حتى config.max_depth.
xpath_subs_seq (`torch.LongTensor` من الشكل `(batch_size, sequence_length, config.max_depth)`، *اختياري*) : معرّفات الفهارس الفرعية لكل رمز في تسلسل الإدخال، مع ملء الفراغات حتى config.max_depth.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
token_type_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار الفهارس من `[0, 1]`: - 0 يقابل رمز *الجملة أ*، - 1 يقابل رمز *الجملة ب*. [ما هي معرّفات أنواع الرموز؟](../glossary#token-type-ids)
position_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
labels (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : تسميات لحساب خسارة تصنيف الرموز. يجب أن تكون الفهارس ضمن `[0, ..., config.num_labels - 1]`.
**يعيد:** [MaskedLMOutput](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) أو `tuple(torch.Tensor)`
[MaskedLMOutput](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([MarkupLMConfig](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMConfig)) والمدخلات.
تتجاوز طريقة [MarkupLMForTokenClassification](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMForTokenClassification) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`، *اختياري*، يُعاد عند توفير `labels`) -- خسارة نمذجة اللغة المقنّعة (MLM).
- **logits** (`torch.Tensor` من الشكل `(batch_size, sequence_length, config.vocab_size)`) -- درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from transformers import AutoProcessor, AutoModelForTokenClassification
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> processor.parse_html = False
>>> model = AutoModelForTokenClassification.from_pretrained("microsoft/markuplm-base", num_labels=7)
>>> nodes = ["hello", "world"]
>>> xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span"]
>>> node_labels = [1, 2]
>>> encoding = processor(nodes=nodes, xpaths=xpaths, node_labels=node_labels, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> loss = outputs.loss
>>> logits = outputs.logits
```
## MarkupLMForQuestionAnswering[[transformers.MarkupLMForQuestionAnswering]]
#### transformers.MarkupLMForQuestionAnswering[[transformers.MarkupLMForQuestionAnswering]]
```python
transformers.MarkupLMForQuestionAnswering(config: MarkupLMConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L603)
**المعاملات:**
config ([MarkupLMConfig](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج Markuplm transformer مع رأس تصنيف نطاقات (span classification head) في الأعلى لمهام الإجابة الاستخراجية على الأسئلة مثل SQuAD (طبقة خطية فوق مخرجات الحالات المخفية لحساب `span start logits` و`span end logits`).
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.MarkupLMForQuestionAnswering.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, start_positions: typing.Optional[torch.Tensor] = None, end_positions: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L615)
**المعاملات:**
input_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/main/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor` من الشكل `(batch_size, sequence_length, config.max_depth)`، *اختياري*) : معرّفات الوسوم لكل رمز في تسلسل الإدخال، مع ملء الفراغات حتى config.max_depth.
xpath_subs_seq (`torch.LongTensor` من الشكل `(batch_size, sequence_length, config.max_depth)`، *اختياري*) : معرّفات الفهارس الفرعية لكل رمز في تسلسل الإدخال، مع ملء الفراغات حتى config.max_depth.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
token_type_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار الفهارس من `[0, 1]`: - 0 يقابل رمز *الجملة أ*، - 1 يقابل رمز *الجملة ب*. [ما هي معرّفات أنواع الرموز؟](../glossary#token-type-ids)
position_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
start_positions (`torch.Tensor` بأبعاد `(batch_size,)`، *اختياري*) : تسميات لموضع (فهرس) بداية النطاق المُسمّى لحساب خسارة تصنيف الرموز. تُثبَّت المواضع على طول التسلسل (`sequence_length`). المواضع خارج التسلسل لا تُؤخذ في الاعتبار عند حساب الخسارة.
end_positions (`torch.Tensor` بأبعاد `(batch_size,)`، *اختياري*) : تسميات لموضع (فهرس) نهاية المقطع المُسمّى لحساب خسارة تصنيف الرموز. تُثبَّت المواضع على طول التسلسل (`sequence_length`). المواضع خارج التسلسل لا تُؤخذ في الاعتبار عند حساب الخسارة.
**يعيد:** [QuestionAnsweringModelOutput](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) أو `tuple(torch.Tensor)`
[QuestionAnsweringModelOutput](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) أو مجموعة مرتبة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([MarkupLMConfig](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMConfig)) والمدخلات.
تتجاوز طريقة [MarkupLMForQuestionAnswering](/docs/transformers/main/ar/model_doc/markuplm#transformers.MarkupLMForQuestionAnswering) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` بشكل `(1,)`، *اختياري*، يُعاد عند توفير `labels`) -- خسارة استخراج النطاق الكلي هي مجموع دالة Cross-Entropy لموقعي البداية والنهاية.
- **start_logits** (`torch.Tensor` من الشكل `(batch_size, sequence_length)`) -- درجات بداية المقطع (قبل SoftMax).
- **end_logits** (`torch.Tensor` بأبعاد `(batch_size, sequence_length)`) -- درجات نهاية المقطع (قبل SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from transformers import AutoProcessor, MarkupLMForQuestionAnswering
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base-finetuned-websrc")
>>> model = MarkupLMForQuestionAnswering.from_pretrained("microsoft/markuplm-base-finetuned-websrc")
>>> html_string = " My name is Niels "
>>> question = "What's his name?"
>>> encoding = processor(html_string, questions=question, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> answer_start_index = outputs.start_logits.argmax()
>>> answer_end_index = outputs.end_logits.argmax()
>>> predict_answer_tokens = encoding.input_ids[0, answer_start_index : answer_end_index + 1]
>>> processor.decode(predict_answer_tokens).strip()
'Niels'
```