# OWL-ViT
## نظرة عامة
قُدِّم نموذج OWL-ViT (اختصار لـ Vision Transformer for Open-World Localization) في ورقة [Simple Open-Vocabulary Object Detection with Vision Transformers](https://huggingface.co/papers/2205.06230) التي كتبها Matthias Minderer وAlexey Gritsenko وAustin Stone وMaxim Neumann وDirk Weissenborn وAlexey Dosovitskiy وAravindh Mahendran وAnurag Arnab وMostafa Dehghani وZhuoran Shen وXiao Wang وXiaohua Zhai وThomas Kipf وNeil Houlsby. OWL-ViT هو شبكة كشف كائنات ذات مفردات مفتوحة، تم تدريبها على مجموعة متنوعة من أزواج (صورة، نص). يمكن استخدامه للاستعلام عن صورة باستخدام استعلام نصي واحد أو عدة استعلامات نصية للبحث عن الكائنات المستهدفة الموصوفة في النص وكشفها.
المستخلص من الورقة البحثية هو كالتالي:
*أدى الجمع بين البنى البسيطة والتدريب المسبق على نطاق واسع إلى تحسينات هائلة في تصنيف الصور. أما في كشف الكائنات، فإن أساليب التدريب المسبق والتوسع أقل رسوخاً، لا سيما في الإعدادات ذات الذيل الطويل والمفردات المفتوحة، حيث تكون بيانات التدريب نادرة نسبياً. في هذه الورقة، نقترح وصفة قوية لنقل نماذج الصورة-النص إلى كشف الكائنات بمفردات مفتوحة. نستخدم بنية Vision Transformer قياسية مع تعديلات طفيفة، والتدريب المسبق التبايني للصورة-النص، والتدريب الدقيق للكشف من الطرف إلى الطرف. تُظهر تحليلاتنا لخصائص التوسع في هذا الإعداد أن زيادة التدريب المسبق على مستوى الصورة وحجم النموذج تُحقق تحسينات متسقة في مهمة الكشف اللاحقة. نوفر استراتيجيات التكيف والتنظيمات اللازمة لتحقيق أداء قوي جداً في كشف الكائنات الشرطي بالنص دون تدريب مسبق (zero-shot) وكشف الكائنات الشرطي بالصورة مع مثال واحد (one-shot). الكود والنماذج متاحة على GitHub.*
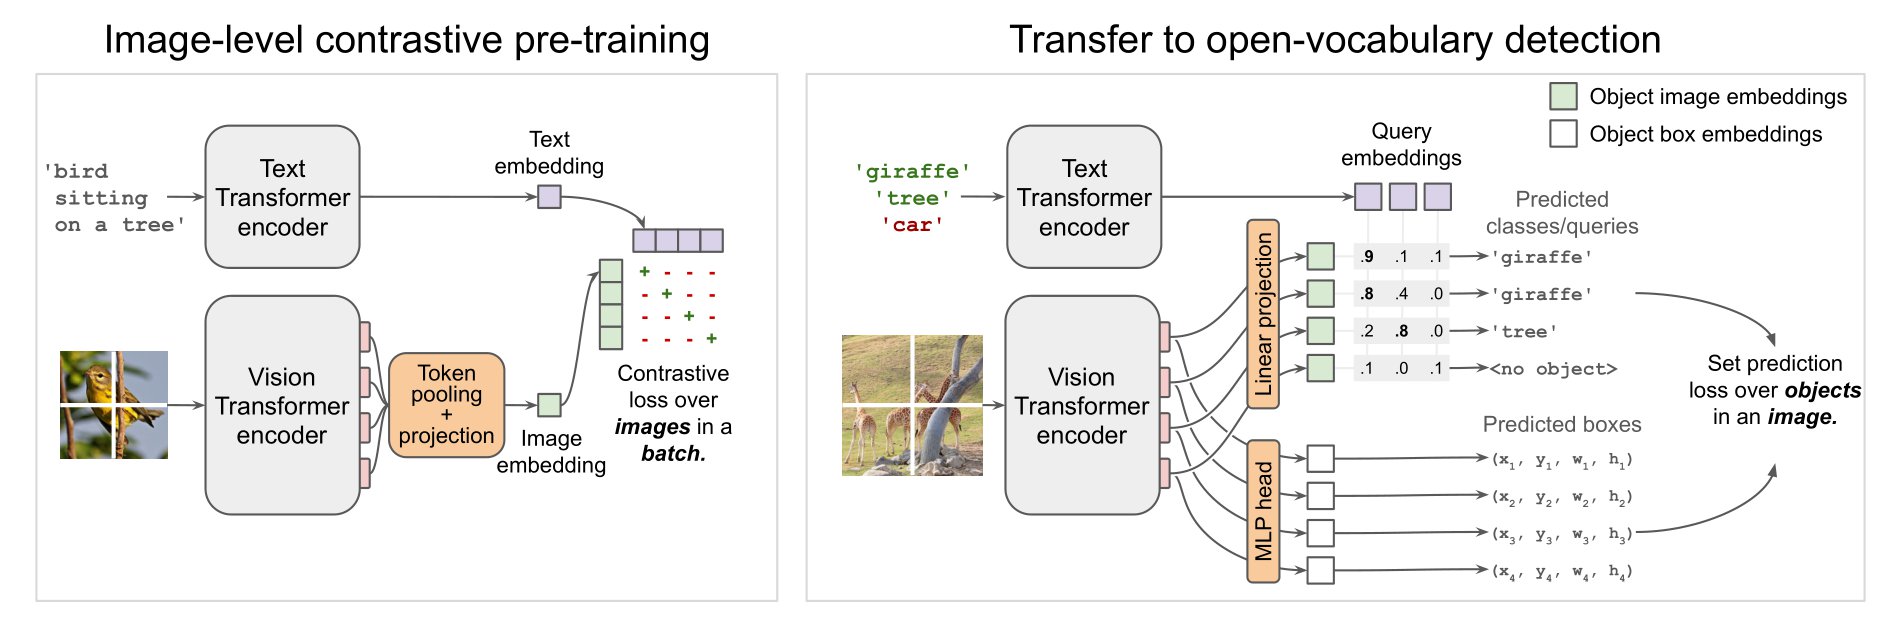 بنية OWL-ViT. مأخوذة من الورقة الأصلية.
تمت مساهمة هذا النموذج من قِبل [adirik](https://huggingface.co/adirik). يمكن العثور على الكود الأصلي [هنا](https://github.com/google-research/scenic/tree/main/scenic/projects/owl_vit).
## نصائح للاستخدام
OWL-ViT هو نموذج للكشف عن الأشياء مشروط بالنص دون تدريب مسبق (zero-shot). يستخدم OWL-ViT [CLIP](clip) كهيكل أساسي متعدد الوسائط، مع محول (Transformer) يشبه ViT لاستخراج الميزات البصرية، ونموذج لغوي سببي (causal language model) لاستخراج ميزات النص. لاستخدام CLIP في الكشف، يزيل OWL-ViT طبقة تجميع الرمز النهائي (final token pooling layer) من النموذج البصري، ويربط رأس تصنيف ورأس صندوق (box head) خفيف الوزن بكل رمز مخرجات المحوّل. يتم تمكين التصنيف بمفردات مفتوحة (open-vocabulary) عن طريق استبدال أوزان طبقة التصنيف الثابتة بتضمينات أسماء الفئات (class-name embeddings) المستخرجة من النموذج النصي. يقوم المؤلفون أولاً بتدريب CLIP من الصفر، ثم ضبطه الدقيق (fine-tune) من البداية إلى النهاية مع رؤوس التصنيف والصندوق على مجموعات بيانات الكشف القياسية باستخدام خسارة المطابقة الثنائية (bipartite matching loss). يمكن استخدام استعلام نصي واحد أو عدة استعلامات لكل صورة لأداء الكشف عن الأشياء المشروط بالنص دون تدريب مسبق.
يمكن استخدام [OwlViTImageProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTImageProcessor) لتغيير حجم (أو إعادة مقياس) الصور وتطبيعها للنموذج، بينما يُستخدم [CLIPTokenizer](/docs/transformers/main/ar/model_doc/clip#transformers.CLIPTokenizer) لتشفير النص. يجمع [OwlViTProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTProcessor) بين [OwlViTImageProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTImageProcessor) و[CLIPTokenizer](/docs/transformers/main/ar/model_doc/clip#transformers.CLIPTokenizer) في كائن واحد لتشفير النص وتجهيز الصور معاً. يُظهر المثال التالي كيفية تنفيذ كشف الكائنات باستخدام [OwlViTProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTProcessor) و[OwlViTForObjectDetection](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTForObjectDetection).
```python
import requests
from PIL import Image
import torch
from transformers import OwlViTProcessor, OwlViTForObjectDetection
processor = OwlViTProcessor.from_pretrained("google/owlvit-base-patch32")
model = OwlViTForObjectDetection.from_pretrained("google/owlvit-base-patch32", device_map="auto")
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
text_labels = [["a photo of a cat", "a photo of a dog"]]
inputs = processor(text=text_labels, images=image, return_tensors="pt").to(model.device)
outputs = model(**inputs)
# Target image sizes (height, width) to rescale box predictions [batch_size, 2]
target_sizes = torch.tensor([(image.height, image.width)])
# Convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
results = processor.post_process_grounded_object_detection(
outputs=outputs, target_sizes=target_sizes, threshold=0.1, text_labels=text_labels
)
# Retrieve predictions for the first image for the corresponding text queries
result = results[0]
boxes, scores, text_labels = result["boxes"], result["scores"], result["text_labels"]
for box, score, text_label in zip(boxes, scores, text_labels):
box = [round(i, 2) for i in box.tolist()]
print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a photo of a cat with confidence 0.707 at location [324.97, 20.44, 640.58, 373.29]
Detected a photo of a cat with confidence 0.717 at location [1.46, 55.26, 315.55, 472.17]
```
## الموارد
يمكن العثور على دفتر ملاحظات توضيحي لاستخدام OWL-ViT للكشف عن الأشياء بطريقة صفرية وواحدة (بإرشاد الصور) [هنا](https://github.com/huggingface/notebooks/blob/main/examples/zeroshot_object_detection_with_owlvit.ipynb).
## OwlViTConfig[[transformers.OwlViTConfig]]
#### transformers.OwlViTConfig[[transformers.OwlViTConfig]]
```python
transformers.OwlViTConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, return_dict: bool = True, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, projection_dim: int = 512, logit_scale_init_value: float = 2.6592, initializer_factor: float = 1.0)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/configuration_owlvit.py#L101)
**المعاملات:**
return_dict (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إرجاع `ModelOutput` (dataclass) بدلاً من tuple عادي.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`، *اختياري*) : كائن الإعداد أو قاموس العمود الفقري النصي.
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`، *اختياري*) : كائن الإعداد أو قاموس العمود الفقري البصري.
projection_dim (`int`، *اختياري*، القيمة الافتراضية `512`) : بُعد طبقات الإسقاط للنص والرؤية.
logit_scale_init_value (`float`، *اختياري*، القيمة الافتراضية `2.6592`) : القيمة الأولية لمعامل *logit_scale*.
initializer_factor (`float`، *اختياري*، القيمة الافتراضية `1.0`) : معامل لتجميع جميع مصفوفات الأوزان (يجب إبقاؤه عند 1، ويُستخدم داخليًا لاختبارات التهيئة).
هذه فئة الإعدادات المخزنة لإعدادات OwlViTModel. تُستخدم لاستحداث نموذج Owlvit وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [google/owlvit-base-patch16](https://huggingface.co/google/owlvit-base-patch16)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
## OwlViTTextConfig[[transformers.OwlViTTextConfig]]
#### transformers.OwlViTTextConfig[[transformers.OwlViTTextConfig]]
```python
transformers.OwlViTTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 49408, hidden_size: int = 512, intermediate_size: int = 2048, num_hidden_layers: int = 12, num_attention_heads: int = 8, max_position_embeddings: int = 16, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0, pad_token_id: int | None = 0, bos_token_id: int | None = 49406, eos_token_id: int | list[int] | None = 49407)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/configuration_owlvit.py#L27)
**المعاملات:**
vocab_size (`int`، *اختياري*، القيمة الافتراضية `49408`) : حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطة `input_ids`.
hidden_size (`int`، *اختياري*، القيمة الافتراضية `512`) : بُعد التمثيلات المخفية.
intermediate_size (`int`، *اختياري*، القيمة الافتراضية `2048`) : بُعد تمثيلات MLP.
num_hidden_layers (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد الطبقات المخفية في مُفكِّك Transformer.
num_attention_heads (`int`، *اختياري*، القيمة الافتراضية `8`) : عدد رؤوس الانتباه في كل طبقة انتباه داخل مُفكِّك Transformer.
max_position_embeddings (`int`، *اختياري*، القيمة الافتراضية `16`) : الحد الأقصى لطول التسلسل الذي قد يُستخدم به هذا النموذج على الإطلاق.
hidden_act (`str`، *اختياري*، القيمة الافتراضية `quick_gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
layer_norm_eps (`float`، *اختياري*، القيمة الافتراضية `1e-05`) : قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
attention_dropout (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.0`) : نسبة الإسقاط (dropout) لاحتمالات الانتباه.
initializer_range (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
initializer_factor (`float`، *اختياري*، القيمة الافتراضية `1.0`) : معامل لتجميع جميع مصفوفات الأوزان (يجب إبقاؤه عند 1، ويُستخدم داخليًا لاختبارات التهيئة).
pad_token_id (`int`، *اختياري*، القيمة الافتراضية `0`) : معرّف الرمز المستخدم للتعبئة في المفردات.
bos_token_id (`int`، *اختياري*، القيمة الافتراضية `49406`) : معرّف الرمز المستخدم لبدء البث في المفردات.
eos_token_id (`Union[int, list[int]]`، *اختياري*، القيمة الافتراضية `49407`) : معرّف الرمز المستخدم لنهاية البث في المفردات.
هذه فئة الإعدادات المخزنة لإعدادات OwlViTModel. تُستخدم لاستحداث نموذج Owlvit وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [google/owlvit-base-patch16](https://huggingface.co/google/owlvit-base-patch16)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
مثال:
```python
>>> from transformers import OwlViTTextConfig, OwlViTTextModel
>>> # Initializing a OwlViTTextModel with google/owlvit-base-patch32 style configuration
>>> configuration = OwlViTTextConfig()
>>> # Initializing a OwlViTTextConfig from the google/owlvit-base-patch32 style configuration
>>> model = OwlViTTextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## OwlViTVisionConfig[[transformers.OwlViTVisionConfig]]
#### transformers.OwlViTVisionConfig[[transformers.OwlViTVisionConfig]]
```python
transformers.OwlViTVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 768, patch_size: int | list[int] | tuple[int, int] = 32, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/configuration_owlvit.py#L65)
**المعاملات:**
hidden_size (`int`، *اختياري*، القيمة الافتراضية `768`) : بُعد التمثيلات المخفية.
intermediate_size (`int`، *اختياري*، القيمة الافتراضية `3072`) : بُعد تمثيلات MLP.
num_hidden_layers (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد الطبقات المخفية في مُفكِّك Transformer.
num_attention_heads (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد رؤوس الانتباه في كل طبقة انتباه داخل مُفكِّك Transformer.
num_channels (`int`، *اختياري*، القيمة الافتراضية `3`) : عدد قنوات الإدخال.
image_size (`Union[int, list[int], tuple[int, int]]`، *اختياري*، القيمة الافتراضية `768`) : حجم (دقة) كل صورة.
patch_size (`Union[int, list[int], tuple[int, int]]`، *اختياري*، القيمة الافتراضية `32`) : حجم (دقة) كل رقعة.
hidden_act (`str`، *اختياري*، القيمة الافتراضية `quick_gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
layer_norm_eps (`float`، *اختياري*، القيمة الافتراضية `1e-05`) : قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
attention_dropout (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.0`) : نسبة الإسقاط (dropout) لاحتمالات الانتباه.
initializer_range (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
initializer_factor (`float`، *اختياري*، القيمة الافتراضية `1.0`) : معامل لتجميع جميع مصفوفات الأوزان (يجب إبقاؤه عند 1، ويُستخدم داخليًا لاختبارات التهيئة).
هذه فئة الإعدادات المخزنة لإعدادات OwlViTModel. تُستخدم لاستحداث نموذج Owlvit وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [google/owlvit-base-patch16](https://huggingface.co/google/owlvit-base-patch16)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
مثال:
```python
>>> from transformers import OwlViTVisionConfig, OwlViTVisionModel
>>> # Initializing a OwlViTVisionModel with google/owlvit-base-patch32 style configuration
>>> configuration = OwlViTVisionConfig()
>>> # Initializing a OwlViTVisionModel model from the google/owlvit-base-patch32 style configuration
>>> model = OwlViTVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## OwlViTImageProcessor[[transformers.OwlViTImageProcessor]]
#### transformers.OwlViTImageProcessor[[transformers.OwlViTImageProcessor]]
```python
transformers.OwlViTImageProcessor(**kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/image_processing_owlvit.py#L102)
**المعاملات:**
do_convert_rgb (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*، الافتراضي هو `True`) : ما إذا كان سيتم تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*، القيمة الافتراضية `{'height' : 768, 'width': 768}`): يصف الأبعاد القصوى للإدخال إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم من نوع عدد صحيح.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*، القيمة الافتراضية `{'height' : 768, 'width': 768}`): حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`، *kwargs*، القيمة الافتراضية `3`) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كانت قيمة `do_resize` هي `True`.
do_rescale (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*، القيمة الافتراضية هي `0.00392156862745098`) : عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطاً على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *اختياري*، القيمة الافتراضية هي `[0.48145466, 0.4578275, 0.40821073]`) : متوسط الصورة المستخدم للتطبيع. لا يكون له تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *اختياري*، القيمة الافتراضية هي `[0.26862954, 0.26130258, 0.27577711]`) : انحراف معيار الصورة المستخدم للتطبيع. لا يكون له تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
ينشئ معالج صور OwlViTImageProcessor.
#### preprocess[[transformers.OwlViTImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : الصورة المراد معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`، *اختياري*) : علم مخصص للمطورين لإدخال مدخلات إضافية تشبه الصور والتي سيتم معالجتها مسبقًا أيضًا. استخدم هذا الخيار فقط إذا لم يعمل تمرير المدخلات كحجة اسمية (kwarg). على سبيل المثال، يُعد `preprocess(images, masks=masks)` الخيار المفضل، لكنه يؤدي إلى مشاكل في أولوية الحجة لبعض النماذج. في تلك الحالات، يمكن استخدام `preprocess(images, image_like_inputs={"masks": masks})` بدلاً منه.
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم عددًا صحيحًا.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كان `do_resize` مضبوطاً على `True`.
do_rescale (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*) : معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطًا على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
معالجة صورة أو دفعة من الصور مسبقًا.
## OwlViTImageProcessorPil[[transformers.OwlViTImageProcessorPil]]
#### transformers.OwlViTImageProcessorPil[[transformers.OwlViTImageProcessorPil]]
```python
transformers.OwlViTImageProcessorPil(**kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/image_processing_pil_owlvit.py#L108)
**المعاملات:**
do_convert_rgb (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*، الافتراضي هو `True`) : ما إذا كان سيتم تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*، القيمة الافتراضية `{'height' : 768, 'width': 768}`): يصف الأبعاد القصوى للإدخال إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم من نوع عدد صحيح.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*، القيمة الافتراضية `{'height' : 768, 'width': 768}`): حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`، *kwargs*، القيمة الافتراضية `3`) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كانت قيمة `do_resize` هي `True`.
do_rescale (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*، القيمة الافتراضية هي `0.00392156862745098`) : عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطاً على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *اختياري*، القيمة الافتراضية هي `[0.48145466, 0.4578275, 0.40821073]`) : متوسط الصورة المستخدم للتطبيع. لا يكون له تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *اختياري*، القيمة الافتراضية هي `[0.26862954, 0.26130258, 0.27577711]`) : انحراف معيار الصورة المستخدم للتطبيع. لا يكون له تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
ينشئ معالج صور OwlViTImageProcessor.
#### preprocess[[transformers.OwlViTImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : الصورة المراد معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`، *اختياري*) : علم مخصص للمطورين لإدخال مدخلات إضافية تشبه الصور والتي سيتم معالجتها مسبقًا أيضًا. استخدم هذا الخيار فقط إذا لم يعمل تمرير المدخلات كحجة اسمية (kwarg). على سبيل المثال، يُعد `preprocess(images, masks=masks)` الخيار المفضل، لكنه يؤدي إلى مشاكل في أولوية الحجة لبعض النماذج. في تلك الحالات، يمكن استخدام `preprocess(images, image_like_inputs={"masks": masks})` بدلاً منه.
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم عددًا صحيحًا.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كان `do_resize` مضبوطاً على `True`.
do_rescale (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*) : معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطًا على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
معالجة صورة أو دفعة من الصور مسبقًا.
#### post_process_object_detection[[transformers.OwlViTImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs: OwlViTObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/image_processing_pil_owlvit.py#L132)
**المعاملات:**
outputs (`OwlViTObjectDetectionOutput`) : المخرجات الخام للنموذج.
threshold (`float`، *اختياري*، القيمة الافتراضية 0.1) : عتبة التقييم للاحتفاظ بتوقعات كشف الكائنات.
target_sizes (`torch.Tensor` أو `list[tuple[int, int]]`، *اختياري*) : متجه (Tensor) بأبعاد `(batch_size, 2)` أو قائمة من الأزواج (`tuple[int, int]`) تحتوي على الحجم المستهدف `(height, width)` لكل صورة في الدفعة. إذا لم يتم تعيينه، فلن يتم تغيير حجم التنبؤات.
**يعيد:** `list[Dict]`
قائمة من القواميس، حيث يحتوي كل قاموس على المفاتيح التالية:
- …
- "labels": فهارس الفئات التي يتنبأ بها النموذج في الصورة.
- "boxes": صناديق الحدود للصور بصيغة (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
يحوّل المخرجات الخام لـ [OwlViTForObjectDetection](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTForObjectDetection) إلى صناديق حدود نهائية بصيغة (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
#### post_process_image_guided_detection[[transformers.OwlViTImageProcessorPil.post_process_image_guided_detection]]
```python
post_process_image_guided_detection(outputs, threshold = 0.0, nms_threshold = 0.3, target_sizes = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/image_processing_pil_owlvit.py#L188)
**المعاملات:**
outputs (`OwlViTImageGuidedObjectDetectionOutput`) : المخرجات الخام للنموذج.
threshold (`float`، *اختياري*، القيمة الافتراضية 0.0) : الحد الأدنى لدرجة الثقة المستخدم لتصفية الصناديق المتوقعة.
nms_threshold (`float`، *اختياري*، القيمة الافتراضية 0.3) : عتبة IoU لتطبيق كبح أقصى غير (non-maximum suppression) على الصناديق المتداخلة.
target_sizes (`torch.Tensor`، *اختياري*) : متجه (Tensor) من الشكل (batch_size, 2) حيث يمثل كل إدخال (الارتفاع، العرض) للصورة المقابلة في الدفعة. إذا تم تعيينه، تُعاد ملاءة الصناديق المحيطة المعيارية المتوقعة إلى الأحجام المستهدفة. إذا تُركت القيمة None، فلن يتم إلغاء تقييس التوقعات.
**يعيد:** `list[Dict]`
قائمة من القواميس، يحتوي كل قاموس على الدرجات والتسميات والصناديق لصورة في الدفعة كما تتنبأ بها النموذج. يتم تعيين جميع التسميات إلى None لأن `OwlViTForObjectDetection.image_guided_detection` يؤدي كشف كائنات أحادي الخطوة.
يحوّل مخرجات [OwlViTForObjectDetection.image_guided_detection()](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTForObjectDetection.image_guided_detection) إلى التنسيق الذي تتوقعه واجهة COCO البرمجية.
## OwlViTProcessor[[transformers.OwlViTProcessor]]
#### transformers.OwlViTProcessor[[transformers.OwlViTProcessor]]
```python
transformers.OwlViTProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/processing_owlvit.py#L62)
**المعاملات:**
image_processor (`OwlViTImageProcessor`) : مُعالج الصور هو مدخل مطلوب.
tokenizer (`CLIPTokenizer`) : مُجزِّئ الرموز هو مدخل مطلوب.
ينشئ OwlViTProcessor الذي يجمع معالج الصور ومعالج الرموز في معالج واحد.
يوفر [OwlViTProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTProcessor) جميع وظائف [OwlViTImageProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTImageProcessor) و[CLIPTokenizer](/docs/transformers/main/ar/model_doc/clip#transformers.CLIPTokenizer). راجع [~OwlViTImageProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTImageProcessor) و[~CLIPTokenizer](/docs/transformers/main/ar/model_doc/clip#transformers.CLIPTokenizer) لمزيد من المعلومات.
#### __call__[[transformers.OwlViTProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/processing_owlvit.py#L66)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *اختياري*) : الصورة التي سيتم معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`، *اختياري*) : التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُجزَّأ مسبقًا). إذا مررت مدخلات مُجزَّأة مسبقًا، فاضبط `is_split_into_words=True` لتجنب الغموض مع المدخلات المُجمَّعة في دفعات.
query_images (`ImageInput`، *kwargs*، *اختياري*) : صور الاستعلام المستخدمة للكشف عن الكائنات الموجَّهة بالصور. عند تقديمها، تعمل هذه الصور كاستعلامات بصرية للعثور على كائنات مشابهة في الصور الرئيسية `images`. تتجاوز صور الاستعلام أيّ موجهات نصية، وينفّذ النموذج مطابقةً من صورة إلى صورة بدلاً من مطابقة من نص إلى صورة.
return_tensors (`str` أو [TensorType](/docs/transformers/main/ar/internal/file_utils#transformers.TensorType)، *اختياري*) : إذا تم تعيينه، فسيُرجع تينسورات من إطار عمل محدد. القيم المقبولة هي: - `'pt'`: يُرجع كائنات `torch.Tensor` من PyTorch. - `'np'`: يُرجع كائنات `np.ndarray` من NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/ar/main_classes/processors#transformers.ProcessingKwargs)، *اختياري*) : خيارات معالجة إضافية لكل نمط (نص، صور، مقاطع فيديو، صوت). تُدرج المعلمات الخاصة بالنموذج أعلاه؛ راجع فئة TypedDict للحصول على القائمة الكاملة للحجج المدعومة.
**يعيد:** [BatchFeature](/docs/transformers/main/ar/main_classes/feature_extractor#transformers.BatchFeature)
[BatchFeature](/docs/transformers/main/ar/main_classes/feature_extractor#transformers.BatchFeature) يحتوي على الحقول التالية:
- **input_ids** -- قائمة معرّفات الرموز التي تُغذّى بها النموذج. تُعاد عندما لا تكون `text` قيمة `None`.
- **attention_mask** -- قائمة بالفهارس تحدد الرموز التي يجب أن يوليها النموذج انتباهه (عندما يكون `return_attention_mask=True` أو إذا كان *"attention_mask"* ضمن `self.model_input_names` وإذا لم يكن `text` مساوياً لـ `None`).
- **pixel_values** -- قيم البكسلات التي تُمرَّر إلى النموذج. تُعاد عندما لا تكون `images` قيمة `None`.
- **query_pixel_values** -- قيم البكسلات لصور الاستعلام التي تُمرَّر إلى النموذج. تُعاد عندما لا تكون `query_images` قيمة `None`.
#### post_process_grounded_object_detection[[transformers.OwlViTProcessor.post_process_grounded_object_detection]]
```python
post_process_grounded_object_detection(outputs: OwlViTObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None, text_labels: list[list[str]] | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/processing_owlvit.py#L149)
**المعاملات:**
outputs (`OwlViTObjectDetectionOutput`) : المخرجات الخام للنموذج.
threshold (`float`، *اختياري*، القيمة الافتراضية 0.1) : عتبة التقييم للاحتفاظ بتوقعات كشف الكائنات.
target_sizes (`torch.Tensor` أو `list[tuple[int, int]]`، *اختياري*) : متجه (Tensor) بأبعاد `(batch_size, 2)` أو قائمة من الأزواج (`tuple[int, int]`) تحتوي على الحجم المستهدف `(height, width)` لكل صورة في الدفعة. إذا لم يتم تعيينه، فلن يتم تغيير حجم التنبؤات.
text_labels (`list[list[str]]`، *اختياري*) : قائمة قوائم من تسميات النص لكل صورة في الدفعة. إذا لم يتم ضبطه، فسيتم ضبط "text_labels" في المخرجات على `None`.
**يعيد:** `list[Dict]`
قائمة من القواميس، حيث يحتوي كل قاموس على المفاتيح التالية:
- …
- "labels": فهارس الفئات التي يتنبأ بها النموذج في الصورة.
- "boxes": صناديق الحدود للصور بصيغة (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
- "نص_التسميات": التسميات النصية لكل صندوق محدد متوقع على الصورة.
يحوّل المخرجات الخام لـ [OwlViTForObjectDetection](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTForObjectDetection) إلى صناديق حدود نهائية بصيغة (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
#### post_process_image_guided_detection[[transformers.OwlViTProcessor.post_process_image_guided_detection]]
```python
post_process_image_guided_detection(outputs: OwlViTImageGuidedObjectDetectionOutput, threshold: float = 0.0, nms_threshold: float = 0.3, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/processing_owlvit.py#L197)
**المعاملات:**
outputs (`OwlViTImageGuidedObjectDetectionOutput`) : المخرجات الخام للنموذج.
threshold (`float`، *اختياري*، القيمة الافتراضية 0.0) : الحد الأدنى لدرجة الثقة المستخدم لتصفية الصناديق المتوقعة.
nms_threshold (`float`، *اختياري*، القيمة الافتراضية 0.3) : عتبة IoU لتطبيق كبح أقصى غير (non-maximum suppression) على الصناديق المتداخلة.
target_sizes (`torch.Tensor`، *اختياري*) : متجه (Tensor) من الشكل (batch_size, 2) حيث يمثل كل إدخال (الارتفاع، العرض) للصورة المقابلة في الدفعة. إذا تم تعيينه، تُعاد ملاءة الصناديق المحيطة المعيارية المتوقعة إلى الأحجام المستهدفة. إذا تُركت القيمة None، فلن يتم إلغاء تقييس التوقعات.
**يعيد:** `list[Dict]`
قائمة من القواميس، حيث يحتوي كل قاموس على المفاتيح التالية:
- …
- "boxes": صناديق الحدود للصور بصيغة (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
- "labels": اضبطه على `None`.
يحوّل مخرجات [OwlViTForObjectDetection.image_guided_detection()](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTForObjectDetection.image_guided_detection) إلى التنسيق الذي تتوقعه واجهة COCO البرمجية.
## OwlViTModel[[transformers.OwlViTModel]]
#### transformers.OwlViTModel[[transformers.OwlViTModel]]
```python
transformers.OwlViTModel(config: OwlViTConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L813)
**المعاملات:**
config ([OwlViTConfig](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج Owlvit الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.OwlViTModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, return_loss: bool | None = None, interpolate_pos_encoding: bool = False, return_base_image_embeds: bool | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L907)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/main/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام [OwlViTImageProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTImageProcessor). راجع [OwlViTImageProcessor.__call__()](/docs/transformers/main/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([OwlViTProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTProcessor) يستخدم [OwlViTImageProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTImageProcessor) لمعالجة الصور).
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
return_loss (`bool`، *اختياري*) : ما إذا كان يجب إرجاع خسارة التباينية أم لا.
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
return_base_image_embeds (`bool`، *اختياري*) : ما إذا كان يجب إرجاع تضمينات الصورة الأساسية أم لا.
**يعيد:** `OwlViTOutput` أو `tuple(torch.Tensor)`
A `OwlViTOutput` or a tuple of `torch.Tensor` (if `return_dict=False` is passed or when `config.return_dict=False`) comprising various elements depending on the configuration ([OwlViTConfig](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTConfig)) and inputs.
تتجاوز طريقة [OwlViTModel](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTModel) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` of shape `(1,)`, *اختياري*, يُعاد عندما تكون `return_loss` هي `True`) -- خسارة تباينية (Contrastive loss) لتقدير التشابه بين الصورة والنص.
- **logits_per_image** (`torch.Tensor` من الشكل `(image_batch_size, text_batch_size)`) -- درجات ضرب النقطة المُقيَّسة بين `image_embeds` و`text_embeds`. وهذا يمثل درجات التشابه بين الصورة والنص.
- **logits_per_text** (`torch.Tensor` من الشكل `(text_batch_size, image_batch_size)`) -- درجات ضرب النقطة المُقيَّسة بين `text_embeds` و`image_embeds`. تمثل هذه الدرجات درجات التشابه بين النص والصورة.
- **text_embeds** (`torch.Tensor` من الشكل `(batch_size * num_max_text_queries, output_dim`) -- تمثيلات النص (embeddings) التي تم الحصول عليها عن طريق تطبيق طبقة الإسقاط (projection layer) على المخرجات المجمعة (pooled output) لـ [OwlViTTextModel](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTTextModel).
- **image_embeds** (`torch.Tensor` من الشكل `(batch_size, output_dim`) -- تمثيلات الصور التي تم الحصول عليها من خلال تطبيق طبقة الإسقاط على المخرجات المجمعة لـ [OwlViTVisionModel](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTVisionModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`، *اختياري*) -- مخرجات [OwlViTTextModel](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`، *اختياري*) -- مخرجات [OwlViTVisionModel](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTVisionModel).
أمثلة:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, OwlViTModel
>>> model = OwlViTModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(text=[["a photo of a cat", "a photo of a dog"]], images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> logits_per_image = outputs.logits_per_image # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
```
#### get_text_features[[transformers.OwlViTModel.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L836)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size * num_max_text_queries, sequence_length)`) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/main/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
**يعيد:** [BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([OwlViTConfig](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTConfig)) والمدخلات.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> import torch
>>> from transformers import AutoProcessor, OwlViTModel
>>> model = OwlViTModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> inputs = processor(
... text=[["a photo of a cat", "a photo of a dog"], ["photo of a astranaut"]], return_tensors="pt"
... )
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_image_features[[transformers.OwlViTModel.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L873)
**المعاملات:**
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`) : المصفوفات المتناظرة مع الصور المدخلة. يمكن الحصول على قيم البكسل باستخدام [OwlViTImageProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTImageProcessor). راجع [OwlViTImageProcessor.__call__()](/docs/transformers/main/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([OwlViTProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTProcessor) يستخدم [OwlViTImageProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTImageProcessor) لمعالجة الصور).
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
**يعيد:** [BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([OwlViTConfig](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTConfig)) والمدخلات.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> import torch
>>> from transformers.image_utils import load_image
>>> from transformers import AutoProcessor, OwlViTModel
>>> model = OwlViTModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... image_features = model.get_image_features(**inputs)
```
## OwlViTTextModel[[transformers.OwlViTTextModel]]
#### transformers.OwlViTTextModel[[transformers.OwlViTTextModel]]
```python
transformers.OwlViTTextModel(config: OwlViTTextConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L668)
#### forward[[transformers.OwlViTTextModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L684)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size * num_max_text_queries, sequence_length)`) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/main/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
**يعيد:** [BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([OwlViTConfig](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTConfig)) والمدخلات.
تُعيد طريقة [OwlViTTextModel](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTTextModel) الخاصة بالتقديم (forward) تعريف الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from transformers import AutoProcessor, OwlViTTextModel
>>> model = OwlViTTextModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> inputs = processor(
... text=[["a photo of a cat", "a photo of a dog"], ["photo of a astranaut"]], return_tensors="pt"
... )
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled (EOS token) states
```
## OwlViTVisionModel[[transformers.OwlViTVisionModel]]
#### transformers.OwlViTVisionModel[[transformers.OwlViTVisionModel]]
```python
transformers.OwlViTVisionModel(config: OwlViTVisionConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L763)
#### forward[[transformers.OwlViTVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L777)
**المعاملات:**
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام [OwlViTImageProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTImageProcessor). راجع [OwlViTImageProcessor.__call__()](/docs/transformers/main/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([OwlViTProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTProcessor) يستخدم [OwlViTImageProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTImageProcessor) لمعالجة الصور).
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
**يعيد:** [BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([OwlViTConfig](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTConfig)) والمدخلات.
تتجاوز طريقة [OwlViTVisionModel](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTVisionModel) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, OwlViTVisionModel
>>> model = OwlViTVisionModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled CLS states
```
## OwlViTForObjectDetection[[transformers.OwlViTForObjectDetection]]
#### transformers.OwlViTForObjectDetection[[transformers.OwlViTForObjectDetection]]
```python
transformers.OwlViTForObjectDetection(config: OwlViTConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L1054)
#### forward[[transformers.OwlViTForObjectDetection.forward]]
```python
forward(input_ids: Tensor, pixel_values: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L1379)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size * num_max_text_queries, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/main/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids).
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`) : المصفوفات المتناظرة مع الصور المدخلة. يمكن الحصول على قيم البكسل باستخدام [OwlViTImageProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTImageProcessor). راجع [OwlViTImageProcessor.__call__()](/docs/transformers/main/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([OwlViTProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTProcessor) يستخدم [OwlViTImageProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTImageProcessor) لمعالجة الصور).
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
**يعيد:** `OwlViTObjectDetectionOutput` أو `tuple(torch.Tensor)`
`OwlViTObjectDetectionOutput` أو مجموعة مرتبة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([OwlViTConfig](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTConfig)) والمدخلات.
تتجاوز طريقة [OwlViTForObjectDetection](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTForObjectDetection) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` of shape `(1,)`, *اختياري*, يُعاد عند توفير `labels`) -- إجمالي الخسارة على شكل تركيبة خطية من سلبية الاحتمال اللوغاريتمي (الإنتروبيا المتقاطعة) للتنبؤ بالفئة وخسارة صندوق الحدود. تُعرَّف الأخيرة على أنها تركيبة خطية من خسارة L1 وخسارة IoU العامة غير المعتمدة على المقياس.
- **loss_dict** (`Dict`، *اختياري*) -- قاموس يحتوي على الخسائر الفردية. مفيد للتسجيل.
- **logits** (`torch.Tensor` من الشكل `(batch_size, num_patches, num_queries)`) -- قيم التصنيف (تشمل عدم وجود كائن) لجميع الاستعلامات.
- **pred_boxes** (`torch.Tensor` من الشكل `(batch_size, num_patches, 4)`) -- إحداثيات صناديق مُطبَّعة لجميع الاستعلامات، ممثّلة على شكل (center_x, center_y, width, height). هذه القيم مُطبَّعة ضمن [0, 1]، نسبةً إلى حجم كل صورة فردية في الدفعة (مع تجاهل أي حشو محتمل). يمكنك استخدام `post_process_object_detection()` لاسترجاع صناديق الحدود غير المُطبَّعة.
- **text_embeds** (`torch.Tensor` من الشكل `(batch_size, num_max_text_queries, output_dim`) -- تمثيلات النص التي تم الحصول عليها من خلال تطبيق طبقة الإسقاط على المخرجات المجمعة لـ [OwlViTTextModel](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTTextModel).
- **image_embeds** (`torch.Tensor` من الشكل `(batch_size, patch_size, patch_size, output_dim`) -- المخرجات المجمّعة لـ [OwlViTVisionModel](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTVisionModel). يمثّل OWL-ViT الصور كمجموعة من بقع الصور (patches) ويحسب تضمينات الصور لكل بقعة.
- **class_embeds** (`torch.Tensor` من الشكل `(batch_size, num_patches, hidden_size)`) -- تمثيلات الفئات لجميع بقع الصورة. يمثل OWL-ViT الصور كمجموعة من بقع الصورة حيث يكون العدد الإجمالي للبقع هو (image_size / patch_size)**2.
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`، *اختياري*) -- مخرجات [OwlViTTextModel](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`، *اختياري*) -- مخرجات [OwlViTVisionModel](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTVisionModel).
أمثلة:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> from transformers import OwlViTProcessor, OwlViTForObjectDetection
>>> processor = OwlViTProcessor.from_pretrained("google/owlvit-base-patch32")
>>> model = OwlViTForObjectDetection.from_pretrained("google/owlvit-base-patch32")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text_labels = [["a photo of a cat", "a photo of a dog"]]
>>> inputs = processor(text=text_labels, images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # Target image sizes (height, width) to rescale box predictions [batch_size, 2]
>>> target_sizes = torch.tensor([(image.height, image.width)])
>>> # Convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> results = processor.post_process_grounded_object_detection(
... outputs=outputs, target_sizes=target_sizes, threshold=0.1, text_labels=text_labels
... )
>>> # Retrieve predictions for the first image for the corresponding text queries
>>> result = results[0]
>>> boxes, scores, text_labels = result["boxes"], result["scores"], result["text_labels"]
>>> for box, score, text_label in zip(boxes, scores, text_labels):
... box = [round(i, 2) for i in box.tolist()]
... print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a photo of a cat with confidence 0.707 at location [324.97, 20.44, 640.58, 373.29]
Detected a photo of a cat with confidence 0.717 at location [1.46, 55.26, 315.55, 472.17]
```
#### image_guided_detection[[transformers.OwlViTForObjectDetection.image_guided_detection]]
```python
image_guided_detection(pixel_values: Tensor, query_pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L1294)
**المعاملات:**
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`) : المصفوفات المتناظرة مع الصور المدخلة. يمكن الحصول على قيم البكسل باستخدام [OwlViTImageProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTImageProcessor). راجع [OwlViTImageProcessor.__call__()](/docs/transformers/main/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([OwlViTProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTProcessor) يستخدم [OwlViTImageProcessor](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTImageProcessor) لمعالجة الصور).
query_pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, height, width)`) : قيم البكسلات لصورة الاستعلام أو صور الاستعلام المراد اكتشافها. مرّر صورة استعلام واحدة لكل صورة هدف.
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
**يعيد:** `OwlViTImageGuidedObjectDetectionOutput` أو `tuple(torch.Tensor)`
`OwlViTImageGuidedObjectDetectionOutput` أو مجموعة مرتبة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([OwlViTConfig](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTConfig)) والمدخلات.
- **logits** (`torch.Tensor` من الشكل `(batch_size, num_patches, num_queries)`) -- قيم التصنيف (تشمل عدم وجود كائن) لجميع الاستعلامات.
- **image_embeds** (`torch.Tensor` من الشكل `(batch_size, patch_size, patch_size, output_dim`) -- المخرجات المجمّعة لـ [OwlViTVisionModel](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTVisionModel). يمثّل OWL-ViT الصور كمجموعة من بقع الصور (patches) ويحسب تضمينات الصور لكل بقعة.
- **query_image_embeds** (`torch.Tensor` من الشكل `(batch_size, patch_size, patch_size, output_dim`) -- المخرجات المجمّعة لـ [OwlViTVisionModel](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTVisionModel). يمثّل OWL-ViT الصور كمجموعة من رقعات الصور (patches) ويحسب تضمينات الصور لكل رقعة.
- **target_pred_boxes** (`torch.Tensor` من الشكل `(batch_size, num_patches, 4)`) -- إحداثيات صناديق مُطبَّعة لجميع الاستعلامات، ممثّلة على شكل (center_x, center_y, width, height). هذه القيم مُطبَّعة ضمن [0, 1]، نسبةً إلى حجم كل صورة هدف فردية في الدفعة (مع تجاهل أي حشو محتمل). يمكنك استخدام `post_process_object_detection()` لاسترجاع صناديق الحدود غير المُطبَّعة.
- **query_pred_boxes** (`torch.Tensor` من الشكل `(batch_size, num_patches, 4)`) -- إحداثيات صناديق مُطبَّعة لجميع الاستعلامات، ممثّلة على شكل (center_x, center_y, width, height). هذه القيم مُطبَّعة ضمن [0, 1]، نسبةً إلى حجم كل صورة استعلام فردية في الدفعة (مع تجاهل أي حشو محتمل). يمكنك استخدام `post_process_object_detection()` لاسترجاع صناديق الحدود غير المُطبَّعة.
- **class_embeds** (`torch.Tensor` من الشكل `(batch_size, num_patches, hidden_size)`) -- تمثيلات الفئات لجميع بقع الصورة. يمثل OWL-ViT الصور كمجموعة من بقع الصورة حيث يكون العدد الإجمالي للبقع هو (image_size / patch_size)**2.
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`، *اختياري*) -- مخرجات [OwlViTTextModel](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`، *اختياري*) -- مخرجات [OwlViTVisionModel](/docs/transformers/main/ar/model_doc/owlvit#transformers.OwlViTVisionModel).
أمثلة:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> from transformers import AutoProcessor, OwlViTForObjectDetection
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch16")
>>> model = OwlViTForObjectDetection.from_pretrained("google/owlvit-base-patch16")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> query_url = "http://images.cocodataset.org/val2017/000000001675.jpg"
>>> with httpx.stream("GET", query_url) as response:
... query_image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, query_images=query_image, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model.image_guided_detection(**inputs)
>>> # Target image sizes (height, width) to rescale box predictions [batch_size, 2]
>>> target_sizes = torch.Tensor([image.size[::-1]])
>>> # Convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> results = processor.post_process_image_guided_detection(
... outputs=outputs, threshold=0.6, nms_threshold=0.3, target_sizes=target_sizes
... )
>>> i = 0 # Retrieve predictions for the first image
>>> boxes, scores = results[i]["boxes"], results[i]["scores"]
>>> for box, score in zip(boxes, scores):
... box = [round(i, 2) for i in box.tolist()]
... print(f"Detected similar object with confidence {round(score.item(), 3)} at location {box}")
Detected similar object with confidence 0.856 at location [10.94, 50.4, 315.8, 471.39]
Detected similar object with confidence 1.0 at location [334.84, 25.33, 636.16, 374.71]
```