# TrOCR
[TrOCR](https://huggingface.co/papers/2109.10282) هو نموذج لتعرف النص مخصص لكل من فهم الصور وتوليد النص. لا يتطلب نماذج منفصلة لمعالجة الصور أو توليد الأحرف. إنه نظام بسيط شامل من الطرف إلى الطرف يستخدم محوّلًا للتعامل مع الفهم البصري وتوليد النص.
يمكنك العثور على جميع نقاط التفتيش الأصلية لـ TrOCR تحت منظمة [Microsoft](https://huggingface.co/microsoft/models?search=trocr).
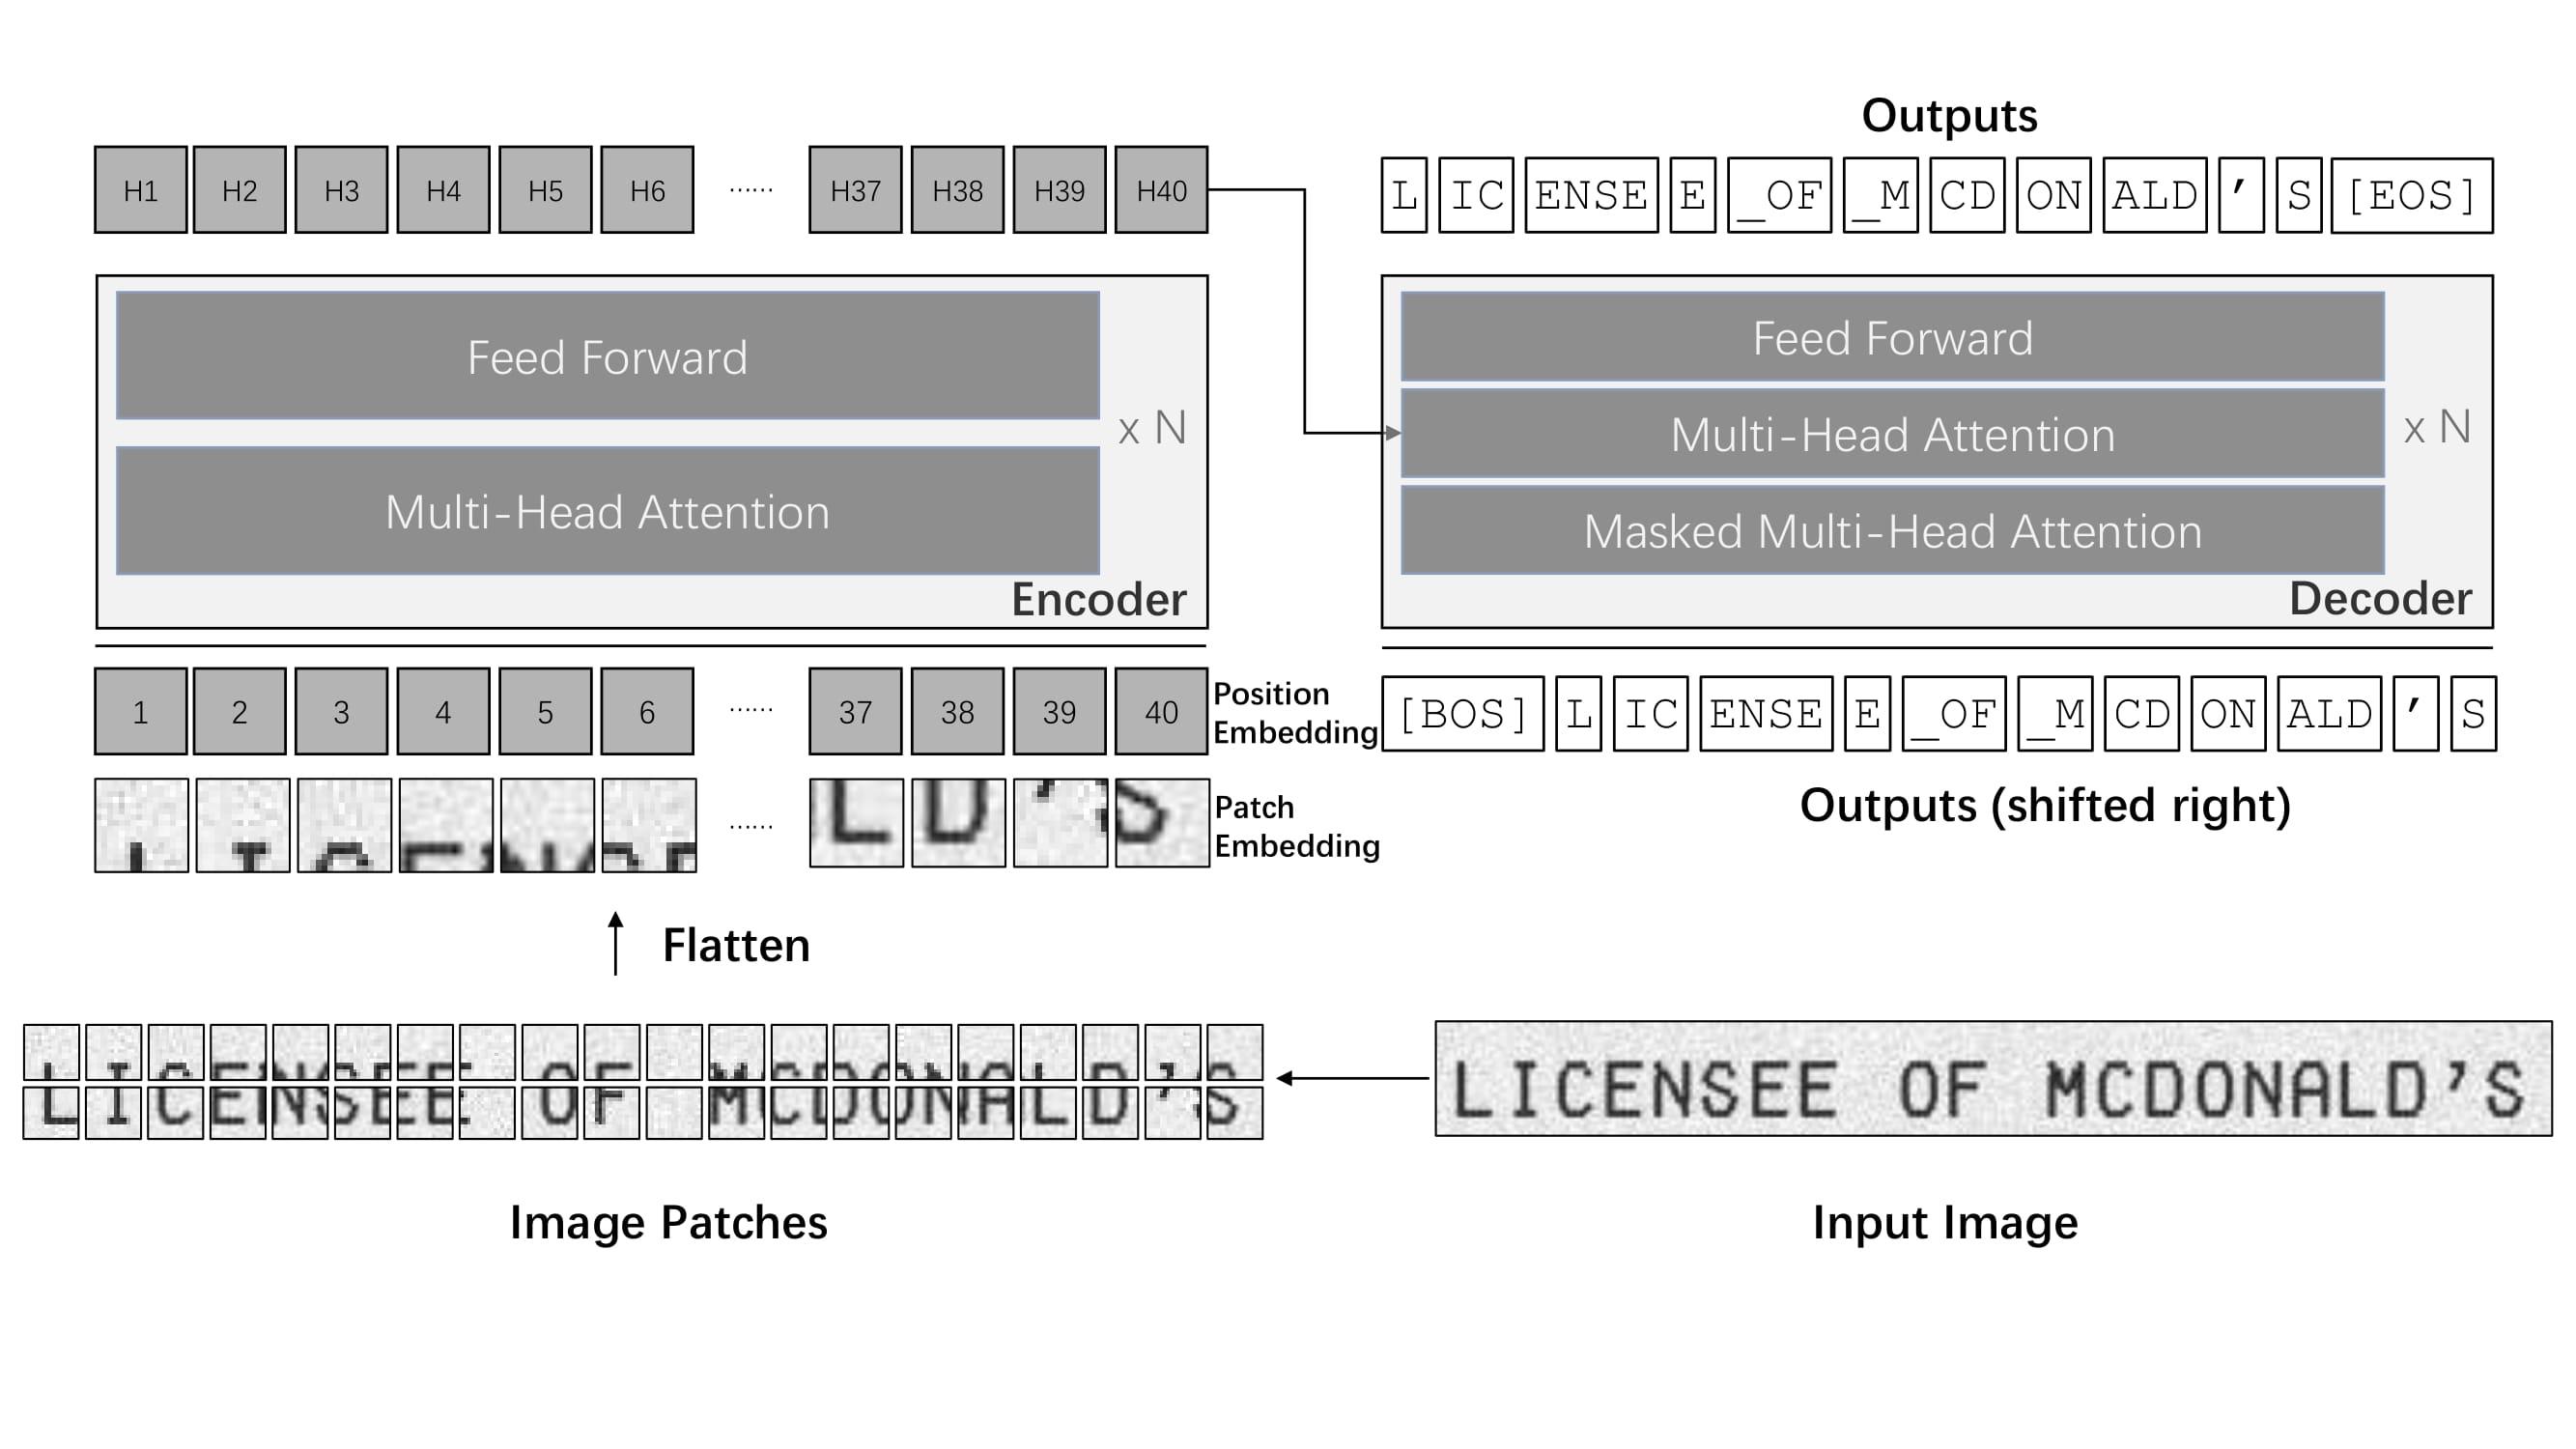 بنية TrOCR. مأخوذة من الورقة الأصلية.
> [!TIP]
> تمت مساهمة هذا النموذج من قِبل [nielsr](https://huggingface.co/nielsr).
>
> انقر على نماذج TrOCR في الشريط الجانبي الأيمن لمزيد من الأمثلة حول كيفية تطبيق TrOCR على مهام مختلفة للصور والنصوص.
يُظهر المثال أدناه كيفية تنفيذ التعرف الضوئي على الحروف (OCR) باستخدام فئة [AutoModel](/docs/transformers/main/ar/model_doc/auto#transformers.AutoModel).
```python
import requests
from PIL import Image
from transformers import TrOCRProcessor, VisionEncoderDecoderModel
processor = TrOCRProcessor.from_pretrained("microsoft/trocr-base-handwritten")
model = VisionEncoderDecoderModel.from_pretrained("microsoft/trocr-base-handwritten", device_map="auto")
# load image from the IAM dataset
url = "https://fki.tic.heia-fr.ch/static/img/a01-122-02.jpg"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
pixel_values = processor(image, return_tensors="pt").to(model.device).pixel_values
generated_ids = model.generate(pixel_values)
generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
print(generated_text)
```
## التكميم
تقلل عملية التكميم العبء على الذاكرة في النماذج الكبيرة من خلال تمثيل الأوزان بدقة أقل. راجع نظرة عامة على [التكميم](../quantization/overview) للاطلاع على المزيد من واجهات التكميم المتاحة.
يستخدم المثال أدناه [bitsandbytes](../quantization/bitsandbytes) لاختزال الأوزان إلى 8 بتات.
```python
# pip install bitsandbytes accelerate
from transformers import TrOCRProcessor, VisionEncoderDecoderModel, BitsandBytesConfig
import requests
from PIL import Image
# Set up the quantization configuration
quantization_config = BitsandBytesConfig(load_in_8bit=True)
# Use a large checkpoint for a more noticeable impact
processor = TrOCRProcessor.from_pretrained("microsoft/trocr-large-handwritten")
model = VisionEncoderDecoderModel.from_pretrained(
"microsoft/trocr-large-handwritten",
quantization_config=quantization_config
device_map="auto")
# load image from the IAM dataset
url = "[https://fki.tic.heia-fr.ch/static/img/a01-122-02.jpg](https://fki.tic.heia-fr.ch/static/img/a01-122-02.jpg)"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
pixel_values = processor(image, return_tensors="pt").to(model.device).pixel_values
generated_ids = model.generate(pixel_values)
generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
print(generated_text)
```
## ملاحظات
- يجمع [TrOCR](/docs/transformers/main/ar/model_doc/vit#transformers.ViTImageProcessor) بين [ViTImageProcessor](/docs/transformers/main/ar/model_doc/deit#transformers.DeiTImageProcessor)/[DeiTImageProcessor](/docs/transformers/main/ar/model_doc/led#transformers.RobertaTokenizer) و [RobertaTokenizer](/docs/transformers/main/ar/model_doc/xlm-roberta#transformers.XLMRobertaTokenizer)/[XLMRobertaTokenizer](/docs/transformers/main/ar/model_doc/trocr#transformers.TrOCRProcessor) في كائن واحد من TrOCRProcessor للتعامل مع الصور والنصوص.
- يُستخدم TrOCR دائمًا ضمن إطار [VisionEncoderDecoder](vision-encoder-decoder).
## الموارد
- منشور مدونة حول [تسريع ذكاء المستندات](https://huggingface.co/blog/document-ai) باستخدام TrOCR.
- منشور مدونة حول كيفية [توثيق الذكاء الاصطناعي](https://github.com/philschmid/document-ai-transformers) باستخدام TrOCR.
- دفتر ملاحظات حول كيفية [ضبط نموذج TrOCR على قاعدة بيانات IAM للخط اليدوي باستخدام Seq2SeqTrainer](https://colab.research.google.com/github/NielsRogge/Transformers-Tutorials/blob/master/TrOCR/Fine_tune_TrOCR_on_IAM_Handwriting_Database_using_Seq2SeqTrainer.ipynb).
- عرض تفاعلي حول [تعرّف TrOCR على الأحرف المكتوبة بخط اليد](https://huggingface.co/spaces/nielsr/TrOCR-handwritten).
- دفتر ملاحظات حول [الاستدلال باستخدام TrOCR](https://colab.research.google.com/github/NielsRogge/Transformers-Tutorials/blob/master/TrOCR/Inference_with_TrOCR_%2B_Gradio_demo.ipynb) وعرض Gradio.
- دفتر ملاحظات حول [تقييم TrOCR على مجموعة اختبار IAM](https://colab.research.google.com/github/NielsRogge/Transformers-Tutorials/blob/master/TrOCR/Evaluating_TrOCR_base_handwritten_on_the_IAM_test_set.ipynb).
## TrOCRConfig[[transformers.TrOCRConfig]]
#### transformers.TrOCRConfig[[transformers.TrOCRConfig]]
```python
transformers.TrOCRConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 50265, d_model: int = 1024, decoder_layers: int = 12, decoder_attention_heads: int = 16, decoder_ffn_dim: int = 4096, activation_function: str = 'gelu', max_position_embeddings: int = 512, dropout: float | int = 0.1, attention_dropout: float | int = 0.0, activation_dropout: float | int = 0.0, decoder_start_token_id: int = 2, init_std: float = 0.02, decoder_layerdrop: float | int = 0.0, use_cache: bool = True, scale_embedding: bool = False, use_learned_position_embeddings: bool = True, layernorm_embedding: bool = True, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, cross_attention_hidden_size: int | None = None, is_decoder: bool = False, tie_word_embeddings: bool = True)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/trocr/configuration_trocr.py#L24)
**المعاملات:**
vocab_size (`int`, *اختياري*, الافتراضي `50265`) : حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطة `input_ids`.
d_model (`int`, *اختياري*, القيمة الافتراضية هي `1024`) : حجم طبقات المُرمِّز وطبقة المُجمِّع.
decoder_layers (`int`، *اختياري*، الافتراضي هو `12`) : عدد الطبقات المخفية في مُفكِّك Transformer. سيُستخدم نفس قيمة `num_layers` إذا لم يُضبط.
decoder_attention_heads (`int`، *اختياري*، القيمة الافتراضية `16`) : عدد رؤوس الانتباه في كل طبقة انتباه داخل مُفكِّك Transformer.
decoder_ffn_dim (`int`، *اختياري*، القيمة الافتراضية هي `4096`) : أبعاد طبقة "الوسيطة" (المعروفة غالبًا باسم طبقة التقدّم الأمامي) في المُفكِّك.
activation_function (`str`، *اختياري*، القيمة الافتراضية `gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
max_position_embeddings (`int`، *اختياري*، القيمة الافتراضية `512`) : أقصى طول تسلسل قد يُستخدم مع هذا النموذج.
dropout (`Union[float, int]`، *اختياري*، القيمة الافتراضية هي `0.1`) : النسبة لجميع طبقات dropout.
attention_dropout (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.0`) : نسبة الإسقاط (dropout) لاحتمالات الانتباه.
activation_dropout (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.0`) : نسبة الإسقاط (dropout) للتفعيلات داخل الطبقة المتصلة بالكامل.
decoder_start_token_id (`int`، *اختياري*، القيمة الافتراضية `2`) : إذا بدأ نموذج encoder-decoder فك الترميز برمز مختلف عن `bos`، فهذا هو معرّف ذلك الرمز.
init_std (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
decoder_layerdrop (`Union[float, int]`, *اختياري*, القيمة الافتراضية `0.0`) : احتمال LayerDrop لمفكّك الترميز. راجع [ورقة LayerDrop](see https://huggingface.co/papers/1909.11556) لمزيد من التفاصيل.
use_cache (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب على النموذج إرجاع قيم المفاتيح/القيم الأخيرة للانتباه (لا تستخدمها جميع النماذج). لا ينطبق إلا إذا كان `config.is_decoder=True` أو عندما يكون النموذج نموذجًا توليديًا يعتمد على المُفكِّك فقط.
scale_embedding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم توسيع التضمينات (embeddings) من خلال القسمة على sqrt(d_model).
use_learned_position_embeddings (`bool`، *اختياري*، الافتراضي `True`) : ما إذا كان سيتم استخدام تضمينات المواقع المتعلمة أم لا. إذا لم يتم ذلك، فسيتم استخدام تضمينات المواقع الجيبية.
layernorm_embedding (`bool`، *اختياري*، الافتراضي `True`) : ما إذا كان سيتم استخدام layernorm بعد تضمينات الكلمات والمواقع.
pad_token_id (`int`، *اختياري*، القيمة الافتراضية `1`) : معرّف الرمز المستخدم للتعبئة في المفردات.
bos_token_id (`int`، *اختياري*، القيمة الافتراضية `0`) : معرّف الرمز المستخدم لبدء البث في المفردات.
eos_token_id (`Union[int, list[int]]`، *اختياري*، القيمة الافتراضية `2`) : معرّف الرمز المستخدم لنهاية البث في المفردات.
cross_attention_hidden_size (`int`، *اختياري*) : حجم المخفيّ لمخرجات المُشفِّر المُسقَط إلى فضاء المفتاح/القيمة في الانتباه المتقاطع للمُفكِّك. يُستخدم عندما يكون حجم المخفيّ مختلفًا بين المُشفِّر والمُفكِّك.
is_decoder (`bool`، *اختياري*، الافتراضي `False`) : ما إذا كان النموذج يُستخدم كمُفكِّك أم لا. إذا كان `False`، يُستخدم النموذج كمُشفِّر.
tie_word_embeddings (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب ربط ترميزات الأوزان وفقاً لخريطة `tied_weights_keys` الخاصة بالنموذج.
هذه فئة الإعدادات المخزنة لإعدادات نموذج TrocrModel. تُستخدم لاستحداث نموذج Trocr وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [microsoft/trocr-base-handwritten](https://huggingface.co/microsoft/trocr-base-handwritten)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
مثال:
```python
>>> from transformers import TrOCRConfig, TrOCRForCausalLM
>>> # Initializing a TrOCR-base style configuration
>>> configuration = TrOCRConfig()
>>> # Initializing a model (with random weights) from the TrOCR-base style configuration
>>> model = TrOCRForCausalLM(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## TrOCRProcessor[[transformers.TrOCRProcessor]]
#### transformers.TrOCRProcessor[[transformers.TrOCRProcessor]]
```python
transformers.TrOCRProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/trocr/processing_trocr.py#L30)
**المعاملات:**
image_processor (`ViTImageProcessor`) : مُعالج الصور هو مدخل مطلوب.
tokenizer (`XLMRobertaTokenizer`) : مُجزِّئ النص (tokenizer) هو مدخل مطلوب.
ينشئ معالج TrOCRProcessor يجمع معالج الصور ومجزئ الرموز في معالج واحد.
يوفر [TrOCRProcessor](/docs/transformers/main/ar/model_doc/trocr#transformers.TrOCRProcessor) جميع وظائف [ViTImageProcessor](/docs/transformers/main/ar/model_doc/vit#transformers.ViTImageProcessor) و[XLMRobertaTokenizer](/docs/transformers/main/ar/model_doc/xlm-roberta#transformers.XLMRobertaTokenizer). راجع [~ViTImageProcessor](/docs/transformers/main/ar/model_doc/vit#transformers.ViTImageProcessor) و[~XLMRobertaTokenizer](/docs/transformers/main/ar/model_doc/xlm-roberta#transformers.XLMRobertaTokenizer) لمزيد من المعلومات.
#### __call__[[transformers.TrOCRProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/trocr/processing_trocr.py#L34)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *اختياري*) : الصورة التي سيتم معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`، *اختياري*) : التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُجزَّأ مسبقًا). إذا مررت مدخلات مُجزَّأة مسبقًا، فاضبط `is_split_into_words=True` لتجنب الغموض مع المدخلات المُجمَّعة في دفعات.
return_tensors (`str` أو [TensorType](/docs/transformers/main/ar/internal/file_utils#transformers.TensorType)، *اختياري*) : إذا تم تعيينه، فسيُرجع تينسورات من إطار عمل محدد. القيم المقبولة هي: - `'pt'`: يُرجع كائنات `torch.Tensor` من PyTorch. - `'np'`: يُرجع كائنات `np.ndarray` من NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/ar/main_classes/processors#transformers.ProcessingKwargs)، *اختياري*) : خيارات معالجة إضافية لكل نمط (نص، صور، مقاطع فيديو، صوت). تُدرج المعلمات الخاصة بالنموذج أعلاه؛ راجع فئة TypedDict للحصول على القائمة الكاملة للحجج المدعومة.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
#### from_pretrained[[transformers.TrOCRProcessor.from_pretrained]]
```python
from_pretrained(pretrained_model_name_or_path: str | os.PathLike, cache_dir: str | os.PathLike | None = None, force_download: bool = False, local_files_only: bool = False, token: str | bool | None = None, revision: str = 'main', **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L1693)
**المعاملات:**
pretrained_model_name_or_path (`str` أو `os.PathLike`) : يمكن أن يكون هذا: - نصًا، وهو *معرف النموذج* لمُستخرج ميزات مُدرَّب مسبقًا مُستضاف داخل مستودع نموذج على huggingface.co. - مسارًا إلى *مجلد* يحتوي على ملف مستخرج ميزات تم حفظه باستخدام طريقة [save_pretrained()](/docs/transformers/main/ar/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained)، على سبيل المثال `./my_model_directory/`. - مسارًا إلى ملف JSON *لمستخرج ميزات* محفوظ، على سبيل المثال `./my_model_directory/preprocessor_config.json`.
- ****kwargs** : حُجج إضافية تُمرَّر إلى كلٍّ من [from_pretrained()](/docs/transformers/main/ar/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained) و`~tokenization_utils_base.PreTrainedTokenizer.from_pretrained`.
أنشئ معالجًا مرتبطًا بنموذج مُدرَّب مسبقًا.
تستدعي طريقة الفئة هذه ببساطة مستخرج الميزات [from_pretrained()](/docs/transformers/main/ar/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained) ومعالج الصور [ImageProcessingMixin](/docs/transformers/main/ar/internal/image_processing_utils#transformers.ImageProcessingMixin) وطريقة المرمّز `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained`. يُرجى الرجوع إلى سلاسل التوثيق للطرق المذكورة أعلاه لمزيد من المعلومات.
#### save_pretrained[[transformers.TrOCRProcessor.save_pretrained]]
```python
save_pretrained(save_directory, push_to_hub: bool = False, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L1108)
**المعاملات:**
save_directory (`str` أو `os.PathLike`) : المجلد الذي سيتم حفظ ملف مستخرج الميزات بصيغة JSON وملفات المُرمِّز فيه (سيتم إنشاء المجلد إذا لم يكن موجودًا).
push_to_hub (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم دفع نموذجك إلى مستودع نماذج Hugging Face بعد حفظه. يمكنك تحديد المستودع الذي تريد الدفع إليه باستخدام `repo_id` (سيكون الافتراضي هو اسم `save_directory` ضمن نطاقك).
kwargs (`dict[str, Any]`، *اختياري*) : حُجج إضافية تُمرَّر إلى طريقة [push_to_hub()](/docs/transformers/main/ar/main_classes/model#transformers.utils.PushToHubMixin.push_to_hub).
يحفظ خصائص هذا المعالج (مستخرج الميزات، المرمّز...) في المجلد المحدد بحيث يمكن إعادة تحميله باستخدام طريقة [from_pretrained()](/docs/transformers/main/ar/model_doc/wav2vec2#transformers.Wav2Vec2Processor.from_pretrained).
تستدعي طريقة الفئة هذه ببساطة [save_pretrained()](/docs/transformers/main/ar/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained) و [save_pretrained()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.save_pretrained). يُرجى الرجوع إلى سلاسل التوثيق للطرق المذكورة أعلاه لمزيد من المعلومات.
#### batch_decode[[transformers.TrOCRProcessor.batch_decode]]
```python
batch_decode(*args, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L1948)
تُمرّر هذه الطريقة جميع معاملاتها إلى [batch_decode()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.batch_decode) الخاصة بـ PreTrainedTokenizer. يُرجى الرجوع إلى سلسلة التوثيق (docstring) لهذه الطريقة لمزيد من المعلومات.
#### فك الترميز[[transformers.TrOCRProcessor.decode]]
```python
decode(*args, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L1957)
تُمرّر هذه الطريقة جميع معاملاتها إلى [decode()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.decode) الخاصة بـ PreTrainedTokenizer. يُرجى الرجوع إلى سلسلة التوثيق (docstring) لهذه الطريقة لمزيد من المعلومات.
## TrOCRForCausalLM[[transformers.TrOCRForCausalLM]]
#### transformers.TrOCRForCausalLM[[transformers.TrOCRForCausalLM]]
```python
transformers.TrOCRForCausalLM(config: TrOCRConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/trocr/modeling_trocr.py#L639)
**المعاملات:**
config ([TrOCRConfig](/docs/transformers/main/ar/model_doc/trocr#transformers.TrOCRConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
مفكّك TrOCR مع رأس لنمذجة اللغة. يمكن استخدامه كجزء المفكّك في [EncoderDecoderModel](/docs/transformers/main/ar/model_doc/encoder-decoder#transformers.EncoderDecoderModel) و
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.TrOCRForCausalLM.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.LongTensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/trocr/modeling_trocr.py#L665)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/main/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
encoder_hidden_states (`torch.Tensor` بأبعاد `(batch_size, sequence_length, hidden_size)`، *اختياري*) : تسلسل من الحالات المخفية عند مخرجات الطبقة الأخيرة من المُشفِّر. يُستخدم في الانتباه المتقاطع إذا كان النموذج مُهيأً كمُفكِّك.
encoder_attention_mask (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو في مدخلات المُشفِّر. يُستخدم هذا القناع في الانتباه المتقاطع إذا كان النموذج مُهيأً كمُفكِّك. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنَّعة**، - 0 للرموز التي **مقنَّعة**.
past_key_values (`~cache_utils.Cache`، *اختياري*) : حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكوّن هذا عادةً من `past_key_values` التي يعيدها النموذج في مرحلة سابقة من فك الترميز، عندما يكون `use_cache=True` أو `config.use_cache=True`. يُسمح فقط بتمرير كائن [Cache](/docs/transformers/main/ar/internal/generation_utils#transformers.Cache) كمدخل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache). إذا لم يتم تمرير `past_key_values`، فسيتم تهيئة [DynamicCache](/docs/transformers/main/ar/internal/generation_utils#transformers.DynamicCache) افتراضيًا. سيُخرج النموذج نفس تنسيق الذاكرة المؤقتة المُدخل. إذا تم استخدام `past_key_values`، يُتوقع من المستخدم إدخال `input_ids` غير المعالجة فقط (تلك التي لم تُعطَ حالات مفاتيح وقيم سابقة لها في هذا النموذج) بأبعاد `(batch_size, unprocessed_length)` بدلاً من جميع `input_ids` بأبعاد `(batch_size, sequence_length)`.
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
labels (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : تسميات لحساب خسارة نمذجة اللغة المقنّعة. يجب أن تكون الفهارس إما ضمن `[0, ..., config.vocab_size]` أو -100 (انظر `input_ids` docstring). يتم تجاهل الرموز التي تكون فهارسها مضبوطة على `-100` (مقنّعة)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن `[0, ..., config.vocab_size]`.
use_cache (`bool`، *اختياري*) : إذا تم ضبطه على `True`، تُعاد حالات المفاتيح والقيم `past_key_values` ويمكن استخدامها لتسريع فك الترميز (انظر `past_key_values`).
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/main/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
**يعيد:** [CausalLMOutputWithCrossAttentions](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) أو `tuple(torch.Tensor)`
[CausalLMOutputWithCrossAttentions](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([TrOCRConfig](/docs/transformers/main/ar/model_doc/trocr#transformers.TrOCRConfig)) والمدخلات.
تتجاوز طريقة [TrOCRForCausalLM](/docs/transformers/main/ar/model_doc/trocr#transformers.TrOCRForCausalLM) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`، *اختياري*، يُعاد عند توفير `labels`) -- خسارة نمذجة اللغة (لتوقع الرمز التالي).
- **logits** (`torch.Tensor` من الشكل `(batch_size, sequence_length, config.vocab_size)`) -- درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) من الشكل `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه المتقاطع بعد softmax للانتباه، وتُستخدم لحساب المتوسط المرجح في رؤوس الانتباه المتقاطع.
- **past_key_values** (`Cache`، *اختياري*، يُعاد عند تمرير `use_cache=True` أو عند تعيين `config.use_cache=True`) -- هو كائن من نوع [Cache](/docs/transformers/main/ar/internal/generation_utils#transformers.Cache). لمزيد من التفاصيل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache).
تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه) يمكن استخدامها (انظر مدخل `past_key_values`) لتسريع فك الترميز التسلسلي.
مثال:
```python
>>> from transformers import (
... TrOCRConfig,
... TrOCRProcessor,
... TrOCRForCausalLM,
... ViTConfig,
... ViTModel,
... VisionEncoderDecoderModel,
... )
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> # TrOCR is a decoder model and should be used within a VisionEncoderDecoderModel
>>> # init vision2text model with random weights
>>> encoder = ViTModel(ViTConfig())
>>> decoder = TrOCRForCausalLM(TrOCRConfig())
>>> model = VisionEncoderDecoderModel(encoder=encoder, decoder=decoder)
>>> # If you want to start from the pretrained model, load the checkpoint with `VisionEncoderDecoderModel`
>>> processor = TrOCRProcessor.from_pretrained("microsoft/trocr-base-handwritten")
>>> model = VisionEncoderDecoderModel.from_pretrained("microsoft/trocr-base-handwritten")
>>> # load image from the IAM dataset
>>> url = "https://fki.tic.heia-fr.ch/static/img/a01-122-02.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> pixel_values = processor(image, return_tensors="pt").pixel_values
>>> text = "industry, ' Mr. Brown commented icily. ' Let us have a"
>>> # training
>>> model.config.decoder_start_token_id = processor.tokenizer.eos_token_id
>>> model.config.pad_token_id = processor.tokenizer.pad_token_id
>>> model.config.vocab_size = model.config.decoder.vocab_size
>>> labels = processor.tokenizer(text, return_tensors="pt").input_ids
>>> outputs = model(pixel_values, labels=labels)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
5.30
>>> # inference
>>> generated_ids = model.generate(pixel_values)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
>>> generated_text
'industry, " Mr. Brown commented icily. " Let us have a'
```