# X-CLIP
## نظرة عامة
قُدِّم نموذج X-CLIP في [Expanding Language-Image Pretrained Models for General Video Recognition](https://huggingface.co/papers/2208.02816) من قِبل Bolin Ni وHouwen Peng وMinghao Chen وSongyang Zhang وGaofeng Meng وJianlong Fu وShiming Xiang وHaibin Ling. يُعد X-CLIP امتداداً بسيطاً لنموذج [CLIP](clip) مخصصاً للفيديو. يتكوّن النموذج من مشفّر للنص، ومشفّر بصري بين الإطارات، ومحوّل (Transformer) لتكامل الإطارات المتعددة، ومولّد موجهات (prompts) مخصص للفيديو.
المستخلص من الورقة البحثية هو كالتالي:
*أظهر التدريب المسبق التبايني للغة والصورة نجاحًا كبيرًا في تعلم التمثيل المشترك البصري-النصي من بيانات على نطاق الويب، مما يثبت قدرة ملحوظة على التعميم "بدون تدريب مسبق" لمهام الصور المختلفة. ومع ذلك، لا يزال كيفية التوسع بفعالية في مثل هذه الطرق الجديدة للتدريب المسبق للغة والصورة إلى نطاقات الفيديو مشكلة مفتوحة. في هذا العمل، نقدم نهجًا بسيطًا وفعالًا يكيّف نماذج اللغة والصورة المدرَّبة مسبقًا مباشرةً للتعرف على الفيديو، بدلاً من تدريب نموذج جديد من الصفر. بشكل أكثر تحديداً، لالتقاط التبعيات طويلة المدى للإطارات على البُعد الزمني، نقترح آلية انتباه بين الإطارات تتبادل المعلومات صراحةً عبر الإطارات. هذا المكوّن خفيف الوزن ويمكن دمجه بسلاسة في نماذج اللغة والصورة المدرَّبة مسبقًا. علاوة على ذلك، نقترح مخطط تلميح مخصص للفيديو، يستفيد من معلومات محتوى الفيديو لتوليد تلميحات نصية تمييزية. تُظهر التجارب الواسعة أن نهجنا فعّال وقادر على التعميل إلى سيناريوهات مختلفة للتعرف على الفيديو. على وجه الخصوص، في الإعدادات المُشرَّحة بالكامل، يحقق نهجنا دقة أعلى بنسبة 87.1% على Kinectics-400، مع استخدام عدد أقل من عمليات FLOPs بمقدار 12 مرة مقارنةً بـ Swin-L و ViViT-H. في تجارب "بدون تدريب مسبق"، يتفوق نهجنا على أحدث الطرق الحالية بنسبة +7.6% و +14.9% من حيث دقة أعلى تحت بروتوكولين شائعين. في سيناريوهات "بقليل من العينات"، يتفوق نهجنا على أفضل الطرق السابقة بنسبة +32.1% و +23.1% عندما تكون البيانات الموسومة محدودة للغاية.*
نصائح:
- استخدام X-CLIP مطابق تماماً لاستخدام [CLIP](clip).
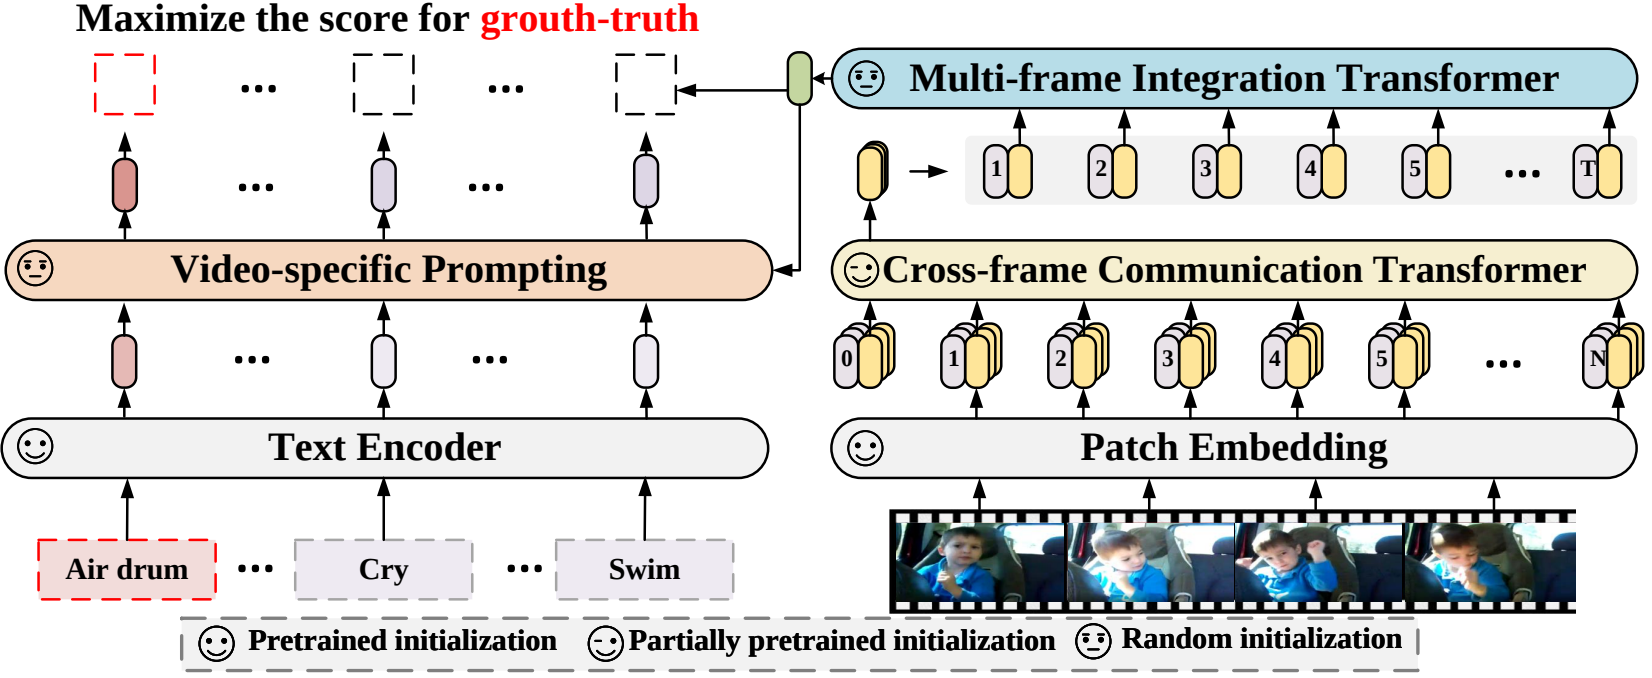 بنية X-CLIP. مأخوذة من الورقة الأصلية.
تمت مساهمة هذا النموذج من قِبل [nielsr](https://huggingface.co/nielsr). يمكن العثور على الكود الأصلي [هنا](https://github.com/microsoft/VideoX/tree/master/X-CLIP).
## الموارد
قائمة بموارد رسمية من Hugging Face وموارد من المجتمع (مشار إليها بـ 🌎) لمساعدتك على البدء في استخدام X-CLIP.
- يمكن العثور على كراسات الملاحظات التوضيحية لـ X-CLIP [هنا](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/X-CLIP).
إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب وسنقوم بمراجعته! يُفضَّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
## XCLIPProcessor[[transformers.XCLIPProcessor]]
#### transformers.XCLIPProcessor[[transformers.XCLIPProcessor]]
```python
transformers.XCLIPProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/processing_x_clip.py#L23)
**المعاملات:**
image_processor (`image_processor_class`) : مُعالج الصور هو مدخل مطلوب.
tokenizer (`tokenizer_class`) : مُجزِّئ النص (tokenizer) هو مدخل إلزامي.
ينشئ XCLIPProcessor الذي يجمع معالج الصور ومعالج الرموز في معالج واحد.
يوفر [XCLIPProcessor](/docs/transformers/main/ar/model_doc/xclip#transformers.XCLIPProcessor) جميع وظائف `image_processor_class` و`tokenizer_class`. راجع `~image_processor_class` و`~tokenizer_class` لمزيد من المعلومات.
#### __call__[[transformers.XCLIPProcessor.__call__]]
```python
__call__(images = None, text = None, videos = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/processing_x_clip.py#L28)
## XCLIPConfig[[transformers.XCLIPConfig]]
#### transformers.XCLIPConfig[[transformers.XCLIPConfig]]
```python
transformers.XCLIPConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, projection_dim: int = 512, prompt_layers: int = 2, prompt_alpha: float = 0.1, prompt_hidden_act: str = 'quick_gelu', prompt_num_attention_heads: int = 8, prompt_attention_dropout: float | int = 0.0, prompt_projection_dropout: float | int = 0.0, logit_scale_init_value: float = 2.6592, initializer_factor: float = 1.0)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/configuration_x_clip.py#L119)
**المعاملات:**
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`، *اختياري*) : كائن الإعداد أو قاموس العمود الفقري النصي.
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`، *اختياري*) : كائن الإعداد أو قاموس العمود الفقري البصري.
projection_dim (`int`، *اختياري*، القيمة الافتراضية `512`) : بُعد طبقات الإسقاط للنص والرؤية.
prompt_layers (`int`، *اختياري*، القيمة الافتراضية 2) : عدد الطبقات في مولّد الموجه الخاص بالفيديو.
prompt_alpha (`float`، *اختياري*، القيمة الافتراضية 0.1) : قيمة Alpha المستخدمة في مولّد الأوامر الخاص بالفيديو.
prompt_hidden_act (`str` أو `function`، *اختياري*، القيمة الافتراضية `"quick_gelu"`) : دالة التنشيط غير الخطية (دالة أو نص) في مولّد الموجهات المحدد للفيديو. إذا كان نصًا، فالدوال المدعومة هي `"gelu"`، `"relu"`، `"selu"` و`"gelu_new"` `"quick_gelu"`.
prompt_num_attention_heads (`int`، *اختياري*، القيمة الافتراضية 8) : عدد رؤوس الانتباه في الانتباه المتقاطع (cross-attention) الخاص بمولّد الموجهات (prompts) المحدد للفيديو.
prompt_attention_dropout (`float`، *اختياري*، القيمة الافتراضية 0.0) : احتمال الإسقاط (dropout) لطبقات الانتباه في مولد الموجهات المحدد للفيديو.
prompt_projection_dropout (`float`، *اختياري*، القيمة الافتراضية 0.0) : احتمال الإسقاط (dropout) لطبقات الإسقاط في مولّد الموجهات المحدد للفيديو.
logit_scale_init_value (`float`، *اختياري*، القيمة الافتراضية `2.6592`) : القيمة الأولية لمعامل *logit_scale*.
initializer_factor (`float`، *اختياري*، القيمة الافتراضية `1.0`) : معامل لتجميع جميع مصفوفات الأوزان (يجب إبقاؤه عند 1، ويُستخدم داخليًا لاختبارات التهيئة).
هذه فئة الإعدادات المخزنة لإعدادات نموذج X ClipModel. تُستخدم لتوليد نموذج X Clip وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن إنشاء إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ [microsoft/xclip-base-patch32](https://huggingface.co/microsoft/xclip-base-patch32)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
## XCLIPTextConfig[[transformers.XCLIPTextConfig]]
#### transformers.XCLIPTextConfig[[transformers.XCLIPTextConfig]]
```python
transformers.XCLIPTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 49408, hidden_size: int = 512, intermediate_size: int = 2048, num_hidden_layers: int = 12, num_attention_heads: int = 8, max_position_embeddings: int = 77, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/configuration_x_clip.py#L27)
**المعاملات:**
vocab_size (`int`، *اختياري*، القيمة الافتراضية `49408`) : حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطة `input_ids`.
hidden_size (`int`، *اختياري*، القيمة الافتراضية `512`) : بُعد التمثيلات المخفية.
intermediate_size (`int`، *اختياري*، القيمة الافتراضية `2048`) : بُعد تمثيلات MLP.
num_hidden_layers (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد الطبقات المخفية في مُفكِّك Transformer.
num_attention_heads (`int`، *اختياري*، القيمة الافتراضية `8`) : عدد رؤوس الانتباه في كل طبقة انتباه داخل مُفكِّك Transformer.
max_position_embeddings (`int`، *اختياري*، القيمة الافتراضية `77`) : الحد الأقصى لطول التسلسل الذي قد يُستخدم به هذا النموذج.
hidden_act (`str`، *اختياري*، القيمة الافتراضية `quick_gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
layer_norm_eps (`float`، *اختياري*، القيمة الافتراضية `1e-05`) : قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
attention_dropout (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.0`) : نسبة الإسقاط (dropout) لاحتمالات الانتباه.
initializer_range (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
initializer_factor (`float`، *اختياري*، القيمة الافتراضية `1.0`) : معامل لتجميع جميع مصفوفات الأوزان (يجب إبقاؤه عند 1، ويُستخدم داخليًا لاختبارات التهيئة).
pad_token_id (`int`، *اختياري*، القيمة الافتراضية `1`) : معرّف الرمز المستخدم للتعبئة في المفردات.
bos_token_id (`int`، *اختياري*، القيمة الافتراضية `0`) : معرّف الرمز المستخدم لبدء البث في المفردات.
eos_token_id (`Union[int, list[int]]`، *اختياري*، القيمة الافتراضية `2`) : معرّف الرمز المستخدم لنهاية البث في المفردات.
هذه فئة الإعدادات المخزنة لإعدادات نموذج X ClipModel. تُستخدم لاستحداث نموذج X Clip وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ [microsoft/xclip-base-patch32](https://huggingface.co/microsoft/xclip-base-patch32)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
مثال:
```python
>>> from transformers import XCLIPTextModel, XCLIPTextConfig
>>> # Initializing a XCLIPTextModel with microsoft/xclip-base-patch32 style configuration
>>> configuration = XCLIPTextConfig()
>>> # Initializing a XCLIPTextConfig from the microsoft/xclip-base-patch32 style configuration
>>> model = XCLIPTextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## XCLIPVisionConfig[[transformers.XCLIPVisionConfig]]
#### transformers.XCLIPVisionConfig[[transformers.XCLIPVisionConfig]]
```python
transformers.XCLIPVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, mit_hidden_size: int = 512, mit_intermediate_size: int = 2048, mit_num_hidden_layers: int = 1, mit_num_attention_heads: int = 8, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 32, num_frames: int = 8, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0, drop_path_rate: float | int = 0.0)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/configuration_x_clip.py#L65)
**المعاملات:**
hidden_size (`int`، *اختياري*، القيمة الافتراضية `768`) : بُعد التمثيلات المخفية.
intermediate_size (`int`، *اختياري*، القيمة الافتراضية `3072`) : بُعد تمثيلات MLP.
num_hidden_layers (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد الطبقات المخفية في مُفكِّك Transformer.
num_attention_heads (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد رؤوس الانتباه في كل طبقة انتباه داخل مُفكِّك Transformer.
mit_hidden_size (`int`، *اختياري*، القيمة الافتراضية 512) : بُعد طبقات المُشفِّر في محوّل دمج الإطارات متعددة (MIT).
mit_intermediate_size (`int`، *اختياري*، القيمة الافتراضية 2048) : بُعد طبقة "الوسط" (أي طبقة التغذية الأمامية) في محوّل دمج الإطارات متعددة (MIT).
mit_num_hidden_layers (`int`، *اختياري*، القيمة الافتراضية 1) : عدد الطبقات المخفية في محوّل التكامل متعدد الإطارات (Multiframe Integration Transformer).
mit_num_attention_heads (`int`، *اختياري*، القيمة الافتراضية 8) : عدد رؤوس الانتباه لكل طبقة انتباه في محوّل التكامل متعدد الإطارات (MIT).
num_channels (`int`، *اختياري*، القيمة الافتراضية `3`) : عدد قنوات الإدخال.
image_size (`Union[int, list[int], tuple[int, int]]`، *اختياري*، القيمة الافتراضية `224`) : حجم (دقة) كل صورة.
patch_size (`Union[int, list[int], tuple[int, int]]`، *اختياري*، القيمة الافتراضية `32`) : حجم (دقة) كل رقعة.
num_frames (`int`، *اختياري*، القيمة الافتراضية 8) : عدد الإطارات في كل فيديو.
hidden_act (`str`، *اختياري*، القيمة الافتراضية `quick_gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
layer_norm_eps (`float`، *اختياري*، القيمة الافتراضية `1e-05`) : قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
attention_dropout (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.0`) : نسبة الإسقاط (dropout) لاحتمالات الانتباه.
initializer_range (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
initializer_factor (`float`، *اختياري*، القيمة الافتراضية `1.0`) : معامل لتجميع جميع مصفوفات الأوزان (يجب إبقاؤه عند 1، ويُستخدم داخليًا لاختبارات التهيئة).
drop_path_rate (`Union[float, int]`, *اختياري*, القيمة الافتراضية هي `0.0`) : معدل إسقاط المسار لدمج البقع.
هذه فئة الإعدادات المخزنة لإعدادات نموذج X ClipModel. تُستخدم لتوليد نموذج X Clip وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن إنشاء إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ [microsoft/xclip-base-patch32](https://huggingface.co/microsoft/xclip-base-patch32)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
مثال:
```python
>>> from transformers import XCLIPVisionModel, XCLIPVisionConfig
>>> # Initializing a XCLIPVisionModel with microsoft/xclip-base-patch32 style configuration
>>> configuration = XCLIPVisionConfig()
>>> # Initializing a XCLIPVisionModel model from the microsoft/xclip-base-patch32 style configuration
>>> model = XCLIPVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## XCLIPModel[[transformers.XCLIPModel]]
#### transformers.XCLIPModel[[transformers.XCLIPModel]]
```python
transformers.XCLIPModel(config: XCLIPConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L914)
**المعاملات:**
config ([XCLIPConfig](/docs/transformers/main/ar/model_doc/xclip#transformers.XCLIPConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج X Clip الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.XCLIPModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, return_loss: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L981)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/main/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام `image_processor_class`. راجع `image_processor_class.__call__` للتفاصيل (`processor_class` يستخدم `image_processor_class` لمعالجة الصور).
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
position_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
return_loss (`bool`، *اختياري*) : ما إذا كان يجب إرجاع خسارة التباينية أم لا.
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
**يعيد:** `XCLIPOutput` أو `tuple(torch.Tensor)`
A `XCLIPOutput` or a tuple of `torch.Tensor` (if `return_dict=False` is passed or when `config.return_dict=False`) comprising various elements depending on the configuration ([XCLIPConfig](/docs/transformers/main/ar/model_doc/xclip#transformers.XCLIPConfig)) and inputs.
تتجاوز طريقة [XCLIPModel](/docs/transformers/main/ar/model_doc/xclip#transformers.XCLIPModel) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` of shape `(1,)`, *اختياري*, يُعاد عندما تكون `return_loss` هي `True`) -- خسارة تباينية لتقييم التشابه بين الفيديو والنص.
- **logits_per_text** (`torch.Tensor` من الشكل `(text_batch_size, video_batch_size)`) -- درجات ضرب النقطة المُقيَّسة بين `text_embeds` و`video_embeds`. وهذا يمثل درجات التشابه بين النص والفيديو.
- **text_embeds** (`torch.Tensor` من الشكل `(batch_size, output_dim`) -- تمثيلات النص (embeddings) الناتجة عن تطبيق طبقة الإسقاط (projection layer) على المخرجات المجمعة (pooled output) لـ [XCLIPTextModel](/docs/transformers/main/ar/model_doc/xclip#transformers.XCLIPTextModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`، *اختياري*) -- مخرجات [XCLIPTextModel](/docs/transformers/main/ar/model_doc/xclip#transformers.XCLIPTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`، *اختياري*) -- مخرجات [XCLIPVisionModel](/docs/transformers/main/ar/model_doc/xclip#transformers.XCLIPVisionModel).
- **logits_per_video** (`torch.Tensor` من الشكل `(video_batch_size, text_batch_size)`) -- درجات ضرب النقطة المُقيَّسة بين `video_embeds` و`text_embeds`. تمثل هذه الدرجات درجات التشابه بين الفيديو والنص.
- **video_embeds** (`torch.Tensor` من الشكل `(batch_size, output_dim`) -- تمثيلات الفيديو الناتجة عن تطبيق طبقة الإسقاط على المخرجات المجمعة لـ [XCLIPVisionModel](/docs/transformers/main/ar/model_doc/xclip#transformers.XCLIPVisionModel).
- **mit_output** (`~modeling_outputs.BaseModelOutputWithPooling`، *اختياري*) -- مخرجات `XCLIPMultiframeIntegrationTransformer` (اختصار MIT).
أمثلة:
```python
>>> import av
>>> import torch
>>> import numpy as np
>>> from transformers import AutoProcessor, AutoModel
>>> from huggingface_hub import hf_hub_download
>>> np.random.seed(0)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # video clip consists of 300 frames (10 seconds at 30 FPS)
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample 8 frames
>>> indices = sample_frame_indices(clip_len=8, frame_sample_rate=1, seg_len=container.streams.video[0].frames)
>>> video = read_video_pyav(container, indices)
>>> processor = AutoProcessor.from_pretrained("microsoft/xclip-base-patch32")
>>> model = AutoModel.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = processor(
... text=["playing sports", "eating spaghetti", "go shopping"],
... videos=list(video),
... return_tensors="pt",
... padding=True,
... )
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> logits_per_video = outputs.logits_per_video # this is the video-text similarity score
>>> probs = logits_per_video.softmax(dim=1) # we can take the softmax to get the label probabilities
>>> print(probs)
tensor([[1.9496e-04, 9.9960e-01, 2.0825e-04]])
```
#### get_text_features[[transformers.XCLIPModel.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L946)
**المعاملات:**
input_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/main/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
position_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
**يعيد:** [BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو مجموعة مرتبة من `torch.Tensor` (في حال تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([XCLIPConfig](/docs/transformers/main/ar/model_doc/xclip#transformers.XCLIPConfig)) والمدخلات.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> import torch
>>> from transformers import AutoTokenizer, AutoModel
>>> tokenizer = AutoTokenizer.from_pretrained("microsoft/xclip-base-patch32")
>>> model = AutoModel.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_video_features[[transformers.XCLIPModel.get_video_features]]
```python
get_video_features(pixel_values: Tensor, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L1141)
**المعاملات:**
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`) : المصفوفات المتناظرة مع الصور المدخلة. يمكن الحصول على قيم البكسل باستخدام `image_processor_class`. راجع `image_processor_class.__call__` للتفاصيل (`processor_class` يستخدم `image_processor_class` لمعالجة الصور).
**يعيد:** [BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو مجموعة مرتبة من `torch.Tensor` (في حال تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([XCLIPConfig](/docs/transformers/main/ar/model_doc/xclip#transformers.XCLIPConfig)) والمدخلات.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> import av
>>> import torch
>>> import numpy as np
>>> from transformers import AutoProcessor, AutoModel
>>> from huggingface_hub import hf_hub_download
>>> np.random.seed(0)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # video clip consists of 300 frames (10 seconds at 30 FPS)
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample 8 frames
>>> indices = sample_frame_indices(clip_len=8, frame_sample_rate=1, seg_len=container.streams.video[0].frames)
>>> video = read_video_pyav(container, indices)
>>> processor = AutoProcessor.from_pretrained("microsoft/xclip-base-patch32")
>>> model = AutoModel.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = processor(videos=list(video), return_tensors="pt")
>>> video_features = model.get_video_features(**inputs)
```
## XCLIPTextModel[[transformers.XCLIPTextModel]]
#### transformers.XCLIPTextModel[[transformers.XCLIPTextModel]]
```python
transformers.XCLIPTextModel(config: XCLIPTextConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L549)
**المعاملات:**
config ([XCLIPTextConfig](/docs/transformers/main/ar/model_doc/xclip#transformers.XCLIPTextConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج النص من XCLIP دون أي رأس أو إسقاط في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.XCLIPTextModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L563)
**المعاملات:**
input_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/main/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/main/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
position_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
**يعيد:** [BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو مجموعة مرتبة من `torch.Tensor` (في حال تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([XCLIPConfig](/docs/transformers/main/ar/model_doc/xclip#transformers.XCLIPConfig)) والمدخلات.
تتجاوز طريقة [XCLIPTextModel](/docs/transformers/main/ar/model_doc/xclip#transformers.XCLIPTextModel) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from transformers import AutoTokenizer, XCLIPTextModel
>>> model = XCLIPTextModel.from_pretrained("microsoft/xclip-base-patch32")
>>> tokenizer = AutoTokenizer.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled (EOS token) states
```
## XCLIPVisionModel[[transformers.XCLIPVisionModel]]
#### transformers.XCLIPVisionModel[[transformers.XCLIPVisionModel]]
```python
transformers.XCLIPVisionModel(config: XCLIPVisionConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L647)
**المعاملات:**
config ([XCLIPVisionConfig](/docs/transformers/main/ar/model_doc/xclip#transformers.XCLIPVisionConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج الرؤية من XCLIP دون أي رأس أو إسقاط في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.XCLIPVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor], interpolate_pos_encoding: bool | None = False, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L663)
**المعاملات:**
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام `image_processor_class`. راجع `image_processor_class.__call__` للتفاصيل (`processor_class` يستخدم `image_processor_class` لمعالجة الصور).
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
**يعيد:** [BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو مجموعة مرتبة من `torch.Tensor` (في حال تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([XCLIPConfig](/docs/transformers/main/ar/model_doc/xclip#transformers.XCLIPConfig)) والمدخلات.
تتجاوز طريقة [XCLIPVisionModel](/docs/transformers/main/ar/model_doc/xclip#transformers.XCLIPVisionModel) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> import av
>>> import torch
>>> import numpy as np
>>> from transformers import AutoProcessor, XCLIPVisionModel
>>> from huggingface_hub import hf_hub_download
>>> np.random.seed(0)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # video clip consists of 300 frames (10 seconds at 30 FPS)
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample 16 frames
>>> indices = sample_frame_indices(clip_len=8, frame_sample_rate=1, seg_len=container.streams.video[0].frames)
>>> video = read_video_pyav(container, indices)
>>> processor = AutoProcessor.from_pretrained("microsoft/xclip-base-patch32")
>>> model = XCLIPVisionModel.from_pretrained("microsoft/xclip-base-patch32")
>>> pixel_values = processor(videos=list(video), return_tensors="pt").pixel_values
>>> batch_size, num_frames, num_channels, height, width = pixel_values.shape
>>> pixel_values = pixel_values.reshape(-1, num_channels, height, width)
>>> outputs = model(pixel_values)
>>> last_hidden_state = outputs.last_hidden_state
```