# ZoeDepth
[ZoeDepth](https://huggingface.co/papers/2302.12288) هو نموذج لتقدير العمق يجمع بين أداء التعميم في تقدير العمق النسبي (مدى بُعد الكائنات عن بعضها البعض) وتقدير العمق المقنن (قياس دقيق للعمق على مقياس مقنن) من صورة واحدة. تم تدريبه مسبقًا على 12 مجموعة بيانات باستخدام العمق النسبي، وعلى مجموعتي بيانات (NYU Depth v2 وKITTI) لضمان الدقة المقننة. يُستخدم رأس خفيف يحتوي على وحدة تجميع مقنن لكل مجال، وأثناء الاستدلال، يختار تلقائيًا الرأس المناسب لكل صورة مدخلات بواسطة مصنّف كامن.
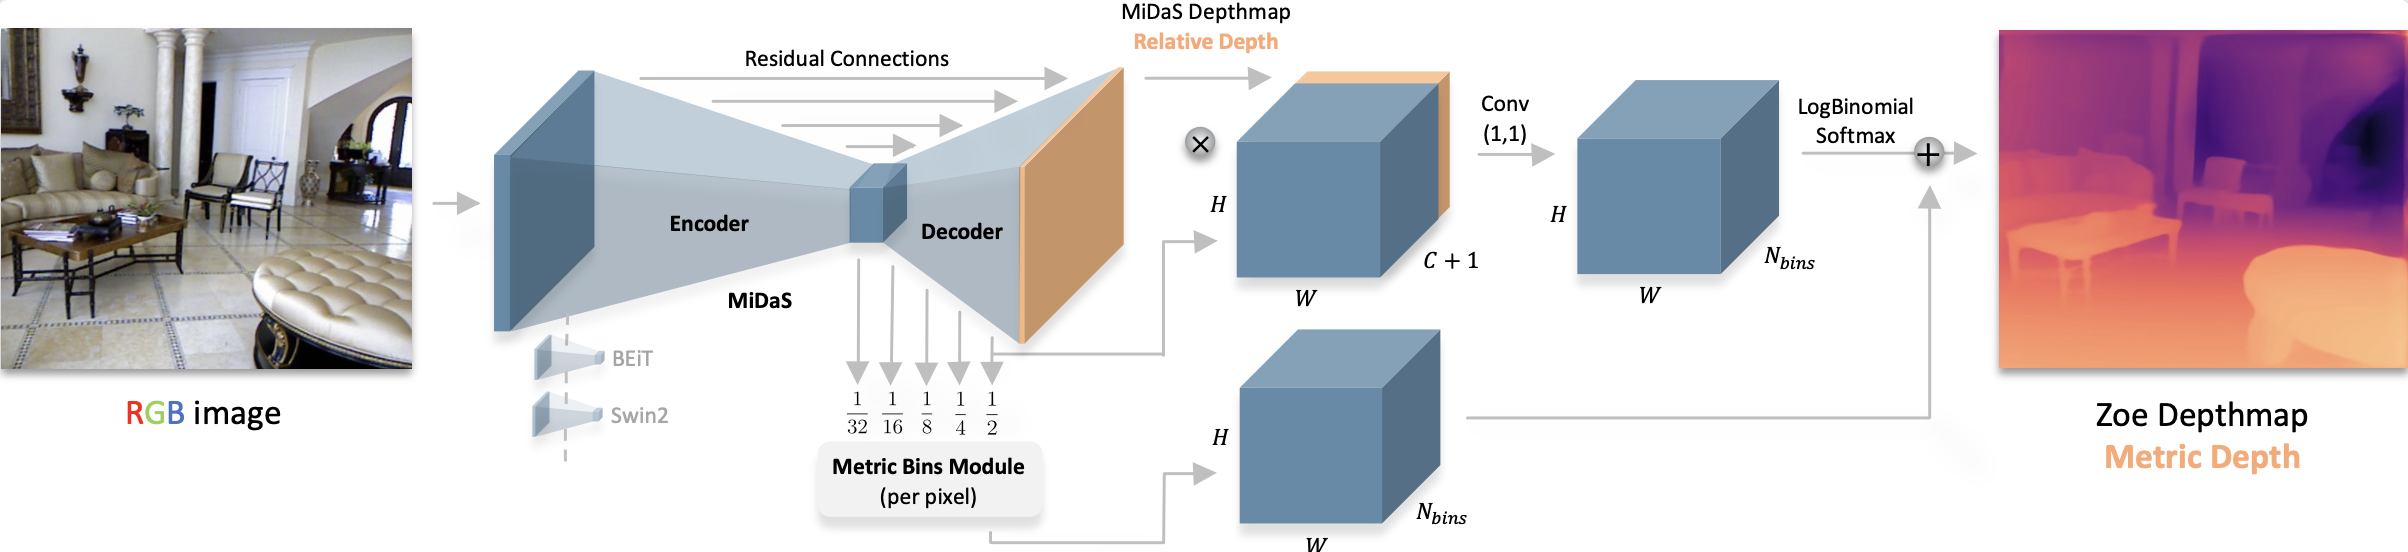 يمكنك العثور على جميع نقاط التفتيش الأصلية لنموذج ZoeDepth تحت منظمة [Intel](https://huggingface.co/Intel?search=zoedepth).
يُبيّن المثال أدناه كيفية تقدير العمق باستخدام [Pipeline](/docs/transformers/main/ar/main_classes/pipelines#transformers.Pipeline) أو فئة [AutoModel](/docs/transformers/main/ar/model_doc/auto#transformers.AutoModel).
```python
import requests
from PIL import Image
from transformers import pipeline
url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"
image = Image.open(requests.get(url, stream=True).raw)
pipeline = pipeline(
task="depth-estimation",
model="Intel/zoedepth-nyu-kitti",
device=0
)
results = pipeline(image)
results["depth"]
```
```python
import requests
import torch
from PIL import Image
from transformers import AutoImageProcessor, AutoModelForDepthEstimation
image_processor = AutoImageProcessor.from_pretrained(
"Intel/zoedepth-nyu-kitti"
)
model = AutoModelForDepthEstimation.from_pretrained(
"Intel/zoedepth-nyu-kitti",
device_map="auto"
)
url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"
image = Image.open(requests.get(url, stream=True).raw)
inputs = image_processor(image, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(inputs)
# interpolate to original size and visualize the prediction
## ZoeDepth dynamically pads the input image, so pass the original image size as argument
## to `post_process_depth_estimation` to remove the padding and resize to original dimensions.
post_processed_output = image_processor.post_process_depth_estimation(
outputs,
source_sizes=[(image.height, image.width)],
)
predicted_depth = post_processed_output[0]["predicted_depth"]
depth = (predicted_depth - predicted_depth.min()) / (predicted_depth.max() - predicted_depth.min())
depth = depth.detach().cpu().numpy() * 255
Image.fromarray(depth.astype("uint8"))
```
## ملاحظات
- في [التنفيذ الأصلي](https://github.com/isl-org/ZoeDepth/blob/edb6daf45458569e24f50250ef1ed08c015f17a7/zoedepth/models/depth_model.py#L131)، يقوم ZoeDepth بتنفيذ الاستدلال على كلٍّ من الصورة الأصلية والصورة المعكوسة، ثم يأخذ متوسط النتائج. يتولى الدالة `post_process_depth_estimation` معالجة ذلك عن طريق تمرير المخرجات المعكوسة إلى الحجة الاختيارية `outputs_flipped` كما هو موضح أدناه.
```py
with torch.no_grad():
outputs = model(pixel_values)
outputs_flipped = model(pixel_values=torch.flip(inputs.pixel_values, dims=[3]))
post_processed_output = image_processor.post_process_depth_estimation(
outputs,
source_sizes=[(image.height, image.width)],
outputs_flipped=outputs_flipped,
)
```
## الموارد
- راجع هذا [دفتر الملاحظات](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/ZoeDepth) لمثال على الاستدلال.
## ZoeDepthConfig[[transformers.ZoeDepthConfig]]
#### transformers.ZoeDepthConfig[[transformers.ZoeDepthConfig]]
```python
transformers.ZoeDepthConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, hidden_act: str = 'gelu', initializer_range: float = 0.02, batch_norm_eps: float = 1e-05, readout_type: typing.Literal['ignore', 'add', 'project'] = 'project', reassemble_factors: list[int | float] | tuple[int | float, ...] = (4, 2, 1, 0.5), neck_hidden_sizes: list[int] | tuple[int, ...] = (96, 192, 384, 768), fusion_hidden_size: int = 256, head_in_index: int = -1, use_batch_norm_in_fusion_residual: bool = False, use_bias_in_fusion_residual: bool | None = None, num_relative_features: int = 32, add_projection: bool = False, bottleneck_features: int = 256, num_attractors: list[int] | tuple[int, ...] = (16, 8, 4, 1), bin_embedding_dim: int = 128, attractor_alpha: int = 1000, attractor_gamma: int = 2, attractor_kind: typing.Literal['mean', 'sum'] = 'mean', min_temp: float = 0.0212, max_temp: float = 50.0, bin_centers_type: str = 'softplus', bin_configurations: list[dict] | None = None, num_patch_transformer_layers: int | None = None, patch_transformer_hidden_size: int | None = None, patch_transformer_intermediate_size: int | None = None, patch_transformer_num_attention_heads: int | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/zoedepth/configuration_zoedepth.py#L32)
**المعاملات:**
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`، *اختياري*) : إعدادات نموذج الهيكل الأساسي.
hidden_act (`str`، *اختياري*، القيمة الافتراضية `gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
initializer_range (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
batch_norm_eps (`float`، *اختياري*، القيمة الافتراضية `1e-05`) : قيمة الإيبسلون المستخدمة في طبقات تطبيع الدفعة.
readout_type (`str`، *اختياري*، القيمة الافتراضية `"project"`) : نوع القراءة (readout) المستخدم عند معالجة رمز القراءة (رمز CLS) للحالات المخفية الوسيطة للعمود الفقري ViT. يمكن أن يكون أحد [`"ignore"`، `"add"`، `"project"`]. - "ignore" يتجاهل رمز CLS ببساطة. - "add" يمرر المعلومات من رمز CLS إلى جميع الرموز الأخرى عن طريق جمع التمثيلات. - "project" يمرر المعلومات إلى الرموز الأخرى عن طريق دمج القراءة مع جميع الرموز الأخرى قبل إسقاط التمثيل إلى بُعد الميزة الأصلي D باستخدام طبقة خطية تليها دالة عدم خطية GELU.
reassemble_factors (`list[int]`، *اختياري*، القيمة الافتراضية `[4, 2, 1, 0.5]`) : عوامل التوسيع/التصغير لطبقات إعادة التجميع.
neck_hidden_sizes (`list[str]`، *اختياري*، القيمة الافتراضية `[96, 192, 384, 768]`) : أحجام الطبقات المخفية التي سيتم الإسقاط إليها لخرائط الميزات الخاصة بالهيكل العظمي.
fusion_hidden_size (`int`، *اختياري*، القيمة الافتراضية 256) : عدد القنوات قبل الدمج.
head_in_index (`int`، *اختياري*، القيمة الافتراضية -1) : فهرس الميزات المستخدمة في الرؤوس.
use_batch_norm_in_fusion_residual (`bool`، *اختياري*، الافتراضي `False`) : ما إذا كان سيتم استخدام تطبيع الدفعة (batch normalization) في وحدات البقايا قبل التفعيل (pre-activate residual units) داخل كتل الدمج (fusion blocks).
use_bias_in_fusion_residual (`bool`، *اختياري*، الافتراضي `True`) : ما إذا كان سيتم استخدام الانحياز في وحدات البقايا قبل التفعيل في كتل الدمج.
num_relative_features (`int`، *اختياري*، القيمة الافتراضية 32) : عدد الميزات المستخدمة في رأس تقدير العمق النسبي.
add_projection (`bool`، *اختياري*، الافتراضي `False`) : ما إذا كان يجب إضافة طبقة إسقاط قبل رأس تقدير العمق.
bottleneck_features (`int`، *اختياري*، القيمة الافتراضية 256) : عدد الميزات في طبقة عنق الزجاجة.
num_attractors (`list[int], *optional*, defaults to `[16, 8, 4, 1]`) : The number of attractors to use in each stage.
bin_embedding_dim (`int`، *اختياري*، القيمة الافتراضية 128) : بُعد تضمينات الفئات.
attractor_alpha (`int`، *اختياري*، القيمة الافتراضية 1000) : قيمة ألفا المستخدمة في الجاذب.
attractor_gamma (`int`، *اختياري*، القيمة الافتراضية 2) : قيمة غاما المستخدمة في الجاذب.
attractor_kind (`str`، *اختياري*، القيمة الافتراضية `"mean"`) : نوع الجاذب (attractor) الذي سيتم استخدامه. يمكن أن يكون أحد القيم التالية: [`"mean"`، `"sum"`].
min_temp (`float`، *اختياري*، القيمة الافتراضية 0.0212) : الحد الأدنى لقيمة درجة الحرارة التي يجب أخذها في الاعتبار.
max_temp (`float`، *اختياري*، القيمة الافتراضية 50.0) : القيمة القصوى لدرجة الحرارة التي يجب أخذها في الاعتبار.
bin_centers_type (`str`، *اختياري*، القيمة الافتراضية `"softplus"`) : نوع التفعيل المستخدم لمراكز الفئات. يمكن أن يكون "normed" أو "softplus". في حالة مراكز الفئات "normed"، يُطبَّق حيلة التطبيع الخطي، مما يؤدي إلى مراكز فئات محدودة. أما في حالة "softplus"، فيُستخدم تفعيل softplus، وبالتالي تكون مراكز الفئات غير محدودة.
bin_configurations (`list[dict]`، *اختياري*، القيمة الافتراضية `[{'n_bins' : 64, 'min_depth': 0.001, 'max_depth': 10.0}]`): إعدادات لكل رأس من رؤوس التقسيم. يجب أن تتكون كل إعدادات من المفاتيح التالية: - name (`str`): اسم رأس التقسيم - مطلوب فقط في حالة وجود عدة إعدادات للتقسيم. - `n_bins` (`int`): عدد التقسيمات المستخدمة. - `min_depth` (`float`): قيمة العمق الدنيا التي يجب أخذها في الاعتبار. - `max_depth` (`float`): قيمة العمق القصوى التي يجب أخذها في الاعتبار. في حالة تمرير إعداد واحد فقط، سيقوم النموذج باستخدام رأس واحد مع الإعداد المحدد. في حالة تمرير عدة إعدادات، سيقوم النموذج باستخدام عدة رؤوس مع الإعدادات المحددة.
num_patch_transformer_layers (`int`، *اختياري*) : عدد طبقات التحوّل (transformer) المستخدمة في مُحوّل الباتش (patch transformer). يُستخدم فقط في حالة وجود تكوينات متعددة للثوابت (bins).
patch_transformer_hidden_size (`int`، *اختياري*) : حجم الطبقة المخفية الذي سيُستخدم في محوّل الباتش. يُستخدم فقط في حالة وجود إعدادات متعددة للوحدات.
patch_transformer_intermediate_size (`int`، *اختياري*) : الحجم الوسيط المستخدم في محوّل الباتش. يُستخدم فقط في حالة وجود تكوينات متعددة للثوابت.
patch_transformer_num_attention_heads (`int`, *اختياري*) : عدد رؤوس الانتباه (attention heads) المستخدمة في محوّل الباتش (patch transformer). يُستخدم فقط في حالة وجود تكوينات متعددة للثوابت (bin configurations).
هذه فئة الإعدادات المخزنة لإعدادات نموذج ZoedepthModel. تُستخدم لتوليد نموذج Zoedepth وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن إنشاء فئة الإعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ [Intel/zoedepth-nyu](https://huggingface.co/Intel/zoedepth-nyu)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
مثال:
```python
>>> from transformers import ZoeDepthConfig, ZoeDepthForDepthEstimation
>>> # Initializing a ZoeDepth zoedepth-large style configuration
>>> configuration = ZoeDepthConfig()
>>> # Initializing a model from the zoedepth-large style configuration
>>> model = ZoeDepthForDepthEstimation(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ZoeDepthImageProcessor[[transformers.ZoeDepthImageProcessor]]
#### transformers.ZoeDepthImageProcessor[[transformers.ZoeDepthImageProcessor]]
```python
transformers.ZoeDepthImageProcessor(**kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/zoedepth/image_processing_zoedepth.py#L105)
**المعاملات:**
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*، الافتراضي هو `True`) : ما إذا كان سيتم تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*، القيمة الافتراضية `{'height' : 384, 'width': 512}`): يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم من نوع عدد صحيح.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`، *kwargs*، القيمة الافتراضية `2`) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعداد `PILImageResampling`. لا يؤثر إلا إذا كانت قيمة `do_resize` هي `True`.
do_rescale (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*، القيمة الافتراضية هي `0.00392156862745098`) : عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطاً على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية هي `[0.5, 0.5, 0.5]`) : متوسط الصورة المستخدم للتطبيع. لا يكون له تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية هي `[0.5, 0.5, 0.5]`) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم إضافة حشوة إلى الصورة. تتم الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
keep_aspect_ratio (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية هي `self.keep_aspect_ratio`) : إذا كانت `True`، يتم تغيير حجم الصورة عن طريق اختيار أصغر عاملَي توسيع بين الارتفاع والعرض واستخدامه لكلا البعدين. يضمن هذا أن يتم تصغير الصورة بأقل قدر ممكن مع ضمان ملاءمتها ضمن حجم الإخراج المطلوب. في حال تم ضبط `ensure_multiple_of` أيضاً، يتم تغيير حجم الصورة مرة أخرى إلى حجم يكون مضاعفاً لهذه القيمة عن طريق تقريب الارتفاع والعرض إلى أقرب مضاعف لهذه القيمة. يمكن تجاوز ذلك بواسطة `keep_aspect_ratio` في `preprocess`.
ensure_multiple_of (`int`، *kwargs*، *اختياري*، القيمة الافتراضية هي `self.ensure_multiple_of`) : إذا كانت `do_resize` تساوي `True`، يتم تغيير حجم الصورة إلى حجم يكون مضاعفاً لهذه القيمة. يعمل عن طريق تقريب الارتفاع والعرض إلى أقرب مضاعف لهذه القيمة. يعمل سواء مع أو بدون تعيين `keep_aspect_ratio` إلى `True`. يمكن تجاوزها بواسطة `ensure_multiple_of` في `preprocess`.
ينشئ معالج صور ZoeDepthImageProcessor.
#### preprocess[[transformers.ZoeDepthImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/zoedepth/image_processing_zoedepth.py#L121)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : الصورة المراد معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم عددًا صحيحًا.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كان `do_resize` مضبوطاً على `True`.
do_rescale (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*) : معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطًا على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
keep_aspect_ratio (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية هي `self.keep_aspect_ratio`) : إذا كانت `True`، يتم تغيير حجم الصورة عن طريق اختيار أصغر عاملَي توسيع بين الارتفاع والعرض واستخدامه لكلا البعدين. يضمن ذلك تصغير الصورة بأقل قدر ممكن مع ضمان ملاءمتها ضمن حجم الإخراج المطلوب. في حال تم ضبط `ensure_multiple_of` أيضاً، يتم تغيير حجم الصورة مرة أخرى إلى حجم يكون مضاعفاً لهذه القيمة عن طريق تقريب الارتفاع والعرض إلى أقرب مضاعف لهذه القيمة. يمكن تجاوز ذلك بواسطة `keep_aspect_ratio` في `preprocess`.
ensure_multiple_of (`int`، *kwargs*، *اختياري*، القيمة الافتراضية هي `self.ensure_multiple_of`) : إذا كانت `do_resize` هي `True`، يتم تغيير حجم الصورة إلى حجم يكون مضاعفاً لهذه القيمة. يعمل عن طريق تقريب الارتفاع والعرض إلى أقرب مضاعف لهذه القيمة. يعمل سواء مع أو بدون تعيين `keep_aspect_ratio` إلى `True`. يمكن تجاوزها بواسطة `ensure_multiple_of` في `preprocess`.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
## ZoeDepthImageProcessorPil[[transformers.ZoeDepthImageProcessorPil]]
#### transformers.ZoeDepthImageProcessorPil[[transformers.ZoeDepthImageProcessorPil]]
```python
transformers.ZoeDepthImageProcessorPil(**kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/zoedepth/image_processing_pil_zoedepth.py#L113)
**المعاملات:**
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*، الافتراضي هو `True`) : ما إذا كان سيتم تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*، القيمة الافتراضية `{'height' : 384, 'width': 512}`): يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم من نوع عدد صحيح.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`، *kwargs*، القيمة الافتراضية `2`) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعداد `PILImageResampling`. لا يؤثر إلا إذا كانت قيمة `do_resize` هي `True`.
do_rescale (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*، القيمة الافتراضية هي `0.00392156862745098`) : عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطاً على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية هي `[0.5, 0.5, 0.5]`) : متوسط الصورة المستخدم للتطبيع. لا يكون له تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية هي `[0.5, 0.5, 0.5]`) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم إضافة حشوة إلى الصورة. تتم الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
keep_aspect_ratio (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية هي `self.keep_aspect_ratio`) : إذا كانت `True`، يتم تغيير حجم الصورة عن طريق اختيار أصغر عاملَي توسيع بين الارتفاع والعرض واستخدامه لكلا البعدين. يضمن هذا أن يتم تصغير الصورة بأقل قدر ممكن مع ضمان ملاءمتها ضمن حجم الإخراج المطلوب. في حال تم ضبط `ensure_multiple_of` أيضاً، يتم تغيير حجم الصورة مرة أخرى إلى حجم يكون مضاعفاً لهذه القيمة عن طريق تقريب الارتفاع والعرض إلى أقرب مضاعف لهذه القيمة. يمكن تجاوز ذلك بواسطة `keep_aspect_ratio` في `preprocess`.
ensure_multiple_of (`int`، *kwargs*، *اختياري*، القيمة الافتراضية هي `self.ensure_multiple_of`) : إذا كانت `do_resize` هي `True`، يتم تغيير حجم الصورة إلى حجم يكون مضاعفاً لهذه القيمة. يعمل عن طريق تقريب الارتفاع والعرض إلى أقرب مضاعف لهذه القيمة. يعمل سواء مع أو بدون تعيين `keep_aspect_ratio` إلى `True`. يمكن تجاوزها بواسطة `ensure_multiple_of` في `preprocess`.
ينشئ معالج صور ZoeDepthImageProcessor.
#### preprocess[[transformers.ZoeDepthImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/zoedepth/image_processing_pil_zoedepth.py#L129)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : الصورة المراد معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم عددًا صحيحًا.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كان `do_resize` مضبوطاً على `True`.
do_rescale (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*) : معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطًا على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
keep_aspect_ratio (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية هي `self.keep_aspect_ratio`) : إذا كانت `True`، يتم تغيير حجم الصورة عن طريق اختيار أصغر عاملَي توسيع بين الارتفاع والعرض واستخدامه لكلا البعدين. يضمن هذا أن يتم تصغير الصورة بأقل قدر ممكن مع ضمان ملاءمتها ضمن حجم الإخراج المطلوب. في حال تم ضبط `ensure_multiple_of` أيضاً، يتم تغيير حجم الصورة مرة أخرى إلى حجم يكون مضاعفاً لهذه القيمة عن طريق تقريب الارتفاع والعرض إلى أقرب مضاعف لهذه القيمة. يمكن تجاوز ذلك بواسطة `keep_aspect_ratio` في `preprocess`.
ensure_multiple_of (`int`، *kwargs*، *اختياري*، القيمة الافتراضية هي `self.ensure_multiple_of`) : إذا كانت `do_resize` تساوي `True`، يتم تغيير حجم الصورة إلى حجم يكون مضاعفاً لهذه القيمة. يعمل عن طريق تقريب الارتفاع والعرض إلى أقرب مضاعف لهذه القيمة. يعمل سواء مع أو بدون تعيين `keep_aspect_ratio` إلى `True`. يمكن تجاوزها بواسطة `ensure_multiple_of` في `preprocess`.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
## ZoeDepthForDepthEstimation[[transformers.ZoeDepthForDepthEstimation]]
#### transformers.ZoeDepthForDepthEstimation[[transformers.ZoeDepthForDepthEstimation]]
```python
transformers.ZoeDepthForDepthEstimation(config: ZoeDepthConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/zoedepth/modeling_zoedepth.py#L1224)
**المعاملات:**
config ([ZoeDepthConfig](/docs/transformers/main/ar/model_doc/zoedepth#transformers.ZoeDepthConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج ZoeDepth مع رأس واحد أو عدة رؤوس لتقدير العمق القياسي في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.ZoeDepthForDepthEstimation.forward]]
```python
forward(pixel_values: Tensor, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/zoedepth/modeling_zoedepth.py#L1250)
**المعاملات:**
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`) : المصفوفات المتناظرة مع الصور المدخلة. يمكن الحصول على قيم البكسل باستخدام [ZoeDepthImageProcessor](/docs/transformers/main/ar/model_doc/zoedepth#transformers.ZoeDepthImageProcessor). راجع [ZoeDepthImageProcessor.__call__()](/docs/transformers/main/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل (`processor_class` يستخدم [ZoeDepthImageProcessor](/docs/transformers/main/ar/model_doc/zoedepth#transformers.ZoeDepthImageProcessor) لمعالجة الصور).
labels (`torch.LongTensor` من الشكل `(batch_size, height, width)`، *اختياري*) : خرائط تقدير العمق الصحيحة (Ground truth) لحساب الخسارة.
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/main/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
**يعيد:** [DepthEstimatorOutput](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.DepthEstimatorOutput) أو `tuple(torch.Tensor)`
[DepthEstimatorOutput](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.DepthEstimatorOutput) أو مجموعة مرتبة من `torch.Tensor` (في حال تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([ZoeDepthConfig](/docs/transformers/main/ar/model_doc/zoedepth#transformers.ZoeDepthConfig)) والمدخلات.
تُعيد طريقة [ZoeDepthForDepthEstimation](/docs/transformers/main/ar/model_doc/zoedepth#transformers.ZoeDepthForDepthEstimation) الخاصة بالتقديم (forward) تعريف الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`, *اختياري*، يُعاد عند تقديم `labels`) -- خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).
- **predicted_depth** (`torch.Tensor` من الشكل `(batch_size, height, width)`) -- العمق المتوقع لكل بكسل.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات الطبقات المضمنة إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, num_channels, height, width)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة (Tuple) من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, patch_size, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from transformers import AutoImageProcessor, ZoeDepthForDepthEstimation
>>> import torch
>>> import numpy as np
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("Intel/zoedepth-nyu-kitti")
>>> model = ZoeDepthForDepthEstimation.from_pretrained("Intel/zoedepth-nyu-kitti")
>>> # prepare image for the model
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> # interpolate to original size
>>> post_processed_output = image_processor.post_process_depth_estimation(
... outputs,
... source_sizes=[(image.height, image.width)],
... )
>>> # visualize the prediction
>>> predicted_depth = post_processed_output[0]["predicted_depth"]
>>> depth = predicted_depth * 255 / predicted_depth.max()
>>> depth = depth.detach().cpu().numpy()
>>> depth = Image.fromarray(depth.astype("uint8"))
```