# MarkupLM
## 概要
MarkupLMモデルは、Junlong Li、Yiheng Xu、Lei Cui、Furu Wei による [MarkupLM: Pre-training of Text and Markup Language for Visually-rich Document Understanding](https://huggingface.co/papers/2110.08518) で提案されました。MarkupLM は BERT をベースにしており、生のテキスト文書ではなく HTML ページに適用します。このモデルは、[LayoutLM](layoutlm) と同様に、パフォーマンスを向上させるために追加の埋め込み層を組み込んでいます。
このモデルは、Webページでの質問応答やWebページからの情報抽出などのタスクに使用できます。2つの重要なベンチマークで最先端の結果を達成しています:
- Webベースの構造化読解(SQuADに似ていますが、Webページを対象としたもの)用のデータセットである[WebSRC](https://x-lance.github.io/WebSRC/)
- [SWDE](https://www.researchgate.net/publication/221299838_From_one_tree_to_a_forest_a_unified_solution_for_structured_web_data_extraction)、データセット
Webページからの情報抽出(基本的にはWebページにおける名前実体認識)
論文の抄録は以下の通りです。
*テキスト、レイアウト、画像を用いたマルチモーダル事前学習は、Visually-rich Document Understanding (VrDU) の分野で大きな進歩を遂げており、スキャンされた文書画像のような固定レイアウトの文書において特に顕著です。一方で、レイアウト情報が固定されておらず、可視化のためにインタラクティブかつ動的にレンダリングされる必要があるデジタル文書も依然として多く存在し、既存のレイアウトベースの事前学習アプローチを適用しにくい状況にあります。本論文では、HTML/XML ベースの文書のようにマークアップ言語を基盤とする文書理解タスク向けに、MarkupLM を提案します。MarkupLM では、テキスト情報とマークアップ情報を統合して事前学習を行います。実験結果により、事前学習済み MarkupLM は、複数の文書理解タスクにおいて既存の強力なベースラインモデルを大きく上回ることが示されました。事前学習済みモデルとコードは公開予定です。*
このモデルは [nielsr](https://huggingface.co/nielsr) によって提供されました。元のコードは [こちら](https://github.com/microsoft/unilm/tree/master/markuplm) で確認できます。
## 使用のコツ
- `input_ids`に加えて、[forward()](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMModel.forward)は`xpath_tags_seq`と`xpath_subs_seq`という2つの追加の入力を期待します。
これらは、入力シーケンス内の各トークンに対応する XPATH タグおよび下付き文字です。
- [MarkupLMProcessor](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMProcessor) を使用して、モデル用のすべてのデータを準備できます。詳細は[使用ガイド](#usage-markuplmprocessor)を参照してください。
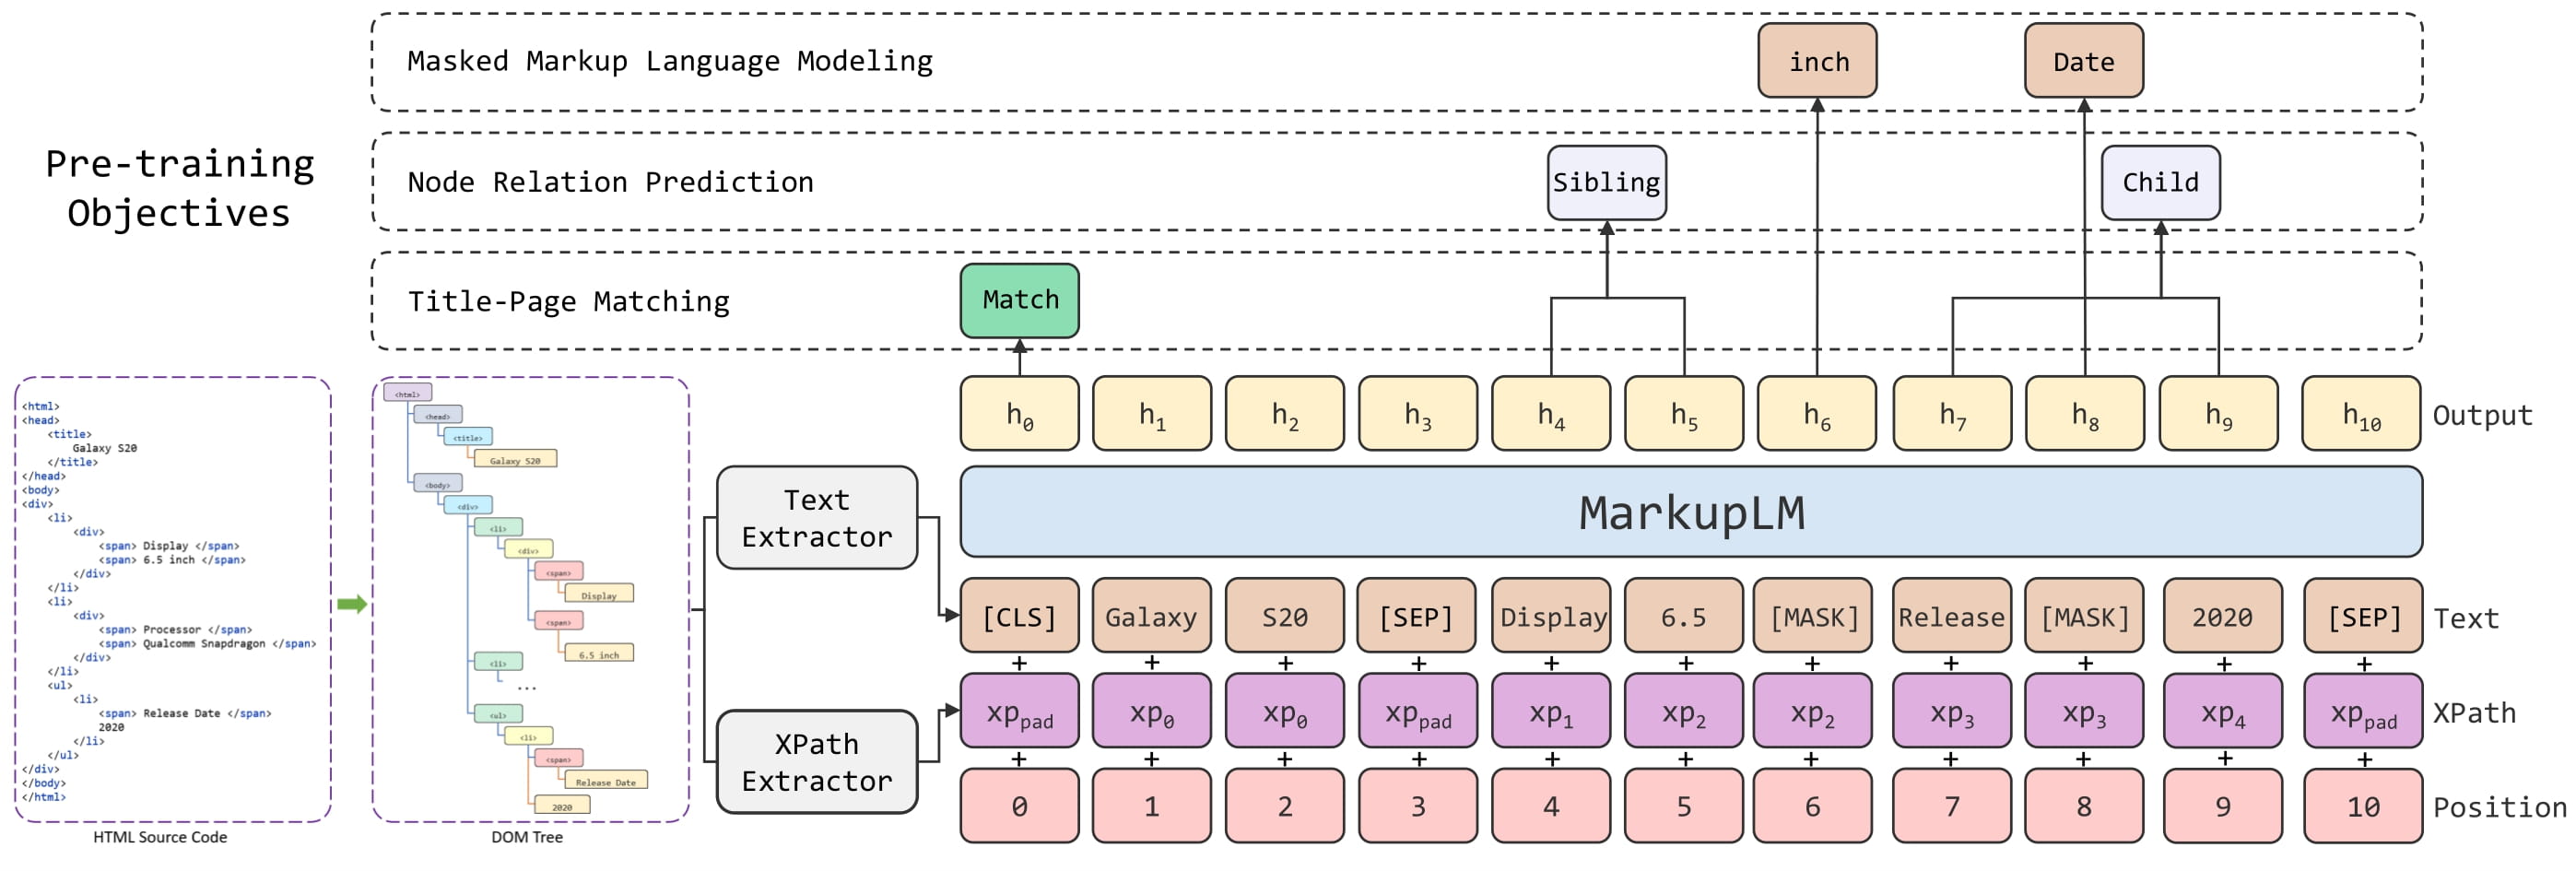 MarkupLM のアーキテクチャ。元の論文より引用。
## 使用法: MarkupLMProcessor
モデル用のデータを準備する最も簡単な方法は、[MarkupLMProcessor](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMProcessor)を使用することです。これは内部で、フィーチャーエクストラクター([MarkupLMFeatureExtractor](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMFeatureExtractor))とトークナイザー([MarkupLMTokenizer](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMTokenizer)または[MarkupLMTokenizerFast](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMTokenizer))を組み合わせます。フィーチャーエクストラクターは、HTML文字列からすべてのノードとxpathを抽出するために使用され、それらはトークナイザーに渡されて、モデルのトークンレベルの入力(`input_ids`など)に変換されます。なお、2つのタスクのいずれかのみを処理したい場合は、フィーチャーエクストラクターとトークナイザーを個別に使用することもできます。
```python
from transformers import MarkupLMFeatureExtractor, MarkupLMProcessor, MarkupLMTokenizerFast
feature_extractor = MarkupLMFeatureExtractor()
tokenizer = MarkupLMTokenizerFast.from_pretrained("microsoft/markuplm-base")
processor = MarkupLMProcessor(feature_extractor, tokenizer)
```
簡潔に述べると、[MarkupLMProcessor](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMProcessor)にHTML文字列(および追加データ)を渡すことで、モデルが期待する入力が作成されます。内部では、プロセッサはまず[MarkupLMFeatureExtractor](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMFeatureExtractor)を使用して、ノードのリストと対応するxpathを取得します。その後、ノードとxpathは[MarkupLMTokenizer](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMTokenizer)または[MarkupLMTokenizerFast](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMTokenizer)に渡され、これらはそれらをトークンレベルの`input_ids`、`attention_mask`、`token_type_ids`、`xpath_subs_seq`、`xpath_tags_seq`に変換します。オプションとして、プロセッサにノードラベルを渡すこともでき、これらはトークンレベルの`labels`に変換されます。
[MarkupLMFeatureExtractor](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMFeatureExtractor) は、HTML や XML ファイルからデータを抽出するための Python ライブラリである [Beautiful Soup](https://www.crummy.com/software/BeautifulSoup/bs4/doc/) を内部で使用しています。なお、ご自身で選択したパース処理を使用し、[MarkupLMTokenizer](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMTokenizer) または [MarkupLMTokenizerFast](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMTokenizer) にノードと xpath を直接提供することも可能です。
プロセッサがサポートするユースケースは合計5つあります。以下にすべてを列挙します。これらのユースケースは、バッチ入力および非バッチ入力の両方で動作します(ここでは非バッチ入力を例として説明します)。
**ユースケース1: Webページ分類(学習、推論)+ トークン分類(推論)、parse_html = True**
これは最もシンプルなケースであり、プロセッサはフィーチャーエクストラクターを使用して、HTMLからすべてのノードとxpathを取得します。
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
html_string = """
Hello world
Welcome
Here is my website.
"""
# note that you can also add provide all tokenizer parameters here such as padding, truncation
encoding = processor(html_string, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**ユースケース2: Webページ分類(学習、推論)+ トークン分類(推論)、parse_html=False**
すでにすべてのノードとxpathを取得済みの場合、feature extractorは不要です。その場合は、ノードと対応するxpathを自分でprocessorに渡し、`parse_html`を`False`に設定してください。
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
encoding = processor(nodes=nodes, xpaths=xpaths, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**ユースケース3: トークン分類(学習)、parse_html=False**
トークン分類タスク([SWDE](https://paperswithcode.com/dataset/swde)など)では、モデルを訓練するために対応するノードラベルを指定することもできます。プロセッサはこれらをトークンレベルの`labels`に変換します。デフォルトでは、単語の最初のwordpieceのみラベルを付け、残りのwordpieceには-100をラベルとして付けます。これはPyTorchのCrossEntropyLossの`ignore_index`です。単語のすべてのwordpieceにラベルを付けたい場合は、`only_label_first_subword`を`False`に設定してトークナイザを初期化できます。
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
node_labels = [1, 2, 2, 1]
encoding = processor(nodes=nodes, xpaths=xpaths, node_labels=node_labels, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq', 'labels'])
```
**ユースケース4: Webページの質問応答(推論)、parse_html=True**
Webページ上の質問応答タスクでは、プロセッサーに質問を渡すことができます。デフォルトでは、プロセッサーはフィーチャーエクストラクターを使用してすべてのノードとXPathを取得し、[CLS] question tokens [SEP] word tokens [SEP]を作成します。
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
html_string = """
Hello world
Welcome
My name is Niels.
"""
question = "What's his name?"
encoding = processor(html_string, questions=question, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**ユースケース 5: Web ページの質問応答(推論)、parse_html=False**
質問応答タスク(WebSRC など)では、プロセッサーに質問を渡すことができます。すべてのノードと xpath を自分で抽出した場合は、それらをプロセッサーに直接渡すことができます。`parse_html` を `False` に設定することを忘れないでください。
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
question = "What's his name?"
encoding = processor(nodes=nodes, xpaths=xpaths, questions=question, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
## リソース
- [デモノートブック](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/MarkupLM)
- [テキスト分類タスクガイド](../tasks/sequence_classification)
- [トークン分類タスクガイド](../tasks/token_classification)
- [質問応答タスクガイド](../tasks/question_answering)
## MarkupLMConfig[[transformers.MarkupLMConfig]]
#### transformers.MarkupLMConfig[[transformers.MarkupLMConfig]]
```python
transformers.MarkupLMConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 512, type_vocab_size: int = 2, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, max_xpath_tag_unit_embeddings: int = 256, max_xpath_subs_unit_embeddings: int = 1024, tag_pad_id: int = 216, subs_pad_id: int = 1001, xpath_unit_hidden_size: int = 32, max_depth: int = 50, use_cache: bool = True, classifier_dropout: float | int | None = None)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/configuration_markuplm.py#L24)
**パラメータ:**
vocab_size (`int`、*任意*、デフォルトは`30522`) : モデルの語彙サイズ。`input_ids`で表現できるトークンの種類数を定義します。
hidden_size (`int`、*任意*、デフォルトは`768`) : 隠れ表現の次元数。
num_hidden_layers (`int`, *任意*, デフォルトは `12`) : Transformer デコーダーの隠れ層の数。
num_attention_heads (`int`、*任意*、デフォルトは `12`) : Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。
intermediate_size (`int`、*任意*、デフォルトは `3072`) : MLP 表現の次元数。
hidden_act (`str`、*任意*、デフォルトは`gelu`) : デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、`"gelu"`、`"relu"`、`"silu"`など。
hidden_dropout_prob (`Union[float, int]`、*任意*、デフォルト値は`0.1`) : embeddings、encoder、pooler 内のすべての全結合層における dropout 確率。
attention_probs_dropout_prob (`Union[float, int]`、*任意*、デフォルトは`0.1`) : 注意確率のドロップアウト率。
max_position_embeddings (`int`、*任意*、デフォルトは`512`) : このモデルが使用される可能性のある最大シーケンス長。
type_vocab_size (`int`、*任意*、デフォルトは`2`) : `token_type_ids`の語彙サイズ。
initializer_range (`float`、*任意*、デフォルトは`0.02`) : すべての重み行列を初期化するためのtruncated_normal_initializerの標準偏差です。
layer_norm_eps (`float`、*任意*、デフォルトは `1e-12`) : layer normalization レイヤーで使用する epsilon。
pad_token_id (`int`, *任意*, デフォルトは `0`) : 語彙内でパディングに使用されるトークン ID。
bos_token_id (`int`, *optional*, デフォルトは `0`) : 語彙内でストリームの開始に使用されるトークン ID。
eos_token_id (`Union[int, list[int]]`、*任意*、デフォルトは`2`) : 語彙内でストリーム終了に使用されるトークン ID。
max_xpath_tag_unit_embeddings (`int`、*optional*、デフォルトは 256) : xpath タグのユニット埋め込みが使用する可能性のある最大値です。念のため、通常は大きな値(例: 256)に設定します。
max_xpath_subs_unit_embeddings (`int`、*optional*、デフォルト値は 1024) : xpath 部分文字列単位の埋め込みが使用する可能性のある最大値です。念のため、通常は大きな値(例: 1024)に設定します。
tag_pad_id (`int`、*optional*、デフォルト値は 216) : xpath タグにおける padding トークンの id。
subs_pad_id (`int`、*optional*、デフォルト値は 1001) : xpath 部分文字列における padding トークンの id。
xpath_unit_hidden_size (`int`、*任意*、デフォルトは 32) : xpath の各ユニットの隠れ層サイズです。
max_depth (`int`、*任意*、デフォルトは 50) : xpath の最大深度。
use_cache (`bool`、*任意*、デフォルトは `True`) : モデルが最後のキー/バリューアテンションを返すかどうか(すべてのモデルで利用されるわけではありません)。`config.is_decoder=True` の場合、またはモデルがデコーダー専用の生成モデルである場合にのみ関連します。
classifier_dropout (`Union[float, int]`、*任意*) : クラス分類器の dropout 率。
This is the configuration class to store the configuration of a MarkupLMModel. It is used to instantiate a Markuplm model according to the specified arguments, defining the model architecture. Instantiating a configuration with the defaults will yield a similar configuration to that of the [microsoft/markuplm-base](https://huggingface.co/microsoft/markuplm-base)
設定オブジェクトは [PreTrainedConfig](/docs/transformers/main/ja/main_classes/configuration#transformers.PreTrainedConfig) を継承し、モデルの出力を制御するために使用できます。詳細については、[PreTrainedConfig](/docs/transformers/main/ja/main_classes/configuration#transformers.PreTrainedConfig) のドキュメントを参照してください。
例:
```python
>>> from transformers import MarkupLMModel, MarkupLMConfig
>>> # Initializing a MarkupLM microsoft/markuplm-base style configuration
>>> configuration = MarkupLMConfig()
>>> # Initializing a model from the microsoft/markuplm-base style configuration
>>> model = MarkupLMModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## MarkupLMFeatureExtractor[[transformers.MarkupLMFeatureExtractor]]
#### transformers.MarkupLMFeatureExtractor[[transformers.MarkupLMFeatureExtractor]]
```python
transformers.MarkupLMFeatureExtractor(**kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/feature_extraction_markuplm.py#L32)
MarkupLM の特徴抽出器を構築します。これにより、HTML 文字列からノードのリストと対応する xpath を取得できます。
この feature extractor は、`PreTrainedFeatureExtractor()` を継承しており、主要なメソッドのほとんどが含まれています。これらのメソッドに関する詳細については、このスーパークラスを参照してください。
#### __call__[[transformers.MarkupLMFeatureExtractor.__call__]]
```python
__call__(html_strings)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/feature_extraction_markuplm.py#L98)
**パラメータ:**
html_strings (`str`, `list[str]`) : ノードと対応するxpathを抽出するHTML文字列、またはHTML文字列のバッチ。
**戻り値:** [BatchFeature](/docs/transformers/main/ja/main_classes/feature_extractor#transformers.BatchFeature)
以下のフィールドを持つ[BatchFeature](/docs/transformers/main/ja/main_classes/feature_extractor#transformers.BatchFeature):
- **nodes** -- ノード。
- **xpaths** -- 対応する xpaths。
モデルに1つまたは複数のHTML文字列を準備するための主要なメソッドです。
例:
```python
>>> from transformers import MarkupLMFeatureExtractor
>>> page_name_1 = "page1.html"
>>> page_name_2 = "page2.html"
>>> page_name_3 = "page3.html"
>>> with open(page_name_1) as f:
... single_html_string = f.read()
>>> feature_extractor = MarkupLMFeatureExtractor()
>>> # single example
>>> encoding = feature_extractor(single_html_string)
>>> print(encoding.keys())
>>> # dict_keys(['nodes', 'xpaths'])
>>> # batched example
>>> multi_html_strings = []
>>> with open(page_name_2) as f:
... multi_html_strings.append(f.read())
>>> with open(page_name_3) as f:
... multi_html_strings.append(f.read())
>>> encoding = feature_extractor(multi_html_strings)
>>> print(encoding.keys())
>>> # dict_keys(['nodes', 'xpaths'])
```
## MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
#### transformers.MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
```python
transformers.MarkupLMTokenizer(tags_dict, vocab: str | dict[str, int] | list[tuple[str, float]] | None = None, merges: str | list[str] | None = None, errors = 'replace', bos_token = '', eos_token = '', sep_token = '', cls_token = '', unk_token = '', pad_token = '', mask_token = '', add_prefix_space = False, max_depth = 50, max_width = 1000, pad_width = 1001, pad_token_label = -100, only_label_first_subword = True, trim_offsets = False, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L91)
**パラメータ:**
vocab (`str` または `dict[str, int]`、*省略可*) : カスタムの語彙辞書です。指定しない場合、`vocab_file` から語彙が読み込まれます。
merges (`str` または `list[str]`、*省略可能*) : カスタムなマージリストです。指定しない場合、`merges_file` からマージが読み込まれます。
errors (`str`、*任意*、デフォルトは`"replace"`) : バイトを UTF-8 にデコードする際に従うパラダイム。詳細は[bytes.decode](https://docs.python.org/3/library/stdtypes.html#bytes.decode)を参照してください。
bos_token (`str`、*任意*、デフォルトは `""`) : 事前学習で使用されたシーケンスの開始トークンです。シーケンス分類器のトークンとして使用できます。 特殊トークンを使用してシーケンスを構築する場合は、シーケンスの開始にこのトークンは使用されません。使用されるのは `cls_token` です。
eos_token (`str`、*任意*、デフォルトは`""`) : シーケンスの終了トークン。特殊トークンを使用してシーケンスを構築する場合は、シーケンスの終了に使用されるトークンではありません。使用されるトークンは`sep_token`です。
sep_token (`str`、*任意*、デフォルトは `""`) : 区切りトークンです。複数のシーケンスからシーケンスを構築する際に使用されます。例えば、シーケンス分類では2つのシーケンス、質問応答ではテキストと質問です。また、特殊トークンを用いて構築されたシーケンスの最後のトークンとしても使用されます。
cls_token (`str`、*任意*、デフォルトは `""`) : シーケンス分類(トークンごとの分類ではなく、シーケンス全体に対する分類)を行う際に使用される分類トークンです。特殊トークンを用いて構築された場合、シーケンスの最初のトークンになります。
unk_token (`str`、*任意*、デフォルトは `""`) : 不明トークン。語彙に存在しないトークンは ID に変換できず、代わりにこのトークンが設定されます。
pad_token (`str`、*任意*、デフォルトは `""`) : パディングに使用されるトークンです。長さの異なるシーケンスをバッチ処理する場合などに使用します。
mask_token (`str`、*任意*、デフォルトは `""`) : 値をマスクするために使用されるトークンです。これは、マスク言語モデリングでこのモデルを訓練する際に使用されるトークンです。モデルが予測しようとするトークンです。
add_prefix_space (`bool`、*任意*、デフォルトは`False`) : 入力に先頭スペースを追加するかどうか。これにより、先頭の単語を他の単語と同様に扱うことができます。(RoBERTa トークナイザーは、先行するスペースによって単語の先頭を検出します)。
MarkupLMのトークナイザーを構築します。バイトレベルのByte-Pair-Encoding (BPE)に基づいています。
[MarkupLMTokenizer](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMTokenizer) は、HTML 文字列をトークンレベルの `input_ids`、`attention_mask`、`token_type_ids`、`xpath_tags_seq` および `xpath_tags_seq` に変換するために使用できます。このトークナイザーは [TokenizersBackend](/docs/transformers/main/ja/main_classes/tokenizer#transformers.TokenizersBackend) を継承しており、主要なメソッドの大部分を備え、`tokenizers` バックエンドが常にインスタンス化されることを保証します。
これらのメソッドに関する詳細については、このスーパークラスを参照してください。
#### build_inputs_with_special_tokens[[transformers.MarkupLMTokenizer.build_inputs_with_special_tokens]]
```python
build_inputs_with_special_tokens(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L952)
**パラメータ:**
token_ids_0 (`list[int]`) : 特殊トークンが追加されるIDのリスト。
token_ids_1 (`list[int]`, *任意*) : シーケンスペア用の任意の第2のIDリスト。
**戻り値:** `list[int]`
適切な特殊トークンを含む[入力 ID](../glossary#input-ids)のリスト。
シーケンス分類タスクにおいて、シーケンスまたはシーケンスのペアからモデルの入力を構築するために、特殊トークンを追加して連結します。RoBERTaのシーケンスは、次の形式を持ちます:
- 単一シーケンス: ` X `
- シーケンスのペア: ` A B `
#### get_special_tokens_mask[[transformers.MarkupLMTokenizer.get_special_tokens_mask]]
```python
get_special_tokens_mask(token_ids_0: list[int], token_ids_1: list[int] | None = None, already_has_special_tokens: bool = False)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/tokenization_utils_base.py#L1338)
**パラメータ:**
token_ids_0 : (すでにフォーマット済みの可能性がある) シーケンスの ID のリスト。
token_ids_1 `already_has_special_tokens=True` の場合は使用されません。その場合は None でなければなりません。
already_has_special_tokens : シーケンスがすでに特殊トークンでフォーマットされているかどうか。
**戻り値:** 範囲 [0, 1] 内の整数のリスト
特殊トークンには1、シーケンストークンには0を指定します。
特殊トークンが追加されていないトークンリストからシーケンスIDを取得します。
高速なトークナイザーでは、データコラテーターは`already_has_special_tokens=True`を指定してこの関数を呼び出し、すでに整形済みのシーケンスに対してマスクを構築します。その場合、`all_special_ids`への所属を確認することによってマスクを計算します。
#### create_token_type_ids_from_sequences[[transformers.MarkupLMTokenizer.create_token_type_ids_from_sequences]]
```python
create_token_type_ids_from_sequences(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L975)
**パラメータ:**
token_ids_0 (`list[int]`) : ID のリスト。
token_ids_1 (`list[int]`, *任意*) : シーケンスペア用の任意の第2のIDリスト。
**戻り値:** `list[int]`
ゼロのリスト。
シーケンスペア分類タスクで使用するために、渡された2つのシーケンスからマスクを作成します。RoBERTaはトークンタイプIDを使用しないため、ゼロのリストが返されます。
#### save_vocabulary[[transformers.MarkupLMTokenizer.save_vocabulary]]
```python
save_vocabulary(save_directory: str, filename_prefix: str | None = None)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L997)
## MarkupLMTokenizerFast[[transformers.MarkupLMTokenizer]]
#### transformers.MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
```python
transformers.MarkupLMTokenizer(tags_dict, vocab: str | dict[str, int] | list[tuple[str, float]] | None = None, merges: str | list[str] | None = None, errors = 'replace', bos_token = '', eos_token = '', sep_token = '', cls_token = '', unk_token = '', pad_token = '', mask_token = '', add_prefix_space = False, max_depth = 50, max_width = 1000, pad_width = 1001, pad_token_label = -100, only_label_first_subword = True, trim_offsets = False, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L91)
**パラメータ:**
vocab (`str` または `dict[str, int]`、*省略可*) : カスタムの語彙辞書です。指定しない場合、`vocab_file` から語彙が読み込まれます。
merges (`str` または `list[str]`、*省略可能*) : カスタムなマージリストです。指定しない場合、`merges_file` からマージが読み込まれます。
errors (`str`、*任意*、デフォルトは`"replace"`) : バイトを UTF-8 にデコードする際に従うパラダイム。詳細は[bytes.decode](https://docs.python.org/3/library/stdtypes.html#bytes.decode)を参照してください。
bos_token (`str`、*任意*、デフォルトは `""`) : 事前学習で使用されたシーケンスの開始トークンです。シーケンス分類器のトークンとして使用できます。 特殊トークンを使用してシーケンスを構築する場合は、シーケンスの開始にこのトークンは使用されません。使用されるのは `cls_token` です。
eos_token (`str`、*任意*、デフォルトは`""`) : シーケンスの終了トークン。特殊トークンを使用してシーケンスを構築する場合は、シーケンスの終了に使用されるトークンではありません。使用されるトークンは`sep_token`です。
sep_token (`str`、*任意*、デフォルトは `""`) : 区切りトークンです。複数のシーケンスからシーケンスを構築する際に使用されます。例えば、シーケンス分類では2つのシーケンス、質問応答ではテキストと質問です。また、特殊トークンを用いて構築されたシーケンスの最後のトークンとしても使用されます。
cls_token (`str`、*任意*、デフォルトは `""`) : シーケンス分類(トークンごとの分類ではなく、シーケンス全体に対する分類)を行う際に使用される分類トークンです。特殊トークンを用いて構築された場合、シーケンスの最初のトークンになります。
unk_token (`str`、*任意*、デフォルトは `""`) : 不明トークン。語彙に存在しないトークンは ID に変換できず、代わりにこのトークンが設定されます。
pad_token (`str`、*任意*、デフォルトは `""`) : パディングに使用されるトークンです。長さの異なるシーケンスをバッチ処理する場合などに使用します。
mask_token (`str`、*任意*、デフォルトは `""`) : 値をマスクするために使用されるトークンです。これは、マスク言語モデリングでこのモデルを訓練する際に使用されるトークンです。モデルが予測しようとするトークンです。
add_prefix_space (`bool`、*任意*、デフォルトは`False`) : 入力に先頭スペースを追加するかどうか。これにより、先頭の単語を他の単語と同様に扱うことができます。(RoBERTa トークナイザーは、先行するスペースによって単語の先頭を検出します)。
MarkupLMのトークナイザーを構築します。バイトレベルのByte-Pair-Encoding (BPE)に基づいています。
[MarkupLMTokenizer](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMTokenizer) は、HTML 文字列をトークンレベルの `input_ids`、`attention_mask`、`token_type_ids`、`xpath_tags_seq` および `xpath_tags_seq` に変換するために使用できます。このトークナイザーは [TokenizersBackend](/docs/transformers/main/ja/main_classes/tokenizer#transformers.TokenizersBackend) を継承しており、主要なメソッドの大部分を備え、`tokenizers` バックエンドが常にインスタンス化されることを保証します。
これらのメソッドに関する詳細については、このスーパークラスを参照してください。
#### batch_encode_plus[[transformers.MarkupLMTokenizer.batch_encode_plus]]
```python
batch_encode_plus(batch_text_or_text_pairs: list[str] | list[tuple[str, str]] | list[list[str]], is_pair: bool | None = None, xpaths: list[list[list[int]]] | None = None, node_labels: list[int] | list[list[int]] | None = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L453)
add_special_tokens (`bool`、*任意*、デフォルトは`True`): シーケンスをエンコードする際に特殊トークンを追加するかどうか。これは、入力 ID に自動的に追加されるトークンを定義する基盤となる`PretrainedTokenizerBase.build_inputs_with_special_tokens`関数を使用します。`bos`または`eos`トークンを自動的に追加したい場合に便利です。padding (`bool`、`str`または[PaddingStrategy](/docs/transformers/main/ja/internal/file_utils#transformers.utils.PaddingStrategy)、*任意*、デフォルトは`False`): パディングを有効にし、制御します。以下の値を受け入れます:
- `True` または `'longest'`: バッチ内の最長のシーケンスの長さにパディングします(単一のシーケンスのみが提供された場合は、パディングを行いません)。
- `'max_length'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが受け入れ可能な最大入力長までパディングします。
- `False` または `'do_not_pad'`(デフォルト):パディングを行いません(つまり、長さが異なるシーケンスのバッチを出力できます)。
truncation (`bool`、`str`または[TruncationStrategy](/docs/transformers/main/ja/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy)、*省略可能*、デフォルトは`False`):切り詰めを有効化し、制御します。以下の値を受け入れます:
- `True` または `'longest_first'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが受け入れられる最大入力長まで切り詰めます。この場合、トークン単位で切り詰められ、ペアのシーケンス(またはペアのバッチ)が提供されている場合は、ペアの中で最も長いシーケンスから1トークンずつ削除します。
- `'only_first'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが受け入れられる最大入力長まで切り詰めます。この設定では、シーケンスのペア(またはペアのバッチ)が提供された場合のみ、ペアの最初のシーケンスだけが切り詰められます。
- `'only_second'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが受け入れ可能な最大入力長まで切り詰めます。このモードでは、ペアのシーケンス(またはペアのバッチ)が提供された場合のみ、ペアの2番目のシーケンスが切り詰められます。
- `False` または `'do_not_truncate'`(デフォルト): トランケーションを行いません(つまり、モデルが許容する最大入力サイズを超えるシーケンス長を持つバッチを出力する可能性があります)。
max_length (`int`, *任意*): 切り詰め/パディングのパラメータのいずれかによって使用される最大長を制御します。
未設定または`None`に設定されている場合、truncation/padding パラメータのいずれかが最大長を必要とする場合、事前定義されたモデルの最大長が使用されます。モデルに特定の最大入力長がない場合(XLNet など)、最大長への truncation/padding は無効になります。stride (`int`, *任意*, デフォルト値 0): `max_length` とともに数値に設定すると、`return_overflowing_tokens=True` の際に返されるオーバーフローするトークンは、切り詰められたシーケンスの末尾からいくつかのトークンを含むようになり、切り詰められたシーケンスとオーバーフローするシーケンスの間に重複が提供されます。この引数の値は、重複するトークンの数を定義します。is_split_into_words (`bool`, *任意*, デフォルト値 `False`): 入力がすでに事前トークン化(例: 単語に分割)されているかどうか。`True` に設定すると、トークナイザーは入力がすでに単語に分割されている(たとえば空白で分割されている)と仮定し、それをトークン化します。これは NER やトークン分類に有用です。pad_to_multiple_of (`int`, *任意*): 設定すると、シーケンスを指定された値の倍数にパディングします。`padding` が有効化されている必要があります。これは、計算能力 `>= 7.5` (Volta) を持つ NVIDIA ハードウェアで Tensor Cores を使用可能にするために特に有用です。padding_side (`str`, *任意*): モデルにパディングを適用する側。['right', 'left'] のいずれかを選択する必要があります。デフォルト値は、同名のクラス属性から選択されます。return_tensors (`str` または [TensorType](/docs/transformers/main/ja/internal/file_utils#transformers.TensorType), *任意*): 設定すると、Python の整数のリストの代わりにテンソルを返します。許容される値は以下の通りです:
- `'pt'`: PyTorchの`torch.Tensor`オブジェクトを返します。
- `'np'`: Numpy の `np.ndarray` オブジェクトを返します。
add_special_tokens (`bool`、*任意*、デフォルトは`True`):モデルに相対的な特殊トークンでシーケンスをエンコードするかどうか。padding (`bool`、`str`または[PaddingStrategy](/docs/transformers/main/ja/internal/file_utils#transformers.utils.PaddingStrategy)、*任意*、デフォルトは`False`):パディングの有効化と制御を行います。以下の値を受け入れます:
- `True` または `'longest'`: バッチ内の最長のシーケンスの長さにパディングします(単一のシーケンスのみが提供された場合は、パディングを行いません)。
- `'max_length'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが受け入れ可能な最大入力長までパディングします。
- `False` または `'do_not_pad'`(デフォルト):パディングを行いません(つまり、長さが異なるシーケンスのバッチを出力できます)。
truncation (`bool`、`str`または[TruncationStrategy](/docs/transformers/main/ja/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy)、*省略可能*、デフォルトは`False`):切り詰めを有効化し、制御します。以下の値を受け入れます:
- `True` または `'longest_first'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが受け入れられる最大入力長まで切り詰めます。この場合、トークン単位で切り詰められ、ペアのシーケンス(またはペアのバッチ)が提供されている場合は、ペアの中で最も長いシーケンスから1トークンずつ削除します。
- `'only_first'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが受け入れられる最大入力長まで切り詰めます。この設定では、シーケンスのペア(またはペアのバッチ)が提供された場合のみ、ペアの最初のシーケンスだけが切り詰められます。
- `'only_second'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが受け入れ可能な最大入力長まで切り詰めます。このモードでは、ペアのシーケンス(またはペアのバッチ)が提供された場合のみ、ペアの2番目のシーケンスが切り詰められます。
- `False` または `'do_not_truncate'`(デフォルト): トランケーションを行いません(つまり、モデルが許容する最大入力サイズを超えるシーケンス長を持つバッチを出力する可能性があります)。
max_length (`int`, *optional*): Controls the maximum length to use by one of the truncation/padding parameters. If left unset or set to `None`, this will use the predefined model maximum length if a maximum length is required by one of the truncation/padding parameters. If the model has no specific maximum input length (like XLNet) truncation/padding to a maximum length will be deactivated. stride (`int`, *optional*, defaults to 0): If set to a number along with `max_length`, the overflowing tokens returned when `return_overflowing_tokens=True` will contain some tokens from the end of the truncated sequence returned to provide some overlap between truncated and overflowing sequences. The value of this argument defines the number of overlapping tokens. is_split_into_words (`bool`, *optional*, defaults to `False`): Whether or not the input is already pretokenized (e.g. split into words). Set this to `True` if you are passing pretokenized inputs to avoid additional tokenization. pad_to_multiple_of (`int`, *optional*): If set will pad the sequence to a multiple of the provided value. This is especially useful to enable the use of Tensor Cores on NVIDIA hardware with compute capability `>= 7.5` (Volta). return_tensors (`str` or [TensorType](/docs/transformers/main/ja/internal/file_utils#transformers.TensorType), *optional*): If set, will return tensors instead of list of python integers. Acceptable values are:
- `'pt'`: PyTorchの`torch.Tensor`オブジェクトを返します。
- `'np'`: Numpy の `np.ndarray` オブジェクトを返します。
#### build_inputs_with_special_tokens[[transformers.MarkupLMTokenizer.build_inputs_with_special_tokens]]
```python
build_inputs_with_special_tokens(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L952)
**パラメータ:**
token_ids_0 (`list[int]`) : 特殊トークンが追加されるIDのリスト。
token_ids_1 (`list[int]`, *任意*) : シーケンスペア用の任意の第2のIDリスト。
**戻り値:** `list[int]`
適切な特殊トークンを含む[入力 ID](../glossary#input-ids)のリスト。
シーケンス分類タスクにおいて、シーケンスまたはシーケンスのペアからモデルの入力を構築するために、特殊トークンを追加して連結します。RoBERTaのシーケンスは、次の形式を持ちます:
- 単一シーケンス: ` X `
- シーケンスのペア: ` A B `
#### create_token_type_ids_from_sequences[[transformers.MarkupLMTokenizer.create_token_type_ids_from_sequences]]
```python
create_token_type_ids_from_sequences(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L975)
**パラメータ:**
token_ids_0 (`list[int]`) : ID のリスト。
token_ids_1 (`list[int]`, *任意*) : シーケンスペア用の任意の第2のIDリスト。
**戻り値:** `list[int]`
ゼロのリスト。
シーケンスペア分類タスクで使用するために、渡された2つのシーケンスからマスクを作成します。RoBERTaはトークンタイプIDを使用しないため、ゼロのリストが返されます。
#### encode_plus[[transformers.MarkupLMTokenizer.encode_plus]]
```python
encode_plus(text: str | list[str], text_pair: list[str] | None = None, xpaths: list[list[int]] | None = None, node_labels: list[int] | None = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L518)
**パラメータ:**
text (`str`、`list[str]`、`list[list[str]]`) : エンコードする最初のシーケンスです。文字列、文字列のリスト、または文字列のリストのリストを指定できます。
text_pair (`list[str]` または `list[int]`、*任意*) : エンコード対象の任意の第2シーケンスです。これは文字列のリスト(単一の例の単語)または文字列のリストのリスト(バッチの例の単語)である可能性があります。
add_special_tokens (`bool`、*任意*、デフォルトは`True`) : シーケンスをエンコードする際に特殊トークンを追加するかどうか。これは、入力 ID に自動的に追加されるトークンを定義する基盤となる`PretrainedTokenizerBase.build_inputs_with_special_tokens`関数を使用します。`bos`または`eos`トークンを自動的に追加したい場合に便利です。
padding (`bool`、`str` または [PaddingStrategy](/docs/transformers/main/ja/internal/file_utils#transformers.utils.PaddingStrategy)、*optional*、デフォルトは `False`) : パディングの有効化と制御を行います。以下の値を受け取ります: - `True` または `'longest'`: バッチ内の最長のシーケンスの長さにパディングします(単一のシーケンスのみが提供された場合は、パディングを行いません)。 - `'max_length'`: 引数 `max_length` で指定された最大長、またはその引数が提供されていない場合はモデルが受け入れ可能な最大入力長までパディングします。 - `False` または `'do_not_pad'`(デフォルト): パディングを行いません(つまり、長さが異なるシーケンスのバッチを出力できます)。
truncation (`bool`、`str` または [TruncationStrategy](/docs/transformers/main/ja/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy)、*optional*、デフォルトは `False`) : トランケーションを有効化し、制御します。以下の値を受け取ります: - `True` または `'longest_first'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが許容する最大入力長まで切り詰めます。ペアのシーケンス(またはペアのバッチ)が提供されている場合、ペアの中で最も長いシーケンスからトークン単位で1トークンずつ削除します。 - `'only_first'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが許容する最大入力長まで切り詰めます。ペアのシーケンス(またはペアのバッチ)が提供されている場合、ペアの最初のシーケンスのみを切り詰めます。 - `'only_second'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが許容する最大入力長まで切り詰めます。ペアのシーケンス(またはペアのバッチ)が提供されている場合、ペアの2番目のシーケンスのみを切り詰めます。 - `False` または `'do_not_truncate'`(デフォルト): トランケーションを行いません(つまり、モデルが許容する最大入力サイズを超えるシーケンス長を持つバッチを出力する可能性があります)。
max_length (`int`, *optional*) : 切り詰め/パディングパラメータのいずれかによって使用される最大長を制御します。 未設定のまま、または `None` に設定されている場合、切り詰め/パディングパラメータのいずれかが最大長を必要とする場合、事前に定義されたモデルの最大長が使用されます。 モデルに特定の最大入力長がない場合(XLNet など)、最大長への切り詰め/パディングは無効になります。
stride (`int`、*optional*、デフォルト値は 0) : `max_length` とともに数値が設定されている場合、`return_overflowing_tokens=True` のときに返されるオーバーフローしたトークンは、切り詰められたシーケンスの末尾の一部のトークンを含み、切り詰められたシーケンスとオーバーフローしたシーケンスの間に重複部分を持たせます。この引数の値は、重複するトークンの数を定義します。
is_split_into_words (`bool`、*任意*、デフォルトは `False`) : 入力がすでに事前トークン化済み(例:単語に分割済み)かどうかを示します。`True` に設定すると、トークナイザーは入力がすでに単語に分割済み(たとえば空白で分割済み)であると仮定し、それをトークン化します。これは NER やトークン分類に有用です。
pad_to_multiple_of (`int`, *optional*) : 設定すると、シーケンスを指定された値の倍数にパディングします。`padding` が有効になっている必要があります。これは、計算能力が `>= 7.5` (Volta) の NVIDIA ハードウェア上で Tensor Cores を使用可能にするために特に有用です。
padding_side (`str`, *任意*) : モデルにパディングを適用する側です。['right', 'left'] から選択する必要があります。デフォルト値は、同名のクラス属性から取得されます。
return_tensors (`str` または [TensorType](/docs/transformers/main/ja/internal/file_utils#transformers.TensorType)、*optional*) : 設定されている場合、Python の整数のリストではなくテンソルを返します。指定可能な値は以下の通りです。 - `'pt'`: PyTorch の `torch.Tensor` オブジェクトを返します。 - `'np'`: Numpy の `np.ndarray` オブジェクトを返します。
add_special_tokens (`bool`、*任意*、デフォルトは`True`) : モデルに相対的な特殊トークンを用いてシーケンスをエンコードするかどうか。
padding (`bool`、`str`または[PaddingStrategy](/docs/transformers/main/ja/internal/file_utils#transformers.utils.PaddingStrategy)、*optional*、デフォルトは`False`) : パディングの有効化と制御を行います。以下の値を受け取ります: - `True`または`'longest'`: バッチ内の最長のシーケンスの長さにパディングします(単一のシーケンスのみが提供された場合は、パディングを行いません)。 - `'max_length'`: 引数`max_length`で指定された最大長、またはその引数が提供されていない場合はモデルが受け入れ可能な最大入力長までパディングします。 - `False`または`'do_not_pad'`(デフォルト): パディングを行いません(つまり、長さが異なるシーケンスのバッチを出力できます)。
truncation (`bool`、`str` または [TruncationStrategy](/docs/transformers/main/ja/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy)、*optional*、デフォルトは `False`) : トランケーションを有効化し、制御します。以下の値を受け取ります: - `True` または `'longest_first'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが許容する最大入力長まで切り詰めます。ペアのシーケンス(またはペアのバッチ)が提供されている場合、ペアの中で最も長いシーケンスからトークン単位で1トークンずつ削除します。 - `'only_first'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが許容する最大入力長まで切り詰めます。ペアのシーケンス(またはペアのバッチ)が提供されている場合、ペアの最初のシーケンスのみを切り詰めます。 - `'only_second'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが許容する最大入力長まで切り詰めます。ペアのシーケンス(またはペアのバッチ)が提供されている場合、ペアの2番目のシーケンスのみを切り詰めます。 - `False` または `'do_not_truncate'`(デフォルト): トランケーションを行いません(つまり、モデルが許容する最大入力サイズを超えるシーケンス長を持つバッチを出力する可能性があります)。
max_length (`int`, *optional*) : 切り詰め/パディングパラメータのいずれかによって使用される最大長を制御します。未設定のまま、または `None` に設定されている場合、切り詰め/パディングパラメータのいずれかが最大長を必要とする場合、事前に定義されたモデルの最大長が使用されます。モデルに特定の最大入力長がない場合(XLNet など)、最大長への切り詰め/パディングは無効になります。
stride (`int`、*optional*、デフォルト値は 0) : `max_length` とともに数値が設定されている場合、`return_overflowing_tokens=True` のときに返されるオーバーフローしたトークンは、切り詰められたシーケンスの末尾の一部のトークンを含み、切り詰められたシーケンスとオーバーフローしたシーケンスの間に重複部分を持たせます。この引数の値は、重複するトークンの数を定義します。
is_split_into_words (`bool`、*任意*、デフォルトは`False`) : 入力がすでにプレトークン化済み(例:単語に分割済み)かどうかを示します。追加のトークン化を回避するために、プレトークン化済みの入力を渡す場合は、これを`True`に設定してください。
pad_to_multiple_of (`int`, *optional*) : 設定すると、シーケンスを指定された値の倍数にパディングします。これは、計算能力が `>= 7.5` (Volta) の NVIDIA ハードウェア上で Tensor Cores を使用可能にするために特に有用です。
return_tensors (`str` または [TensorType](/docs/transformers/main/ja/internal/file_utils#transformers.TensorType)、*optional*) : 設定されている場合、Python の整数のリストではなくテンソルを返します。指定可能な値は以下の通りです。 - `'pt'`: PyTorch の `torch.Tensor` オブジェクトを返します。 - `'np'`: Numpy の `np.ndarray` オブジェクトを返します。
シーケンスまたはシーケンスのペアをトークナイズし、モデル用に準備します。 .. warning:: このメソッドは非推奨です。`__call__` を代わりに使用してください。
#### get_xpath_seq[[transformers.MarkupLMTokenizer.get_xpath_seq]]
```python
get_xpath_seq(xpath)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L253)
特定のノードのxpath式(例: "/html/body/div/li[1]/div/span[2]")が与えられた場合、最大深度を考慮して、タグIDと対応するサブスクリプトのリストを返します。
## MarkupLMProcessor[[transformers.MarkupLMProcessor]]
#### transformers.MarkupLMProcessor[[transformers.MarkupLMProcessor]]
```python
transformers.MarkupLMProcessor(feature_extractor, tokenizer)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/processing_markuplm.py#L25)
**パラメータ:**
feature_extractor (`feature_extractor_class`) : 特徴量抽出器は必須の入力です。
tokenizer (`MarkupLMTokenizer`) : トークナイザーは必須の入力です。
MarkupLMProcessor を構築します。このプロセッサーは、フィーチャーエクストラクターとトークナイザーを単一のプロセッサーにラップします。
[MarkupLMProcessor](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMProcessor) は、`feature_extractor_class` と [MarkupLMTokenizer](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMTokenizer) のすべての機能を提供します。詳細については、`~feature_extractor_class` および [~MarkupLMTokenizer](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMTokenizer) を参照してください。
#### __call__[[transformers.MarkupLMProcessor.__call__]]
```python
__call__(html_strings = None, nodes = None, xpaths = None, node_labels = None, questions = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, return_tensors: str | transformers.utils.generic.TensorType | None = None, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/processing_markuplm.py#L31)
**パラメータ:**
html_strings (`str` または `list[str]`、*任意*) : 解析および処理対象の生の HTML 文字列。`parse_html=True`(デフォルト)の場合、これらの文字列を解析して、ノードと xpath を自動的に抽出します。指定した場合、`nodes`、`xpaths`、および `node_labels` は指定しないでください。`parse_html=True` の場合は必須です。
nodes (`list[list[str]]`、*任意*) : 各内部リストが単一のドキュメントのノードのテキストコンテンツを含む、リストのリストとして事前抽出された HTML ノード。`parse_html=False` の場合は必須です。`parse_html=True` の場合は指定しないでください。
xpaths (`list[list[str]]`、*任意*) : ノードに対応する事前抽出済みの XPath 式です。`nodes` と同じ構造を持つリストのリストである必要があります。各 XPath は、HTML ツリー内の対応するノードの位置を特定します。`parse_html=False` の場合は必須です。`parse_html=True` の場合は指定しないでください。
node_labels (`list[list[int]]`、*任意*) : ノードのラベルです。通常、学習やファインチューニングのタスクで使用します。`nodes` と同じ構造を持つリストのリストである必要があります。各ラベルはノードに対応します。任意の引数であり、`parse_html=False` の場合のみ使用されます。
questions (`str` または `list[str]`、*省略可*) : 質問応答タスク用の質問文字列です。指定された場合、トークナイザーは質問を最初のシーケンス、ノードを2番目のシーケンス(text_pair)として処理します。単一の文字列が指定された場合は、解析済み HTML のバッチ次元に合わせるためにリストに変換されます。
add_special_tokens (`bool`、*任意*、デフォルトは`True`) : シーケンスをエンコードする際に特殊トークンを追加するかどうか。これは、入力 ID に自動的に追加されるトークンを定義する基盤となる`PretrainedTokenizerBase.build_inputs_with_special_tokens`関数を使用します。`bos`または`eos`トークンを自動的に追加したい場合に便利です。
padding (bool, str or [PaddingStrategy](/docs/transformers/main/ja/internal/file_utils#transformers.utils.PaddingStrategy), *optional*, デフォルトは `False`) : パディングの有効化と制御を行います。以下の値を受け取ります: - `True` または `'longest'`: バッチ内の最長のシーケンスの長さにパディングします(単一のシーケンスのみが提供された場合は、パディングを行いません)。 - `'max_length'`: 引数 `max_length` で指定された最大長、またはその引数が提供されていない場合はモデルが受け入れ可能な最大入力長までパディングします。 - `False` または `'do_not_pad'`(デフォルト): パディングを行いません(つまり、長さが異なるシーケンスを含むバッチを出力できます)。
truncation (bool, str or [TruncationStrategy](/docs/transformers/main/ja/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *optional*) : トランケーションを有効化し、制御します。以下の値を受け取ります: - `True` または `'longest_first'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが許容する最大入力長まで切り詰めます。ペアのシーケンス(またはペアのバッチ)が提供されている場合、ペアの中で最も長いシーケンスからトークン単位で1トークンずつ削除して切り詰めます。 - `'only_first'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが許容する最大入力長まで切り詰めます。ペアのシーケンス(またはペアのバッチ)が提供されている場合、ペアの最初のシーケンスのみを切り詰めます。 - `'only_second'`: 引数 `max_length` で指定された最大長、またはその引数が指定されていない場合はモデルが許容する最大入力長まで切り詰めます。ペアのシーケンス(またはペアのバッチ)が提供されている場合、ペアの2番目のシーケンスのみを切り詰めます。 - `False` または `'do_not_truncate'` (デフォルト): トランケーションを行いません(つまり、モデルの最大許容入力サイズを超えるシーケンス長を持つバッチを出力する可能性があります)。
max_length (`int`, *optional*) : 切り詰め/パディングパラメータのいずれかによって使用される最大長を制御します。 未設定のまま、または `None` に設定されている場合、切り詰め/パディングパラメータのいずれかが最大長を必要とする場合、事前に定義されたモデルの最大長が使用されます。 モデルに特定の最大入力長がない場合(XLNet など)、最大長への切り詰め/パディングは無効になります。
stride (`int`, *optional*, デフォルトは `0`) : `max_length` とともに数値が設定されている場合、`return_overflowing_tokens=True` のときに返されるオーバーフローしたトークンは、切り詰められたシーケンスの末尾の一部のトークンを含み、切り詰められたシーケンスとオーバーフローしたシーケンスの間に重複部分を提供します。この引数の値は、重複するトークンの数を定義します。
pad_to_multiple_of (`int`, *optional*) : 設定すると、シーケンスを指定された値の倍数にパディングします。`padding` が有効化されている必要があります。これは、計算能力 `>= 7.5` (Volta) を備えた NVIDIA ハードウェア上で Tensor Cores を使用できるようにするため、特に有用です。
return_token_type_ids (`bool`、*省略可*) : トークンタイプIDを返すかどうか。デフォルトのままにすると、`return_outputs` 属性で定義される特定のトークナイザーのデフォルトに従って、トークンタイプIDを返します。 [トークンタイプIDとは?](../glossary#token-type-ids)
return_attention_mask (`bool`、*省略可*) : アテンションマスクを返すかどうか。デフォルトのままにすると、`return_outputs` 属性で定義される特定のトークナイザーのデフォルトに従って、アテンションマスクを返します。 [アテンションマスクとは?](../glossary#attention-mask)
return_overflowing_tokens (`bool`, *任意*, デフォルトは `False`) : 溢れたトークンシーケンスを返すかどうかを指定します。入力 ID のシーケンスのペア(またはペアのバッチ)が `truncation_strategy = longest_first` または `True` とともに提供された場合、溢れたトークンを返す代わりにエラーが発生します。
return_special_tokens_mask (`bool`, *任意*, デフォルトは `False`) : 特殊トークンのマスク情報を返すかどうか。
return_offsets_mapping (`bool`、*任意*、デフォルトは`False`) : 各トークンについて`(char_start, char_end)`を返すかどうか。これは[PreTrainedTokenizerFast](/docs/transformers/main/ja/main_classes/tokenizer#transformers.TokenizersBackend)を継承する fast tokenizer のみで利用可能であり、Python の tokenizer を使用している場合、このメソッドは`NotImplementedError`を送出します。
return_length (`bool`、*任意*、デフォルトは`False`) : エンコードされた入力の長さを返すかどうかを指定します。
verbose (`bool`、*任意*、デフォルトは `True`) : 詳細な情報や警告を表示するかどうか。
return_tensors (`Union[str, ~utils.generic.TensorType]`、*任意*) : 設定すると、特定のフレームワークのテンソルを返します。指定可能な値は以下の通りです。 - `'pt'`: PyTorch の `torch.Tensor` オブジェクトを返します。 - `'np'`: NumPy の `np.ndarray` オブジェクトを返します。
**戻り値:** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`, *optional*) -- `__call__`/`encode_plus`/`batch_encode_plus` メソッドによって返される、リスト/配列/テンソルの辞書('input_ids'、'attention_mask' など)。
- **encoding**(`tokenizers.Encoding` または `Sequence[tokenizers.Encoding]`、*任意*)-- トークナイザーが、単語/文字空間からトークン空間へのマッピングなどの追加情報を出力する fast tokenizer の場合、`tokenizers.Encoding` のインスタンス、またはそのリスト(バッチの場合)にこの情報が保持されます。
- **tensor_type** (`Union[None, str, TensorType]`、*省略可*) -- 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
- **prepend_batch_axis** (`bool`、*任意*、デフォルトは `False`) -- テンソルに変換する際にバッチ軸を追加するかどうかを指定します(`tensor_type` を参照)。パラメータ `tensor_type` が設定されている場合のみこのパラメータが有効で、*それ以外の場合は無効です*。
- **n_sequences** (`int`, *任意*) -- 各エンコーディングが表す入力シーケンスの数(不明な場合は`None`、単一のシーケンスの場合は`1`、シーケンスのペアの場合は`2`)。
## MarkupLMModel[[transformers.MarkupLMModel]]
#### transformers.MarkupLMModel[[transformers.MarkupLMModel]]
```python
transformers.MarkupLMModel(config: MarkupLMConfig, add_pooling_layer = True)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L497)
**パラメータ:**
config ([MarkupLMConfig](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
add_pooling_layer (`bool`、*任意*、デフォルトは`True`) : プーリング層を追加するかどうか
Markuplmのベースモデル。特定のヘッドを付加せず、生のhidden-statesを出力します。
このモデルは [PreTrainedModel](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.MarkupLMModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, xpath_tags_seq: typing.Optional[torch.LongTensor] = None, xpath_subs_seq: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.FloatTensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.FloatTensor] = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L521)
**パラメータ:**
input_ids (`torch.LongTensor`、shape `(batch_size, sequence_length)`、*任意*) : 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスは [AutoTokenizer](/docs/transformers/main/ja/model_doc/auto#transformers.AutoTokenizer) を使用して取得できます。詳細については、[PreTrainedTokenizer.encode()](/docs/transformers/main/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) および [PreTrainedTokenizer.__call__()](/docs/transformers/main/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) を参照してください。 [入力IDとは何ですか?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor`、shape `(batch_size, sequence_length, config.max_depth)`、*optional*) : 入力シーケンスの各トークンに対するタグ ID。config.max_depth までパディングされています。
xpath_subs_seq (`torch.LongTensor`、shape `(batch_size, sequence_length, config.max_depth)`、*任意*) : 入力シーケンスの各トークンに対するサブスクリプトID。config.max_depth までパディングされています。
attention_mask (`torch.FloatTensor`、形状 `(batch_size, sequence_length)`、*任意*) : パディングトークンのインデックスに対してアテンションを実行しないためのマスク。`[0, 1]` から選択されるマスクの値: - **マスクされない**トークンは 1、**マスクされる**トークンは 0。 [アテンションマスクとは?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`、形状 `(batch_size, sequence_length)`、*任意*) : 入力の前半と後半を示すセグメントトークンインデックス。インデックスは `[0, 1]` から選択されます: - 0 は *文 A* のトークンに対応します。 - 1 は *文 B* のトークンに対応します。 [トークンタイプIDとは何ですか?](../glossary#token-type-ids)
position_ids (`torch.LongTensor`、shape `(batch_size, sequence_length)`、*任意*) : 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックスです。`[0, config.n_positions - 1]` の範囲から選択されます。 [位置 ID とは何か?](../glossary#position-ids)
inputs_embeds (`torch.FloatTensor`、shape `(batch_size, sequence_length, hidden_size)`、*任意*) : `input_ids` を渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、`input_ids` のインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。
**戻り値:** [BaseModelOutputWithPooling](/docs/transformers/main/ja/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) または `tuple(torch.FloatTensor)`
[MarkupLMConfig](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMConfig) および入力に応じて、さまざまな要素で構成される [BaseModelOutputWithPooling](/docs/transformers/main/ja/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) または `torch.FloatTensor` のタプル(`return_dict=False` が渡された場合、または `config.return_dict=False` の場合)。
[MarkupLMModel](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMModel)のforwardメソッドは、`__call__`特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **last_hidden_state** (`torch.FloatTensor`、shape `(batch_size, sequence_length, hidden_size)`) -- モデルの最終層の出力における隠れ状態のシーケンス。
- **pooler_output** (`torch.FloatTensor`、shape `(batch_size, hidden_size)`) -- 補助事前学習タスクに使用される層をさらに通して処理された後、シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態です。例えば、BERT 系のモデルでは、線形層と tanh 活性化関数を経て処理された後の分類トークンを返します。この線形層の重みは、事前学習中の次文予測(分類)目的から学習されます。
- **hidden_states** (`tuple(torch.FloatTensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.FloatTensor` のタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.FloatTensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.FloatTensor` のタプル(各レイヤーごとに1つ)で、形状は `(batch_size, num_heads, sequence_length, sequence_length)` です。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
```python
>>> from transformers import AutoProcessor, MarkupLMModel
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> model = MarkupLMModel.from_pretrained("microsoft/markuplm-base")
>>> html_string = " Page Title "
>>> encoding = processor(html_string, return_tensors="pt")
>>> outputs = model(**encoding)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 4, 768]
```
## MarkupLMForSequenceClassification[[transformers.MarkupLMForSequenceClassification]]
#### transformers.MarkupLMForSequenceClassification[[transformers.MarkupLMForSequenceClassification]]
```python
transformers.MarkupLMForSequenceClassification(config: MarkupLMConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L802)
**パラメータ:**
config ([MarkupLMConfig](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
MarkupLMは、プーリングされた出力の上に線形層を配置したシーケンス分類/回帰ヘッドを備えたTransformerモデルです。GLUEタスクなどに使用できます。
このモデルは [PreTrainedModel](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.MarkupLMForSequenceClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L819)
**パラメータ:**
input_ids (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスは [AutoTokenizer](/docs/transformers/main/ja/model_doc/auto#transformers.AutoTokenizer) を使用して取得できます。詳細については、[PreTrainedTokenizer.encode()](/docs/transformers/main/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) および [PreTrainedTokenizer.__call__()](/docs/transformers/main/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) を参照してください。 [入力IDとは何ですか?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor`、shape `(batch_size, sequence_length, config.max_depth)`、*optional*) : 入力シーケンスの各トークンに対するタグ ID。config.max_depth までパディングされています。
xpath_subs_seq (`torch.LongTensor`、shape `(batch_size, sequence_length, config.max_depth)`、*任意*) : 入力シーケンスの各トークンに対するサブスクリプトID。config.max_depth までパディングされています。
attention_mask (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンのインデックスに対する attention を回避するためのマスクです。マスクの値は `[0, 1]` から選択されます: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
token_type_ids (`torch.Tensor`、形状 `(batch_size, sequence_length)`、*任意*) : 入力の前半と後半を示すセグメントトークンインデックス。インデックスは `[0, 1]` から選択されます: - 0 は *文 A* のトークンに対応します。 - 1 は *文 B* のトークンに対応します。 [トークンタイプIDとは何ですか?](../glossary#token-type-ids)
position_ids (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。`[0, config.n_positions - 1]` の範囲から選択されます。 [位置 ID とは何か?](../glossary#position-ids)
inputs_embeds (`torch.Tensor`、shape `(batch_size, sequence_length, hidden_size)`、*任意*) : `input_ids` を渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、`input_ids` のインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。
labels (`torch.LongTensor`、形状 `(batch_size,)`、*任意*) : シーケンス分類/回帰の損失を計算するためのラベル。インデックスは `[0, ..., config.num_labels - 1]` の範囲である必要があります。`config.num_labels == 1` の場合は回帰損失(平均二乗誤差)が計算され、`config.num_labels > 1` の場合は分類損失(クロスエントロピー)が計算されます。
**戻り値:** [SequenceClassifierOutput](/docs/transformers/main/ja/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) または `tuple(torch.FloatTensor)`
設定([MarkupLMConfig](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMConfig))や入力に応じて、さまざまな要素で構成される [SequenceClassifierOutput](/docs/transformers/main/ja/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput)、または `torch.FloatTensor` のタプル(`return_dict=False` が渡された場合、または `config.return_dict=False` の場合)。
[MarkupLMForSequenceClassification](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMForSequenceClassification) の forward メソッドは、`__call__` という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **loss** (`torch.FloatTensor`、shape `(1,)`、*optional*、`labels` が指定された場合に返されます) -- 分類(または config.num_labels==1 の場合は回帰)の損失。
- **logits** (`torch.FloatTensor`、shape `(batch_size, config.num_labels)`) -- SoftMax 適用前の分類(または config.num_labels==1 の場合は回帰)スコア。
- **hidden_states** (`tuple(torch.FloatTensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.FloatTensor` のタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.FloatTensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.FloatTensor` のタプル(各レイヤーごとに1つ)で、形状は `(batch_size, num_heads, sequence_length, sequence_length)` です。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
```python
>>> from transformers import AutoProcessor, AutoModelForSequenceClassification
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> model = AutoModelForSequenceClassification.from_pretrained("microsoft/markuplm-base", num_labels=7)
>>> html_string = " Page Title "
>>> encoding = processor(html_string, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> loss = outputs.loss
>>> logits = outputs.logits
```
## MarkupLMForTokenClassification[[transformers.MarkupLMForTokenClassification]]
#### transformers.MarkupLMForTokenClassification[[transformers.MarkupLMForTokenClassification]]
```python
transformers.MarkupLMForTokenClassification(config: MarkupLMConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L709)
**パラメータ:**
config ([MarkupLMConfig](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
`token_classification`ヘッドを上に配置したMarkupLMモデル。
このモデルは [PreTrainedModel](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.MarkupLMForTokenClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L725)
**パラメータ:**
input_ids (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスは [AutoTokenizer](/docs/transformers/main/ja/model_doc/auto#transformers.AutoTokenizer) を使用して取得できます。詳細については、[PreTrainedTokenizer.encode()](/docs/transformers/main/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) および [PreTrainedTokenizer.__call__()](/docs/transformers/main/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) を参照してください。 [入力IDとは何ですか?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor`、shape `(batch_size, sequence_length, config.max_depth)`、*optional*) : 入力シーケンスの各トークンに対するタグ ID。config.max_depth までパディングされています。
xpath_subs_seq (`torch.LongTensor`、shape `(batch_size, sequence_length, config.max_depth)`、*任意*) : 入力シーケンスの各トークンに対するサブスクリプトID。config.max_depth までパディングされています。
attention_mask (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンのインデックスに対する attention を回避するためのマスクです。マスクの値は `[0, 1]` から選択されます: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
token_type_ids (`torch.Tensor`、形状 `(batch_size, sequence_length)`、*任意*) : 入力の前半と後半を示すセグメントトークンインデックス。インデックスは `[0, 1]` から選択されます: - 0 は *文 A* のトークンに対応します。 - 1 は *文 B* のトークンに対応します。 [トークンタイプIDとは何ですか?](../glossary#token-type-ids)
position_ids (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。`[0, config.n_positions - 1]` の範囲から選択されます。 [位置 ID とは何か?](../glossary#position-ids)
inputs_embeds (`torch.Tensor`、shape `(batch_size, sequence_length, hidden_size)`、*任意*) : `input_ids` を渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、`input_ids` のインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。
labels (`torch.LongTensor`、shape `(batch_size, sequence_length)`、*optional*) : トークン分類損失を計算するためのラベル。インデックスは `[0, ..., config.num_labels - 1]` の範囲である必要があります。
**戻り値:** [MaskedLMOutput](/docs/transformers/main/ja/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) または `tuple(torch.FloatTensor)`
[MarkupLMConfig](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMConfig) や入力に応じて、さまざまな要素で構成される [MaskedLMOutput](/docs/transformers/main/ja/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) または `torch.FloatTensor` のタプル(`return_dict=False` が渡された場合、または `config.return_dict=False` の場合)。
[MarkupLMForTokenClassification](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMForTokenClassification) の forward メソッドは、`__call__` という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **loss** (`torch.FloatTensor`、shape `(1,)`、*optional*、`labels` が指定された場合に返されます) -- マスクド言語モデリング (MLM) の損失。
- **logits** (`torch.FloatTensor`、shape `(batch_size, sequence_length, config.vocab_size)`) -- 言語モデリングヘッドの予測スコア(SoftMax 適用前の各語彙トークンのスコア)。
- **hidden_states** (`tuple(torch.FloatTensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.FloatTensor` のタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.FloatTensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.FloatTensor` のタプル(各レイヤーごとに1つ)で、形状は `(batch_size, num_heads, sequence_length, sequence_length)` です。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
```python
>>> from transformers import AutoProcessor, AutoModelForTokenClassification
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> processor.parse_html = False
>>> model = AutoModelForTokenClassification.from_pretrained("microsoft/markuplm-base", num_labels=7)
>>> nodes = ["hello", "world"]
>>> xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span"]
>>> node_labels = [1, 2]
>>> encoding = processor(nodes=nodes, xpaths=xpaths, node_labels=node_labels, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> loss = outputs.loss
>>> logits = outputs.logits
```
## MarkupLMForQuestionAnswering[[transformers.MarkupLMForQuestionAnswering]]
#### transformers.MarkupLMForQuestionAnswering[[transformers.MarkupLMForQuestionAnswering]]
```python
transformers.MarkupLMForQuestionAnswering(config: MarkupLMConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L603)
**パラメータ:**
config ([MarkupLMConfig](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
Markuplm トランスフォーマーの上にスパン分類ヘッドを配置し、SQuAD などの抽出型質問応答タスクに対応します(隠れ状態の出力の上に線形層を置き、`span start logits` と `span end logits` を計算します)。
このモデルは [PreTrainedModel](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.MarkupLMForQuestionAnswering.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, start_positions: typing.Optional[torch.Tensor] = None, end_positions: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L615)
**パラメータ:**
input_ids (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスは [AutoTokenizer](/docs/transformers/main/ja/model_doc/auto#transformers.AutoTokenizer) を使用して取得できます。詳細については、[PreTrainedTokenizer.encode()](/docs/transformers/main/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) および [PreTrainedTokenizer.__call__()](/docs/transformers/main/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) を参照してください。 [入力IDとは何ですか?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor`、shape `(batch_size, sequence_length, config.max_depth)`、*optional*) : 入力シーケンスの各トークンに対するタグ ID。config.max_depth までパディングされています。
xpath_subs_seq (`torch.LongTensor`、shape `(batch_size, sequence_length, config.max_depth)`、*任意*) : 入力シーケンスの各トークンに対するサブスクリプトID。config.max_depth までパディングされています。
attention_mask (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンのインデックスに対する attention を回避するためのマスクです。マスクの値は `[0, 1]` から選択されます: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
token_type_ids (`torch.Tensor`、形状 `(batch_size, sequence_length)`、*任意*) : 入力の前半と後半を示すセグメントトークンインデックス。インデックスは `[0, 1]` から選択されます: - 0 は *文 A* のトークンに対応します。 - 1 は *文 B* のトークンに対応します。 [トークンタイプIDとは何ですか?](../glossary#token-type-ids)
position_ids (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。`[0, config.n_positions - 1]` の範囲から選択されます。 [位置 ID とは何か?](../glossary#position-ids)
inputs_embeds (`torch.Tensor`、shape `(batch_size, sequence_length, hidden_size)`、*任意*) : `input_ids` を渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、`input_ids` のインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。
start_positions (`torch.Tensor`、shape `(batch_size,)`、*任意*) : トークン分類損失の計算に使用する、ラベル付きスパンの開始位置(インデックス)のラベル。位置はシーケンスの長さ(`sequence_length`)にクランプされます。シーケンス外の位置は、損失の計算には考慮されません。
end_positions (`torch.Tensor`、shape `(batch_size,)`、*任意*) : トークン分類損失の計算に使用する、ラベル付きスパンの終了位置(インデックス)のラベル。位置はシーケンスの長さ(`sequence_length`)にクランプされます。シーケンス外の位置は、損失の計算には考慮されません。
**戻り値:** [QuestionAnsweringModelOutput](/docs/transformers/main/ja/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) または `tuple(torch.FloatTensor)`
[QuestionAnsweringModelOutput](/docs/transformers/main/ja/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput)、または`torch.FloatTensor`のタプル(`return_dict=False`が渡された場合、または`config.return_dict=False`の場合)。設定([MarkupLMConfig](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMConfig))と入力に応じて、さまざまな要素で構成されます。
[MarkupLMForQuestionAnswering](/docs/transformers/main/ja/model_doc/markuplm#transformers.MarkupLMForQuestionAnswering)のforwardメソッドは、`__call__`特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **loss** (`torch.FloatTensor`、shape `(1,)`、*optional*、`labels` が指定された場合に返されます) -- 総スパン抽出損失は、開始位置と終了位置の Cross-Entropy の和です。
- **start_logits** (`torch.FloatTensor`、形状 `(batch_size, sequence_length)`) -- SoftMax 適用前のスパン開始スコア。
- **end_logits** (`torch.FloatTensor`、shape `(batch_size, sequence_length)`) -- スパンの終了スコア(SoftMax 適用前)。
- **hidden_states** (`tuple(torch.FloatTensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.FloatTensor` のタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.FloatTensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.FloatTensor` のタプル(各レイヤーごとに1つ)で、形状は `(batch_size, num_heads, sequence_length, sequence_length)` です。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
```python
>>> from transformers import AutoProcessor, MarkupLMForQuestionAnswering
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base-finetuned-websrc")
>>> model = MarkupLMForQuestionAnswering.from_pretrained("microsoft/markuplm-base-finetuned-websrc")
>>> html_string = " My name is Niels "
>>> question = "What's his name?"
>>> encoding = processor(html_string, questions=question, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> answer_start_index = outputs.start_logits.argmax()
>>> answer_end_index = outputs.end_logits.argmax()
>>> predict_answer_tokens = encoding.input_ids[0, answer_start_index : answer_end_index + 1]
>>> processor.decode(predict_answer_tokens).strip()
'Niels'
```