# Nougat
## 概要
Nougatモデルは、Lukas Blecher、Guillem Cucurull、Thomas Scialom、Robert Stojnic によって [Nougat: Neural Optical Understanding for Academic Documents](https://huggingface.co/papers/2308.13418) で提案されました。Nougatは[Donut](donut)と同じアーキテクチャを使用しており、画像Transformerエンコーダーと自己回帰型テキストTransformerデコーダーを用いて、科学論文のPDFをMarkdownに変換し、それへのアクセスを容易にします。
論文の抄録は以下の通りです。
*科学的な知識は、主に書籍や学術ジャーナルに蓄積されており、多くの場合、PDF形式で提供されています。しかし、PDF形式では意味的な情報が失われやすく、特に数式においてその傾向が顕著です。本稿では、学術文書処理のための視覚トランスフォーマーモデルであるNougat(Neural Optical Understanding for Academic Documents)を提案します。Nougatは、学術文書をマークアップ言語に変換するためのOCR(Optical Character Recognition)タスクを実行します。また、新規に構築した学術文書データセットを用いて、本モデルの有効性を示しました。提案した手法は、人間が読める文書と機械が読めるテキストの間のギャップを埋めることで、デジタル時代における科学的知識のアクセシビリティを向上させる有望なソリューションを提供します。学術テキスト認識に関する今後の研究を加速させるため、モデルとコードを公開します。*
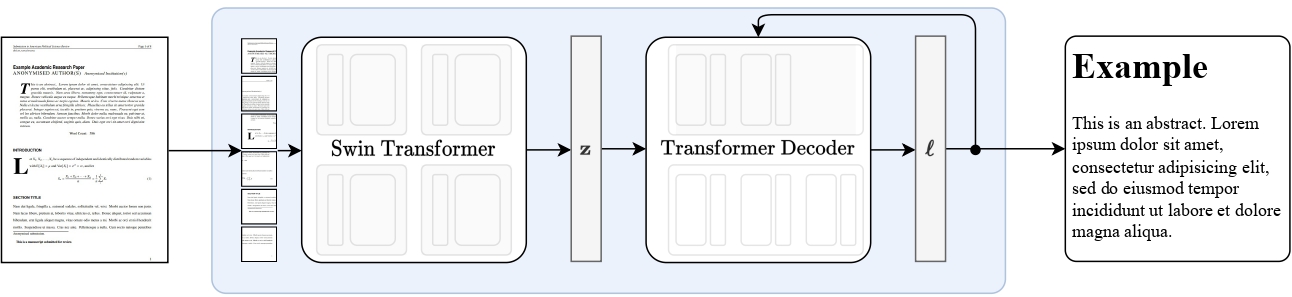 Nougatの概要。元の論文より引用。
このモデルは [nielsr](https://huggingface.co/nielsr) によって提供されました。元のコードは [こちら](https://github.com/facebookresearch/nougat) で確認できます。
## 使用のコツ
- Nougatのクイックスタートとして、推論時のモデルの使用方法とカスタムデータでのファインチューニングの方法を示す[tutorial notebooks](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Nougat)を確認することをお勧めします。
- Nougatは常に[VisionEncoderDecoder](vision-encoder-decoder)フレームワーク内で使用されます。アーキテクチャの観点では、このモデルは[Donut](donut)と同一です。
## 推論
Nougatの`VisionEncoderDecoder`モデルは画像を入力として受け取り、[generate()](/docs/transformers/main/ja/main_classes/text_generation#transformers.GenerationMixin.generate)を使用して、入力された画像に基づいてテキストを自己回帰的に生成します。
[NougatImageProcessor](/docs/transformers/main/ja/model_doc/nougat#transformers.NougatImageProcessor) クラスは入力画像の前処理を担当し、[NougatTokenizerFast](/docs/transformers/main/ja/model_doc/nougat#transformers.NougatTokenizer) は生成されたターゲットトークンをターゲット文字列にデコードします。[NougatProcessor](/docs/transformers/main/ja/model_doc/nougat#transformers.NougatProcessor) は [NougatImageProcessor](/docs/transformers/main/ja/model_doc/nougat#transformers.NougatImageProcessor) と [NougatTokenizerFast](/docs/transformers/main/ja/model_doc/nougat#transformers.NougatTokenizer) クラスを単一のインスタンスにラップし、入力特徴量の抽出と予測トークンIDのデコードの両方を行います。
- PDF文字起こしのステップバイステップ
```python
from huggingface_hub import hf_hub_download
from PIL import Image
from transformers import AutoModelForImageTextToText, NougatProcessor
processor = NougatProcessor.from_pretrained("facebook/nougat-base")
model = AutoModelForImageTextToText.from_pretrained("facebook/nougat-base", device_map="auto")
model.to(model.device) # doctest: +IGNORE_RESULT
# prepare PDF image for the model
filepath = hf_hub_download(repo_id="hf-internal-testing/fixtures_docvqa", filename="nougat_paper.png", repo_type="dataset")
image = Image.open(filepath)
pixel_values = processor(image, return_tensors="pt").to(model.device).pixel_values
# generate transcription (here we only generate 30 tokens)
outputs = model.generate(
pixel_values.to(model.device),
min_length=1,
max_new_tokens=30,
bad_words_ids=[[processor.tokenizer.unk_token_id]],
)
sequence = processor.batch_decode(outputs, skip_special_tokens=True)[0]
sequence = processor.post_process_generation(sequence, fix_markdown=False)
# note: we're using repr here such for the sake of printing the \n characters, feel free to just print the sequence
print(repr(sequence))
'\n\n# Nougat: Neural Optical Understanding for Academic Documents\n\n Lukas Blecher\n\nCorrespondence to: lblecher@'
```
Nougatのチェックポイントを探すには、[モデルハブ](https://huggingface.co/models?filter=nougat)を参照してください。
このモデルは、アーキテクチャの観点では[Donut](donut)と同一です。
## NougatConfig[[transformers.NougatConfig]]
#### transformers.NougatConfig[[transformers.NougatConfig]]
```python
transformers.NougatConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, encoder: dict | transformers.configuration_utils.PreTrainedConfig | None = None, decoder: dict | transformers.configuration_utils.PreTrainedConfig | None = None)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/configuration_nougat.py#L28)
**パラメータ:**
is_encoder_decoder (`bool`、*任意*、デフォルトは`True`) : モデルがエンコーダー/デコーダーとして使用されるかどうかを示します。
encoder (`Union[dict, ~configuration_utils.PreTrainedConfig]`、*optional*) : エンコーダーのバックボーンの設定オブジェクトまたは辞書。
decoder (`Union[dict, ~configuration_utils.PreTrainedConfig]`、*optional*) : デコーダーのバックボーンの設定オブジェクトまたは辞書。
これはNougatModelの設定を保存するための設定クラスです。指定された引数に基づいてNougatモデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、[facebook/nougat-base](https://huggingface.co/facebook/nougat-base)と類似した設定が得られます。
設定オブジェクトは [PreTrainedConfig](/docs/transformers/main/ja/main_classes/configuration#transformers.PreTrainedConfig) を継承し、モデルの出力を制御するために使用できます。詳細については、[PreTrainedConfig](/docs/transformers/main/ja/main_classes/configuration#transformers.PreTrainedConfig) のドキュメントを参照してください。
例:
```python
>>> from transformers import NougatConfig, VisionEncoderDecoderModel
>>> # Initializing a Nougat configuration
>>> config = NougatConfig()
>>> # Initializing a VisionEncoderDecoder model (with random weights) from a Nougat configurations
>>> model = VisionEncoderDecoderModel(config=config)
```
#### from_encoder_decoder_configs[[transformers.NougatConfig.from_encoder_decoder_configs]]
```python
from_encoder_decoder_configs(encoder_config: PreTrainedConfig, decoder_config: PreTrainedConfig, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/configuration_nougat.py#L52)
**戻り値:** [VisionEncoderDecoderConfig](/docs/transformers/main/ja/model_doc/vision-encoder-decoder#transformers.VisionEncoderDecoderConfig)
設定オブジェクトのインスタンス
事前学習済みエンコーダーモデルの設定とデコーダーモデルの設定から、[VisionEncoderDecoderConfig](/docs/transformers/main/ja/model_doc/vision-encoder-decoder#transformers.VisionEncoderDecoderConfig)(または派生クラス)をインスタンス化します。
## NougatImageProcessor[[transformers.NougatImageProcessor]]
#### transformers.NougatImageProcessor[[transformers.NougatImageProcessor]]
```python
transformers.NougatImageProcessor(**kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/image_processing_nougat.py#L57)
**パラメータ:**
do_convert_rgb (`bool`, *kwargs*, *optional*) : 画像を RGB に変換するかどうか。
do_resize (`bool`, *kwargs*, *任意*, デフォルトは `True`) : 画像をリサイズするかどうか。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*、デフォルト値は`{'height' : 896, 'width': 672}`): モデルへの最大入力次元を記述します。
default_to_square (`bool`, *kwargs*, *任意*、デフォルトは `True`) : size が整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` を適用した後の出力画像のサイズ。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*、デフォルト値は`2`) : 画像のリサイズ時に使用するリサンプリングフィルタです。これは列挙型`PILImageResampling`のいずれかになります。`do_resize`が`True`に設定されている場合のみ、効果が現れます。
do_rescale (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像をリスケールするかどうか。
rescale_factor (`float`, *kwargs*, *optional*, デフォルトは `0.00392156862745098`) : `do_rescale` が `True` に設定されている場合、画像をリスケールするための係数。
do_normalize (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像を正規化するかどうかを指定します。
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, デフォルトは `[0.485, 0.456, 0.406]`) : 正規化に使用する画像の平均値です。`do_normalize` が `True` に設定されている場合のみ有効です。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, デフォルトは `[0.229, 0.224, 0.225]`) : 正規化に使用する画像の標準偏差。`do_normalize` が `True` に設定されている場合のみ有効です。
do_pad (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像にパディングを適用するかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。正確なパディング戦略はモデルによって異なります。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 画像をパディングするサイズを`{"height": int, "width" int}`で指定します。前処理に提供されたすべての画像サイズより大きい必要があります。`pad_size`が指定されない場合、バッチ内の最大の幅と高さにパディングされます。`do_pad=True.`の場合にのみ適用されます。
do_center_crop (`bool`, *kwargs*, *optional*) : 画像を中央クロップするかどうか。
data_format (`Union[str, ~image_utils.ChannelDimension]`、*kwargs*、*optional*) : 対応するのは `ChannelDimension.FIRST` のみです。slow processors との互換性のために追加されました。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *任意*) : 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推論されます。以下のいずれかになります: - `"channels_first"` または `ChannelDimension.FIRST`: (num_channels, height, width) 形式の画像。 - `"channels_last"` または `ChannelDimension.LAST`: (height, width, num_channels) 形式の画像。 - `"none"` または `ChannelDimension.NONE`: (height, width) 形式の画像。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
disable_grouping (`bool`, *kwargs*, *optional*) : 画像をサイズごとにグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうかを指定します。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (`int`, *kwargs*, *任意*) : 入力内の各画像に使用される画像トークンの数です。後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
do_crop_margin (`bool`, *kwargs*, *optional*, デフォルトは `self.do_crop_margin`) : 画像の余白をクロップするかどうか。
do_thumbnail (`bool`, *kwargs*, *任意*、デフォルトは `self.do_thumbnail`) : thumbnail メソッドを使用して画像をリサイズするかどうか。
do_align_long_axis (`bool`, *kwargs*, *optional*, デフォルトは `self.do_align_long_axis`) : 90度回転させることで、画像の長軸を `size` の長軸に揃えるかどうかを指定します。
NougatImageProcessor 画像プロセッサを構築します。
#### preprocess[[transformers.NougatImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/image_processing_nougat.py#L74)
**パラメータ:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 前処理対象の画像。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチの画像を想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、`do_rescale=False` を設定してください。
do_convert_rgb (`bool`, *kwargs*, *optional*) : 画像を RGB に変換するかどうか。
do_resize (`bool`, *kwargs*, *optional*) : 画像をリサイズするかどうか。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : モデルへの最大入力次元を記述します。
default_to_square (`bool`, *kwargs*, *optional*) : size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` を適用した後の出力画像のサイズ。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 画像をリサイズする場合に使用するリサンプリングフィルタ。`PILImageResampling` の列挙型のいずれかです。`do_resize` が `True` に設定されている場合のみ有効です。
do_rescale (`bool`, *kwargs*, *任意*) : 画像をリスケールするかどうか。
rescale_factor (`float`, *kwargs*, *optional*) : `do_rescale` が `True` に設定されている場合、画像をリサイズするためのリスケール係数。
do_normalize (`bool`, *kwargs*, *optional*) : 画像を正規化するかどうかを指定します。
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : 正規化に使用する画像の平均値。`do_normalize` が `True` に設定されている場合のみ有効です。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : 正規化に使用する画像の標準偏差。`do_normalize` が `True` に設定されている場合のみ有効です。
do_pad (`bool`, *kwargs*, *任意*) : 画像にパディングを適用するかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。正確なパディング戦略はモデルによって異なります。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 画像をパディングするサイズを`{"height": int, "width" int}`で指定します。前処理に提供されたすべての画像サイズより大きい必要があります。`pad_size`が指定されない場合、バッチ内の最大の幅と高さにパディングされます。`do_pad=True.`の場合にのみ適用されます。
do_center_crop (`bool`, *kwargs*, *optional*) : 画像を中央クロップするかどうか。
data_format (`Union[str, ~image_utils.ChannelDimension]`、*kwargs*、*optional*) : 対応するのは `ChannelDimension.FIRST` のみです。slow processors との互換性のために追加されました。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *任意*) : 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推論されます。以下のいずれかになります: - `"channels_first"` または `ChannelDimension.FIRST`: (num_channels, height, width) 形式の画像。 - `"channels_last"` または `ChannelDimension.LAST`: (height, width, num_channels) 形式の画像。 - `"none"` または `ChannelDimension.NONE`: (height, width) 形式の画像。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
disable_grouping (`bool`, *kwargs*, *optional*) : 画像をサイズごとにグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうかを指定します。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (`int`, *kwargs*, *任意*) : 入力内の各画像に使用される画像トークンの数です。後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
do_crop_margin (`bool`, *kwargs*, *optional*, デフォルトは `self.do_crop_margin`) : 画像の余白をクロップするかどうか。
do_thumbnail (`bool`, *kwargs*, *任意*、デフォルトは `self.do_thumbnail`) : thumbnail メソッドを使用して画像をリサイズするかどうか。
do_align_long_axis (`bool`, *kwargs*, *optional*, デフォルトは `self.do_align_long_axis`) : 90度回転させることで、画像の長軸を `size` の長軸に揃えるかどうかを指定します。
**戻り値:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ メソッドによって返されるリスト/配列/テンソルの辞書('pixel_values' など)。
- **tensor_type** (`Union[None, str, TensorType]`、*省略可*) -- 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
## NougatImageProcessorPil[[transformers.NougatImageProcessorPil]]
#### transformers.NougatImageProcessorPil[[transformers.NougatImageProcessorPil]]
```python
transformers.NougatImageProcessorPil(**kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/image_processing_pil_nougat.py#L59)
**パラメータ:**
do_convert_rgb (`bool`, *kwargs*, *optional*) : 画像を RGB に変換するかどうか。
do_resize (`bool`, *kwargs*, *任意*, デフォルトは `True`) : 画像をリサイズするかどうか。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*、デフォルト値は`{'height' : 896, 'width': 672}`): モデルへの最大入力次元を記述します。
default_to_square (`bool`, *kwargs*, *任意*、デフォルトは `True`) : size が整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` を適用した後の出力画像のサイズ。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*、デフォルト値は`2`) : 画像のリサイズ時に使用するリサンプリングフィルタです。これは列挙型`PILImageResampling`のいずれかになります。`do_resize`が`True`に設定されている場合のみ、効果が現れます。
do_rescale (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像をリスケールするかどうか。
rescale_factor (`float`, *kwargs*, *optional*, デフォルトは `0.00392156862745098`) : `do_rescale` が `True` に設定されている場合、画像をリスケールするための係数。
do_normalize (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像を正規化するかどうかを指定します。
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, デフォルトは `[0.485, 0.456, 0.406]`) : 正規化に使用する画像の平均値です。`do_normalize` が `True` に設定されている場合のみ有効です。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, デフォルトは `[0.229, 0.224, 0.225]`) : 正規化に使用する画像の標準偏差。`do_normalize` が `True` に設定されている場合のみ有効です。
do_pad (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像にパディングを適用するかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。正確なパディング戦略はモデルによって異なります。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 画像をパディングするサイズを`{"height": int, "width" int}`で指定します。前処理に提供されたすべての画像サイズより大きい必要があります。`pad_size`が指定されない場合、バッチ内の最大の幅と高さにパディングされます。`do_pad=True.`の場合にのみ適用されます。
do_center_crop (`bool`, *kwargs*, *optional*) : 画像を中央クロップするかどうか。
data_format (`Union[str, ~image_utils.ChannelDimension]`、*kwargs*、*optional*) : 対応するのは `ChannelDimension.FIRST` のみです。slow processors との互換性のために追加されました。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *任意*) : 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推論されます。以下のいずれかになります: - `"channels_first"` または `ChannelDimension.FIRST`: (num_channels, height, width) 形式の画像。 - `"channels_last"` または `ChannelDimension.LAST`: (height, width, num_channels) 形式の画像。 - `"none"` または `ChannelDimension.NONE`: (height, width) 形式の画像。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
disable_grouping (`bool`, *kwargs*, *optional*) : 画像をサイズごとにグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうかを指定します。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (`int`, *kwargs*, *任意*) : 入力内の各画像に使用される画像トークンの数です。後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
do_crop_margin (`bool`, *kwargs*, *optional*, デフォルトは `self.do_crop_margin`) : 画像の余白をクロップするかどうか。
do_thumbnail (`bool`, *kwargs*, *任意*、デフォルトは `self.do_thumbnail`) : thumbnail メソッドを使用して画像をリサイズするかどうか。
do_align_long_axis (`bool`, *kwargs*, *optional*, デフォルトは `self.do_align_long_axis`) : 90度回転させることで、画像の長軸を `size` の長軸に揃えるかどうかを指定します。
NougatImageProcessor 画像プロセッサを構築します。
#### preprocess[[transformers.NougatImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/image_processing_pil_nougat.py#L76)
**パラメータ:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 前処理対象の画像。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチの画像を想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、`do_rescale=False` を設定してください。
do_convert_rgb (`bool`, *kwargs*, *optional*) : 画像を RGB に変換するかどうか。
do_resize (`bool`, *kwargs*, *optional*) : 画像をリサイズするかどうか。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : モデルへの最大入力次元を記述します。
default_to_square (`bool`, *kwargs*, *optional*) : size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` を適用した後の出力画像のサイズ。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 画像をリサイズする場合に使用するリサンプリングフィルタ。`PILImageResampling` の列挙型のいずれかです。`do_resize` が `True` に設定されている場合のみ有効です。
do_rescale (`bool`, *kwargs*, *任意*) : 画像をリスケールするかどうか。
rescale_factor (`float`, *kwargs*, *optional*) : `do_rescale` が `True` に設定されている場合、画像をリサイズするためのリスケール係数。
do_normalize (`bool`, *kwargs*, *optional*) : 画像を正規化するかどうかを指定します。
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : 正規化に使用する画像の平均値。`do_normalize` が `True` に設定されている場合のみ有効です。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : 正規化に使用する画像の標準偏差。`do_normalize` が `True` に設定されている場合のみ有効です。
do_pad (`bool`, *kwargs*, *任意*) : 画像にパディングを適用するかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。正確なパディング戦略はモデルによって異なります。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 画像をパディングするサイズを`{"height": int, "width" int}`で指定します。前処理に提供されたすべての画像サイズより大きい必要があります。`pad_size`が指定されない場合、バッチ内の最大の幅と高さにパディングされます。`do_pad=True.`の場合にのみ適用されます。
do_center_crop (`bool`, *kwargs*, *optional*) : 画像を中央クロップするかどうか。
data_format (`Union[str, ~image_utils.ChannelDimension]`、*kwargs*、*optional*) : 対応するのは `ChannelDimension.FIRST` のみです。slow processors との互換性のために追加されました。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *任意*) : 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推論されます。以下のいずれかになります: - `"channels_first"` または `ChannelDimension.FIRST`: (num_channels, height, width) 形式の画像。 - `"channels_last"` または `ChannelDimension.LAST`: (height, width, num_channels) 形式の画像。 - `"none"` または `ChannelDimension.NONE`: (height, width) 形式の画像。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
disable_grouping (`bool`, *kwargs*, *optional*) : 画像をサイズごとにグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうかを指定します。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (`int`, *kwargs*, *任意*) : 入力内の各画像に使用される画像トークンの数です。後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
do_crop_margin (`bool`, *kwargs*, *optional*, デフォルトは `self.do_crop_margin`) : 画像の余白をクロップするかどうか。
do_thumbnail (`bool`, *kwargs*, *任意*、デフォルトは `self.do_thumbnail`) : thumbnail メソッドを使用して画像をリサイズするかどうか。
do_align_long_axis (`bool`, *kwargs*, *optional*, デフォルトは `self.do_align_long_axis`) : 90度回転させることで、画像の長軸を `size` の長軸に揃えるかどうかを指定します。
**戻り値:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ メソッドによって返されるリスト/配列/テンソルの辞書('pixel_values' など)。
- **tensor_type** (`Union[None, str, TensorType]`、*省略可*) -- 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
## NougatTokenizer[[transformers.NougatTokenizer]]
#### transformers.NougatTokenizer[[transformers.NougatTokenizer]]
```python
transformers.NougatTokenizer(errors: str = 'replace', unk_token: str = '', bos_token: str = '
', eos_token: str = '', pad_token: str = '', vocab: str | dict | list | None = None, merges: str | list | None = None, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/tokenization_nougat.py#L347)
**パラメータ:**
vocab_file (`str`, *任意*) : 語彙ファイルへのパス。
merges_file (`str`, *任意*) : マージファイルへのパス。
tokenizer_file (`str`、*任意*) : トークナイザーを読み込むために必要な情報がすべて含まれている [tokenizers](https://github.com/huggingface/tokenizers) ファイル(通常は .json 拡張子を持っています)。
clean_up_tokenization_spaces (`str`、*任意*、デフォルトは`False`) : デコード後にスペースをクリーンアップするかどうか。クリーンアップとは、余分なスペースなどの潜在的なアーティファクトを削除することです。
unk_token (`str`、*任意*、デフォルトは `""`) : 不明トークン。語彙に存在しないトークンは ID に変換できず、代わりにこのトークンが設定されます。
bos_token (`str`、*任意*、デフォルトは`""`) : 事前学習中に使用されたシーケンスの開始トークンです。シーケンス分類器のトークンとして使用できます。
eos_token (`str`、*任意*、デフォルトは `""`) : シーケンスの終了トークン。
pad_token (`str`、*任意*、デフォルトは `""`) : パディングに使用されるトークンです。長さの異なるシーケンスをバッチ処理する場合などに使用します。
vocab (`str`、`dict`または`list`、*省略可*) : カスタムの語彙辞書。指定しない場合、vocab_fileから語彙が読み込まれます。
merges (`str` または `list`、*省略可*) : カスタムなマージリスト。指定しない場合、マージは merges_file から読み込まれます。
Nougat用のTokenizer(HuggingFace tokenizersライブラリをベースにしています)。
このトークナイザーは、ほとんどの主要なメソッドを含む[TokenizersBackend](/docs/transformers/main/ja/main_classes/tokenizer#transformers.TokenizersBackend)を継承しています。これらのメソッドに関する詳細は、このスーパークラスを参照してください。このクラスは主に、生成テキストの後処理を行うNougat固有のメソッドを追加します。
#### correct_tables[[transformers.NougatTokenizer.correct_tables]]
```python
correct_tables(generation: str)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/tokenization_nougat.py#L493)
**パラメータ:**
generation (str) : 後処理対象の生成テキスト。
**戻り値:** `str`
後処理されたテキスト。
生成された文字列を受け取り、Markdown形式に必要とされるテーブル/表形式に修正します。
例:
```python
correct_tables("\begin{table} \begin{tabular}{l l} & \ \end{tabular} \end{table}")
"\begin{table}
abular}{l l} & \ \end{tabular}
le}"
```
#### post_process_generation[[transformers.NougatTokenizer.post_process_generation]]
```python
post_process_generation(generation: str | list[str], fix_markdown: bool = True, num_workers: int | None = None)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/tokenization_nougat.py#L623)
**パラメータ:**
generation (Union[str, list[str]]) : 生成されたテキスト、または生成されたテキストのリスト。
fix_markdown (`bool`、*任意*、デフォルトは`True`) : Markdownのフォーマット修正を実行するかどうか。
num_workers (`int`, *optional*) : マルチプロセッシングを活用するために渡すワーカーの任意の数(複数のテキストを並列で後処理する場合)。
**戻り値:** Union[str, list[str]]
後処理されたテキスト、または後処理されたテキストのリスト。
生成されたテキストまたは生成されたテキストのリストを後処理します。
この関数は、生成されたテキストの後処理、例えばMarkdownの書式修正などに使用できます。
後処理は比較的遅いため、処理を高速化するためにマルチプロセッシングの使用をお勧めします。
#### post_process_single[[transformers.NougatTokenizer.post_process_single]]
```python
post_process_single(generation: str, fix_markdown: bool = True)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/tokenization_nougat.py#L528)
**パラメータ:**
generation (str) : 後処理対象の生成テキスト。
fix_markdown (bool, optional) : Markdownのフォーマット修正を実行するかどうか。デフォルトはTrueです。
**戻り値:** `str`
後処理されたテキスト。
Postprocess a single generated text. ここでは、Nougat論文の著者が使用した正規表現をそのまま採用しています。これらの式は、明確さのためにコメントで説明されており、ほとんどのケースでエンドツーエンドでテストされています。
#### remove_hallucinated_references[[transformers.NougatTokenizer.remove_hallucinated_references]]
```python
remove_hallucinated_references(text: str)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/tokenization_nougat.py#L463)
**パラメータ:**
text (`str`) : 参照を含む入力テキスト。
**戻り値:** `str`
幻覚による参照が除去されたテキスト。
テキストから、幻覚(ハルシネーション)による参照や欠落した参照を削除します。
この関数は、入力テキストから、欠落または幻覚とマークされた参照を特定して削除します。
## NougatProcessor[[transformers.NougatProcessor]]
#### transformers.NougatProcessor[[transformers.NougatProcessor]]
```python
transformers.NougatProcessor(image_processor, tokenizer)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/processing_nougat.py#L37)
**パラメータ:**
image_processor (`NougatImageProcessor`) : 画像プロセッサは必須の入力です。
tokenizer (`NougatTokenizer`) : トークナイザーは必須の入力です。
NougatProcessorを構築します。画像プロセッサとトークナイザーを単一のプロセッサにラップします。
[NougatProcessor](/docs/transformers/main/ja/model_doc/nougat#transformers.NougatProcessor) は、[NougatImageProcessor](/docs/transformers/main/ja/model_doc/nougat#transformers.NougatImageProcessor) と [NougatTokenizer](/docs/transformers/main/ja/model_doc/nougat#transformers.NougatTokenizer) のすべての機能を提供します。詳細については、[~NougatImageProcessor](/docs/transformers/main/ja/model_doc/nougat#transformers.NougatImageProcessor) および [~NougatTokenizer](/docs/transformers/main/ja/model_doc/nougat#transformers.NougatTokenizer) を参照してください。
#### __call__[[transformers.NougatProcessor.__call__]]
```python
__call__(images = None, text = None, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/processing_nougat.py#L43)
**パラメータ:**
images (``) : Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, set `do_rescale=False`.
text (``) : The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, set `is_split_into_words=True` to avoid ambiguity with batched inputs.
return_tensors (`str` または [TensorType](/docs/transformers/main/ja/internal/file_utils#transformers.TensorType)、*optional*) : 設定されている場合、特定のフレームワークのテンソルを返します。受け入れ可能な値は以下の通りです: - `'pt'`: PyTorch の `torch.Tensor` オブジェクトを返します。 - `'np'`: NumPy の `np.ndarray` オブジェクトを返します。
#### from_pretrained[[transformers.NougatProcessor.from_pretrained]]
```python
from_pretrained(pretrained_model_name_or_path: str | os.PathLike, cache_dir: str | os.PathLike | None = None, force_download: bool = False, local_files_only: bool = False, token: str | bool | None = None, revision: str = 'main', **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L1697)
**パラメータ:**
pretrained_model_name_or_path (`str` または `os.PathLike`) : 以下のいずれかです: - huggingface.co のモデルリポジトリにホストされている事前学習済み feature_extractor の *model id* を示す文字列。 - [save_pretrained()](/docs/transformers/main/ja/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained) メソッドを使用して feature extractor ファイルを保存した *ディレクトリ* へのパス。例: `./my_model_directory/`。 - 保存された feature extractor の JSON *ファイル* へのパス。例: `./my_model_directory/preprocessor_config.json`。
- ****kwargs** : [from_pretrained()](/docs/transformers/main/ja/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained) と `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained` の両方に渡される追加のキーワード引数。
事前学習済みモデルに関連付けられたプロセッサをインスタンス化します。
このクラスメソッドは、単にフィーチャーエクストラクターの [from_pretrained()](/docs/transformers/main/ja/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained)、イメージプロセッサーの [ImageProcessingMixin](/docs/transformers/main/ja/internal/image_processing_utils#transformers.ImageProcessingMixin)、およびトークナイザーの `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained` メソッドを呼び出しています。詳細については、上記のメソッドのドキュメント文字列を参照してください。
#### save_pretrained[[transformers.NougatProcessor.save_pretrained]]
```python
save_pretrained(save_directory, push_to_hub: bool = False, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L1112)
**パラメータ:**
save_directory (`str` または `os.PathLike`) : 特徴量抽出器の JSON ファイルとトークナイザーのファイルを保存するディレクトリ(存在しない場合は作成されます)。
push_to_hub (`bool`、*任意*、デフォルトは`False`) : モデルを保存した後、Hugging Face モデルハブにプッシュするかどうかを指定します。プッシュ先のリポジトリは`repo_id`で指定できます(指定しない場合、`save_directory`の名前があなたのネームスペース内でデフォルトとして使用されます)。
kwargs (`dict[str, Any]`、*省略可*) : [push_to_hub()](/docs/transformers/main/ja/main_classes/model#transformers.utils.PushToHubMixin.push_to_hub) メソッドに渡される追加のキーワード引数。
このプロセッサ(フィーチャーエクストラクター、トークナイザーなど)の属性を指定されたディレクトリに保存し、[from_pretrained()](/docs/transformers/main/ja/model_doc/wav2vec2#transformers.Wav2Vec2Processor.from_pretrained) メソッドによって再読み込みできるようにします。
このクラスメソッドは、[save_pretrained()](/docs/transformers/main/ja/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained)と[save_pretrained()](/docs/transformers/main/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.save_pretrained)を呼び出すだけです。詳細については、上記のメソッドのドキュメント文字列を参照してください。
#### batch_decode[[transformers.NougatProcessor.batch_decode]]
```python
batch_decode(*args, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L1952)
このメソッドは、すべての引数を PreTrainedTokenizer の [batch_decode()](/docs/transformers/main/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.batch_decode) に転送します。詳細については、このメソッドのドキュメント文字列を参照してください。
#### decode[[transformers.NougatProcessor.decode]]
```python
decode(*args, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L1961)
このメソッドは、すべての引数を PreTrainedTokenizer の [decode()](/docs/transformers/main/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.decode) に転送します。詳細については、このメソッドのドキュメント文字列を参照してください。
#### post_process_generation[[transformers.NougatProcessor.post_process_generation]]
```python
post_process_generation(*args, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/processing_nougat.py#L51)
このメソッドは、すべての引数を NougatTokenizer の `~PreTrainedTokenizer.post_process_generation` に転送します。詳細については、このメソッドのドキュメント文字列を参照してください。