# Audio Spectrogram Transformer
## Visão geral
O modelo Audio Spectrogram Transformer foi proposto em [AST: Audio Spectrogram Transformer](https://huggingface.co/papers/2104.01778) por Yuan Gong, Yu-An Chung e James Glass. O Audio Spectrogram Transformer aplica um [Vision Transformer](vit) a áudio, convertendo o áudio em uma imagem (espectrograma). O modelo obtém resultados de estado da arte para classificação de áudio.
O resumo do artigo é o seguinte:
*Nas últimas décadas, as redes neurais convolucionais (CNNs) foram amplamente adotadas como o principal bloco de construção para modelos de classificação de áudio de ponta a ponta, que visam aprender um mapeamento direto de espectrogramas de áudio para os rótulos correspondentes. Para capturar melhor o contexto global de longo alcance, uma tendência recente é adicionar um mecanismo de autoatenção sobre a CNN, formando um modelo híbrido CNN-atenção. No entanto, não está claro se a dependência de uma CNN é necessária e se redes neurais baseadas puramente em atenção são suficientes para obter bom desempenho na classificação de áudio. Neste artigo, respondemos a essa pergunta introduzindo o Audio Spectrogram Transformer (AST), o primeiro modelo sem convoluções, baseado puramente em atenção, para classificação de áudio. Avaliamos o AST em vários benchmarks de classificação de áudio, onde ele atinge novos resultados state-of-the-art de 0,485 mAP no AudioSet, 95,6% de precisão no ESC-50 e 98,1% de precisão no Speech Commands V2.*
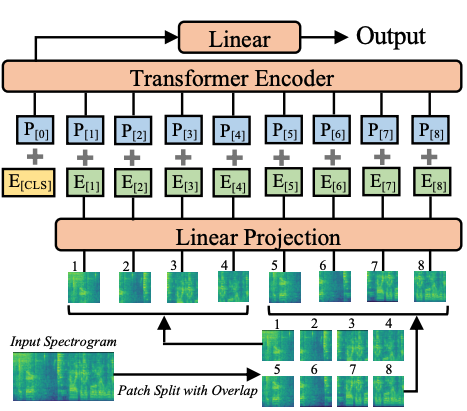 Arquitetura do Audio Spectrogram Transformer. Retirada do artigo original.
Este modelo foi contribuído por [nielsr](https://huggingface.co/nielsr). O código original pode ser encontrado [aqui](https://github.com/YuanGongND/ast).
## Dicas de uso
- Ao fazer o ajuste fino do Audio Spectrogram Transformer (AST) no seu próprio conjunto de dados, é recomendável cuidar da normalização da entrada (para
certifique-se de que a entrada tem média de 0 e desvio padrão de 0,5). O [ASTFeatureExtractor](/docs/transformers/main/pt/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor) cuida disso. Observe que ele usa a média e o desvio padrão do AudioSet por padrão. Você pode verificar [`ast/src/get_norm_stats.py`](https://github.com/YuanGongND/ast/blob/master/src/get_norm_stats.py) para ver como os autores calculam as estatísticas para um conjunto de dados de nível inferior.
- Observe que a AST requer uma taxa de aprendizado baixa (os autores usam uma taxa de aprendizado 10 vezes menor em comparação com o modelo CNN proposto no
[artigo do PSLA](https://huggingface.co/papers/2102.01243)) e converge rapidamente, portanto, procure uma taxa de aprendizado e um agendador de taxa de aprendizado adequados para sua tarefa.
### Usando Scaled Dot Product Attention (SDPA)
O PyTorch inclui um operador nativo de atenção de produto escalar escalonado (SDPA) como parte de `torch.nn.functional`. Essa função abrange várias implementações que podem ser aplicadas dependendo das entradas e do hardware em uso. Consulte a [documentação oficial](https://pytorch.org/docs/stable/generated/torch.nn.functional.scaled_dot_product_attention.html) ou a página [GPU Inference](https://huggingface.co/docs/transformers/main/en/perf_infer_gpu_one#pytorch-scaled-dot-product-attention) para mais informações.
O SDPA é usado por padrão para `torch>=2.1.1` quando uma implementação está disponível, mas você também pode definir `attn_implementation="sdpa"` em `from_pretrained()` para solicitar explicitamente o uso do SDPA.
```python
from transformers import ASTForAudioClassification
model = ASTForAudioClassification.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593", attn_implementation="sdpa", device_map="auto")
...
```
Para obter as melhores acelerações, recomendamos carregar o modelo em meia precisão (por exemplo, `torch.float16` ou `torch.bfloat16`).
Em um benchmark local (A100-40GB, PyTorch 2.3.0, sistema operacional Ubuntu 22.04) com `float32` e o modelo `MIT/ast-finetuned-audioset-10-10-0.4593`, observamos os seguintes aumentos de velocidade durante a inferência.
| Tamanho do lote | Tempo médio de inferência (ms), modo eager | Tempo médio de inferência (ms), modelo sdpa | Aceleração, Sdpa / Eager (x) |
|--------------|-------------------------------------------|-------------------------------------------|------------------------------|
| 1 | 27 | 6 | 4.5 |
| 2 | 12 | 6 | 2 |
| 4 | 21 | 8 | 2.62 |
| 8 | 40 | 14 | 2.86 |
## Recursos
Uma lista de recursos oficiais do Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o Audio Spectrogram Transformer.
- Um notebook ilustrando a inferência com AST para classificação de áudio pode ser encontrado [aqui](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/AST).
- [ASTForAudioClassification](/docs/transformers/main/pt/model_doc/audio-spectrogram-transformer#transformers.ASTForAudioClassification) é suportado por este [notebook](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/audio_classification.ipynb).
- Veja também: [Classificação de áudio](../tasks/audio_classification).
Se você tiver interesse em enviar um recurso para ser incluído aqui, sinta-se à vontade para abrir um Pull Request e faremos a revisão! O recurso deve, idealmente, demonstrar algo novo, em vez de duplicar um recurso existente.
## ASTConfig[[transformers.ASTConfig]]
#### transformers.ASTConfig[[transformers.ASTConfig]]
```python
transformers.ASTConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, patch_size: int | list[int] | tuple[int, int] = 16, qkv_bias: bool = True, frequency_stride: int = 10, time_stride: int = 10, max_length: int = 1024, num_mel_bins: int = 128)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/configuration_audio_spectrogram_transformer.py#L24)
**Parâmetros:**
hidden_size (`int`, *opcional*, padrão `768`) : Dimensão das representações ocultas.
num_hidden_layers (`int`, *opcional*, padrão `12`) : Número de camadas ocultas no decodificador do Transformer.
num_attention_heads (`int`, *opcional*, padrão `12`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
intermediate_size (`int`, *opcional*, padrão `3072`) : Dimensão das representações do MLP.
hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.0`) : A probabilidade de dropout para todas as camadas totalmente conectadas nos embeddings, no encoder e no pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.0`) : A taxa de dropout para as probabilidades de atenção.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
layer_norm_eps (`float`, *opcional*, padrão `1e-12`) : O epsilon usado pelas camadas de normalização de camada.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `16`) : O tamanho (resolução) de cada patch.
qkv_bias (`bool`, *opcional*, padrão `True`) : Se deve adicionar um viés às queries, keys e values.
frequency_stride (`int`, *opcional*, padrão 10) : Passo de frequência a ser usado ao aplicar patchificação nos espectrogramas.
time_stride (`int`, *opcional*, padrão 10) : Passada temporal a ser usada ao aplicar patchificação nos espectrogramas.
max_length (`int`, *opcional*, padrão 1024) : Dimensão temporal dos espectrogramas.
num_mel_bins (`int`, *opcional*, padrão `128`) : Número de recursos mel usados por quadro de entrada. Deve corresponder ao valor usado na classe `AutoFeatureExtractor`.
Esta é a classe de configuração para armazenar a configuração de um modelo Audio Spectrogram Transformer. Ela é usada para instanciar um modelo Audio Spectrogram Transformer de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os valores padrão resultará em uma configuração semelhante à do [MIT/ast-finetuned-audioset-10-10-0.4593](https://huggingface.co/MIT/ast-finetuned-audioset-10-10-0.4593)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import ASTConfig, ASTModel
>>> # Initializing a AST MIT/ast-finetuned-audioset-10-10-0.4593 style configuration
>>> configuration = ASTConfig()
>>> # Initializing a model (with random weights) from the MIT/ast-finetuned-audioset-10-10-0.4593 style configuration
>>> model = ASTModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ASTFeatureExtractor[[transformers.ASTFeatureExtractor]]
#### transformers.ASTFeatureExtractor[[transformers.ASTFeatureExtractor]]
```python
transformers.ASTFeatureExtractor(feature_size = 1, sampling_rate = 16000, num_mel_bins = 128, max_length = 1024, padding_value = 0.0, do_normalize = True, mean = -4.2677393, std = 4.5689974, return_attention_mask = False, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/feature_extraction_audio_spectrogram_transformer.py#L38)
**Parâmetros:**
feature_size (`int`, *opcional*, padrão 1) : A dimensão dos recursos das características extraídas.
sampling_rate (`int`, *opcional*, padrão 16000) : A taxa de amostragem na qual os arquivos de áudio devem ser digitalizados, expressa em hertz (Hz).
num_mel_bins (`int`, *opcional*, padrão 128) : Número de bins de frequência Mel.
max_length (`int`, *opcional*, padrão 1024) : Comprimento máximo para o qual as características extraídas devem ser preenchidas/truncadas.
do_normalize (`bool`, *opcional*, padrão `True`) : Se as características log-Mel devem ser normalizadas usando `mean` e `std`.
mean (`float`, *opcional*, padrão -4.2677393) : O valor médio usado para normalizar os recursos log-Mel. Usa a média do AudioSet por padrão.
std (`float`, *opcional*, padrão 4.5689974) : O valor do desvio padrão usado para normalizar os recursos log-Mel. Usa o desvio padrão do AudioSet por padrão.
return_attention_mask (`bool`, *opcional*, padrão `False`) : Se [__call__()](/docs/transformers/main/pt/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__) deve retornar `attention_mask` ou não.
Constrói um extrator de recursos Audio Spectrogram Transformer (AST).
Este extrator de características herda de [SequenceFeatureExtractor](/docs/transformers/main/pt/main_classes/feature_extractor#transformers.SequenceFeatureExtractor), que contém a maioria dos métodos principais. Os usuários devem consultar esta superclasse para obter mais informações sobre esses métodos.
Esta classe extrai recursos de banco de filtros mel a partir de fala bruta usando TorchAudio, se instalado, ou numpy caso contrário, faz o preenchimento/truncamento para um comprimento fixo e os normaliza usando uma média e um desvio padrão.
#### __call__[[transformers.ASTFeatureExtractor.__call__]]
```python
__call__(raw_speech: numpy.ndarray | list[float] | list[numpy.ndarray] | list[list[float]], sampling_rate: int | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/feature_extraction_audio_spectrogram_transformer.py#L160)
**Parâmetros:**
raw_speech (`np.ndarray`, `list[float]`, `list[np.ndarray]`, `list[list[float]]`) : A sequência ou lote de sequências a serem preenchidas. Cada sequência pode ser um array numpy, uma lista de valores float, uma lista de arrays numpy ou uma lista de listas de valores float. Deve ser áudio mono canal, não estéreo, ou seja, um único float por timestep.
sampling_rate (`int`, *opcional*) : A taxa de amostragem na qual a entrada `raw_speech` foi amostrada. É fortemente recomendável passar `sampling_rate` na chamada de forward para evitar erros silenciosos.
return_tensors (`str` ou [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *opcional*) : Se definido, retornará tensores em vez de lista de inteiros do Python. Os valores aceitos são: - `'pt'`: Retorna objetos `torch.Tensor` do PyTorch. - `'np'`: Retorna objetos `np.ndarray` do Numpy.
Método principal para criar recursos e preparar uma ou várias sequências para o modelo.
## ASTModel[[transformers.ASTModel]]
#### transformers.ASTModel[[transformers.ASTModel]]
```python
transformers.ASTModel(config: ASTConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L257)
**Parâmetros:**
config ([ASTConfig](/docs/transformers/main/pt/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Audio Spectrogram Transformer básico que produz estados ocultos brutos, sem nenhuma cabeça específica no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.ASTModel.forward]]
```python
forward(input_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L273)
**Parâmetros:**
input_values (`torch.Tensor` de forma `(batch_size, max_length, num_mel_bins)`) : Valores flutuantes das características mel extraídas da forma de onda de áudio bruto. A forma de onda de áudio bruto pode ser obtida carregando um arquivo de áudio `.flac` ou `.wav` em um array do tipo `list[float]`, um `numpy.ndarray` ou um `torch.Tensor`, *por exemplo*, por meio da biblioteca torchcodec (`pip install torchcodec`) ou da biblioteca soundfile (`pip install soundfile`). Para preparar o array para `input_features`, o [AutoFeatureExtractor](/docs/transformers/main/pt/model_doc/auto#transformers.AutoFeatureExtractor) deve ser usado para extrair as características mel, aplicar padding e converter em um tensor do tipo `torch.Tensor`. Consulte [__call__()](/docs/transformers/main/pt/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
**Retorna:** [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([ASTConfig](/docs/transformers/main/pt/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) e das entradas.
O método forward do [ASTModel](/docs/transformers/main/pt/model_doc/audio-spectrogram-transformer#transformers.ASTModel) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
## ASTForAudioClassification[[transformers.ASTForAudioClassification]]
#### transformers.ASTForAudioClassification[[transformers.ASTForAudioClassification]]
```python
transformers.ASTForAudioClassification(config: ASTConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L327)
**Parâmetros:**
config ([ASTConfig](/docs/transformers/main/pt/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo Audio Spectrogram Transformer com uma cabeça de classificação de áudio no topo (uma camada linear sobre a saída agregada), por exemplo, para conjuntos de dados como AudioSet e Speech Commands v2.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.ASTForAudioClassification.forward]]
```python
forward(input_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L340)
**Parâmetros:**
input_values (`torch.Tensor` de forma `(batch_size, max_length, num_mel_bins)`) : Valores flutuantes das características mel extraídas da forma de onda de áudio bruto. A forma de onda de áudio bruto pode ser obtida carregando um arquivo de áudio `.flac` ou `.wav` em um array do tipo `list[float]`, um `numpy.ndarray` ou um `torch.Tensor`, *por exemplo*, por meio da biblioteca torchcodec (`pip install torchcodec`) ou da biblioteca soundfile (`pip install soundfile`). Para preparar o array em `input_features`, o [AutoFeatureExtractor](/docs/transformers/main/pt/model_doc/auto#transformers.AutoFeatureExtractor) deve ser usado para extrair as características mel, aplicar padding e converter em um tensor do tipo `torch.Tensor`. Veja [__call__()](/docs/transformers/main/pt/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__)
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para o cálculo da perda de classificação/regressão de áudio. Os índices devem estar em `[0, ..., config.num_labels - 1]`. Se `config.num_labels == 1`, uma perda de regressão é calculada (perda de erro quadrático médio). Se `config.num_labels > 1`, uma perda de classificação é calculada (entropia cruzada).
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
**Retorna:** [SequenceClassifierOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) ou `tuple(torch.Tensor)`
Um [SequenceClassifierOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([ASTConfig](/docs/transformers/main/pt/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) e das entradas.
O método forward de [ASTForAudioClassification](/docs/transformers/main/pt/model_doc/audio-spectrogram-transformer#transformers.ASTForAudioClassification) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação (ou de regressão se config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplo:
```python
>>> from transformers import AutoFeatureExtractor, ASTForAudioClassification
>>> from datasets import load_dataset
>>> import torch
>>> dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
>>> dataset = dataset.sort("id")
>>> sampling_rate = dataset.features["audio"].sampling_rate
>>> feature_extractor = AutoFeatureExtractor.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")
>>> model = ASTForAudioClassification.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")
>>> # audio file is decoded on the fly
>>> inputs = feature_extractor(dataset[0]["audio"]["array"], sampling_rate=sampling_rate, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_class_ids = torch.argmax(logits, dim=-1).item()
>>> predicted_label = model.config.id2label[predicted_class_ids]
>>> predicted_label
...
>>> # compute loss - target_label is e.g. "down"
>>> target_label = model.config.id2label[0]
>>> inputs["labels"] = torch.tensor([model.config.label2id[target_label]])
>>> loss = model(**inputs).loss
>>> round(loss.item(), 2)
...
```