# BEiT
## Visão geral
O modelo BEiT foi proposto em [BEiT: BERT Pre-Training of Image Transformers](https://huggingface.co/papers/2106.08254) por Hangbo Bao, Li Dong e Furu Wei. Inspirado no BERT, o BEiT é o primeiro artigo que faz o pré-treinamento auto-supervisionado de Vision Transformers (ViTs) superar o pré-treinamento supervisionado. Em vez de pré-treinar o modelo para prever a classe de uma imagem (como feito no [artigo original do ViT](https://huggingface.co/papers/2010.11929)), os modelos BEiT são pré-treinados para prever tokens visuais a partir do codebook do modelo [DALL-E](https://huggingface.co/papers/2102.12092) da OpenAI, dados patches mascarados.
O resumo do artigo é o seguinte:
*Apresentamos um modelo de representação visual auto-supervisionado chamado BEiT, que significa Bidirectional Encoder representation from Image Transformers. Seguindo o BERT, desenvolvido na área de processamento de linguagem natural, propomos uma tarefa de modelagem de imagens mascaradas para pré-treinar Transformers visuais. Especificamente, cada imagem possui duas visualizações em nosso pré-treino, ou seja, patches de imagem (como 16x16 pixels) e tokens visuais (ou seja, tokens discretos). Primeiro, "tokenizamos" a imagem original em tokens visuais. Em seguida, mascaramos aleatoriamente alguns patches de imagem e os alimentamos no Transformer principal. O objetivo do pré-treino é recuperar os tokens visuais originais com base nos patches de imagem corrompidos. Após o pré-treino do BEiT, ajustamos diretamente os parâmetros do modelo em tarefas de baixo nível adicionando camadas de tarefa sobre o codificador pré-treinado. Os resultados experimentais em classificação de imagens e segmentação semântica mostram que nosso modelo alcança resultados competitivos em comparação com métodos de pré-treino anteriores. Por exemplo, o BEiT de tamanho base atinge 83,2% de precisão top-1 no ImageNet-1K, superando significativamente o treinamento DeiT do zero (81,8%) com a mesma configuração. Além disso, o BEiT de tamanho grande obtém 86,3% usando apenas o ImageNet-1K, superando até mesmo o ViT-L com pré-treino supervisionado no ImageNet-22K (85,2%).*
Este modelo foi contribuído por [nielsr](https://huggingface.co/nielsr). O código original pode ser encontrado [aqui](https://github.com/microsoft/unilm/tree/master/beit).
## Dicas de uso
- Os modelos BEiT são Vision Transformers regulares, mas pré-treinados de forma auto-supervisionada, em vez de supervisionada. Eles superam tanto o [modelo original (ViT)](vit) quanto o [Data-efficient Image Transformers (DeiT)](deit) quando ajustados no ImageNet-1K e no CIFAR-100. Você pode conferir notebooks de demonstração sobre inferência e ajuste fino em dados personalizados [aqui](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/VisionTransformer) (basta substituir [ViTImageProcessor](/docs/transformers/main/pt/model_doc/vit#transformers.ViTImageProcessor) por [BeitImageProcessor](/docs/transformers/main/pt/model_doc/beit#transformers.BeitImageProcessor) e [ViTForImageClassification](/docs/transformers/main/pt/model_doc/vit#transformers.ViTForImageClassification) por [BeitForImageClassification](/docs/transformers/main/pt/model_doc/beit#transformers.BeitForImageClassification)).
- Também está disponível um notebook de demonstração que mostra como combinar o tokenizer de imagens do DALL-E com o BEiT para realizar modelagem de imagens mascaradas. Você pode encontrá-lo [aqui](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/BEiT).
- Como os modelos BEiT esperam que cada imagem tenha o mesmo tamanho (resolução), é possível usar [BeitImageProcessor](/docs/transformers/main/pt/model_doc/beit#transformers.BeitImageProcessor) para redimensionar (ou reescalar) e normalizar as imagens para o modelo.
- Tanto a resolução dos patches quanto a resolução das imagens usadas durante o pré-treinamento ou o ajuste fino são refletidas no nome de cada checkpoint. Por exemplo, `microsoft/beit-base-patch16-224` se refere a uma arquitetura de tamanho base com resolução de patch de 16x16 e resolução de ajuste fino de 224x224. Todos os checkpoints podem ser encontrados no [hub](https://huggingface.co/models?search=microsoft/beit).
- Os checkpoints disponíveis são (1) pré-treinados apenas no [ImageNet-22k](http://www.image-net.org/) (uma coleção de 14 milhões de imagens e 22 mil classes), (2) também ajustados finamente no ImageNet-22k ou (3) também ajustados finamente no [ImageNet-1k](http://www.image-net.org/challenges/LSVRC/2012/) (também referido como ILSVRC 2012, uma coleção de 1,3 milhão de imagens e 1.000 classes).
- O BEiT usa incorporações de posição relativa, inspirado no modelo T5. Durante o pré-treino, os autores compartilharam o viés de posição relativa entre as várias camadas de autoatenção. Durante o ajuste fino, o viés de posição relativa de cada camada é inicializado com o viés de posição relativa compartilhado obtido após o pré-treino. Observe que, se você deseja pré-treinar um modelo do zero, é necessário definir o atributo `use_relative_position_bias` ou `use_relative_position_bias` de [BeitConfig](/docs/transformers/main/pt/model_doc/beit#transformers.BeitConfig) como `True` para adicionar incorporações de posição.
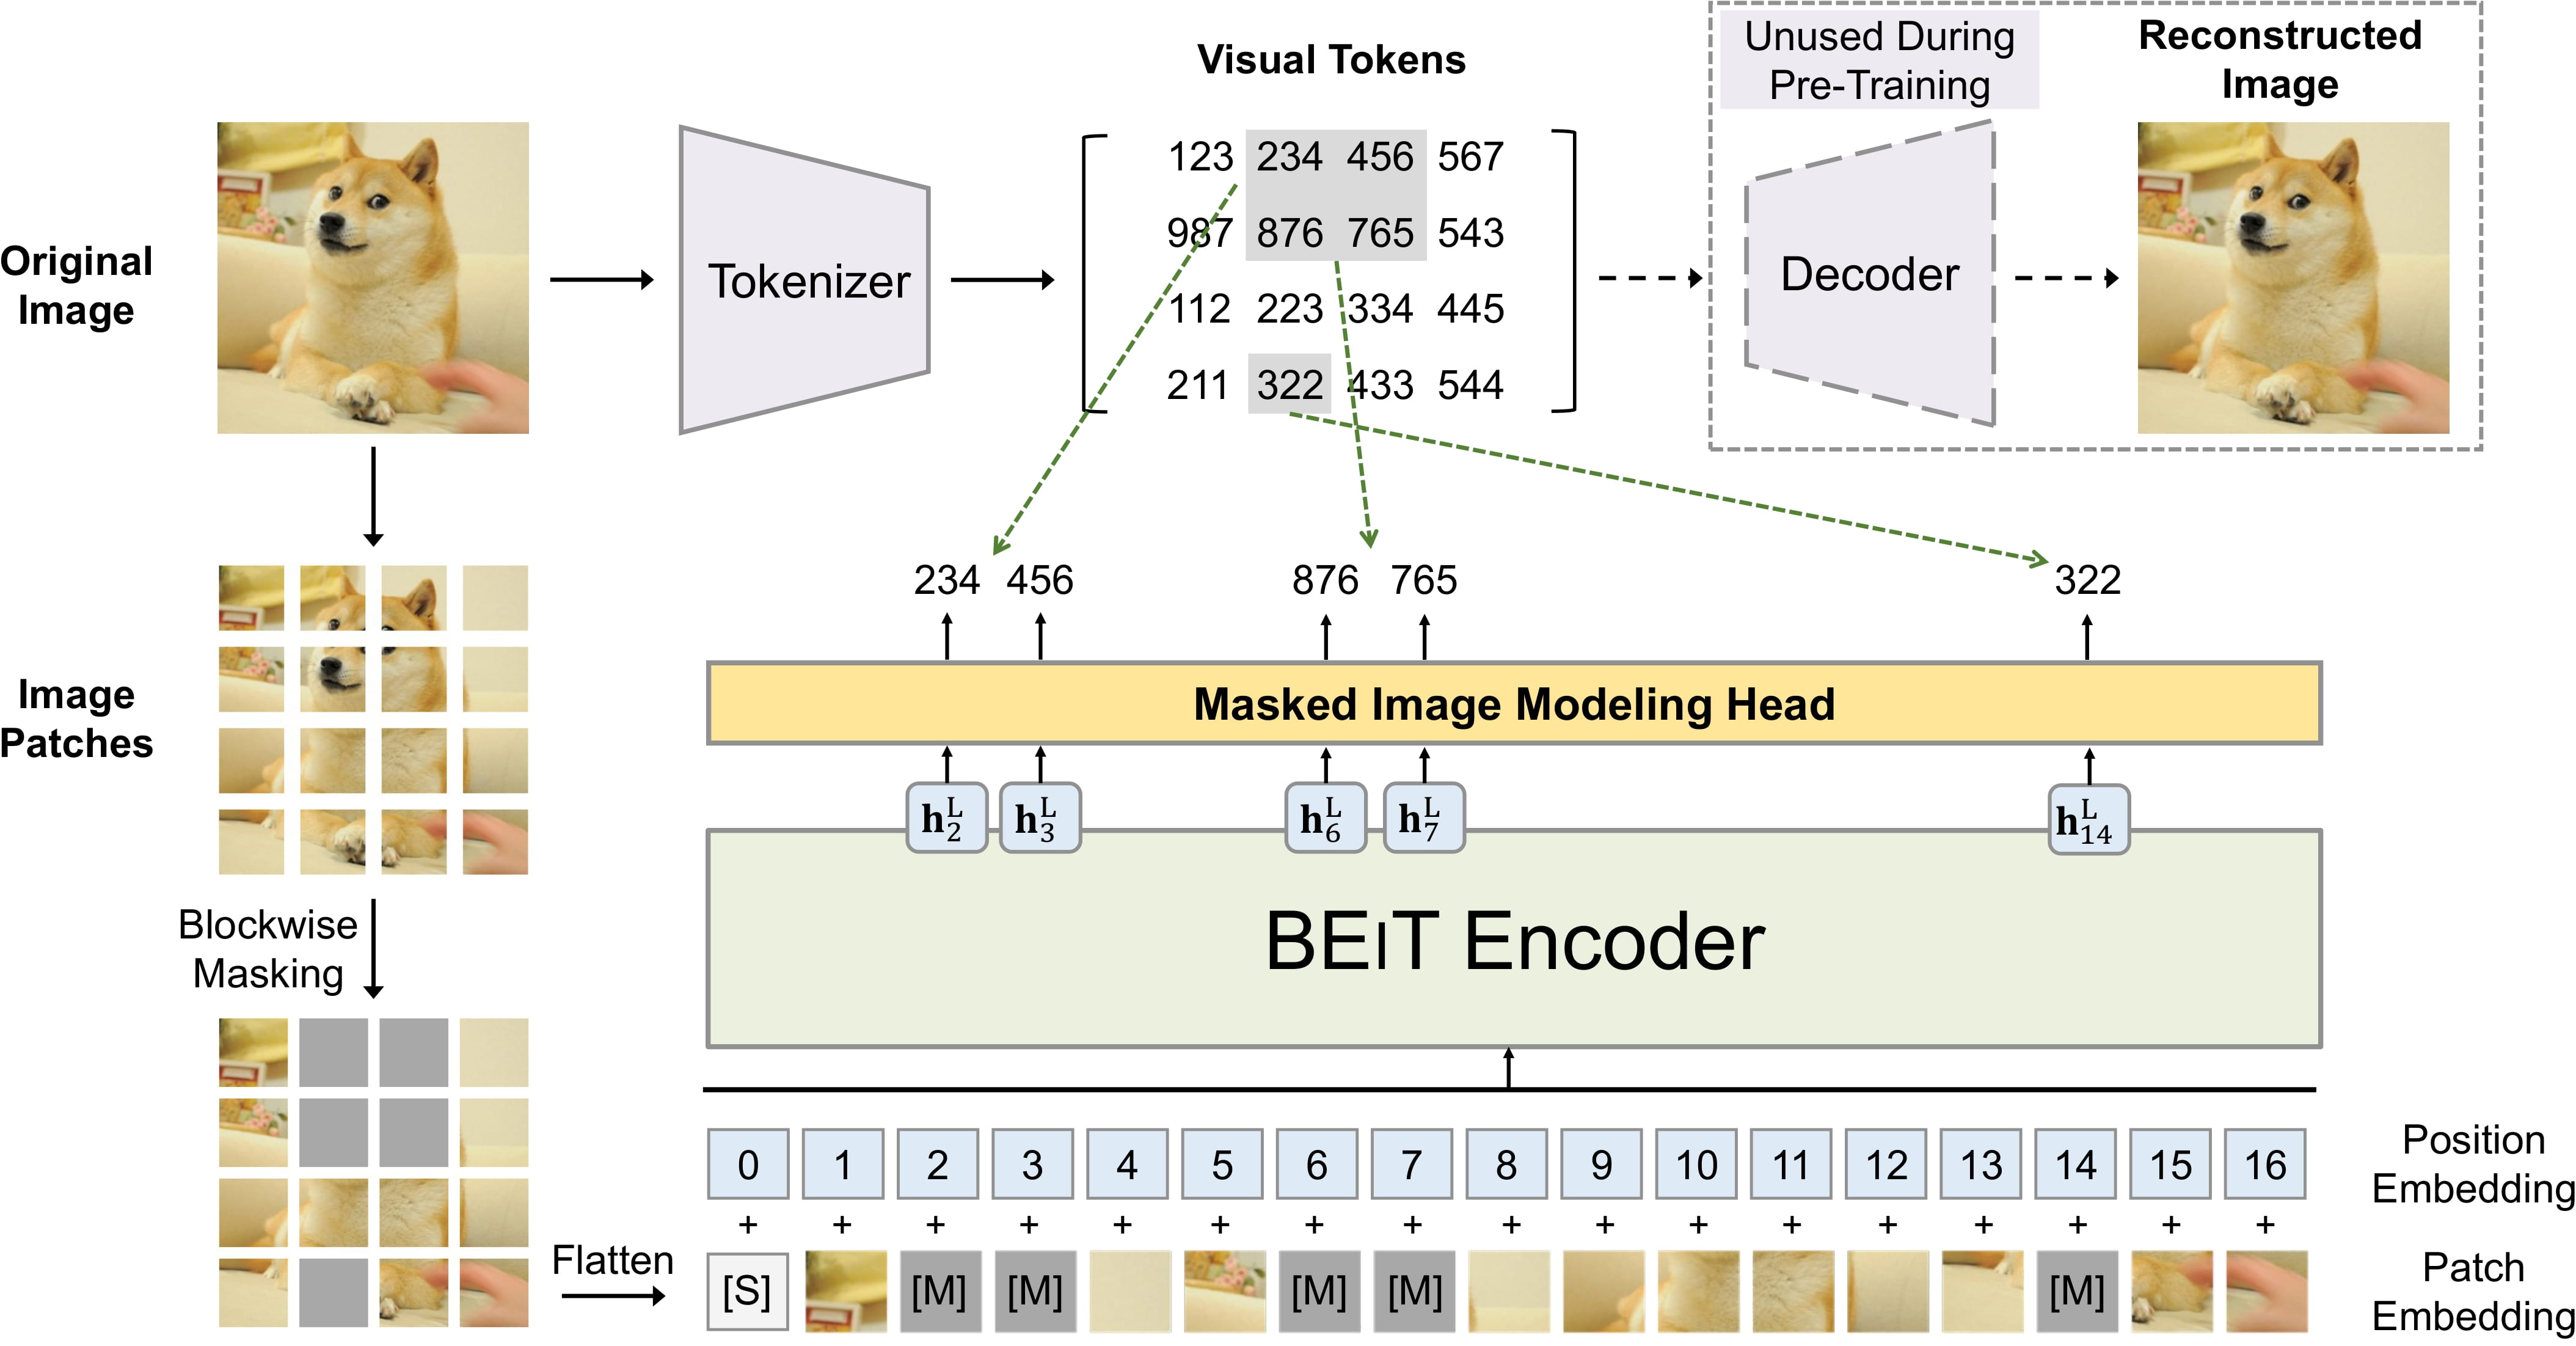 Pré-treino do BEiT. Retirado do artigo original.
### Usando Scaled Dot Product Attention (SDPA)
O PyTorch inclui um operador nativo de atenção de produto escalar escalonado (SDPA) como parte de `torch.nn.functional`. Essa função abrange várias implementações que podem ser aplicadas dependendo das entradas e do hardware em uso. Consulte a [documentação oficial](https://pytorch.org/docs/stable/generated/torch.nn.functional.scaled_dot_product_attention.html) ou a página [GPU Inference](https://huggingface.co/docs/transformers/main/en/perf_infer_gpu_one#pytorch-scaled-dot-product-attention) para mais informações.
O SDPA é usado por padrão para `torch>=2.1.1` quando uma implementação está disponível, mas você também pode definir `attn_implementation="sdpa"` em `from_pretrained()` para solicitar explicitamente o uso do SDPA.
```python
from transformers import BeitForImageClassification
model = BeitForImageClassification.from_pretrained("microsoft/beit-base-patch16-224", attn_implementation="sdpa", device_map="auto")
...
```
Para obter as melhores acelerações, recomendamos carregar o modelo em meia precisão (por exemplo, `torch.float16` ou `torch.bfloat16`).
Em um benchmark local (NVIDIA GeForce RTX 2060-8GB, PyTorch 2.5.1, SO Ubuntu 20.04) com `float16` e o modelo `microsoft/beit-base-patch16-224`, observamos as seguintes melhorias durante o treinamento e a inferência:
#### Treinamento
| num_training_steps | batch_size | image_size | is_cuda | Tempo por lote (eager - s) | Tempo por lote (sdpa - s) | Aceleração (%) | Memória de pico Eager (MB) | Mem. de pico do SDPA (MB) | Economia de memória (%) |
|--------------------|------------|--------------|---------|----------------------------|---------------------------|-------------|----------------------|--------------------|----------------|
| 50 | 2 | (1048, 640) | True | 0.984 | 0.746 | 31.975 | 6738.915 | 4319.886 | 55.998 |
#### Inferência
| Tamanho do lote de imagens | Eager (s/iter) | CI Eager, % | Memória eager (MB) | SDPA (s/iter) | SDPA CI, % | Memória do SDPA (MB) | Aceleração do SDPA | Memória economizada pelo SDPA (%) |
|-------------------:|-----------------:|:--------------|--------------------:|----------------:|:-------------|-------------------:|---------------:|----------------------:|
| 1 | 0.012 | ±0.3% | 3.76657e+08 | 0.011 | ±0.5% | 3.75739e+08 | 1.05 | 0.244 |
| 4 | 0.013 | ±0.1% | 4.03147e+08 | 0.011 | ±0.2% | 3.90554e+08 | 1.178 | 3.225 |
| 16 | 0.045 | ±0.1% | 4.96697e+08 | 0.035 | ±0.1% | 4.51232e+08 | 1.304 | 10.076 |
| 32 | 0.088 | ±0.1% | 6.24417e+08 | 0.066 | ±0.1% | 5.33488e+08 | 1.325 | 17.044 |
## Recursos
Uma lista de recursos oficiais da Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o BEiT.
- [BeitForImageClassification](/docs/transformers/main/pt/model_doc/beit#transformers.BeitForImageClassification) é suportado por este [notebook](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb).
- Veja também: [Guia da tarefa de classificação de imagens](../tasks/image_classification)
**Segmentação semântica**
- [Guia da tarefa de segmentação semântica](../tasks/semantic_segmentation)
Se você tiver interesse em enviar um recurso para ser incluído aqui, sinta-se à vontade para abrir um Pull Request e faremos a revisão! O recurso deve, idealmente, demonstrar algo novo, em vez de duplicar um recurso existente.
## Saídas específicas do BEiT[[transformers.models.beit.modeling_beit.BeitModelOutputWithPooling]]
#### transformers.models.beit.modeling_beit.BeitModelOutputWithPooling[[transformers.models.beit.modeling_beit.BeitModelOutputWithPooling]]
```python
transformers.models.beit.modeling_beit.BeitModelOutputWithPooling(last_hidden_state: typing.Optional[torch.Tensor] = None, pooler_output: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor, ...] | None = None, attentions: tuple[torch.Tensor, ...] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L54)
**Parâmetros:**
last_hidden_state (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) : Sequência de estados ocultos na saída da última camada do modelo.
pooler_output (`torch.Tensor` de forma `(batch_size, hidden_size)`) : Média dos estados ocultos da última camada dos tokens de patch (excluindo o token *[CLS]*) se *config.use_mean_pooling* estiver definido como True. Se definido como False, o estado oculto final do token *[CLS]* será retornado.
hidden_states (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) : Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`. Estados ocultos do modelo na saída de cada camada, além das saídas iniciais opcionais dos embeddings.
attentions (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) : Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`. Pesos das atenções após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Classe para as saídas de [BeitModel](/docs/transformers/main/pt/model_doc/beit#transformers.BeitModel).
## BeitConfig[[transformers.BeitConfig]]
#### transformers.BeitConfig[[transformers.BeitConfig]]
```python
transformers.BeitConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 8192, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, use_mask_token: bool = False, use_absolute_position_embeddings: bool = False, use_relative_position_bias: bool = False, use_shared_relative_position_bias: bool = False, layer_scale_init_value: float = 0.1, drop_path_rate: float | int = 0.1, use_mean_pooling: bool = True, pool_scales: list[int] | tuple[int, ...] = (1, 2, 3, 6), use_auxiliary_head: bool = True, auxiliary_loss_weight: float = 0.4, auxiliary_channels: int = 256, auxiliary_num_convs: int = 1, auxiliary_concat_input: bool = False, semantic_loss_ignore_index: int = 255, _out_features: list[str] | None = None, _out_indices: list[int] | None = None, add_fpn: bool = False, reshape_hidden_states: bool = True)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/configuration_beit.py#L25)
**Parâmetros:**
vocab_size (`int`, *opcional*, padrão `8192`) : Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelos `input_ids`.
hidden_size (`int`, *opcional*, padrão `768`) : Dimensão das representações ocultas.
num_hidden_layers (`int`, *opcional*, padrão `12`) : Número de camadas ocultas no decodificador do Transformer.
num_attention_heads (`int`, *opcional*, padrão `12`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
intermediate_size (`int`, *opcional*, padrão `3072`) : Dimensão das representações do MLP.
hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.0`) : A probabilidade de dropout para todas as camadas totalmente conectadas nos embeddings, no encoder e no pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.0`) : A taxa de dropout para as probabilidades de atenção.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
layer_norm_eps (`float`, *opcional*, padrão `1e-12`) : O epsilon usado pelas camadas de normalização de camada.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `224`) : O tamanho (resolução) de cada imagem.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `16`) : O tamanho (resolução) de cada patch.
num_channels (`int`, *opcional*, padrão `3`) : O número de canais de entrada.
use_mask_token (`bool`, *opcional*, padrão `False`) : Se deve usar um token de máscara para modelagem de imagem mascarada.
use_absolute_position_embeddings (`bool`, *opcional*, padrão `False`) : Se deve usar embeddings de posição absoluta.
use_relative_position_bias (`bool`, *opcional*, padrão `False`) : Se deve usar embeddings de posição relativa no estilo T5 nas camadas de autoatenção.
use_shared_relative_position_bias (`bool`, *opcional*, padrão `False`) : Se deve usar os mesmos embeddings de posição relativa em todas as camadas de autoatenção do Transformer.
layer_scale_init_value (`float`, *opcional*, padrão `0.1`) : Escala a ser usada nas camadas de autoatenção. 0.1 para base, 1e-6 para grande. Defina 0 para desativar a escala da camada.
drop_path_rate (`Union[float, int]`, *opcional*, padrão `0.1`) : Taxa de drop path para a fusão de patches.
use_mean_pooling (`bool`, *opcional*, padrão `True`) : Se deve aplicar a média das camadas ocultas finais dos patches, em vez de usar a camada oculta final do token CLS, antes de aplicar a cabeça de classificação.
pool_scales (`tuple[int]`, *opcional*, padrão `[1, 2, 3, 6]`) : Escalas de pooling usadas no Pooling Pyramid Module aplicadas ao último mapa de características.
use_auxiliary_head (`bool`, *opcional*, padrão `True`) : Se deve usar uma cabeça auxiliar durante o treinamento.
auxiliary_loss_weight (`float`, *opcional*, padrão 0.4) : Peso da perda de entropia cruzada da cabeça auxiliar.
auxiliary_channels (`int`, *opcional*, padrão 256) : Número de canais a serem usados na cabeça auxiliar.
auxiliary_num_convs (`int`, *opcional*, padrão 1) : Número de camadas convolucionais a serem usadas na cabeça auxiliar.
auxiliary_concat_input (`bool`, *opcional*, padrão `False`) : Indica se a saída da cabeça auxiliar deve ser concatenada com a entrada antes da camada de classificação.
semantic_loss_ignore_index (`int`, *opcional*, padrão `255`) : O índice que é ignorado pela função de perda do modelo de segmentação semântica.
add_fpn (`bool`, *opcional*, padrão `False`) : Se deve adicionar um FPN como parte do backbone. Relevante apenas para `BeitBackbone`.
reshape_hidden_states (`bool`, *opcional*, padrão `True`) : Se deve redimensionar os mapas de características para tensores 4D de forma `(batch_size, hidden_size, height, width)` caso o modelo seja usado como backbone. Se `False`, os mapas de características serão tensores 3D de forma `(batch_size, seq_len, hidden_size)`. Relevante apenas para `BeitBackbone`.
Esta é a classe de configuração para armazenar a configuração de um BeitModel. Ela é usada para instanciar um modelo Beit de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [microsoft/beit-base-patch16-224-pt22k](https://huggingface.co/microsoft/beit-base-patch16-224-pt22k)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import BeitConfig, BeitModel
>>> # Initializing a BEiT beit-base-patch16-224-pt22k style configuration
>>> configuration = BeitConfig()
>>> # Initializing a model (with random weights) from the beit-base-patch16-224-pt22k style configuration
>>> model = BeitModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## BeitImageProcessor[[transformers.BeitImageProcessor]]
#### transformers.BeitImageProcessor[[transformers.BeitImageProcessor]]
```python
transformers.BeitImageProcessor(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_beit.py#L50)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 224, 'width': 224}`): Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 224, 'width': 224}`): Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `3`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.5, 0.5, 0.5]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.5, 0.5, 0.5]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve aplicar um recorte centralizado na imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
do_reduce_labels (`bool`, *kwargs*, *opcional*, padrão `self.do_reduce_labels`) : Indica se todos os valores de rótulo dos mapas de segmentação devem ser reduzidos em 1. Geralmente usado em conjuntos de dados em que 0 é usado para o plano de fundo e o próprio plano de fundo não está incluído em todas as classes do conjunto de dados (por exemplo, ADE20k). O rótulo do plano de fundo será substituído por 255.
Constrói um processador de imagem BeitImageProcessor.
#### preprocess[[transformers.BeitImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_beit.py#L70)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
segmentation_maps (`ImageInput`, *opcional*) : Os mapas de segmentação a serem pré-processados.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
do_reduce_labels (`bool`, *kwargs*, *opcional*, padrão `self.do_reduce_labels`) : Indica se todos os valores de rótulo dos mapas de segmentação devem ser reduzidos em 1. Geralmente usado em conjuntos de dados em que 0 é usado para o plano de fundo e o próprio plano de fundo não está incluído em todas as classes do conjunto de dados (por exemplo, ADE20k). O rótulo do plano de fundo será substituído por 255.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
#### post_process_semantic_segmentation[[transformers.BeitImageProcessor.post_process_semantic_segmentation]]
```python
post_process_semantic_segmentation(outputs, target_sizes: list[tuple] | None = None, return_segmentation_scores: bool = False)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_beit.py#L183)
**Parâmetros:**
outputs ([BeitForSemanticSegmentation](/docs/transformers/main/pt/model_doc/beit#transformers.BeitForSemanticSegmentation)) : Saídas brutas do modelo.
target_sizes (`list[Tuple]` de comprimento `batch_size`, *opcional*) : Lista de tuplas correspondente ao tamanho final solicitado (altura, largura) de cada previsão. Se não definido, as previsões não serão redimensionadas.
return_segmentation_scores (`bool`, *opcional*, padrão `False`) : Se deve retornar as pontuações de segmentação junto com o mapa de segmentação. Quando `True`, cada elemento da lista retornada é um `SemanticSegmentationPostProcessorOutput` com os campos `segmentation` (IDs de classe, forma `(height, width)`) e `segmentation_scores` (forma `(num_classes, height, width)`).
**Retorna:** `list[torch.Tensor]` ou `list[SemanticSegmentationPostProcessorOutput]`
Quando `return_segmentation_scores=False` (padrão), uma lista de comprimento `batch_size` em que cada item é um mapa de segmentação de forma `(height, width)` com IDs de classe. Quando `return_segmentation_scores=True`, uma lista de `SemanticSegmentationPostProcessorOutput` com os campos `segmentation` (IDs de classe, forma `(height, width)`) e `segmentation_scores` (forma `(num_classes, height, width)`). Em ambos os casos, `(height, width)` corresponde ao tamanho alvo (se `target_sizes` for especificado).
Converte a saída de [BeitForSemanticSegmentation](/docs/transformers/main/pt/model_doc/beit#transformers.BeitForSemanticSegmentation) em mapas de segmentação semântica.
## BeitImageProcessorPil[[transformers.BeitImageProcessorPil]]
#### transformers.BeitImageProcessorPil[[transformers.BeitImageProcessorPil]]
```python
transformers.BeitImageProcessorPil(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_pil_beit.py#L53)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 224, 'width': 224}`): Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 224, 'width': 224}`): Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `3`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.5, 0.5, 0.5]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.5, 0.5, 0.5]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve aplicar um recorte centralizado na imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
do_reduce_labels (`bool`, *kwargs*, *opcional*, padrão `self.do_reduce_labels`) : Indica se todos os valores de rótulo dos mapas de segmentação devem ser reduzidos em 1. Geralmente usado em conjuntos de dados em que 0 é usado para o plano de fundo e o próprio plano de fundo não está incluído em todas as classes do conjunto de dados (por exemplo, ADE20k). O rótulo do plano de fundo será substituído por 255.
Constrói um processador de imagem BeitImageProcessor.
#### preprocess[[transformers.BeitImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_pil_beit.py#L73)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
segmentation_maps (`ImageInput`, *opcional*) : Os mapas de segmentação a serem pré-processados.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
do_reduce_labels (`bool`, *kwargs*, *opcional*, padrão `self.do_reduce_labels`) : Indica se todos os valores de rótulo dos mapas de segmentação devem ser reduzidos em 1. Geralmente usado em conjuntos de dados em que 0 é usado para o plano de fundo e o próprio plano de fundo não está incluído em todas as classes do conjunto de dados (por exemplo, ADE20k). O rótulo do plano de fundo será substituído por 255.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
#### post_process_semantic_segmentation[[transformers.BeitImageProcessorPil.post_process_semantic_segmentation]]
```python
post_process_semantic_segmentation(outputs, target_sizes: list[tuple] | None = None, return_segmentation_scores: bool = False)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_pil_beit.py#L169)
**Parâmetros:**
outputs ([BeitForSemanticSegmentation](/docs/transformers/main/pt/model_doc/beit#transformers.BeitForSemanticSegmentation)) : Saídas brutas do modelo.
target_sizes (`list[Tuple]` de comprimento `batch_size`, *opcional*) : Lista de tuplas correspondente ao tamanho final solicitado (altura, largura) de cada previsão. Se não definido, as previsões não serão redimensionadas.
return_segmentation_scores (`bool`, *opcional*, padrão `False`) : Se deve retornar as pontuações de segmentação junto com o mapa de segmentação. Quando `True`, cada elemento da lista retornada é um `SemanticSegmentationPostProcessorOutput` com os campos `segmentation` (IDs de classe, forma `(height, width)`) e `segmentation_scores` (forma `(num_classes, height, width)`).
**Retorna:** `list[torch.Tensor]` ou `list[SemanticSegmentationPostProcessorOutput]`
Quando `return_segmentation_scores=False` (padrão), uma lista de comprimento `batch_size` em que cada item é um mapa de segmentação de forma `(height, width)` com IDs de classe. Quando `return_segmentation_scores=True`, uma lista de `SemanticSegmentationPostProcessorOutput` com os campos `segmentation` (IDs de classe, forma `(height, width)`) e `segmentation_scores` (forma `(num_classes, height, width)`). Em ambos os casos, `(height, width)` corresponde ao tamanho alvo (se `target_sizes` for especificado).
Converte a saída de [BeitForSemanticSegmentation](/docs/transformers/main/pt/model_doc/beit#transformers.BeitForSemanticSegmentation) em mapas de segmentação semântica.
## BeitModel[[transformers.BeitModel]]
#### transformers.BeitModel[[transformers.BeitModel]]
```python
transformers.BeitModel(config: BeitConfig, add_pooling_layer: bool = True)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L486)
**Parâmetros:**
config ([BeitConfig](/docs/transformers/main/pt/model_doc/beit#transformers.BeitConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
add_pooling_layer (`bool`, *opcional*, padrão `True`) : Se deve adicionar uma camada de pooling
O modelo Beit básico que produz estados ocultos brutos, sem nenhum cabeçalho específico no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.BeitModel.forward]]
```python
forward(pixel_values: Tensor, bool_masked_pos: typing.Optional[torch.BoolTensor] = None, interpolate_pos_encoding: bool = False, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L512)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [BeitImageProcessor](/docs/transformers/main/pt/model_doc/beit#transformers.BeitImageProcessor). Consulte [BeitImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para obter detalhes (`processor_class` usa [BeitImageProcessor](/docs/transformers/main/pt/model_doc/beit#transformers.BeitImageProcessor) para processar imagens).
bool_masked_pos (`torch.BoolTensor` de forma `(batch_size, num_patches)`, *opcional*) : Posições mascaradas booleanas. Indica quais patches estão mascarados (1) e quais não estão (0).
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
**Retorna:** [BeitModelOutputWithPooling](/docs/transformers/main/pt/model_doc/beit#transformers.models.beit.modeling_beit.BeitModelOutputWithPooling) ou `tuple(torch.Tensor)`
Um [BeitModelOutputWithPooling](/docs/transformers/main/pt/model_doc/beit#transformers.models.beit.modeling_beit.BeitModelOutputWithPooling) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`), composto por diversos elementos, dependendo da configuração ([BeitConfig](/docs/transformers/main/pt/model_doc/beit#transformers.BeitConfig)) e das entradas.
O método forward do [BeitModel](/docs/transformers/main/pt/model_doc/beit#transformers.BeitModel) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Média dos estados ocultos da última camada dos tokens de patch (excluindo o token *[CLS]*) se *config.use_mean_pooling* estiver definido como True. Se definido como False, o estado oculto final do token *[CLS]* será retornado.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplo:
```python
```
## BeitForMaskedImageModeling[[transformers.BeitForMaskedImageModeling]]
#### transformers.BeitForMaskedImageModeling[[transformers.BeitForMaskedImageModeling]]
```python
transformers.BeitForMaskedImageModeling(config: BeitConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L583)
**Parâmetros:**
config ([BeitConfig](/docs/transformers/main/pt/model_doc/beit#transformers.BeitConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo transformer Beit com uma cabeça de modelagem de 'linguagem' no topo. O BEiT realiza modelagem de imagem mascarada ao prever tokens visuais de um Vector-Quantize Variational Autoencoder (VQ-VAE), enquanto outros modelos de visão, como ViT e DeiT, preveem valores de pixels RGB. Como resultado, esta classe é incompatível com [AutoModelForMaskedImageModeling](/docs/transformers/main/pt/model_doc/auto#transformers.AutoModelForMaskedImageModeling), portanto, você precisará usar [BeitForMaskedImageModeling](/docs/transformers/main/pt/model_doc/beit#transformers.BeitForMaskedImageModeling) diretamente se desejar realizar modelagem de imagem mascarada com o BEiT.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.BeitForMaskedImageModeling.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, bool_masked_pos: typing.Optional[torch.BoolTensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L600)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [BeitImageProcessor](/docs/transformers/main/pt/model_doc/beit#transformers.BeitImageProcessor). Veja [BeitImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes (`processor_class` usa [BeitImageProcessor](/docs/transformers/main/pt/model_doc/beit#transformers.BeitImageProcessor) para processar imagens).
bool_masked_pos (`torch.BoolTensor` de forma `(batch_size, num_patches)`) : Posições mascaradas booleanas. Indica quais patches estão mascarados (1) e quais não estão (0).
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para o cálculo da perda de classificação/regressão de imagem. Os índices devem estar em `[0, ..., config.num_labels - 1]`. Se `config.num_labels == 1`, uma perda de regressão é calculada (perda de erro quadrático médio). Se `config.num_labels > 1`, uma perda de classificação é calculada (entropia cruzada).
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
**Retorna:** [MaskedLMOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) ou `tuple(torch.Tensor)`
Um [MaskedLMOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`), composto por vários elementos dependendo da configuração ([BeitConfig](/docs/transformers/main/pt/model_doc/beit#transformers.BeitConfig)) e das entradas.
O método forward de [BeitForMaskedImageModeling](/docs/transformers/main/pt/model_doc/beit#transformers.BeitForMaskedImageModeling) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de modelagem de linguagem mascarada (MLM).
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> from transformers import AutoImageProcessor, BeitForMaskedImageModeling
>>> import torch
>>> from PIL import Image
>>> import requests
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = Image.open(requests.get(url, stream=True).raw)
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> model = BeitForMaskedImageModeling.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> num_patches = (model.config.image_size // model.config.patch_size) ** 2
>>> pixel_values = image_processor(images=image, return_tensors="pt").pixel_values
>>> # create random boolean mask of shape (batch_size, num_patches)
>>> bool_masked_pos = torch.randint(low=0, high=2, size=(1, num_patches)).bool()
>>> outputs = model(pixel_values, bool_masked_pos=bool_masked_pos)
>>> loss, logits = outputs.loss, outputs.logits
>>> list(logits.shape)
[1, 196, 8192]
```
## BeitForImageClassification[[transformers.BeitForImageClassification]]
#### transformers.BeitForImageClassification[[transformers.BeitForImageClassification]]
```python
transformers.BeitForImageClassification(config: BeitConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L675)
**Parâmetros:**
config ([BeitConfig](/docs/transformers/main/pt/model_doc/beit#transformers.BeitConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo transformer Beit com uma cabeça de classificação de imagem no topo (uma camada linear sobre a média dos estados ocultos finais dos tokens de patch), por exemplo, para o ImageNet.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.BeitForImageClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L688)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [BeitImageProcessor](/docs/transformers/main/pt/model_doc/beit#transformers.BeitImageProcessor). Veja [BeitImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes (`processor_class` usa [BeitImageProcessor](/docs/transformers/main/pt/model_doc/beit#transformers.BeitImageProcessor) para processar imagens).
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para o cálculo da perda de classificação/regressão de imagem. Os índices devem estar em `[0, ..., config.num_labels - 1]`. Se `config.num_labels == 1`, uma perda de regressão é calculada (perda de erro quadrático médio). Se `config.num_labels > 1`, uma perda de classificação é calculada (entropia cruzada).
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** [ImageClassifierOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.ImageClassifierOutput) ou `tuple(torch.Tensor)`
Um [ImageClassifierOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.ImageClassifierOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`), composto por vários elementos dependendo da configuração ([BeitConfig](/docs/transformers/main/pt/model_doc/beit#transformers.BeitConfig)) e das entradas.
O método forward de [BeitForImageClassification](/docs/transformers/main/pt/model_doc/beit#transformers.BeitForImageClassification) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação (ou de regressão se config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (uma para a saída dos embeddings, se o modelo tiver uma camada de embedding, + uma para a saída de cada estágio) de forma `(batch_size, sequence_length, hidden_size)`. Hidden-states (também chamados de feature maps) do modelo na saída de cada estágio.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, patch_size, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplo:
```python
>>> from transformers import AutoImageProcessor, BeitForImageClassification
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> model = BeitForImageClassification.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```
## BeitForSemanticSegmentation[[transformers.BeitForSemanticSegmentation]]
#### transformers.BeitForSemanticSegmentation[[transformers.BeitForSemanticSegmentation]]
```python
transformers.BeitForSemanticSegmentation(config: BeitConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L978)
**Parâmetros:**
config ([BeitConfig](/docs/transformers/main/pt/model_doc/beit#transformers.BeitConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Beit com uma cabeça de segmentação semântica no topo, por exemplo, para ADE20K, CityScapes.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.BeitForSemanticSegmentation.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L1000)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [BeitImageProcessor](/docs/transformers/main/pt/model_doc/beit#transformers.BeitImageProcessor). Veja [BeitImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes (`processor_class` usa [BeitImageProcessor](/docs/transformers/main/pt/model_doc/beit#transformers.BeitImageProcessor) para processar imagens).
labels (`torch.LongTensor` de forma `(batch_size, height, width)`, *opcional*) : Mapas de segmentação semântica de verdade para o cálculo da perda. Os índices devem estar em `[0, ..., config.num_labels - 1]`. Se `config.num_labels > 1`, uma perda de classificação é calculada (Cross-Entropy).
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** [SemanticSegmenterOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.SemanticSegmenterOutput) ou `tuple(torch.Tensor)`
Um [SemanticSegmenterOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.SemanticSegmenterOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`), composto por vários elementos, dependendo da configuração ([BeitConfig](/docs/transformers/main/pt/model_doc/beit#transformers.BeitConfig)) e das entradas.
O método forward de [BeitForSemanticSegmentation](/docs/transformers/main/pt/model_doc/beit#transformers.BeitForSemanticSegmentation) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação (ou de regressão se config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels, logits_height, logits_width)`) -- Pontuações de classificação para cada pixel.
Os logits retornados não necessariamente têm o mesmo tamanho que os `pixel_values` passados como entradas. Isso é para evitar realizar duas interpolações e perder alguma qualidade quando um usuário precisa redimensionar os logits para o tamanho da imagem original como pós-processamento. Você deve sempre verificar a forma dos seus logits e redimensioná-los conforme necessário.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma `(batch_size, patch_size, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, patch_size, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> from transformers import AutoImageProcessor, BeitForSemanticSegmentation
>>> from PIL import Image
>>> import requests
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = Image.open(requests.get(url, stream=True).raw)
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-finetuned-ade-640-640")
>>> model = BeitForSemanticSegmentation.from_pretrained("microsoft/beit-base-finetuned-ade-640-640")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # logits are of shape (batch_size, num_labels, height, width)
>>> logits = outputs.logits
```