# BLIP-2
## Visão geral
O modelo BLIP-2 foi proposto em [BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models](https://huggingface.co/papers/2301.12597) por Junnan Li, Dongxu Li, Silvio Savarese e Steven Hoi. O BLIP-2 aproveita codificadores de imagem pré-treinados congelados e grandes modelos de linguagem (LLMs) treinando um codificador Transformer leve, de 12 camadas, entre eles, alcançando desempenho de estado da arte em diversas tarefas de visão-linguagem. Notavelmente, o BLIP-2 supera o [Flamingo](https://huggingface.co/papers/2204.14198), um modelo com 80 bilhões de parâmetros, em 8,7% no zero-shot VQAv2, com 54x menos parâmetros treináveis.
O resumo do artigo é o seguinte:
*O custo do pré-treino de visão e linguagem tornou-se cada vez mais proibitivo devido ao treinamento de ponta a ponta de modelos em larga escala. Este artigo propõe o BLIP-2, uma estratégia de pré-treino genérica e eficiente que inicia o pré-treino de visão e linguagem a partir de codificadores de imagem pré-treinados e congelados, prontos para uso, e de grandes modelos de linguagem congelados. O BLIP-2 reduz a lacuna entre modalidades por meio de um Querying Transformer leve, que é pré-treinado em duas etapas. A primeira etapa inicia o aprendizado de representações de visão e linguagem a partir de um codificador de imagem congelado. A segunda etapa inicia o aprendizado generativo de visão para linguagem a partir de um modelo de linguagem congelado. O BLIP-2 atinge desempenho de estado da arte em diversas tarefas de visão e linguagem, apesar de ter significativamente menos parâmetros treináveis do que os métodos existentes. Por exemplo, nosso modelo supera o Flamingo80B em 8,7% no zero-shot VQAv2, com 54x menos parâmetros treináveis. Também demonstramos as capacidades emergentes do modelo de geração de imagem para texto em zero-shot, que pode seguir instruções em linguagem natural.*
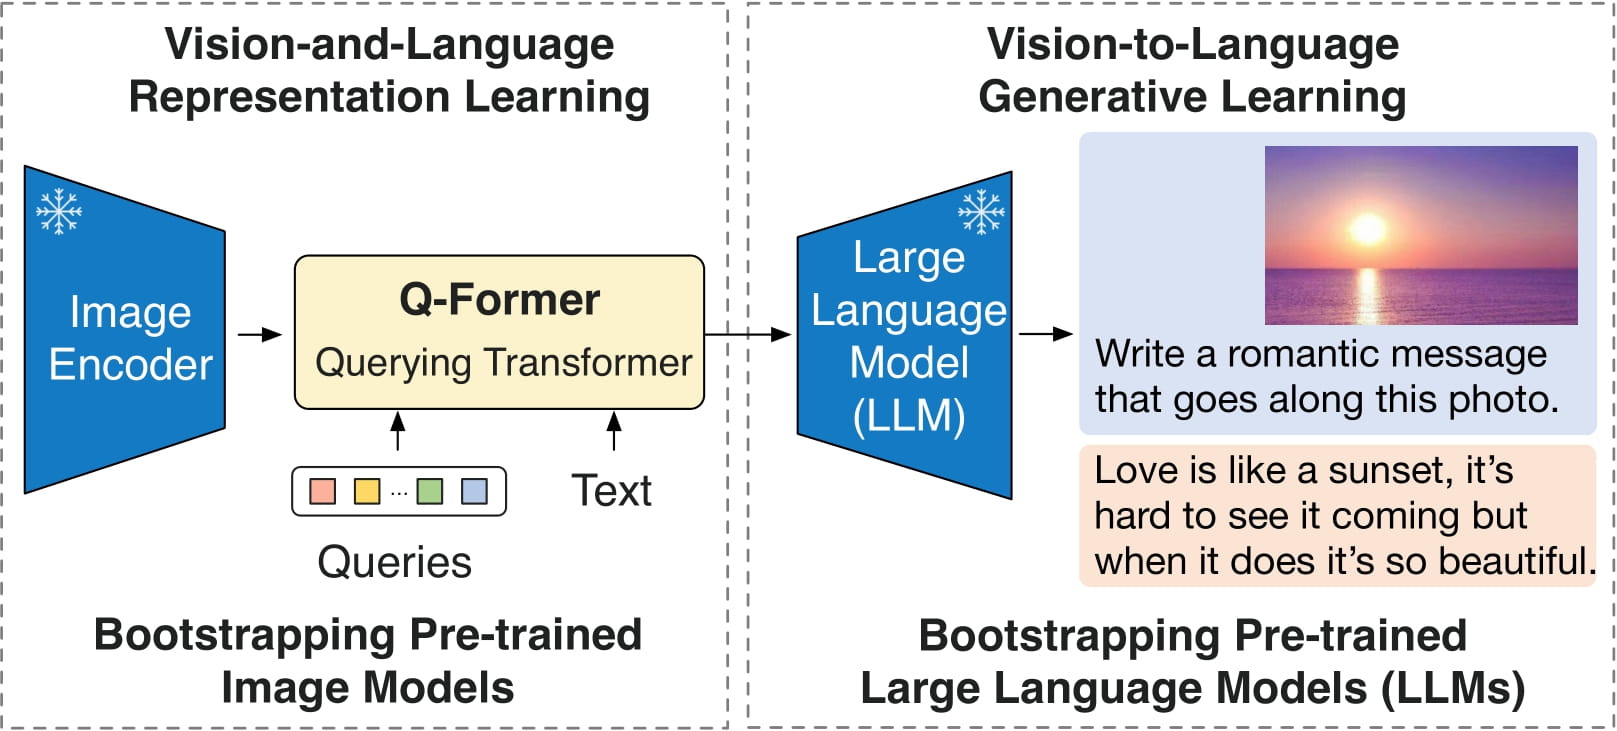 Arquitetura do BLIP-2. Retirada do artigo original.
Este modelo foi contribuído por [nielsr](https://huggingface.co/nielsr). O código original pode ser encontrado [aqui](https://github.com/salesforce/LAVIS/tree/5ee63d688ba4cebff63acee04adaef2dee9af207).
## Dicas de uso
- O BLIP-2 pode ser usado para geração de texto condicional a partir de uma imagem e de um prompt de texto opcional. No momento da inferência, recomenda-se usar o método `generate`.
- É possível usar [Blip2Processor](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Processor) para preparar as imagens para o modelo e decodificar os IDs dos tokens previstos de volta para texto.
> [!NOTE]
> Modelos BLIP após a versão v4.46 emitirão avisos sobre a adição de `processor.num_query_tokens = {{num_query_tokens}}` e a expansão da camada de embeddings do modelo para incluir o token especial ``. É fortemente recomendável adicionar os atributos ao processor se você for o proprietário do checkpoint do modelo, ou abrir um PR caso não seja. Adicionar esses atributos significa que o BLIP adicionará o número de query tokens necessários por imagem e expandirá o texto com tantos placeholders `` quanto houver query tokens. Geralmente, são cerca de 500 tokens por imagem, portanto, certifique-se de que o texto não seja truncado, pois caso contrário ocorrerá falha ao mesclar os embeddings.
Os atributos podem ser obtidos a partir da configuração do modelo, como `model.config.num_query_tokens`, e a expansão dos embeddings do modelo pode ser feita seguindo [este link](https://gist.github.com/zucchini-nlp/e9f20b054fa322f84ac9311d9ab67042).
## Recursos
Uma lista de recursos oficiais do Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o BLIP-2.
- Os notebooks de demonstração do BLIP-2 para legendagem de imagens, resposta a perguntas visuais (VQA) e conversas em formato de chat podem ser encontrados [aqui](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/BLIP-2).
Se você tiver interesse em enviar um recurso para ser incluído aqui, sinta-se à vontade para abrir um Pull Request e faremos a revisão! O recurso deve, idealmente, demonstrar algo novo, em vez de duplicar um recurso existente.
## Blip2Config[[transformers.Blip2Config]]
#### transformers.Blip2Config[[transformers.Blip2Config]]
```python
transformers.Blip2Config(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, qformer_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_query_tokens: int = 32, image_text_hidden_size: int = 256, image_token_index: int | None = None, initializer_factor: float = 1.0, initializer_range: float = 0.02)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/configuration_blip_2.py#L107)
**Parâmetros:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : O objeto de configuração ou dicionário do backbone de visão.
qformer_config (`dict`, *opcional*) : Dicionário de opções de configuração usadas para inicializar [Blip2QFormerConfig](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2QFormerConfig).
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : O objeto de configuração ou dicionário do backbone de texto.
num_query_tokens (`int`, *opcional*, padrão 32) : O número de tokens de consulta passados pelo Transformer.
image_text_hidden_size (`int`, *opcional*, padrão 256) : Dimensionalidade do estado oculto da camada de fusão de imagem e texto.
image_token_index (`int`, *opcional*) : O índice do token de imagem usado como marcador de posição para as imagens de entrada.
initializer_factor (`float`, *opcional*, padrão `1.0`) : Um fator para inicializar todas as matrizes de pesos (deve ser mantido em 1, usado internamente para testes de inicialização).
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
Esta é a classe de configuração para armazenar a configuração de um modelo Blip 2. Ela é usada para instanciar um modelo Blip 2 de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os valores padrão resultará em uma configuração semelhante à do [Salesforce/blip2-opt-2.7b](https://huggingface.co/Salesforce/blip2-opt-2.7b)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import (
... Blip2VisionConfig,
... Blip2QFormerConfig,
... OPTConfig,
... Blip2Config,
... Blip2ForConditionalGeneration,
... )
>>> # Initializing a Blip2Config with Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2Config()
>>> # Initializing a Blip2ForConditionalGeneration (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2ForConditionalGeneration(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a Blip2Config from a Blip2VisionConfig, Blip2QFormerConfig and any PreTrainedConfig
>>> # Initializing BLIP-2 vision, BLIP-2 Q-Former and language model configurations
>>> vision_config = Blip2VisionConfig()
>>> qformer_config = Blip2QFormerConfig()
>>> text_config = OPTConfig()
>>> config = Blip2Config(vision_config=vision_config, qformer_config=qformer_config, text_config=text_config)
```
## Blip2VisionConfig[[transformers.Blip2VisionConfig]]
#### transformers.Blip2VisionConfig[[transformers.Blip2VisionConfig]]
```python
transformers.Blip2VisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 1408, intermediate_size: int = 6144, num_hidden_layers: int = 39, num_attention_heads: int = 16, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 14, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06, attention_dropout: float | int = 0.0, initializer_range: float = 1e-10, qkv_bias: bool = True)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/configuration_blip_2.py#L29)
**Parâmetros:**
hidden_size (`int`, *opcional*, padrão `1408`) : Dimensão das representações ocultas.
intermediate_size (`int`, *opcional*, padrão `6144`) : Dimensão das representações do MLP.
num_hidden_layers (`int`, *opcional*, padrão `39`) : Número de camadas ocultas no decodificador do Transformer.
num_attention_heads (`int`, *opcional*, padrão `16`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `224`) : O tamanho (resolução) de cada imagem.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `14`) : O tamanho (resolução) de cada patch.
hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *opcional*, padrão `1e-06`) : O epsilon usado pelas camadas de normalização de camada.
attention_dropout (`Union[float, int]`, *opcional*, padrão `0.0`) : A taxa de dropout para as probabilidades de atenção.
initializer_range (`float`, *opcional*, padrão `1e-10`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
qkv_bias (`bool`, *opcional*, padrão `True`) : Se deve adicionar um viés às queries, keys e values.
Esta é a classe de configuração para armazenar a configuração de um modelo Blip 2. Ela é usada para instanciar um modelo Blip 2 de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os valores padrão resultará em uma configuração semelhante à do [Salesforce/blip2-opt-2.7b](https://huggingface.co/Salesforce/blip2-opt-2.7b)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import Blip2VisionConfig, Blip2VisionModel
>>> # Initializing a Blip2VisionConfig with Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2VisionConfig()
>>> # Initializing a Blip2VisionModel (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2VisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Blip2QFormerConfig[[transformers.Blip2QFormerConfig]]
#### transformers.Blip2QFormerConfig[[transformers.Blip2QFormerConfig]]
```python
transformers.Blip2QFormerConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 512, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, cross_attention_frequency: int = 2, encoder_hidden_size: int = 1408, use_qformer_text_input: bool = False)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/configuration_blip_2.py#L64)
**Parâmetros:**
vocab_size (`int`, *opcional*, padrão `30522`) : Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelos `input_ids`.
hidden_size (`int`, *opcional*, padrão `768`) : Dimensão das representações ocultas.
num_hidden_layers (`int`, *opcional*, padrão `12`) : Número de camadas ocultas no decodificador do Transformer.
num_attention_heads (`int`, *opcional*, padrão `12`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
intermediate_size (`int`, *opcional*, padrão `3072`) : Dimensão das representações do MLP.
hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.1`) : A probabilidade de dropout para todas as camadas totalmente conectadas nos embeddings, encoder e pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.1`) : A taxa de dropout para as probabilidades de atenção.
max_position_embeddings (`int`, *opcional*, padrão `512`) : O comprimento máximo de sequência com o qual este modelo pode ser utilizado.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
layer_norm_eps (`float`, *opcional*, padrão `1e-12`) : O epsilon usado pelas camadas de normalização de camada.
pad_token_id (`int`, *opcional*, padrão `0`) : ID do token usado para preenchimento no vocabulário.
cross_attention_frequency (`int`, *opcional*, padrão 2) : A frequência de adição de cross-attention às camadas do Transformer.
encoder_hidden_size (`int`, *opcional*, padrão `1408`) : Dimensão das representações ocultas.
use_qformer_text_input (`bool`, *opcional*, padrão `False`) : Se deve usar embeddings no estilo BERT.
Esta é a classe de configuração para armazenar a configuração de um modelo Blip 2. Ela é usada para instanciar um modelo Blip 2 de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os valores padrão resultará em uma configuração semelhante à do [Salesforce/blip2-opt-2.7b](https://huggingface.co/Salesforce/blip2-opt-2.7b)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplos:
```python
>>> from transformers import Blip2QFormerConfig, Blip2QFormerModel
>>> # Initializing a BLIP-2 Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2QFormerConfig()
>>> # Initializing a model (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2QFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Blip2Processor[[transformers.Blip2Processor]]
#### transformers.Blip2Processor[[transformers.Blip2Processor]]
```python
transformers.Blip2Processor(image_processor, tokenizer, num_query_tokens = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/processing_blip_2.py#L45)
**Parâmetros:**
image_processor (`BlipImageProcessor`) : O processador de imagem é uma entrada obrigatória.
tokenizer (`GPT2Tokenizer`) : O tokenizer é uma entrada obrigatória.
num_query_tokens (`int`, *opcional*) : Número de tokens usados pelo Qformer como consultas, deve ser o mesmo da configuração do modelo.
Constrói um Blip2Processor que encapsula um processador de imagem e um tokenizer em um único processador.
[Blip2Processor](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Processor) oferece todas as funcionalidades de [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor) e [GPT2Tokenizer](/docs/transformers/main/pt/model_doc/gpt2#transformers.GPT2Tokenizer). Consulte [~BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor) e [~GPT2Tokenizer](/docs/transformers/main/pt/model_doc/gpt2#transformers.GPT2Tokenizer) para mais informações.
#### __call__[[transformers.Blip2Processor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/processing_blip_2.py#L61)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opcional*) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
text (`Union[str, list[str]]`, *opcional*) : A sequência ou lote de sequências a serem codificadas. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se você passar uma entrada pretokenizada, defina `is_split_into_words=True` para evitar ambiguidade com entradas em lote.
return_tensors (`str` ou [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *opcional*) : Se definido, retornará tensores de um framework específico. Os valores aceitos são: - `'pt'`: Retorna objetos `torch.Tensor` do PyTorch. - `'np'`: Retorna objetos `np.ndarray` do NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/pt/main_classes/processors#transformers.ProcessingKwargs), *opcional*) : Opções de processamento adicionais para cada modalidade (texto, imagens, vídeos, áudio). Os parâmetros específicos do modelo estão listados acima; consulte a classe TypedDict para a lista completa de argumentos suportados.
**Retorna:** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`, *opcional*) -- Dicionário de listas/arrays/tensors retornados pelos métodos `__call__`/`encode_plus`/`batch_encode_plus` ('input_ids', 'attention_mask', etc.).
- **encoding** (`tokenizers.Encoding` ou `Sequence[tokenizers.Encoding]`, *opcional*) -- Se o tokenizer for um fast tokenizer que fornece informações adicionais, como o mapeamento do espaço de palavras/caracteres para o espaço de tokens, a instância de `tokenizers.Encoding` ou a lista de instâncias (para lotes) armazena essas informações.
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
- **prepend_batch_axis** (`bool`, *opcional*, padrão `False`) -- Indica se deve ou não adicionar um eixo de lote ao converter para tensores (veja `tensor_type` acima). Observe que este parâmetro tem efeito se o parâmetro `tensor_type` estiver definido, *caso contrário, não tem efeito*.
- **n_sequences** (`int`, *opcional*) -- O número de sequências de entrada representadas por cada codificação (`None` para desconhecido, `1` para uma única sequência e `2` para um par de sequências).
## Blip2VisionModel[[transformers.Blip2VisionModel]]
#### transformers.Blip2VisionModel[[transformers.Blip2VisionModel]]
```python
transformers.Blip2VisionModel(config: Blip2VisionConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L481)
**Parâmetros:**
config ([Blip2VisionConfig](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2VisionConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Blip 2 puro, que produz estados ocultos brutos sem nenhum cabeçalho específico no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.Blip2VisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L501)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor). Veja [BlipImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para mais detalhes ([Blip2Processor](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Processor) usa [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor) para processar imagens).
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`), composto por diversos elementos, dependendo da configuração ([Blip2Config](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Config)) e das entradas.
O método forward do [Blip2VisionModel](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2VisionModel) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
## Blip2QFormerModel[[transformers.Blip2QFormerModel]]
#### transformers.Blip2QFormerModel[[transformers.Blip2QFormerModel]]
```python
transformers.Blip2QFormerModel(config: Blip2QFormerConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L848)
**Parâmetros:**
config ([Blip2QFormerConfig](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2QFormerConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
BLIP-2 Querying Transformer (Q-Former).
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.Blip2QFormerModel.forward]]
```python
forward(query_embeds: Tensor, query_length: int | None = None, attention_mask: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L885)
**Parâmetros:**
query_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) : Estados ocultos a serem usados no cálculo de atenção. Em caso de cross-attention, serão usados como query (ou seja, key e value usarão encoder_hidden_states).
query_length (`int`, *opcional*) : Comprimento da consulta, geralmente baseado no número de tokens de consulta. Se nenhum valor for fornecido, query_length será inferido por query_embeds.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
encoder_hidden_states (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Sequência de hidden-states na saída da última camada do encoder. Usada na cross-attention se o modelo estiver configurado como um decoder.
encoder_attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento da entrada do codificador. Essa máscara é usada na atenção cruzada se o modelo estiver configurado como um decodificador. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**.
**Retorna:** [BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo diversos elementos, dependendo da configuração ([Blip2Config](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Config)) e das entradas.
O método forward do [Blip2QFormerModel](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2QFormerModel) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` e `config.add_cross_attention=True` são passados, ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
- **past_key_values** (`Cache`, *opcional*, retornado quando `use_cache=True` é passado ou quando `config.use_cache=True`) -- Trata-se de uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache). Para mais detalhes, consulte nosso [guia de cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e, opcionalmente, se `config.is_encoder_decoder=True`, nos blocos de atenção cruzada) que podem ser usados (veja a entrada `past_key_values`) para acelerar a decodificação sequencial.
## Blip2Model[[transformers.Blip2Model]]
#### transformers.Blip2Model[[transformers.Blip2Model]]
```python
transformers.Blip2Model(config: Blip2Config)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L957)
**Parâmetros:**
config ([Blip2Config](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Config)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo BLIP-2 para gerar texto e recursos de imagem. O modelo consiste em um codificador de visão, um Querying Transformer (Q-Former) e um modelo de linguagem.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.Blip2Model.forward]]
```python
forward(pixel_values: Tensor, input_ids: Tensor, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1152)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor). Veja [BlipImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para mais detalhes ([Blip2Processor](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Processor) usa [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor) para processar imagens).
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obter detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada do decodificador no vocabulário. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada do decodificador?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Comportamento padrão: gerar um tensor que ignora tokens de preenchimento em `decoder_input_ids`. A máscara causal também será usada por padrão. Relevante apenas quando um modelo de linguagem encoder-decoder (como T5) é utilizado.
labels (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Rótulos para calcular a perda de modelagem de linguagem mascarada. Os índices devem estar em `[0, ..., config.vocab_size]` ou ser -100 (veja a docstring de `input_ids`). Tokens com índices definidos como `-100` são ignorados (mascarados); a perda é calculada apenas para os tokens com rótulos em `[0, ..., config.vocab_size]`.
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** `Blip2ForConditionalGenerationModelOutput` ou `tuple(torch.Tensor)`
Um `Blip2ForConditionalGenerationModelOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`), composto por diversos elementos, dependendo da configuração ([Blip2Config](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Config)) e das entradas.
O método forward do [Blip2Model](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Model) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor`, *opcional*, retornado quando `labels` é fornecido, `torch.Tensor` de forma `(1,)`) -- Perda de modelagem de linguagem do modelo de linguagem.
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Pontuações de predição da cabeça de modelagem de linguagem do modelo de linguagem.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- Saídas do codificador de visão.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *opcional*) -- Saídas do Q-Former (Querying Transformer).
- **language_model_outputs** (`CausalLMOutputWithPast` ou `Seq2SeqLMOutput`) -- Saídas do modelo de linguagem.
Exemplos:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import Blip2Processor, Blip2Model
>>> import torch
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b", dtype=torch.float16)
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> prompt = "Question: how many cats are there? Answer:"
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device, torch.float16)
>>> outputs = model(**inputs)
```
#### get_text_features[[transformers.Blip2Model.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, decoder_input_ids: typing.Optional[torch.Tensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L994)
**Parâmetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obter detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada do decodificador no vocabulário. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada do decodificador?](../glossary#decoder-input-ids) O T5 usa `pad_token_id` como o token inicial para a geração de `decoder_input_ids`. Se `past_key_values` for usado, opcionalmente, apenas os últimos `decoder_input_ids` precisam ser inseridos (veja `past_key_values`). Para saber mais sobre como preparar `decoder_input_ids` para pré-treinamento, veja [T5 Training](./t5#training).
decoder_attention_mask (`torch.BoolTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Comportamento padrão: gerar um tensor que ignora tokens de preenchimento em `decoder_input_ids`. A máscara causal também será usada por padrão.
labels (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Rótulos para calcular a perda de modelagem de linguagem mascarada. Os índices devem estar em `[0, ..., config.vocab_size]` ou ser -100 (veja a docstring de `input_ids`). Tokens com índices definidos como `-100` são ignorados (mascarados); a perda é calculada apenas para os tokens com rótulos em `[0, ..., config.vocab_size]`.
**Retorna:** [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`), composto por diversos elementos, dependendo da configuração ([Blip2Config](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Config)) e das entradas.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> import torch
>>> from transformers import AutoTokenizer, Blip2Model
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> tokenizer = AutoTokenizer.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> inputs = tokenizer(["a photo of a cat"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_image_features[[transformers.Blip2Model.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1056)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor). Veja [BlipImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para mais detalhes ([Blip2Processor](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Processor) usa [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor) para processar imagens).
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`), composto por diversos elementos, dependendo da configuração ([Blip2Config](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Config)) e das entradas.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2Model
>>> from transformers.image_utils import load_image
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... image_outputs = model.get_image_features(**inputs)
```
#### get_qformer_features[[transformers.Blip2Model.get_qformer_features]]
```python
get_qformer_features(pixel_values: Tensor, interpolate_pos_encoding: bool = False)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1087)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor). Veja [BlipImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para mais detalhes ([Blip2Processor](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Processor) usa [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor) para processar imagens).
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** qformer_outputs (`torch.Tensor`)
Os estados ocultos da última camada do modelo Q-Former.
Exemplos:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2Model
>>> from transformers.image_utils import load_image
>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... qformer_outputs = model.get_qformer_features(**inputs)
```
## Blip2ForConditionalGeneration[[transformers.Blip2ForConditionalGeneration]]
#### transformers.Blip2ForConditionalGeneration[[transformers.Blip2ForConditionalGeneration]]
```python
transformers.Blip2ForConditionalGeneration(config: Blip2Config)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1460)
**Parâmetros:**
config ([Blip2Config](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Config)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo BLIP-2 para gerar texto a partir de uma imagem e um prompt de texto opcional. O modelo consiste em um codificador de visão, um Querying Transformer (Q-Former) e um modelo de linguagem.
É possível, opcionalmente, passar `input_ids` para o modelo, que funcionam como um prompt de texto, para que o modelo de linguagem continue o prompt. Caso contrário, o modelo de linguagem inicia a geração de texto a partir do token [BOS] (início da sequência).
Observe que os checkpoints do Flan-T5 não podem ser convertidos para float16. Eles foram pré-treinados usando bfloat16.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.Blip2ForConditionalGeneration.forward]]
```python
forward(pixel_values: Tensor, input_ids: LongTensor, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1587)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor). Veja [BlipImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para mais detalhes ([Blip2Processor](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Processor) usa [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor) para processar imagens).
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário do modelo de linguagem. Os tokens de entrada podem ser fornecidos opcionalmente para servir como prompt de texto, que o modelo de linguagem pode continuar. Os índices podem ser obtidos usando [Blip2Processor](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Processor). Veja [Blip2Processor.__call__()](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Processor.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada do decodificador no vocabulário. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada do decodificador?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Comportamento padrão: gerar um tensor que ignora tokens de preenchimento em `decoder_input_ids`. A máscara causal também será usada por padrão. Relevante apenas quando um modelo de linguagem encoder-decoder (como T5) é utilizado.
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
labels (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Rótulos para calcular a perda de modelagem de linguagem mascarada. Os índices devem estar em `[0, ..., config.vocab_size]` ou ser -100 (veja a docstring de `input_ids`). Tokens com índices definidos como `-100` são ignorados (mascarados); a perda é calculada apenas para os tokens com rótulos em `[0, ..., config.vocab_size]`.
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *opcional*) : Dicionário em que as chaves são as modalidades suportadas e os valores são as saídas codificadas para essa modalidade. Cada saída codificada é uma tupla que consiste em (`pooler_output`, *opcional*: `last_hidden_states`, *opcional*: `hidden_states`, *opcional*: `attentions`) `pooler_output` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) é uma sequência de recursos multimodais do codificador mesclados em incorporações de texto.
**Retorna:** `Blip2ForConditionalGenerationModelOutput` ou `tuple(torch.Tensor)`
Um `Blip2ForConditionalGenerationModelOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`), composto por diversos elementos, dependendo da configuração ([Blip2Config](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Config)) e das entradas.
O método forward de [Blip2ForConditionalGeneration](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2ForConditionalGeneration) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor`, *opcional*, retornado quando `labels` é fornecido, `torch.Tensor` de forma `(1,)`) -- Perda de modelagem de linguagem do modelo de linguagem.
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Pontuações de predição da cabeça de modelagem de linguagem do modelo de linguagem.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- Saídas do codificador de visão.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *opcional*) -- Saídas do Q-Former (Querying Transformer).
- **language_model_outputs** (`CausalLMOutputWithPast` ou `Seq2SeqLMOutput`) -- Saídas do modelo de linguagem.
Exemplos:
Prepare o processador, o modelo e a entrada de imagem
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import Blip2Processor, Blip2ForConditionalGeneration
>>> import torch
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2ForConditionalGeneration.from_pretrained(
... "Salesforce/blip2-opt-2.7b", load_in_8bit=True, device_map={"": 0}, dtype=torch.float16
... ) # doctest: +IGNORE_RESULT
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
```
Legendação de imagens (sem fornecer um prompt de texto):
```python
>>> inputs = processor(images=image, return_tensors="pt").to(device, torch.float16)
>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two cats laying on a couch
```
Resposta a perguntas visuais (prompt = pergunta):
```python
>>> prompt = "Question: how many cats are there? Answer:"
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device="cuda", dtype=torch.float16)
>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two
```
Observe que a inferência em int8 também é suportada por meio do [bitsandbytes](https://github.com/TimDettmers/bitsandbytes). Isso reduz significativamente a quantidade de memória usada pelo modelo, mantendo o mesmo desempenho.
```python
>>> model = Blip2ForConditionalGeneration.from_pretrained(
... "Salesforce/blip2-opt-2.7b", load_in_8bit=True, device_map={"": 0}, dtype=torch.bfloat16
... ) # doctest: +IGNORE_RESULT
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device="cuda", dtype=torch.bfloat16)
>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two
```
#### generate[[transformers.Blip2ForConditionalGeneration.generate]]
```python
generate(pixel_values: Tensor, input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **generate_kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1738)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma (batch_size, num_channels, height, width)) : Imagens de entrada a serem processadas.
input_ids (`torch.LongTensor` de forma (batch_size, sequence_length), *opcional*) : A sequência usada como prompt para a geração.
attention_mask (`torch.LongTensor` de forma (batch_size, sequence_length), *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) : Representação embutida das entradas. Deve ser float, não tokens int.
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar a codificação posicional dos embeddings de imagem.
**Retorna:** `captions (list)`
Uma lista de strings de comprimento batch_size * num_captions.
Substitui a função `generate` para permitir o uso do modelo como um gerador condicional.
#### get_image_features[[transformers.Blip2ForConditionalGeneration.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool | None = False, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1519)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada.
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** `BaseModelOutputWithVisionQformerOutputs` ou `tuple(torch.Tensor)`
Um `BaseModelOutputWithVisionQformerOutputs` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`), composto por diversos elementos, dependendo da configuração ([Blip2Config](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Config)) e das entradas.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- Saídas do codificador de visão.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *opcional*) -- Saídas do Q-Former (Querying Transformer).
Exemplo:
```python
>>> from PIL import Image
>>> from transformers import AutoProcessor, Blip2ForConditionalGeneration
>>> model = Blip2ForConditionalGeneration.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> messages = [
... {
... "role": "user", "content": [
... {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
... {"type": "text", "text": "Where is the cat standing?"},
... ]
... },
... ]
>>> inputs = processor.apply_chat_template(
... messages,
... tokenize=True,
... return_dict=True,
... return_tensors="pt",
... add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
```
## Blip2ForImageTextRetrieval[[transformers.Blip2ForImageTextRetrieval]]
#### transformers.Blip2ForImageTextRetrieval[[transformers.Blip2ForImageTextRetrieval]]
```python
transformers.Blip2ForImageTextRetrieval(config: Blip2Config)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1832)
**Parâmetros:**
config ([Blip2Config](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Config)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo BLIP-2 com um projetor de visão e texto e uma cabeça de classificação no topo. O modelo é usado no contexto de recuperação de imagem-texto. Dada uma imagem e um texto, o modelo retorna a probabilidade de o texto ser relevante para a imagem.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.Blip2ForImageTextRetrieval.forward]]
```python
forward(pixel_values: Tensor, input_ids: LongTensor, attention_mask: typing.Optional[torch.LongTensor] = None, use_image_text_matching_head: bool | None = False, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1866)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor). Veja [BlipImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para mais detalhes ([Blip2Processor](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Processor) usa [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor) para processar imagens).
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário do modelo de linguagem. Os tokens de entrada podem ser fornecidos opcionalmente para servir como prompt de texto, que o modelo de linguagem pode continuar. Os índices podem ser obtidos usando [Blip2Processor](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Processor). Veja [Blip2Processor.__call__()](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Processor.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
use_image_text_matching_head (`bool`, *opcional*) : Se deve retornar as pontuações de Correspondência de Imagem-Texto ou Contrastivas.
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** `Blip2ImageTextMatchingModelOutput` ou `tuple(torch.Tensor)`
Um `Blip2ImageTextMatchingModelOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`), composto por diversos elementos, dependendo da configuração ([Blip2Config](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Config)) e das entradas.
O método forward de [Blip2ForImageTextRetrieval](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2ForImageTextRetrieval) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `return_loss` é `True`) -- Perda contrastiva para similaridade entre imagem e texto.
- **logits_per_image** (`torch.Tensor` de forma `(image_batch_size, text_batch_size)`) -- As pontuações de produto escalar escalonado entre `image_embeds` e `text_embeds`. Isso representa as pontuações de similaridade entre imagem e texto.
- **logits_per_text** (`torch.Tensor` de forma `(text_batch_size, image_batch_size)`) -- As pontuações de produto escalar escalonado entre `text_embeds` e `image_embeds`. Isso representa as pontuações de similaridade entre texto e imagem.
- **text_embeds** (`torch.Tensor` de forma `(batch_size, output_dim`) -- As embeddings de texto obtidas ao aplicar a camada de projeção à saída agregada.
- **image_embeds** (`torch.Tensor` de forma `(batch_size, output_dim`) -- Os embeddings de imagem obtidos ao aplicar a camada de projeção à saída agregada.
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- A saída do [Blip2QFormerModel](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2QFormerModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- A saída do [Blip2VisionModel](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2VisionModel).
Exemplos:
```python
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, Blip2ForImageTextRetrieval
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> model = Blip2ForImageTextRetrieval.from_pretrained("Salesforce/blip2-itm-vit-g", dtype=torch.float16)
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "two cats laying on a pink blanket"
>>> inputs = processor(images=image, text=text, return_tensors="pt").to(device, torch.float16)
>>> itm_out = model(**inputs, use_image_text_matching_head=True)
>>> logits_per_image = torch.nn.functional.softmax(itm_out.logits_per_image, dim=1)
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
>>> print(f"{probs[0][0]:.1%} that image 0 is not '{text}'")
26.9% that image 0 is not 'two cats laying on a pink blanket'
>>> print(f"{probs[0][1]:.1%} that image 0 is '{text}'")
73.0% that image 0 is 'two cats laying on a pink blanket'
>>> texts = ["a photo of a cat", "a photo of a dog"]
>>> inputs = processor(images=image, text=texts, return_tensors="pt").to(device, torch.float16)
>>> itc_out = model(**inputs, use_image_text_matching_head=False)
>>> logits_per_image = itc_out.logits_per_image # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
>>> print(f"{probs[0][0]:.1%} that image 0 is '{texts[0]}'")
55.3% that image 0 is 'a photo of a cat'
>>> print(f"{probs[0][1]:.1%} that image 0 is '{texts[1]}'")
44.7% that image 0 is 'a photo of a dog'
```
## Blip2TextModelWithProjection[[transformers.Blip2TextModelWithProjection]]
#### transformers.Blip2TextModelWithProjection[[transformers.Blip2TextModelWithProjection]]
```python
transformers.Blip2TextModelWithProjection(config: Blip2Config)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1274)
**Parâmetros:**
config ([Blip2Config](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Config)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Blip 2 com uma camada de projeção no topo (uma camada linear no topo da saída agregada).
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.Blip2TextModelWithProjection.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1298)
**Parâmetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
**Retorna:** `Blip2TextModelOutput` ou `tuple(torch.Tensor)`
Um `Blip2TextModelOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo diversos elementos, dependendo da configuração ([Blip2Config](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Config)) e das entradas.
O método forward do [Blip2TextModelWithProjection](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2TextModelWithProjection) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **text_embeds** (`torch.Tensor` de forma `(batch_size, output_dim)` *opcional* retornado quando o modelo é inicializado com `with_projection=True`) -- Os embeddings de texto obtidos ao aplicar a camada de projeção ao pooler_output.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) -- Sequência de hidden-states na saída da última camada do modelo.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (uma para a saída dos embeddings, se o modelo tiver uma camada de embedding, + uma para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple[torch.Tensor, ...]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2TextModelWithProjection
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> model = Blip2TextModelWithProjection.from_pretrained(
... "Salesforce/blip2-itm-vit-g", dtype=torch.float16
... )
>>> model.to(device)
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")
>>> inputs = processor(text=["a photo of a cat", "a photo of a dog"], return_tensors="pt").to(device)
>>> outputs = model(**inputs)
>>> text_embeds = outputs.text_embeds
>>> print(text_embeds.shape)
torch.Size([2, 7, 256])
```
## Blip2VisionModelWithProjection[[transformers.Blip2VisionModelWithProjection]]
#### transformers.Blip2VisionModelWithProjection[[transformers.Blip2VisionModelWithProjection]]
```python
transformers.Blip2VisionModelWithProjection(config: Blip2Config)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1359)
**Parâmetros:**
config ([Blip2Config](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Config)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Blip 2 com uma camada de projeção no topo (uma camada linear no topo da saída agregada).
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.Blip2VisionModelWithProjection.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1382)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor). Veja [BlipImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para mais detalhes ([Blip2Processor](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Processor) usa [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor) para processar imagens).
**Retorna:** `Blip2VisionModelOutput` ou `tuple(torch.Tensor)`
Um `Blip2VisionModelOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`), composto por diversos elementos, dependendo da configuração ([Blip2Config](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2Config)) e das entradas.
O método forward do [Blip2VisionModelWithProjection](/docs/transformers/main/pt/model_doc/blip-2#transformers.Blip2VisionModelWithProjection) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **image_embeds** (`torch.Tensor` de forma `(batch_size, output_dim)` *opcional* retornado quando o modelo é inicializado com `with_projection=True`) -- Os embeddings de imagem obtidos ao aplicar a camada de projeção ao pooler_output.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) -- Sequência de hidden-states na saída da última camada do modelo.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (uma para a saída dos embeddings, se o modelo tiver uma camada de embedding, + uma para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple[torch.Tensor, ...]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2VisionModelWithProjection
>>> from transformers.image_utils import load_image
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")
>>> model = Blip2VisionModelWithProjection.from_pretrained(
... "Salesforce/blip2-itm-vit-g", dtype=torch.float16
... )
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt").to(device, torch.float16)
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> image_embeds = outputs.image_embeds
>>> print(image_embeds.shape)
torch.Size([1, 32, 256])
```