# ConvNeXT
## Visão geral
O modelo ConvNeXT foi proposto em [A ConvNet for the 2020s](https://huggingface.co/papers/2201.03545) por Zhuang Liu, Hanzi Mao, Chao-Yuan Wu, Christoph Feichtenhofer, Trevor Darrell e Saining Xie. O ConvNeXT é um modelo puramente convolucional (ConvNet), inspirado no design dos Vision Transformers, que afirma superá-los.
O resumo do artigo é o seguinte:
*A "década de 1920" do reconhecimento visual começou com a introdução dos Vision Transformers (ViTs), que rapidamente superaram os ConvNets como o modelo de classificação de imagens mais avançado. Por outro lado, um ViT padrão enfrenta dificuldades quando aplicado a tarefas gerais de visão computacional, como detecção de objetos e segmentação semântica. São os Transformers hierárquicos (por exemplo, Swin Transformers) que reintroduziram vários pré-requisitos dos ConvNets, tornando os Transformers praticamente viáveis como um backbone de visão genérico e demonstrando desempenho notável em uma grande variedade de tarefas de visão. No entanto, a eficácia dessas abordagens híbridas ainda é atribuída em grande parte à superioridade intrínseca dos Transformers, em vez dos vieses indutivos inerentes às convoluções. Neste trabalho, reexaminamos os espaços de design e testamos os limites do que um ConvNet puro pode alcançar. Gradualmente, "modernizamos" um ResNet padrão em direção ao design de um vision Transformer e descobrimos vários componentes-chave que contribuem para a diferença de desempenho ao longo do caminho. O resultado dessa exploração é uma família de modelos de ConvNet puros chamados ConvNeXt. Construídos inteiramente a partir de módulos padrão de ConvNet, os ConvNeXts competem favoravelmente com os Transformers em termos de precisão e escalabilidade, alcançando 87,8% de precisão top-1 no ImageNet e superando os Swin Transformers na detecção COCO e na segmentação ADE20K, mantendo a simplicidade e a eficiência dos ConvNets padrão.*
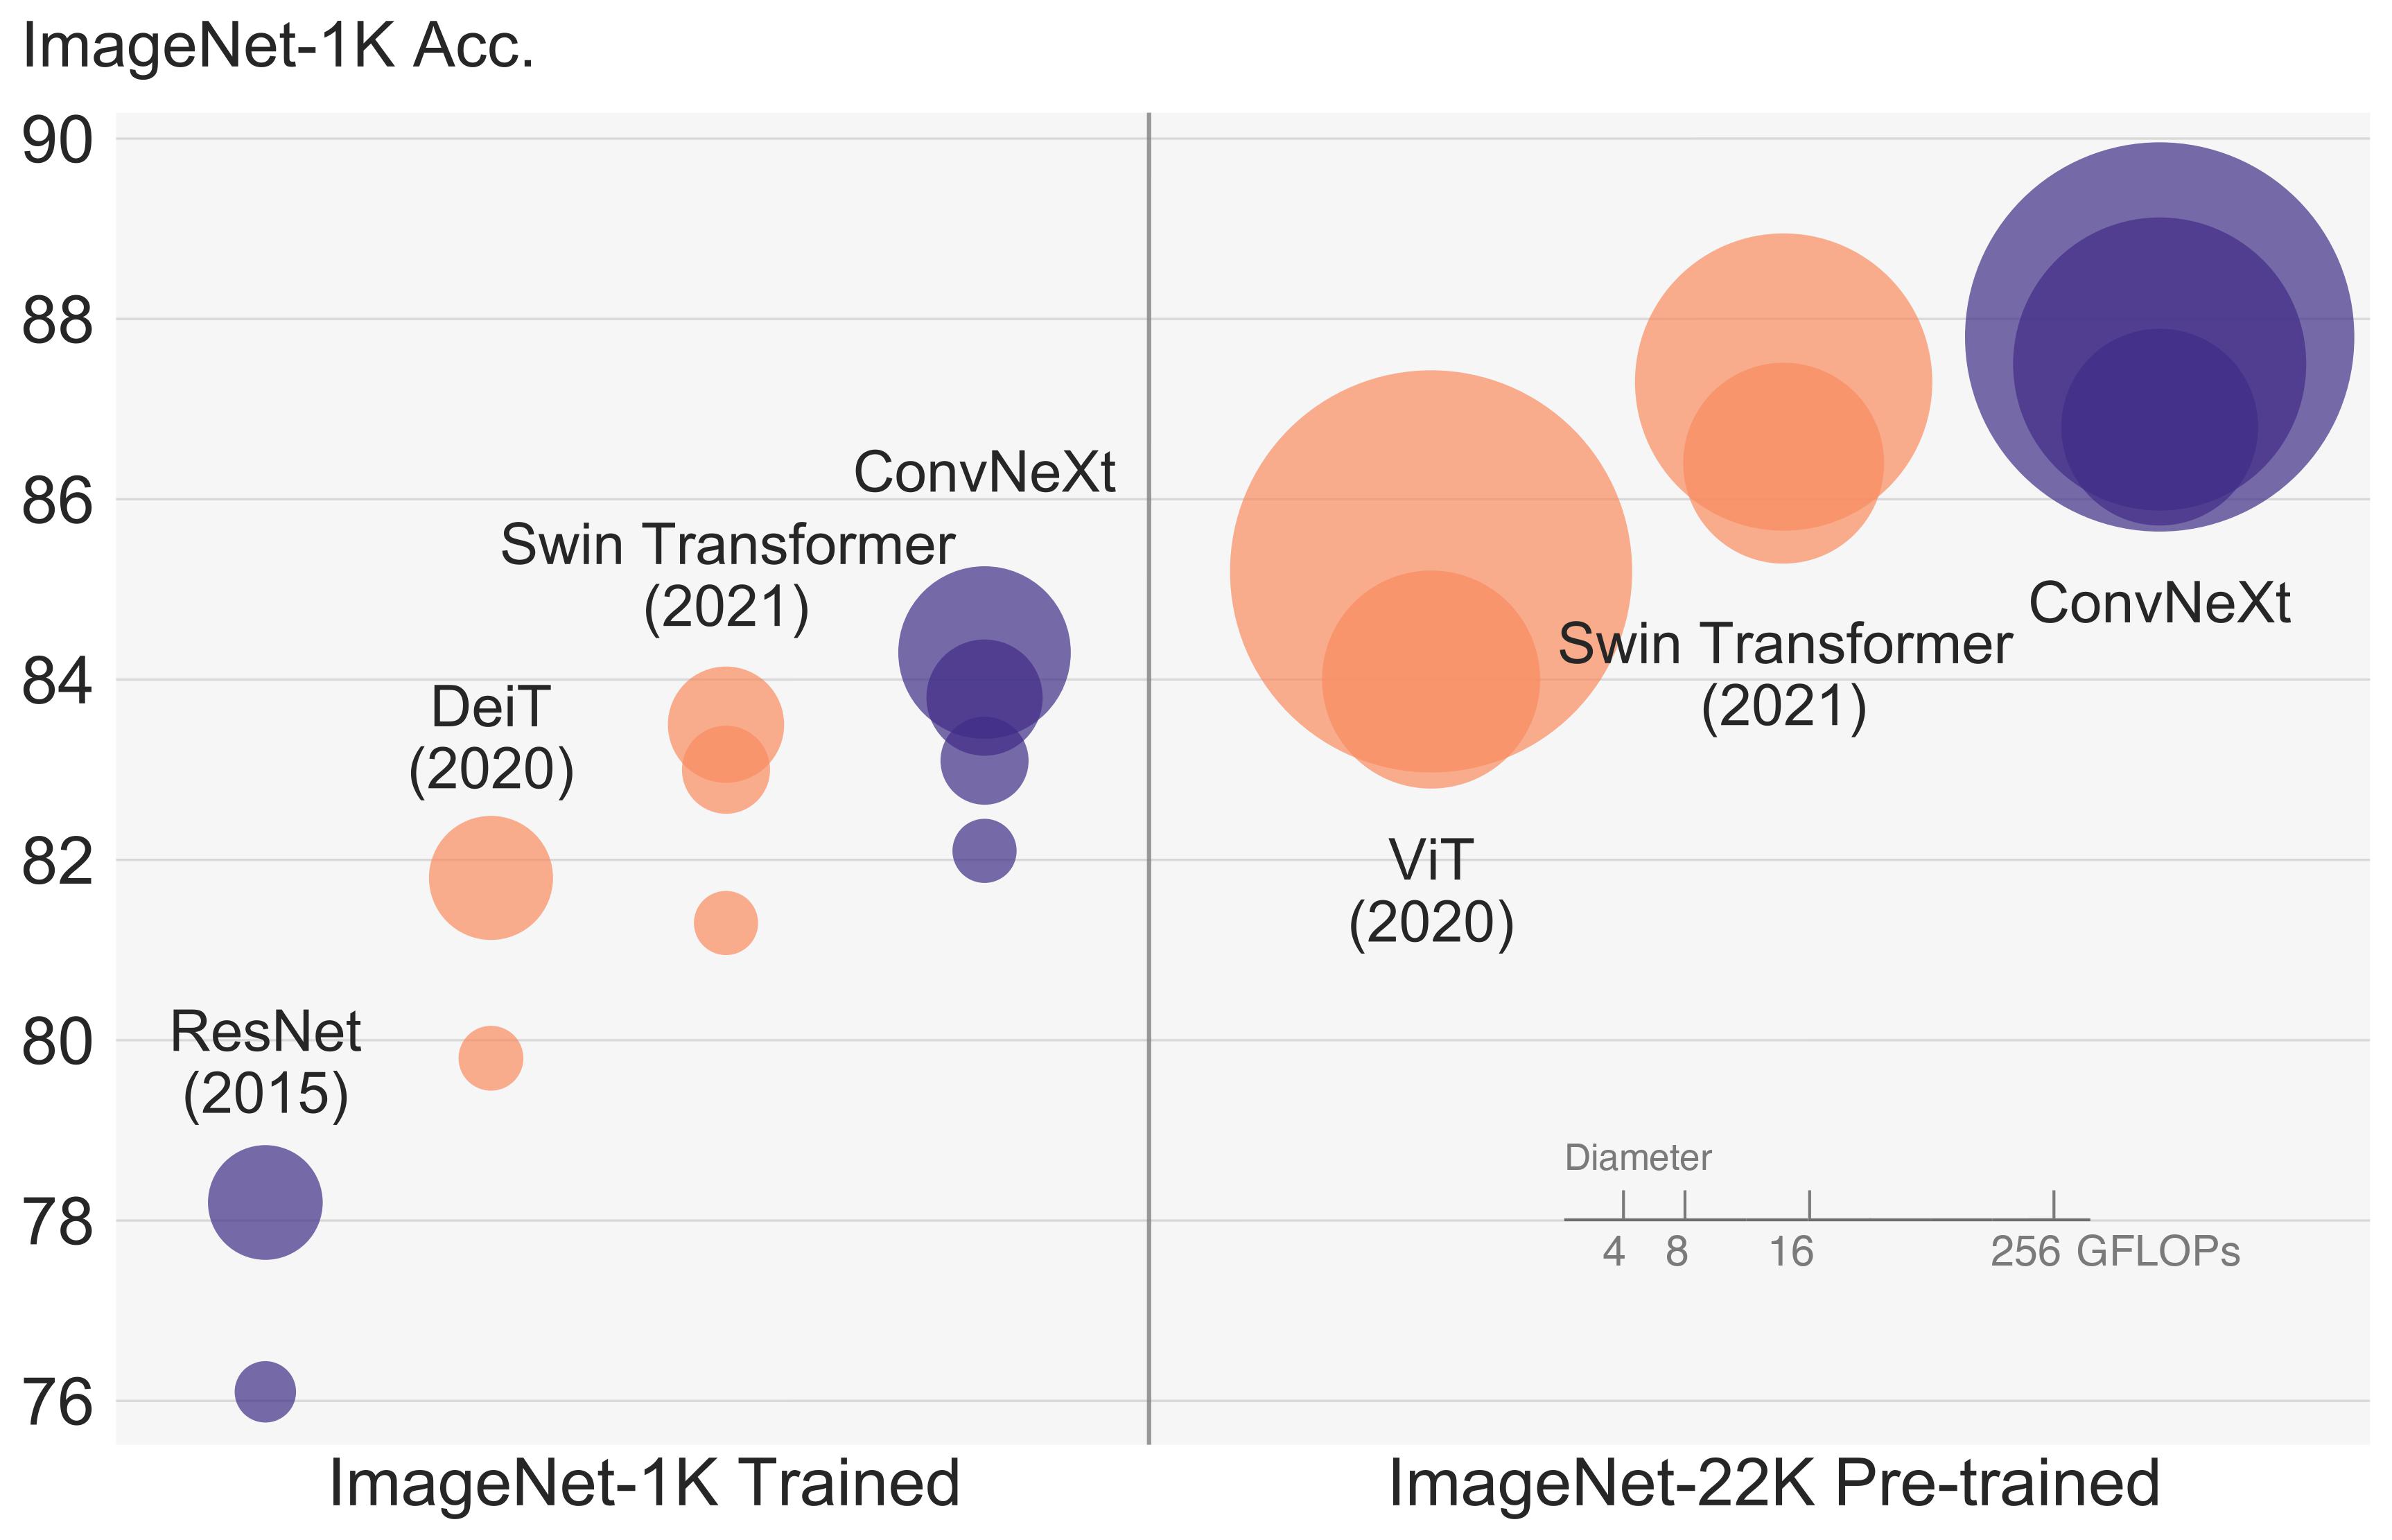 Arquitetura ConvNeXT. Retirada do artigo original.
Este modelo foi contribuído por [nielsr](https://huggingface.co/nielsr). O código original pode ser encontrado [aqui](https://github.com/facebookresearch/ConvNeXt).
## Recursos
Uma lista de recursos oficiais da Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o ConvNeXT.
- [ConvNextForImageClassification](/docs/transformers/main/pt/model_doc/convnext#transformers.ConvNextForImageClassification) é suportado por este [notebook](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb).
- Veja também: [Guia da tarefa de classificação de imagens](../tasks/image_classification)
Se você tiver interesse em enviar um recurso para ser incluído aqui, sinta-se à vontade para abrir um Pull Request e faremos a revisão! O recurso deve, idealmente, demonstrar algo novo, em vez de duplicar um recurso existente.
## ConvNextConfig[[transformers.ConvNextConfig]]
#### transformers.ConvNextConfig[[transformers.ConvNextConfig]]
```python
transformers.ConvNextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, num_channels: int = 3, patch_size: int | list[int] | tuple[int, int] = 4, num_stages: int = 4, hidden_sizes: list[int] | tuple[int, ...] | None = (96, 192, 384, 768), depths: list[int] | tuple[int, ...] | None = (3, 3, 9, 3), hidden_act: str = 'gelu', initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, layer_scale_init_value: float = 1e-06, drop_path_rate: float | int = 0.0, image_size: int | list[int] | tuple[int, int] = 224, _out_features: list[str] | None = None, _out_indices: list[int] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/configuration_convnext.py#L25)
**Parâmetros:**
num_channels (`int`, *opcional*, padrão `3`) : O número de canais de entrada.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `4`) : O tamanho (resolução) de cada patch.
num_stages (`int`, *opcional*, padrão 4) : O número de estágios no modelo.
hidden_sizes (`Union[list[int], tuple[int, ...]]`, *opcional*, padrão `(96, 192, 384, 768)`) : Dimensionalidade (tamanho oculto) em cada etapa do modelo.
depths (`Union[list[int], tuple[int, ...]]`, *opcional*, padrão `(3, 3, 9, 3)`) : Profundidade de cada camada no Transformer.
hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
layer_norm_eps (`float`, *opcional*, padrão `1e-12`) : O epsilon usado pelas camadas de normalização de camada.
layer_scale_init_value (`float`, *opcional*, padrão `1e-06`) : Escala a ser usada nas camadas de autoatenção. 0.1 para base, 1e-6 para large. Defina 0 para desativar a escala da camada.
drop_path_rate (`Union[float, int]`, *opcional*, padrão `0.0`) : Taxa de drop path para a fusão de patches.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `224`) : O tamanho (resolução) de cada imagem.
Esta é a classe de configuração para armazenar a configuração de um ConvNextModel. Ela é usada para instanciar um modelo Convnext de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [facebook/convnext-tiny-224](https://huggingface.co/facebook/convnext-tiny-224)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import ConvNextConfig, ConvNextModel
>>> # Initializing a ConvNext convnext-tiny-224 style configuration
>>> configuration = ConvNextConfig()
>>> # Initializing a model (with random weights) from the convnext-tiny-224 style configuration
>>> model = ConvNextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ConvNextImageProcessor[[transformers.ConvNextImageProcessor]]
#### transformers.ConvNextImageProcessor[[transformers.ConvNextImageProcessor]]
```python
transformers.ConvNextImageProcessor(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/image_processing_convnext.py#L43)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'shortest_edge' : 384}`): Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `3`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.5, 0.5, 0.5]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.5, 0.5, 0.5]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
crop_pct (`float`, *kwargs*, *opcional*, padrão `self.crop_pct`) : Porcentagem da imagem a ser recortada. Tem efeito apenas se size < 384.
Constrói um processador de imagens ConvNextImageProcessor.
#### preprocess[[transformers.ConvNextImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Sinalizador do desenvolvedor para entradas adicionais semelhantes a imagens que também serão pré-processadas. Use isso apenas se a passagem das entradas como kwarg não funcionar. Por exemplo, `preprocess(images, masks=masks)` é a opção preferida, mas resulta em problemas de prioridade de argumentos para alguns modelos. Nesses casos, `preprocess(images, image_like_inputs={"masks": masks})` pode ser usado em vez disso.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
Pré-processa uma imagem ou um lote de imagens.
## ConvNextImageProcessorPil[[transformers.ConvNextImageProcessorPil]]
#### transformers.ConvNextImageProcessorPil[[transformers.ConvNextImageProcessorPil]]
```python
transformers.ConvNextImageProcessorPil(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/image_processing_pil_convnext.py#L43)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'shortest_edge' : 384}`): Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `3`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.5, 0.5, 0.5]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.5, 0.5, 0.5]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
crop_pct (`float`, *kwargs*, *opcional*, padrão `self.crop_pct`) : Porcentagem da imagem a ser recortada. Tem efeito apenas se size < 384.
Constrói um processador de imagens ConvNextImageProcessor.
#### preprocess[[transformers.ConvNextImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Sinalizador do desenvolvedor para entradas adicionais semelhantes a imagens que também serão pré-processadas. Use isso apenas se a passagem das entradas como kwarg não funcionar. Por exemplo, `preprocess(images, masks=masks)` é a opção preferida, mas resulta em problemas de prioridade de argumentos para alguns modelos. Nesses casos, `preprocess(images, image_like_inputs={"masks": masks})` pode ser usado em vez disso.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
Pré-processa uma imagem ou um lote de imagens.
## ConvNextModel[[transformers.ConvNextModel]]
#### transformers.ConvNextModel[[transformers.ConvNextModel]]
```python
transformers.ConvNextModel(config: ConvNextConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/modeling_convnext.py#L251)
**Parâmetros:**
config ([ConvNextConfig](/docs/transformers/main/pt/model_doc/convnext#transformers.ConvNextConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Convnext puro que produz estados ocultos brutos, sem nenhum cabeçalho específico no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.ConvNextModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/modeling_convnext.py#L265)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [ConvNextImageProcessor](/docs/transformers/main/pt/model_doc/convnext#transformers.ConvNextImageProcessor). Consulte [ConvNextImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para obter detalhes (`processor_class` usa [ConvNextImageProcessor](/docs/transformers/main/pt/model_doc/convnext#transformers.ConvNextImageProcessor) para processar imagens).
**Retorna:** `BaseModelOutputWithPoolingAndNoAttention` ou `tuple(torch.Tensor)`
Um `BaseModelOutputWithPoolingAndNoAttention` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([ConvNextConfig](/docs/transformers/main/pt/model_doc/convnext#transformers.ConvNextConfig)) e das entradas.
O método forward do [ConvNextModel](/docs/transformers/main/pt/model_doc/convnext#transformers.ConvNextModel) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, num_channels, height, width)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada após uma operação de pooling nas dimensões espaciais.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, num_channels, height, width)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
Exemplo:
```python
```
## ConvNextForImageClassification[[transformers.ConvNextForImageClassification]]
#### transformers.ConvNextForImageClassification[[transformers.ConvNextForImageClassification]]
```python
transformers.ConvNextForImageClassification(config: ConvNextConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/modeling_convnext.py#L293)
**Parâmetros:**
config ([ConvNextConfig](/docs/transformers/main/pt/model_doc/convnext#transformers.ConvNextConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo ConvNext com uma cabeça de classificação de imagem no topo (uma camada linear sobre os recursos agregados), por exemplo, para o ImageNet.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.ConvNextForImageClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/modeling_convnext.py#L311)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [ConvNextImageProcessor](/docs/transformers/main/pt/model_doc/convnext#transformers.ConvNextImageProcessor). Consulte [ConvNextImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para obter detalhes (`processor_class` usa [ConvNextImageProcessor](/docs/transformers/main/pt/model_doc/convnext#transformers.ConvNextImageProcessor) para processar imagens).
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para o cálculo da perda de classificação/regressão de imagem. Os índices devem estar em `[0, ..., config.num_labels - 1]`. Se `config.num_labels == 1`, uma perda de regressão é calculada (perda de erro quadrático médio). Se `config.num_labels > 1`, uma perda de classificação é calculada (entropia cruzada).
**Retorna:** [ImageClassifierOutputWithNoAttention](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) ou `tuple(torch.Tensor)`
Um [ImageClassifierOutputWithNoAttention](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([ConvNextConfig](/docs/transformers/main/pt/model_doc/convnext#transformers.ConvNextConfig)) e das entradas.
O método forward de [ConvNextForImageClassification](/docs/transformers/main/pt/model_doc/convnext#transformers.ConvNextForImageClassification) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação (ou de regressão se config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada estágio) de forma `(batch_size, num_channels, height, width)`. Estados ocultos (também chamados de mapas de características) do modelo na saída de cada estágio.
Exemplo:
```python
>>> from transformers import AutoImageProcessor, ConvNextForImageClassification
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/convnext-tiny-224")
>>> model = ConvNextForImageClassification.from_pretrained("facebook/convnext-tiny-224")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```