# Deformable DETR
[Deformable DETR](https://huggingface.co/papers/2010.04159) aprimora o [DETR](./detr) original ao utilizar um módulo de atenção deformável. Esse mecanismo atende seletivamente a um pequeno conjunto de pontos de amostragem em torno de uma referência. Ele melhora a velocidade de treinamento e a precisão.
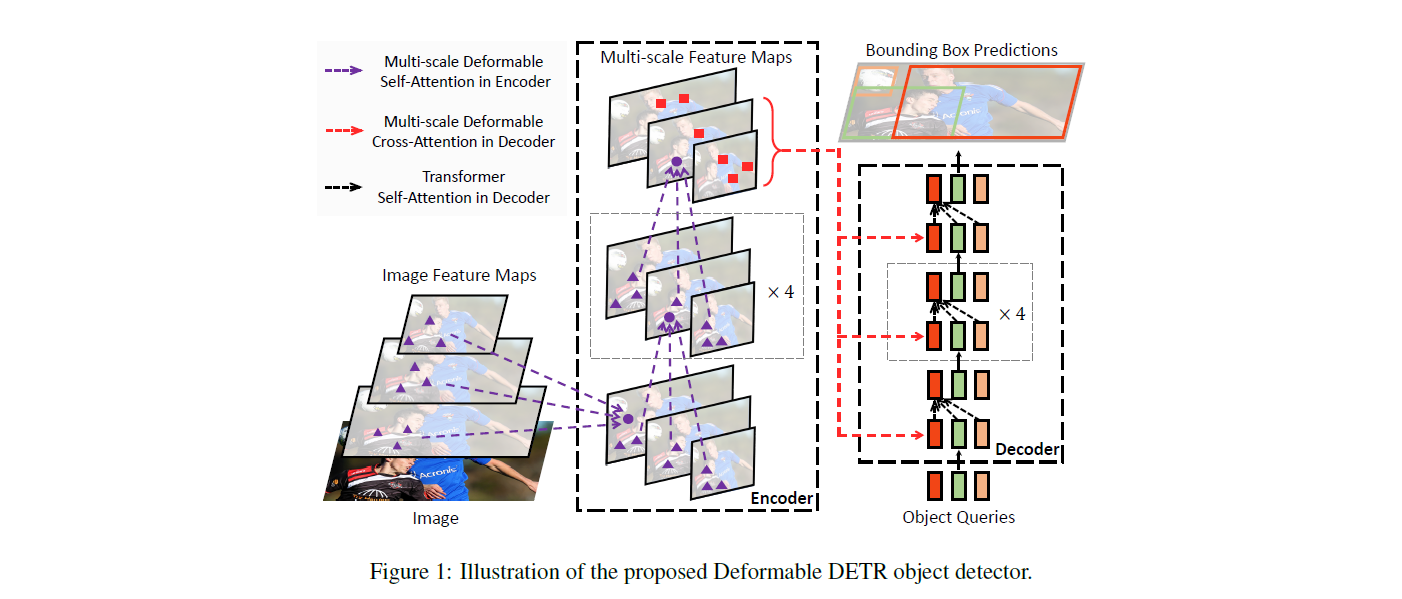 Arquitetura do Deformable DETR. Retirada do artigo original.
Você pode encontrar todos os checkpoints disponíveis do Deformable DETR na organização [SenseTime](https://huggingface.co/SenseTime).
> [!TIP]
> Este modelo foi contribuído por [nielsr](https://huggingface.co/nielsr).
>
> Clique nos modelos Deformable DETR na barra lateral à direita para ver mais exemplos de como aplicar o Deformable DETR a diferentes tarefas de detecção de objetos e segmentação.
O exemplo abaixo demonstra como realizar detecção de objetos com o [Pipeline](/docs/transformers/main/pt/main_classes/pipelines#transformers.Pipeline) e a classe [AutoModel](/docs/transformers/main/pt/model_doc/auto#transformers.AutoModel).
```python
from transformers import pipeline
pipeline = pipeline(
"object-detection",
model="SenseTime/deformable-detr",
device_map=0
)
pipeline("http://images.cocodataset.org/val2017/000000039769.jpg")
```
```python
import requests
import torch
from PIL import Image
from transformers import AutoImageProcessor, AutoModelForObjectDetection
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
image_processor = AutoImageProcessor.from_pretrained("SenseTime/deformable-detr")
model = AutoModelForObjectDetection.from_pretrained("SenseTime/deformable-detr", device_map="auto")
# prepare image for the model
inputs = image_processor(images=image, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
results = image_processor.post_process_object_detection(outputs, target_sizes=torch.tensor([image.size[::-1]]), threshold=0.3)
for result in results:
for score, label_id, box in zip(result["scores"], result["labels"], result["boxes"]):
score, label = score.item(), label_id.item()
box = [round(i, 2) for i in box.tolist()]
print(f"{model.config.id2label[label]}: {score:.2f} {box}")
```
## Recursos
- Consulte este conjunto de [notebooks](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Deformable-DETR) para inferência e ajuste fino de [DeformableDetrForObjectDetection](/docs/transformers/main/pt/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) em um conjunto de dados personalizado.
## DeformableDetrImageProcessor[[transformers.DeformableDetrImageProcessor]]
#### transformers.DeformableDetrImageProcessor[[transformers.DeformableDetrImageProcessor]]
```python
transformers.DeformableDetrImageProcessor(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_deformable_detr.py#L271)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'shortest_edge' : 800, 'longest_edge': 1333}`): Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `2`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.485, 0.456, 0.406]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.229, 0.224, 0.225]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*, padrão `True`) : Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
format (`str`, *kwargs*, *opcional*, padrão `AnnotationFormat.COCO_DETECTION`) : Formato dos dados das anotações. Um dos valores "coco_detection" ou "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *opcional*, padrão `True`) : Controla se as anotações devem ser convertidas para o formato esperado pelo modelo DEFORMABLE_DETR. Converte as caixas delimitadoras para o formato `(center_x, center_y, width, height)` e no intervalo `[0, 1]`. Pode ser sobrescrito pelo parâmetro `do_convert_annotations` no método `preprocess`.
Constrói um processador de imagem DeformableDetrImageProcessor.
#### preprocess[[transformers.DeformableDetrImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_deformable_detr.py#L526)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
annotations (`AnnotationType` ou `list[AnnotationType]`, *opcional*) : Anotações a serem transformadas de acordo com o padding aplicado às imagens.
return_segmentation_masks (`bool`, *opcional*, padrão `self.return_segmentation_masks`) : Se deve retornar máscaras de segmentação.
masks_path (`str` ou `pathlib.Path`, *opcional*) : Caminho para o diretório que contém as máscaras de segmentação.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
format (`str`, *kwargs*, *opcional*, padrão `AnnotationFormat.COCO_DETECTION`) : Formato dos dados das anotações. Um dos valores "coco_detection" ou "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *opcional*, padrão `True`) : Controla se as anotações devem ser convertidas para o formato esperado pelo modelo DEFORMABLE_DETR. Converte as caixas delimitadoras para o formato `(center_x, center_y, width, height)` e no intervalo `[0, 1]`. Pode ser sobrescrito pelo parâmetro `do_convert_annotations` no método `preprocess`.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
#### post_process_object_detection[[transformers.DeformableDetrImageProcessor.post_process_object_detection]]
```python
post_process_object_detection(outputs, threshold: float = 0.5, target_sizes: transformers.utils.generic.TensorType | list[tuple] = None, top_k: int = 100)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_deformable_detr.py#L667)
**Parâmetros:**
outputs (`DetrObjectDetectionOutput`) : Saídas brutas do modelo.
threshold (`float`, *opcional*) : Limiar de pontuação para manter as previsões de detecção de objetos.
target_sizes (`torch.Tensor` ou `list[tuple[int, int]]`, *opcional*) : Tensor de forma `(batch_size, 2)` ou lista de tuplas (`tuple[int, int]`) contendo o tamanho alvo (altura, largura) de cada imagem no lote. Se deixado como None, as previsões não serão redimensionadas.
top_k (`int`, *opcional*, padrão 100) : Mantém apenas as k primeiras bounding boxes antes da filtragem por limiar.
**Retorna:** `list[Dict]`
Uma lista de dicionários, em que cada dicionário contém as pontuações, rótulos e caixas para uma imagem no lote, conforme previstos pelo modelo.
Converte a saída bruta de [DeformableDetrForObjectDetection](/docs/transformers/main/pt/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) em caixas delimitadoras finais no formato (top_left_x, top_left_y, bottom_right_x, bottom_right_y). Suporta apenas PyTorch.
## DeformableDetrImageProcessorPil[[transformers.DeformableDetrImageProcessorPil]]
#### transformers.DeformableDetrImageProcessorPil[[transformers.DeformableDetrImageProcessorPil]]
```python
transformers.DeformableDetrImageProcessorPil(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_pil_deformable_detr.py#L263)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'shortest_edge' : 800, 'longest_edge': 1333}`): Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `2`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.485, 0.456, 0.406]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.229, 0.224, 0.225]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*, padrão `True`) : Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
format (`str`, *kwargs*, *opcional*, padrão `AnnotationFormat.COCO_DETECTION`) : Formato dos dados das anotações. Um dos valores "coco_detection" ou "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *opcional*, padrão `True`) : Controla se as anotações devem ser convertidas para o formato esperado pelo modelo DEFORMABLE_DETR. Converte as caixas delimitadoras para o formato `(center_x, center_y, width, height)` e no intervalo `[0, 1]`. Pode ser sobrescrito pelo parâmetro `do_convert_annotations` no método `preprocess`.
Constrói um processador de imagem DeformableDetrImageProcessor.
#### preprocess[[transformers.DeformableDetrImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_pil_deformable_detr.py#L531)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
annotations (`AnnotationType` ou `list[AnnotationType]`, *opcional*) : Anotações a serem transformadas de acordo com o padding aplicado às imagens.
return_segmentation_masks (`bool`, *opcional*, padrão `self.return_segmentation_masks`) : Se deve retornar máscaras de segmentação.
masks_path (`str` ou `pathlib.Path`, *opcional*) : Caminho para o diretório que contém as máscaras de segmentação.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
format (`str`, *kwargs*, *opcional*, padrão `AnnotationFormat.COCO_DETECTION`) : Formato dos dados das anotações. Um dos valores "coco_detection" ou "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *opcional*, padrão `True`) : Controla se as anotações devem ser convertidas para o formato esperado pelo modelo DEFORMABLE_DETR. Converte as caixas delimitadoras para o formato `(center_x, center_y, width, height)` e no intervalo `[0, 1]`. Pode ser sobrescrito pelo parâmetro `do_convert_annotations` no método `preprocess`.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
#### post_process_object_detection[[transformers.DeformableDetrImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs, threshold: float = 0.5, target_sizes: transformers.utils.generic.TensorType | list[tuple] = None, top_k: int = 100)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_pil_deformable_detr.py#L676)
**Parâmetros:**
outputs (`DetrObjectDetectionOutput`) : Saídas brutas do modelo.
threshold (`float`, *opcional*) : Limiar de pontuação para manter as previsões de detecção de objetos.
target_sizes (`torch.Tensor` ou `list[tuple[int, int]]`, *opcional*) : Tensor de forma `(batch_size, 2)` ou lista de tuplas (`tuple[int, int]`) contendo o tamanho alvo (altura, largura) de cada imagem no lote. Se deixado como None, as previsões não serão redimensionadas.
top_k (`int`, *opcional*, padrão 100) : Mantém apenas as k primeiras bounding boxes antes da filtragem por limiar.
**Retorna:** `list[Dict]`
Uma lista de dicionários, em que cada dicionário contém as pontuações, rótulos e caixas para uma imagem no lote, conforme previstos pelo modelo.
Converte a saída bruta de [DeformableDetrForObjectDetection](/docs/transformers/main/pt/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) em caixas delimitadoras finais no formato (top_left_x, top_left_y, bottom_right_x, bottom_right_y). Suporta apenas PyTorch.
## DeformableDetrConfig[[transformers.DeformableDetrConfig]]
#### transformers.DeformableDetrConfig[[transformers.DeformableDetrConfig]]
```python
transformers.DeformableDetrConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_channels: int = 3, num_queries: int = 300, max_position_embeddings: int = 1024, encoder_layers: int = 6, encoder_ffn_dim: int = 1024, encoder_attention_heads: int = 8, decoder_layers: int = 6, decoder_ffn_dim: int = 1024, decoder_attention_heads: int = 8, encoder_layerdrop: float | int = 0.0, activation_function: str = 'relu', d_model: int = 256, dropout: float | int = 0.1, attention_dropout: float | int = 0.0, activation_dropout: float | int = 0.0, init_std: float = 0.02, init_xavier_std: float = 1.0, return_intermediate: bool = True, auxiliary_loss: bool = False, position_embedding_type: str = 'sine', dilation: bool = False, num_feature_levels: int = 4, encoder_n_points: int = 4, decoder_n_points: int = 4, two_stage: bool = False, two_stage_num_proposals: int = 300, with_box_refine: bool = False, class_cost: int = 1, bbox_cost: int = 5, giou_cost: int = 2, mask_loss_coefficient: int = 1, dice_loss_coefficient: int = 1, bbox_loss_coefficient: int = 5, giou_loss_coefficient: int = 2, eos_coefficient: float = 0.1, focal_alpha: float = 0.25, disable_custom_kernels: bool = False, tie_word_embeddings: bool = True)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/configuration_deformable_detr.py#L25)
**Parâmetros:**
is_encoder_decoder (`bool`, *opcional*, padrão `True`) : Indica se o modelo é usado como codificador/decodificador ou não.
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : A configuração do modelo backbone.
num_channels (`int`, *opcional*, padrão `3`) : O número de canais de entrada.
num_queries (`int`, *opcional*, padrão 300) : Número de consultas de objeto, ou seja, slots de detecção. Este é o número máximo de objetos que [DeformableDetrModel](/docs/transformers/main/pt/model_doc/deformable_detr#transformers.DeformableDetrModel) pode detectar em uma única imagem. Caso `two_stage` esteja definido como `True`, usamos `two_stage_num_proposals` em vez disso.
max_position_embeddings (`int`, *opcional*, padrão `1024`) : O comprimento máximo de sequência com o qual este modelo pode ser usado.
encoder_layers (`int`, *opcional*, padrão `6`) : Número de camadas ocultas no codificador do Transformer. Usará o mesmo valor de `num_layers` se não for definido.
encoder_ffn_dim (`int`, *opcional*, padrão `1024`) : Dimensionalidade da camada "intermediária" (frequentemente chamada de feed-forward) no codificador.
encoder_attention_heads (`int`, *opcional*, padrão `8`) : Número de cabeças de atenção para cada camada de atenção no codificador do Transformer.
decoder_layers (`int`, *opcional*, padrão `6`) : Número de camadas ocultas no decodificador do Transformer. Usará o mesmo valor de `num_layers` se não for definido.
decoder_ffn_dim (`int`, *opcional*, padrão `1024`) : Dimensionalidade da camada "intermediária" (frequentemente chamada de feed-forward) no decodificador.
decoder_attention_heads (`int`, *opcional*, padrão `8`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
encoder_layerdrop (`Union[float, int]`, *opcional*, padrão `0.0`) : A probabilidade de LayerDrop para o codificador. Consulte o [artigo LayerDrop](see https://huggingface.co/papers/1909.11556) para mais detalhes.
activation_function (`str`, *opcional*, padrão `relu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
d_model (`int`, *opcional*, padrão `256`) : Tamanho das camadas do codificador e da camada pooler.
dropout (`Union[float, int]`, *opcional*, padrão `0.1`) : A proporção para todas as camadas de dropout.
attention_dropout (`Union[float, int]`, *opcional*, padrão `0.0`) : A taxa de dropout para as probabilidades de atenção.
activation_dropout (`Union[float, int]`, *opcional*, padrão `0.0`) : A taxa de dropout para as ativações dentro da camada totalmente conectada.
init_std (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
init_xavier_std (`float`, *opcional*, padrão `1.0`) : O fator de escala usado na inicialização Xavier dos pesos de atenção cruzada.
return_intermediate (`bool`, *opcional*, padrão True) : Se deve retornar ou não o estado intermediário
auxiliary_loss (`bool`, *opcional*, padrão `False`) : Se as perdas de decodificação auxiliares (perdas em cada camada do decodificador) devem ser usadas.
position_embedding_type (`str`, *opcional*, padrão `"sine"`) : Tipo de embeddings de posição a ser usado sobre os recursos da imagem. Um dos valores `"sine"` ou `"learned"`.
dilation (`bool`, *opcional*, padrão `False`) : Se deve substituir o stride pela dilatação no último bloco convolucional (DC5). Suportado apenas quando `use_timm_backbone` = `True`.
num_feature_levels (`int`, *opcional*, padrão 4) : O número de níveis de recursos de entrada.
encoder_n_points (`int`, *opcional*, padrão 4) : O número de chaves amostradas em cada nível de recurso para cada cabeça de atenção no codificador.
decoder_n_points (`int`, *opcional*, padrão 4) : O número de chaves amostradas em cada nível de recurso para cada cabeça de atenção no decodificador.
two_stage (`bool`, *opcional*, padrão `False`) : Se deve aplicar um DETR deformável de duas etapas, no qual as propostas de região também são geradas por uma variante do Deformable DETR, que são então fornecidas ao decodificador para o refinamento iterativo das caixas delimitadoras.
two_stage_num_proposals (`int`, *opcional*, padrão 300) : O número de propostas de região a serem geradas, caso `two_stage` esteja definido como `True`.
with_box_refine (`bool`, *opcional*, padrão `False`) : Se deve aplicar refinamento iterativo de caixas delimitadoras, em que cada camada do decodificador refina as caixas delimitadoras com base nas previsões da camada anterior.
class_cost (`int`, *opcional*, padrão `1`) : Peso relativo do erro de classificação no custo de correspondência húngara.
bbox_cost (`int`, *opcional*, padrão `5`) : Peso relativo do erro L1 da caixa delimitadora no custo de correspondência húngara.
giou_cost (`int`, *opcional*, padrão `2`) : Peso relativo da perda de IoU generalizada no custo de correspondência húngara.
mask_loss_coefficient (`int`, *opcional*, padrão `1`) : Peso relativo da focal loss na perda de segmentação panótica.
dice_loss_coefficient (`int`, *opcional*, padrão `1`) : Peso relativo da perda dice na perda de segmentação panótica.
bbox_loss_coefficient (`int`, *opcional*, padrão `5`) : Peso relativo da perda de caixa delimitadora L1 na perda de segmentação panótica.
giou_loss_coefficient (`int`, *opcional*, padrão `2`) : Peso relativo da perda de IoU generalizada na perda de segmentação panótica.
eos_coefficient (`float`, *opcional*, padrão `0.1`) : Peso relativo de classificação da classe 'no-object' na perda de detecção de objetos.
focal_alpha (`float`, *opcional*, padrão `0.25`) : Parâmetro alpha na focal loss.
disable_custom_kernels (`bool`, *opcional*, padrão `False`) : Desativa o uso de kernels CUDA e CPU personalizados. Essa opção é necessária para a exportação ONNX, pois os kernels personalizados não são suportados pela exportação ONNX do PyTorch.
tie_word_embeddings (`bool`, *opcional*, padrão `True`) : Se deve vincular as embeddings de pesos de acordo com o mapeamento `tied_weights_keys` do modelo.
Esta é a classe de configuração para armazenar a configuração de um DeformableDetrModel. Ela é usada para instanciar um modelo Deformable Detr de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os valores padrão resultará em uma configuração semelhante à do [SenseTime/deformable-detr](https://huggingface.co/SenseTime/deformable-detr)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplos:
```python
>>> from transformers import DeformableDetrConfig, DeformableDetrModel
>>> # Initializing a Deformable DETR SenseTime/deformable-detr style configuration
>>> configuration = DeformableDetrConfig()
>>> # Initializing a model (with random weights) from the SenseTime/deformable-detr style configuration
>>> model = DeformableDetrModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## DeformableDetrModel[[transformers.DeformableDetrModel]]
#### transformers.DeformableDetrModel[[transformers.DeformableDetrModel]]
```python
transformers.DeformableDetrModel(config: DeformableDetrConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1145)
**Parâmetros:**
config ([DeformableDetrConfig](/docs/transformers/main/pt/model_doc/deformable_detr#transformers.DeformableDetrConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Deformable DETR básico (consistindo de um backbone e um Transformer encoder-decoder) que produz estados ocultos brutos, sem nenhum head específico no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.DeformableDetrModel.forward]]
```python
forward(pixel_values: Tensor, pixel_mask: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1319)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando `image_processor_class`. Consulte `image_processor_class.__call__` para obter detalhes (`processor_class` usa `image_processor_class` para processar imagens).
pixel_mask (`torch.LongTensor` de forma `(batch_size, height, width)`, *opcional*) : Máscara para evitar a execução de atenção em valores de pixels de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para pixels reais (ou seja, **não mascarados**), - 0 para pixels de preenchimento (ou seja, **mascarados**). [O que são máscaras de atenção?](../glossary#attention-mask)
decoder_attention_mask (`torch.Tensor` de forma `(batch_size, num_queries)`, *opcional*) : Não é usado por padrão. Pode ser usado para mascarar consultas de objetos.
encoder_outputs (`torch.Tensor`, *opcional*) : Tupla consiste em (`last_hidden_state`, *opcional*: `hidden_states`, *opcional*: `attentions`) `last_hidden_state` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) é uma sequência de hidden-states na saída da última camada do codificador. Usado na cross-attention do decodificador.
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar o mapa de recursos achatado (saída do backbone + camada de projeção), você pode escolher passar diretamente uma representação achatada de uma imagem.
decoder_inputs_embeds (`torch.Tensor` de forma `(batch_size, num_queries, hidden_size)`, *opcional*) : Opcionalmente, em vez de inicializar as consultas com um tensor de zeros, você pode escolher passar diretamente uma representação incorporada.
**Retorna:** `DeformableDetrModelOutput` ou `tuple(torch.Tensor)`
Uma `DeformableDetrModelOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração (`None`) e das entradas.
O método forward do [DeformableDetrModel](/docs/transformers/main/pt/model_doc/deformable_detr#transformers.DeformableDetrModel) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **init_reference_points** (`torch.Tensor` de forma `(batch_size, num_queries, 4)`) -- Pontos de referência iniciais enviados através do decodificador do Transformer.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, num_queries, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do decodificador do modelo.
- **intermediate_hidden_states** (`torch.Tensor` de forma `(batch_size, config.decoder_layers, num_queries, hidden_size)`) -- Estados ocultos intermediários empilhados (saída de cada camada do decodificador).
- **intermediate_reference_points** (`torch.Tensor` de forma `(batch_size, config.decoder_layers, num_queries, 4)`) -- Pontos de referência intermediários empilhados (pontos de referência de cada camada do decodificador).
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (uma para a saída dos embeddings, se o modelo tiver uma camada de embedding, + uma para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do decodificador na saída de cada camada, além das saídas do embedding inicial.
- **decoder_attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) com forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
- **encoder_last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) -- Sequência de estados ocultos na saída da última camada do encoder do modelo.
- **encoder_hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (uma para a saída dos embeddings, se o modelo tiver uma camada de embedding, + uma para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do codificador na saída de cada camada, além das saídas do embedding inicial.
- **encoder_attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção do codificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **enc_outputs_class** (`torch.Tensor` de forma `(batch_size, sequence_length, config.num_labels)`, *opcional*, retornado quando `config.with_box_refine=True` e `config.two_stage=True`) -- Pontuações das caixas delimitadoras previstas, nas quais as `config.two_stage_num_proposals` caixas delimitadoras com as maiores pontuações são selecionadas como propostas de região na primeira etapa. Saída da classificação binária de caixas delimitadoras (ou seja, primeiro plano e segundo plano).
- **enc_outputs_coord_logits** (`torch.Tensor` de forma `(batch_size, sequence_length, 4)`, *opcional*, retornado quando `config.with_box_refine=True` e `config.two_stage=True`) -- Logits das coordenadas das caixas delimitadoras previstas na primeira etapa.
Exemplos:
```python
>>> from transformers import AutoImageProcessor, DeformableDetrModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("SenseTime/deformable-detr")
>>> model = DeformableDetrModel.from_pretrained("SenseTime/deformable-detr")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 300, 256]
```
## DeformableDetrForObjectDetection[[transformers.DeformableDetrForObjectDetection]]
#### transformers.DeformableDetrForObjectDetection[[transformers.DeformableDetrForObjectDetection]]
```python
transformers.DeformableDetrForObjectDetection(config: DeformableDetrConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1542)
**Parâmetros:**
config ([DeformableDetrConfig](/docs/transformers/main/pt/model_doc/deformable_detr#transformers.DeformableDetrConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo Deformable DETR (composto por um backbone e um Transformer encoder-decoder) com cabeças de detecção de objetos no topo, para tarefas como a detecção COCO.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.DeformableDetrForObjectDetection.forward]]
```python
forward(pixel_values: Tensor, pixel_mask: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, labels: list[dict] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1580)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando `image_processor_class`. Consulte `image_processor_class.__call__` para obter detalhes (`processor_class` usa `image_processor_class` para processar imagens).
pixel_mask (`torch.LongTensor` de forma `(batch_size, height, width)`, *opcional*) : Máscara para evitar a execução de atenção em valores de pixels de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para pixels reais (ou seja, **não mascarados**), - 0 para pixels de preenchimento (ou seja, **mascarados**). [O que são máscaras de atenção?](../glossary#attention-mask)
decoder_attention_mask (`torch.Tensor` de forma `(batch_size, num_queries)`, *opcional*) : Não é usado por padrão. Pode ser usado para mascarar consultas de objetos.
encoder_outputs (`torch.Tensor`, *opcional*) : Tupla consiste em (`last_hidden_state`, *opcional*: `hidden_states`, *opcional*: `attentions`) `last_hidden_state` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) é uma sequência de hidden-states na saída da última camada do codificador. Usado na cross-attention do decodificador.
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar o mapa de recursos achatado (saída do backbone + camada de projeção), você pode escolher passar diretamente uma representação achatada de uma imagem.
decoder_inputs_embeds (`torch.Tensor` de forma `(batch_size, num_queries, hidden_size)`, *opcional*) : Opcionalmente, em vez de inicializar as consultas com um tensor de zeros, você pode escolher passar diretamente uma representação incorporada.
labels (`list[Dict]` of len `(batch_size,)`, *optional*) : Labels for computing the bipartite matching loss. List of dicts, each dictionary containing at least the following 2 keys: 'class_labels' and 'boxes' (the class labels and bounding boxes of an image in the batch respectively). The class labels themselves should be a `torch.LongTensor` of len `(number of bounding boxes in the image,)` and the boxes a `torch.Tensor` of shape `(number of bounding boxes in the image, 4)`.
**Retorna:** `DeformableDetrObjectDetectionOutput` ou `tuple(torch.Tensor)`
Uma `DeformableDetrObjectDetectionOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração (`None`) e das entradas.
O método forward de [DeformableDetrForObjectDetection](/docs/transformers/main/pt/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` são fornecidas)) -- Perda total como uma combinação linear de uma log-verossimilhança negativa (entropia cruzada) para a previsão de classe e uma perda de caixa delimitadora. Esta última é definida como uma combinação linear da perda L1 e da perda de IoU generalizada e invariante à escala.
- **loss_dict** (`Dict`, *opcional*) -- Um dicionário contendo as perdas individuais. Útil para registro de logs.
- **logits** (`torch.Tensor` de forma `(batch_size, num_queries, num_classes + 1)`) -- Logits de classificação (incluindo no-object) para todas as queries.
- **pred_boxes** (`torch.Tensor` de forma `(batch_size, num_queries, 4)`) -- Coordenadas normalizadas das caixas para todas as queries, representadas como (center_x, center_y, width, height). Esses valores são normalizados em [0, 1], relativos ao tamanho de cada imagem individual no lote (ignorando possível padding). Você pode usar `~DeformableDetrProcessor.post_process_object_detection` para recuperar as caixas delimitadoras não normalizadas.
- **auxiliary_outputs** (`list[Dict]`, *opcional*) -- Opcional, retornado apenas quando as perdas auxiliares são ativadas (ou seja, `config.auxiliary_loss` está definido como `True`) e os rótulos são fornecidos. É uma lista de dicionários contendo as duas chaves acima (`logits` e `pred_boxes`) para cada camada do decodificador.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, num_queries, hidden_size)`, *opcional*) -- Sequência de estados ocultos na saída da última camada do decodificador do modelo.
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (uma para a saída dos embeddings, se o modelo tiver uma camada de embedding, + uma para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do decodificador na saída de cada camada, além das saídas do embedding inicial.
- **decoder_attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) com forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
- **encoder_last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) -- Sequência de estados ocultos na saída da última camada do encoder do modelo.
- **encoder_hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (uma para a saída dos embeddings, se o modelo tiver uma camada de embedding, + uma para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do codificador na saída de cada camada, além das saídas do embedding inicial.
- **encoder_attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção do codificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **init_reference_points** (`torch.Tensor` de forma `(batch_size, num_queries, 4)`) -- Pontos de referência iniciais enviados através do decodificador do Transformer.
- **intermediate_hidden_states** (`torch.Tensor` de forma `(batch_size, config.decoder_layers, num_queries, hidden_size)`) -- Estados ocultos intermediários empilhados (saída de cada camada do decodificador).
- **intermediate_reference_points** (`torch.Tensor` de forma `(batch_size, config.decoder_layers, num_queries, 4)`) -- Pontos de referência intermediários empilhados (pontos de referência de cada camada do decodificador).
- **enc_outputs_class** (`torch.Tensor` de forma `(batch_size, sequence_length, config.num_labels)`, *opcional*, retornado quando `config.with_box_refine=True` e `config.two_stage=True`) -- Pontuações das caixas delimitadoras previstas, nas quais as `config.two_stage_num_proposals` caixas delimitadoras com as maiores pontuações são selecionadas como propostas de região na primeira etapa. Saída da classificação binária de caixas delimitadoras (ou seja, primeiro plano e segundo plano).
- **enc_outputs_coord_logits** (`torch.Tensor` de forma `(batch_size, sequence_length, 4)`, *opcional*, retornado quando `config.with_box_refine=True` e `config.two_stage=True`) -- Logits das coordenadas das caixas delimitadoras previstas na primeira etapa.
Exemplos:
```python
>>> from transformers import AutoImageProcessor, DeformableDetrForObjectDetection
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("SenseTime/deformable-detr")
>>> model = DeformableDetrForObjectDetection.from_pretrained("SenseTime/deformable-detr")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> target_sizes = torch.tensor([image.size[::-1]])
>>> results = image_processor.post_process_object_detection(outputs, threshold=0.5, target_sizes=target_sizes)[
... 0
... ]
>>> for score, label, box in zip(results["scores"], results["labels"], results["boxes"]):
... box = [round(i, 2) for i in box.tolist()]
... print(
... f"Detected {model.config.id2label[label.item()]} with confidence "
... f"{round(score.item(), 3)} at location {box}"
... )
Detected cat with confidence 0.8 at location [16.5, 52.84, 318.25, 470.78]
Detected cat with confidence 0.789 at location [342.19, 24.3, 640.02, 372.25]
Detected remote with confidence 0.633 at location [40.79, 72.78, 176.76, 117.25]
```