# GIT
## Visão geral
O modelo GIT foi proposto em [GIT: A Generative Image-to-text Transformer for Vision and Language](https://huggingface.co/papers/2205.14100) por Jianfeng Wang, Zhengyuan Yang, Xiaowei Hu, Linjie Li, Kevin Lin, Zhe Gan, Zicheng Liu, Ce Liu, Lijuan Wang. O GIT é um Transformer somente de decodificador que utiliza o codificador de visão do [CLIP](clip) para condicionar o modelo em entradas de visão, além do texto. O modelo obtém resultados de estado da arte em benchmarks de legendagem de imagens e resposta a perguntas visuais.
O resumo do artigo é o seguinte:
*Neste artigo, projetamos e treinamos um Transformer Generativo de Imagem para Texto, GIT, para unificar tarefas de visão-linguagem, como a geração de legendas para imagens/vídeos e a resposta a perguntas. Embora os modelos generativos forneçam uma arquitetura de rede consistente entre o pré-treinamento e o ajuste fino, o trabalho existente geralmente contém estruturas complexas (codificador/decodificador unimodal/multimodal) e depende de módulos externos, como detectores/etiquetadores de objetos e reconhecimento óptico de caracteres (OCR). No GIT, simplificamos a arquitetura para um codificador de imagem e um decodificador de texto sob uma única tarefa de modelagem de linguagem. Também ampliamos os dados de pré-treinamento e o tamanho do modelo para impulsionar o desempenho. Sem recursos extras, nosso GIT estabelece novos estados da arte em 12 benchmarks desafiadores com uma grande margem. Por exemplo, nosso modelo supera o desempenho humano pela primeira vez no TextCaps (138,2 vs. 125,5 em CIDEr). Além disso, apresentamos um novo esquema de classificação de imagem e reconhecimento de texto de cena baseado em geração, alcançando desempenho razoável em benchmarks padrão.*
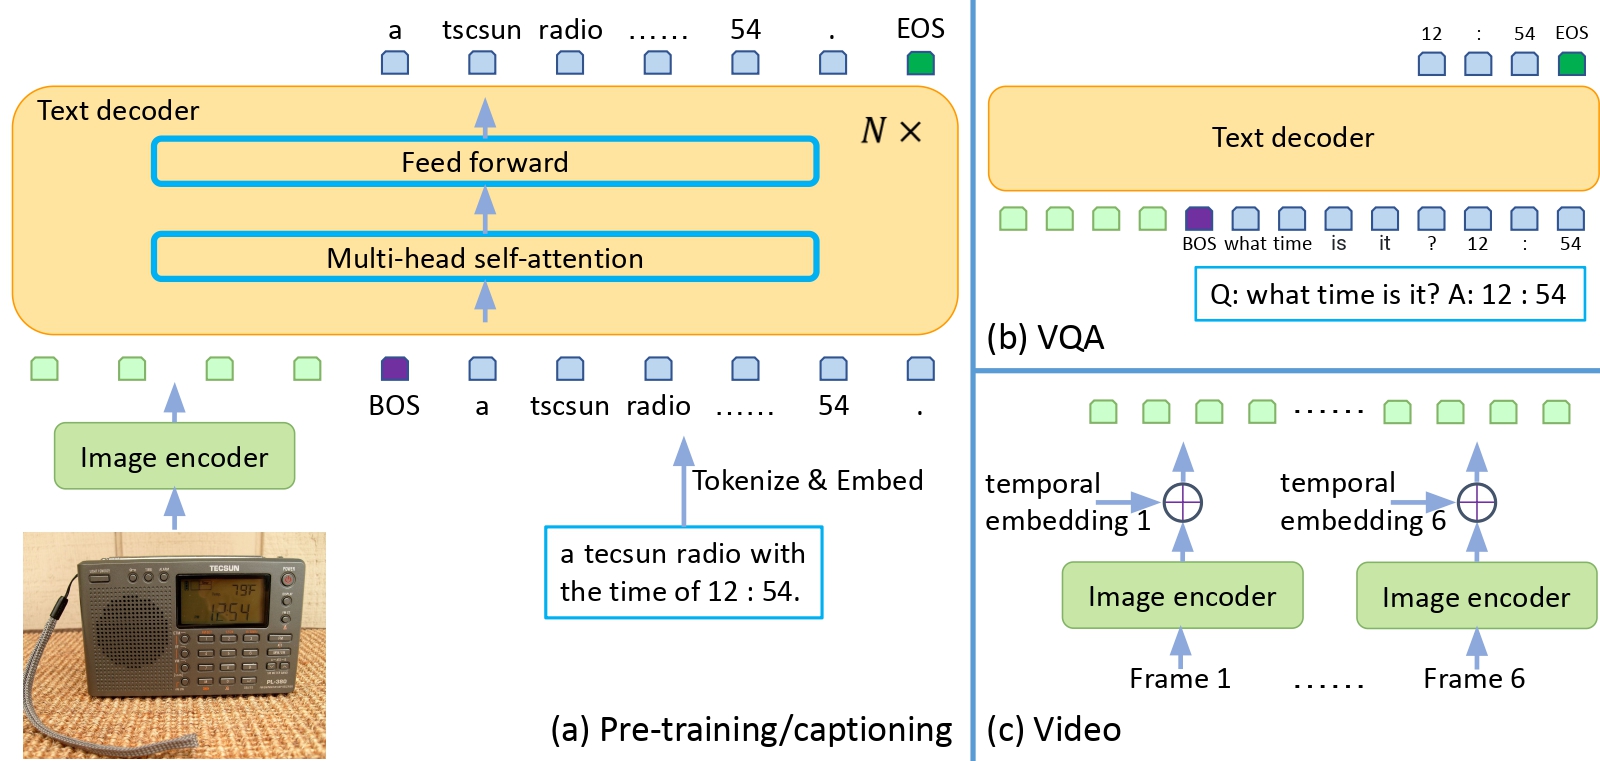 Arquitetura do GIT. Retirada do artigo original.
Este modelo foi contribuído por [nielsr](https://huggingface.co/nielsr). O código original pode ser encontrado [aqui](https://github.com/microsoft/GenerativeImage2Text).
## Dicas de uso
- O GIT é implementado de uma forma muito semelhante ao GPT-2, com a única diferença de que o modelo também é condicionado em `pixel_values`.
## Recursos
Uma lista de recursos oficiais da Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com GIT.
- Notebooks de demonstração sobre inferência + ajuste fino do GIT em dados personalizados podem ser encontrados [aqui](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/GIT).
- Veja também: [Guia da tarefa de modelagem de linguagem causal](../tasks/language_modeling)
Se você tiver interesse em enviar um recurso para ser incluído aqui, sinta-se à vontade para abrir um Pull Request e faremos a revisão. O recurso deve, idealmente, demonstrar algo novo em vez de duplicar um recurso existente.
## GitVisionConfig[[transformers.GitVisionConfig]]
#### transformers.GitVisionConfig[[transformers.GitVisionConfig]]
```python
transformers.GitVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/configuration_git.py#L27)
**Parâmetros:**
hidden_size (`int`, *opcional*, padrão `768`) : Dimensão das representações ocultas.
intermediate_size (`int`, *opcional*, padrão `3072`) : Dimensão das representações do MLP.
num_hidden_layers (`int`, *opcional*, padrão `12`) : Número de camadas ocultas no decodificador do Transformer.
num_attention_heads (`int`, *opcional*, padrão `12`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
num_channels (`int`, *opcional*, padrão `3`) : O número de canais de entrada.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `224`) : O tamanho (resolução) de cada imagem.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `16`) : O tamanho (resolução) de cada patch.
hidden_act (`str`, *opcional*, padrão `quick_gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *opcional*, padrão `1e-05`) : O epsilon usado pelas camadas de normalização de camada.
attention_dropout (`Union[float, int]`, *opcional*, padrão `0.0`) : A taxa de dropout para as probabilidades de atenção.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
Esta é a classe de configuração para armazenar a configuração de um GitModel. Ela é usada para instanciar um modelo Git de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [microsoft/git-base](https://huggingface.co/microsoft/git-base)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import GitVisionConfig, GitVisionModel
>>> # Initializing a GitVisionConfig with microsoft/git-base style configuration
>>> configuration = GitVisionConfig()
>>> # Initializing a GitVisionModel (with random weights) from the microsoft/git-base style configuration
>>> model = GitVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## GitVisionModel[[transformers.GitVisionModel]]
#### transformers.GitVisionModel[[transformers.GitVisionModel]]
```python
transformers.GitVisionModel(config: GitVisionConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L634)
**Parâmetros:**
config ([GitVisionConfig](/docs/transformers/main/pt/model_doc/git#transformers.GitVisionConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo de visão do CLIP, usado no GIT, sem nenhum head ou projeção no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.GitVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L652)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [CLIPImageProcessor](/docs/transformers/main/pt/model_doc/clip#transformers.CLIPImageProcessor). Consulte [CLIPImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para obter detalhes ([GitProcessor](/docs/transformers/main/pt/model_doc/git#transformers.GitProcessor) usa [CLIPImageProcessor](/docs/transformers/main/pt/model_doc/clip#transformers.CLIPImageProcessor) para processar imagens).
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** [BaseModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutput) ou `tuple(torch.Tensor)`
Um [BaseModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([GitConfig](/docs/transformers/main/pt/model_doc/git#transformers.GitConfig)) e das entradas.
O método forward do [GitVisionModel](/docs/transformers/main/pt/model_doc/git#transformers.GitVisionModel) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, GitVisionModel
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base")
>>> model = GitVisionModel.from_pretrained("microsoft/git-base")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
```
## GitConfig[[transformers.GitConfig]]
#### transformers.GitConfig[[transformers.GitConfig]]
```python
transformers.GitConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.models.git.configuration_git.GitVisionConfig | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 6, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 1024, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, use_cache: bool = True, tie_word_embeddings: bool = False, bos_token_id: int | None = 101, eos_token_id: int | list[int] | None = 102, num_image_with_embedding: int | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/configuration_git.py#L62)
**Parâmetros:**
vision_config (`Union[dict, ~models.git.configuration_git.GitVisionConfig]`, *opcional*) : O objeto de configuração ou dicionário do backbone de visão.
vocab_size (`int`, *opcional*, padrão `30522`) : Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelos `input_ids`.
hidden_size (`int`, *opcional*, padrão `768`) : Dimensão das representações ocultas.
num_hidden_layers (`int`, *opcional*, padrão `6`) : Número de camadas ocultas no decodificador do Transformer.
num_attention_heads (`int`, *opcional*, padrão `12`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
intermediate_size (`int`, *opcional*, padrão `3072`) : Dimensão das representações do MLP.
hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.1`) : A probabilidade de dropout para todas as camadas totalmente conectadas nos embeddings, encoder e pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.1`) : A taxa de dropout para as probabilidades de atenção.
max_position_embeddings (`int`, *opcional*, padrão `1024`) : O comprimento máximo de sequência com o qual este modelo pode ser usado.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
layer_norm_eps (`float`, *opcional*, padrão `1e-12`) : O epsilon usado pelas camadas de normalização de camada.
pad_token_id (`int`, *opcional*, padrão `0`) : ID do token usado para preenchimento no vocabulário.
use_cache (`bool`, *opcional*, padrão `True`) : Indica se o modelo deve retornar as últimas atenções de chave/valor (não utilizado por todos os modelos). Relevante apenas se `config.is_decoder=True` ou quando o modelo for um modelo generativo somente de decodificador.
tie_word_embeddings (`bool`, *opcional*, padrão `False`) : Se deve vincular as embeddings de pesos de acordo com o mapeamento `tied_weights_keys` do modelo.
bos_token_id (`int`, *opcional*, padrão `101`) : ID do token usado para o início do fluxo no vocabulário.
eos_token_id (`Union[int, list[int]]`, *opcional*, padrão `102`) : ID do token usado para o fim do fluxo no vocabulário.
num_image_with_embedding (`int`, *opcional*) : O número de embeddings temporais a serem adicionados, caso o modelo seja usado para legendagem de vídeo/VQA.
Esta é a classe de configuração para armazenar a configuração de um GitModel. Ela é usada para instanciar um modelo Git de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [microsoft/git-base](https://huggingface.co/microsoft/git-base)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplos:
```python
>>> from transformers import GitConfig, GitModel
>>> # Initializing a GIT microsoft/git-base style configuration
>>> configuration = GitConfig()
>>> # Initializing a model (with random weights) from the microsoft/git-base style configuration
>>> model = GitModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## GitProcessor[[transformers.GitProcessor]]
#### transformers.GitProcessor[[transformers.GitProcessor]]
```python
transformers.GitProcessor(image_processor, tokenizer)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/processing_git.py#L23)
**Parâmetros:**
image_processor (`CLIPImageProcessor`) : O processador de imagem é uma entrada obrigatória.
tokenizer (`BertTokenizer`) : O tokenizer é uma entrada obrigatória.
Constrói um GitProcessor que encapsula um processador de imagem e um tokenizer em um único processador.
[GitProcessor](/docs/transformers/main/pt/model_doc/git#transformers.GitProcessor) oferece todas as funcionalidades de [CLIPImageProcessor](/docs/transformers/main/pt/model_doc/clip#transformers.CLIPImageProcessor) e [BertTokenizer](/docs/transformers/main/pt/model_doc/lxmert#transformers.BertTokenizer). Consulte [~CLIPImageProcessor](/docs/transformers/main/pt/model_doc/clip#transformers.CLIPImageProcessor) e [~BertTokenizer](/docs/transformers/main/pt/model_doc/lxmert#transformers.BertTokenizer) para mais informações.
#### __call__[[transformers.GitProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L659)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opcional*) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *opcional*) : A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se você passar uma entrada pretokenizada, defina `is_split_into_words=True` para evitar ambiguidade com entradas em lote.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *opcional*) : Vídeo para pré-processar. Espera um único vídeo ou um lote de vídeos com valores de pixel variando de 0 a 255. Se estiver passando vídeos com valores de pixel entre 0 e 1, defina `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *opcional*) : O áudio ou lote de áudios a ser preparado. Cada áudio pode ser um array NumPy ou um tensor PyTorch. No caso de um array NumPy/tensor PyTorch, cada áudio deve ter a forma (C, T), onde C é o número de canais e T é o comprimento de amostras do áudio.
return_tensors (`str` ou [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *opcional*) : Se definido, retornará tensores de um framework específico. Os valores aceitos são: - `'pt'`: Retorna objetos `torch.Tensor` do PyTorch. - `'np'`: Retorna objetos `np.ndarray` do NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/pt/main_classes/processors#transformers.ProcessingKwargs), *opcional*) : Opções de processamento adicionais para cada modalidade (texto, imagens, vídeos, áudio). Os parâmetros específicos do modelo estão listados acima; consulte a classe TypedDict para a lista completa de argumentos suportados.
## GitModel[[transformers.GitModel]]
#### transformers.GitModel[[transformers.GitModel]]
```python
transformers.GitModel(config: GitConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L707)
**Parâmetros:**
config ([GitConfig](/docs/transformers/main/pt/model_doc/git#transformers.GitConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O transformador de modelo GIT puro, composto por um codificador de imagem CLIP e um decodificador de texto que produz estados ocultos brutos
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.GitModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, use_cache: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L738)
**Parâmetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [CLIPImageProcessor](/docs/transformers/main/pt/model_doc/clip#transformers.CLIPImageProcessor). Consulte [CLIPImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para obter detalhes ([GitProcessor](/docs/transformers/main/pt/model_doc/git#transformers.GitProcessor) usa [CLIPImageProcessor](/docs/transformers/main/pt/model_doc/clip#transformers.CLIPImageProcessor) para processar imagens).
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
past_key_values (`~cache_utils.Cache`, *opcional*) : hidden-states pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nos `past_key_values` retornados pelo modelo em uma etapa anterior da decodificação, quando `use_cache=True` ou `config.use_cache=True`. Apenas uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache) é permitida como entrada, consulte nosso [guia de kv cache](https://huggingface.co/docs/transformers/en/kv_cache). Se nenhum `past_key_values` for passado, [DynamicCache](/docs/transformers/main/pt/internal/generation_utils#transformers.DynamicCache) será inicializado por padrão. O modelo sairá no mesmo formato de cache que foi fornecido como entrada. Se `past_key_values` forem usados, espera-se que o usuário insira apenas `input_ids` não processados (aqueles que não têm seus estados de chave e valor passados para este modelo) com a forma `(batch_size, unprocessed_length)` em vez de todos os `input_ids` com a forma `(batch_size, sequence_length)`.
use_cache (`bool`, *opcional*) : Se definido como `True`, os estados de chave-valor de `past_key_values` são retornados e podem ser usados para acelerar a decodificação (veja `past_key_values`).
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([GitConfig](/docs/transformers/main/pt/model_doc/git#transformers.GitConfig)) e das entradas.
O método forward da [GitModel](/docs/transformers/main/pt/model_doc/git#transformers.GitModel) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> from transformers import AutoProcessor, AutoModel
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base")
>>> model = AutoModel.from_pretrained("microsoft/git-base")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "this is an image of two cats"
>>> inputs = processor(images=image, text=text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
```
## GitForCausalLM[[transformers.GitForCausalLM]]
#### transformers.GitForCausalLM[[transformers.GitForCausalLM]]
```python
transformers.GitForCausalLM(config: GitConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L890)
**Parâmetros:**
config ([GitConfig](/docs/transformers/main/pt/model_doc/git#transformers.GitConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo GIT com uma cabeça de `language modeling` no topo para modelagem de linguagem autoregressiva.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.GitForCausalLM.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, use_cache: bool | None = None, interpolate_pos_encoding: bool = False, logits_to_keep: typing.Union[int, torch.Tensor] = 0, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L908)
**Parâmetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [CLIPImageProcessor](/docs/transformers/main/pt/model_doc/clip#transformers.CLIPImageProcessor). Consulte [CLIPImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para obter detalhes ([GitProcessor](/docs/transformers/main/pt/model_doc/git#transformers.GitProcessor) usa [CLIPImageProcessor](/docs/transformers/main/pt/model_doc/clip#transformers.CLIPImageProcessor) para processar imagens).
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
labels (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Rótulos para calcular a perda de modelagem de linguagem da esquerda para a direita (previsão da próxima palavra). Os índices devem estar em `[-100, 0, ..., config.vocab_size]` (veja a docstring de `input_ids`). Tokens com índices definidos como `-100` são ignorados (mascarados); a perda é calculada apenas para os tokens com rótulos em `[0, ..., config.vocab_size]`
past_key_values (`~cache_utils.Cache`, *opcional*) : hidden-states pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nos `past_key_values` retornados pelo modelo em uma etapa anterior da decodificação, quando `use_cache=True` ou `config.use_cache=True`. Apenas uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache) é permitida como entrada, consulte nosso [guia de kv cache](https://huggingface.co/docs/transformers/en/kv_cache). Se nenhum `past_key_values` for passado, [DynamicCache](/docs/transformers/main/pt/internal/generation_utils#transformers.DynamicCache) será inicializado por padrão. O modelo sairá no mesmo formato de cache que foi fornecido como entrada. Se `past_key_values` forem usados, espera-se que o usuário insira apenas `input_ids` não processados (aqueles que não têm seus estados de chave e valor passados para este modelo) com a forma `(batch_size, unprocessed_length)` em vez de todos os `input_ids` com a forma `(batch_size, sequence_length)`.
use_cache (`bool`, *opcional*) : Se definido como `True`, os estados de chave-valor de `past_key_values` são retornados e podem ser usados para acelerar a decodificação (veja `past_key_values`).
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
logits_to_keep (`Union[int, torch.Tensor]`, *opcional*, padrão `0`) : Se for um `int`, calcula os logits para os últimos `logits_to_keep` tokens. Se for `0`, calcula os logits para todos os `input_ids` (caso especial). Apenas os logits do último token são necessários para a geração, e calculá-los apenas para esse token pode economizar memória, o que se torna bastante significativo para sequências longas ou tamanho de vocabulário grande. Se for um `torch.Tensor`, deve ser 1D, correspondendo aos índices a serem mantidos na dimensão de comprimento da sequência. Isso é útil ao usar o formato de tensor empacotado (uma única dimensão para lote e comprimento da sequência).
**Retorna:** [CausalLMOutputWithPast](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithPast) ou `tuple(torch.Tensor)`
Um [CausalLMOutputWithPast](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithPast) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([GitConfig](/docs/transformers/main/pt/model_doc/git#transformers.GitConfig)) e das entradas.
O método forward de [GitForCausalLM](/docs/transformers/main/pt/model_doc/git#transformers.GitForCausalLM) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de modelagem de linguagem (para previsão do próximo token).
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).
- **past_key_values** (`Cache`, *opcional*, retornado quando `use_cache=True` é passado ou quando `config.use_cache=True`) -- Trata-se de uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache). Para mais detalhes, consulte nosso [guia de cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção) que podem ser usados (veja a entrada `past_key_values`) para acelerar a decodificação sequencial.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
Exemplo de legenda de imagem:
```python
>>> from transformers import AutoProcessor, AutoModelForCausalLM
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base-coco")
>>> model = AutoModelForCausalLM.from_pretrained("microsoft/git-base-coco")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> pixel_values = processor(images=image, return_tensors="pt").pixel_values
>>> generated_ids = model.generate(pixel_values=pixel_values, max_length=50)
>>> generated_caption = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
>>> print(generated_caption)
two cats sleeping on a pink blanket next to remotes.
```
Exemplo de visual question answering (VQA):
```python
>>> from transformers import AutoProcessor, AutoModelForCausalLM
>>> from huggingface_hub import hf_hub_download
>>> from PIL import Image
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base-textvqa")
>>> model = AutoModelForCausalLM.from_pretrained("microsoft/git-base-textvqa")
>>> file_path = hf_hub_download(repo_id="nielsr/textvqa-sample", filename="bus.png", repo_type="dataset")
>>> image = Image.open(file_path).convert("RGB")
>>> pixel_values = processor(images=image, return_tensors="pt").pixel_values
>>> question = "what does the front of the bus say at the top?"
>>> input_ids = processor(text=question, add_special_tokens=False).input_ids
>>> input_ids = [processor.tokenizer.cls_token_id] + input_ids
>>> input_ids = torch.tensor(input_ids).unsqueeze(0)
>>> generated_ids = model.generate(pixel_values=pixel_values, input_ids=input_ids, max_length=50)
>>> print(processor.batch_decode(generated_ids, skip_special_tokens=True))
['what does the front of the bus say at the top? special']
```
Exemplo de legendagem de vídeo:
```python
>>> import av
>>> import numpy as np
>>> from PIL import Image
>>> from huggingface_hub import hf_hub_download
>>> from transformers import AutoProcessor, AutoModelForCausalLM
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base-vatex")
>>> model = AutoModelForCausalLM.from_pretrained("microsoft/git-base-vatex")
>>> # set seed for reproducibility
>>> np.random.seed(45)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # load video
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample frames
>>> num_frames = model.config.num_image_with_embedding
>>> indices = sample_frame_indices(
... clip_len=num_frames, frame_sample_rate=4, seg_len=container.streams.video[0].frames
... )
>>> frames = read_video_pyav(container, indices)
>>> pixel_values = processor(images=list(frames), return_tensors="pt").pixel_values
>>> generated_ids = model.generate(pixel_values=pixel_values, max_length=50)
>>> print("Generated caption:", processor.batch_decode(generated_ids, skip_special_tokens=True))
Generated caption: ['a woman is sitting at a table and she is talking about the food she is holding.']
```