# GLPN
Este é um modelo introduzido recentemente, portanto a API não foi testada extensivamente. Pode haver alguns bugs ou pequenas mudanças que quebram a compatibilidade para corrigir no futuro. Se você notar algo estranho, abra uma [Github Issue](https://github.com/huggingface/transformers/issues/new?assignees=&labels=&template=bug-report.md&title).
## Visão geral
O modelo GLPN foi proposto em [Global-Local Path Networks for Monocular Depth Estimation with Vertical CutDepth](https://huggingface.co/papers/2201.07436) por Doyeon Kim, Woonghyun Ga, Pyungwhan Ahn, Donggyu Joo, Sehwan Chun, Junmo Kim. O GLPN combina o mix-Transformer hierárquico do [SegFormer](segformer) com um decodificador leve para estimativa de profundidade monocular. O decodificador proposto apresenta melhor desempenho do que os decodificadores propostos anteriormente, com complexidade computacional consideravelmente menor.
O resumo do artigo é o seguinte:
*A estimativa de profundidade a partir de uma única imagem é uma tarefa importante que pode ser aplicada a diversos campos da visão computacional e tem crescido rapidamente com o desenvolvimento de redes neurais convolucionais. Neste artigo, propomos uma nova estrutura e estratégia de treinamento para a estimativa de profundidade monocular, a fim de melhorar ainda mais a precisão da previsão da rede. Implantamos um codificador de transformador hierárquico para capturar e transmitir o contexto global e projetamos um decodificador leve, porém poderoso, para gerar um mapa de profundidade estimado, considerando a conectividade local. Ao construir caminhos conectados entre recursos locais multiescala e o fluxo de decodificação global com nosso módulo proposto de fusão seletiva de recursos, a rede pode integrar ambas as representações e recuperar detalhes finos. Além disso, o decodificador proposto apresenta melhor desempenho do que os decodificadores propostos anteriormente, com complexidade computacional consideravelmente menor. Além disso, aprimoramos o método de aumento específico de profundidade, utilizando uma observação importante na estimativa de profundidade para aprimorar o modelo. Nossa rede atinge desempenho de estado da arte no conjunto de dados de profundidade desafiador NYU Depth V2. Foram realizados experimentos extensos para validar e demonstrar a eficácia da abordagem proposta. Por fim, nosso modelo demonstra melhor capacidade de generalização e robustez do que outros modelos comparativos.*
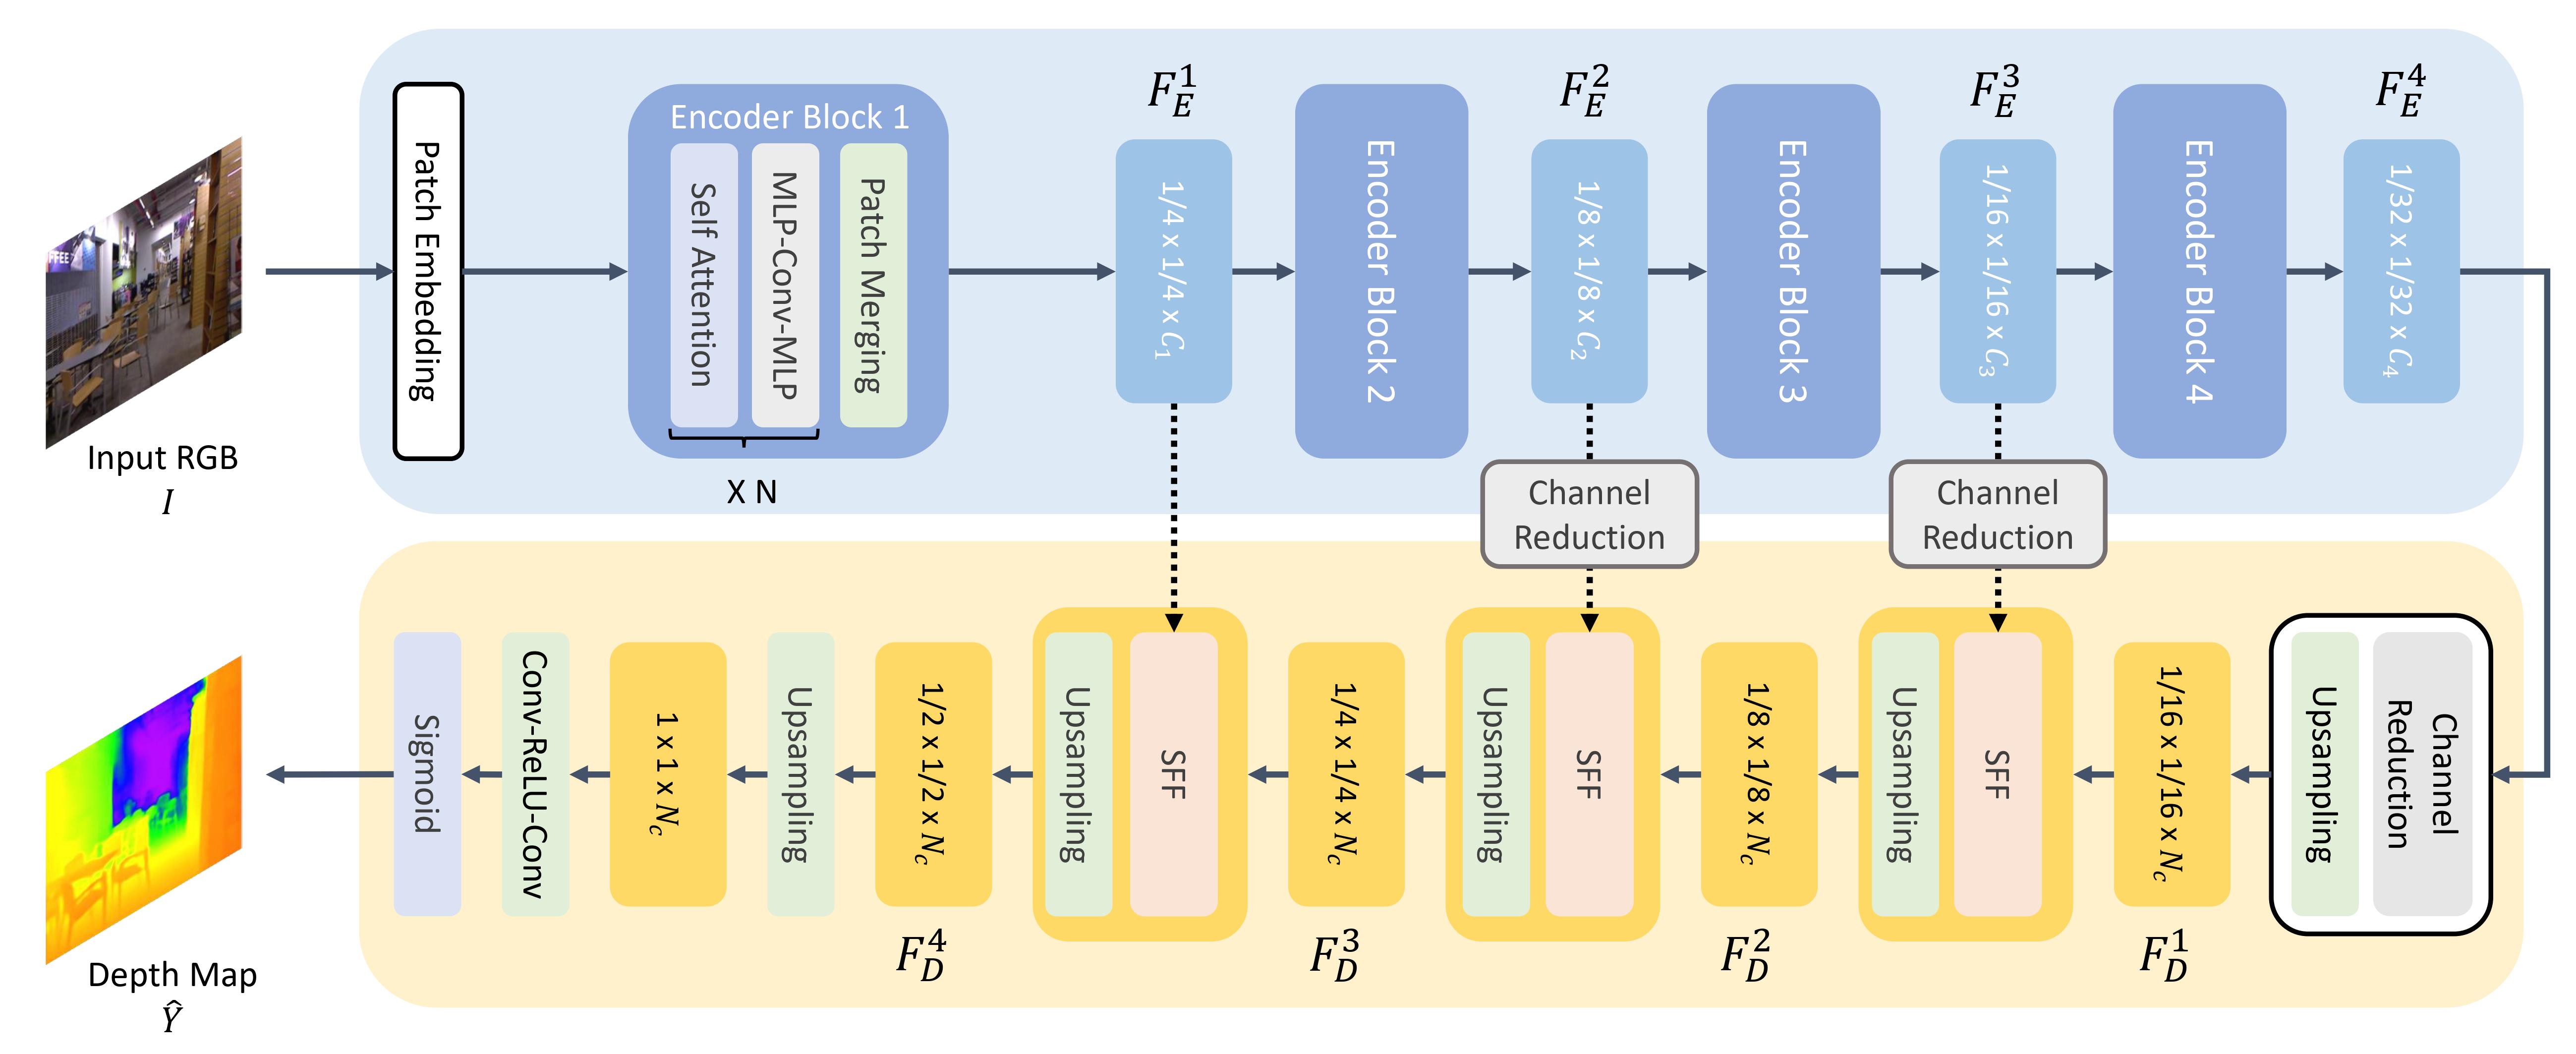 Resumo da abordagem. Retirado do artigo original.
Este modelo foi contribuído por [nielsr](https://huggingface.co/nielsr). O código original pode ser encontrado [aqui](https://github.com/vinvino02/GLPDepth).
## Recursos
Uma lista de recursos oficiais da Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o GLPN.
- Os notebooks de demonstração para [GLPNForDepthEstimation](/docs/transformers/main/pt/model_doc/glpn#transformers.GLPNForDepthEstimation) podem ser encontrados [aqui](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/GLPN).
- [Guia da tarefa de estimativa de profundidade monocular](../tasks/monocular_depth_estimation)
## GLPNConfig[[transformers.GLPNConfig]]
#### transformers.GLPNConfig[[transformers.GLPNConfig]]
```python
transformers.GLPNConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, num_channels: int = 3, num_encoder_blocks: int = 4, depths: list[int] | tuple[int, ...] = (2, 2, 2, 2), sr_ratios: list[int] | tuple[int, ...] = (8, 4, 2, 1), hidden_sizes: list[int] | tuple[int, ...] = (32, 64, 160, 256), patch_sizes: list[int] | tuple[int, ...] = (7, 3, 3, 3), strides: list[int] | tuple[int, ...] = (4, 2, 2, 2), num_attention_heads: list[int] | tuple[int, ...] = (1, 2, 5, 8), mlp_ratios: list[int] | tuple[int, ...] = (4, 4, 4, 4), hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, drop_path_rate: float | int = 0.1, layer_norm_eps: float = 1e-06, decoder_hidden_size: int = 64, max_depth: int = 10, head_in_index: int = -1)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/glpn/configuration_glpn.py#L24)
**Parâmetros:**
num_channels (`int`, *opcional*, padrão `3`) : O número de canais de entrada.
num_encoder_blocks (`int`, *opcional*, padrão 4) : O número de blocos do codificador (ou seja, os estágios no codificador do Mix Transformer).
depths (`list[int]`, *opcional*, padrão `[2, 2, 2, 2]`) : O número de camadas em cada bloco do codificador.
sr_ratios (`list[int]`, *opcional*, padrão `[8, 4, 2, 1]`) : Razões de redução de sequência em cada bloco do codificador.
hidden_sizes (`Union[list[int], tuple[int, ...]]`, *opcional*, padrão `(32, 64, 160, 256)`) : Dimensionalidade (tamanho oculto) em cada etapa do modelo.
patch_sizes (`list[int]`, *opcional*, padrão `[7, 3, 3, 3]`) : Tamanho do patch antes de cada bloco do codificador.
strides (`list[int]`, *opcional*, padrão `[4, 2, 2, 2]`) : Stride antes de cada bloco do encoder.
num_attention_heads (`list[int]`, *opcional*, padrão `[1, 2, 5, 8]`) : Número de cabeças de atenção para cada camada de atenção em cada bloco do codificador do Transformer.
mlp_ratios (`list[int]`, *opcional*, padrão `[4, 4, 4, 4]`) : Razão entre o tamanho da camada oculta e o tamanho da camada de entrada dos Mix FFNs nos blocos do codificador.
hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.0`) : A probabilidade de dropout para todas as camadas totalmente conectadas nos embeddings, no encoder e no pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.0`) : A taxa de dropout para as probabilidades de atenção.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
drop_path_rate (`Union[float, int]`, *opcional*, padrão `0.1`) : Taxa de drop path para a fusão de patches.
layer_norm_eps (`float`, *opcional*, padrão `1e-06`) : O epsilon usado pelas camadas de normalização de camada.
decoder_hidden_size (`int`, *opcional*, padrão 64) : A dimensão do decodificador.
max_depth (`int`, *opcional*, padrão 10) : A profundidade máxima do decodificador.
head_in_index (`int`, *opcional*, padrão -1) : O índice dos recursos a serem usados na head.
Esta é a classe de configuração para armazenar a configuração de um GLPNModel. Ela é usada para instanciar um modelo Glpn de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [vinvino02/glpn-kitti](https://huggingface.co/vinvino02/glpn-kitti)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import GLPNModel, GLPNConfig
>>> # Initializing a GLPN vinvino02/glpn-kitti style configuration
>>> configuration = GLPNConfig()
>>> # Initializing a model from the vinvino02/glpn-kitti style configuration
>>> model = GLPNModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## GLPNImageProcessor[[transformers.GLPNImageProcessor]]
#### transformers.GLPNImageProcessor[[transformers.GLPNImageProcessor]]
```python
transformers.GLPNImageProcessor(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/glpn/image_processing_glpn.py#L51)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `2`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
size_divisor (`int`, *kwargs*, *opcional*, padrão é 32) : Quando `do_resize` é `True`, as imagens são redimensionadas para que a altura e a largura sejam arredondadas para baixo até o múltiplo mais próximo de `size_divisor`.
Constrói um processador de imagem GLPNImageProcessor.
#### preprocess[[transformers.GLPNImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/glpn/image_processing_glpn.py#L70)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
size_divisor (`int`, *kwargs*, *opcional*, padrão é 32) : Quando `do_resize` é `True`, as imagens são redimensionadas para que a altura e a largura sejam arredondadas para baixo até o múltiplo mais próximo de `size_divisor`.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
## GLPNImageProcessorPil[[transformers.GLPNImageProcessorPil]]
#### transformers.GLPNImageProcessorPil[[transformers.GLPNImageProcessorPil]]
```python
transformers.GLPNImageProcessorPil(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/glpn/image_processing_pil_glpn.py#L46)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `2`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
size_divisor (`int`, *kwargs*, *opcional*, padrão é 32) : Quando `do_resize` é `True`, as imagens são redimensionadas para que a altura e a largura sejam arredondadas para baixo até o múltiplo mais próximo de `size_divisor`.
Constrói um processador de imagem GLPNImageProcessor.
#### preprocess[[transformers.GLPNImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/glpn/image_processing_pil_glpn.py#L65)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
size_divisor (`int`, *kwargs*, *opcional*, padrão é 32) : Quando `do_resize` é `True`, as imagens são redimensionadas para que a altura e a largura sejam arredondadas para baixo até o múltiplo mais próximo de `size_divisor`.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
## GLPNModel[[transformers.GLPNModel]]
#### transformers.GLPNModel[[transformers.GLPNModel]]
```python
transformers.GLPNModel(config: GLPNConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/glpn/modeling_glpn.py#L377)
**Parâmetros:**
config ([GLPNConfig](/docs/transformers/main/pt/model_doc/glpn#transformers.GLPNConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Glpn puro, que produz os hidden-states brutos sem nenhum head específico no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.GLPNModel.forward]]
```python
forward(pixel_values: Tensor, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/glpn/modeling_glpn.py#L389)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [GLPNImageProcessor](/docs/transformers/main/pt/model_doc/glpn#transformers.GLPNImageProcessor). Veja [GLPNImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes (`processor_class` usa [GLPNImageProcessor](/docs/transformers/main/pt/model_doc/glpn#transformers.GLPNImageProcessor) para processar imagens).
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** [BaseModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutput) ou `tuple(torch.Tensor)`
Um [BaseModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([GLPNConfig](/docs/transformers/main/pt/model_doc/glpn#transformers.GLPNConfig)) e das entradas.
O método forward do [GLPNModel](/docs/transformers/main/pt/model_doc/glpn#transformers.GLPNModel) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplo:
```python
```
## GLPNForDepthEstimation[[transformers.GLPNForDepthEstimation]]
#### transformers.GLPNForDepthEstimation[[transformers.GLPNForDepthEstimation]]
```python
transformers.GLPNForDepthEstimation(config: GLPNConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/glpn/modeling_glpn.py#L565)
**Parâmetros:**
config ([GLPNConfig](/docs/transformers/main/pt/model_doc/glpn#transformers.GLPNConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo transformer GLPN com uma cabeça de estimativa de profundidade leve no topo, por exemplo, para KITTI, NYUv2.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.GLPNForDepthEstimation.forward]]
```python
forward(pixel_values: Tensor, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/glpn/modeling_glpn.py#L576)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [GLPNImageProcessor](/docs/transformers/main/pt/model_doc/glpn#transformers.GLPNImageProcessor). Veja [GLPNImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes (`processor_class` usa [GLPNImageProcessor](/docs/transformers/main/pt/model_doc/glpn#transformers.GLPNImageProcessor) para processar imagens).
labels (`torch.Tensor` de forma `(batch_size, height, width)`, *opcional*) : Mapas de estimativa de profundidade de verdade para o cálculo da perda.
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** [DepthEstimatorOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.DepthEstimatorOutput) ou `tuple(torch.Tensor)`
Um [DepthEstimatorOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.DepthEstimatorOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([GLPNConfig](/docs/transformers/main/pt/model_doc/glpn#transformers.GLPNConfig)) e das entradas.
O método forward de [GLPNForDepthEstimation](/docs/transformers/main/pt/model_doc/glpn#transformers.GLPNForDepthEstimation) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação (ou de regressão se config.num_labels==1).
- **predicted_depth** (`torch.Tensor` de forma `(batch_size, height, width)`) -- Profundidade prevista para cada pixel.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, num_channels, height, width)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, patch_size, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> from transformers import AutoImageProcessor, GLPNForDepthEstimation
>>> import torch
>>> import numpy as np
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("vinvino02/glpn-kitti")
>>> model = GLPNForDepthEstimation.from_pretrained("vinvino02/glpn-kitti")
>>> # prepare image for the model
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> # interpolate to original size
>>> post_processed_output = image_processor.post_process_depth_estimation(
... outputs,
... target_sizes=[(image.height, image.width)],
... )
>>> # visualize the prediction
>>> predicted_depth = post_processed_output[0]["predicted_depth"]
>>> depth = predicted_depth * 255 / predicted_depth.max()
>>> depth = depth.detach().cpu().numpy()
>>> depth = Image.fromarray(depth.astype("uint8"))
```