# Grounding DINO
## Visão geral
O modelo Grounding DINO foi proposto em [Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection](https://huggingface.co/papers/2303.05499) por Shilong Liu, Zhaoyang Zeng, Tianhe Ren, Feng Li, Hao Zhang, Jie Yang, Chunyuan Li, Jianwei Yang, Hang Su, Jun Zhu, Lei Zhang. O Grounding DINO estende um modelo de detecção de objetos de conjunto fechado com um codificador de texto, permitindo a detecção de objetos de conjunto aberto. O modelo alcança resultados notáveis, como 52,5 AP no COCO zero-shot.
O resumo do artigo é o seguinte:
*Neste artigo, apresentamos um detector de objetos de conjunto aberto, chamado Grounding DINO, que combina o detector baseado em Transformer DINO com pré-treinamento fundamentado, capaz de detectar objetos arbitrários a partir de entradas humanas, como nomes de categorias ou expressões de referência. A solução-chave para a detecção de objetos de conjunto aberto é a introdução de linguagem em um detector de conjunto fechado para a generalização de conceitos de conjunto aberto. Para fundir efetivamente as modalidades de linguagem e visão, dividimos conceitualmente um detector de conjunto fechado em três fases e propomos uma solução de fusão integrada, que inclui um aprimorador de recursos, uma seleção de consultas guiada por linguagem e um decodificador de multimodalidade para fusão entre modalidades. Enquanto trabalhos anteriores avaliavam principalmente a detecção de objetos de conjunto aberto em categorias novas, propomos também realizar avaliações em compreensão de expressões de referência para objetos especificados com atributos. O Grounding DINO apresenta desempenho notável em todos os três cenários, incluindo benchmarks em COCO, LVIS, ODinW e RefCOCO/+/g. O Grounding DINO atinge 52,5 AP no benchmark de transferência zero-shot de detecção do COCO, ou seja, sem nenhum dado de treinamento do COCO. Ele estabelece um novo recorde no benchmark zero-shot do ODinW, com uma média de 26,1 AP.*
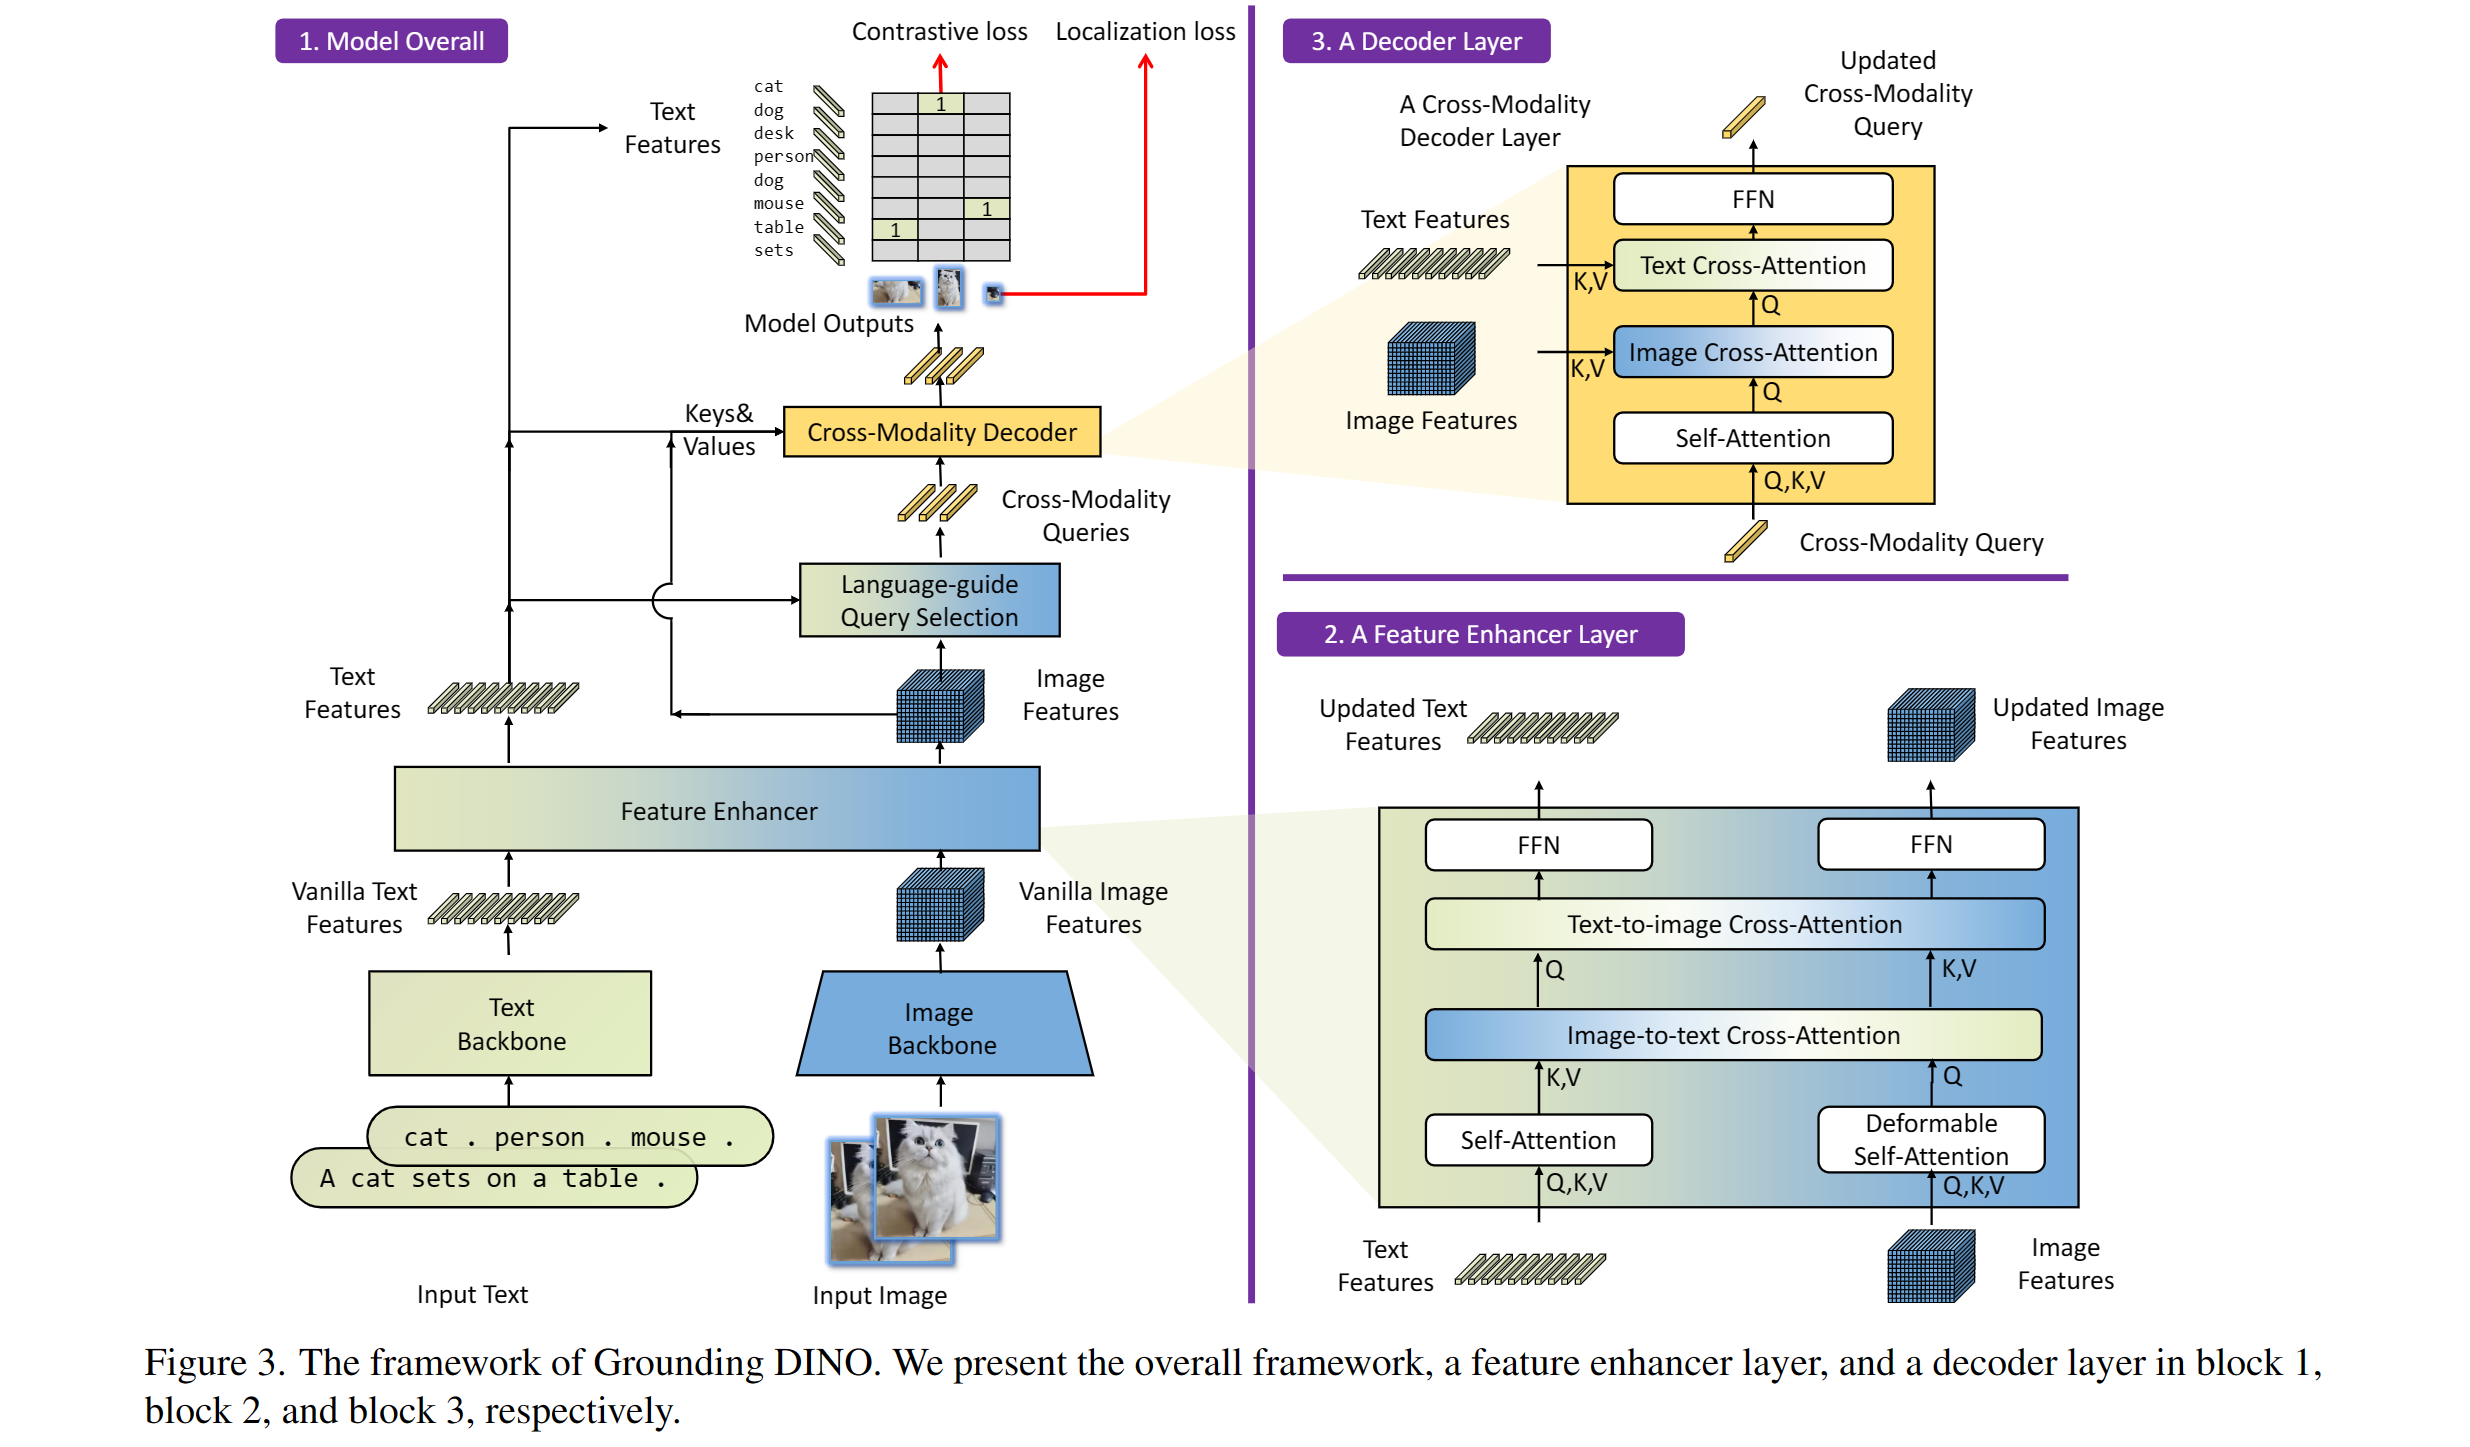 Visão geral do Grounding DINO. Retirado do artigo original.
Este modelo foi contribuído por [EduardoPacheco](https://huggingface.co/EduardoPacheco) e [nielsr](https://huggingface.co/nielsr). O código original pode ser encontrado [aqui](https://github.com/IDEA-Research/GroundingDINO).
## Dicas de uso
- É possível usar [GroundingDinoProcessor](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoProcessor) para preparar pares de imagem e texto para o modelo.
- Para separar classes no texto, use um ponto, por exemplo, "a cat. a dog."
- Ao usar múltiplas classes (por exemplo, `"a cat. a dog."`), utilize `post_process_grounded_object_detection` de [GroundingDinoProcessor](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoProcessor) para pós-processar as saídas. Isso porque os rótulos retornados por `post_process_object_detection` representam os índices da dimensão do modelo em que prob > threshold.
Aqui está como usar o modelo para detecção de objetos zero-shot:
```python
import requests
import torch
from PIL import Image
from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection
model_id = "IDEA-Research/grounding-dino-tiny"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id, device_map="auto")
image_url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(image_url, stream=True).raw)
# Check for cats and remote controls
text_labels = [["a cat", "a remote control"]]
inputs = processor(images=image, text=text_labels, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
results = processor.post_process_grounded_object_detection(
outputs,
inputs.input_ids,
threshold=0.4,
text_threshold=0.3,
target_sizes=[image.size[::-1]]
)
# Retrieve the first image result
result = results[0]
for box, score, labels in zip(result["boxes"], result["scores"], result["labels"]):
box = [round(x, 2) for x in box.tolist()]
print(f"Detected {labels} with confidence {round(score.item(), 3)} at location {box}")
Detected a cat with confidence 0.468 at location [344.78, 22.9, 637.3, 373.62]
Detected a cat with confidence 0.426 at location [11.74, 51.55, 316.51, 473.22]
```
## Grounded SAM
É possível combinar o Grounding DINO com o modelo [Segment Anything](sam) para geração de máscaras baseadas em texto, conforme introduzido em [Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks](https://huggingface.co/papers/2401.14159). Você pode consultar este [notebook de demonstração](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/Grounding%20DINO/GroundingDINO_with_Segment_Anything.ipynb) 🌍 para mais detalhes.
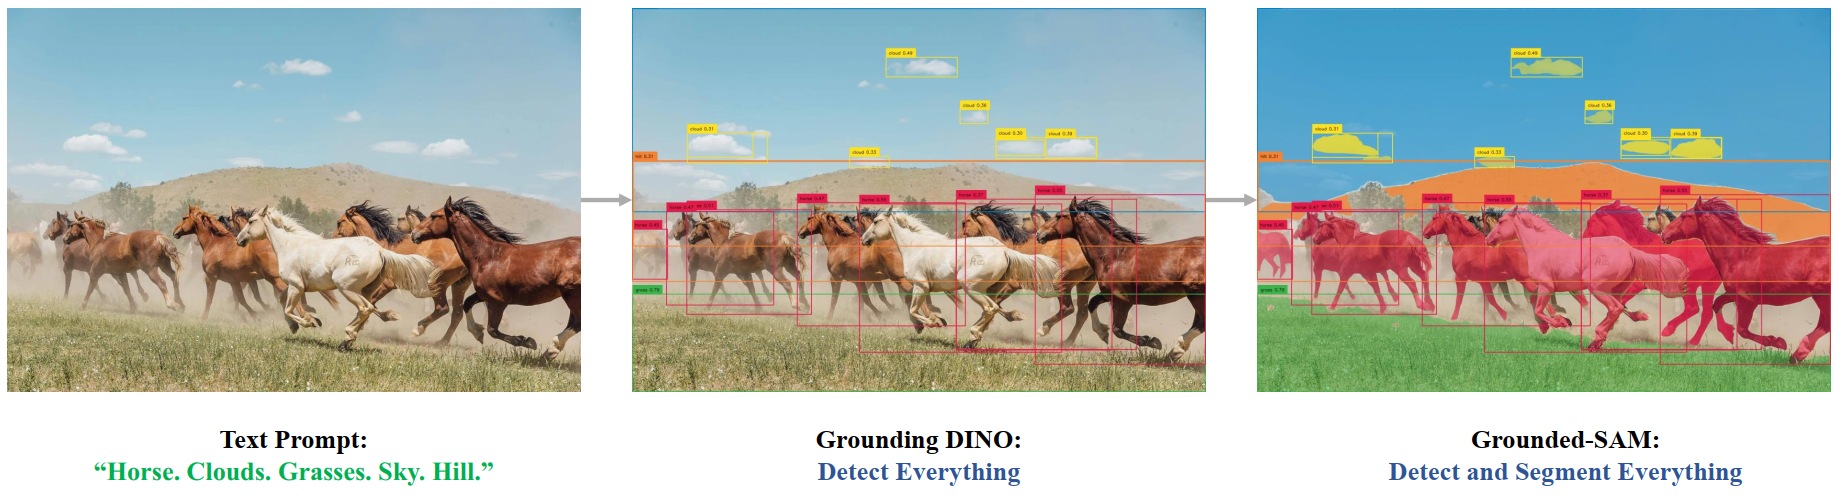 Visão geral do Grounded SAM. Retirado do repositório original.
## Recursos
Uma lista de recursos oficiais do Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o Grounding DINO. Se você tiver interesse em enviar um recurso para ser incluído aqui, sinta-se à vontade para abrir um Pull Request e faremos a revisão! O recurso deve, idealmente, demonstrar algo novo, em vez de duplicar um recurso existente.
- Notebooks de demonstração sobre inferência com Grounding DINO, bem como sua combinação com [SAM](sam), podem ser encontrados [aqui](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Grounding%20DINO). 🌎
## GroundingDinoImageProcessor[[transformers.GroundingDinoImageProcessor]]
#### transformers.GroundingDinoImageProcessor[[transformers.GroundingDinoImageProcessor]]
```python
transformers.GroundingDinoImageProcessor(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_grounding_dino.py#L308)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'shortest_edge' : 800, 'longest_edge': 1333}`): Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `2`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.485, 0.456, 0.406]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.229, 0.224, 0.225]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*, padrão `True`) : Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
format (`str`, *kwargs*, *opcional*, padrão `AnnotationFormat.COCO_DETECTION`) : Formato dos dados das anotações. Um dos valores "coco_detection" ou "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *opcional*, padrão `True`) : Controla se as anotações devem ser convertidas para o formato esperado pelo modelo GROUNDING_DINO. Converte as bounding boxes para o formato `(center_x, center_y, width, height)` e no intervalo `[0, 1]`. Pode ser sobrescrito pelo parâmetro `do_convert_annotations` no método `preprocess`.
Constrói um processador de imagem GroundingDinoImageProcessor.
#### preprocess[[transformers.GroundingDinoImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_grounding_dino.py#L563)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
annotations (`AnnotationType` ou `list[AnnotationType]`, *opcional*) : Anotações a serem transformadas de acordo com o padding aplicado às imagens.
return_segmentation_masks (`bool`, *opcional*, padrão `self.return_segmentation_masks`) : Se deve retornar máscaras de segmentação.
masks_path (`str` ou `pathlib.Path`, *opcional*) : Caminho para o diretório que contém as máscaras de segmentação.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
format (`str`, *kwargs*, *opcional*, padrão `AnnotationFormat.COCO_DETECTION`) : Formato dos dados das anotações. Um dos valores "coco_detection" ou "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *opcional*, padrão `True`) : Controla se as anotações devem ser convertidas para o formato esperado pelo modelo GROUNDING_DINO. Converte as bounding boxes para o formato `(center_x, center_y, width, height)` e no intervalo `[0, 1]`. Pode ser sobrescrito pelo parâmetro `do_convert_annotations` no método `preprocess`.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
## GroundingDinoImageProcessorPil[[transformers.GroundingDinoImageProcessorPil]]
#### transformers.GroundingDinoImageProcessorPil[[transformers.GroundingDinoImageProcessorPil]]
```python
transformers.GroundingDinoImageProcessorPil(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L300)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'shortest_edge' : 800, 'longest_edge': 1333}`): Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `2`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.485, 0.456, 0.406]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.229, 0.224, 0.225]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*, padrão `True`) : Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
format (`str`, *kwargs*, *opcional*, padrão `AnnotationFormat.COCO_DETECTION`) : Formato dos dados das anotações. Um dos valores "coco_detection" ou "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *opcional*, padrão `True`) : Controla se as anotações devem ser convertidas para o formato esperado pelo modelo GROUNDING_DINO. Converte as bounding boxes para o formato `(center_x, center_y, width, height)` e no intervalo `[0, 1]`. Pode ser sobrescrito pelo parâmetro `do_convert_annotations` no método `preprocess`.
Constrói um processador de imagem GroundingDinoImageProcessor.
#### preprocess[[transformers.GroundingDinoImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L568)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
annotations (`AnnotationType` ou `list[AnnotationType]`, *opcional*) : Anotações a serem transformadas de acordo com o padding aplicado às imagens.
return_segmentation_masks (`bool`, *opcional*, padrão `self.return_segmentation_masks`) : Se deve retornar máscaras de segmentação.
masks_path (`str` ou `pathlib.Path`, *opcional*) : Caminho para o diretório que contém as máscaras de segmentação.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
format (`str`, *kwargs*, *opcional*, padrão `AnnotationFormat.COCO_DETECTION`) : Formato dos dados das anotações. Um dos valores "coco_detection" ou "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *opcional*, padrão `True`) : Controla se as anotações devem ser convertidas para o formato esperado pelo modelo GROUNDING_DINO. Converte as bounding boxes para o formato `(center_x, center_y, width, height)` e no intervalo `[0, 1]`. Pode ser sobrescrito pelo parâmetro `do_convert_annotations` no método `preprocess`.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
#### post_process_object_detection[[transformers.GroundingDinoImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs: GroundingDinoObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L713)
**Parâmetros:**
outputs (`GroundingDinoObjectDetectionOutput`) : Saídas brutas do modelo.
threshold (`float`, *opcional*, padrão 0.1) : Limiar de pontuação para manter as previsões de detecção de objetos.
target_sizes (`torch.Tensor` ou `list[tuple[int, int]]`, *opcional*) : Tensor de forma `(batch_size, 2)` ou lista de tuplas (`tuple[int, int]`) contendo o tamanho alvo `(height, width)` de cada imagem no lote. Se não definido, as previsões não serão redimensionadas.
**Retorna:** `list[Dict]`
Uma lista de dicionários, em que cada dicionário contém as seguintes chaves:
- "scores": as pontuações de confiança para cada caixa prevista na imagem.
- "labels": Índices das classes previstas pelo modelo na imagem.
- "boxes": Caixas delimitadoras de imagem no formato (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
Converte a saída bruta de [GroundingDinoForObjectDetection](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection) em caixas delimitadoras finais no formato (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
## GroundingDinoProcessor[[transformers.GroundingDinoProcessor]]
#### transformers.GroundingDinoProcessor[[transformers.GroundingDinoProcessor]]
```python
transformers.GroundingDinoProcessor(image_processor, tokenizer)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/processing_grounding_dino.py#L115)
**Parâmetros:**
image_processor (`GroundingDinoImageProcessor`) : O processador de imagem é uma entrada obrigatória.
tokenizer (`BertTokenizer`) : O tokenizer é uma entrada obrigatória.
Constrói um GroundingDinoProcessor que encapsula um processador de imagem e um tokenizer em um único processador.
[GroundingDinoProcessor](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoProcessor) oferece todas as funcionalidades de [GroundingDinoImageProcessor](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) e [BertTokenizer](/docs/transformers/main/pt/model_doc/lxmert#transformers.BertTokenizer). Consulte [~GroundingDinoImageProcessor](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) e [~BertTokenizer](/docs/transformers/main/pt/model_doc/lxmert#transformers.BertTokenizer) para mais informações.
#### __call__[[transformers.GroundingDinoProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L653)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opcional*) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *opcional*) : A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se você passar uma entrada pretokenizada, defina `is_split_into_words=True` para evitar ambiguidade com entradas em lote.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *opcional*) : Vídeo para pré-processar. Espera um único vídeo ou um lote de vídeos com valores de pixel variando de 0 a 255. Se estiver passando vídeos com valores de pixel entre 0 e 1, defina `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *opcional*) : O áudio ou lote de áudios a ser preparado. Cada áudio pode ser um array NumPy ou um tensor PyTorch. No caso de um array NumPy/tensor PyTorch, cada áudio deve ter a forma (C, T), onde C é o número de canais e T é o comprimento de amostras do áudio.
return_tensors (`str` ou [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *opcional*) : Se definido, retornará tensores de um framework específico. Os valores aceitos são: - `'pt'`: Retorna objetos `torch.Tensor` do PyTorch. - `'np'`: Retorna objetos `np.ndarray` do NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/pt/main_classes/processors#transformers.ProcessingKwargs), *opcional*) : Opções de processamento adicionais para cada modalidade (texto, imagens, vídeos, áudio). Os parâmetros específicos do modelo estão listados acima; consulte a classe TypedDict para a lista completa de argumentos suportados.
#### post_process_grounded_object_detection[[transformers.GroundingDinoProcessor.post_process_grounded_object_detection]]
```python
post_process_grounded_object_detection(outputs: GroundingDinoObjectDetectionOutput, input_ids: transformers.utils.generic.TensorType | None = None, threshold: float = 0.25, text_threshold: float = 0.25, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None, text_labels: list[list[str]] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/processing_grounding_dino.py#L143)
**Parâmetros:**
outputs (`GroundingDinoObjectDetectionOutput`) : Saídas brutas do modelo.
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Os ids dos tokens do texto de entrada. Se não for fornecido, será obtido da saída do modelo.
threshold (`float`, *opcional*, padrão 0.25) : Limiar para manter as previsões de detecção de objetos com base na pontuação de confiança.
text_threshold (`float`, *opcional*, padrão 0.25) : Limiar de pontuação para manter as previsões de detecção de texto.
target_sizes (`torch.Tensor` ou `list[tuple[int, int]]`, *opcional*) : Tensor de forma `(batch_size, 2)` ou lista de tuplas (`tuple[int, int]`) contendo o tamanho alvo `(height, width)` de cada imagem no lote. Se não definido, as previsões não serão redimensionadas.
text_labels (`list[list[str]]`, *opcional*) : Lista de rótulos candidatos a serem detectados em cada imagem. No momento, *NÃO é usado*, mas é obrigatório na assinatura do pipeline de detecção de objetos zero-shot. Os rótulos de texto são extraídos do tensor `input_ids` fornecido em `outputs`.
**Retorna:** `list[Dict]`
Uma lista de dicionários, em que cada dicionário contém
- **scores**: tensor de pontuações de confiança para os objetos detectados
- **boxes**: tensor de caixas delimitadoras no formato [x0, y0, x1, y1]
- **labels**: lista de rótulos de texto para cada objeto detectado (será substituída por ids inteiros na v4.51.0)
- **text_labels**: lista de rótulos de texto para os objetos detectados
Converte a saída bruta de [GroundingDinoForObjectDetection](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection) em caixas delimitadoras finais no formato (top_left_x, top_left_y, bottom_right_x, bottom_right_y) e obtém o rótulo de texto associado.
## GroundingDinoConfig[[transformers.GroundingDinoConfig]]
#### transformers.GroundingDinoConfig[[transformers.GroundingDinoConfig]]
```python
transformers.GroundingDinoConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_queries: int = 900, encoder_layers: int = 6, encoder_ffn_dim: int = 2048, encoder_attention_heads: int = 8, decoder_layers: int = 6, decoder_ffn_dim: int = 2048, decoder_attention_heads: int = 8, activation_function: str = 'relu', d_model: int = 256, dropout: float | int = 0.1, attention_dropout: float | int = 0.0, activation_dropout: float | int = 0.0, auxiliary_loss: bool = False, position_embedding_type: str = 'sine', num_feature_levels: int = 4, encoder_n_points: int = 4, decoder_n_points: int = 4, two_stage: bool = True, class_cost: float = 1.0, bbox_cost: float = 5.0, giou_cost: float = 2.0, bbox_loss_coefficient: float = 5.0, giou_loss_coefficient: float = 2.0, focal_alpha: float = 0.25, disable_custom_kernels: bool = False, max_text_len: int = 256, text_enhancer_dropout: float | int = 0.0, fusion_droppath: float | int = 0.1, fusion_dropout: float | int = 0.0, embedding_init_target: bool = True, query_dim: int = 4, decoder_bbox_embed_share: bool = True, two_stage_bbox_embed_share: bool = False, positional_embedding_temperature: int = 20, init_std: float = 0.02, layer_norm_eps: float = 1e-05, tie_word_embeddings: bool = True)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/configuration_grounding_dino.py#L28)
**Parâmetros:**
is_encoder_decoder (`bool`, *opcional*, padrão `True`) : Indica se o modelo é usado como codificador/decodificador ou não.
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : A configuração do modelo backbone.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : O objeto de configuração ou dicionário do backbone de texto.
num_queries (`int`, *opcional*, padrão 900) : Número de consultas de objeto, ou seja, slots de detecção. Este é o número máximo de objetos que o [GroundingDinoModel](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoModel) pode detectar em uma única imagem.
encoder_layers (`int`, *opcional*, padrão `6`) : Número de camadas ocultas no codificador do Transformer. Usará o mesmo valor de `num_layers` se não for definido.
encoder_ffn_dim (`int`, *opcional*, padrão `2048`) : Dimensionalidade da camada "intermediária" (frequentemente chamada de feed-forward) no codificador.
encoder_attention_heads (`int`, *opcional*, padrão `8`) : Número de cabeças de atenção para cada camada de atenção no codificador do Transformer.
decoder_layers (`int`, *opcional*, padrão `6`) : Número de camadas ocultas no decodificador do Transformer. Usará o mesmo valor de `num_layers` se não for definido.
decoder_ffn_dim (`int`, *opcional*, padrão `2048`) : Dimensionalidade da camada "intermediária" (frequentemente chamada de feed-forward) no decodificador.
decoder_attention_heads (`int`, *opcional*, padrão `8`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
activation_function (`str`, *opcional*, padrão `relu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
d_model (`int`, *opcional*, padrão `256`) : Tamanho das camadas do codificador e da camada pooler.
dropout (`Union[float, int]`, *opcional*, padrão `0.1`) : A proporção para todas as camadas de dropout.
attention_dropout (`Union[float, int]`, *opcional*, padrão `0.0`) : A taxa de dropout para as probabilidades de atenção.
activation_dropout (`Union[float, int]`, *opcional*, padrão `0.0`) : A taxa de dropout para as ativações dentro da camada totalmente conectada.
auxiliary_loss (`bool`, *opcional*, padrão `False`) : Se as perdas de decodificação auxiliares (perdas em cada camada do decodificador) devem ser usadas.
position_embedding_type (`str`, *opcional*, padrão `"sine"`) : Tipo de embeddings de posição a ser usado sobre os recursos da imagem. Um dos valores `"sine"` ou `"learned"`.
num_feature_levels (`int`, *opcional*, padrão 4) : O número de níveis de recursos de entrada.
encoder_n_points (`int`, *opcional*, padrão 4) : O número de chaves amostradas em cada nível de recurso para cada cabeça de atenção no codificador.
decoder_n_points (`int`, *opcional*, padrão 4) : O número de chaves amostradas em cada nível de recurso para cada cabeça de atenção no decodificador.
two_stage (`bool`, *opcional*, padrão `True`) : Se deve aplicar um DETR deformável de duas etapas, no qual as propostas de região também são geradas por uma variante do Grounding DINO, que são então fornecidas ao decodificador para o refinamento iterativo das caixas delimitadoras.
class_cost (`float`, *opcional*, padrão `1.0`) : Peso relativo do erro de classificação no custo de correspondência húngara.
bbox_cost (`float`, *opcional*, padrão `5.0`) : Peso relativo do erro de caixa delimitadora L1 no custo de correspondência húngara.
giou_cost (`float`, *opcional*, padrão `2.0`) : Peso relativo da perda de IoU generalizada no custo de correspondência húngara.
bbox_loss_coefficient (`float`, *opcional*, padrão `5.0`) : Peso relativo da perda de caixa delimitadora L1 na perda de segmentação panótica.
giou_loss_coefficient (`float`, *opcional*, padrão `2.0`) : Peso relativo da perda de IoU generalizada na perda de segmentação panótica.
focal_alpha (`float`, *opcional*, padrão `0.25`) : Parâmetro alpha na focal loss.
disable_custom_kernels (`bool`, *opcional*, padrão `False`) : Desativa o uso de kernels CUDA e CPU personalizados. Essa opção é necessária para a exportação ONNX, pois os kernels personalizados não são suportados pela exportação ONNX do PyTorch.
max_text_len (`int`, *opcional*, padrão 256) : O comprimento máximo da entrada de texto.
text_enhancer_dropout (`float`, *opcional*, padrão 0.0) : A taxa de dropout para o aprimorador de texto.
fusion_droppath (`float`, *opcional*, padrão 0.1) : A proporção de droppath para o módulo de fusão.
fusion_dropout (`float`, *opcional*, padrão 0.0) : A taxa de dropout para o módulo de fusão.
embedding_init_target (`bool`, *opcional*, padrão `True`) : Se deve inicializar o alvo com pesos de Embedding.
query_dim (`int`, *opcional*, padrão 4) : A dimensão do vetor de consulta.
decoder_bbox_embed_share (`bool`, *opcional*, padrão `True`) : Se deve compartilhar a cabeça de regressão de bbox para todas as camadas do decodificador.
two_stage_bbox_embed_share (`bool`, *opcional*, padrão `False`) : Se deve compartilhar o embedding de bbox entre o gerador de bbox de duas etapas e a geração de propostas de região.
positional_embedding_temperature (`float`, *opcional*, padrão 20) : A temperatura para Sine Positional Embedding que é usada junto com o vision backbone.
init_std (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
layer_norm_eps (`float`, *opcional*, padrão `1e-05`) : O epsilon usado pelas camadas de normalização de camada.
tie_word_embeddings (`bool`, *opcional*, padrão `True`) : Se deve vincular as embeddings de pesos de acordo com o mapeamento `tied_weights_keys` do modelo.
Esta é a classe de configuração para armazenar a configuração de um modelo Grounding Dino. Ela é usada para instanciar um modelo Grounding Dino de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [IDEA-Research/grounding-dino-tiny](https://huggingface.co/IDEA-Research/grounding-dino-tiny)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplos:
```python
>>> from transformers import GroundingDinoConfig, GroundingDinoModel
>>> # Initializing a Grounding DINO IDEA-Research/grounding-dino-tiny style configuration
>>> configuration = GroundingDinoConfig()
>>> # Initializing a model (with random weights) from the IDEA-Research/grounding-dino-tiny style configuration
>>> model = GroundingDinoModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## GroundingDinoModel[[transformers.GroundingDinoModel]]
#### transformers.GroundingDinoModel[[transformers.GroundingDinoModel]]
```python
transformers.GroundingDinoModel(config: GroundingDinoConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L1866)
**Parâmetros:**
config ([GroundingDinoConfig](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Grounding DINO básico (consistindo de um backbone e um Transformer encoder-decoder) que produz estados ocultos brutos, sem nenhum head específico no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.GroundingDinoModel.forward]]
```python
forward(pixel_values: Tensor, input_ids: Tensor, token_type_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.Tensor] = None, encoder_outputs = None, output_attentions = None, output_hidden_states = None, return_dict = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2008)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [GroundingDinoImageProcessor](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor). Veja [GroundingDinoImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([GroundingDinoProcessor](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoProcessor) usa [GroundingDinoImageProcessor](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) para processar imagens).
input_ids (`torch.LongTensor` de forma `(batch_size, text_sequence_length)`) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão, caso você o forneça. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [BertTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes.
token_type_ids (`torch.LongTensor` de forma `(batch_size, text_sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em `[0, 1]`: 0 corresponde a um token de `sentence A`, 1 corresponde a um token de `sentence B` [O que são token type IDs?](../glossary#token-type-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
pixel_mask (`torch.Tensor` de forma `(batch_size, height, width)`, *opcional*) : Máscara para evitar a execução de atenção em valores de pixels de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para pixels reais (ou seja, **não mascarados**), - 0 para pixels de preenchimento (ou seja, **mascarados**). [O que são máscaras de atenção?](../glossary#attention-mask)
encoder_outputs (``) : Tuple consists of (`last_hidden_state`, *optional*: `hidden_states`, *optional*: `attentions`) `last_hidden_state` of shape `(batch_size, sequence_length, hidden_size)`, *optional*) is a sequence of hidden-states at the output of the last layer of the encoder. Used in the cross-attention of the decoder.
output_attentions (``) : Whether or not to return the attentions tensors of all attention layers. See `attentions` under returned tensors for more detail.
output_hidden_states (``) : Whether or not to return the hidden states of all layers. See `hidden_states` under returned tensors for more detail.
return_dict (``) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** `GroundingDinoModelOutput` ou `tuple(torch.Tensor)`
Um `GroundingDinoModelOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([GroundingDinoConfig](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoConfig)) e das entradas.
O método forward do [GroundingDinoModel](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoModel) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, num_queries, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do decodificador do modelo.
- **init_reference_points** (`torch.Tensor` de forma `(batch_size, num_queries, 4)`) -- Pontos de referência iniciais enviados através do decodificador do Transformer.
- **intermediate_hidden_states** (`torch.Tensor` de forma `(batch_size, config.decoder_layers, num_queries, hidden_size)`) -- Estados ocultos intermediários empilhados (saída de cada camada do decodificador).
- **intermediate_reference_points** (`torch.Tensor` de forma `(batch_size, config.decoder_layers, num_queries, 4)`) -- Pontos de referência intermediários empilhados (pontos de referência de cada camada do decodificador).
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (uma para a saída dos embeddings, se o modelo tiver uma camada de embedding, + uma para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do decodificador na saída de cada camada, além das saídas do embedding inicial.
- **decoder_attentions** (`tuple[tuple[torch.Tensor]]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **encoder_last_hidden_state_vision** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) -- Sequência de estados ocultos na saída da última camada do codificador do modelo.
- **encoder_last_hidden_state_text** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) -- Sequência de estados ocultos na saída da última camada do codificador do modelo.
- **encoder_vision_hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings de visão + um para a saída de cada camada) com forma `(batch_size, sequence_length, hidden_size)`. Estados ocultos do codificador de visão na saída de cada camada, além das saídas dos embeddings iniciais.
- **encoder_text_hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída das incorporações de texto + um para a saída de cada camada) com forma `(batch_size, sequence_length, hidden_size)`. Estados ocultos do codificador de texto na saída de cada camada, além das saídas das incorporações iniciais.
- **encoder_attentions** (`tuple(tuple(torch.Tensor))`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de tuplas de `torch.Tensor` (uma para a atenção de cada camada) com forma `(batch_size, num_heads, sequence_length, sequence_length)`. Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de atenção texto-visão, visão-texto, aprimorador de texto (autoatenção) e atenção deformável multiescala. softmax de atenção, usado para calcular a média ponderada nos cabeçalhos de biatenção.
- **enc_outputs_class** (`torch.Tensor` de forma `(batch_size, sequence_length, config.num_labels)`, *opcional*, retornado quando `config.two_stage=True`) -- Pontuações das caixas delimitadoras previstas, nas quais as caixas delimitadoras com as `config.num_queries` maiores pontuações são selecionadas como propostas de região na primeira etapa. Saída da classificação binária de caixas delimitadoras (ou seja, primeiro plano e segundo plano).
- **enc_outputs_coord_logits** (`torch.Tensor` de forma `(batch_size, sequence_length, 4)`, *opcional*, retornado quando `config.two_stage=True`) -- Logits das coordenadas das caixas delimitadoras previstas na primeira etapa.
- **encoder_logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.num_labels)`, *opcional*, retornado quando `config.two_stage=True`) -- Logits das `config.num_queries` caixas delimitadoras com maior pontuação na primeira etapa.
- **encoder_pred_boxes** (`torch.Tensor` de forma `(batch_size, sequence_length, 4)`, *opcional*, retornado quando `config.two_stage=True`) -- Coordenadas das `config.num_queries` caixas delimitadoras com maior pontuação na primeira etapa.
Exemplos:
```python
>>> from transformers import AutoProcessor, AutoModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "a cat."
>>> processor = AutoProcessor.from_pretrained("IDEA-Research/grounding-dino-tiny")
>>> model = AutoModel.from_pretrained("IDEA-Research/grounding-dino-tiny")
>>> inputs = processor(images=image, text=text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 900, 256]
```
## GroundingDinoForObjectDetection[[transformers.GroundingDinoForObjectDetection]]
#### transformers.GroundingDinoForObjectDetection[[transformers.GroundingDinoForObjectDetection]]
```python
transformers.GroundingDinoForObjectDetection(config: GroundingDinoConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2376)
**Parâmetros:**
config ([GroundingDinoConfig](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo Grounding DINO (composto por um backbone e um Transformer encoder-decoder) com cabeças de detecção de objetos no topo, para tarefas como a detecção COCO.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.GroundingDinoForObjectDetection.forward]]
```python
forward(pixel_values: Tensor, input_ids: LongTensor, token_type_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, pixel_mask: typing.Optional[torch.BoolTensor] = None, encoder_outputs: transformers.models.grounding_dino.modeling_grounding_dino.GroundingDinoEncoderOutput | tuple | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, labels: list[dict[str, typing.Union[torch.LongTensor, torch.Tensor]]] | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2417)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [GroundingDinoImageProcessor](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor). Veja [GroundingDinoImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([GroundingDinoProcessor](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoProcessor) usa [GroundingDinoImageProcessor](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) para processar imagens).
input_ids (`torch.LongTensor` de forma `(batch_size, text_sequence_length)`) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão, caso você o forneça. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [BertTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes.
token_type_ids (`torch.LongTensor` de forma `(batch_size, text_sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em `[0, 1]`: 0 corresponde a um token de `sentence A`, 1 corresponde a um token de `sentence B` [O que são token type IDs?](../glossary#token-type-ids)
attention_mask (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
pixel_mask (`torch.BoolTensor` de forma `(batch_size, height, width)`, *opcional*) : Máscara para evitar a execução de atenção em valores de pixels de preenchimento. Valores da máscara selecionados em `[0, 1]`: - 1 para pixels reais (ou seja, **não mascarados**), - 0 para pixels de preenchimento (ou seja, **mascarados**). [O que são máscaras de atenção?](../glossary#attention-mask)
encoder_outputs (`Union[~models.grounding_dino.modeling_grounding_dino.GroundingDinoEncoderOutput, tuple]`, *opcional*) : A tupla consiste em (`last_hidden_state`, *opcional*: `hidden_states`, *opcional*: `attentions`) `last_hidden_state` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) é uma sequência de hidden-states na saída da última camada do encoder. Usado na cross-attention do decoder.
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
labels (`list[Dict]` of len `(batch_size,)`, *optional*) : Labels for computing the bipartite matching loss. List of dicts, each dictionary containing at least the following 2 keys: 'class_labels' and 'boxes' (the class labels and bounding boxes of an image in the batch respectively). The class labels themselves should be a `torch.LongTensor` of len `(number of bounding boxes in the image,)` and the boxes a `torch.Tensor` of shape `(number of bounding boxes in the image, 4)`.
O método forward de [GroundingDinoForObjectDetection](/docs/transformers/main/pt/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
Exemplos:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> import torch
>>> from PIL import Image
>>> from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection
>>> model_id = "IDEA-Research/grounding-dino-tiny"
>>> device = "cuda"
>>> processor = AutoProcessor.from_pretrained(model_id)
>>> model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id).to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> # Check for cats and remote controls
>>> text_labels = [["a cat", "a remote control"]]
>>> inputs = processor(images=image, text=text_labels, return_tensors="pt").to(device)
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> results = processor.post_process_grounded_object_detection(
... outputs,
... threshold=0.4,
... text_threshold=0.3,
... target_sizes=[(image.height, image.width)]
... )
>>> # Retrieve the first image result
>>> result = results[0]
>>> for box, score, text_label in zip(result["boxes"], result["scores"], result["text_labels"]):
... box = [round(x, 2) for x in box.tolist()]
... print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a cat with confidence 0.479 at location [344.7, 23.11, 637.18, 374.28]
Detected a cat with confidence 0.438 at location [12.27, 51.91, 316.86, 472.44]
Detected a remote control with confidence 0.478 at location [38.57, 70.0, 176.78, 118.18]
```