# ImageGPT
## Visão geral
O modelo ImageGPT foi proposto em [Generative Pretraining from Pixels](https://openai.com/blog/image-gpt) por Mark Chen, Alec Radford, Rewon Child, Jeffrey Wu, Heewoo Jun, David Luan e Ilya Sutskever. O ImageGPT (iGPT) é um modelo semelhante ao GPT-2, treinado para prever o valor do próximo pixel, permitindo a geração de imagens tanto incondicional quanto condicional.
O resumo do [artigo](https://cdn.openai.com/papers/Generative_Pretraining_from_Pixels_V1_ICML.pdf) é o seguinte:
*Inspirados pelos avanços no aprendizado de representações não supervisionadas para linguagem natural, investigamos se modelos semelhantes podem aprender representações úteis para imagens. Treinamos um Transformer de sequência para prever pixels de forma auto-regressiva, sem incorporar conhecimento da estrutura 2D da entrada. Apesar de treinar em ImageNet de baixa resolução sem rótulos, constatamos que um modelo na escala do GPT-2 aprende representações de imagem robustas, conforme medido por linear probing, fine-tuning e classificação com poucos dados. No CIFAR-10, alcançamos 96,3% de precisão com um linear probe, superando um Wide ResNet supervisionado, e 99,0% de precisão com fine-tuning completo, igualando os principais modelos pré-treinados supervisionados. Também somos competitivos em benchmarks auto-supervisionados no ImageNet ao substituir pixels por uma codificação VQVAE, alcançando 69,0% de precisão top-1 em um linear probe de nossos recursos.*
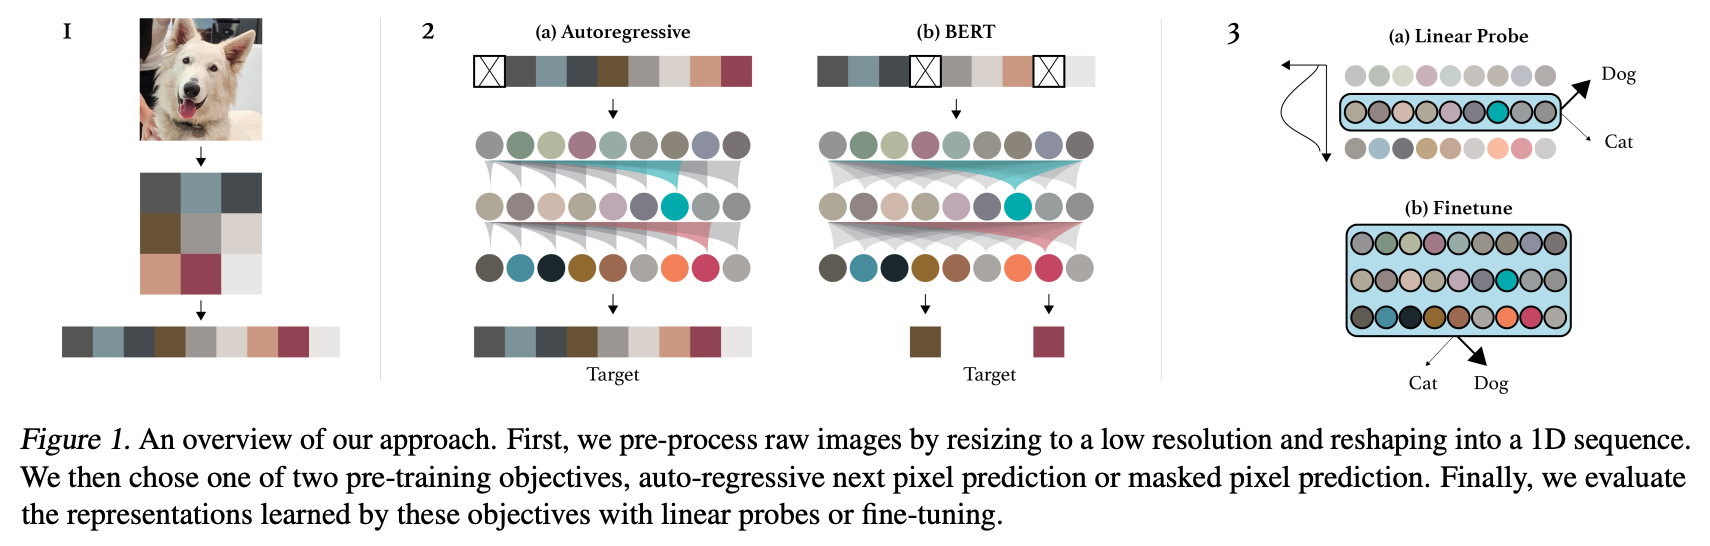 Resumo da abordagem. Retirado do [artigo original](https://cdn.openai.com/papers/Generative_Pretraining_from_Pixels_V2.pdf).
Este modelo foi contribuído por [nielsr](https://huggingface.co/nielsr), com base [neste problema](https://github.com/openai/image-gpt/issues/7). O código original pode ser encontrado [aqui](https://github.com/openai/image-gpt).
## Dicas de uso
- O ImageGPT é praticamente idêntico ao [GPT-2](gpt2), com a exceção de que é utilizada uma função de ativação diferente (especificamente, "quick gelu") e as camadas de normalização de camada não centralizam as entradas. O ImageGPT também não possui embeddings de entrada e saída vinculados.
- Como os requisitos de tempo e memória do mecanismo de atenção dos Transformers crescem quadraticamente em relação ao comprimento da sequência, os autores pré-treinaram o ImageGPT em resoluções de entrada menores, como 32x32 e 64x64. No entanto, alimentar uma sequência de 32x32x3=3072 tokens de 0..255 para um Transformer ainda é proibitivamente grande. Portanto, os autores aplicaram o agrupamento k-means aos valores de pixels (R,G,B) com k=512. Dessa forma, temos apenas uma sequência de comprimento 32*32 = 1024, mas agora de inteiros no intervalo 0..511. Assim, estamos reduzindo o comprimento da sequência ao custo de uma matriz de incorporação maior. Em outras palavras, o tamanho do vocabulário do ImageGPT é 512, + 1 para um token especial "início de frase" (SOS), usado no início de cada sequência. É possível usar [ImageGPTImageProcessor](/docs/transformers/main/pt/model_doc/imagegpt#transformers.ImageGPTImageProcessor) para preparar as imagens para o modelo.
- Apesar de ser pré-treinado de forma totalmente não supervisionada (ou seja, sem o uso de qualquer rótulo), o ImageGPT produz recursos de imagem bastante eficientes, úteis para tarefas subsequentes, como a classificação de imagens. Os autores demonstraram que os recursos no meio da rede são os mais eficientes e podem ser usados diretamente para treinar um modelo linear (como, por exemplo, um modelo de regressão logística do sklearn). Isso também é conhecido como "linear probing". Os recursos podem ser obtidos facilmente enviando primeiro a imagem pelo modelo, especificando `output_hidden_states=True` e, em seguida, aplicando average-pooling nos estados ocultos da camada desejada.
- Alternativamente, é possível fazer o ajuste fino de todo o modelo em um conjunto de dados de um caso de uso específico, de forma semelhante ao BERT. Para isso, você pode usar [ImageGPTForImageClassification](/docs/transformers/main/pt/model_doc/imagegpt#transformers.ImageGPTForImageClassification).
- O ImageGPT está disponível em diferentes tamanhos: há o ImageGPT-small, o ImageGPT-medium e o ImageGPT-large. Os autores também treinaram uma variante XL, que não foi liberada. As diferenças de tamanho são resumidas na tabela a seguir:
| **Variação do modelo** | **Profundidades** | **Tamanhos ocultos** | **Tamanho oculto do decodificador** | **Parâmetros (M)** | **ImageNet-1k Top 1** |
|---|---|---|---|---|---|
| MiT-b0 | [2, 2, 2, 2] | [32, 64, 160, 256] | 256 | 3.7 | 70.5 |
| MiT-b1 | [2, 2, 2, 2] | [64, 128, 320, 512] | 256 | 14.0 | 78.7 |
| MiT-b2 | [3, 4, 6, 3] | [64, 128, 320, 512] | 768 | 25.4 | 81.6 |
| MiT-b3 | [3, 4, 18, 3] | [64, 128, 320, 512] | 768 | 45.2 | 83.1 |
| MiT-b4 | [3, 8, 27, 3] | [64, 128, 320, 512] | 768 | 62.6 | 83.6 |
| MiT-b5 | [3, 6, 40, 3] | [64, 128, 320, 512] | 768 | 82.0 | 83.8 |
## Recursos
Uma lista de recursos oficiais da Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o ImageGPT.
- Os notebooks de demonstração do ImageGPT podem ser encontrados [aqui](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/ImageGPT).
- [ImageGPTForImageClassification](/docs/transformers/main/pt/model_doc/imagegpt#transformers.ImageGPTForImageClassification) é suportado por este [notebook](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb).
- Veja também: [Guia da tarefa de classificação de imagens](../tasks/image_classification)
Se você tiver interesse em enviar um recurso para ser incluído aqui, sinta-se à vontade para abrir um Pull Request e faremos a revisão! O recurso deve, idealmente, demonstrar algo novo, em vez de duplicar um recurso existente.
## ImageGPTConfig[[transformers.ImageGPTConfig]]
#### transformers.ImageGPTConfig[[transformers.ImageGPTConfig]]
```python
transformers.ImageGPTConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 513, n_positions: int = 1024, n_embd: int = 512, n_layer: int = 24, n_head: int = 8, n_inner: int | None = None, activation_function: str = 'quick_gelu', resid_pdrop: float | int = 0.1, embd_pdrop: float | int = 0.1, attn_pdrop: float | int = 0.1, layer_norm_epsilon: float = 1e-05, initializer_range: float = 0.02, scale_attn_weights: bool = True, use_cache: bool = True, tie_word_embeddings: bool = False, scale_attn_by_inverse_layer_idx: bool = False, reorder_and_upcast_attn: bool = False, add_cross_attention: bool = False, pad_token_id: int | None = None, bos_token_id: int | None = None, eos_token_id: int | list[int] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/configuration_imagegpt.py#L24)
**Parâmetros:**
vocab_size (`int`, *opcional*, padrão `513`) : Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelos `input_ids`.
n_positions (`int`, *opcional*, padrão `1024`) : O comprimento máximo de sequência com o qual este modelo pode ser usado.
n_embd (`int`, *opcional*, padrão `512`) : Dimensionalidade dos embeddings e dos estados ocultos.
n_layer (`int`, *opcional*, padrão `24`) : Número de camadas ocultas no decodificador do Transformer.
n_head (`int`, *opcional*, padrão `8`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
n_inner (`int`, *opcional*) : Dimensão das representações do MLP.
activation_function (`str`, *opcional*, padrão `quick_gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
resid_pdrop (`Union[float, int]`, *opcional*, padrão `0.1`) : A probabilidade de dropout para todas as camadas totalmente conectadas nos embeddings, encoder e pooler.
embd_pdrop (`Union[float, int]`, *opcional*, padrão `0.1`) : A taxa de dropout para os embeddings.
attn_pdrop (`Union[float, int]`, *opcional*, padrão `0.1`) : A taxa de dropout para as probabilidades de atenção.
layer_norm_epsilon (`float`, *opcional*, padrão `1e-05`) : O epsilon usado pelas camadas de normalização de camada.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
scale_attn_weights (`bool`, *opcional*, padrão `True`) : Se as embeddings devem ser escalonadas dividindo por sqrt(d_model).
use_cache (`bool`, *opcional*, padrão `True`) : Indica se o modelo deve retornar as últimas atenções de chave/valor (não utilizado por todos os modelos). Relevante apenas se `config.is_decoder=True` ou quando o modelo for um modelo generativo somente de decodificador.
tie_word_embeddings (`bool`, *opcional*, padrão `False`) : Se deve vincular as embeddings de pesos de acordo com o mapeamento `tied_weights_keys` do modelo.
scale_attn_by_inverse_layer_idx (`bool`, *opcional*, padrão `False`) : Se as pesos de atenção devem ser escalados adicionalmente por `1 / layer_idx + 1`.
reorder_and_upcast_attn (`bool`, *opcional*, padrão `False`) : Se deve escalar as chaves (K) antes de calcular a atenção (produto escalar) e fazer o upcast do produto escalar/softmax da atenção para float() durante o treinamento com precisão mista.
add_cross_attention (`bool`, *opcional*, padrão `False`) : Se as camadas de atenção cruzada devem ser adicionadas ao modelo.
pad_token_id (`int`, *opcional*) : ID do token usado para preenchimento (padding) no vocabulário.
bos_token_id (`int`, *opcional*) : ID do token usado para o início do fluxo no vocabulário.
eos_token_id (`Union[int, list[int]]`, *opcional*) : ID do token usado para o fim do fluxo no vocabulário.
Esta é a classe de configuração para armazenar a configuração de um ImageGPTModel. Ela é usada para instanciar um modelo Imagegpt de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [openai/imagegpt-small](https://huggingface.co/openai/imagegpt-small)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import ImageGPTConfig, ImageGPTModel
>>> # Initializing a ImageGPT configuration
>>> configuration = ImageGPTConfig()
>>> # Initializing a model (with random weights) from the configuration
>>> model = ImageGPTModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ImageGPTImageProcessor[[transformers.ImageGPTImageProcessor]]
#### transformers.ImageGPTImageProcessor[[transformers.ImageGPTImageProcessor]]
```python
transformers.ImageGPTImageProcessor(clusters: typing.Union[list, numpy.ndarray, torch.Tensor, NoneType] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/image_processing_imagegpt.py#L82)
**Parâmetros:**
clusters (`np.ndarray` ou `list[list[int]]` ou `torch.Tensor`, *opcional*) : Os clusters de cores a serem usados, com forma `(n_clusters, 3)` ao quantizar cores. Pode ser substituído por `clusters` em `preprocess`.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 256, 'width': 256}`): Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `2`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.5, 0.5, 0.5]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.5, 0.5, 0.5]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
clusters (`np.ndarray`, *kwargs* ou `list[list[int]]` ou `torch.Tensor`, *opcional*, padrão `self.clusters`) : Os clusters de cores a serem usados, com forma `(n_clusters, 3)` ao quantizar cores. Pode ser sobrescrito por `clusters` em `preprocess`.
do_color_quantize (`bool`, *kwargs*, *opcional*, padrão `self.do_color_quantize`) : Controla se a quantização de cores deve ser aplicada para converter valores de pixels contínuos em índices discretos de clusters. Quando True, cada pixel é atribuído ao seu cluster de cores mais próximo, permitindo a modelagem de tokens discretos do ImageGPT.
Constrói um processador de imagem ImageGPTImageProcessor.
#### preprocess[[transformers.ImageGPTImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Sinalizador do desenvolvedor para entradas adicionais semelhantes a imagens que também serão pré-processadas. Use isso apenas se a passagem das entradas como kwarg não funcionar. Por exemplo, `preprocess(images, masks=masks)` é a opção preferida, mas resulta em problemas de prioridade de argumentos para alguns modelos. Nesses casos, `preprocess(images, image_like_inputs={"masks": masks})` pode ser usado em vez disso.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
Pré-processa uma imagem ou um lote de imagens.
## ImageGPTImageProcessorPil[[transformers.ImageGPTImageProcessorPil]]
#### transformers.ImageGPTImageProcessorPil[[transformers.ImageGPTImageProcessorPil]]
```python
transformers.ImageGPTImageProcessorPil(clusters: list | np.ndarray | torch.Tensor | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/image_processing_pil_imagegpt.py#L69)
**Parâmetros:**
clusters (`np.ndarray` ou `list[list[int]]` ou `torch.Tensor`, *opcional*) : Os clusters de cores a serem usados, com forma `(n_clusters, 3)` ao quantizar cores. Pode ser substituído por `clusters` em `preprocess`.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 256, 'width': 256}`): Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `2`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.5, 0.5, 0.5]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.5, 0.5, 0.5]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
clusters (`np.ndarray`, *kwargs* ou `list[list[int]]` ou `torch.Tensor`, *opcional*, padrão `self.clusters`) : Os clusters de cores a serem usados, com forma `(n_clusters, 3)` ao quantizar cores. Pode ser sobrescrito por `clusters` em `preprocess`.
do_color_quantize (`bool`, *kwargs*, *opcional*, padrão `self.do_color_quantize`) : Controla se a quantização de cores deve ser aplicada para converter valores de pixels contínuos em índices discretos de clusters. Quando True, cada pixel é atribuído ao seu cluster de cores mais próximo, permitindo a modelagem de tokens discretos do ImageGPT.
Constrói um processador de imagem ImageGPTImageProcessor.
#### preprocess[[transformers.ImageGPTImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Sinalizador do desenvolvedor para entradas adicionais semelhantes a imagens que também serão pré-processadas. Use isso apenas se a passagem das entradas como kwarg não funcionar. Por exemplo, `preprocess(images, masks=masks)` é a opção preferida, mas resulta em problemas de prioridade de argumentos para alguns modelos. Nesses casos, `preprocess(images, image_like_inputs={"masks": masks})` pode ser usado em vez disso.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
Pré-processa uma imagem ou um lote de imagens.
## ImageGPTModel[[transformers.ImageGPTModel]]
#### transformers.ImageGPTModel[[transformers.ImageGPTModel]]
```python
transformers.ImageGPTModel(config: ImageGPTConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L393)
**Parâmetros:**
config ([ImageGPTConfig](/docs/transformers/main/pt/model_doc/imagegpt#transformers.ImageGPTConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Imagegpt básico, que gera os hidden-states brutos sem nenhum head específico no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.ImageGPTModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs: Any)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L416)
**Parâmetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, input_ids_length)`) : `input_ids_length` = `sequence_length` se `past_key_values` for `None`, caso contrário `past_key_values.get_seq_length()` (`sequence_length` dos estados de chave e valor passados de entrada). Índices dos tokens da sequência de entrada no vocabulário. Se `past_key_values` for usado, apenas os `input_ids` que ainda não têm seu passado calculado devem ser passados como `input_ids`. Os índices podem ser obtidos usando [AutoImageProcessor](/docs/transformers/main/pt/model_doc/auto#transformers.AutoImageProcessor). Consulte [ImageGPTImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para mais detalhes.
past_key_values (`~cache_utils.Cache`, *opcional*) : hidden-states pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nos `past_key_values` retornados pelo modelo em uma etapa anterior da decodificação, quando `use_cache=True` ou `config.use_cache=True`. Apenas uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache) é permitida como entrada, consulte nosso [guia de kv cache](https://huggingface.co/docs/transformers/en/kv_cache). Se nenhum `past_key_values` for passado, [DynamicCache](/docs/transformers/main/pt/internal/generation_utils#transformers.DynamicCache) será inicializado por padrão. O modelo sairá no mesmo formato de cache que foi fornecido como entrada. Se `past_key_values` forem usados, espera-se que o usuário insira apenas `input_ids` não processados (aqueles que não têm seus estados de chave e valor passados para este modelo) com a forma `(batch_size, unprocessed_length)` em vez de todos os `input_ids` com a forma `(batch_size, sequence_length)`.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em `[0, 1]`: - 0 corresponde a um token de *frase A*, - 1 corresponde a um token de *frase B*. [O que são IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
encoder_hidden_states (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Sequência de hidden-states na saída da última camada do encoder. Usada na cross-attention se o modelo estiver configurado como um decoder.
encoder_attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento da entrada do codificador. Essa máscara é usada na atenção cruzada se o modelo estiver configurado como um decodificador. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**.
use_cache (`bool`, *opcional*) : Se definido como `True`, os estados de chave-valor de `past_key_values` são retornados e podem ser usados para acelerar a decodificação (veja `past_key_values`).
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** [BaseModelOutputWithPastAndCrossAttentions](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPastAndCrossAttentions) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPastAndCrossAttentions](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPastAndCrossAttentions) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([ImageGPTConfig](/docs/transformers/main/pt/model_doc/imagegpt#transformers.ImageGPTConfig)) e das entradas.
O método forward do [ImageGPTModel](/docs/transformers/main/pt/model_doc/imagegpt#transformers.ImageGPTModel) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
Se `past_key_values` for usado, apenas o último hidden-state das sequências, com forma `(batch_size, 1, hidden_size)`, é retornado.
- **past_key_values** (`Cache`, *opcional*, retornado quando `use_cache=True` é passado ou quando `config.use_cache=True`) -- Trata-se de uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache). Para mais detalhes, consulte nosso [guia de cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e, opcionalmente, se `config.is_encoder_decoder=True`, nos blocos de atenção cruzada) que podem ser usados (veja a entrada `past_key_values`) para acelerar a decodificação sequencial.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` e `config.add_cross_attention=True` são passados, ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
Exemplos:
```python
>>> from transformers import AutoImageProcessor, ImageGPTModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTModel.from_pretrained("openai/imagegpt-small")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
```
## ImageGPTForCausalImageModeling[[transformers.ImageGPTForCausalImageModeling]]
#### transformers.ImageGPTForCausalImageModeling[[transformers.ImageGPTForCausalImageModeling]]
```python
transformers.ImageGPTForCausalImageModeling(config: ImageGPTConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L594)
**Parâmetros:**
config ([ImageGPTConfig](/docs/transformers/main/pt/model_doc/imagegpt#transformers.ImageGPTConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O transformer do modelo ImageGPT com uma cabeça de modelagem de linguagem no topo (camada linear com pesos vinculados aos embeddings de entrada).
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.ImageGPTForCausalImageModeling.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs: Any)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L605)
**Parâmetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, input_ids_length)`) : `input_ids_length` = `sequence_length` se `past_key_values` for `None`, caso contrário `past_key_values.get_seq_length()` (`sequence_length` dos estados de chave e valor passados de entrada). Índices dos tokens da sequência de entrada no vocabulário. Se `past_key_values` for usado, apenas os `input_ids` que ainda não têm seu passado calculado devem ser passados como `input_ids`. Os índices podem ser obtidos usando [AutoImageProcessor](/docs/transformers/main/pt/model_doc/auto#transformers.AutoImageProcessor). Consulte [ImageGPTImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para mais detalhes.
past_key_values (`~cache_utils.Cache`, *opcional*) : hidden-states pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nos `past_key_values` retornados pelo modelo em uma etapa anterior da decodificação, quando `use_cache=True` ou `config.use_cache=True`. Apenas uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache) é permitida como entrada, consulte nosso [guia de kv cache](https://huggingface.co/docs/transformers/en/kv_cache). Se nenhum `past_key_values` for passado, [DynamicCache](/docs/transformers/main/pt/internal/generation_utils#transformers.DynamicCache) será inicializado por padrão. O modelo sairá no mesmo formato de cache que foi fornecido como entrada. Se `past_key_values` forem usados, espera-se que o usuário insira apenas `input_ids` não processados (aqueles que não têm seus estados de chave e valor passados para este modelo) com a forma `(batch_size, unprocessed_length)` em vez de todos os `input_ids` com a forma `(batch_size, sequence_length)`.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em `[0, 1]`: - 0 corresponde a um token de *frase A*, - 1 corresponde a um token de *frase B*. [O que são IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
encoder_hidden_states (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Sequência de hidden-states na saída da última camada do encoder. Usada na cross-attention se o modelo estiver configurado como um decoder.
encoder_attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento da entrada do codificador. Essa máscara é usada na atenção cruzada se o modelo estiver configurado como um decodificador. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**.
labels (`torch.LongTensor` de forma `(batch_size, input_ids_length)`, *opcional*) : Rótulos para modelagem de linguagem. Observe que os rótulos **são deslocados** dentro do modelo, ou seja, você pode definir `labels = input_ids` Os índices são selecionados em `[-100, 0, ..., config.vocab_size]` Todos os rótulos definidos como `-100` são ignorados (mascarados); a perda é calculada apenas para rótulos em `[0, ..., config.vocab_size]`
use_cache (`bool`, *opcional*) : Se definido como `True`, os estados de chave-valor de `past_key_values` são retornados e podem ser usados para acelerar a decodificação (veja `past_key_values`).
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** [CausalLMOutputWithCrossAttentions](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) ou `tuple(torch.Tensor)`
Um [CausalLMOutputWithCrossAttentions](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([ImageGPTConfig](/docs/transformers/main/pt/model_doc/imagegpt#transformers.ImageGPTConfig)) e das entradas.
O método forward de [ImageGPTForCausalImageModeling](/docs/transformers/main/pt/model_doc/imagegpt#transformers.ImageGPTForCausalImageModeling) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de modelagem de linguagem (para previsão do próximo token).
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos das atenções cruzadas após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
- **past_key_values** (`Cache`, *opcional*, retornado quando `use_cache=True` é passado ou quando `config.use_cache=True`) -- Trata-se de uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache). Para mais detalhes, consulte nosso [guia de cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contém estados ocultos pré-computados (chaves e valores nos blocos de atenção) que podem ser usados (veja a entrada `past_key_values`) para acelerar a decodificação sequencial.
Exemplos:
```python
>>> from transformers import AutoImageProcessor, ImageGPTForCausalImageModeling
>>> import torch
>>> import matplotlib.pyplot as plt
>>> import numpy as np
>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTForCausalImageModeling.from_pretrained("openai/imagegpt-small")
>>> device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
>>> model.to(device)
>>> # unconditional generation of 8 images
>>> batch_size = 4
>>> context = torch.full((batch_size, 1), model.config.vocab_size - 1) # initialize with SOS token
>>> context = context.to(device)
>>> output = model.generate(
... input_ids=context, max_length=model.config.n_positions + 1, temperature=1.0, do_sample=True, top_k=40
... )
>>> clusters = image_processor.clusters
>>> height = image_processor.size["height"]
>>> width = image_processor.size["width"]
>>> samples = output[:, 1:].detach().cpu().numpy()
>>> samples_img = [
... np.reshape(np.rint(127.5 * (clusters[s] + 1.0)), [height, width, 3]).astype(np.uint8) for s in samples
... ] # convert color cluster tokens back to pixels
>>> f, axes = plt.subplots(1, batch_size, dpi=300)
>>> for img, ax in zip(samples_img, axes):
... ax.axis("off")
... ax.imshow(img)
```
## ImageGPTForImageClassification[[transformers.ImageGPTForImageClassification]]
#### transformers.ImageGPTForImageClassification[[transformers.ImageGPTForImageClassification]]
```python
transformers.ImageGPTForImageClassification(config: ImageGPTConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L723)
**Parâmetros:**
config ([ImageGPTConfig](/docs/transformers/main/pt/model_doc/imagegpt#transformers.ImageGPTConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo ImageGPT é um transformer com uma cabeça de classificação de imagem no topo (camada linear). O [ImageGPTForImageClassification](/docs/transformers/main/pt/model_doc/imagegpt#transformers.ImageGPTForImageClassification) aplica average pooling nos estados ocultos para realizar a classificação.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.ImageGPTForImageClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs: Any)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L733)
**Parâmetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, input_ids_length)`) : `input_ids_length` = `sequence_length` se `past_key_values` for `None`, caso contrário `past_key_values.get_seq_length()` (`sequence_length` dos estados de chave e valor passados de entrada). Índices dos tokens da sequência de entrada no vocabulário. Se `past_key_values` for usado, apenas os `input_ids` que ainda não têm seu passado calculado devem ser passados como `input_ids`. Os índices podem ser obtidos usando [AutoImageProcessor](/docs/transformers/main/pt/model_doc/auto#transformers.AutoImageProcessor). Consulte [ImageGPTImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para mais detalhes.
past_key_values (`~cache_utils.Cache`, *opcional*) : hidden-states pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nos `past_key_values` retornados pelo modelo em uma etapa anterior da decodificação, quando `use_cache=True` ou `config.use_cache=True`. Apenas uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache) é permitida como entrada, consulte nosso [guia de kv cache](https://huggingface.co/docs/transformers/en/kv_cache). Se nenhum `past_key_values` for passado, [DynamicCache](/docs/transformers/main/pt/internal/generation_utils#transformers.DynamicCache) será inicializado por padrão. O modelo sairá no mesmo formato de cache que foi fornecido como entrada. Se `past_key_values` forem usados, espera-se que o usuário insira apenas `input_ids` não processados (aqueles que não têm seus estados de chave e valor passados para este modelo) com a forma `(batch_size, unprocessed_length)` em vez de todos os `input_ids` com a forma `(batch_size, sequence_length)`.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em `[0, 1]`: - 0 corresponde a um token de *frase A*, - 1 corresponde a um token de *frase B*. [O que são IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para o cálculo da perda de classificação/regressão de sequência. Os índices devem estar em `[0, ..., config.num_labels - 1]`. Se `config.num_labels == 1`, uma perda de regressão é calculada (perda de erro quadrático médio). Se `config.num_labels > 1`, uma perda de classificação é calculada (entropia cruzada).
use_cache (`bool`, *opcional*) : Se definido como `True`, os estados de chave-valor de `past_key_values` são retornados e podem ser usados para acelerar a decodificação (veja `past_key_values`).
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** `SequenceClassifierOutputWithPast` ou `tuple(torch.Tensor)`
Um `SequenceClassifierOutputWithPast` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([ImageGPTConfig](/docs/transformers/main/pt/model_doc/imagegpt#transformers.ImageGPTConfig)) e das entradas.
O método forward de [ImageGPTForImageClassification](/docs/transformers/main/pt/model_doc/imagegpt#transformers.ImageGPTForImageClassification) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação (ou de regressão se config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).
- **past_key_values** (`Cache`, *opcional*, retornado quando `use_cache=True` é passado ou quando `config.use_cache=True`) -- Trata-se de uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache). Para mais detalhes, consulte nosso [guia de cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção) que podem ser usados (veja a entrada `past_key_values`) para acelerar a decodificação sequencial.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> from transformers import AutoImageProcessor, ImageGPTForImageClassification
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTForImageClassification.from_pretrained("openai/imagegpt-small")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> logits = outputs.logits
```