# InstructBLIP
## Visão geral
O modelo InstructBLIP foi proposto em [InstructBLIP: Towards General-purpose Vision-Language Models with Instruction Tuning](https://huggingface.co/papers/2305.06500) por Wenliang Dai, Junnan Li, Dongxu Li, Anthony Meng Huat Tiong, Junqi Zhao, Weisheng Wang, Boyang Li, Pascale Fung, Steven Hoi. O InstructBLIP utiliza a arquitetura [BLIP-2](blip-2) para ajuste de instruções visuais.
O resumo do artigo é o seguinte:
*Modelos de linguagem de uso geral, capazes de resolver diversas tarefas no domínio da linguagem, surgiram impulsionados pelo pipeline de pré-treino e ajuste por instrução. No entanto, construir modelos de visão-linguagem de uso geral é desafiador devido à maior discrepância de tarefas introduzida pela entrada visual adicional. Embora o pré-treino de visão-linguagem tenha sido amplamente estudado, o ajuste de visão-linguagem por instrução permanece relativamente menos explorado. Neste artigo, conduzimos um estudo sistemático e abrangente sobre o ajuste de visão-linguagem por instrução com base nos modelos BLIP-2 pré-treinados. Reunimos uma grande variedade de 26 conjuntos de dados publicamente disponíveis, os transformamos no formato de ajuste por instrução e os categorizamos em dois clusters para ajuste por instrução com dados retidos e avaliação zero-shot com dados retidos. Além disso, introduzimos a extração de recursos visuais consciente de instrução, um método crucial que permite ao modelo extrair recursos informativos adaptados à instrução fornecida. Os modelos InstructBLIP resultantes alcançam desempenho zero-shot de estado da arte em todos os 13 conjuntos de dados retidos, superando substancialmente o BLIP-2 e o Flamingo, que é maior. Nossos modelos também levam a um desempenho de estado da arte quando ajustados em tarefas downstream individuais (por exemplo, 90,7% de precisão no ScienceQA IMG). Além disso, demonstramos qualitativamente as vantagens do InstructBLIP em relação a modelos multimodais concorrentes.*
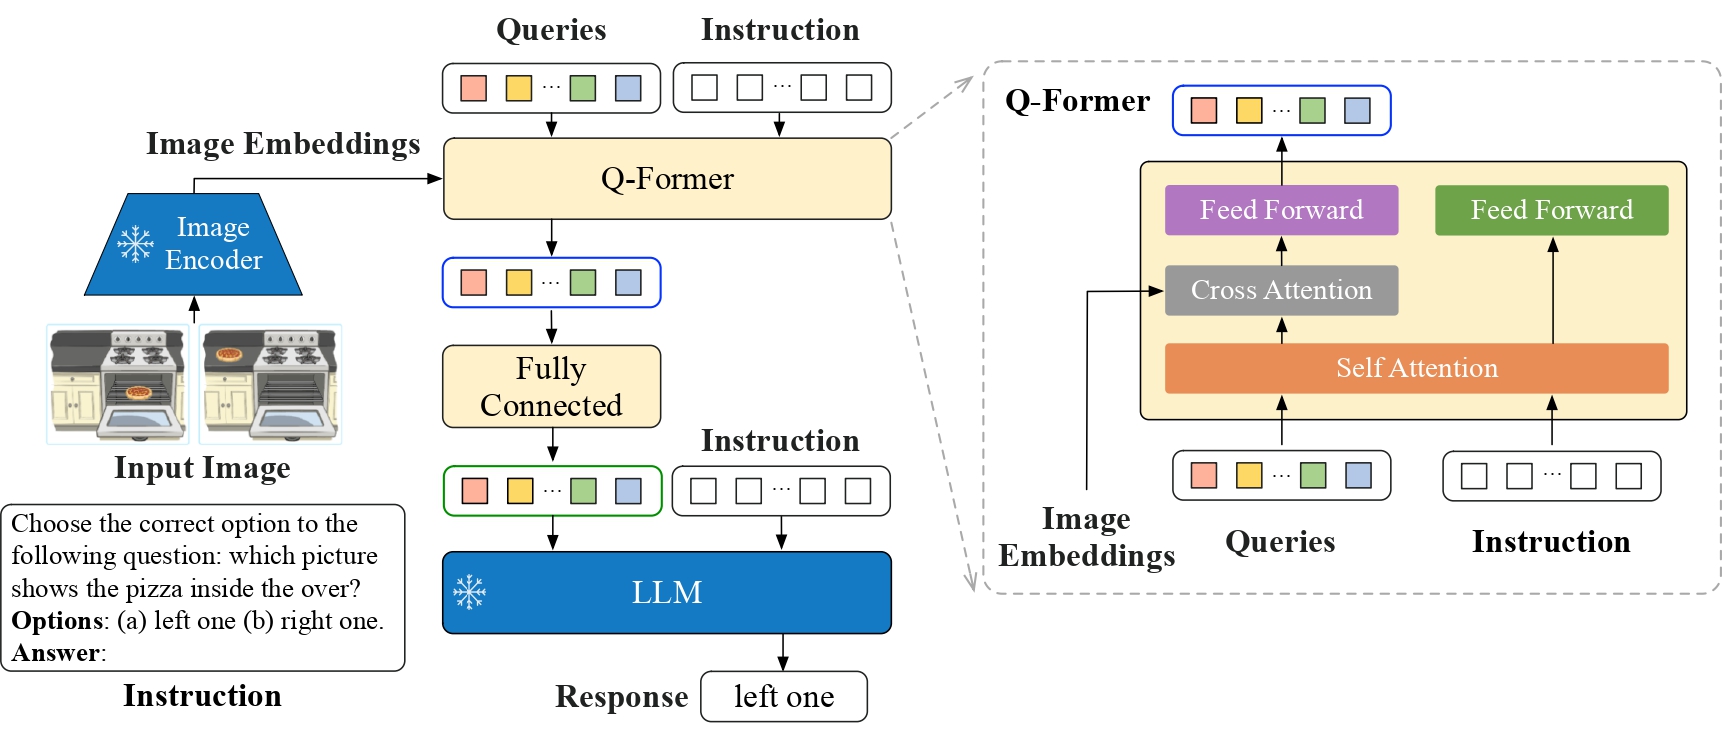 Arquitetura do InstructBLIP. Retirada do artigo original.
Este modelo foi contribuído por [nielsr](https://huggingface.co/nielsr). O código original pode ser encontrado [aqui](https://github.com/salesforce/LAVIS/tree/main/projects/instructblip).
## Dicas de uso
O InstructBLIP usa a mesma arquitetura do [BLIP-2](blip-2), com uma pequena, porém importante diferença: ele também fornece o prompt de texto (instrução) ao Q-Former.
> [!NOTE]
> Modelos BLIP após a versão v4.46 emitirão avisos sobre a adição de `processor.num_query_tokens = {{num_query_tokens}}` e a expansão da camada de embeddings do modelo para incluir o token especial ``. É fortemente recomendável adicionar os atributos ao processor se você for o proprietário do checkpoint do modelo, ou abrir um PR caso não seja. Adicionar esses atributos significa que o BLIP adicionará o número de query tokens necessários por imagem e expandirá o texto com tantos placeholders `` quanto houver query tokens. Geralmente, são cerca de 500 tokens por imagem, portanto, certifique-se de que o texto não seja truncado, pois caso contrário ocorrerá falha ao mesclar os embeddings.
Os atributos podem ser obtidos a partir da configuração do modelo, como `model.config.num_query_tokens`, e a expansão dos embeddings do modelo pode ser feita seguindo [este link](https://gist.github.com/zucchini-nlp/e9f20b054fa322f84ac9311d9ab67042).
## InstructBlipConfig[[transformers.InstructBlipConfig]]
#### transformers.InstructBlipConfig[[transformers.InstructBlipConfig]]
```python
transformers.InstructBlipConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, qformer_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_query_tokens: int = 32, image_token_index: int | None = None, initializer_factor: float = 1.0, initializer_range: float = 0.02)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblip/configuration_instructblip.py#L106)
**Parâmetros:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : O objeto de configuração ou dicionário do backbone de visão.
qformer_config (`dict`, *opcional*) : Dicionário de opções de configuração usadas para inicializar [InstructBlipQFormerConfig](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipQFormerConfig).
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : O objeto de configuração ou dicionário do backbone de texto.
num_query_tokens (`int`, *opcional*, padrão 32) : O número de tokens de consulta passados pelo Transformer.
image_token_index (`int`, *opcional*) : O índice do token de imagem usado como marcador de posição para as imagens de entrada.
initializer_factor (`float`, *opcional*, padrão `1.0`) : Um fator para inicializar todas as matrizes de pesos (deve ser mantido em 1, usado internamente para testes de inicialização).
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
Esta é a classe de configuração para armazenar a configuração de um InstructBlipModel. Ela é usada para instanciar um modelo Instructblip de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [Salesforce/instructblip-flan-t5-xl](https://huggingface.co/Salesforce/instructblip-flan-t5-xl)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import (
... InstructBlipVisionConfig,
... InstructBlipQFormerConfig,
... OPTConfig,
... InstructBlipConfig,
... InstructBlipForConditionalGeneration,
... )
>>> # Initializing a InstructBlipConfig with Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipConfig()
>>> # Initializing a InstructBlipForConditionalGeneration (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipForConditionalGeneration(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a InstructBlipConfig from a InstructBlipVisionConfig, InstructBlipQFormerConfig and any PreTrainedConfig
>>> # Initializing InstructBLIP vision, InstructBLIP Q-Former and language model configurations
>>> vision_config = InstructBlipVisionConfig()
>>> qformer_config = InstructBlipQFormerConfig()
>>> text_config = OPTConfig()
>>> config = InstructBlipConfig(vision_config=vision_config, qformer_config=qformer_config, text_config=text_config)
```
## InstructBlipVisionConfig[[transformers.InstructBlipVisionConfig]]
#### transformers.InstructBlipVisionConfig[[transformers.InstructBlipVisionConfig]]
```python
transformers.InstructBlipVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 1408, intermediate_size: int = 6144, num_hidden_layers: int = 39, num_attention_heads: int = 16, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 14, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06, attention_dropout: float | int = 0.0, initializer_range: float = 1e-10, qkv_bias: bool = True)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblip/configuration_instructblip.py#L29)
**Parâmetros:**
hidden_size (`int`, *opcional*, padrão `1408`) : Dimensão das representações ocultas.
intermediate_size (`int`, *opcional*, padrão `6144`) : Dimensão das representações do MLP.
num_hidden_layers (`int`, *opcional*, padrão `39`) : Número de camadas ocultas no decodificador do Transformer.
num_attention_heads (`int`, *opcional*, padrão `16`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `224`) : O tamanho (resolução) de cada imagem.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `14`) : O tamanho (resolução) de cada patch.
hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *opcional*, padrão `1e-06`) : O epsilon usado pelas camadas de normalização de camada.
attention_dropout (`Union[float, int]`, *opcional*, padrão `0.0`) : A taxa de dropout para as probabilidades de atenção.
initializer_range (`float`, *opcional*, padrão `1e-10`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
qkv_bias (`bool`, *opcional*, padrão `True`) : Se deve adicionar um viés às queries, keys e values.
Esta é a classe de configuração para armazenar a configuração de um InstructBlipModel. Ela é usada para instanciar um modelo Instructblip de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [Salesforce/instructblip-flan-t5-xl](https://huggingface.co/Salesforce/instructblip-flan-t5-xl)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import InstructBlipVisionConfig, InstructBlipVisionModel
>>> # Initializing a InstructBlipVisionConfig with Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipVisionConfig()
>>> # Initializing a InstructBlipVisionModel (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## InstructBlipQFormerConfig[[transformers.InstructBlipQFormerConfig]]
#### transformers.InstructBlipQFormerConfig[[transformers.InstructBlipQFormerConfig]]
```python
transformers.InstructBlipQFormerConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 512, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, cross_attention_frequency: int = 2, encoder_hidden_size: int = 1408)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblip/configuration_instructblip.py#L64)
**Parâmetros:**
vocab_size (`int`, *opcional*, padrão `30522`) : Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelos `input_ids`.
hidden_size (`int`, *opcional*, padrão `768`) : Dimensão das representações ocultas.
num_hidden_layers (`int`, *opcional*, padrão `12`) : Número de camadas ocultas no decodificador do Transformer.
num_attention_heads (`int`, *opcional*, padrão `12`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
intermediate_size (`int`, *opcional*, padrão `3072`) : Dimensão das representações do MLP.
hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.1`) : A probabilidade de dropout para todas as camadas totalmente conectadas nos embeddings, encoder e pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.1`) : A taxa de dropout para as probabilidades de atenção.
max_position_embeddings (`int`, *opcional*, padrão `512`) : O comprimento máximo de sequência com o qual este modelo pode ser utilizado.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
layer_norm_eps (`float`, *opcional*, padrão `1e-12`) : O epsilon usado pelas camadas de normalização de camada.
pad_token_id (`int`, *opcional*, padrão `0`) : ID do token usado para preenchimento no vocabulário.
cross_attention_frequency (`int`, *opcional*, padrão 2) : A frequência de adição de cross-attention às camadas do Transformer.
encoder_hidden_size (`int`, *opcional*, padrão 1408) : O tamanho oculto dos estados ocultos para a atenção cruzada.
Esta é a classe de configuração para armazenar a configuração de um InstructBlipModel. Ela é usada para instanciar um modelo Instructblip de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [Salesforce/instructblip-flan-t5-xl](https://huggingface.co/Salesforce/instructblip-flan-t5-xl)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplos:
```python
>>> from transformers import InstructBlipQFormerConfig, InstructBlipQFormerModel
>>> # Initializing a InstructBLIP Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipQFormerConfig()
>>> # Initializing a model (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipQFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## InstructBlipProcessor[[transformers.InstructBlipProcessor]]
#### transformers.InstructBlipProcessor[[transformers.InstructBlipProcessor]]
```python
transformers.InstructBlipProcessor(image_processor, tokenizer, qformer_tokenizer, num_query_tokens = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblip/processing_instructblip.py#L45)
**Parâmetros:**
image_processor (`BlipImageProcessor`) : O processador de imagem é uma entrada obrigatória.
tokenizer (`GPT2Tokenizer`) : O tokenizer é uma entrada obrigatória.
qformer_tokenizer (`AutoTokenizer`) : Uma instância de ['PreTrainedTokenizer`]. O tokenizador do Q-Former é uma entrada obrigatória.
num_query_tokens (`int`, *opcional*) : "Número de tokens usados pelo Qformer como consultas, deve ser o mesmo da configuração do modelo.
Constrói um InstructBlipProcessor que encapsula um processador de imagem, um tokenizer e um tokenizer do qformer em um único processador.
[InstructBlipProcessor](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipProcessor) oferece todas as funcionalidades de [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor), [GPT2Tokenizer](/docs/transformers/main/pt/model_doc/gpt2#transformers.GPT2Tokenizer) e `{qformer_tokenizer_class}`. Consulte [~BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor), [~GPT2Tokenizer](/docs/transformers/main/pt/model_doc/gpt2#transformers.GPT2Tokenizer) e `~{qformer_tokenizer_class}` para mais informações.
#### __call__[[transformers.InstructBlipProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblip/processing_instructblip.py#L63)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opcional*) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *opcional*) : A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se você passar uma entrada pretokenizada, defina `is_split_into_words=True` para evitar ambiguidade com entradas em lote.
return_tensors (`str` ou [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *opcional*) : Se definido, retornará tensores de um framework específico. Os valores aceitos são: - `'pt'`: Retorna objetos `torch.Tensor` do PyTorch. - `'np'`: Retorna objetos `np.ndarray` do NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/pt/main_classes/processors#transformers.ProcessingKwargs), *opcional*) : Opções de processamento adicionais para cada modalidade (texto, imagens, vídeos, áudio). Os parâmetros específicos do modelo estão listados acima; consulte a classe TypedDict para a lista completa de argumentos suportados.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
## InstructBlipVisionModel[[transformers.InstructBlipVisionModel]]
#### transformers.InstructBlipVisionModel[[transformers.InstructBlipVisionModel]]
```python
transformers.InstructBlipVisionModel(config: InstructBlipVisionConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblip/modeling_instructblip.py#L392)
#### forward[[transformers.InstructBlipVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblip/modeling_instructblip.py#L412)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor). Veja [BlipImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([InstructBlipProcessor](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipProcessor) usa [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor) para processar imagens).
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([InstructBlipConfig](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipConfig)) e das entradas.
O método forward do [InstructBlipVisionModel](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipVisionModel) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
## InstructBlipQFormerModel[[transformers.InstructBlipQFormerModel]]
#### transformers.InstructBlipQFormerModel[[transformers.InstructBlipQFormerModel]]
```python
transformers.InstructBlipQFormerModel(config: InstructBlipQFormerConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblip/modeling_instructblip.py#L760)
Querying Transformer (Q-Former), usado no InstructBLIP. Levemente modificado em relação ao BLIP-2, pois também recebe a instrução como entrada.
#### forward[[transformers.InstructBlipQFormerModel.forward]]
```python
forward(input_ids: LongTensor, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, query_embeds: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblip/modeling_instructblip.py#L799)
**Parâmetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
position_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
query_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) : Estados ocultos a serem usados no cálculo de atenção. Em caso de cross-attention, serão usados como query (ou seja, key e value usarão encoder_hidden_states).
encoder_hidden_states (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Sequência de hidden-states na saída da última camada do encoder. Usada na cross-attention se o modelo estiver configurado como um decoder.
encoder_attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento da entrada do codificador. Essa máscara é usada na atenção cruzada se o modelo estiver configurado como um decodificador. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**.
**Retorna:** [BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([InstructBlipConfig](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipConfig)) e das entradas.
O método forward do [InstructBlipQFormerModel](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipQFormerModel) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` e `config.add_cross_attention=True` são passados, ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
- **past_key_values** (`Cache`, *opcional*, retornado quando `use_cache=True` é passado ou quando `config.use_cache=True`) -- Trata-se de uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache). Para mais detalhes, consulte nosso [guia de cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e, opcionalmente, se `config.is_encoder_decoder=True`, nos blocos de atenção cruzada) que podem ser usados (veja a entrada `past_key_values`) para acelerar a decodificação sequencial.
## InstructBlipModel[[transformers.InstructBlipModel]]
#### transformers.InstructBlipModel[[transformers.InstructBlipModel]]
```python
transformers.InstructBlipModel(config: InstructBlipConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblip/modeling_instructblip.py#L867)
**Parâmetros:**
config ([InstructBlipConfig](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo base do InstructBLIP, composto por um modelo de linguagem, um qformer e um codificador de visão.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.InstructBlipModel.forward]]
```python
forward(pixel_values: Tensor, qformer_input_ids: Tensor, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblip/modeling_instructblip.py#L919)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor). Veja [BlipImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([InstructBlipProcessor](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipProcessor) usa [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor) para processar imagens).
qformer_input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário do Q-Former. Os tokens de entrada podem ser fornecidos opcionalmente para servir como prompt de texto, que o modelo Q-Former codificará. Os índices podem ser obtidos usando [InstructBlipProcessor](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipProcessor). Veja [InstructBlipProcessor.__call__()](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipProcessor.__call__) para detalhes. [O que são IDs de entrada?](../glossary#input-ids)
qformer_attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada do decodificador no vocabulário. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada do decodificador?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Comportamento padrão: gerar um tensor que ignora tokens de preenchimento em `decoder_input_ids`. A máscara causal também será usada por padrão. Relevante apenas quando um modelo de linguagem encoder-decoder (como T5) é utilizado.
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** `InstructBlipForConditionalGenerationModelOutput` ou `tuple(torch.Tensor)`
Um `InstructBlipForConditionalGenerationModelOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([InstructBlipConfig](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipConfig)) e das entradas.
O método forward do [InstructBlipModel](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipModel) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor`, *opcional*, retornado quando `labels` é fornecido, `torch.Tensor` de forma `(1,)`) -- Perda de modelagem de linguagem do modelo de linguagem.
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Pontuações de predição da cabeça de modelagem de linguagem do modelo de linguagem.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- Saídas do codificador de visão.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *opcional*) -- Saídas do Q-Former (Querying Transformer).
- **language_model_outputs** (`CausalLMOutputWithPast` ou `Seq2SeqLMOutput`) -- Saídas do modelo de linguagem.
#### get_placeholder_mask[[transformers.InstructBlipModel.get_placeholder_mask]]
```python
get_placeholder_mask(input_ids: LongTensor, inputs_embeds: Tensor)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblip/modeling_instructblip.py#L904)
Obtém a máscara de placeholder multimodal a partir de `input_ids` ou `inputs_embeds`.
## InstructBlipForConditionalGeneration[[transformers.InstructBlipForConditionalGeneration]]
#### transformers.InstructBlipForConditionalGeneration[[transformers.InstructBlipForConditionalGeneration]]
```python
transformers.InstructBlipForConditionalGeneration(config: InstructBlipConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblip/modeling_instructblip.py#L1028)
**Parâmetros:**
config ([InstructBlipConfig](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo InstructBLIP para gerar texto a partir de uma imagem e um prompt de texto opcional. O modelo consiste em um codificador de visão, um Querying Transformer (Q-Former) e um modelo de linguagem.
É possível, opcionalmente, passar `input_ids` para o modelo, que funcionam como um prompt de texto, para que o modelo de linguagem continue o prompt. Caso contrário, o modelo de linguagem inicia a geração de texto a partir do token [BOS] (início da sequência).
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.InstructBlipForConditionalGeneration.forward]]
```python
forward(pixel_values: Tensor, qformer_input_ids: Tensor, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblip/modeling_instructblip.py#L1174)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor). Veja [BlipImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([InstructBlipProcessor](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipProcessor) usa [BlipImageProcessor](/docs/transformers/main/pt/model_doc/blip#transformers.BlipImageProcessor) para processar imagens).
qformer_input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário do Q-Former. Os tokens de entrada podem ser fornecidos opcionalmente para servir como prompt de texto, que o modelo Q-Former codificará. Os índices podem ser obtidos usando [InstructBlipProcessor](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipProcessor). Veja [InstructBlipProcessor.__call__()](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipProcessor.__call__) para detalhes. [O que são IDs de entrada?](../glossary#input-ids)
qformer_attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada do decodificador no vocabulário. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada do decodificador?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Comportamento padrão: gerar um tensor que ignora tokens de preenchimento em `decoder_input_ids`. A máscara causal também será usada por padrão. Relevante apenas quando um modelo de linguagem encoder-decoder (como T5) é utilizado.
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para o cálculo da perda de modelagem de linguagem. Os índices devem estar em `[-100, 0, ..., config.vocab_size - 1]`. Todos os rótulos definidos como `-100` são ignorados (mascarados); a perda é calculada apenas para rótulos em `[0, ..., config.vocab_size]`
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *opcional*) : Dicionário em que as chaves são as modalidades suportadas e os valores são as saídas codificadas para essa modalidade. Cada saída codificada é uma tupla que consiste em (`pooler_output`, *opcional*: `last_hidden_states`, *opcional*: `hidden_states`, *opcional*: `attentions`) `pooler_output` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) é uma sequência de recursos multimodais do codificador mesclados em incorporações de texto.
**Retorna:** `InstructBlipForConditionalGenerationModelOutput` ou `tuple(torch.Tensor)`
Um `InstructBlipForConditionalGenerationModelOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([InstructBlipConfig](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipConfig)) e das entradas.
O método forward de [InstructBlipForConditionalGeneration](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipForConditionalGeneration) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor`, *opcional*, retornado quando `labels` é fornecido, `torch.Tensor` de forma `(1,)`) -- Perda de modelagem de linguagem do modelo de linguagem.
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Pontuações de predição da cabeça de modelagem de linguagem do modelo de linguagem.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- Saídas do codificador de visão.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *opcional*) -- Saídas do Q-Former (Querying Transformer).
- **language_model_outputs** (`CausalLMOutputWithPast` ou `Seq2SeqLMOutput`) -- Saídas do modelo de linguagem.
Exemplos:
```python
>>> from transformers import InstructBlipProcessor, InstructBlipForConditionalGeneration
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> model = InstructBlipForConditionalGeneration.from_pretrained("Salesforce/instructblip-vicuna-7b")
>>> processor = InstructBlipProcessor.from_pretrained("Salesforce/instructblip-vicuna-7b")
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> model.to(device)
>>> url = "https://huggingface.co/datasets/hf-internal-testing/transformers-synthetic-assets/resolve/main/images/lavis_confusing_pictures.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> prompt = "What is unusual about this image?"
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device)
>>> outputs = model.generate(
... **inputs,
... do_sample=False,
... num_beams=5,
... max_length=256,
... min_length=1,
... top_p=0.9,
... repetition_penalty=1.5,
... length_penalty=1.0,
... temperature=1,
... )
>>> generated_text = processor.batch_decode(outputs, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
The unusual aspect of this image is that a man is ironing clothes on the back of a yellow SUV, which is parked in the middle of a busy city street. This is an unconventional approach to ironing clothes, as it requires the man to balance himself and his ironing equipment on top of the vehicle while navigating through traffic. Additionally, the presence of taxis and other vehicles in the scene further emphasizes the unusual nature of this situation.
```
#### generate[[transformers.InstructBlipForConditionalGeneration.generate]]
```python
generate(pixel_values: Tensor, qformer_input_ids: typing.Optional[torch.LongTensor] = None, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **generate_kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblip/modeling_instructblip.py#L1313)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma (batch_size, num_channels, height, width)) : Imagens de entrada a serem processadas.
qformer_input_ids (`torch.LongTensor` de forma (batch_size, sequence_length), *opcional*) : A sequência usada como prompt para ser fornecida ao módulo Q-Former.
qformer_attention_mask (`torch.LongTensor` de forma (batch_size, sequence_length), *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento.
input_ids (`torch.LongTensor` de forma (batch_size, sequence_length), *opcional*) : A sequência usada como prompt para a geração.
attention_mask (`torch.LongTensor` de forma (batch_size, sequence_length), *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento.
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) : Representação embutida das entradas. Deve ser float, não tokens int.
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar a codificação posicional dos embeddings de imagem.
**Retorna:** `captions (list)`
Uma lista de strings de comprimento batch_size * num_captions.
Substitui a função `generate` para permitir o uso do modelo como um gerador condicional.
#### get_image_features[[transformers.InstructBlipForConditionalGeneration.get_image_features]]
```python
get_image_features(pixel_values: Tensor, qformer_input_ids: LongTensor, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool | None = False, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblip/modeling_instructblip.py#L1091)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada.
qformer_input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário do Q-Former. Os tokens de entrada podem ser fornecidos opcionalmente para servir como prompt de texto, que o modelo Q-Former codificará. Os índices podem ser obtidos usando [InstructBlipProcessor](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipProcessor). Veja [InstructBlipProcessor.__call__()](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipProcessor.__call__) para detalhes. [O que são IDs de entrada?](../glossary#input-ids)
qformer_attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** `BaseModelOutputWithVisionQformerOutputs` ou `tuple(torch.Tensor)`
Um `BaseModelOutputWithVisionQformerOutputs` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([InstructBlipConfig](/docs/transformers/main/pt/model_doc/instructblip#transformers.InstructBlipConfig)) e das entradas.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- Saídas do codificador de visão.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *opcional*) -- Saídas do Q-Former (Querying Transformer).
Exemplo:
```python
>>> from PIL import Image
>>> from transformers import AutoProcessor, InstructBlipForConditionalGeneration
>>> model = InstructBlipForConditionalGeneration.from_pretrained("Salesforce/instructblip-flan-t5-xl")
>>> processor = AutoProcessor.from_pretrained("Salesforce/instructblip-flan-t5-xl")
>>> messages = [
... {
... "role": "user", "content": [
... {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
... {"type": "text", "text": "Where is the cat standing?"},
... ]
... },
... ]
>>> inputs = processor.apply_chat_template(
... messages,
... tokenize=True,
... return_dict=True,
... return_tensors="pt",
... add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
```