# LeViT
## Visão geral
O modelo LeViT foi proposto em [LeViT: Introducing Convolutions to Vision Transformers](https://huggingface.co/papers/2104.01136) por Ben Graham, Alaaeldin El-Nouby, Hugo Touvron, Pierre Stock, Armand Joulin, Hervé Jégou e Matthijs Douze. O LeViT melhora o desempenho e a eficiência do [Vision Transformer (ViT)](vit) por meio de algumas diferenças arquitetônicas, como mapas de ativação com resoluções decrescentes nos Transformers e a introdução de um viés de atenção para integrar informações posicionais.
O resumo do artigo é o seguinte:
*Projetamos uma família de arquiteturas de classificação de imagens que otimiza o equilíbrio entre precisão e eficiência em um regime de alta velocidade. Nosso trabalho explora descobertas recentes em arquiteturas baseadas em atenção, que são competitivas em hardware de processamento altamente paralelo. Revisitamos princípios da extensa literatura sobre redes neurais convolucionais para aplicá-los a transformers, em particular mapas de ativação com resoluções decrescentes. Também introduzimos o viés de atenção, uma nova maneira de integrar informações posicionais em transformers de visão. Como resultado, propomos o LeVIT: uma rede neural híbrida para classificação de imagens com inferência rápida. Consideramos diferentes medidas de eficiência em diferentes plataformas de hardware, a fim de refletir da melhor forma uma ampla gama de cenários de aplicação. Nossos extensos experimentos validam empiricamente nossas escolhas técnicas e mostram que são adequadas para a maioria das arquiteturas. No geral, o LeViT supera significativamente as convnets e os transformers de visão existentes em relação ao compromisso entre velocidade e precisão. Por exemplo, com 80% de precisão top-1 no ImageNet, o LeViT é 5 vezes mais rápido que o EfficientNet em CPU.*
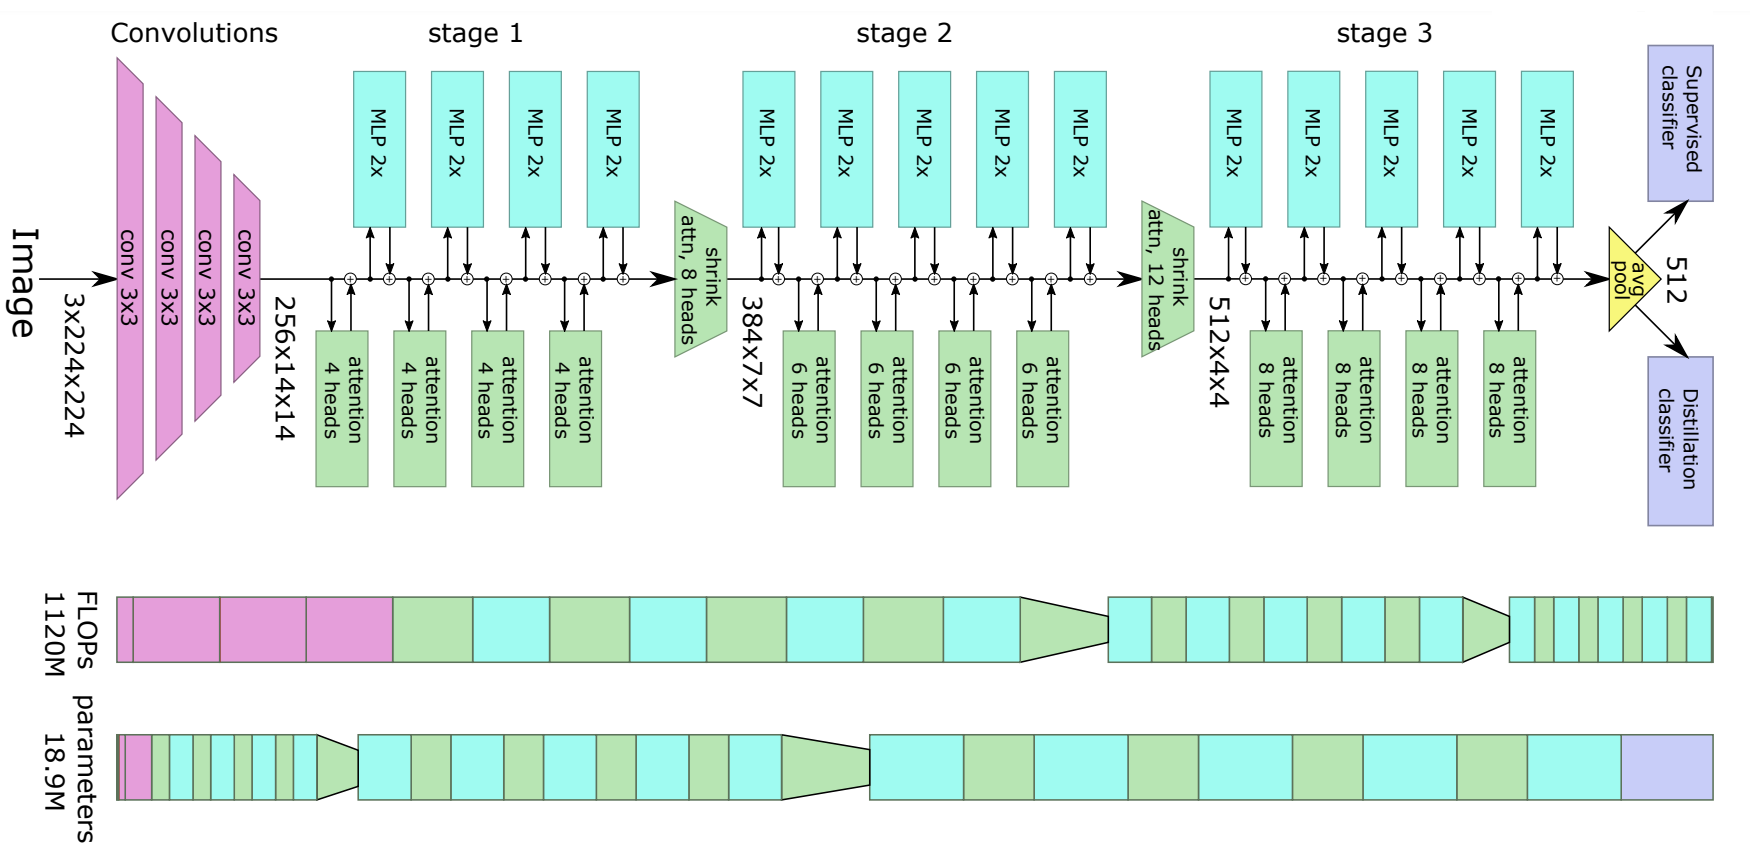 Arquitetura LeViT. Retirada do artigo original.
Este modelo foi contribuído por [anugunj](https://huggingface.co/anugunj). O código original pode ser encontrado [aqui](https://github.com/facebookresearch/LeViT).
## Dicas de uso
- Em comparação com o ViT, os modelos LeViT utilizam uma cabeça de destilação adicional para aprender de forma eficaz com um modelo professor (que, no artigo do LeViT, é um modelo semelhante a um ResNet). A cabeça de destilação é aprendida por retropropagação sob a supervisão de um modelo semelhante a um ResNet. Eles também se inspiram em redes neurais convolucionais para usar mapas de ativação com resoluções decrescentes, a fim de aumentar a eficiência.
- Existem 2 maneiras de fazer o fine-tuning de modelos destilados: (1) de forma clássica, colocando apenas um head de previsão sobre o estado oculto final e sem usar o head de destilação, ou (2) colocando tanto um head de previsão quanto um head de destilação sobre o estado oculto final. Nesse caso, o head de previsão é treinado usando a entropia cruzada regular entre a previsão do head e o rótulo verdadeiro (ground-truth), enquanto o head de previsão de destilação é treinado usando destilação dura (entropia cruzada entre a previsão do head de destilação e o rótulo previsto pelo teacher). No momento da inferência, adota-se a previsão média entre os dois heads como previsão final. A opção (2) também é chamada de "fine-tuning com destilação", pois depende de um teacher que já foi fine-tuned no dataset de downstream. Em termos de modelos, (1) corresponde a [LevitForImageClassification](/docs/transformers/main/pt/model_doc/levit#transformers.LevitForImageClassification) e (2) corresponde a [LevitForImageClassificationWithTeacher](/docs/transformers/main/pt/model_doc/levit#transformers.LevitForImageClassificationWithTeacher).
- Todos os checkpoints liberados foram pré-treinados e ajustados exclusivamente no [ImageNet-1k](https://huggingface.co/datasets/ILSVRC/imagenet-1k) (também conhecido como ILSVRC 2012, uma coleção de 1,3 milhão de imagens e 1.000 classes). Nenhum dado externo foi utilizado. Isso difere do modelo ViT original, que utilizou dados externos, como o conjunto de dados JFT-300M/Imagenet-21k, para o pré-treinamento.
- Os autores do LeViT publicaram 5 modelos LeViT treinados, que podem ser plugados diretamente em [LevitModel](/docs/transformers/main/pt/model_doc/levit#transformers.LevitModel) ou [LevitForImageClassification](/docs/transformers/main/pt/model_doc/levit#transformers.LevitForImageClassification). Técnicas como aumento de dados, otimização e regularização foram utilizadas para simular o treinamento em um conjunto de dados muito maior (enquanto apenas o ImageNet-1k era usado para pré-treinamento). As 5 variantes disponíveis são (todas treinadas em imagens de tamanho 224x224): *facebook/levit-128S*, *facebook/levit-128*, *facebook/levit-192*, *facebook/levit-256* e *facebook/levit-384*. Observe que deve-se usar [LevitImageProcessor](/docs/transformers/main/pt/model_doc/levit#transformers.LevitImageProcessor) para preparar as imagens para o modelo.
- [LevitForImageClassificationWithTeacher](/docs/transformers/main/pt/model_doc/levit#transformers.LevitForImageClassificationWithTeacher) atualmente suporta apenas inferência, não treinamento ou ajuste fino.
- Você pode conferir notebooks de demonstração sobre inferência e também ajuste fino em dados personalizados [aqui](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/VisionTransformer) (basta substituir [ViTImageProcessor](/docs/transformers/main/pt/model_doc/vit#transformers.ViTImageProcessor) por [LevitImageProcessor](/docs/transformers/main/pt/model_doc/levit#transformers.LevitImageProcessor) e [ViTForImageClassification](/docs/transformers/main/pt/model_doc/vit#transformers.ViTForImageClassification) por [LevitForImageClassification](/docs/transformers/main/pt/model_doc/levit#transformers.LevitForImageClassification) ou [LevitForImageClassificationWithTeacher](/docs/transformers/main/pt/model_doc/levit#transformers.LevitForImageClassificationWithTeacher)).
## Recursos
Uma lista de recursos oficiais da Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o LeViT.
- [LevitForImageClassification](/docs/transformers/main/pt/model_doc/levit#transformers.LevitForImageClassification) é suportado por este [notebook](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb).
- Veja também: [Guia da tarefa de classificação de imagens](../tasks/image_classification)
Se você tiver interesse em enviar um recurso para ser incluído aqui, sinta-se à vontade para abrir um Pull Request e faremos a revisão! O recurso deve, idealmente, demonstrar algo novo, em vez de duplicar um recurso existente.
## LevitConfig[[transformers.LevitConfig]]
#### transformers.LevitConfig[[transformers.LevitConfig]]
```python
transformers.LevitConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, image_size: int | list[int] | tuple[int, int] = 224, num_channels: int = 3, kernel_size: int = 3, stride: int = 2, padding: int = 1, patch_size: int | list[int] | tuple[int, int] = 16, hidden_sizes: list[int] | tuple[int, ...] = (128, 256, 384), num_attention_heads: list[int] | tuple[int, ...] = (4, 8, 12), depths: list[int] | tuple[int, ...] = (4, 4, 4), key_dim: list[int] | tuple[int, ...] = (16, 16, 16), drop_path_rate: int = 0, mlp_ratio: list[int] | tuple[int, ...] = (2, 2, 2), attention_ratio: list[int] | tuple[int, ...] = (2, 2, 2), initializer_range: float = 0.02)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/configuration_levit.py#L24)
**Parâmetros:**
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `224`) : O tamanho (resolução) de cada imagem.
num_channels (`int`, *opcional*, padrão `3`) : O número de canais de entrada.
kernel_size (`int`, *opcional*, padrão `3`) : O tamanho do kernel de convolução.
stride (`int`, *opcional*, padrão 2) : O tamanho do stride para as camadas de convolução iniciais do patch embedding.
padding (`int`, *opcional*, padrão 1) : O tamanho do padding para as camadas de convolução iniciais do patch embedding.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `16`) : O tamanho (resolução) de cada patch.
hidden_sizes (`Union[list[int], tuple[int, ...]]`, *opcional*, padrão `(128, 256, 384)`) : Dimensionalidade (tamanho oculto) em cada etapa do modelo.
num_attention_heads (`Union[list[int], tuple[int, ...]]`, *opcional*, padrão `(4, 8, 12)`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
depths (`Union[list[int], tuple[int, ...]]`, *opcional*, padrão `(4, 4, 4)`) : Profundidade de cada camada no Transformer.
key_dim (`list[int]`, *opcional*, padrão `[16, 16, 16]`) : O tamanho da chave em cada um dos blocos do codificador.
drop_path_rate (`int`, *opcional*, padrão `0`) : Taxa de drop path para a fusão de patches.
mlp_ratio (`Union[list[int], tuple[int, ...]]`, *opcional*, padrão `(2, 2, 2)`) : Razão entre a dimensão oculta do MLP e a dimensão de incorporação.
attention_ratio (`list[int]`, *opcional*, padrão `[2, 2, 2]`) : Razão entre o tamanho da dimensão de saída e a dimensão de entrada das camadas de atenção.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
Esta é a classe de configuração para armazenar a configuração de um LevitModel. Ela é usada para instanciar um modelo Levit de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [facebook/levit-128S](https://huggingface.co/facebook/levit-128S)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import LevitConfig, LevitModel
>>> # Initializing a LeViT levit-128S style configuration
>>> configuration = LevitConfig()
>>> # Initializing a model (with random weights) from the levit-128S style configuration
>>> model = LevitModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## LevitImageProcessor[[transformers.LevitImageProcessor]]
#### transformers.LevitImageProcessor[[transformers.LevitImageProcessor]]
```python
transformers.LevitImageProcessor(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/image_processing_levit.py#L33)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*, padrão `None`) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'shortest_edge' : 224}`): Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 224, 'width': 224}`): Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `3`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.485, 0.456, 0.406]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.229, 0.224, 0.225]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve aplicar um recorte centralizado na imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
Constrói um processador de imagens LevitImageProcessor.
#### preprocess[[transformers.LevitImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Sinalizador do desenvolvedor para entradas adicionais semelhantes a imagens que também serão pré-processadas. Use isso apenas se a passagem das entradas como kwarg não funcionar. Por exemplo, `preprocess(images, masks=masks)` é a opção preferida, mas resulta em problemas de prioridade de argumentos para alguns modelos. Nesses casos, `preprocess(images, image_like_inputs={"masks": masks})` pode ser usado em vez disso.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
Pré-processa uma imagem ou um lote de imagens.
## LevitImageProcessorPil[[transformers.LevitImageProcessorPil]]
#### transformers.LevitImageProcessorPil[[transformers.LevitImageProcessorPil]]
```python
transformers.LevitImageProcessorPil(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/image_processing_pil_levit.py#L32)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*, padrão `None`) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'shortest_edge' : 224}`): Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 224, 'width': 224}`): Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `3`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.485, 0.456, 0.406]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.229, 0.224, 0.225]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve aplicar um recorte centralizado na imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
Constrói um processador de imagens LevitImageProcessor.
#### preprocess[[transformers.LevitImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Sinalizador do desenvolvedor para entradas adicionais semelhantes a imagens que também serão pré-processadas. Use isso apenas se a passagem das entradas como kwarg não funcionar. Por exemplo, `preprocess(images, masks=masks)` é a opção preferida, mas resulta em problemas de prioridade de argumentos para alguns modelos. Nesses casos, `preprocess(images, image_like_inputs={"masks": masks})` pode ser usado em vez disso.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
Pré-processa uma imagem ou um lote de imagens.
## LevitModel[[transformers.LevitModel]]
#### transformers.LevitModel[[transformers.LevitModel]]
```python
transformers.LevitModel(config: LevitConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L489)
**Parâmetros:**
config ([LevitConfig](/docs/transformers/main/pt/model_doc/levit#transformers.LevitConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Levit básico, que produz estados ocultos brutos sem nenhum cabeçalho específico no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.LevitModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L498)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [LevitImageProcessor](/docs/transformers/main/pt/model_doc/levit#transformers.LevitImageProcessor). Veja [LevitImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes (`processor_class` usa [LevitImageProcessor](/docs/transformers/main/pt/model_doc/levit#transformers.LevitImageProcessor) para processar imagens).
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** `BaseModelOutputWithPoolingAndNoAttention` ou `tuple(torch.Tensor)`
Um `BaseModelOutputWithPoolingAndNoAttention` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([LevitConfig](/docs/transformers/main/pt/model_doc/levit#transformers.LevitConfig)) e das entradas.
O método forward do [LevitModel](/docs/transformers/main/pt/model_doc/levit#transformers.LevitModel) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, num_channels, height, width)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada após uma operação de pooling nas dimensões espaciais.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, num_channels, height, width)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
Exemplo:
```python
```
## LevitForImageClassification[[transformers.LevitForImageClassification]]
#### transformers.LevitForImageClassification[[transformers.LevitForImageClassification]]
```python
transformers.LevitForImageClassification(config: LevitConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L542)
**Parâmetros:**
config ([LevitConfig](/docs/transformers/main/pt/model_doc/levit#transformers.LevitConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo Levit com uma cabeça de classificação de imagem no topo (uma camada linear sobre os recursos agregados), por exemplo, para o ImageNet.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.LevitForImageClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L559)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [LevitImageProcessor](/docs/transformers/main/pt/model_doc/levit#transformers.LevitImageProcessor). Veja [LevitImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes (`processor_class` usa [LevitImageProcessor](/docs/transformers/main/pt/model_doc/levit#transformers.LevitImageProcessor) para processar imagens).
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para o cálculo da perda de classificação/regressão de imagem. Os índices devem estar em `[0, ..., config.num_labels - 1]`. Se `config.num_labels == 1`, uma perda de regressão é calculada (perda de erro quadrático médio). Se `config.num_labels > 1`, uma perda de classificação é calculada (entropia cruzada).
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** [ImageClassifierOutputWithNoAttention](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) ou `tuple(torch.Tensor)`
Um [ImageClassifierOutputWithNoAttention](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([LevitConfig](/docs/transformers/main/pt/model_doc/levit#transformers.LevitConfig)) e das entradas.
O método forward de [LevitForImageClassification](/docs/transformers/main/pt/model_doc/levit#transformers.LevitForImageClassification) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação (ou de regressão se config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada estágio) de forma `(batch_size, num_channels, height, width)`. Estados ocultos (também chamados de mapas de características) do modelo na saída de cada estágio.
Exemplo:
```python
>>> from transformers import AutoImageProcessor, LevitForImageClassification
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/levit-128S")
>>> model = LevitForImageClassification.from_pretrained("facebook/levit-128S")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```
## LevitForImageClassificationWithTeacher[[transformers.LevitForImageClassificationWithTeacher]]
#### transformers.LevitForImageClassificationWithTeacher[[transformers.LevitForImageClassificationWithTeacher]]
```python
transformers.LevitForImageClassificationWithTeacher(config: LevitConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L599)
**Parâmetros:**
config ([LevitConfig](/docs/transformers/main/pt/model_doc/levit#transformers.LevitConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo LeViT com cabeças de classificação de imagem no topo (uma camada linear no topo do estado oculto final e uma camada linear no topo do estado oculto final do token de destilação), por exemplo, para ImageNet. .. warning:: Este modelo suporta apenas inferência. O ajuste fino com destilação (ou seja, com um professor) ainda não é suportado.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.LevitForImageClassificationWithTeacher.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L621)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [LevitImageProcessor](/docs/transformers/main/pt/model_doc/levit#transformers.LevitImageProcessor). Veja [LevitImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes (`processor_class` usa [LevitImageProcessor](/docs/transformers/main/pt/model_doc/levit#transformers.LevitImageProcessor) para processar imagens).
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** `LevitForImageClassificationWithTeacherOutput` ou `tuple(torch.Tensor)`
Um `LevitForImageClassificationWithTeacherOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([LevitConfig](/docs/transformers/main/pt/model_doc/levit#transformers.LevitConfig)) e das entradas.
O método forward de [LevitForImageClassificationWithTeacher](/docs/transformers/main/pt/model_doc/levit#transformers.LevitForImageClassificationWithTeacher) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Pontuações de previsão como a média dos `cls_logits` e `distillation_logits`.
- **cls_logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Pontuações de previsão da cabeça de classificação (ou seja, a camada linear no topo do estado oculto final do token de classe).
- **distillation_logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Pontuações de previsão da cabeça de destilação (ou seja, a camada linear no topo do estado oculto final do token de destilação).
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
Exemplo:
```python
>>> from transformers import AutoImageProcessor, LevitForImageClassificationWithTeacher
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/levit-128S")
>>> model = LevitForImageClassificationWithTeacher.from_pretrained("facebook/levit-128S")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```