# LLaVa
## Visão geral
LLaVa é um chatbot de código aberto treinado por ajuste fino de LlamA/Vicuna em dados de instrução multimodal gerados por GPT. Trata-se de um modelo de linguagem autoregressivo, baseado na arquitetura transformer. Em outras palavras, é uma versão multimodal de LLMs ajustada para chat/instruções.
O modelo LLaVa foi proposto em [Visual Instruction Tuning](https://huggingface.co/papers/2304.08485) e aprimorado em [Improved Baselines with Visual Instruction Tuning](https://huggingface.co/papers/2310.03744) por Haotian Liu, Chunyuan Li, Yuheng Li e Yong Jae Lee.
O resumo do artigo é o seguinte:
*Os grandes modelos multimodais (LMM) demonstraram recentemente um progresso promissor com o ajuste de instruções visuais. Nesta nota, mostramos que o conector intermodal de visão-linguagem totalmente conectado no LLaVA é surpreendentemente poderoso e eficiente em dados. Com modificações simples no LLaVA, a saber, o uso de CLIP-ViT-L-336px com uma projeção MLP e a adição de dados de VQA orientados para tarefas acadêmicas com prompts simples de formatação de resposta, estabelecemos baselines mais fortes que alcançam o estado da arte em 11 benchmarks. Nosso checkpoint final de 13B usa apenas 1,2M de dados publicamente disponíveis e conclui o treinamento completo em ∼1 dia em um único nó com 8-A100. Esperamos que isso torne a pesquisa de LMM no estado da arte mais acessível. O código e o modelo estarão publicamente disponíveis*
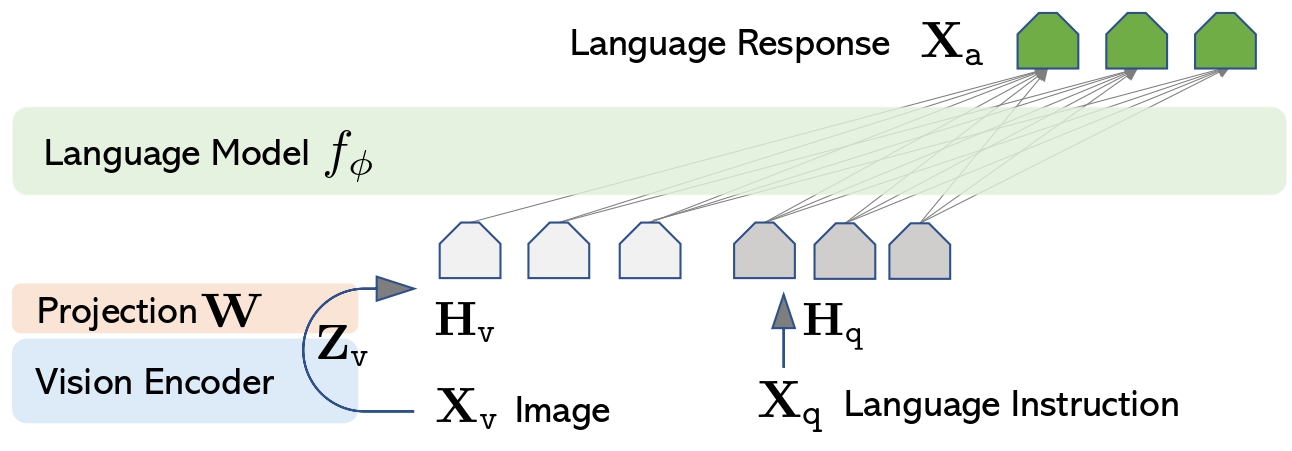 Arquitetura do LLaVa. Retirada do artigo original.
Este modelo foi contribuído por [ArthurZ](https://huggingface.co/ArthurZ) e [ybelkada](https://huggingface.co/ybelkada). O código original pode ser encontrado [aqui](https://github.com/haotian-liu/LLaVA/tree/main/llava).
> [!TIP]
> Defina `use_kernels=True` em [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para substituir camadas compatíveis por kernels otimizados do Hub. Consulte [Carregando kernels](../kernel_doc/loading_kernels) para saber mais.
## Dicas de uso
- Recomendamos que os usuários utilizem `padding_side="left"` ao realizar a geração em lote, pois isso resulta em resultados mais precisos. Basta garantir que você chame `processor.tokenizer.padding_side = "left"` antes de gerar.
- Observe que o modelo não foi explicitamente treinado para processar múltiplas imagens no mesmo prompt, embora isso seja tecnicamente possível, você pode obter resultados imprecisos.
> [!NOTE]
> Os modelos LLaVA após o lançamento da v4.46 exibirão avisos sobre a adição de `processor.patch_size = {{patch_size}}`, `processor.num_additional_image_tokens = {{num_additional_image_tokens}}` e `processor.vision_feature_select_strategy = {{vision_feature_select_strategy}}`. É fortemente recomendável adicionar os atributos ao processor se você for o proprietário do checkpoint do modelo, ou abrir um PR caso não seja.
Adicionar esses atributos faz com que o LLaVA tente inferir o número de tokens de imagem necessários por imagem e expandir o texto com tantos placeholders `` quanto houver tokens. Geralmente, são cerca de 500 tokens por imagem, portanto, certifique-se de que o texto não seja truncado, pois caso contrário ocorrerá falha ao mesclar os embeddings. Os atributos podem ser obtidos da configuração do modelo, como `model.config.vision_config.patch_size` ou `model.config.vision_feature_select_strategy`. O `num_additional_image_tokens` deve ser `1` se o backbone de visão adicionar um token CLS ou `0` se nada extra for adicionado aos patches de visão.
### Formatando prompts com modelos de chat
Cada **checkpoint** é treinado com um formato de prompt específico, dependendo do backbone do modelo de linguagem subjacente. Para garantir o formato correto, use o método `apply_chat_template` do processador.
**Importante:**
- Você deve construir um histórico de conversa — passar uma string simples não funcionará.
- Cada mensagem deve ser um dicionário com as chaves `"role"` e `"content"`.
- O `"content"` deve ser uma lista de dicionários para diferentes modalidades, como `"text"` e `"image"`.
Aqui está um exemplo de como estruturar sua entrada. Usaremos [llava-hf/llava-1.5-7b-hf](https://huggingface.co/llava-hf/llava-1.5-7b-hf) e um histórico de conversa de texto e imagem. Cada campo de conteúdo deve ser uma lista de dicts, conforme a seguir:
```python
from transformers import AutoProcessor
processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
conversation = [
{
"role": "user",
"content": [
{"type": "image"},
{"type": "text", "text": "What’s shown in this image?"},
],
},
{
"role": "assistant",
"content": [{"type": "text", "text": "This image shows a red stop sign."},]
},
{
"role": "user",
"content": [
{"type": "text", "text": "Describe the image in more details."},
],
},
]
text_prompt = processor.apply_chat_template(conversation, add_generation_prompt=True)
# Note that the template simply formats your prompt, you still have to tokenize it and obtain pixel values for your images
print(text_prompt)
"USER: \nUSER: Describe the image in more details. ASSISTANT:"
```
- Se você quiser construir um prompt de chat por conta própria, abaixo está uma lista dos formatos de prompt aceitos por cada checkpoint do llava:
Os modelos [llava-interleave](https://huggingface.co/collections/llava-hf/llava-interleave-668e19a97da0036aad4a2f19) exigem o seguinte formato:
```bash
"<|im_start|>user \nWhat is shown in this image?<|im_end|><|im_start|>assistant"
```
Para conversas com múltiplas rodadas:
```bash
"<|im_start|>user \n<|im_end|><|im_start|>assistant <|im_end|><|im_start|>user \n<|im_end|><|im_start|>assistant "
```
Os modelos [llava-1.5](https://huggingface.co/collections/llava-hf/llava-15-65f762d5b6941db5c2ba07e0) exigem o seguinte formato:
```bash
"USER: \n ASSISTANT:"
```
Para conversas com múltiplas rodadas:
```bash
"USER: \n ASSISTANT: USER: ASSISTANT: USER: ASSISTANT:"
```
🚀 **Bônus:** Se você estiver usando `transformers>=4.49.0`, também pode obter uma saída vetorizada de `apply_chat_template`. Consulte os **Exemplos de uso** abaixo para mais detalhes sobre como usá-lo.
## Exemplos de uso
### Inferência com entrada única
```python
import torch
from transformers import AutoProcessor, LlavaForConditionalGeneration
# Load the model in half-precision
model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf", device_map="auto")
processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
conversation = [
{
"role": "user",
"content": [
{"type": "image", "url": "https://www.ilankelman.org/stopsigns/australia.jpg"},
{"type": "text", "text": "What is shown in this image?"},
],
},
]
inputs = processor.apply_chat_template(
conversation,
add_generation_prompt=True,
tokenize=True,
return_dict=True,
return_tensors="pt"
).to(model.device, torch.float16)
# Generate
generate_ids = model.generate(**inputs, max_new_tokens=30)
processor.batch_decode(generate_ids, skip_special_tokens=True)
```
### Inferência em lote
O LLaVa também suporta inferência em lote. Veja como fazer isso:
```python
import torch
from transformers import AutoProcessor, LlavaForConditionalGeneration
# Load the model in half-precision
model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf", device_map="auto")
processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
# Prepare a batch of two prompts
conversation_1 = [
{
"role": "user",
"content": [
{"type": "image", "url": "https://www.ilankelman.org/stopsigns/australia.jpg"},
{"type": "text", "text": "What is shown in this image?"},
],
},
]
conversation_2 = [
{
"role": "user",
"content": [
{"type": "image", "url": "http://images.cocodataset.org/val2017/000000039769.jpg"},
{"type": "text", "text": "What is shown in this image?"},
],
},
]
inputs = processor.apply_chat_template(
[conversation_1, conversation_2],
add_generation_prompt=True,
tokenize=True,
return_dict=True,
padding=True,
return_tensors="pt"
).to(model.device, torch.float16)
# Generate
generate_ids = model.generate(**inputs, max_new_tokens=30)
processor.batch_decode(generate_ids, skip_special_tokens=True)
```
## Nota sobre a reprodução da implementação original
Para corresponder aos logits da [implementação original](https://github.com/haotian-liu/LLaVA/tree/main), é necessário especificar adicionalmente `do_pad=True` ao instanciar `LlavaImageProcessor`:
```python
from transformers import LlavaImageProcessor
image_processor = LlavaImageProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf", do_pad=True)
```
### Usando Flash Attention 2
O Flash Attention 2 é uma versão ainda mais rápida e otimizada da otimização anterior. Consulte a [seção do Flash Attention 2 na documentação de desempenho](https://huggingface.co/docs/transformers/perf_infer_gpu_one).
## Recursos
Uma lista de recursos oficiais da Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o LLaVa.
- Uma [demonstração no Google Colab](https://colab.research.google.com/drive/1qsl6cd2c8gGtEW1xV5io7S8NHh-Cp1TV?usp=sharing) sobre como executar o Llava em uma instância gratuita do Google Colab, aproveitando a inferência de 4 bits.
- Um [notebook semelhante](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/LLaVa/Inference_with_LLaVa_for_multimodal_generation.ipynb) demonstrando inferência em lote. 🌎
## LlavaConfig[[transformers.LlavaConfig]]
#### transformers.LlavaConfig[[transformers.LlavaConfig]]
```python
transformers.LlavaConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, image_token_index: int = 32000, image_seq_length: int = 576, projector_hidden_act: str = 'gelu', vision_feature_select_strategy: typing.Literal['default', 'full'] = 'default', vision_feature_layer: int | list[int] = -2, multimodal_projector_bias: bool = True, tie_word_embeddings: bool = False)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/configuration_llava.py#L26)
**Parâmetros:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : O objeto de configuração ou dicionário do backbone de visão.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : O objeto de configuração ou dicionário do backbone de texto.
image_token_index (`int`, *opcional*, padrão `32000`) : O índice do token de imagem usado como marcador para as imagens de entrada.
image_seq_length (`int`, *opcional*, padrão `576`) : Comprimento da sequência de um embedding de imagem.
projector_hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação usada pelo projetor multimodal.
vision_feature_select_strategy (`Literal[default, full]`, *opcional*, padrão `default`) : A estratégia de seleção de recursos usada para selecionar o recurso visual do backbone visual.
vision_feature_layer (`Union[int, list[int]]`, *opcional*, padrão `-2`) : O índice da camada para selecionar o recurso visual. Se vários índices forem fornecidos, os recursos visuais dos índices correspondentes serão concatenados para formar os recursos visuais.
multimodal_projector_bias (`bool`, *opcional*, padrão `True`) : Se deve usar viés no projetor multimodal.
tie_word_embeddings (`bool`, *opcional*, padrão `False`) : Se deve vincular as embeddings de pesos de acordo com o mapeamento `tied_weights_keys` do modelo.
Esta é a classe de configuração para armazenar a configuração de um LlavaModel. Ela é usada para instanciar um modelo Llava de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [llava-hf/llava-1.5-7b-hf](https://huggingface.co/llava-hf/llava-1.5-7b-hf)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import LlavaForConditionalGeneration, LlavaConfig, CLIPVisionConfig, LlamaConfig
>>> # Initializing a CLIP-vision config
>>> vision_config = CLIPVisionConfig()
>>> # Initializing a Llama config
>>> text_config = LlamaConfig()
>>> # Initializing a Llava llava-1.5-7b style configuration
>>> configuration = LlavaConfig(vision_config, text_config)
>>> # Initializing a model from the llava-1.5-7b style configuration
>>> model = LlavaForConditionalGeneration(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## LlavaImageProcessor[[transformers.LlavaImageProcessor]]
#### transformers.LlavaImageProcessor[[transformers.LlavaImageProcessor]]
```python
transformers.LlavaImageProcessor(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/image_processing_llava.py#L38)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'shortest_edge' : 224}`): Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 224, 'width': 224}`): Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `3`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.48145466, 0.4578275, 0.40821073]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.26862954, 0.26130258, 0.27577711]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve aplicar um recorte centralizado na imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
Constrói um processador de imagem LlavaImageProcessor.
#### preprocess[[transformers.LlavaImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Sinalizador do desenvolvedor para entradas adicionais semelhantes a imagens que também serão pré-processadas. Use isso apenas se a passagem das entradas como kwarg não funcionar. Por exemplo, `preprocess(images, masks=masks)` é a opção preferida, mas resulta em problemas de prioridade de argumentos para alguns modelos. Nesses casos, `preprocess(images, image_like_inputs={"masks": masks})` pode ser usado em vez disso.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
Pré-processa uma imagem ou um lote de imagens.
## LlavaImageProcessorPil[[transformers.LlavaImageProcessorPil]]
#### transformers.LlavaImageProcessorPil[[transformers.LlavaImageProcessorPil]]
```python
transformers.LlavaImageProcessorPil(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/image_processing_pil_llava.py#L31)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'shortest_edge' : 224}`): Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 224, 'width': 224}`): Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `3`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.48145466, 0.4578275, 0.40821073]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.26862954, 0.26130258, 0.27577711]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve aplicar um recorte centralizado na imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
Constrói um processador de imagem LlavaImageProcessor.
#### preprocess[[transformers.LlavaImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Sinalizador do desenvolvedor para entradas adicionais semelhantes a imagens que também serão pré-processadas. Use isso apenas se a passagem das entradas como kwarg não funcionar. Por exemplo, `preprocess(images, masks=masks)` é a opção preferida, mas resulta em problemas de prioridade de argumentos para alguns modelos. Nesses casos, `preprocess(images, image_like_inputs={"masks": masks})` pode ser usado em vez disso.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
Pré-processa uma imagem ou um lote de imagens.
## LlavaProcessor[[transformers.LlavaProcessor]]
#### transformers.LlavaProcessor[[transformers.LlavaProcessor]]
```python
transformers.LlavaProcessor(image_processor = None, tokenizer = None, patch_size = None, vision_feature_select_strategy = None, chat_template = None, image_token = '', num_additional_image_tokens = 0, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/processing_llava.py#L37)
**Parâmetros:**
image_processor (`LlavaImageProcessor`) : O processador de imagem é uma entrada obrigatória.
tokenizer (`TokenizersBackend`) : O tokenizer é uma entrada obrigatória.
patch_size (`int`, *opcional*) : Tamanho do patch da torre de visão.
vision_feature_select_strategy (`str`, *opcional*) : A estratégia de seleção de recursos usada para selecionar o recurso visual do backbone visual. Deve ser a mesma da configuração do modelo
chat_template (`str`) : Um modelo Jinja para converter listas de mensagens em um chat em uma string tokenizável.
image_token (`str`, *opcional*, padrão `""`) : Token especial usado para indicar a localização da imagem.
num_additional_image_tokens (`int`, *opcional*, padrão 0) : Número de tokens adicionais adicionados aos embeddings da imagem, como CLS (+1). Se o backbone não tiver CLS ou outros tokens extras anexados, não é necessário definir este argumento.
Constrói um LlavaProcessor que encapsula um processador de imagem e um tokenizer em um único processador.
[LlavaProcessor](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaProcessor) oferece todas as funcionalidades de [LlavaImageProcessor](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaImageProcessor) e [TokenizersBackend](/docs/transformers/main/pt/main_classes/tokenizer#transformers.TokenizersBackend). Consulte [~LlavaImageProcessor](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaImageProcessor) e [~TokenizersBackend](/docs/transformers/main/pt/main_classes/tokenizer#transformers.TokenizersBackend) para mais informações.
#### __call__[[transformers.LlavaProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L659)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opcional*) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *opcional*) : A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se você passar uma entrada pretokenizada, defina `is_split_into_words=True` para evitar ambiguidade com entradas em lote.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *opcional*) : Vídeo para pré-processar. Espera um único vídeo ou um lote de vídeos com valores de pixel variando de 0 a 255. Se estiver passando vídeos com valores de pixel entre 0 e 1, defina `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *opcional*) : O áudio ou lote de áudios a ser preparado. Cada áudio pode ser um array NumPy ou um tensor PyTorch. No caso de um array NumPy/tensor PyTorch, cada áudio deve ter a forma (C, T), onde C é o número de canais e T é o comprimento de amostras do áudio.
return_tensors (`str` ou [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *opcional*) : Se definido, retornará tensores de um framework específico. Os valores aceitos são: - `'pt'`: Retorna objetos `torch.Tensor` do PyTorch. - `'np'`: Retorna objetos `np.ndarray` do NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/pt/main_classes/processors#transformers.ProcessingKwargs), *opcional*) : Opções de processamento adicionais para cada modalidade (texto, imagens, vídeos, áudio). Os parâmetros específicos do modelo estão listados acima; consulte a classe TypedDict para a lista completa de argumentos suportados.
## LlavaModel[[transformers.LlavaModel]]
#### transformers.LlavaModel[[transformers.LlavaModel]]
```python
transformers.LlavaModel(config: LlavaConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/modeling_llava.py#L130)
**Parâmetros:**
config ([LlavaConfig](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Llava, que consiste em um backbone de visão e um modelo de linguagem, sem uma cabeça de modelagem de linguagem.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.LlavaModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, image_sizes: typing.Optional[torch.Tensor] = None, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/modeling_llava.py#L217)
**Parâmetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [LlavaImageProcessor](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaImageProcessor). Veja [LlavaImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([LlavaProcessor](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaProcessor) usa [LlavaImageProcessor](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaImageProcessor) para processar imagens).
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
position_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
past_key_values (`~cache_utils.Cache`, *opcional*) : hidden-states pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nos `past_key_values` retornados pelo modelo em uma etapa anterior da decodificação, quando `use_cache=True` ou `config.use_cache=True`. Apenas uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache) é permitida como entrada, consulte nosso [guia de kv cache](https://huggingface.co/docs/transformers/en/kv_cache). Se nenhum `past_key_values` for passado, [DynamicCache](/docs/transformers/main/pt/internal/generation_utils#transformers.DynamicCache) será inicializado por padrão. O modelo sairá no mesmo formato de cache que foi fornecido como entrada. Se `past_key_values` forem usados, espera-se que o usuário insira apenas `input_ids` não processados (aqueles que não têm seus estados de chave e valor passados para este modelo) com a forma `(batch_size, unprocessed_length)` em vez de todos os `input_ids` com a forma `(batch_size, sequence_length)`.
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
vision_feature_layer (`Union[int, list[int]]`, *opcional*) : O índice da camada para selecionar o recurso visual. Se vários índices forem fornecidos, os recursos visuais dos índices correspondentes serão concatenados para formar os recursos visuais.
vision_feature_select_strategy (`str`, *opcional*) : A estratégia de seleção de recursos usada para selecionar o recurso visual do backbone visual. Pode ser `"default"` ou `"full"`.
image_sizes (`torch.Tensor` de forma `(batch_size, 2)`, *opcional*) : Os tamanhos das imagens no lote, sendo (altura, largura) para cada imagem.
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *opcional*) : Dicionário em que as chaves são as modalidades suportadas e os valores são as saídas codificadas para essa modalidade. Cada saída codificada é uma tupla que consiste em (`pooler_output`, *opcional*: `last_hidden_states`, *opcional*: `hidden_states`, *opcional*: `attentions`) `pooler_output` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) é uma sequência de recursos multimodais do codificador mesclados em incorporações de texto.
**Retorna:** `LlavaModelOutputWithPast` ou `tuple(torch.Tensor)`
Um `LlavaModelOutputWithPast` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([LlavaConfig](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaConfig)) e das entradas.
O método forward do [LlavaModel](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaModel) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
Se `past_key_values` for usado, apenas o último hidden-state das sequências, com forma `(batch_size, 1, hidden_size)`, é retornado.
- **past_key_values** (`Cache`, *opcional*, retornado quando `use_cache=True` é passado ou quando `config.use_cache=True`) -- Trata-se de uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache). Para mais detalhes, consulte nosso [guia de cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção) que podem ser usados (veja a entrada `past_key_values`) para acelerar a decodificação sequencial.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **image_hidden_states** (`torch.Tensor`, *opcional*) -- Um `torch.Tensor` de tamanho `(batch_size, num_images, sequence_length, hidden_size)`. image_hidden_states do modelo produzido pelo codificador de visão e após projetar o último estado oculto.
#### get_image_features[[transformers.LlavaModel.get_image_features]]
```python
get_image_features(pixel_values: Tensor, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, image_sizes: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/modeling_llava.py#L139)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [LlavaImageProcessor](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaImageProcessor). Veja [LlavaImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([LlavaProcessor](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaProcessor) usa [LlavaImageProcessor](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaImageProcessor) para processar imagens).
vision_feature_layer (`Union[int, list[int]]`, *opcional*) : O índice da camada para selecionar o recurso visual. Se vários índices forem fornecidos, os recursos visuais dos índices correspondentes serão concatenados para formar os recursos visuais.
vision_feature_select_strategy (`str`, *opcional*) : A estratégia de seleção de recursos usada para selecionar o recurso visual do backbone visual. Pode ser `"default"` ou `"full"`.
image_sizes (`torch.Tensor` de forma `(batch_size, 2)`, *opcional*) : Os tamanhos das imagens no lote, sendo (altura, largura) para cada imagem.
**Retorna:** [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([LlavaConfig](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaConfig)) e das entradas.
Obtém os estados ocultos finais da imagem da torre de visão e aplica a projeção multimodal.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
#### get_placeholder_mask[[transformers.LlavaModel.get_placeholder_mask]]
```python
get_placeholder_mask(input_ids: LongTensor, inputs_embeds: Tensor, image_features: Tensor)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/modeling_llava.py#L193)
Obtém a máscara de placeholder multimodal a partir de `input_ids` ou `inputs_embeds` e verifica se a contagem de tokens de placeholder é igual ao comprimento das características multimodais. Se os comprimentos forem diferentes, um erro é lançado.
## LlavaForConditionalGeneration[[transformers.LlavaForConditionalGeneration]]
#### transformers.LlavaForConditionalGeneration[[transformers.LlavaForConditionalGeneration]]
```python
transformers.LlavaForConditionalGeneration(config: LlavaConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/modeling_llava.py#L282)
**Parâmetros:**
config ([LlavaConfig](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo LLAVA, que consiste em um backbone de visão e um modelo de linguagem.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.LlavaForConditionalGeneration.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, labels: typing.Optional[torch.LongTensor] = None, logits_to_keep: typing.Union[int, torch.Tensor] = 0, image_sizes: typing.Optional[torch.Tensor] = None, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/modeling_llava.py#L310)
**Parâmetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [LlavaImageProcessor](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaImageProcessor). Veja [LlavaImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([LlavaProcessor](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaProcessor) usa [LlavaImageProcessor](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaImageProcessor) para processar imagens).
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
position_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
past_key_values (`~cache_utils.Cache`, *opcional*) : hidden-states pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nos `past_key_values` retornados pelo modelo em uma etapa anterior da decodificação, quando `use_cache=True` ou `config.use_cache=True`. Apenas uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache) é permitida como entrada, consulte nosso [guia de kv cache](https://huggingface.co/docs/transformers/en/kv_cache). Se nenhum `past_key_values` for passado, [DynamicCache](/docs/transformers/main/pt/internal/generation_utils#transformers.DynamicCache) será inicializado por padrão. O modelo sairá no mesmo formato de cache que foi fornecido como entrada. Se `past_key_values` forem usados, espera-se que o usuário insira apenas `input_ids` não processados (aqueles que não têm seus estados de chave e valor passados para este modelo) com a forma `(batch_size, unprocessed_length)` em vez de todos os `input_ids` com a forma `(batch_size, sequence_length)`.
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
vision_feature_layer (`Union[int, list[int]]`, *opcional*) : O índice da camada para selecionar o recurso visual. Se vários índices forem fornecidos, os recursos visuais dos índices correspondentes serão concatenados para formar os recursos visuais.
vision_feature_select_strategy (`str`, *opcional*) : A estratégia de seleção de recursos usada para selecionar o recurso visual do backbone visual. Pode ser `"default"` ou `"full"`.
labels (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Rótulos para calcular a perda de modelagem de linguagem mascarada. Os índices devem estar em `[0, ..., config.vocab_size]` ou ser -100 (veja a docstring de `input_ids`). Tokens com índices definidos como `-100` são ignorados (mascarados); a perda é calculada apenas para os tokens com rótulos em `[0, ..., config.vocab_size]`.
logits_to_keep (`Union[int, torch.Tensor]`, *opcional*, padrão `0`) : Se for um `int`, calcula os logits para os últimos `logits_to_keep` tokens. Se for `0`, calcula os logits para todos os `input_ids` (caso especial). Apenas os logits do último token são necessários para a geração, e calculá-los apenas para esse token pode economizar memória, o que se torna bastante significativo para sequências longas ou tamanho de vocabulário grande. Se for um `torch.Tensor`, deve ser 1D, correspondendo aos índices a serem mantidos na dimensão de comprimento da sequência. Isso é útil ao usar o formato de tensor empacotado (uma única dimensão para lote e comprimento da sequência).
image_sizes (`torch.Tensor` de forma `(batch_size, 2)`, *opcional*) : Os tamanhos das imagens no lote, sendo (altura, largura) para cada imagem.
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *opcional*) : Dicionário em que as chaves são as modalidades suportadas e os valores são as saídas codificadas para essa modalidade. Cada saída codificada é uma tupla que consiste em (`pooler_output`, *opcional*: `last_hidden_states`, *opcional*: `hidden_states`, *opcional*: `attentions`) `pooler_output` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) é uma sequência de recursos multimodais do codificador mesclados em incorporações de texto.
**Retorna:** `LlavaCausalLMOutputWithPast` ou `tuple(torch.Tensor)`
Um `LlavaCausalLMOutputWithPast` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([LlavaConfig](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaConfig)) e das entradas.
O método forward de [LlavaForConditionalGeneration](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaForConditionalGeneration) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de modelagem de linguagem (para previsão do próximo token).
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).
- **past_key_values** (`Cache`, *opcional*, retornado quando `use_cache=True` é passado ou quando `config.use_cache=True`) -- Trata-se de uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache). Para mais detalhes, consulte nosso [guia de cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção) que podem ser usados (veja a entrada `past_key_values`) para acelerar a decodificação sequencial.
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **image_hidden_states** (`torch.Tensor`, *opcional*) -- Um `torch.Tensor` de tamanho `(batch_size, num_images, sequence_length, hidden_size)`. image_hidden_states do modelo produzido pelo codificador de visão e após projetar o último estado oculto.
Exemplo:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, LlavaForConditionalGeneration
>>> model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> prompt = "USER: \nWhat's the content of the image? ASSISTANT:"
>>> url = "https://www.ilankelman.org/stopsigns/australia.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, text=prompt, return_tensors="pt")
>>> # Generate
>>> generate_ids = model.generate(**inputs, max_new_tokens=15)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]
"USER: \nWhat's the content of the image? ASSISTANT: The image features a busy city street with a stop sign prominently displayed"
```
#### get_image_features[[transformers.LlavaForConditionalGeneration.get_image_features]]
```python
get_image_features(pixel_values: Tensor, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/modeling_llava.py#L295)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [LlavaImageProcessor](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaImageProcessor). Veja [LlavaImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([LlavaProcessor](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaProcessor) usa [LlavaImageProcessor](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaImageProcessor) para processar imagens).
vision_feature_layer (`Union[int, list[int]]`, *opcional*) : O índice da camada para selecionar o recurso visual. Se vários índices forem fornecidos, os recursos visuais dos índices correspondentes serão concatenados para formar os recursos visuais.
vision_feature_select_strategy (`str`, *opcional*) : A estratégia de seleção de recursos usada para selecionar o recurso visual do backbone visual. Pode ser `"default"` ou `"full"`.
**Retorna:** [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([LlavaConfig](/docs/transformers/main/pt/model_doc/llava#transformers.LlavaConfig)) e das entradas.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplo:
```python
>>> from PIL import Image
>>> from transformers import AutoProcessor, LlavaForConditionalGeneration
>>> model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> messages = [
... {
... "role": "user", "content": [
... {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
... {"type": "text", "text": "Where is the cat standing?"},
... ]
... },
... ]
>>> inputs = processor.apply_chat_template(
... messages,
... tokenize=True,
... return_dict=True,
... return_tensors="pt",
... add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
```