# MarkupLM
## Visão geral
O modelo MarkupLM foi proposto em [MarkupLM: Pre-training of Text and Markup Language for Visually-rich Document Understanding](https://huggingface.co/papers/2110.08518) por Junlong Li, Yiheng Xu, Lei Cui, Furu Wei. O MarkupLM é um BERT, mas aplicado a páginas HTML em vez de documentos de texto puro. O modelo incorpora camadas de embedding adicionais para melhorar o desempenho, de forma semelhante ao [LayoutLM](layoutlm).
O modelo pode ser usado para tarefas como resposta a perguntas em páginas da web ou extração de informações de páginas da web. Ele obtém resultados de estado da arte em 2 benchmarks importantes:
- [WebSRC](https://x-lance.github.io/WebSRC/), um conjunto de dados para Compreensão de Leitura Estrutural Baseada na Web (um pouco como o SQuAD, mas para páginas da web)
- [SWDE](https://www.researchgate.net/publication/221299838_From_one_tree_to_a_forest_a_unified_solution_for_structured_web_data_extraction), um conjunto de dados
para extração de informações de páginas da web (basicamente, reconhecimento de entidades nomeadas em páginas da web)
O resumo do artigo é o seguinte:
*O pré-treino multimodal com texto, layout e imagem tem feito progressos significativos para a Compreensão de Documentos Visualmente Ricos (VrDU), especialmente para documentos de layout fixo, como imagens de documentos digitalizados. No entanto, ainda há um grande número de documentos digitais em que as informações de layout não são fixas e precisam ser renderizadas de forma interativa e dinâmica para visualização, o que torna as abordagens de pré-treino baseadas em layout existentes difíceis de aplicar. Neste artigo, propomos o MarkupLM para tarefas de compreensão de documentos com linguagens de marcação como espinha dorsal, como documentos baseados em HTML/XML, em que as informações de texto e de marcação são pré-treinadas conjuntamente. Os resultados experimentais mostram que o MarkupLM pré-treinado supera significativamente os modelos de linha de base fortes existentes em várias tarefas de compreensão de documentos. O modelo pré-treinado e o código ficarão publicamente disponíveis.*
Este modelo foi contribuído por [nielsr](https://huggingface.co/nielsr). O código original pode ser encontrado [aqui](https://github.com/microsoft/unilm/tree/master/markuplm).
## Dicas de uso
- Além de `input_ids`, [forward()](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMModel.forward) espera 2 entradas adicionais, a saber, `xpath_tags_seq` e `xpath_subs_seq`.
Estas são, respectivamente, as tags XPATH e os subíndices para cada token na sequência de entrada.
- É possível usar o [MarkupLMProcessor](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMProcessor) para preparar todos os dados para o modelo. Consulte o [guia de uso](#usage-markuplmprocessor) para mais informações.
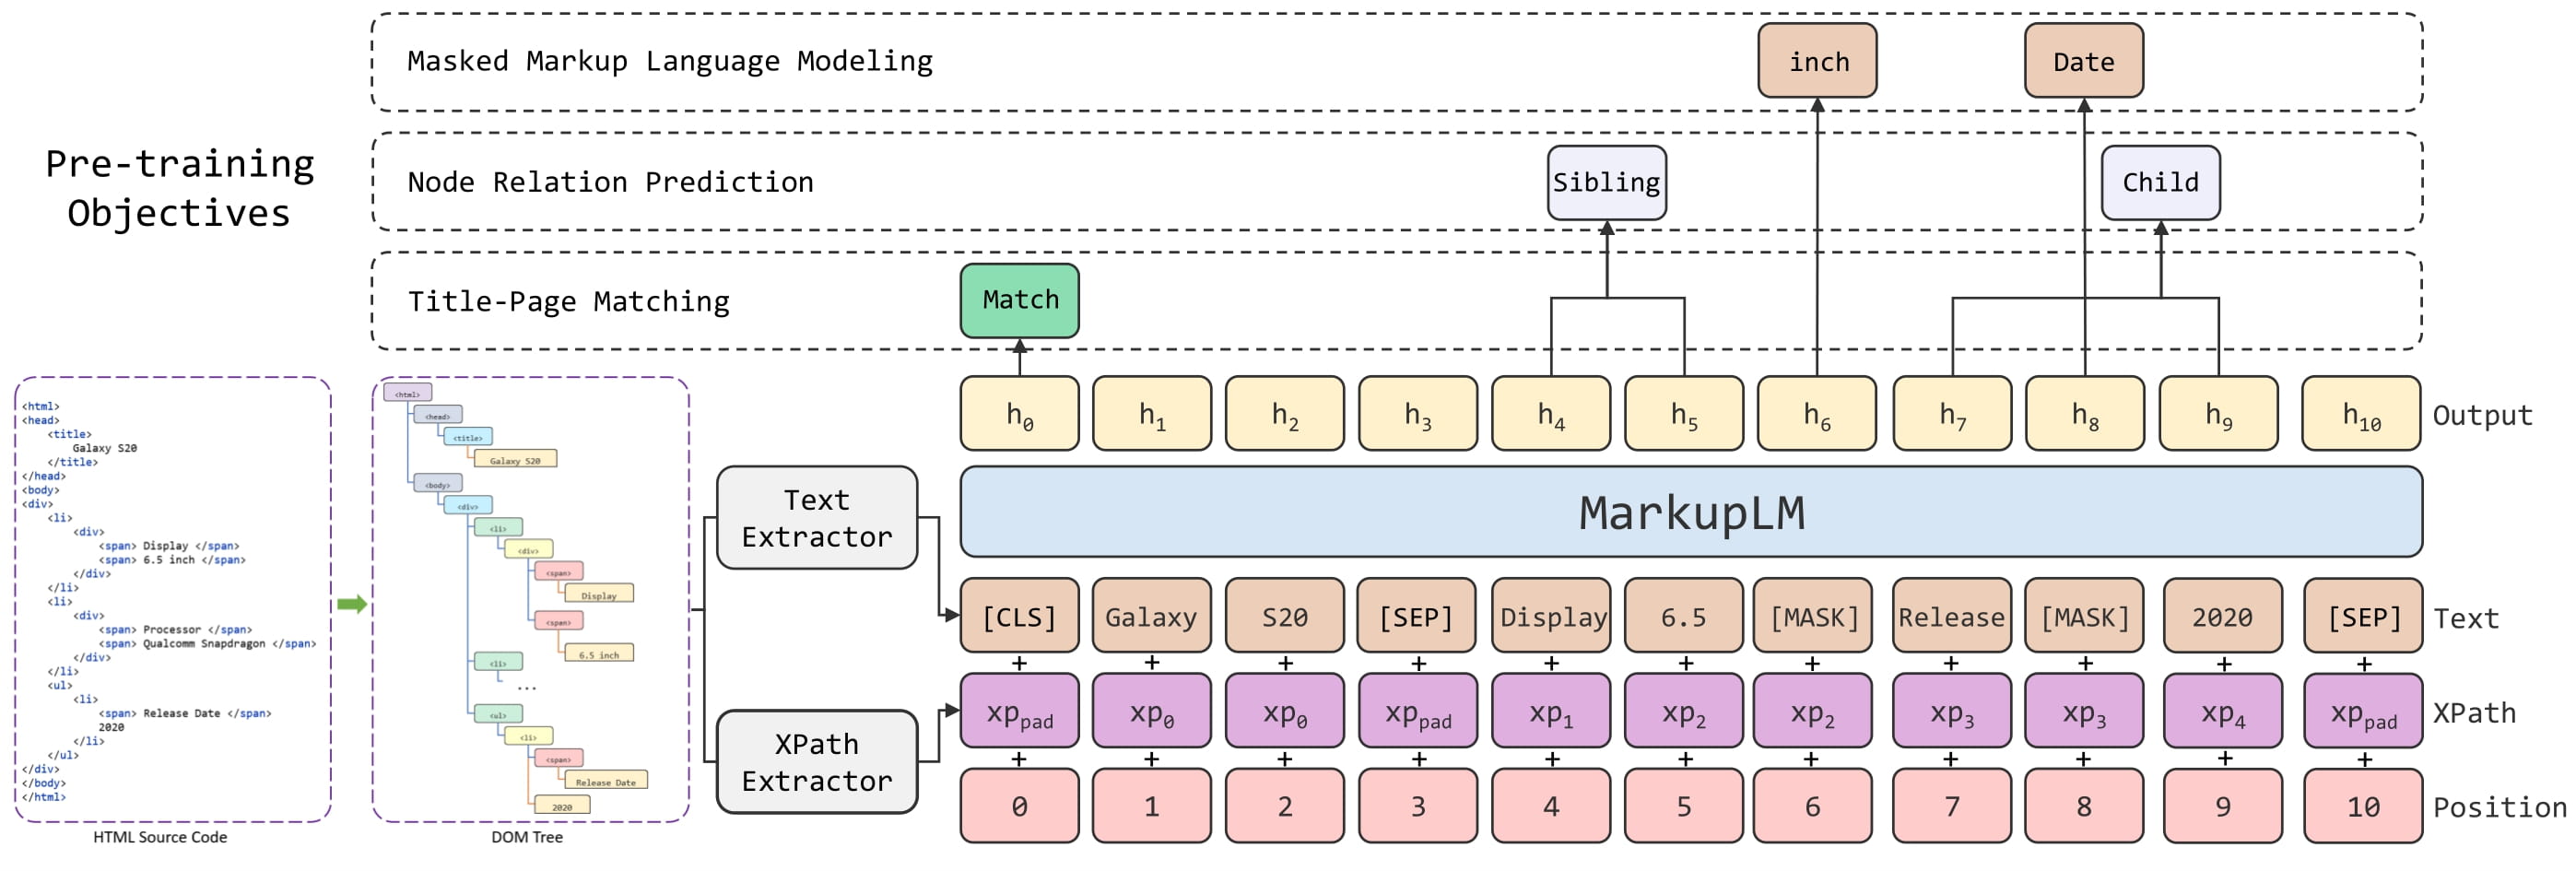 Arquitetura do MarkupLM. Retirada do artigo original.
## Uso: MarkupLMProcessor
A maneira mais fácil de preparar os dados para o modelo é usar o [MarkupLMProcessor](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMProcessor), que internamente combina um extrator de recursos ([MarkupLMFeatureExtractor](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMFeatureExtractor)) e um tokenizador ([MarkupLMTokenizer](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMTokenizer) ou [MarkupLMTokenizerFast](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMTokenizer)). O extrator de recursos é usado para extrair todos os nós e xpaths das strings HTML, que são então fornecidos ao tokenizador, o qual os converte nas entradas em nível de token do modelo (`input_ids` etc.). Observe que você ainda pode usar o extrator de recursos e o tokenizador separadamente, caso queira lidar apenas com uma das duas tarefas.
```python
from transformers import MarkupLMFeatureExtractor, MarkupLMProcessor, MarkupLMTokenizerFast
feature_extractor = MarkupLMFeatureExtractor()
tokenizer = MarkupLMTokenizerFast.from_pretrained("microsoft/markuplm-base")
processor = MarkupLMProcessor(feature_extractor, tokenizer)
```
Em resumo, é possível fornecer strings HTML (e possivelmente dados adicionais) para o [MarkupLMProcessor](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMProcessor), e ele criará as entradas esperadas pelo modelo. Internamente, o processador primeiro usa o [MarkupLMFeatureExtractor](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMFeatureExtractor) para obter uma lista de nós e os xpaths correspondentes. Em seguida, os nós e os xpaths são fornecidos ao [MarkupLMTokenizer](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMTokenizer) ou ao [MarkupLMTokenizerFast](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMTokenizer), que os convertem em `input_ids`, `attention_mask`, `token_type_ids`, `xpath_subs_seq` e `xpath_tags_seq` no nível de tokens. Opcionalmente, é possível fornecer rótulos de nós ao processador, que são convertidos em `labels` no nível de tokens.
[MarkupLMFeatureExtractor](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMFeatureExtractor) utiliza [Beautiful Soup](https://www.crummy.com/software/BeautifulSoup/bs4/doc/), uma biblioteca Python para extrair dados de arquivos HTML e XML, internamente. Observe que você ainda pode usar sua própria solução de parsing preferida e fornecer os nós e xpaths por conta própria para [MarkupLMTokenizer](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMTokenizer) ou [MarkupLMTokenizerFast](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMTokenizer).
No total, há 5 casos de uso suportados pelo processador. Abaixo, listamos todos eles. Observe que cada um desses casos de uso funciona tanto para entradas em lote (batched) quanto para entradas não em lote (non-batched) (ilustramos para entradas não em lote).
**Caso de uso 1: classificação de página web (treinamento, inferência) + classificação de tokens (inferência), parse_html = True**
Esse é o caso mais simples, no qual o processador usará o extrator de recursos para obter todos os nós e xpaths do HTML.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
html_string = """
Hello world
Welcome
Here is my website.
"""
# note that you can also add provide all tokenizer parameters here such as padding, truncation
encoding = processor(html_string, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**Caso de uso 2: classificação de página web (treinamento, inferência) + classificação de tokens (inferência), parse_html=False**
Caso já se tenha obtido todos os nós e xpaths, não é necessário o extrator de recursos. Nesse caso, deve-se fornecer os nós e os xpaths correspondentes diretamente ao processador, garantindo que `parse_html` esteja definido como `False`.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
encoding = processor(nodes=nodes, xpaths=xpaths, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**Caso de uso 3: classificação de tokens (treinamento), parse_html=False**
Para tarefas de classificação de tokens (como [SWDE](https://paperswithcode.com/dataset/swde)), também é possível fornecer os rótulos de nó correspondentes para treinar um modelo. O processador converterá esses rótulos em `labels` no nível de token. Por padrão, ele rotulará apenas o primeiro wordpiece de uma palavra e rotulará os wordpieces restantes com -100, que é o `ignore_index` do CrossEntropyLoss do PyTorch. Caso você queira que todos os wordpieces de uma palavra sejam rotulados, pode inicializar o tokenizer com `only_label_first_subword` definido como `False`.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
node_labels = [1, 2, 2, 1]
encoding = processor(nodes=nodes, xpaths=xpaths, node_labels=node_labels, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq', 'labels'])
```
**Caso de uso 4: resposta a perguntas sobre páginas da web (inferência), parse_html=True**
Para tarefas de resposta a perguntas em páginas da web, você pode fornecer uma pergunta ao processador. Por padrão, o processador usará o extrator de recursos para obter todos os nós e xpaths e criar [CLS] tokens da pergunta [SEP] tokens das palavras [SEP].
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
html_string = """
Hello world
Welcome
My name is Niels.
"""
question = "What's his name?"
encoding = processor(html_string, questions=question, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**Caso de uso 5: resposta a perguntas sobre páginas da web (inferência), parse_html=False**
Para tarefas de resposta a perguntas (como o WebSRC), você pode fornecer uma pergunta ao processador. Se você extraiu todos os nós e xpaths por conta própria, pode fornecê-los diretamente ao processador. Certifique-se de definir `parse_html` como `False`.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
question = "What's his name?"
encoding = processor(nodes=nodes, xpaths=xpaths, questions=question, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
## Recursos
- [Notebooks de demonstração](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/MarkupLM)
- [Guia da tarefa de classificação de texto](../tasks/sequence_classification)
- [Guia de tarefas de classificação de tokens](../tasks/token_classification)
- [Guia da tarefa de resposta a perguntas](../tasks/question_answering)
## MarkupLMConfig[[transformers.MarkupLMConfig]]
#### transformers.MarkupLMConfig[[transformers.MarkupLMConfig]]
```python
transformers.MarkupLMConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 512, type_vocab_size: int = 2, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, max_xpath_tag_unit_embeddings: int = 256, max_xpath_subs_unit_embeddings: int = 1024, tag_pad_id: int = 216, subs_pad_id: int = 1001, xpath_unit_hidden_size: int = 32, max_depth: int = 50, use_cache: bool = True, classifier_dropout: float | int | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/configuration_markuplm.py#L24)
**Parâmetros:**
vocab_size (`int`, *opcional*, padrão `30522`) : Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelos `input_ids`.
hidden_size (`int`, *opcional*, padrão `768`) : Dimensão das representações ocultas.
num_hidden_layers (`int`, *opcional*, padrão `12`) : Número de camadas ocultas no decodificador do Transformer.
num_attention_heads (`int`, *opcional*, padrão `12`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
intermediate_size (`int`, *opcional*, padrão `3072`) : Dimensão das representações do MLP.
hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.1`) : A probabilidade de dropout para todas as camadas totalmente conectadas nos embeddings, encoder e pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.1`) : A taxa de dropout para as probabilidades de atenção.
max_position_embeddings (`int`, *opcional*, padrão `512`) : O comprimento máximo de sequência com o qual este modelo pode ser utilizado.
type_vocab_size (`int`, *opcional*, padrão `2`) : O tamanho do vocabulário dos `token_type_ids`.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
layer_norm_eps (`float`, *opcional*, padrão `1e-12`) : O epsilon usado pelas camadas de normalização de camada.
pad_token_id (`int`, *opcional*, padrão `0`) : ID do token usado para preenchimento no vocabulário.
bos_token_id (`int`, *opcional*, padrão `0`) : ID do token usado para o início do fluxo no vocabulário.
eos_token_id (`Union[int, list[int]]`, *opcional*, padrão `2`) : ID do token usado para o fim do fluxo no vocabulário.
max_xpath_tag_unit_embeddings (`int`, *opcional*, padrão 256) : O valor máximo que a incorporação de unidade de tag xpath pode usar. Normalmente, defina este valor para algo grande, apenas por precaução (por exemplo, 256).
max_xpath_subs_unit_embeddings (`int`, *opcional*, padrão 1024) : O valor máximo que a incorporação de unidade de subíndice xpath pode usar. Normalmente, defina esse valor para algo grande, apenas por precaução (por exemplo, 1024).
tag_pad_id (`int`, *opcional*, padrão 216) : O id do token de padding nas tags xpath.
subs_pad_id (`int`, *opcional*, padrão 1001) : O id do token de padding nos subscritos xpath.
xpath_unit_hidden_size (`int`, *opcional*, padrão 32) : O tamanho oculto de cada unidade em xpath.
max_depth (`int`, *opcional*, padrão 50) : A profundidade máxima no xpath.
use_cache (`bool`, *opcional*, padrão `True`) : Indica se o modelo deve retornar as últimas atenções de chave/valor (não utilizado por todos os modelos). Relevante apenas se `config.is_decoder=True` ou quando o modelo for um modelo generativo somente de decodificador.
classifier_dropout (`Union[float, int]`, *opcional*) : A taxa de dropout para o classificador.
Esta é a classe de configuração para armazenar a configuração de um MarkupLMModel. Ela é usada para instanciar um modelo Markuplm de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [microsoft/markuplm-base](https://huggingface.co/microsoft/markuplm-base)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplos:
```python
>>> from transformers import MarkupLMModel, MarkupLMConfig
>>> # Initializing a MarkupLM microsoft/markuplm-base style configuration
>>> configuration = MarkupLMConfig()
>>> # Initializing a model from the microsoft/markuplm-base style configuration
>>> model = MarkupLMModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## MarkupLMFeatureExtractor[[transformers.MarkupLMFeatureExtractor]]
#### transformers.MarkupLMFeatureExtractor[[transformers.MarkupLMFeatureExtractor]]
```python
transformers.MarkupLMFeatureExtractor(**kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/feature_extraction_markuplm.py#L32)
Constrói um extrator de recursos MarkupLM. Ele pode ser usado para obter uma lista de nós e os xpaths correspondentes a partir de strings HTML.
Este extrator de características herda de `PreTrainedFeatureExtractor()`, que contém a maioria dos métodos principais. Os usuários devem consultar esta superclasse para obter mais informações sobre esses métodos.
#### __call__[[transformers.MarkupLMFeatureExtractor.__call__]]
```python
__call__(html_strings)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/feature_extraction_markuplm.py#L98)
**Parâmetros:**
html_strings (`str`, `list[str]`) : A string HTML ou um lote de strings HTML a partir das quais extrair os nós e os xpaths correspondentes.
**Retorna:** [BatchFeature](/docs/transformers/main/pt/main_classes/feature_extractor#transformers.BatchFeature)
Um [BatchFeature](/docs/transformers/main/pt/main_classes/feature_extractor#transformers.BatchFeature) com os seguintes campos:
- **nodes** -- Nós.
- **xpaths** -- xpaths correspondentes.
Método principal para preparar uma ou várias strings HTML para o modelo.
Exemplos:
```python
>>> from transformers import MarkupLMFeatureExtractor
>>> page_name_1 = "page1.html"
>>> page_name_2 = "page2.html"
>>> page_name_3 = "page3.html"
>>> with open(page_name_1) as f:
... single_html_string = f.read()
>>> feature_extractor = MarkupLMFeatureExtractor()
>>> # single example
>>> encoding = feature_extractor(single_html_string)
>>> print(encoding.keys())
>>> # dict_keys(['nodes', 'xpaths'])
>>> # batched example
>>> multi_html_strings = []
>>> with open(page_name_2) as f:
... multi_html_strings.append(f.read())
>>> with open(page_name_3) as f:
... multi_html_strings.append(f.read())
>>> encoding = feature_extractor(multi_html_strings)
>>> print(encoding.keys())
>>> # dict_keys(['nodes', 'xpaths'])
```
## MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
#### transformers.MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
```python
transformers.MarkupLMTokenizer(tags_dict, vocab: str | dict[str, int] | list[tuple[str, float]] | None = None, merges: str | list[str] | None = None, errors = 'replace', bos_token = '', eos_token = '', sep_token = '', cls_token = '', unk_token = '', pad_token = '', mask_token = '', add_prefix_space = False, max_depth = 50, max_width = 1000, pad_width = 1001, pad_token_label = -100, only_label_first_subword = True, trim_offsets = False, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L91)
**Parâmetros:**
vocab (`str` ou `dict[str, int]`, *opcional*) : Dicionário de vocabulário personalizado. Se não for fornecido, o vocabulário é carregado a partir de `vocab_file`.
merges (`str` ou `list[str]`, *opcional*) : Lista de mesclagens personalizada. Se não for fornecida, as mesclagens são carregadas de `merges_file`.
errors (`str`, *opcional*, padrão `"replace"`) : Paradigma a ser seguido ao decodificar bytes para UTF-8. Consulte [bytes.decode](https://docs.python.org/3/library/stdtypes.html#bytes.decode) para mais informações.
bos_token (`str`, *opcional*, padrão `""`) : O token de início de sequência usado durante o pré-treinamento. Pode ser usado como token de classificador de sequência. Ao construir uma sequência usando tokens especiais, este não é o token utilizado para o início da sequência. O token utilizado é o `cls_token`.
eos_token (`str`, *opcional*, padrão `""`) : O token de fim de sequência. Ao construir uma sequência usando tokens especiais, este não é o token utilizado para o fim da sequência. O token utilizado é o `sep_token`.
sep_token (`str`, *opcional*, padrão `""`) : O token separador, usado ao montar uma sequência a partir de múltiplas sequências, por exemplo, duas sequências para classificação de sequência ou um texto e uma pergunta para resposta a perguntas. Também é usado como o último token de uma sequência montada com tokens especiais.
cls_token (`str`, *opcional*, padrão `""`) : O token de classificador usado na classificação de sequência (classificação da sequência inteira, em vez da classificação por token). É o primeiro token da sequência quando esta é construída com tokens especiais.
unk_token (`str`, *opcional*, padrão `""`) : O token desconhecido. Um token que não está no vocabulário não pode ser convertido em um ID e é definido como este token em vez disso.
pad_token (`str`, *opcional*, padrão `""`) : O token usado para preenchimento, por exemplo, ao agrupar sequências de comprimentos diferentes.
mask_token (`str`, *opcional*, padrão `""`) : O token usado para mascarar valores. Este é o token utilizado ao treinar este modelo com modelagem de linguagem mascarada. É o token que o modelo tentará prever.
add_prefix_space (`bool`, *opcional*, padrão `False`) : Indica se deve ou não adicionar um espaço inicial à entrada. Isso permite tratar a palavra inicial como qualquer outra palavra. (O tokenizer do RoBERTa detecta o início das palavras pelo espaço que as precede).
Construa um tokenizador MarkupLM. Baseado em Byte-Pair-Encoding (BPE) em nível de bytes.
[MarkupLMTokenizer](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMTokenizer) pode ser usado para converter strings HTML em `input_ids`, `attention_mask`, `token_type_ids`, `xpath_tags_seq` e `xpath_tags_seq` no nível de tokens. Este tokenizer herda de [TokenizersBackend](/docs/transformers/main/pt/main_classes/tokenizer#transformers.TokenizersBackend), que contém a maioria dos métodos principais e garante que um backend `tokenizers` seja sempre instanciado.
Os usuários devem consultar esta superclasse para obter mais informações sobre esses métodos.
#### build_inputs_with_special_tokens[[transformers.MarkupLMTokenizer.build_inputs_with_special_tokens]]
```python
build_inputs_with_special_tokens(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L952)
**Parâmetros:**
token_ids_0 (`list[int]`) : Lista de IDs aos quais os tokens especiais serão adicionados.
token_ids_1 (`list[int]`, *opcional*) : Lista opcional de IDs para pares de sequências.
**Retorna:** `list[int]`
Lista de [IDs de entrada](../glossary#input-ids) com os tokens especiais apropriados.
Construa as entradas do modelo a partir de uma sequência ou de um par de sequências para tarefas de classificação de sequência, concatenando e adicionando tokens especiais. Uma sequência do RoBERTa tem o seguinte formato:
- sequência única: ` X `
- par de sequências: ` A B `
#### get_special_tokens_mask[[transformers.MarkupLMTokenizer.get_special_tokens_mask]]
```python
get_special_tokens_mask(token_ids_0: list[int], token_ids_1: list[int] | None = None, already_has_special_tokens: bool = False)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/tokenization_utils_base.py#L1338)
**Parâmetros:**
token_ids_0 : Lista de IDs da sequência (possivelmente já formatada).
token_ids_1 : Não utilizado quando `already_has_special_tokens=True`. Deve ser None nesse caso.
already_has_special_tokens : Indica se a sequência já está formatada com tokens especiais.
**Retorna:** Uma lista de inteiros no intervalo [0, 1]
1 para um token especial, 0 para um token de sequência.
Obter os ids de sequência de uma lista de tokens que não possui tokens especiais adicionados.
Para tokenizadores rápidos, os data collators chamam isso com `already_has_special_tokens=True` para construir uma máscara sobre uma sequência já formatada. Nesse caso, calculamos a máscara verificando a pertença em `all_special_ids`.
#### create_token_type_ids_from_sequences[[transformers.MarkupLMTokenizer.create_token_type_ids_from_sequences]]
```python
create_token_type_ids_from_sequences(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L975)
**Parâmetros:**
token_ids_0 (`list[int]`) : Lista de IDs.
token_ids_1 (`list[int]`, *opcional*) : Lista opcional de IDs para pares de sequências.
**Retorna:** `list[int]`
Lista de zeros.
Cria uma máscara a partir das duas sequências passadas para ser usada em uma tarefa de classificação de par de sequências. O RoBERTa não faz uso de ids de tipo de token, portanto, uma lista de zeros é retornada.
#### save_vocabulary[[transformers.MarkupLMTokenizer.save_vocabulary]]
```python
save_vocabulary(save_directory: str, filename_prefix: str | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L997)
## MarkupLMTokenizerFast[[transformers.MarkupLMTokenizer]]
#### transformers.MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
```python
transformers.MarkupLMTokenizer(tags_dict, vocab: str | dict[str, int] | list[tuple[str, float]] | None = None, merges: str | list[str] | None = None, errors = 'replace', bos_token = '', eos_token = '', sep_token = '', cls_token = '', unk_token = '', pad_token = '', mask_token = '', add_prefix_space = False, max_depth = 50, max_width = 1000, pad_width = 1001, pad_token_label = -100, only_label_first_subword = True, trim_offsets = False, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L91)
**Parâmetros:**
vocab (`str` ou `dict[str, int]`, *opcional*) : Dicionário de vocabulário personalizado. Se não for fornecido, o vocabulário é carregado a partir de `vocab_file`.
merges (`str` ou `list[str]`, *opcional*) : Lista de mesclagens personalizada. Se não for fornecida, as mesclagens são carregadas de `merges_file`.
errors (`str`, *opcional*, padrão `"replace"`) : Paradigma a ser seguido ao decodificar bytes para UTF-8. Consulte [bytes.decode](https://docs.python.org/3/library/stdtypes.html#bytes.decode) para mais informações.
bos_token (`str`, *opcional*, padrão `""`) : O token de início de sequência usado durante o pré-treinamento. Pode ser usado como token de classificador de sequência. Ao construir uma sequência usando tokens especiais, este não é o token utilizado para o início da sequência. O token utilizado é o `cls_token`.
eos_token (`str`, *opcional*, padrão `""`) : O token de fim de sequência. Ao construir uma sequência usando tokens especiais, este não é o token utilizado para o fim da sequência. O token utilizado é o `sep_token`.
sep_token (`str`, *opcional*, padrão `""`) : O token separador, usado ao montar uma sequência a partir de múltiplas sequências, por exemplo, duas sequências para classificação de sequência ou um texto e uma pergunta para resposta a perguntas. Também é usado como o último token de uma sequência montada com tokens especiais.
cls_token (`str`, *opcional*, padrão `""`) : O token de classificador usado na classificação de sequência (classificação da sequência inteira, em vez da classificação por token). É o primeiro token da sequência quando esta é construída com tokens especiais.
unk_token (`str`, *opcional*, padrão `""`) : O token desconhecido. Um token que não está no vocabulário não pode ser convertido em um ID e é definido como este token em vez disso.
pad_token (`str`, *opcional*, padrão `""`) : O token usado para preenchimento, por exemplo, ao agrupar sequências de comprimentos diferentes.
mask_token (`str`, *opcional*, padrão `""`) : O token usado para mascarar valores. Este é o token utilizado ao treinar este modelo com modelagem de linguagem mascarada. É o token que o modelo tentará prever.
add_prefix_space (`bool`, *opcional*, padrão `False`) : Indica se deve ou não adicionar um espaço inicial à entrada. Isso permite tratar a palavra inicial como qualquer outra palavra. (O tokenizer do RoBERTa detecta o início das palavras pelo espaço que as precede).
Construa um tokenizador MarkupLM. Baseado em Byte-Pair-Encoding (BPE) em nível de bytes.
[MarkupLMTokenizer](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMTokenizer) pode ser usado para converter strings HTML em `input_ids`, `attention_mask`, `token_type_ids`, `xpath_tags_seq` e `xpath_tags_seq` no nível de tokens. Este tokenizer herda de [TokenizersBackend](/docs/transformers/main/pt/main_classes/tokenizer#transformers.TokenizersBackend), que contém a maioria dos métodos principais e garante que um backend `tokenizers` seja sempre instanciado.
Os usuários devem consultar esta superclasse para obter mais informações sobre esses métodos.
#### batch_encode_plus[[transformers.MarkupLMTokenizer.batch_encode_plus]]
```python
batch_encode_plus(batch_text_or_text_pairs: list[str] | list[tuple[str, str]] | list[list[str]], is_pair: bool | None = None, xpaths: list[list[list[int]]] | None = None, node_labels: list[int] | list[list[int]] | None = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L453)
add_special_tokens (`bool`, *opcional*, padrão `True`): Indica se tokens especiais devem ser adicionados ao codificar as sequências. Isso utiliza a função subjacente `PretrainedTokenizerBase.build_inputs_with_special_tokens`, que define quais tokens são adicionados automaticamente aos ids de entrada. Isso é útil se você deseja adicionar automaticamente tokens `bos` ou `eos`. padding (`bool`, `str` ou [PaddingStrategy](/docs/transformers/main/pt/internal/file_utils#transformers.utils.PaddingStrategy), *opcional*, padrão `False`): Ativa e controla o padding. Aceita os seguintes valores:
- `True` ou `'longest'`: Preenche até a sequência mais longa do lote (ou não aplica preenchimento se apenas uma sequência for fornecida).
- `'max_length'`: Preenche até o comprimento máximo especificado pelo argumento `max_length` ou até o comprimento máximo aceitável de entrada para o modelo, caso esse argumento não seja fornecido.
- `False` ou `'do_not_pad'` (padrão): Sem padding (ou seja, pode gerar um lote com sequências de comprimentos diferentes).
truncation (`bool`, `str` ou [TruncationStrategy](/docs/transformers/main/pt/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *opcional*, padrão `False`): Ativa e controla a truncagem. Aceita os seguintes valores:
- `True` ou `'longest_first'`: Trunca para um comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo aceitável de entrada para o modelo, caso esse argumento não seja fornecido. Isso trunca token por token, removendo um token da sequência mais longa do par, se um par de sequências (ou um lote de pares) for fornecido.
- `'only_first'`: Trunca para o comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo aceitável de entrada do modelo, caso esse argumento não seja fornecido. Isso trunca apenas a primeira sequência de um par, se um par de sequências (ou um lote de pares) for fornecido.
- `'only_second'`: Trunca para um comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo aceitável de entrada para o modelo, caso esse argumento não seja fornecido. Isso trunca apenas a segunda sequência de um par, se um par de sequências (ou um lote de pares) for fornecido.
- `False` ou `'do_not_truncate'` (padrão): Sem truncamento (ou seja, pode gerar um lote com comprimentos de sequência maiores que o tamanho máximo de entrada aceito pelo modelo).
max_length (`int`, *opcional*): Controla o comprimento máximo a ser usado por um dos parâmetros de truncamento/padronização.
If left unset or set to `None`, this will use the predefined model maximum length if a maximum length is required by one of the truncation/padding parameters. If the model has no specific maximum input length (like XLNet) truncation/padding to a maximum length will be deactivated. stride (`int`, *optional*, defaults to 0): If set to a number along with `max_length`, the overflowing tokens returned when `return_overflowing_tokens=True` will contain some tokens from the end of the truncated sequence returned to provide some overlap between truncated and overflowing sequences. The value of this argument defines the number of overlapping tokens. is_split_into_words (`bool`, *optional*, defaults to `False`): Whether or not the input is already pre-tokenized (e.g., split into words). If set to `True`, the tokenizer assumes the input is already split into words (for instance, by splitting it on whitespace) which it will tokenize. This is useful for NER or token classification. pad_to_multiple_of (`int`, *optional*): If set will pad the sequence to a multiple of the provided value. Requires `padding` to be activated. This is especially useful to enable the use of Tensor Cores on NVIDIA hardware with compute capability `>= 7.5` (Volta). padding_side (`str`, *optional*): The side on which the model should have padding applied. Should be selected between ['right', 'left']. Default value is picked from the class attribute of the same name. return_tensors (`str` or [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *optional*): If set, will return tensors instead of list of python integers. Acceptable values are:
- `'pt'`: Retorna objetos `torch.Tensor` do PyTorch.
- `'np'`: Retorna objetos `np.ndarray` do Numpy.
add_special_tokens (`bool`, *opcional*, padrão `True`): Indica se as sequências devem ser codificadas com os tokens especiais relativos ao seu modelo. padding (`bool`, `str` ou [PaddingStrategy](/docs/transformers/main/pt/internal/file_utils#transformers.utils.PaddingStrategy), *opcional*, padrão `False`): Ativa e controla o padding. Aceita os seguintes valores:
- `True` ou `'longest'`: Preenche até a sequência mais longa do lote (ou não aplica preenchimento se apenas uma sequência for fornecida).
- `'max_length'`: Preenche até o comprimento máximo especificado pelo argumento `max_length` ou até o comprimento máximo aceitável de entrada para o modelo, caso esse argumento não seja fornecido.
- `False` ou `'do_not_pad'` (padrão): Sem padding (ou seja, pode gerar um lote com sequências de comprimentos diferentes).
truncation (`bool`, `str` ou [TruncationStrategy](/docs/transformers/main/pt/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *opcional*, padrão `False`): Ativa e controla a truncagem. Aceita os seguintes valores:
- `True` ou `'longest_first'`: Trunca para um comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo aceitável de entrada para o modelo, caso esse argumento não seja fornecido. Isso trunca token por token, removendo um token da sequência mais longa do par, se um par de sequências (ou um lote de pares) for fornecido.
- `'only_first'`: Trunca para o comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo aceitável de entrada do modelo, caso esse argumento não seja fornecido. Isso trunca apenas a primeira sequência de um par, se um par de sequências (ou um lote de pares) for fornecido.
- `'only_second'`: Trunca para um comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo aceitável de entrada para o modelo, caso esse argumento não seja fornecido. Isso trunca apenas a segunda sequência de um par, se um par de sequências (ou um lote de pares) for fornecido.
- `False` ou `'do_not_truncate'` (padrão): Sem truncamento (ou seja, pode gerar um lote com comprimentos de sequência maiores que o tamanho máximo de entrada aceito pelo modelo).
max_length (`int`, *opcional*): Controla o comprimento máximo a ser usado por um dos parâmetros de truncamento/pad. Se não for definido ou for definido como `None`, será usado o comprimento máximo predefinido do modelo, caso um comprimento máximo seja exigido por um dos parâmetros de truncamento/pad. Se o modelo não tiver um comprimento máximo de entrada específico (como o XLNet), o truncamento/pad para um comprimento máximo será desativado. stride (`int`, *opcional*, padrão 0): Se definido como um número junto com `max_length`, os tokens excedentes retornados quando `return_overflowing_tokens=True` conterão alguns tokens do final da sequência truncada retornada, para fornecer alguma sobreposição entre as sequências truncadas e excedentes. O valor deste argumento define o número de tokens sobrepostos. is_split_into_words (`bool`, *opcional*, padrão `False`): Indica se a entrada já está pré-tokenizada (por exemplo, dividida em palavras). Defina como `True` se estiver passando entradas pré-tokenizadas para evitar tokenização adicional. pad_to_multiple_of (`int`, *opcional*): Se definido, fará o pad da sequência para um múltiplo do valor fornecido. Isso é especialmente útil para habilitar o uso de Tensor Cores em hardware NVIDIA com capacidade de computação `>= 7.5` (Volta). return_tensors (`str` ou [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *opcional*): Se definido, retornará tensores em vez de listas de inteiros do Python. Os valores aceitos são:
- `'pt'`: Retorna objetos `torch.Tensor` do PyTorch.
- `'np'`: Retorna objetos `np.ndarray` do Numpy.
#### build_inputs_with_special_tokens[[transformers.MarkupLMTokenizer.build_inputs_with_special_tokens]]
```python
build_inputs_with_special_tokens(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L952)
**Parâmetros:**
token_ids_0 (`list[int]`) : Lista de IDs aos quais os tokens especiais serão adicionados.
token_ids_1 (`list[int]`, *opcional*) : Lista opcional de IDs para pares de sequências.
**Retorna:** `list[int]`
Lista de [IDs de entrada](../glossary#input-ids) com os tokens especiais apropriados.
Construa as entradas do modelo a partir de uma sequência ou de um par de sequências para tarefas de classificação de sequência, concatenando e adicionando tokens especiais. Uma sequência do RoBERTa tem o seguinte formato:
- sequência única: ` X `
- par de sequências: ` A B `
#### create_token_type_ids_from_sequences[[transformers.MarkupLMTokenizer.create_token_type_ids_from_sequences]]
```python
create_token_type_ids_from_sequences(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L975)
**Parâmetros:**
token_ids_0 (`list[int]`) : Lista de IDs.
token_ids_1 (`list[int]`, *opcional*) : Lista opcional de IDs para pares de sequências.
**Retorna:** `list[int]`
Lista de zeros.
Cria uma máscara a partir das duas sequências passadas para ser usada em uma tarefa de classificação de par de sequências. O RoBERTa não faz uso de ids de tipo de token, portanto, uma lista de zeros é retornada.
#### encode_plus[[transformers.MarkupLMTokenizer.encode_plus]]
```python
encode_plus(text: str | list[str], text_pair: list[str] | None = None, xpaths: list[list[int]] | None = None, node_labels: list[int] | None = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L518)
**Parâmetros:**
text (`str`, `list[str]`, `list[list[str]]`) : A primeira sequência a ser codificada. Pode ser uma string, uma lista de strings ou uma lista de listas de strings.
text_pair (`list[str]` ou `list[int]`, *opcional*) : Sequência secundária opcional a ser codificada. Pode ser uma lista de strings (palavras de um único exemplo) ou uma lista de listas de strings (palavras de um lote de exemplos).
add_special_tokens (`bool`, *opcional*, padrão `True`) : Indica se tokens especiais devem ser adicionados ao codificar as sequências. Isso utiliza a função subjacente `PretrainedTokenizerBase.build_inputs_with_special_tokens`, que define quais tokens são adicionados automaticamente aos ids de entrada. Isso é útil se você deseja adicionar automaticamente tokens `bos` ou `eos`.
padding (`bool`, `str` ou [PaddingStrategy](/docs/transformers/main/pt/internal/file_utils#transformers.utils.PaddingStrategy), *opcional*, padrão `False`) : Ativa e controla o padding. Aceita os seguintes valores: - `True` ou `'longest'`: Preenche até a sequência mais longa do lote (ou não aplica padding se apenas uma sequência for fornecida). - `'max_length'`: Preenche até o comprimento máximo especificado com o argumento `max_length` ou até o comprimento máximo aceitável de entrada para o modelo, caso esse argumento não seja fornecido. - `False` ou `'do_not_pad'` (padrão): Sem padding (ou seja, pode gerar um lote com sequências de comprimentos diferentes).
truncation (`bool`, `str` ou [TruncationStrategy](/docs/transformers/main/pt/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *opcional*, padrão `False`) : Ativa e controla a truncagem. Aceita os seguintes valores: - `True` ou `'longest_first'`: Trunca para um comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo de entrada aceitável para o modelo, caso esse argumento não seja fornecido. Isso trunca token por token, removendo um token da sequência mais longa do par, se um par de sequências (ou um lote de pares) for fornecido. - `'only_first'`: Trunca para um comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo de entrada aceitável para o modelo, caso esse argumento não seja fornecido. Isso trunca apenas a primeira sequência de um par, se um par de sequências (ou um lote de pares) for fornecido. - `'only_second'`: Trunca para um comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo de entrada aceitável para o modelo, caso esse argumento não seja fornecido. Isso trunca apenas a segunda sequência de um par, se um par de sequências (ou um lote de pares) for fornecido. - `False` ou `'do_not_truncate'` (padrão): Sem truncagem (ou seja, pode gerar um lote com comprimentos de sequência maiores que o tamanho máximo de entrada admissível do modelo).
max_length (`int`, *opcional*) : Controla o comprimento máximo a ser usado por um dos parâmetros de truncamento/preenchimento. Se não for definido ou for definido como `None`, será usado o comprimento máximo predefinido do modelo, caso um dos parâmetros de truncamento/preenchimento exija um comprimento máximo. Se o modelo não tiver um comprimento máximo de entrada específico (como o XLNet), o truncamento/preenchimento até um comprimento máximo será desativado.
stride (`int`, *opcional*, padrão 0) : Se definido como um número junto com `max_length`, os tokens excedentes retornados quando `return_overflowing_tokens=True` conterão alguns tokens do final da sequência truncada retornada, para fornecer alguma sobreposição entre as sequências truncada e excedente. O valor deste argumento define o número de tokens sobrepostos.
is_split_into_words (`bool`, *opcional*, padrão `False`) : Indica se a entrada já está pré-tokenizada (por exemplo, dividida em palavras). Se definido como `True`, o tokenizer assume que a entrada já foi dividida em palavras (por exemplo, separando por espaços em branco) e a tokenizará. Isso é útil para NER ou classificação de tokens.
pad_to_multiple_of (`int`, *opcional*) : Se definido, a sequência será preenchida até um múltiplo do valor fornecido. Exige que `padding` esteja ativado. Isso é especialmente útil para habilitar o uso de Tensor Cores em hardware NVIDIA com capacidade de computação `>= 7.5` (Volta).
padding_side (`str`, *opcional*) : O lado em que o modelo deve ter padding aplicado. Deve ser selecionado entre ['right', 'left']. O valor padrão é obtido do atributo de classe com o mesmo nome.
return_tensors (`str` ou [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *opcional*) : Se definido, retornará tensores em vez de lista de inteiros do Python. Os valores aceitos são: - `'pt'`: Retorna objetos `torch.Tensor` do PyTorch. - `'np'`: Retorna objetos `np.ndarray` do Numpy.
add_special_tokens (`bool`, *opcional*, padrão `True`) : Se as sequências devem ser codificadas com os tokens especiais relativos ao seu modelo.
padding (`bool`, `str` ou [PaddingStrategy](/docs/transformers/main/pt/internal/file_utils#transformers.utils.PaddingStrategy), *opcional*, padrão `False`) : Ativa e controla o padding. Aceita os seguintes valores: - `True` ou `'longest'`: Preenche até a sequência mais longa do lote (ou não aplica padding se apenas uma sequência for fornecida). - `'max_length'`: Preenche até o comprimento máximo especificado com o argumento `max_length` ou até o comprimento máximo aceitável de entrada para o modelo, caso esse argumento não seja fornecido. - `False` ou `'do_not_pad'` (padrão): Sem padding (ou seja, pode gerar um lote com sequências de comprimentos diferentes).
truncation (`bool`, `str` ou [TruncationStrategy](/docs/transformers/main/pt/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *opcional*, padrão `False`) : Ativa e controla a truncagem. Aceita os seguintes valores: - `True` ou `'longest_first'`: Trunca para um comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo de entrada aceitável para o modelo, caso esse argumento não seja fornecido. Isso trunca token por token, removendo um token da sequência mais longa do par, se um par de sequências (ou um lote de pares) for fornecido. - `'only_first'`: Trunca para um comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo de entrada aceitável para o modelo, caso esse argumento não seja fornecido. Isso trunca apenas a primeira sequência de um par, se um par de sequências (ou um lote de pares) for fornecido. - `'only_second'`: Trunca para um comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo de entrada aceitável para o modelo, caso esse argumento não seja fornecido. Isso trunca apenas a segunda sequência de um par, se um par de sequências (ou um lote de pares) for fornecido. - `False` ou `'do_not_truncate'` (padrão): Sem truncagem (ou seja, pode gerar um lote com comprimentos de sequência maiores que o tamanho máximo de entrada admissível do modelo).
max_length (`int`, *opcional*) : Controla o comprimento máximo a ser usado por um dos parâmetros de truncamento/preenchimento. Se não for definido ou for definido como `None`, isso usará o comprimento máximo predefinido do modelo, caso um comprimento máximo seja exigido por um dos parâmetros de truncamento/preenchimento. Se o modelo não tiver um comprimento máximo específico de entrada (como o XLNet), o truncamento/preenchimento para um comprimento máximo será desativado.
stride (`int`, *opcional*, padrão 0) : Se definido como um número junto com `max_length`, os tokens excedentes retornados quando `return_overflowing_tokens=True` conterão alguns tokens do final da sequência truncada retornada, para fornecer alguma sobreposição entre as sequências truncada e excedente. O valor deste argumento define o número de tokens sobrepostos.
is_split_into_words (`bool`, *opcional*, padrão `False`) : Indica se a entrada já está pré-tokenizada (por exemplo, dividida em palavras). Defina como `True` se estiver passando entradas pré-tokenizadas para evitar uma tokenização adicional.
pad_to_multiple_of (`int`, *opcional*) : Se definido, a sequência será preenchida até um múltiplo do valor fornecido. Isso é especialmente útil para habilitar o uso de Tensor Cores em hardware NVIDIA com capacidade de computação `>= 7.5` (Volta).
return_tensors (`str` ou [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *opcional*) : Se definido, retornará tensores em vez de lista de inteiros do Python. Os valores aceitos são: - `'pt'`: Retorna objetos `torch.Tensor` do PyTorch. - `'np'`: Retorna objetos `np.ndarray` do Numpy.
Tokenize e prepare para o modelo uma sequência ou um par de sequências. .. warning:: Este método está obsoleto, `__call__` deve ser usado em vez dele.
#### get_xpath_seq[[transformers.MarkupLMTokenizer.get_xpath_seq]]
```python
get_xpath_seq(xpath)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/tokenization_markuplm.py#L253)
Dada a expressão xpath de um nó específico (como "/html/body/div/li[1]/div/span[2]"), retorna uma lista de IDs de tags e os subíndices correspondentes, levando em conta a profundidade máxima.
## MarkupLMProcessor[[transformers.MarkupLMProcessor]]
#### transformers.MarkupLMProcessor[[transformers.MarkupLMProcessor]]
```python
transformers.MarkupLMProcessor(feature_extractor, tokenizer)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/processing_markuplm.py#L25)
**Parâmetros:**
feature_extractor (`feature_extractor_class`) : O extrator de recursos é uma entrada obrigatória.
tokenizer (`MarkupLMTokenizer`) : O tokenizer é uma entrada obrigatória.
Constrói um MarkupLMProcessor que encapsula um extrator de recursos e um tokenizador em um único processador.
[MarkupLMProcessor](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMProcessor) oferece todas as funcionalidades de `feature_extractor_class` e [MarkupLMTokenizer](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMTokenizer). Consulte `~feature_extractor_class` e [~MarkupLMTokenizer](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMTokenizer) para mais informações.
#### __call__[[transformers.MarkupLMProcessor.__call__]]
```python
__call__(html_strings = None, nodes = None, xpaths = None, node_labels = None, questions = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, return_tensors: str | transformers.utils.generic.TensorType | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/processing_markuplm.py#L31)
**Parâmetros:**
html_strings (`str` ou `list[str]`, *opcional*) : Strings HTML brutas para analisar e processar. Quando `parse_html=True` (padrão), essas strings são analisadas para extrair automaticamente os nós e os xpaths. Se fornecidas, `nodes`, `xpaths` e `node_labels` não devem ser fornecidas. Obrigatório quando `parse_html=True`.
nodes (`list[list[str]]`, *opcional*) : Nós HTML pré-extraídos como uma lista de listas, em que cada lista interna contém o conteúdo de texto dos nós de um único documento. Obrigatório quando `parse_html=False`. Não deve ser fornecido quando `parse_html=True`.
xpaths (`list[list[str]]`, *opcional*) : Expressões XPath pré-extraídas correspondentes aos nós. Deve ser uma lista de listas com a mesma estrutura de `nodes`, em que cada XPath identifica a localização do nó correspondente na árvore HTML. Obrigatório quando `parse_html=False`. Não deve ser fornecido quando `parse_html=True`.
node_labels (`list[list[int]]`, *opcional*) : Rótulos para os nós, geralmente usados em tarefas de treinamento ou ajuste fino. Deve ser uma lista de listas com a mesma estrutura de `nodes`, em que cada rótulo corresponde a um nó. Opcional e usado apenas quando `parse_html=False`.
questions (`str` ou `list[str]`, *opcional*) : Strings de perguntas para tarefas de question-answering. Quando fornecidas, o tokenizer processa as perguntas como a primeira sequência e os nós como a segunda sequência (text_pair). Se uma única string for fornecida, ela é convertida em uma lista para corresponder à dimensão do lote do HTML analisado.
add_special_tokens (`bool`, *opcional*, padrão `True`) : Indica se tokens especiais devem ser adicionados ao codificar as sequências. Isso utiliza a função subjacente `PretrainedTokenizerBase.build_inputs_with_special_tokens`, que define quais tokens são adicionados automaticamente aos ids de entrada. Isso é útil se você deseja adicionar automaticamente tokens `bos` ou `eos`.
padding (bool, str ou [PaddingStrategy](/docs/transformers/main/pt/internal/file_utils#transformers.utils.PaddingStrategy), *opcional*, padrão `False`) : Ativa e controla o padding. Aceita os seguintes valores: - `True` ou `'longest'`: Preenche até a sequência mais longa do lote (ou não aplica padding se apenas uma sequência for fornecida). - `'max_length'`: Preenche até o comprimento máximo especificado com o argumento `max_length` ou até o comprimento máximo aceitável de entrada para o modelo, caso esse argumento não seja fornecido. - `False` ou `'do_not_pad'` (padrão): Sem padding (ou seja, pode gerar um lote com sequências de comprimentos diferentes).
truncation (bool, str ou [TruncationStrategy](/docs/transformers/main/pt/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *opcional*) : Ativa e controla a truncagem. Aceita os seguintes valores: - `True` ou `'longest_first'`: Trunca para um comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo de entrada aceitável pelo modelo, caso esse argumento não seja fornecido. Isso trunca token por token, removendo um token da sequência mais longa do par, se um par de sequências (ou um lote de pares) for fornecido. - `'only_first'`: Trunca para um comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo de entrada aceitável pelo modelo, caso esse argumento não seja fornecido. Isso trunca apenas a primeira sequência de um par, se um par de sequências (ou um lote de pares) for fornecido. - `'only_second'`: Trunca para um comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo de entrada aceitável pelo modelo, caso esse argumento não seja fornecido. Isso trunca apenas a segunda sequência de um par, se um par de sequências (ou um lote de pares) for fornecido. - `False` ou `'do_not_truncate'` (padrão): Sem truncagem (ou seja, pode gerar um lote com comprimentos de sequência maiores que o tamanho máximo de entrada admissível pelo modelo).
max_length (`int`, *opcional*) : Controla o comprimento máximo a ser usado por um dos parâmetros de truncamento/preenchimento. Se não for definido ou for definido como `None`, será usado o comprimento máximo predefinido do modelo, caso um dos parâmetros de truncamento/preenchimento exija um comprimento máximo. Se o modelo não tiver um comprimento máximo de entrada específico (como o XLNet), o truncamento/preenchimento até um comprimento máximo será desativado.
stride (`int`, *opcional*, padrão `0`) : Se definido como um número junto com `max_length`, os tokens excedentes retornados quando `return_overflowing_tokens=True` conterão alguns tokens do final da sequência truncada retornada, para fornecer alguma sobreposição entre as sequências truncada e excedente. O valor deste argumento define o número de tokens sobrepostos.
pad_to_multiple_of (`int`, *opcional*) : Se definido, a sequência será preenchida até um múltiplo do valor fornecido. Exige que `padding` esteja ativado. Isso é especialmente útil para permitir o uso de Tensor Cores em hardware NVIDIA com capacidade de computação `>= 7.5` (Volta).
return_token_type_ids (`bool`, *opcional*) : Se deve retornar os IDs de tipo de token. Se mantido no padrão, retornará os IDs de tipo de token de acordo com o padrão do tokenizer específico, definido pelo atributo `return_outputs`. [O que são IDs de tipo de token?](../glossary#token-type-ids)
return_attention_mask (`bool`, *opcional*) : Indica se a máscara de atenção deve ser retornada. Se mantido o valor padrão, a máscara de atenção será retornada de acordo com o padrão do tokenizer específico, definido pelo atributo `return_outputs`. [O que são máscaras de atenção?](../glossary#attention-mask)
return_overflowing_tokens (`bool`, *opcional*, padrão `False`) : Indica se as sequências de tokens que excedem o limite devem ser retornadas. Se um par de sequências de ids de entrada (ou um lote de pares) for fornecido com `truncation_strategy = longest_first` ou `True`, um erro será lançado em vez de retornar os tokens excedentes.
return_special_tokens_mask (`bool`, *opcional*, padrão `False`) : Se deve ou não retornar informações da máscara de tokens especiais.
return_offsets_mapping (`bool`, *opcional*, padrão `False`) : Indica se deve ou não retornar `(char_start, char_end)` para cada token. Isso está disponível apenas em tokenizadores rápidos que herdam de [PreTrainedTokenizerFast](/docs/transformers/main/pt/main_classes/tokenizer#transformers.TokenizersBackend); se estiver usando o tokenizador do Python, este método lançará `NotImplementedError`.
return_length (`bool`, *opcional*, padrão `False`) : Indica se os comprimentos das entradas codificadas devem ser retornados.
verbose (`bool`, *opcional*, padrão `True`) : Se deve ou não exibir mais informações e avisos.
return_tensors (`Union[str, ~utils.generic.TensorType]`, *opcional*) : Se definido, retornará tensors de um framework específico. Os valores aceitos são: - `'pt'`: Retorna objetos `torch.Tensor` do PyTorch. - `'np'`: Retorna objetos `np.ndarray` do NumPy.
**Retorna:** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`, *opcional*) -- Dicionário de listas/arrays/tensors retornados pelos métodos `__call__`/`encode_plus`/`batch_encode_plus` ('input_ids', 'attention_mask', etc.).
- **encoding** (`tokenizers.Encoding` ou `Sequence[tokenizers.Encoding]`, *opcional*) -- Se o tokenizer for um fast tokenizer que fornece informações adicionais, como o mapeamento do espaço de palavras/caracteres para o espaço de tokens, a instância de `tokenizers.Encoding` ou a lista de instâncias (para lotes) armazena essas informações.
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
- **prepend_batch_axis** (`bool`, *opcional*, padrão `False`) -- Indica se deve ou não adicionar um eixo de lote ao converter para tensores (veja `tensor_type` acima). Observe que este parâmetro tem efeito se o parâmetro `tensor_type` estiver definido, *caso contrário, não tem efeito*.
- **n_sequences** (`int`, *opcional*) -- O número de sequências de entrada representadas por cada codificação (`None` para desconhecido, `1` para uma única sequência e `2` para um par de sequências).
## MarkupLMModel[[transformers.MarkupLMModel]]
#### transformers.MarkupLMModel[[transformers.MarkupLMModel]]
```python
transformers.MarkupLMModel(config: MarkupLMConfig, add_pooling_layer = True)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L497)
**Parâmetros:**
config ([MarkupLMConfig](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
add_pooling_layer (`bool`, *opcional*, padrão `True`) : Se deve adicionar uma camada de pooling
O modelo Markuplm básico que produz estados ocultos brutos sem nenhum cabeçalho específico no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.MarkupLMModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, xpath_tags_seq: typing.Optional[torch.LongTensor] = None, xpath_subs_seq: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L521)
**Parâmetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor` de forma `(batch_size, sequence_length, config.max_depth)`, *opcional*) : IDs de tags para cada token na sequência de entrada, preenchidos até config.max_depth.
xpath_subs_seq (`torch.LongTensor` de forma `(batch_size, sequence_length, config.max_depth)`, *opcional*) : IDs de subscrito para cada token na sequência de entrada, preenchidos até config.max_depth.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar as primeiras e segundas porções das entradas. Os índices são selecionados em `[0, 1]`: - 0 corresponde a um token de *frase A*, - 1 corresponde a um token de *frase B*. [O que são IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
**Retorna:** [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([MarkupLMConfig](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMConfig)) e das entradas.
O método forward do [MarkupLMModel](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMModel) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> from transformers import AutoProcessor, MarkupLMModel
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> model = MarkupLMModel.from_pretrained("microsoft/markuplm-base")
>>> html_string = " Page Title "
>>> encoding = processor(html_string, return_tensors="pt")
>>> outputs = model(**encoding)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 4, 768]
```
## MarkupLMForSequenceClassification[[transformers.MarkupLMForSequenceClassification]]
#### transformers.MarkupLMForSequenceClassification[[transformers.MarkupLMForSequenceClassification]]
```python
transformers.MarkupLMForSequenceClassification(config: MarkupLMConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L802)
**Parâmetros:**
config ([MarkupLMConfig](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo MarkupLM transformer com uma cabeça de classificação/regressão de sequência no topo (uma camada linear sobre a saída agregada), por exemplo, para tarefas GLUE.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.MarkupLMForSequenceClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L819)
**Parâmetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor` de forma `(batch_size, sequence_length, config.max_depth)`, *opcional*) : IDs de tags para cada token na sequência de entrada, preenchidos até config.max_depth.
xpath_subs_seq (`torch.LongTensor` de forma `(batch_size, sequence_length, config.max_depth)`, *opcional*) : IDs de subscrito para cada token na sequência de entrada, preenchidos até config.max_depth.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em `[0, 1]`: - 0 corresponde a um token de *frase A*, - 1 corresponde a um token de *frase B*. [O que são IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para o cálculo da perda de classificação/regressão de sequência. Os índices devem estar em `[0, ..., config.num_labels - 1]`. Se `config.num_labels == 1`, uma perda de regressão é calculada (perda de erro quadrático médio). Se `config.num_labels > 1`, uma perda de classificação é calculada (entropia cruzada).
**Retorna:** [SequenceClassifierOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) ou `tuple(torch.Tensor)`
Um [SequenceClassifierOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([MarkupLMConfig](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMConfig)) e das entradas.
O método forward de [MarkupLMForSequenceClassification](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMForSequenceClassification) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação (ou de regressão se config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> from transformers import AutoProcessor, AutoModelForSequenceClassification
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> model = AutoModelForSequenceClassification.from_pretrained("microsoft/markuplm-base", num_labels=7)
>>> html_string = " Page Title "
>>> encoding = processor(html_string, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> loss = outputs.loss
>>> logits = outputs.logits
```
## MarkupLMForTokenClassification[[transformers.MarkupLMForTokenClassification]]
#### transformers.MarkupLMForTokenClassification[[transformers.MarkupLMForTokenClassification]]
```python
transformers.MarkupLMForTokenClassification(config: MarkupLMConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L709)
**Parâmetros:**
config ([MarkupLMConfig](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo MarkupLM com um cabeçalho `token_classification` no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.MarkupLMForTokenClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L725)
**Parâmetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor` de forma `(batch_size, sequence_length, config.max_depth)`, *opcional*) : IDs de tags para cada token na sequência de entrada, preenchidos até config.max_depth.
xpath_subs_seq (`torch.LongTensor` de forma `(batch_size, sequence_length, config.max_depth)`, *opcional*) : IDs de subscrito para cada token na sequência de entrada, preenchidos até config.max_depth.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em `[0, 1]`: - 0 corresponde a um token de *frase A*, - 1 corresponde a um token de *frase B*. [O que são IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
labels (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Rótulos para calcular a perda de classificação de tokens. Os índices devem estar em `[0, ..., config.num_labels - 1]`.
**Retorna:** [MaskedLMOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) ou `tuple(torch.Tensor)`
Um [MaskedLMOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([MarkupLMConfig](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMConfig)) e das entradas.
O método forward de [MarkupLMForTokenClassification](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMForTokenClassification) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de modelagem de linguagem mascarada (MLM).
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> from transformers import AutoProcessor, AutoModelForTokenClassification
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> processor.parse_html = False
>>> model = AutoModelForTokenClassification.from_pretrained("microsoft/markuplm-base", num_labels=7)
>>> nodes = ["hello", "world"]
>>> xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span"]
>>> node_labels = [1, 2]
>>> encoding = processor(nodes=nodes, xpaths=xpaths, node_labels=node_labels, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> loss = outputs.loss
>>> logits = outputs.logits
```
## MarkupLMForQuestionAnswering[[transformers.MarkupLMForQuestionAnswering]]
#### transformers.MarkupLMForQuestionAnswering[[transformers.MarkupLMForQuestionAnswering]]
```python
transformers.MarkupLMForQuestionAnswering(config: MarkupLMConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L603)
**Parâmetros:**
config ([MarkupLMConfig](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O transformer Markuplm com uma cabeça de classificação de spans no topo para tarefas de resposta a perguntas extrativas, como SQuAD (uma camada linear no topo da saída dos hidden-states para calcular `span start logits` e `span end logits`).
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.MarkupLMForQuestionAnswering.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, start_positions: typing.Optional[torch.Tensor] = None, end_positions: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/markuplm/modeling_markuplm.py#L615)
**Parâmetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor` de forma `(batch_size, sequence_length, config.max_depth)`, *opcional*) : IDs de tags para cada token na sequência de entrada, preenchidos até config.max_depth.
xpath_subs_seq (`torch.LongTensor` de forma `(batch_size, sequence_length, config.max_depth)`, *opcional*) : IDs de subscrito para cada token na sequência de entrada, preenchidos até config.max_depth.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em `[0, 1]`: - 0 corresponde a um token de *frase A*, - 1 corresponde a um token de *frase B*. [O que são IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
start_positions (`torch.Tensor` de forma `(batch_size,)`, *opcional*) : Rótulos para a posição (índice) do início do trecho rotulado para o cálculo da perda de classificação de tokens. As posições são limitadas ao comprimento da sequência (`sequence_length`). Posições fora da sequência não são consideradas no cálculo da perda.
end_positions (`torch.Tensor` de forma `(batch_size,)`, *opcional*) : Rótulos para a posição (índice) do final do trecho rotulado para o cálculo da perda de classificação de tokens. As posições são limitadas ao comprimento da sequência (`sequence_length`). Posições fora da sequência não são consideradas no cálculo da perda.
**Retorna:** [QuestionAnsweringModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) ou `tuple(torch.Tensor)`
Um [QuestionAnsweringModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([MarkupLMConfig](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMConfig)) e das entradas.
O método forward de [MarkupLMForQuestionAnswering](/docs/transformers/main/pt/model_doc/markuplm#transformers.MarkupLMForQuestionAnswering) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecida) -- A perda total de extração de spans é a soma de uma Cross-Entropy para as posições de início e fim.
- **start_logits** (`torch.Tensor` de forma `(batch_size, sequence_length)`) -- Pontuações de início de span (antes do SoftMax).
- **end_logits** (`torch.Tensor` de forma `(batch_size, sequence_length)`) -- Pontuações de fim de span (antes do SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> from transformers import AutoProcessor, MarkupLMForQuestionAnswering
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base-finetuned-websrc")
>>> model = MarkupLMForQuestionAnswering.from_pretrained("microsoft/markuplm-base-finetuned-websrc")
>>> html_string = " My name is Niels "
>>> question = "What's his name?"
>>> encoding = processor(html_string, questions=question, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> answer_start_index = outputs.start_logits.argmax()
>>> answer_end_index = outputs.end_logits.argmax()
>>> predict_answer_tokens = encoding.input_ids[0, answer_start_index : answer_end_index + 1]
>>> processor.decode(predict_answer_tokens).strip()
'Niels'
```