# Nougat
## Visão geral
O modelo Nougat foi proposto em [Nougat: Neural Optical Understanding for Academic Documents](https://huggingface.co/papers/2308.13418) por Lukas Blecher, Guillem Cucurull, Thomas Scialom, Robert Stojnic. O Nougat utiliza a mesma arquitetura que o [Donut](donut), ou seja, um codificador Transformer de imagem e um decodificador Transformer de texto autoregressivo para traduzir PDFs científicos para markdown, facilitando o acesso a eles.
O resumo do artigo é o seguinte:
*O conhecimento científico é armazenado predominantemente em livros e periódicos científicos, muitas vezes na forma de PDFs. No entanto, o formato PDF resulta em perda de informações semânticas, especialmente para expressões matemáticas. Propomos o Nougat (Neural Optical Understanding for Academic Documents), um modelo Visual Transformer que executa uma tarefa de Reconhecimento Óptico de Caracteres (OCR) para processar documentos científicos em uma linguagem de marcação, e demonstramos a eficácia do nosso modelo em um novo conjunto de dados de documentos científicos. A abordagem proposta oferece uma solução promissora para aprimorar a acessibilidade do conhecimento científico na era digital, ao reduzir a lacuna entre documentos legíveis por humanos e texto legível por máquinas. Liberamos os modelos e o código para acelerar trabalhos futuros sobre reconhecimento de texto científico.*
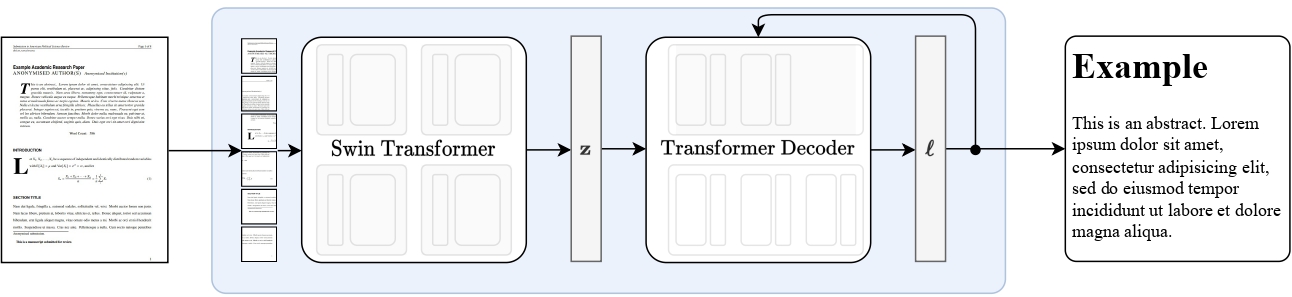 Visão geral de alto nível do Nougat. Retirado do artigo original.
Este modelo foi contribuído por [nielsr](https://huggingface.co/nielsr). O código original pode ser encontrado [aqui](https://github.com/facebookresearch/nougat).
## Dicas de uso
- A maneira mais rápida de começar com o Nougat é consultar os [notebooks de tutorial](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Nougat), que mostram como usar o modelo no momento da inferência, bem como como fazer fine-tuning em dados personalizados.
- O Nougat é sempre utilizado dentro do framework [VisionEncoderDecoder](vision-encoder-decoder). O modelo é idêntico ao [Donut](donut) em termos de arquitetura.
## Inferência
O modelo `VisionEncoderDecoder` do Nougat aceita imagens como entrada e utiliza [generate()](/docs/transformers/main/pt/main_classes/text_generation#transformers.GenerationMixin.generate) para gerar texto de forma autoregressiva com base na imagem de entrada.
A classe [NougatImageProcessor](/docs/transformers/main/pt/model_doc/nougat#transformers.NougatImageProcessor) é responsável pelo pré-processamento da imagem de entrada e o [NougatTokenizerFast](/docs/transformers/main/pt/model_doc/nougat#transformers.NougatTokenizer) decodifica os tokens de destino gerados para a string de destino. O [NougatProcessor](/docs/transformers/main/pt/model_doc/nougat#transformers.NougatProcessor) agrupa as classes [NougatImageProcessor](/docs/transformers/main/pt/model_doc/nougat#transformers.NougatImageProcessor) e [NougatTokenizerFast](/docs/transformers/main/pt/model_doc/nougat#transformers.NougatTokenizer) em uma única instância para extrair os recursos de entrada e decodificar os ids de tokens previstos.
- Transcrição de PDF passo a passo
```python
from huggingface_hub import hf_hub_download
from PIL import Image
from transformers import AutoModelForImageTextToText, NougatProcessor
processor = NougatProcessor.from_pretrained("facebook/nougat-base")
model = AutoModelForImageTextToText.from_pretrained("facebook/nougat-base", device_map="auto")
model.to(model.device) # doctest: +IGNORE_RESULT
# prepare PDF image for the model
filepath = hf_hub_download(repo_id="hf-internal-testing/fixtures_docvqa", filename="nougat_paper.png", repo_type="dataset")
image = Image.open(filepath)
pixel_values = processor(image, return_tensors="pt").to(model.device).pixel_values
# generate transcription (here we only generate 30 tokens)
outputs = model.generate(
pixel_values.to(model.device),
min_length=1,
max_new_tokens=30,
bad_words_ids=[[processor.tokenizer.unk_token_id]],
)
sequence = processor.batch_decode(outputs, skip_special_tokens=True)[0]
sequence = processor.post_process_generation(sequence, fix_markdown=False)
# note: we're using repr here such for the sake of printing the \n characters, feel free to just print the sequence
print(repr(sequence))
'\n\n# Nougat: Neural Optical Understanding for Academic Documents\n\n Lukas Blecher\n\nCorrespondence to: lblecher@'
```
Veja o [model hub](https://huggingface.co/models?filter=nougat) para procurar checkpoints do Nougat.
O modelo é idêntico ao [Donut](donut) em termos de arquitetura.
## NougatConfig[[transformers.NougatConfig]]
#### transformers.NougatConfig[[transformers.NougatConfig]]
```python
transformers.NougatConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, encoder: dict | transformers.configuration_utils.PreTrainedConfig | None = None, decoder: dict | transformers.configuration_utils.PreTrainedConfig | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/configuration_nougat.py#L28)
**Parâmetros:**
is_encoder_decoder (`bool`, *opcional*, padrão `True`) : Indica se o modelo é usado como codificador/decodificador ou não.
encoder (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : O objeto de configuração ou dicionário do backbone do codificador.
decoder (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : O objeto de configuração ou dicionário do backbone do decodificador.
Esta é a classe de configuração para armazenar a configuração de um NougatModel. Ela é usada para instanciar um modelo Nougat de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [facebook/nougat-base](https://huggingface.co/facebook/nougat-base)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplos:
```python
>>> from transformers import NougatConfig, VisionEncoderDecoderModel
>>> # Initializing a Nougat configuration
>>> config = NougatConfig()
>>> # Initializing a VisionEncoderDecoder model (with random weights) from a Nougat configurations
>>> model = VisionEncoderDecoderModel(config=config)
```
#### from_encoder_decoder_configs[[transformers.NougatConfig.from_encoder_decoder_configs]]
```python
from_encoder_decoder_configs(encoder_config: PreTrainedConfig, decoder_config: PreTrainedConfig, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/configuration_nougat.py#L52)
**Retorna:** [VisionEncoderDecoderConfig](/docs/transformers/main/pt/model_doc/vision-encoder-decoder#transformers.VisionEncoderDecoderConfig)
Uma instância de um objeto de configuração
Instancie um [VisionEncoderDecoderConfig](/docs/transformers/main/pt/model_doc/vision-encoder-decoder#transformers.VisionEncoderDecoderConfig) (ou uma classe derivada) a partir de uma configuração de modelo de codificador pré-treinado e uma configuração de modelo de decodificador.
## NougatImageProcessor[[transformers.NougatImageProcessor]]
#### transformers.NougatImageProcessor[[transformers.NougatImageProcessor]]
```python
transformers.NougatImageProcessor(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/image_processing_nougat.py#L57)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 896, 'width': 672}`): Descreve as dimensões de entrada máximas para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `2`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.485, 0.456, 0.406]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.229, 0.224, 0.225]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*, padrão `True`) : Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
do_crop_margin (`bool`, *kwargs*, *opcional*, padrão é `self.do_crop_margin`) : Se as margens da imagem devem ser recortadas.
do_thumbnail (`bool`, *kwargs*, *opcional*, padrão `self.do_thumbnail`) : Se deve redimensionar a imagem usando o método thumbnail.
do_align_long_axis (`bool`, *kwargs*, *opcional*, padrão `self.do_align_long_axis`) : Se deve alinhar o eixo longo da imagem com o eixo longo de `size` por meio de uma rotação de 90 graus.
Constrói um processador de imagem NougatImageProcessor.
#### preprocess[[transformers.NougatImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/image_processing_nougat.py#L74)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
do_crop_margin (`bool`, *kwargs*, *opcional*, padrão é `self.do_crop_margin`) : Se as margens da imagem devem ser recortadas.
do_thumbnail (`bool`, *kwargs*, *opcional*, padrão `self.do_thumbnail`) : Se deve redimensionar a imagem usando o método thumbnail.
do_align_long_axis (`bool`, *kwargs*, *opcional*, padrão `self.do_align_long_axis`) : Se deve alinhar o eixo longo da imagem com o eixo longo de `size` por meio de uma rotação de 90 graus.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
## NougatImageProcessorPil[[transformers.NougatImageProcessorPil]]
#### transformers.NougatImageProcessorPil[[transformers.NougatImageProcessorPil]]
```python
transformers.NougatImageProcessorPil(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/image_processing_pil_nougat.py#L59)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 896, 'width': 672}`): Descreve as dimensões de entrada máximas para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `2`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.485, 0.456, 0.406]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.229, 0.224, 0.225]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*, padrão `True`) : Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
do_crop_margin (`bool`, *kwargs*, *opcional*, padrão é `self.do_crop_margin`) : Se as margens da imagem devem ser recortadas.
do_thumbnail (`bool`, *kwargs*, *opcional*, padrão `self.do_thumbnail`) : Se deve redimensionar a imagem usando o método thumbnail.
do_align_long_axis (`bool`, *kwargs*, *opcional*, padrão `self.do_align_long_axis`) : Se deve alinhar o eixo longo da imagem com o eixo longo de `size` por meio de uma rotação de 90 graus.
Constrói um processador de imagem NougatImageProcessor.
#### preprocess[[transformers.NougatImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/image_processing_pil_nougat.py#L76)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
do_crop_margin (`bool`, *kwargs*, *opcional*, padrão é `self.do_crop_margin`) : Se as margens da imagem devem ser recortadas.
do_thumbnail (`bool`, *kwargs*, *opcional*, padrão `self.do_thumbnail`) : Se deve redimensionar a imagem usando o método thumbnail.
do_align_long_axis (`bool`, *kwargs*, *opcional*, padrão `self.do_align_long_axis`) : Se deve alinhar o eixo longo da imagem com o eixo longo de `size` por meio de uma rotação de 90 graus.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
## NougatTokenizer[[transformers.NougatTokenizer]]
#### transformers.NougatTokenizer[[transformers.NougatTokenizer]]
```python
transformers.NougatTokenizer(errors: str = 'replace', unk_token: str = '', bos_token: str = '
', eos_token: str = '', pad_token: str = '', vocab: str | dict | list | None = None, merges: str | list | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/tokenization_nougat.py#L347)
**Parâmetros:**
vocab_file (`str`, *opcional*) : Caminho para o arquivo de vocabulário.
merges_file (`str`, *opcional*) : Caminho para o arquivo de mesclagens.
tokenizer_file (`str`, *opcional*) : arquivo [tokenizers](https://github.com/huggingface/tokenizers) (geralmente com extensão .json) que contém tudo o que é necessário para carregar o tokenizer.
clean_up_tokenization_spaces (`str`, *opcional*, padrão `False`) : Se deve limpar os espaços após a decodificação. A limpeza consiste em remover possíveis artefatos, como espaços extras.
unk_token (`str`, *opcional*, padrão `""`) : O token desconhecido. Um token que não está no vocabulário não pode ser convertido em um ID e é definido como este token em vez disso.
bos_token (`str`, *opcional*, padrão `""`) : O token de início de sequência usado durante o pré-treinamento. Pode ser usado como token de classificador de sequência.
eos_token (`str`, *opcional*, padrão `""`) : O token de fim de sequência.
pad_token (`str`, *opcional*, padrão `""`) : O token usado para preenchimento, por exemplo, ao agrupar sequências de comprimentos diferentes.
vocab (`str`, `dict` ou `list`, *opcional*) : Dicionário de vocabulário personalizado. Se não for fornecido, o vocabulário é carregado de vocab_file.
merges (`str` ou `list`, *opcional*) : Lista de mesclagens personalizada. Se não for fornecida, as mesclagens são carregadas de merges_file.
Tokenizer para Nougat (baseado na biblioteca HuggingFace tokenizers).
Este tokenizer herda de [TokenizersBackend](/docs/transformers/main/pt/main_classes/tokenizer#transformers.TokenizersBackend), que contém a maioria dos métodos principais. Os usuários devem consultar esta superclasse para mais informações sobre esses métodos. Esta classe adiciona principalmente métodos específicos do Nougat para o pós-processamento do texto gerado.
#### correct_tables[[transformers.NougatTokenizer.correct_tables]]
```python
correct_tables(generation: str)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/tokenization_nougat.py#L493)
**Parâmetros:**
generation (str) : O texto gerado para ser pós-processado.
**Retorna:** `str`
O texto pós-processado.
Recebe uma string gerada e corrige tabelas/tabulares para que correspondam ao formato de markdown necessário.
Exemplo:
```python
correct_tables("\begin{table} \begin{tabular}{l l} & \ \end{tabular} \end{table}")
"\begin{table}
abular}{l l} & \ \end{tabular}
le}"
```
#### post_process_generation[[transformers.NougatTokenizer.post_process_generation]]
```python
post_process_generation(generation: str | list[str], fix_markdown: bool = True, num_workers: int | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/tokenization_nougat.py#L623)
**Parâmetros:**
generation (Union[str, list[str]]) : O texto gerado ou uma lista de textos gerados.
fix_markdown (`bool`, *opcional*, padrão `True`) : Se deve realizar correções de formatação em Markdown.
num_workers (`int`, *opcional*) : Número opcional de workers para aproveitar a multiprocessamento (pós-processamento de vários textos em paralelo).
**Retorna:** Union[str, list[str]]
O texto pós-processado ou a lista de textos pós-processados.
Pós-processa um texto gerado ou uma lista de textos gerados.
Esta função pode ser usada para realizar pós-processamento em texto gerado, como corrigir a formatação Markdown.
O pós-processamento é bastante lento, portanto, recomenda-se usar multiprocessamento para acelerar o processo.
#### post_process_single[[transformers.NougatTokenizer.post_process_single]]
```python
post_process_single(generation: str, fix_markdown: bool = True)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/tokenization_nougat.py#L528)
**Parâmetros:**
generation (str) : O texto gerado para ser pós-processado.
fix_markdown (bool, opcional) : Se deve realizar correções de formatação em Markdown. O padrão é True.
**Retorna:** `str`
O texto pós-processado.
Pós-processa um único texto gerado. As expressões regulares usadas aqui foram retiradas diretamente dos autores do artigo Nougat. Essas expressões são comentadas para clareza e testadas de ponta a ponta na maioria dos casos.
#### remove_hallucinated_references[[transformers.NougatTokenizer.remove_hallucinated_references]]
```python
remove_hallucinated_references(text: str)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/tokenization_nougat.py#L463)
**Parâmetros:**
text (`str`) : O texto de entrada contendo referências.
**Retorna:** `str`
O texto com as referências alucinadas removidas.
Remova referências alucinadas ou ausentes do texto.
Esta função identifica e remove referências marcadas como ausentes ou alucinadas do texto de entrada.
## NougatProcessor[[transformers.NougatProcessor]]
#### transformers.NougatProcessor[[transformers.NougatProcessor]]
```python
transformers.NougatProcessor(image_processor, tokenizer)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/processing_nougat.py#L37)
**Parâmetros:**
image_processor (`NougatImageProcessor`) : O processador de imagens é uma entrada obrigatória.
tokenizer (`NougatTokenizer`) : O tokenizer é uma entrada obrigatória.
Constrói um NougatProcessor que encapsula um processador de imagem e um tokenizer em um único processador.
[NougatProcessor](/docs/transformers/main/pt/model_doc/nougat#transformers.NougatProcessor) oferece todas as funcionalidades de [NougatImageProcessor](/docs/transformers/main/pt/model_doc/nougat#transformers.NougatImageProcessor) e [NougatTokenizer](/docs/transformers/main/pt/model_doc/nougat#transformers.NougatTokenizer). Consulte [~NougatImageProcessor](/docs/transformers/main/pt/model_doc/nougat#transformers.NougatImageProcessor) e [~NougatTokenizer](/docs/transformers/main/pt/model_doc/nougat#transformers.NougatTokenizer) para mais informações.
#### __call__[[transformers.NougatProcessor.__call__]]
```python
__call__(images = None, text = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/processing_nougat.py#L43)
**Parâmetros:**
images (``) : Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, set `do_rescale=False`
text (``) : The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, set `is_split_into_words=True` to avoid ambiguity with batched inputs.
return_tensors (`str` ou [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *opcional*) : Se definido, retornará tensores de um framework específico. Os valores aceitos são: - `'pt'`: Retorna objetos `torch.Tensor` do PyTorch. - `'np'`: Retorna objetos `np.ndarray` do NumPy.
#### from_pretrained[[transformers.NougatProcessor.from_pretrained]]
```python
from_pretrained(pretrained_model_name_or_path: str | os.PathLike, cache_dir: str | os.PathLike | None = None, force_download: bool = False, local_files_only: bool = False, token: str | bool | None = None, revision: str = 'main', **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L1750)
**Parâmetros:**
pretrained_model_name_or_path (`str` or `os.PathLike`) : This can be either: - a string, the *model id* of a pretrained feature_extractor hosted inside a model repo on huggingface.co. - a path to a *directory* containing a feature extractor file saved using the [save_pretrained()](/docs/transformers/main/pt/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained) method, e.g., `./my_model_directory/`. - a path to a saved feature extractor JSON *file*, e.g., `./my_model_directory/preprocessor_config.json`.
- ****kwargs** : Argumentos de palavra-chave adicionais passados tanto para [from_pretrained()](/docs/transformers/main/pt/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained) quanto para `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained`.
Instancie um processador associado a um modelo pré-treinado.
Este método de classe simplesmente chama o método [from_pretrained()](/docs/transformers/main/pt/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained) do extrator de recursos, o método [ImageProcessingMixin](/docs/transformers/main/pt/internal/image_processing_utils#transformers.ImageProcessingMixin) do processador de imagem e o método `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained` do tokenizador. Consulte as docstrings dos métodos acima para mais informações.
#### save_pretrained[[transformers.NougatProcessor.save_pretrained]]
```python
save_pretrained(save_directory, push_to_hub: bool = False, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L1165)
**Parâmetros:**
save_directory (`str` ou `os.PathLike`) : Diretório onde o arquivo JSON do extrator de recursos e os arquivos do tokenizer serão salvos (o diretório será criado caso não exista).
push_to_hub (`bool`, *opcional*, padrão `False`) : Indica se o modelo deve ser enviado para o Hugging Face model hub após ser salvo. Você pode especificar o repositório de destino com `repo_id` (por padrão, será usado o nome de `save_directory` no seu namespace).
kwargs (`dict[str, Any]`, *opcional*) : Argumentos de palavra-chave adicionais passados ao método [push_to_hub()](/docs/transformers/main/pt/main_classes/model#transformers.utils.PushToHubMixin.push_to_hub).
Salva os atributos deste processador (feature extractor, tokenizer...) no diretório especificado para que ele possa ser recarregado usando o método [from_pretrained()](/docs/transformers/main/pt/model_doc/wav2vec2#transformers.Wav2Vec2Processor.from_pretrained).
Este método de classe simplesmente chama [save_pretrained()](/docs/transformers/main/pt/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained) e [save_pretrained()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.save_pretrained). Consulte as docstrings dos métodos acima para mais informações.
#### batch_decode[[transformers.NougatProcessor.batch_decode]]
```python
batch_decode(*args, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L2005)
Este método encaminha todos os seus argumentos para o [batch_decode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.batch_decode) do PreTrainedTokenizer. Consulte a docstring deste método para obter mais informações.
#### decode[[transformers.NougatProcessor.decode]]
```python
decode(*args, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L2014)
Este método encaminha todos os seus argumentos para o [decode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.decode) do PreTrainedTokenizer. Consulte a docstring deste método para obter mais informações.
#### post_process_generation[[transformers.NougatProcessor.post_process_generation]]
```python
post_process_generation(*args, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/processing_nougat.py#L51)
Este método encaminha todos os seus argumentos para o `~PreTrainedTokenizer.post_process_generation` do NougatTokenizer. Consulte a docstring deste método para mais informações.