# OWL-ViT
## Visão geral
O OWL-ViT (sigla para Vision Transformer for Open-World Localization) foi proposto em [Simple Open-Vocabulary Object Detection with Vision Transformers](https://huggingface.co/papers/2205.06230) por Matthias Minderer, Alexey Gritsenko, Austin Stone, Maxim Neumann, Dirk Weissenborn, Alexey Dosovitskiy, Aravindh Mahendran, Anurag Arnab, Mostafa Dehghani, Zhuoran Shen, Xiao Wang, Xiaohua Zhai, Thomas Kipf e Neil Houlsby. O OWL-ViT é uma rede de detecção de objetos de vocabulário aberto treinada em uma variedade de pares (imagem, texto). Ele pode ser usado para consultar uma imagem com uma ou várias consultas de texto para buscar e detectar objetos-alvo descritos em texto.
O resumo do artigo é o seguinte:
*A combinação de arquiteturas simples com pré-treino em larga escala levou a melhorias massivas na classificação de imagens. Para detecção de objetos, as abordagens de pré-treino e escalonamento são menos estabelecidas, especialmente no cenário de cauda longa e vocabulário aberto, onde os dados de treinamento são relativamente escassos. Neste artigo, propomos uma receita robusta para transferir modelos de imagem-texto para detecção de objetos com vocabulário aberto. Utilizamos uma arquitetura padrão de Vision Transformer com modificações mínimas, pré-treino contrastivo de imagem-texto e ajuste fino de detecção de ponta a ponta. Nossa análise das propriedades de escalonamento dessa configuração mostra que aumentar o pré-treino no nível de imagem e o tamanho do modelo resultam em melhorias consistentes na tarefa de detecção downstream. Fornecemos as estratégias de adaptação e regularizações necessárias para alcançar um desempenho muito forte na detecção de objetos condicionada por texto zero-shot e condicionada por imagem one-shot. O código e os modelos estão disponíveis no GitHub.*
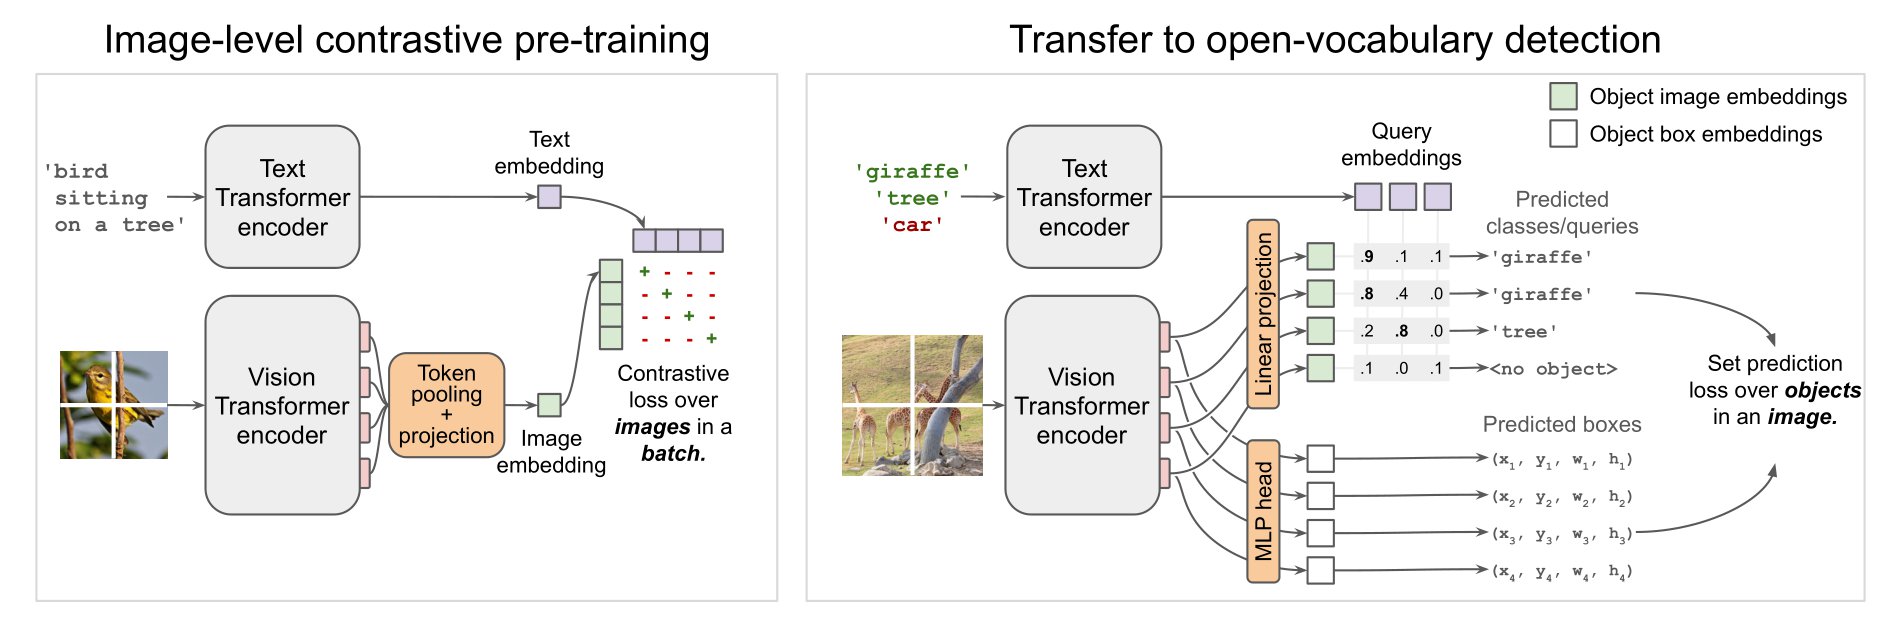 Arquitetura do OWL-ViT. Retirada do artigo original.
Este modelo foi contribuído por [adirik](https://huggingface.co/adirik). O código original pode ser encontrado [aqui](https://github.com/google-research/scenic/tree/main/scenic/projects/owl_vit).
## Dicas de uso
OWL-ViT é um modelo de detecção de objetos condicionado por texto em zero-shot. O OWL-ViT utiliza [CLIP](clip) como sua espinha dorsal multimodal, com um Transformer semelhante a um ViT para obter recursos visuais e um modelo de linguagem causal para obter os recursos de texto. Para usar o CLIP para detecção, o OWL-ViT remove a camada de pooling do token final do modelo de visão e acopla uma cabeça leve de classificação e caixa a cada token de saída do transformer. A classificação de vocabulário aberto é habilitada substituindo os pesos da camada de classificação fixa pelos embeddings dos nomes de classe obtidos do modelo de texto. Os autores primeiro treinam o CLIP do zero e o ajustam finamente de ponta a ponta com as cabeças de classificação e caixa em conjuntos de dados padrão de detecção, usando uma perda de correspondência bipartida. Uma ou várias consultas de texto por imagem podem ser usadas para realizar detecção de objetos em zero-shot condicionada por texto.
[OwlViTImageProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTImageProcessor) pode ser usado para redimensionar (ou reescalar) e normalizar as imagens para o modelo, e [CLIPTokenizer](/docs/transformers/main/pt/model_doc/clip#transformers.CLIPTokenizer) é usado para codificar o texto. [OwlViTProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTProcessor) agrupa [OwlViTImageProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTImageProcessor) e [CLIPTokenizer](/docs/transformers/main/pt/model_doc/clip#transformers.CLIPTokenizer) em uma única instância para codificar o texto e preparar as imagens. O exemplo a seguir mostra como realizar a detecção de objetos usando [OwlViTProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTProcessor) e [OwlViTForObjectDetection](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTForObjectDetection).
```python
import requests
from PIL import Image
import torch
from transformers import OwlViTProcessor, OwlViTForObjectDetection
processor = OwlViTProcessor.from_pretrained("google/owlvit-base-patch32")
model = OwlViTForObjectDetection.from_pretrained("google/owlvit-base-patch32", device_map="auto")
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
text_labels = [["a photo of a cat", "a photo of a dog"]]
inputs = processor(text=text_labels, images=image, return_tensors="pt").to(model.device)
outputs = model(**inputs)
# Target image sizes (height, width) to rescale box predictions [batch_size, 2]
target_sizes = torch.tensor([(image.height, image.width)])
# Convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
results = processor.post_process_grounded_object_detection(
outputs=outputs, target_sizes=target_sizes, threshold=0.1, text_labels=text_labels
)
# Retrieve predictions for the first image for the corresponding text queries
result = results[0]
boxes, scores, text_labels = result["boxes"], result["scores"], result["text_labels"]
for box, score, text_label in zip(boxes, scores, text_labels):
box = [round(i, 2) for i in box.tolist()]
print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a photo of a cat with confidence 0.707 at location [324.97, 20.44, 640.58, 373.29]
Detected a photo of a cat with confidence 0.717 at location [1.46, 55.26, 315.55, 472.17]
```
## Recursos
Um notebook de demonstração sobre o uso do OWL-ViT para detecção de objetos zero-shot e one-shot (orientada por imagem) pode ser encontrado [aqui](https://github.com/huggingface/notebooks/blob/main/examples/zeroshot_object_detection_with_owlvit.ipynb).
## OwlViTConfig[[transformers.OwlViTConfig]]
#### transformers.OwlViTConfig[[transformers.OwlViTConfig]]
```python
transformers.OwlViTConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, return_dict: bool = True, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, projection_dim: int = 512, logit_scale_init_value: float = 2.6592, initializer_factor: float = 1.0)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/configuration_owlvit.py#L101)
**Parâmetros:**
return_dict (`bool`, *opcional*, padrão `True`) : Se deve retornar um `ModelOutput` (dataclass) em vez de uma tupla simples.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : O objeto de configuração ou dicionário do backbone de texto.
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : O objeto de configuração ou dicionário do backbone de visão.
projection_dim (`int`, *opcional*, padrão `512`) : Dimensionalidade das camadas de projeção de texto e visão.
logit_scale_init_value (`float`, *opcional*, padrão `2.6592`) : O valor inicial do parâmetro *logit_scale*.
initializer_factor (`float`, *opcional*, padrão `1.0`) : Um fator para inicializar todas as matrizes de pesos (deve ser mantido em 1, usado internamente para testes de inicialização).
Esta é a classe de configuração para armazenar a configuração de um OwlViTModel. Ela é usada para instanciar um modelo Owlvit de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [google/owlvit-base-patch16](https://huggingface.co/google/owlvit-base-patch16)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
## OwlViTTextConfig[[transformers.OwlViTTextConfig]]
#### transformers.OwlViTTextConfig[[transformers.OwlViTTextConfig]]
```python
transformers.OwlViTTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 49408, hidden_size: int = 512, intermediate_size: int = 2048, num_hidden_layers: int = 12, num_attention_heads: int = 8, max_position_embeddings: int = 16, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0, pad_token_id: int | None = 0, bos_token_id: int | None = 49406, eos_token_id: int | list[int] | None = 49407)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/configuration_owlvit.py#L27)
**Parâmetros:**
vocab_size (`int`, *opcional*, padrão `49408`) : Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelos `input_ids`.
hidden_size (`int`, *opcional*, padrão `512`) : Dimensão das representações ocultas.
intermediate_size (`int`, *opcional*, padrão `2048`) : Dimensão das representações do MLP.
num_hidden_layers (`int`, *opcional*, padrão `12`) : Número de camadas ocultas no decodificador do Transformer.
num_attention_heads (`int`, *opcional*, padrão `8`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
max_position_embeddings (`int`, *opcional*, padrão `16`) : O comprimento máximo da sequência com o qual este modelo pode ser usado.
hidden_act (`str`, *opcional*, padrão `quick_gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *opcional*, padrão `1e-05`) : O epsilon usado pelas camadas de normalização de camada.
attention_dropout (`Union[float, int]`, *opcional*, padrão `0.0`) : A taxa de dropout para as probabilidades de atenção.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
initializer_factor (`float`, *opcional*, padrão `1.0`) : Um fator para inicializar todas as matrizes de pesos (deve ser mantido em 1, usado internamente para testes de inicialização).
pad_token_id (`int`, *opcional*, padrão `0`) : ID do token usado para preenchimento no vocabulário.
bos_token_id (`int`, *opcional*, padrão `49406`) : ID do token usado para o início do fluxo no vocabulário.
eos_token_id (`Union[int, list[int]]`, *opcional*, padrão `49407`) : ID do token usado para o fim do fluxo no vocabulário.
Esta é a classe de configuração para armazenar a configuração de um OwlViTModel. Ela é usada para instanciar um modelo Owlvit de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [google/owlvit-base-patch16](https://huggingface.co/google/owlvit-base-patch16)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import OwlViTTextConfig, OwlViTTextModel
>>> # Initializing a OwlViTTextModel with google/owlvit-base-patch32 style configuration
>>> configuration = OwlViTTextConfig()
>>> # Initializing a OwlViTTextConfig from the google/owlvit-base-patch32 style configuration
>>> model = OwlViTTextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## OwlViTVisionConfig[[transformers.OwlViTVisionConfig]]
#### transformers.OwlViTVisionConfig[[transformers.OwlViTVisionConfig]]
```python
transformers.OwlViTVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 768, patch_size: int | list[int] | tuple[int, int] = 32, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/configuration_owlvit.py#L65)
**Parâmetros:**
hidden_size (`int`, *opcional*, padrão `768`) : Dimensão das representações ocultas.
intermediate_size (`int`, *opcional*, padrão `3072`) : Dimensão das representações do MLP.
num_hidden_layers (`int`, *opcional*, padrão `12`) : Número de camadas ocultas no decodificador do Transformer.
num_attention_heads (`int`, *opcional*, padrão `12`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
num_channels (`int`, *opcional*, padrão `3`) : O número de canais de entrada.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `768`) : O tamanho (resolução) de cada imagem.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `32`) : O tamanho (resolução) de cada patch.
hidden_act (`str`, *opcional*, padrão `quick_gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *opcional*, padrão `1e-05`) : O epsilon usado pelas camadas de normalização de camada.
attention_dropout (`Union[float, int]`, *opcional*, padrão `0.0`) : A taxa de dropout para as probabilidades de atenção.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
initializer_factor (`float`, *opcional*, padrão `1.0`) : Um fator para inicializar todas as matrizes de pesos (deve ser mantido em 1, usado internamente para testes de inicialização).
Esta é a classe de configuração para armazenar a configuração de um OwlViTModel. Ela é usada para instanciar um modelo Owlvit de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [google/owlvit-base-patch16](https://huggingface.co/google/owlvit-base-patch16)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import OwlViTVisionConfig, OwlViTVisionModel
>>> # Initializing a OwlViTVisionModel with google/owlvit-base-patch32 style configuration
>>> configuration = OwlViTVisionConfig()
>>> # Initializing a OwlViTVisionModel model from the google/owlvit-base-patch32 style configuration
>>> model = OwlViTVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## OwlViTImageProcessor[[transformers.OwlViTImageProcessor]]
#### transformers.OwlViTImageProcessor[[transformers.OwlViTImageProcessor]]
```python
transformers.OwlViTImageProcessor(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/image_processing_owlvit.py#L102)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 768, 'width': 768}`): Descreve as dimensões de entrada máximas para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 768, 'width': 768}`): Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `3`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.48145466, 0.4578275, 0.40821073]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.26862954, 0.26130258, 0.27577711]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve aplicar um recorte centralizado na imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
Constrói um processador de imagem OwlViTImageProcessor.
#### preprocess[[transformers.OwlViTImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Sinalizador do desenvolvedor para entradas adicionais semelhantes a imagens que também serão pré-processadas. Use isso apenas se a passagem das entradas como kwarg não funcionar. Por exemplo, `preprocess(images, masks=masks)` é a opção preferida, mas resulta em problemas de prioridade de argumentos para alguns modelos. Nesses casos, `preprocess(images, image_like_inputs={"masks": masks})` pode ser usado em vez disso.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
Pré-processa uma imagem ou um lote de imagens.
## OwlViTImageProcessorPil[[transformers.OwlViTImageProcessorPil]]
#### transformers.OwlViTImageProcessorPil[[transformers.OwlViTImageProcessorPil]]
```python
transformers.OwlViTImageProcessorPil(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/image_processing_pil_owlvit.py#L108)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 768, 'width': 768}`): Descreve as dimensões de entrada máximas para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 768, 'width': 768}`): Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `3`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.48145466, 0.4578275, 0.40821073]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.26862954, 0.26130258, 0.27577711]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve aplicar um recorte centralizado na imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
Constrói um processador de imagem OwlViTImageProcessor.
#### preprocess[[transformers.OwlViTImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Sinalizador do desenvolvedor para entradas adicionais semelhantes a imagens que também serão pré-processadas. Use isso apenas se a passagem das entradas como kwarg não funcionar. Por exemplo, `preprocess(images, masks=masks)` é a opção preferida, mas resulta em problemas de prioridade de argumentos para alguns modelos. Nesses casos, `preprocess(images, image_like_inputs={"masks": masks})` pode ser usado em vez disso.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
Pré-processa uma imagem ou um lote de imagens.
#### post_process_object_detection[[transformers.OwlViTImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs: OwlViTObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/image_processing_pil_owlvit.py#L132)
**Parâmetros:**
outputs (`OwlViTObjectDetectionOutput`) : Saídas brutas do modelo.
threshold (`float`, *opcional*, padrão 0.1) : Limiar de pontuação para manter as previsões de detecção de objetos.
target_sizes (`torch.Tensor` ou `list[tuple[int, int]]`, *opcional*) : Tensor de forma `(batch_size, 2)` ou lista de tuplas (`tuple[int, int]`) contendo o tamanho alvo `(height, width)` de cada imagem no lote. Se não definido, as previsões não serão redimensionadas.
**Retorna:** `list[Dict]`
Uma lista de dicionários, em que cada dicionário contém as seguintes chaves:
- "scores": as pontuações de confiança para cada caixa prevista na imagem.
- "labels": Índices das classes previstas pelo modelo na imagem.
- "boxes": Caixas delimitadoras de imagem no formato (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
Converte a saída bruta de [OwlViTForObjectDetection](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTForObjectDetection) em caixas delimitadoras finais no formato (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
#### post_process_image_guided_detection[[transformers.OwlViTImageProcessorPil.post_process_image_guided_detection]]
```python
post_process_image_guided_detection(outputs, threshold = 0.0, nms_threshold = 0.3, target_sizes = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/image_processing_pil_owlvit.py#L188)
**Parâmetros:**
outputs (`OwlViTImageGuidedObjectDetectionOutput`) : Saídas brutas do modelo.
threshold (`float`, *opcional*, padrão 0.0) : Limite mínimo de confiança a ser usado para filtrar as caixas previstas.
nms_threshold (`float`, *opcional*, padrão 0.3) : Limiar de IoU para supressão de máximos não máximos de caixas sobrepostas.
target_sizes (`torch.Tensor`, *opcional*) : Tensor de forma (batch_size, 2) em que cada entrada é a (altura, largura) da imagem correspondente no lote. Se definido, as caixas delimitadoras normalizadas previstas são reescaladas para os tamanhos-alvo. Se deixado como None, as previsões não serão desnormalizadas.
**Retorna:** `list[Dict]`
Uma lista de dicionários, em que cada dicionário contém as pontuações, rótulos e caixas para uma imagem no lote, conforme previsto pelo modelo. Todos os rótulos são definidos como None, pois `OwlViTForObjectDetection.image_guided_detection` executa detecção de objetos one-shot.
Converte a saída de [OwlViTForObjectDetection.image_guided_detection()](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTForObjectDetection.image_guided_detection) para o formato esperado pela API do COCO.
## OwlViTProcessor[[transformers.OwlViTProcessor]]
#### transformers.OwlViTProcessor[[transformers.OwlViTProcessor]]
```python
transformers.OwlViTProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/processing_owlvit.py#L62)
**Parâmetros:**
image_processor (`OwlViTImageProcessor`) : O processador de imagem é uma entrada obrigatória.
tokenizer (`CLIPTokenizer`) : O tokenizer é uma entrada obrigatória.
Constrói um OwlViTProcessor que encapsula um processador de imagem e um tokenizer em um único processador.
[OwlViTProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTProcessor) oferece todas as funcionalidades de [OwlViTImageProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTImageProcessor) e [CLIPTokenizer](/docs/transformers/main/pt/model_doc/clip#transformers.CLIPTokenizer). Consulte [~OwlViTImageProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTImageProcessor) e [~CLIPTokenizer](/docs/transformers/main/pt/model_doc/clip#transformers.CLIPTokenizer) para mais informações.
#### __call__[[transformers.OwlViTProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/processing_owlvit.py#L66)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opcional*) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *opcional*) : A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se você passar uma entrada pretokenizada, defina `is_split_into_words=True` para evitar ambiguidade com entradas em lote.
query_images (`ImageInput`, *kwargs*, *opcional*) : Imagens de consulta a serem usadas para detecção de objetos guiada por imagem. Quando fornecidas, essas imagens servem como consultas visuais para encontrar objetos semelhantes nas `images` principais. As imagens de consulta substituem quaisquer prompts de texto, e o modelo executa correspondência de imagem para imagem em vez de correspondência de texto para imagem.
return_tensors (`str` ou [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *opcional*) : Se definido, retornará tensores de um framework específico. Os valores aceitos são: - `'pt'`: Retorna objetos `torch.Tensor` do PyTorch. - `'np'`: Retorna objetos `np.ndarray` do NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/pt/main_classes/processors#transformers.ProcessingKwargs), *opcional*) : Opções de processamento adicionais para cada modalidade (texto, imagens, vídeos, áudio). Os parâmetros específicos do modelo estão listados acima; consulte a classe TypedDict para a lista completa de argumentos suportados.
**Retorna:** [BatchFeature](/docs/transformers/main/pt/main_classes/feature_extractor#transformers.BatchFeature)
Um [BatchFeature](/docs/transformers/main/pt/main_classes/feature_extractor#transformers.BatchFeature) com os seguintes campos:
- **input_ids** -- Lista de ids de tokens a serem fornecidos a um modelo. Retornado quando `text` não é `None`.
- **attention_mask** -- Lista de índices que especifica quais tokens devem ser considerados pelo modelo (quando `return_attention_mask=True` ou se *"attention_mask"* estiver em `self.model_input_names` e se `text` não for `None`).
- **pixel_values** -- Valores de pixel a serem fornecidos a um modelo. Retornado quando `images` não é `None`.
- **query_pixel_values** -- Valores de pixels das imagens de consulta a serem fornecidos a um modelo. Retornado quando `query_images` não é `None`.
#### post_process_grounded_object_detection[[transformers.OwlViTProcessor.post_process_grounded_object_detection]]
```python
post_process_grounded_object_detection(outputs: OwlViTObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None, text_labels: list[list[str]] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/processing_owlvit.py#L149)
**Parâmetros:**
outputs (`OwlViTObjectDetectionOutput`) : Saídas brutas do modelo.
threshold (`float`, *opcional*, padrão 0.1) : Limiar de pontuação para manter as previsões de detecção de objetos.
target_sizes (`torch.Tensor` ou `list[tuple[int, int]]`, *opcional*) : Tensor de forma `(batch_size, 2)` ou lista de tuplas (`tuple[int, int]`) contendo o tamanho alvo `(height, width)` de cada imagem no lote. Se não definido, as previsões não serão redimensionadas.
text_labels (`list[list[str]]`, *opcional*) : Lista de listas de rótulos de texto para cada imagem no lote. Se não definido, "text_labels" na saída será definido como `None`.
**Retorna:** `list[Dict]`
Uma lista de dicionários, em que cada dicionário contém as seguintes chaves:
- "scores": as pontuações de confiança para cada caixa prevista na imagem.
- "labels": Índices das classes previstas pelo modelo na imagem.
- "boxes": Caixas delimitadoras de imagem no formato (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
- "text_labels": Os rótulos de texto para cada caixa delimitadora prevista na imagem.
Converte a saída bruta de [OwlViTForObjectDetection](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTForObjectDetection) em caixas delimitadoras finais no formato (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
#### post_process_image_guided_detection[[transformers.OwlViTProcessor.post_process_image_guided_detection]]
```python
post_process_image_guided_detection(outputs: OwlViTImageGuidedObjectDetectionOutput, threshold: float = 0.0, nms_threshold: float = 0.3, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/processing_owlvit.py#L197)
**Parâmetros:**
outputs (`OwlViTImageGuidedObjectDetectionOutput`) : Saídas brutas do modelo.
threshold (`float`, *opcional*, padrão 0.0) : Limite mínimo de confiança a ser usado para filtrar as caixas previstas.
nms_threshold (`float`, *opcional*, padrão 0.3) : Limiar de IoU para supressão de máximos não máximos de caixas sobrepostas.
target_sizes (`torch.Tensor`, *opcional*) : Tensor de forma (batch_size, 2) em que cada entrada é a (altura, largura) da imagem correspondente no lote. Se definido, as caixas delimitadoras normalizadas previstas são reescaladas para os tamanhos-alvo. Se deixado como None, as previsões não serão desnormalizadas.
**Retorna:** `list[Dict]`
Uma lista de dicionários, em que cada dicionário contém as seguintes chaves:
- "scores": as pontuações de confiança para cada caixa prevista na imagem.
- "boxes": Caixas delimitadoras de imagem no formato (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
- "labels": Definido como `None`.
Converte a saída de [OwlViTForObjectDetection.image_guided_detection()](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTForObjectDetection.image_guided_detection) para o formato esperado pela API do COCO.
## OwlViTModel[[transformers.OwlViTModel]]
#### transformers.OwlViTModel[[transformers.OwlViTModel]]
```python
transformers.OwlViTModel(config: OwlViTConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L813)
**Parâmetros:**
config ([OwlViTConfig](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Owlvit puro, que produz estados ocultos brutos sem nenhum cabeçalho específico no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.OwlViTModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, return_loss: bool | None = None, interpolate_pos_encoding: bool = False, return_base_image_embeds: bool | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L907)
**Parâmetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [OwlViTImageProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTImageProcessor). Veja [OwlViTImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([OwlViTProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTProcessor) usa [OwlViTImageProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTImageProcessor) para processar imagens).
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
return_loss (`bool`, *opcional*) : Se deve ou não retornar a perda contrastiva.
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
return_base_image_embeds (`bool`, *opcional*) : Se as incorporações da imagem base devem ser retornadas ou não.
**Retorna:** `OwlViTOutput` ou `tuple(torch.Tensor)`
Um `OwlViTOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([OwlViTConfig](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTConfig)) e das entradas.
O método forward do [OwlViTModel](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTModel) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `return_loss` é `True`) -- Perda contrastiva para similaridade entre imagem e texto.
- **logits_per_image** (`torch.Tensor` de forma `(image_batch_size, text_batch_size)`) -- As pontuações de produto escalar escalonado entre `image_embeds` e `text_embeds`. Isso representa as pontuações de similaridade entre imagem e texto.
- **logits_per_text** (`torch.Tensor` de forma `(text_batch_size, image_batch_size)`) -- As pontuações de produto escalar escalonado entre `text_embeds` e `image_embeds`. Isso representa as pontuações de similaridade entre texto e imagem.
- **text_embeds** (`torch.Tensor` de forma `(batch_size * num_max_text_queries, output_dim`) -- Os embeddings de texto obtidos aplicando a camada de projeção à saída agregada do [OwlViTTextModel](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTTextModel).
- **image_embeds** (`torch.Tensor` de forma `(batch_size, output_dim`) -- Os embeddings de imagem obtidos aplicando a camada de projeção à saída agregada do [OwlViTVisionModel](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTVisionModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- A saída do [OwlViTTextModel](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- A saída do [OwlViTVisionModel](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTVisionModel).
Exemplos:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, OwlViTModel
>>> model = OwlViTModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(text=[["a photo of a cat", "a photo of a dog"]], images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> logits_per_image = outputs.logits_per_image # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
```
#### get_text_features[[transformers.OwlViTModel.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L836)
**Parâmetros:**
input_ids (`torch.LongTensor` de forma `(batch_size * num_max_text_queries, sequence_length)`) : Índices dos tokens da sequência de entrada no vocabulário. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
**Retorna:** [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([OwlViTConfig](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTConfig)) e das entradas.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> import torch
>>> from transformers import AutoProcessor, OwlViTModel
>>> model = OwlViTModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> inputs = processor(
... text=[["a photo of a cat", "a photo of a dog"], ["photo of a astranaut"]], return_tensors="pt"
... )
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_image_features[[transformers.OwlViTModel.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L873)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [OwlViTImageProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTImageProcessor). Veja [OwlViTImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([OwlViTProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTProcessor) usa [OwlViTImageProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTImageProcessor) para processar imagens).
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([OwlViTConfig](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTConfig)) e das entradas.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> import torch
>>> from transformers.image_utils import load_image
>>> from transformers import AutoProcessor, OwlViTModel
>>> model = OwlViTModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... image_features = model.get_image_features(**inputs)
```
## OwlViTTextModel[[transformers.OwlViTTextModel]]
#### transformers.OwlViTTextModel[[transformers.OwlViTTextModel]]
```python
transformers.OwlViTTextModel(config: OwlViTTextConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L668)
#### forward[[transformers.OwlViTTextModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L684)
**Parâmetros:**
input_ids (`torch.LongTensor` de forma `(batch_size * num_max_text_queries, sequence_length)`) : Índices dos tokens da sequência de entrada no vocabulário. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
**Retorna:** [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([OwlViTConfig](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTConfig)) e das entradas.
O método forward do [OwlViTTextModel](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTTextModel) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> from transformers import AutoProcessor, OwlViTTextModel
>>> model = OwlViTTextModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> inputs = processor(
... text=[["a photo of a cat", "a photo of a dog"], ["photo of a astranaut"]], return_tensors="pt"
... )
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled (EOS token) states
```
## OwlViTVisionModel[[transformers.OwlViTVisionModel]]
#### transformers.OwlViTVisionModel[[transformers.OwlViTVisionModel]]
```python
transformers.OwlViTVisionModel(config: OwlViTVisionConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L763)
#### forward[[transformers.OwlViTVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L777)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [OwlViTImageProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTImageProcessor). Veja [OwlViTImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([OwlViTProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTProcessor) usa [OwlViTImageProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTImageProcessor) para processar imagens).
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([OwlViTConfig](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTConfig)) e das entradas.
O método forward do [OwlViTVisionModel](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTVisionModel) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, OwlViTVisionModel
>>> model = OwlViTVisionModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled CLS states
```
## OwlViTForObjectDetection[[transformers.OwlViTForObjectDetection]]
#### transformers.OwlViTForObjectDetection[[transformers.OwlViTForObjectDetection]]
```python
transformers.OwlViTForObjectDetection(config: OwlViTConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L1054)
#### forward[[transformers.OwlViTForObjectDetection.forward]]
```python
forward(input_ids: Tensor, pixel_values: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L1379)
**Parâmetros:**
input_ids (`torch.LongTensor` de forma `(batch_size * num_max_text_queries, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids).
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [OwlViTImageProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTImageProcessor). Veja [OwlViTImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([OwlViTProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTProcessor) usa [OwlViTImageProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTImageProcessor) para processar imagens).
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** `OwlViTObjectDetectionOutput` ou `tuple(torch.Tensor)`
Um `OwlViTObjectDetectionOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([OwlViTConfig](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTConfig)) e das entradas.
O método forward de [OwlViTForObjectDetection](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTForObjectDetection) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` são fornecidas)) -- Perda total como uma combinação linear de uma log-verossimilhança negativa (entropia cruzada) para a previsão de classe e uma perda de caixa delimitadora. Esta última é definida como uma combinação linear da perda L1 e da perda de IoU generalizada e invariante à escala.
- **loss_dict** (`Dict`, *opcional*) -- Um dicionário contendo as perdas individuais. Útil para registro de logs.
- **logits** (`torch.Tensor` de forma `(batch_size, num_patches, num_queries)`) -- Logits de classificação (incluindo no-object) para todas as queries.
- **pred_boxes** (`torch.Tensor` de forma `(batch_size, num_patches, 4)`) -- Coordenadas normalizadas das caixas para todas as queries, representadas como (center_x, center_y, width, height). Esses valores são normalizados em [0, 1], relativos ao tamanho de cada imagem individual no lote (ignorando possível padding). Você pode usar `post_process_object_detection()` para recuperar as caixas delimitadoras não normalizadas.
- **text_embeds** (`torch.Tensor` de forma `(batch_size, num_max_text_queries, output_dim`) -- Os embeddings de texto obtidos aplicando a camada de projeção à saída agregada do [OwlViTTextModel](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTTextModel).
- **image_embeds** (`torch.Tensor` de forma `(batch_size, patch_size, patch_size, output_dim`) -- Saída agregada do [OwlViTVisionModel](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTVisionModel). O OWL-ViT representa imagens como um conjunto de patches de imagem e calcula incorporações de imagem para cada patch.
- **class_embeds** (`torch.Tensor` de forma `(batch_size, num_patches, hidden_size)`) -- Embeddings de classe de todos os patches de imagem. O OWL-ViT representa imagens como um conjunto de patches de imagem, onde o número total de patches é (image_size / patch_size)**2.
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- A saída do [OwlViTTextModel](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- A saída do [OwlViTVisionModel](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTVisionModel).
Exemplos:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> from transformers import OwlViTProcessor, OwlViTForObjectDetection
>>> processor = OwlViTProcessor.from_pretrained("google/owlvit-base-patch32")
>>> model = OwlViTForObjectDetection.from_pretrained("google/owlvit-base-patch32")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text_labels = [["a photo of a cat", "a photo of a dog"]]
>>> inputs = processor(text=text_labels, images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # Target image sizes (height, width) to rescale box predictions [batch_size, 2]
>>> target_sizes = torch.tensor([(image.height, image.width)])
>>> # Convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> results = processor.post_process_grounded_object_detection(
... outputs=outputs, target_sizes=target_sizes, threshold=0.1, text_labels=text_labels
... )
>>> # Retrieve predictions for the first image for the corresponding text queries
>>> result = results[0]
>>> boxes, scores, text_labels = result["boxes"], result["scores"], result["text_labels"]
>>> for box, score, text_label in zip(boxes, scores, text_labels):
... box = [round(i, 2) for i in box.tolist()]
... print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a photo of a cat with confidence 0.707 at location [324.97, 20.44, 640.58, 373.29]
Detected a photo of a cat with confidence 0.717 at location [1.46, 55.26, 315.55, 472.17]
```
#### image_guided_detection[[transformers.OwlViTForObjectDetection.image_guided_detection]]
```python
image_guided_detection(pixel_values: Tensor, query_pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlvit/modeling_owlvit.py#L1294)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [OwlViTImageProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTImageProcessor). Veja [OwlViTImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([OwlViTProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTProcessor) usa [OwlViTImageProcessor](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTImageProcessor) para processar imagens).
query_pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, height, width)`) : Valores de pixels da(s) imagem(ns) de consulta a serem detectadas. Passe uma imagem de consulta para cada imagem de destino.
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** `OwlViTImageGuidedObjectDetectionOutput` ou `tuple(torch.Tensor)`
Um `OwlViTImageGuidedObjectDetectionOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([OwlViTConfig](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTConfig)) e das entradas.
- **logits** (`torch.Tensor` de forma `(batch_size, num_patches, num_queries)`) -- Logits de classificação (incluindo no-object) para todas as queries.
- **image_embeds** (`torch.Tensor` de forma `(batch_size, patch_size, patch_size, output_dim`) -- Saída agregada do [OwlViTVisionModel](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTVisionModel). O OWL-ViT representa imagens como um conjunto de patches de imagem e calcula incorporações de imagem para cada patch.
- **query_image_embeds** (`torch.Tensor` de forma `(batch_size, patch_size, patch_size, output_dim`) -- Saída agregada do [OwlViTVisionModel](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTVisionModel). O OWL-ViT representa imagens como um conjunto de patches de imagem e calcula incorporações de imagem para cada patch.
- **target_pred_boxes** (`torch.Tensor` de forma `(batch_size, num_patches, 4)`) -- Coordenadas normalizadas das caixas para todas as queries, representadas como (center_x, center_y, width, height). Esses valores são normalizados em [0, 1], relativos ao tamanho de cada imagem de destino individual no lote (ignorando possíveis paddings). Você pode usar `post_process_object_detection()` para recuperar as caixas delimitadoras não normalizadas.
- **query_pred_boxes** (`torch.Tensor` de forma `(batch_size, num_patches, 4)`) -- Coordenadas normalizadas das caixas para todas as queries, representadas como (center_x, center_y, width, height). Esses valores são normalizados em [0, 1], relativos ao tamanho de cada imagem de query individual no batch (ignorando possível padding). Você pode usar `post_process_object_detection()` para recuperar as caixas delimitadoras não normalizadas.
- **class_embeds** (`torch.Tensor` de forma `(batch_size, num_patches, hidden_size)`) -- Embeddings de classe de todos os patches de imagem. O OWL-ViT representa imagens como um conjunto de patches de imagem, onde o número total de patches é (image_size / patch_size)**2.
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- A saída do [OwlViTTextModel](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- A saída do [OwlViTVisionModel](/docs/transformers/main/pt/model_doc/owlvit#transformers.OwlViTVisionModel).
Exemplos:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> from transformers import AutoProcessor, OwlViTForObjectDetection
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch16")
>>> model = OwlViTForObjectDetection.from_pretrained("google/owlvit-base-patch16")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> query_url = "http://images.cocodataset.org/val2017/000000001675.jpg"
>>> with httpx.stream("GET", query_url) as response:
... query_image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, query_images=query_image, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model.image_guided_detection(**inputs)
>>> # Target image sizes (height, width) to rescale box predictions [batch_size, 2]
>>> target_sizes = torch.Tensor([image.size[::-1]])
>>> # Convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> results = processor.post_process_image_guided_detection(
... outputs=outputs, threshold=0.6, nms_threshold=0.3, target_sizes=target_sizes
... )
>>> i = 0 # Retrieve predictions for the first image
>>> boxes, scores = results[i]["boxes"], results[i]["scores"]
>>> for box, score in zip(boxes, scores):
... box = [round(i, 2) for i in box.tolist()]
... print(f"Detected similar object with confidence {round(score.item(), 3)} at location {box}")
Detected similar object with confidence 0.856 at location [10.94, 50.4, 315.8, 471.39]
Detected similar object with confidence 1.0 at location [334.84, 25.33, 636.16, 374.71]
```