# Perceiver
## Visão geral
O modelo Perceiver IO foi proposto em [Perceiver IO: A General Architecture for Structured Inputs & Outputs](https://huggingface.co/papers/2107.14795) por Andrew Jaegle, Sebastian Borgeaud, Jean-Baptiste Alayrac, Carl Doersch, Catalin Ionescu, David Ding, Skanda Koppula, Daniel Zoran, Andrew Brock, Evan Shelhamer, Olivier Hénaff, Matthew M. Botvinick, Andrew Zisserman, Oriol Vinyals, João Carreira.
Perceiver IO é uma generalização do [Perceiver](https://huggingface.co/papers/2103.03206) para lidar com saídas arbitrárias, além de entradas arbitrárias. O Perceiver original produzia apenas um único rótulo de classificação. Além de rótulos de classificação, o Perceiver IO pode produzir (por exemplo) linguagem, fluxo óptico e vídeos multimodais com áudio. Isso é feito usando os mesmos blocos de construção do Perceiver original. A complexidade computacional do Perceiver IO é linear em relação ao tamanho da entrada e da saída, e a maior parte do processamento ocorre no espaço latente, permitindo processar entradas e saídas muito maiores do que as que podem ser tratadas por Transformers padrão. Isso significa, por exemplo, que o Perceiver IO pode fazer modelagem de linguagem mascarada no estilo BERT diretamente usando bytes, em vez de entradas tokenizadas.
O resumo do artigo é o seguinte:
*O modelo Perceiver, proposto recentemente, obtém bons resultados em vários domínios (imagens, áudio, multimodal, nuvens de pontos) enquanto escala linearmente em computação e memória em relação ao tamanho da entrada. Embora o Perceiver suporte muitos tipos de entradas, ele só pode produzir saídas muito simples, como pontuações de classe. O Perceiver IO supera essa limitação sem sacrificar as propriedades atraentes do original, aprendendo a consultar flexivelmente o espaço latente do modelo para produzir saídas de tamanho e semântica arbitrários. O Perceiver IO ainda desacopla a profundidade do modelo do tamanho dos dados e ainda escala linearmente com o tamanho dos dados, mas agora em relação aos tamanhos tanto da entrada quanto da saída. O modelo Perceiver IO completo alcança resultados robustos em tarefas com espaços de saída altamente estruturados, como linguagem natural e compreensão visual, StarCraft II, e domínios multitarefa e multimodais. Como destaques, o Perceiver IO iguala uma linha de base BERT baseada em Transformer no benchmark de linguagem GLUE sem a necessidade de tokenização de entrada e alcança desempenho de estado da arte na estimativa de fluxo óptico Sintel.*
Aqui está um resumo explicando como o Perceiver funciona:
O principal problema do mecanismo de autoatenção do Transformer é que os requisitos de tempo e memória escalam quadraticamente com o comprimento da sequência. Portanto, modelos como BERT e RoBERTa são limitados a um comprimento máximo de sequência de 512 tokens. O Perceiver busca resolver esse problema realizando a autoatenção em um conjunto de variáveis latentes, em vez de realizá-la nas entradas, e usando as entradas apenas para a atenção cruzada. Dessa forma, os requisitos de tempo e memória não dependem mais do comprimento das entradas, pois utiliza-se uma quantidade fixa de variáveis latentes, como 256 ou 512. Essas variáveis são inicializadas aleatoriamente e, em seguida, treinadas de ponta a ponta usando retropropagação.
Internamente, o [PerceiverModel](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverModel) criará os latentes, que é um tensor de forma `(batch_size, num_latents, d_latents)`. É necessário fornecer `inputs` (que podem ser texto, imagens, áudio, o que você quiser!) ao modelo, que os usará para realizar cross-attention com os latentes. A saída do codificador Perceiver é um tensor da mesma forma. Em seguida, de forma semelhante ao BERT, é possível converter os últimos estados ocultos dos latentes em logits de classificação, fazendo a média ao longo da dimensão da sequência e colocando uma camada linear por cima para projetar os `d_latents` para `num_labels`.
Essa era a ideia do artigo original do Perceiver. No entanto, ele só conseguia produzir logits de classificação. Em um trabalho subsequente, o PerceiverIO, eles generalizaram o modelo para que ele também pudesse produzir saídas de tamanho arbitrário. Como, você pode perguntar? A ideia é, na verdade, relativamente simples: define-se saídas de tamanho arbitrário e, em seguida, aplica-se atenção cruzada com os últimos estados ocultos dos latentes, usando as saídas como consultas e os latentes como chaves e valores.
Diga-se, então, que se deseja realizar modelagem de linguagem mascarada (estilo BERT) com o Perceiver. Como o comprimento de entrada do Perceiver não terá impacto no tempo de computação das camadas de autoatenção, é possível fornecer bytes brutos, fornecendo `inputs` de comprimento 2048 ao modelo. Se agora se mascarar certos desses 2048 tokens, pode-se definir os `outputs` como tendo a forma: `(batch_size, 2048, 768)`. Em seguida, executa-se a atenção cruzada com os estados ocultos finais dos latentes para atualizar o tensor `outputs`. Após a atenção cruzada, ainda se tem um tensor de forma `(batch_size, 2048, 768)`. Então, pode-se colocar uma cabeça de modelagem de linguagem regular por cima, para projetar a última dimensão para o tamanho do vocabulário do modelo, ou seja, criando logits de forma `(batch_size, 2048, 262)` (como o Perceiver usa um tamanho de vocabulário de 262 IDs de byte).
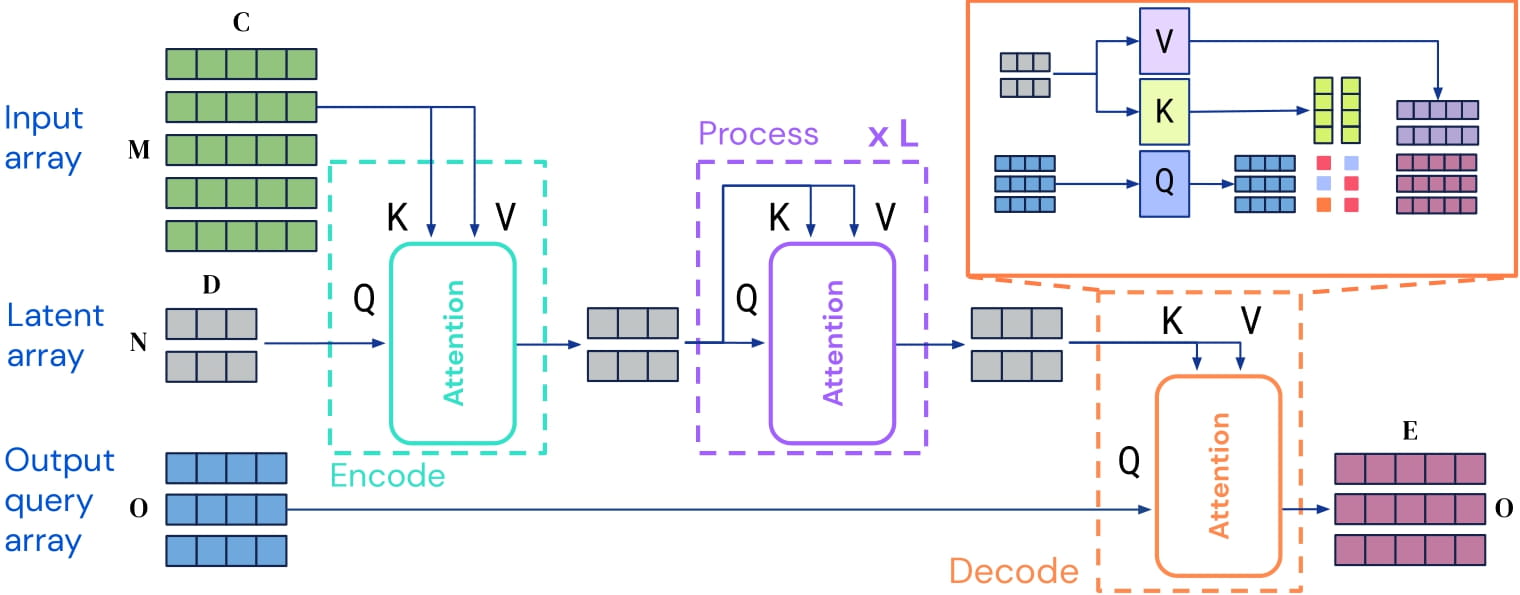 Arquitetura Perceiver IO. Retirada do artigo original
Este modelo foi contribuído por [nielsr](https://huggingface.co/nielsr). O código original pode ser encontrado [aqui](https://github.com/deepmind/deepmind-research/tree/master/perceiver).
O Perceiver **não** funciona com `torch.nn.DataParallel` devido a um bug no PyTorch, veja [issue #36035](https://github.com/pytorch/pytorch/issues/36035)
## Recursos
- A maneira mais rápida de começar com o Perceiver é verificar os [notebooks de tutorial](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Perceiver).
- Consulte o [post no blog](https://huggingface.co/blog/perceiver) se você quiser entender completamente como o modelo funciona e
é implementado na biblioteca. Observe que os modelos disponíveis na biblioteca apenas apresentam alguns exemplos do que você pode fazer com o Perceiver. Existem muitos outros casos de uso, incluindo question answering, named-entity recognition, object detection, audio classification, video classification, etc.
- [Guia da tarefa de classificação de texto](../tasks/sequence_classification)
- [Guia da tarefa de modelagem de linguagem mascarada](../tasks/masked_language_modeling)
- [Guia da tarefa de classificação de imagens](../tasks/image_classification)
## Saídas específicas do Perceiver[[transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput(logits: typing.Optional[torch.Tensor] = None, last_hidden_state: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor] | None = None, attentions: tuple[torch.Tensor] | None = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L53)
**Parâmetros:**
logits (`torch.Tensor` de forma `(batch_size, num_labels)`) : Pontuações de classificação (ou regressão se config.num_labels==1) (antes do SoftMax).
last_hidden_state (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Sequência de estados ocultos na saída da última camada do modelo.
hidden_states (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) : Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`. Hidden-states do modelo na saída de cada camada, além das saídas iniciais opcionais dos embeddings.
attentions (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) : Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`. Pesos das atenções após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
cross_attentions (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) : Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`. Pesos de atenção da camada de cross-attention do decodificador, após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de cross-attention.
Classe base para as saídas do modelo base Perceiver, com estados ocultos, atenções e atenções cruzadas potenciais.
#### transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput(logits: typing.Optional[torch.Tensor] = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L72)
**Parâmetros:**
logits (`torch.Tensor` de forma `(batch_size, num_labels)`) : Saída do decodificador básico.
cross_attentions (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) : Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`. Pesos de atenção da camada de cross-attention do decodificador, após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de cross-attention.
Classe base para as saídas do decodificador Perceiver, com possíveis cross-attentions.
#### transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput(loss: typing.Optional[torch.Tensor] = None, logits: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor] | None = None, attentions: tuple[torch.Tensor] | None = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L88)
**Parâmetros:**
loss (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) : Perda de modelagem de linguagem mascarada (MLM).
logits (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) : Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).
hidden_states (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) : Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`. Hidden-states do modelo na saída de cada camada, além das saídas iniciais opcionais dos embeddings.
attentions (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) : Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`. Pesos das atenções após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
cross_attentions (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) : Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`. Pesos de atenção da camada de cross-attention do decodificador, após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de cross-attention.
Classe base para as saídas do modelo de linguagem mascarado do Perceiver.
#### transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput(loss: typing.Optional[torch.Tensor] = None, logits: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor] | None = None, attentions: tuple[torch.Tensor] | None = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L110)
**Parâmetros:**
loss (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) : Perda de classificação (ou de regressão se config.num_labels==1).
logits (`torch.Tensor` de forma `(batch_size, config.num_labels)`) : Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).
hidden_states (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) : Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`. Hidden-states do modelo na saída de cada camada, além das saídas iniciais opcionais dos embeddings.
attentions (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) : Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`. Pesos das atenções após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
cross_attentions (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) : Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`. Pesos de atenção da camada de cross-attention do decodificador, após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de cross-attention.
Classe base para as saídas do Perceiver em modelos de classificação de sequência/imagem, fluxo óptico e auto-encodimento multimodal.
## PerceiverConfig[[transformers.PerceiverConfig]]
#### transformers.PerceiverConfig[[transformers.PerceiverConfig]]
```python
transformers.PerceiverConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, num_latents: int = 256, d_latents: int = 1280, d_model: int = 768, num_blocks: int = 1, num_self_attends_per_block: int = 26, num_self_attention_heads: int = 8, num_cross_attention_heads: int = 8, qk_channels: int | None = None, v_channels: int | None = None, cross_attention_shape_for_attention: str = 'kv', self_attention_widening_factor: int = 1, cross_attention_widening_factor: int = 1, hidden_act: str = 'gelu', attention_probs_dropout_prob: float | int = 0.1, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, use_query_residual: bool = True, vocab_size: int = 262, max_position_embeddings: int = 2048, image_size: int | list[int] | tuple[int, int] = 56, train_size: list[int] | tuple[int, ...] = (368, 496), num_frames: int = 16, audio_samples_per_frame: int = 1920, samples_per_patch: int = 16, output_shape: list[int] | tuple[int, ...] = (1, 16, 224, 224), output_num_channels: int = 512, _label_trainable_num_channels: int = 1024)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/configuration_perceiver.py#L24)
**Parâmetros:**
num_latents (`int`, *opcional*, padrão 256) : O número de latentes.
d_latents (`int`, *opcional*, padrão 1280) : Dimensão dos embeddings latentes.
d_model (`int`, *opcional*, padrão `768`) : Tamanho das camadas do codificador e da camada pooler.
num_blocks (`int`, *opcional*, padrão 1) : Número de blocos no codificador do Transformer.
num_self_attends_per_block (`int`, *opcional*, padrão 26) : O número de camadas de autoatenção por bloco.
num_self_attention_heads (`int`, *opcional*, padrão 8) : Número de cabeças de atenção para cada camada de autoatenção no codificador do Transformer.
num_cross_attention_heads (`int`, *opcional*, padrão 8) : Número de cabeças de atenção para cada camada de atenção cruzada no codificador do Transformer.
qk_channels (`int`, *opcional*) : Dimensão para projetar as queries + keys antes de aplicar a atenção nas camadas de cross-attention e self-attention do encoder. Se não for especificado, o padrão será preservar a dimensão das queries.
v_channels (`int`, *opcional*) : Dimensão para projetar os valores antes de aplicar a atenção nas camadas de atenção cruzada e autoatenção do codificador. Se não for especificado, o padrão será preservar a dimensão das consultas.
cross_attention_shape_for_attention (`str`, *opcional*, padrão `"kv"`) : Dimensão a ser usada ao reduzir a amostragem das queries e keys na camada de cross-attention do encoder.
self_attention_widening_factor (`int`, *opcional*, padrão 1) : Dimensão da camada feed-forward na camada de atenção cruzada do codificador do Transformer.
cross_attention_widening_factor (`int`, *opcional*, padrão 1) : Dimensão da camada feed-forward nas camadas de autoatenção do codificador do Transformer.
hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.1`) : A taxa de dropout para as probabilidades de atenção.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
layer_norm_eps (`float`, *opcional*, padrão `1e-12`) : O epsilon usado pelas camadas de normalização de camada.
use_query_residual (`float`, *opcional*, padrão `True`) : Se deve adicionar um residual de consulta na camada de atenção cruzada do codificador.
vocab_size (`int`, *opcional*, padrão `262`) : Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelos `input_ids`.
max_position_embeddings (`int`, *opcional*, padrão `2048`) : O comprimento máximo de sequência com o qual este modelo pode ser utilizado.
image_size (`int`, *opcional*, padrão 56) : Tamanho das imagens após o pré-processamento, para [PerceiverForImageClassificationLearned](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned).
train_size (`list[int]`, *opcional*, padrão `[368, 496]`) : Tamanho de treinamento das imagens para o modelo de fluxo óptico.
num_frames (`int`, *opcional*, padrão 16) : Número de quadros de vídeo usados para o modelo de autoencodagem multimodal.
audio_samples_per_frame (`int`, *opcional*, padrão 1920) : Número de amostras de áudio por quadro para o modelo de auto-encodagem multimodal.
samples_per_patch (`int`, *opcional*, padrão 16) : Número de amostras de áudio por patch ao pré-processar o áudio para o modelo de auto-encodagem multimodal.
output_shape (`list[int]`, *opcional*, padrão `[1, 16, 224, 224]`) : Formato da saída (batch_size, num_frames, height, width) para as consultas do decodificador de vídeo do modelo de auto-encodimento multimodal. Isso exclui a dimensão de canal.
output_num_channels (`int`, *opcional*, padrão 512) : Número de canais de saída para cada decodificador de modalidade.
Esta é a classe de configuração para armazenar a configuração de um PerceiverModel. Ela é usada para instanciar um modelo Perceiver de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [deepmind/language-perceiver](https://huggingface.co/deepmind/language-perceiver)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import PerceiverModel, PerceiverConfig
>>> # Initializing a Perceiver deepmind/language-perceiver style configuration
>>> configuration = PerceiverConfig()
>>> # Initializing a model from the deepmind/language-perceiver style configuration
>>> model = PerceiverModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## PerceiverTokenizer[[transformers.PerceiverTokenizer]]
#### transformers.PerceiverTokenizer[[transformers.PerceiverTokenizer]]
```python
transformers.PerceiverTokenizer(pad_token = '[PAD]', bos_token = '[BOS]', eos_token = '[EOS]', mask_token = '[MASK]', cls_token = '[CLS]', sep_token = '[SEP]', model_max_length = 2048, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/tokenization_perceiver.py#L23)
**Parâmetros:**
pad_token (`str`, *opcional*, padrão `"[PAD]"`) : O token usado para preenchimento, por exemplo, ao agrupar sequências de comprimentos diferentes.
bos_token (`str`, *opcional*, padrão `"[BOS]"`) : O token BOS (reservado no vocabulário, mas não utilizado de fato).
eos_token (`str`, *opcional*, padrão `"[EOS]"`) : O token de fim de sequência (reservado no vocabulário, mas não usado na prática). Ao construir uma sequência usando tokens especiais, este não é o token utilizado para o fim da sequência. O token utilizado é o `sep_token`.
mask_token (`str`, *opcional*, padrão `"[MASK]"`) : O token MASK, útil para modelagem de linguagem mascarada.
cls_token (`str`, *opcional*, padrão `"[CLS]"`) : O token CLS (reservado no vocabulário, mas não utilizado de fato).
sep_token (`str`, *opcional*, padrão `"[SEP]"`) : O token separador, usado ao construir uma sequência a partir de duas sequências.
Construa um tokenizador Perceiver. O Perceiver simplesmente usa a codificação utf-8 de bytes brutos.
Este tokenizer herda de [PreTrainedTokenizer](/docs/transformers/main/pt/main_classes/tokenizer#transformers.PythonBackend), que contém a maioria dos métodos principais. Os usuários devem consultar essa superclasse para obter mais informações sobre esses métodos.
#### __call__[[transformers.PerceiverTokenizer.__call__]]
```python
__call__(text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, text_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, text_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, text_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, add_special_tokens: bool = True, padding: bool | str | PaddingStrategy = False, truncation: bool | str | TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, is_split_into_words: bool = False, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, tokenizer_kwargs: dict[str, Any] | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/tokenization_utils_base.py#L2449)
**Parâmetros:**
text (`str`, `list[str]`, `list[list[str]]`, *opcional*) : A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se as sequências forem fornecidas como lista de strings (pretokenizadas), você deve definir `is_split_into_words=True` (para eliminar a ambiguidade com um lote de sequências).
text_pair (`str`, `list[str]`, `list[list[str]]`, *opcional*) : A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se as sequências forem fornecidas como lista de strings (pretokenizadas), você deve definir `is_split_into_words=True` (para eliminar a ambiguidade com um lote de sequências).
text_target (`str`, `list[str]`, `list[list[str]]`, *opcional*) : A sequência ou lote de sequências a serem codificadas como textos de destino. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se as sequências forem fornecidas como lista de strings (pretokenizadas), você deve definir `is_split_into_words=True` (para eliminar a ambiguidade com um lote de sequências).
text_pair_target (`str`, `list[str]`, `list[list[str]]`, *opcional*) : A sequência ou lote de sequências a serem codificadas como textos de destino. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se as sequências forem fornecidas como lista de strings (pretokenizadas), você deve definir `is_split_into_words=True` (para eliminar a ambiguidade com um lote de sequências).
tokenizer_kwargs (`dict[str, Any]`, *opcional*) : Kwargs adicionais para passar ao tokenizer. Eles serão mesclados com os parâmetros explícitos e outros kwargs, com os parâmetros explícitos tendo precedência.
add_special_tokens (`bool`, *opcional*, padrão `True`) : Indica se tokens especiais devem ser adicionados ao codificar as sequências. Isso utiliza a função subjacente `PretrainedTokenizerBase.build_inputs_with_special_tokens`, que define quais tokens são adicionados automaticamente aos ids de entrada. Isso é útil se você deseja adicionar automaticamente tokens `bos` ou `eos`.
padding (`bool`, `str` ou [PaddingStrategy](/docs/transformers/main/pt/internal/file_utils#transformers.utils.PaddingStrategy), *opcional*, padrão `False`) : Ativa e controla o padding. Aceita os seguintes valores: - `True` ou `'longest'`: Preenche até a sequência mais longa do lote (ou não aplica padding se apenas uma sequência for fornecida). - `'max_length'`: Preenche até o comprimento máximo especificado com o argumento `max_length` ou até o comprimento máximo aceitável de entrada para o modelo, caso esse argumento não seja fornecido. - `False` ou `'do_not_pad'` (padrão): Sem padding (ou seja, pode gerar um lote com sequências de comprimentos diferentes).
truncation (`bool`, `str` ou [TruncationStrategy](/docs/transformers/main/pt/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *opcional*, padrão `False`) : Ativa e controla a truncagem. Aceita os seguintes valores: - `True` ou `'longest_first'`: Trunca para um comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo de entrada aceitável para o modelo, caso esse argumento não seja fornecido. Isso trunca token por token, removendo um token da sequência mais longa do par, se um par de sequências (ou um lote de pares) for fornecido. - `'only_first'`: Trunca para um comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo de entrada aceitável para o modelo, caso esse argumento não seja fornecido. Isso trunca apenas a primeira sequência de um par, se um par de sequências (ou um lote de pares) for fornecido. - `'only_second'`: Trunca para um comprimento máximo especificado com o argumento `max_length` ou para o comprimento máximo de entrada aceitável para o modelo, caso esse argumento não seja fornecido. Isso trunca apenas a segunda sequência de um par, se um par de sequências (ou um lote de pares) for fornecido. - `False` ou `'do_not_truncate'` (padrão): Sem truncagem (ou seja, pode gerar um lote com comprimentos de sequência maiores que o tamanho máximo de entrada admissível do modelo).
max_length (`int`, *opcional*) : Controla o comprimento máximo a ser usado por um dos parâmetros de truncamento/preenchimento. Se não for definido ou for definido como `None`, será usado o comprimento máximo predefinido do modelo, caso um dos parâmetros de truncamento/preenchimento exija um comprimento máximo. Se o modelo não tiver um comprimento máximo de entrada específico (como o XLNet), o truncamento/preenchimento até um comprimento máximo será desativado.
stride (`int`, *opcional*, padrão 0) : Se definido como um número junto com `max_length`, os tokens excedentes retornados quando `return_overflowing_tokens=True` conterão alguns tokens do final da sequência truncada retornada, para fornecer alguma sobreposição entre as sequências truncada e excedente. O valor deste argumento define o número de tokens sobrepostos.
is_split_into_words (`bool`, *opcional*, padrão `False`) : Indica se a entrada já está pré-tokenizada (por exemplo, dividida em palavras). Se definido como `True`, o tokenizer assume que a entrada já foi dividida em palavras (por exemplo, separando por espaços em branco) e a tokenizará. Isso é útil para NER ou classificação de tokens.
pad_to_multiple_of (`int`, *opcional*) : Se definido, a sequência será preenchida até um múltiplo do valor fornecido. Exige que `padding` esteja ativado. Isso é especialmente útil para habilitar o uso de Tensor Cores em hardware NVIDIA com capacidade de computação `>= 7.5` (Volta).
padding_side (`str`, *opcional*) : O lado em que o modelo deve ter padding aplicado. Deve ser selecionado entre ['right', 'left']. O valor padrão é obtido do atributo de classe com o mesmo nome.
return_tensors (`str` ou [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *opcional*) : Se definido, retornará tensores em vez de lista de inteiros do Python. Os valores aceitos são: - `'pt'`: Retorna objetos `torch.Tensor` do PyTorch. - `'np'`: Retorna objetos `np.ndarray` do Numpy.
return_token_type_ids (`bool`, *opcional*) : Se deve retornar os IDs de tipo de token. Se mantido no padrão, retornará os IDs de tipo de token de acordo com o padrão do tokenizer específico, definido pelo atributo `return_outputs`. [O que são IDs de tipo de token?](../glossary#token-type-ids)
return_attention_mask (`bool`, *opcional*) : Indica se a máscara de atenção deve ser retornada. Se mantido o valor padrão, a máscara de atenção será retornada de acordo com o padrão do tokenizer específico, definido pelo atributo `return_outputs`. [O que são máscaras de atenção?](../glossary#attention-mask)
return_overflowing_tokens (`bool`, *opcional*, padrão `False`) : Indica se as sequências de tokens que excedem o limite devem ser retornadas. Se um par de sequências de ids de entrada (ou um lote de pares) for fornecido com `truncation_strategy = longest_first` ou `True`, um erro será lançado em vez de retornar os tokens excedentes.
return_special_tokens_mask (`bool`, *opcional*, padrão `False`) : Se deve ou não retornar informações da máscara de tokens especiais.
return_offsets_mapping (`bool`, *opcional*, padrão `False`) : Indica se deve ou não retornar `(char_start, char_end)` para cada token. Isso está disponível apenas em tokenizadores rápidos que herdam de [PreTrainedTokenizerFast](/docs/transformers/main/pt/main_classes/tokenizer#transformers.TokenizersBackend); se estiver usando o tokenizador do Python, este método lançará `NotImplementedError`.
return_length (`bool`, *opcional*, padrão `False`) : Indica se as comprimentos das entradas codificadas devem ser retornados.
verbose (`bool`, *opcional*, padrão `True`) : Se deve ou não exibir mais informações e avisos.
- ****kwargs** : passados para o método `self.tokenize()`
**Retorna:** [BatchEncoding](/docs/transformers/main/pt/main_classes/tokenizer#transformers.BatchEncoding)
Um [BatchEncoding](/docs/transformers/main/pt/main_classes/tokenizer#transformers.BatchEncoding) com os seguintes campos:
- **input_ids** -- Lista de ids de tokens a serem fornecidos a um modelo.
[O que são IDs de entrada?](../glossary#input-ids)
- **token_type_ids** -- Lista de ids de tipo de token a serem fornecidos a um modelo (quando `return_token_type_ids=True` ou se *"token_type_ids"* estiver em `self.model_input_names`).
[O que são IDs de tipo de token?](../glossary#token-type-ids)
- **attention_mask** -- Lista de índices que especifica quais tokens devem ser considerados pelo modelo (quando `return_attention_mask=True` ou se *"attention_mask"* estiver em `self.model_input_names`).
[O que são máscaras de atenção?](../glossary#attention-mask)
- **overflowing_tokens** -- Lista de sequências de tokens excedentes (quando um `max_length` é especificado e `return_overflowing_tokens=True`).
- **num_truncated_tokens** -- Número de tokens truncados (quando um `max_length` é especificado e `return_overflowing_tokens=True`).
- **special_tokens_mask** -- Lista de 0s e 1s, em que 1 especifica tokens especiais adicionados e 0 especifica tokens regulares da sequência (quando `add_special_tokens=True` e `return_special_tokens_mask=True`).
- **length** -- O comprimento das entradas (quando `return_length=True`)
Método principal para tokenizar e preparar uma ou várias sequências ou um ou vários pares de sequências para o modelo.
## PerceiverImageProcessor[[transformers.PerceiverImageProcessor]]
#### transformers.PerceiverImageProcessor[[transformers.PerceiverImageProcessor]]
```python
transformers.PerceiverImageProcessor(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/image_processing_perceiver.py#L33)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 224, 'width': 224}`): Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 256, 'width': 256}`): Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `3`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.485, 0.456, 0.406]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.229, 0.224, 0.225]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve aplicar um recorte centralizado na imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
Constrói um processador de imagem PerceiverImageProcessor.
#### preprocess[[transformers.PerceiverImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Sinalizador do desenvolvedor para entradas adicionais semelhantes a imagens que também serão pré-processadas. Use isso apenas se a passagem das entradas como kwarg não funcionar. Por exemplo, `preprocess(images, masks=masks)` é a opção preferida, mas resulta em problemas de prioridade de argumentos para alguns modelos. Nesses casos, `preprocess(images, image_like_inputs={"masks": masks})` pode ser usado em vez disso.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
Pré-processa uma imagem ou um lote de imagens.
## PerceiverImageProcessorPil[[transformers.PerceiverImageProcessorPil]]
#### transformers.PerceiverImageProcessorPil[[transformers.PerceiverImageProcessorPil]]
```python
transformers.PerceiverImageProcessorPil(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/image_processing_pil_perceiver.py#L31)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 224, 'width': 224}`): Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 256, 'width': 256}`): Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `3`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.485, 0.456, 0.406]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.229, 0.224, 0.225]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve aplicar um recorte centralizado na imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
Constrói um processador de imagem PerceiverImageProcessor.
#### preprocess[[transformers.PerceiverImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Sinalizador do desenvolvedor para entradas adicionais semelhantes a imagens que também serão pré-processadas. Use isso apenas se a passagem das entradas como kwarg não funcionar. Por exemplo, `preprocess(images, masks=masks)` é a opção preferida, mas resulta em problemas de prioridade de argumentos para alguns modelos. Nesses casos, `preprocess(images, image_like_inputs={"masks": masks})` pode ser usado em vez disso.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
Pré-processa uma imagem ou um lote de imagens.
## PerceiverTextPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor(config: PerceiverConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2662)
**Parâmetros:**
config ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) : Configuração do modelo.
Pré-processamento de texto para o Perceiver Encoder. Pode ser usado para incorporar `inputs` e adicionar codificações posicionais.
A dimensionalidade dos embeddings é determinada pelo atributo `d_model` da configuração.
## PerceiverImagePreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor(config, prep_type = 'conv', spatial_downsample: int = 4, temporal_downsample: int = 1, position_encoding_type: str = 'fourier', in_channels: int = 3, out_channels: int = 64, conv_after_patching: bool = False, conv_after_patching_in_channels: int = 54, conv2d_use_batchnorm: bool = True, concat_or_add_pos: str = 'concat', project_pos_dim: int = -1, **position_encoding_kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2825)
**Parâmetros:**
config ([*PerceiverConfig*]) : Configuração do modelo.
prep_type (`str`, *opcional*, padrão `"conv"`) : Tipo de pré-processamento. Pode ser "conv1x1", "conv", "patches", "pixels".
spatial_downsample (`int`, *opcional*, padrão 4) : Fator de redução espacial.
temporal_downsample (`int`, *opcional*, padrão 1) : Fator de downsampling temporal (relevante apenas se houver uma dimensão de tempo).
position_encoding_type (`str`, *opcional*, padrão `"fourier"`) : Tipo de codificação de posição. Pode ser "fourier" ou "trainable".
in_channels (`int`, *opcional*, padrão 3) : Número de canais na entrada.
out_channels (`int`, *opcional*, padrão 64) : Número de canais na saída.
conv_after_patching (`bool`, *opcional*, padrão `False`) : Se deve aplicar uma camada convolucional após o patching.
conv_after_patching_in_channels (`int`, *opcional*, padrão 54) : Número de canais na entrada da camada convolucional após o patching.
conv2d_use_batchnorm (`bool`, *opcional*, padrão `True`) : Se deve usar normalização de lote na camada convolucional.
concat_or_add_pos (`str`, *opcional*, padrão `"concat"`) : Como concatenar a codificação de posição à entrada. Pode ser "concat" ou "add".
project_pos_dim (`int`, *opcional*, padrão -1) : Dimensão da codificação de posição para projetar. Se -1, nenhuma projeção é aplicada.
- ****position_encoding_kwargs** (`Dict`, *opcional*) : Argumentos de palavra-chave para a codificação de posição.
Pré-processamento de imagem para o Perceiver Encoder.
Nota: o argumento *out_channels* se refere aos canais de saída de uma camada convolucional, caso *prep_type* esteja definido como "conv1x1" ou "conv". Se embeddings de posição absoluta forem adicionados, é necessário garantir que o *num_channels* dos kwargs de codificação de posição esteja igual ao *out_channels*.
## PerceiverOneHotPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor(config: PerceiverConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L3063)
**Parâmetros:**
config ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) : Configuração do modelo.
Pré-processador one-hot para o Perceiver Encoder. Pode ser usado para adicionar uma dimensão de índice fictícia à entrada.
## PerceiverAudioPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor(config, prep_type: str = 'patches', samples_per_patch: int = 96, position_encoding_type: str = 'fourier', concat_or_add_pos: str = 'concat', out_channels = 64, project_pos_dim = -1, **position_encoding_kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L3089)
**Parâmetros:**
config ([*PerceiverConfig*]) : Configuração do modelo.
prep_type (`str`, *opcional*, padrão `"patches"`) : Tipo de pré-processador a ser usado. Apenas "patches" é suportado.
samples_per_patch (`int`, *opcional*, padrão 96) : Número de amostras por patch.
position_encoding_type (`str`, *opcional*, padrão `"fourier"`) : Tipo de codificação de posição a ser usado. Pode ser "trainable" ou "fourier".
concat_or_add_pos (`str`, *opcional*, padrão `"concat"`) : Como concatenar a codificação de posição à entrada. Pode ser "concat" ou "add".
out_channels (`int`, *opcional*, padrão 64) : Número de canais na saída.
project_pos_dim (`int`, *opcional*, padrão -1) : Dimensão da codificação de posição para projetar. Se -1, nenhuma projeção é aplicada.
- ****position_encoding_kwargs** (`Dict`, *opcional*) : Argumentos de palavra-chave para a codificação de posição.
Pré-processamento de áudio para o Perceiver Encoder.
## PerceiverMultimodalPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor(modalities: Mapping, mask_probs: collections.abc.Mapping[str, float] | None = None, min_padding_size: int = 2)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L3192)
**Parâmetros:**
modalities (`Mapping[str, PreprocessorType]`) : Dicionário que mapeia o nome da modalidade para o pré-processador.
mask_probs (`dict[str, float]`) : Dicionário que mapeia o nome da modalidade para a probabilidade de mascaramento dessa modalidade.
min_padding_size (`int`, *opcional*, padrão 2) : O tamanho mínimo de padding para todas as modalidades. A saída final terá num_channels igual ao máximo de canais entre todas as modalidades mais min_padding_size.
Pré-processamento multimodal para Perceiver Encoder.
As entradas de cada modalidade são pré-processadas e, em seguida, preenchidas com embeddings de posição treináveis para que tenham o mesmo número de canais.
## PerceiverProjectionDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder(config)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1839)
**Parâmetros:**
config ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) : Configuração do modelo.
Decodificador de projeção de linha de base (sem atenção cruzada).
## PerceiverBasicDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder(config: PerceiverConfig, output_num_channels: int, position_encoding_type: str | None = 'trainable', output_index_dims: int | None = None, num_channels: int | None = 128, subsampled_index_dims: int | None = None, qk_channels: int | None = None, v_channels: int | None = None, num_heads: int | None = 1, widening_factor: int | None = 1, use_query_residual: bool | None = False, concat_preprocessed_input: bool | None = False, final_project: bool | None = True, position_encoding_only: bool | None = False, **position_encoding_kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1863)
**Parâmetros:**
config ([*PerceiverConfig*]) : Configuração do modelo.
output_num_channels (`int`, *opcional*) : O número de canais na saída. Será usado apenas se *final_project* estiver definido como `True`.
position_encoding_type (`str`, *opcional*, padrão "trainable") : O tipo de codificação de posição a ser usado. Pode ser "trainable", "fourier" ou "none".
output_index_dims (`int`, *opcional*) : O número de dimensões das consultas de saída. Ignorado se 'position_encoding_type' == 'none'.
num_channels (`int`, *opcional*, padrão 128) : O número de canais das consultas do decodificador. Ignorado se 'position_encoding_type' == 'none'.
qk_channels (`int`, *opcional*) : O número de canais das queries e keys na camada de cross-attention.
v_channels (`int`, *opcional*) : O número de canais dos valores na camada de atenção cruzada.
num_heads (`int`, *opcional*, padrão 1) : O número de cabeças de atenção na camada de atenção cruzada.
widening_factor (`int`, *opcional*, padrão 1) : O fator de alargamento da camada de atenção cruzada.
use_query_residual (`bool`, *opcional*, padrão `False`) : Se deve usar uma conexão residual entre a query e a saída da camada de atenção cruzada.
concat_preprocessed_input (`bool`, *opcional*, padrão `False`) : Se deve concatenar a entrada pré-processada à consulta.
final_project (`bool`, *opcional*, padrão `True`) : Se deve projetar a saída da camada de atenção cruzada para uma dimensão de destino.
position_encoding_only (`bool`, *opcional*, padrão `False`) : Se deve usar esta classe apenas para definir consultas de saída.
Decoder baseado em cross-attention. Esta classe pode ser usada para decodificar os estados ocultos finais dos latentes usando uma operação de cross-attention, na qual os latentes produzem as chaves e os valores.
A forma da saída desta classe depende de como se definem as consultas de saída (também chamadas de consultas do decodificador).
## PerceiverClassificationDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder(config, **decoder_kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2048)
**Parâmetros:**
config ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) : Configuração do modelo.
Decodificador de classificação baseado em atenção cruzada. Wrapper leve de `PerceiverBasicDecoder` para saída de logits. Converte a saída do codificador Perceiver, que tem a forma (batch_size, num_latents, d_latents), em um tensor de forma (batch_size, num_labels). As queries têm a forma (batch_size, 1, num_labels).
## PerceiverOpticalFlowDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder(config, output_image_shape, output_num_channels = 2, rescale_factor = 100.0, **decoder_kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2094)
Decodificador de fluxo óptico baseado em atenção cruzada.
## PerceiverBasicVideoAutoencodingDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder(config: PerceiverConfig, output_shape: list, position_encoding_type: str, **decoder_kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2129)
**Parâmetros:**
config ([*PerceiverConfig*]) : Configuração do modelo.
output_shape (`list[int]`) : Formato da saída como (batch_size, num_frames, height, width), excluindo a dimensão de canal.
position_encoding_type (`str`) : O tipo de codificação de posição a ser usado. Pode ser "trainable", "fourier" ou "none".
Decodificador de auto-encoding de vídeo baseado em atenção cruzada. Wrapper leve de [*PerceiverBasicDecoder*] com lógica de reorganização de vídeo.
## PerceiverMultimodalDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder(config: PerceiverConfig, modalities: dict, num_outputs: int, output_num_channels: int, min_padding_size: int | None = 2, subsampled_index_dims: dict[str, transformers.models.perceiver.modeling_perceiver.PerceiverAbstractDecoder] | None = None, **decoder_kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2206)
**Parâmetros:**
config ([*PerceiverConfig*]) : Configuração do modelo.
modalities (`dict[str, PerceiverAbstractDecoder]`) : Dicionário que mapeia o nome da modalidade para o decodificador dessa modalidade.
num_outputs (`int`) : O número de saídas do decodificador.
output_num_channels (`int`) : O número de canais na saída.
min_padding_size (`int`, *opcional*, padrão 2) : O tamanho mínimo de padding para todas as modalidades. A saída final terá num_channels igual ao máximo de canais entre todas as modalidades mais min_padding_size.
subsampled_index_dims (`dict[str, PerceiverAbstractDecoder]`, *opcional*) : Dicionário que mapeia o nome da modalidade para as dimensões de índice subsampleadas a serem usadas para a consulta do decodificador daquela modalidade.
Decodificação multimodal por composição de decodificadores unimodais. O argumento *modalities* do construtor é um dicionário que mapeia o nome da modalidade para o decodificador daquela modalidade. Esse decodificador será usado para construir consultas para aquela modalidade. As consultas específicas de cada modalidade são preenchidas com parâmetros treináveis específicos da modalidade, após o que são concatenadas ao longo da dimensão do tempo.
Em seguida, há uma operação de atenção cruzada compartilhada entre todas as modalidades.
## PerceiverProjectionPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor(in_channels: int, out_channels: int)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2804)
**Parâmetros:**
in_channels (`int`) : Número de canais na entrada.
out_channels (`int`) : Número de canais na saída.
Pós-processamento de projeção para Perceiver. Pode ser usado para projetar os canais da saída do decodificador para uma dimensão menor.
## PerceiverAudioPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor(config: PerceiverConfig, in_channels: int, postproc_type: str = 'patches')
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2777)
**Parâmetros:**
config ([*PerceiverConfig*]) : Configuração do modelo.
in_channels (`int`) : Número de canais na entrada.
postproc_type (`str`, *opcional*, padrão `"patches"`) : Tipo de pós-processador a ser usado. Atualmente, apenas "patches" é suportado.
Pós-processamento de áudio para Perceiver. Pode ser usado para converter a saída do decodificador em características de áudio.
## PerceiverClassificationPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor(config: PerceiverConfig, in_channels: int)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2757)
**Parâmetros:**
config ([*PerceiverConfig*]) : Configuração do modelo.
in_channels (`int`) : Número de canais na entrada.
Pós-processamento de classificação para Perceiver. Pode ser usado para converter a saída do decodificador em logits de classificação.
## PerceiverMultimodalPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor(modalities: Mapping, input_is_dict: bool = False)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2723)
**Parâmetros:**
modalities (`Mapping[str, PostprocessorType]`) : Dicionário que mapeia o nome da modalidade para a classe de pós-processador daquela modalidade.
input_is_dict (`bool`, *opcional*, padrão `False`) : Se True, a entrada é assumida como estruturada em dicionário, e as saídas mantêm a mesma forma de dicionário. Se False, a entrada é um tensor que é fatiado durante o pós-processamento por *modality_sizes*.
Pós-processamento multimodal para Perceiver. Pode ser usado para combinar pós-processadores específicos de modalidade em um único pós-processador.
## PerceiverModel[[transformers.PerceiverModel]]
#### transformers.PerceiverModel[[transformers.PerceiverModel]]
```python
transformers.PerceiverModel(config: PerceiverConfig, decoder: typing.Optional[ForwardRef('PerceiverAbstractDecoder')] = None, input_preprocessor: Callable = None, output_postprocessor: Callable = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L561)
**Parâmetros:**
config ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
decoder (`PerceiverDecoder`, *opcional*) : Módulo de decodificador que transforma representações latentes em previsões de tarefa.
input_preprocessor (`PreprocessorType`, *opcional*) : Preprocessador que codifica entradas brutas em tensores para o modelo.
output_postprocessor (`PostprocessorType`, *opcional*) : Pós-processador que transforma as saídas do modelo em previsões finais.
O Perceiver: uma arquitetura totalmente atencional e escalável.
Observe que é possível fazer o ajuste fino do Perceiver em imagens de resolução mais alta do que aquelas em que ele foi treinado, definindo `interpolate_pos_encoding` como `True` no forward do modelo. Isso interpolará os embeddings de posição pré-treinados para a resolução mais alta.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.PerceiverModel.forward]]
```python
forward(inputs: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, subsampled_output_points: dict[str, torch.Tensor] | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, interpolate_pos_encoding: bool = False, return_dict: bool | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L597)
**Parâmetros:**
inputs (`torch.Tensor`) : Entradas para o perceiver. Pode ser qualquer coisa: imagens, texto, áudio, vídeo, etc.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
subsampled_output_points (`dict[str, torch.Tensor]`, *opcional*) : Dicionário de tensores usados como consultas para o decodificador. O decodificador mapeia essas consultas para a representação latente do modelo. Usado para decodificação subsampleada, por exemplo, quando apenas certos patches de imagem são decodificados.
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** [PerceiverModelOutput](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput) ou `tuple(torch.Tensor)`
Um [PerceiverModelOutput](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) e das entradas.
O método forward do [PerceiverModel](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverModel) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **logits** (`torch.Tensor` de forma `(batch_size, num_labels)`) -- Pontuações de classificação (ou regressão se config.num_labels==1) (antes do SoftMax).
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) -- Sequência de hidden-states na saída da última camada do modelo.
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
Exemplos:
```python
>>> from transformers import PerceiverConfig, PerceiverTokenizer, PerceiverImageProcessor, PerceiverModel
>>> from transformers.models.perceiver.modeling_perceiver import (
... PerceiverTextPreprocessor,
... PerceiverImagePreprocessor,
... PerceiverClassificationDecoder,
... )
>>> import torch
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> # EXAMPLE 1: using the Perceiver to classify texts
>>> # - we define a TextPreprocessor, which can be used to embed tokens
>>> # - we define a ClassificationDecoder, which can be used to decode the
>>> # final hidden states of the latents to classification logits
>>> # using trainable position embeddings
>>> config = PerceiverConfig()
>>> preprocessor = PerceiverTextPreprocessor(config)
>>> decoder = PerceiverClassificationDecoder(
... config,
... num_channels=config.d_latents,
... trainable_position_encoding_kwargs=dict(num_channels=config.d_latents, index_dims=1),
... use_query_residual=True,
... )
>>> model = PerceiverModel(config, input_preprocessor=preprocessor, decoder=decoder)
>>> # you can then do a forward pass as follows:
>>> tokenizer = PerceiverTokenizer()
>>> text = "hello world"
>>> inputs = tokenizer(text, return_tensors="pt").input_ids
>>> with torch.no_grad():
... outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
>>> # to train, one can train the model using standard cross-entropy:
>>> criterion = torch.nn.CrossEntropyLoss()
>>> labels = torch.tensor([1])
>>> loss = criterion(logits, labels)
>>> # EXAMPLE 2: using the Perceiver to classify images
>>> # - we define an ImagePreprocessor, which can be used to embed images
>>> config = PerceiverConfig(image_size=224)
>>> preprocessor = PerceiverImagePreprocessor(
... config,
... prep_type="conv1x1",
... spatial_downsample=1,
... out_channels=256,
... position_encoding_type="trainable",
... concat_or_add_pos="concat",
... project_pos_dim=256,
... trainable_position_encoding_kwargs=dict(
... num_channels=256,
... index_dims=config.image_size**2,
... ),
... )
>>> model = PerceiverModel(
... config,
... input_preprocessor=preprocessor,
... decoder=PerceiverClassificationDecoder(
... config,
... num_channels=config.d_latents,
... trainable_position_encoding_kwargs=dict(num_channels=config.d_latents, index_dims=1),
... use_query_residual=True,
... ),
... )
>>> # you can then do a forward pass as follows:
>>> image_processor = PerceiverImageProcessor()
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = image_processor(image, return_tensors="pt").pixel_values
>>> with torch.no_grad():
... outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
>>> # to train, one can train the model using standard cross-entropy:
>>> criterion = torch.nn.CrossEntropyLoss()
>>> labels = torch.tensor([1])
>>> loss = criterion(logits, labels)
```
## PerceiverForMaskedLM[[transformers.PerceiverForMaskedLM]]
#### transformers.PerceiverForMaskedLM[[transformers.PerceiverForMaskedLM]]
```python
transformers.PerceiverForMaskedLM(config: PerceiverConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L807)
**Parâmetros:**
config ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Exemplo de uso do Perceiver para modelagem de linguagem mascarada.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.PerceiverForMaskedLM.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, input_ids: typing.Optional[torch.Tensor] = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L839)
**Parâmetros:**
inputs (`torch.Tensor`, *opcional*) : Entradas do perceiver. Pode ser qualquer coisa: imagens, texto, áudio, vídeo, etc.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
labels (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Rótulos para calcular a perda de modelagem de linguagem mascarada. Os índices devem estar em `[-100, 0, ..., config.vocab_size]` (veja a docstring de `input_ids`). Tokens com índices definidos como `-100` são ignorados (mascarados); a perda é calculada apenas para os tokens com rótulos em `[0, ..., config.vocab_size]`.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
**Retorna:** [PerceiverMaskedLMOutput](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput) ou `tuple(torch.Tensor)`
Um [PerceiverMaskedLMOutput](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) e das entradas.
O método forward de [PerceiverForMaskedLM](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverForMaskedLM) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de modelagem de linguagem mascarada (MLM).
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
Exemplos:
```python
>>> from transformers import AutoTokenizer, PerceiverForMaskedLM
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("deepmind/language-perceiver")
>>> model = PerceiverForMaskedLM.from_pretrained("deepmind/language-perceiver")
>>> # training
>>> text = "This is an incomplete sentence where some words are missing."
>>> inputs = tokenizer(text, padding="max_length", return_tensors="pt")
>>> # mask " missing."
>>> inputs["input_ids"][0, 52:61] = tokenizer.mask_token_id
>>> labels = tokenizer(text, padding="max_length", return_tensors="pt").input_ids
>>> outputs = model(**inputs, labels=labels)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
19.87
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2048, 262]
>>> # inference
>>> text = "This is an incomplete sentence where some words are missing."
>>> encoding = tokenizer(text, padding="max_length", return_tensors="pt")
>>> # mask bytes corresponding to " missing.". Note that the model performs much better if the masked span starts with a space.
>>> encoding["input_ids"][0, 52:61] = tokenizer.mask_token_id
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2048, 262]
>>> masked_tokens_predictions = logits[0, 52:61].argmax(dim=-1).tolist()
>>> tokenizer.decode(masked_tokens_predictions)
' missing.'
```
## PerceiverForSequenceClassification[[transformers.PerceiverForSequenceClassification]]
#### transformers.PerceiverForSequenceClassification[[transformers.PerceiverForSequenceClassification]]
```python
transformers.PerceiverForSequenceClassification(config: PerceiverConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L940)
**Parâmetros:**
config ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Exemplo de uso do Perceiver para classificação de texto.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.PerceiverForSequenceClassification.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, input_ids: typing.Optional[torch.Tensor] = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L961)
**Parâmetros:**
inputs (`torch.Tensor`, *opcional*) : Entradas do perceiver. Pode ser qualquer coisa: imagens, texto, áudio, vídeo, etc.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para o cálculo da perda de classificação/regressão. Os índices devem estar em `[0, ..., config.num_labels - 1]`. Se `config.num_labels == 1`, uma perda de regressão é calculada (perda de erro quadrático médio). Se `config.num_labels > 1`, uma perda de classificação é calculada (entropia cruzada).
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
**Retorna:** [PerceiverClassifierOutput](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou `tuple(torch.Tensor)`
Um [PerceiverClassifierOutput](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) e das entradas.
O método forward de [PerceiverForSequenceClassification](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverForSequenceClassification) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação (ou de regressão se config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
Exemplos:
```python
>>> from transformers import AutoTokenizer, PerceiverForSequenceClassification
>>> tokenizer = AutoTokenizer.from_pretrained("deepmind/language-perceiver")
>>> model = PerceiverForSequenceClassification.from_pretrained("deepmind/language-perceiver")
>>> text = "hello world"
>>> inputs = tokenizer(text, return_tensors="pt").input_ids
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
```
## PerceiverForImageClassificationLearned[[transformers.PerceiverForImageClassificationLearned]]
#### transformers.PerceiverForImageClassificationLearned[[transformers.PerceiverForImageClassificationLearned]]
```python
transformers.PerceiverForImageClassificationLearned(config: PerceiverConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1062)
**Parâmetros:**
config ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Exemplo de uso do Perceiver para classificação de imagens, em tarefas como ImageNet.
Este modelo usa embeddings de posição aprendidos. Em outras palavras, este modelo não recebe nenhuma informação privilegiada sobre a estrutura das imagens. Conforme mostrado no artigo, este modelo pode alcançar uma precisão top-1 de 72,7 no ImageNet.
[PerceiverForImageClassificationLearned](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned) usa [PerceiverImagePreprocessor](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor) (com `prep_type="conv1x1"`) para pré-processar as imagens de entrada e [PerceiverClassificationDecoder](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder) para decodificar a representação latente de [PerceiverModel](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverModel) em logits de classificação.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.PerceiverForImageClassificationLearned.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, return_dict: bool | None = None, pixel_values: typing.Optional[torch.Tensor] = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1093)
**Parâmetros:**
inputs (`torch.Tensor`, *opcional*) : Entradas do perceiver. Pode ser qualquer coisa: imagens, texto, áudio, vídeo, etc.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para o cálculo da perda de classificação/regressão de imagem. Os índices devem estar em `[0, ..., config.num_labels - 1]`. Se `config.num_labels == 1`, uma perda de regressão é calculada (perda de erro quadrático médio). Se `config.num_labels > 1`, uma perda de classificação é calculada (entropia cruzada).
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [PerceiverImageProcessor](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverImageProcessor). Veja [PerceiverImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes (`processor_class` usa [PerceiverImageProcessor](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverImageProcessor) para processar imagens).
**Retorna:** [PerceiverClassifierOutput](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou `tuple(torch.Tensor)`
Um [PerceiverClassifierOutput](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) e das entradas.
O método forward de [PerceiverForImageClassificationLearned](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação (ou de regressão se config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
Exemplos:
```python
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationLearned
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-learned")
>>> model = PerceiverForImageClassificationLearned.from_pretrained("deepmind/vision-perceiver-learned")
>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
```
## PerceiverForImageClassificationFourier[[transformers.PerceiverForImageClassificationFourier]]
#### transformers.PerceiverForImageClassificationFourier[[transformers.PerceiverForImageClassificationFourier]]
```python
transformers.PerceiverForImageClassificationFourier(config: PerceiverConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1187)
**Parâmetros:**
config ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Exemplo de uso do Perceiver para classificação de imagens, em tarefas como ImageNet.
Este modelo usa embeddings de posição 2D de Fourier fixos. Conforme mostrado no artigo, este modelo pode alcançar uma precisão top-1 de 79,0 no ImageNet e 84,5 quando pré-treinado em um conjunto de dados em larga escala (ou seja, JFT).
[PerceiverForImageClassificationLearned](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned) usa [PerceiverImagePreprocessor](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor) (com `prep_type="pixels"`) para pré-processar as imagens de entrada e [PerceiverClassificationDecoder](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder) para decodificar a representação latente de [PerceiverModel](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverModel) em logits de classificação.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.PerceiverForImageClassificationFourier.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, pixel_values: typing.Optional[torch.Tensor] = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1219)
**Parâmetros:**
inputs (`torch.Tensor`, *opcional*) : Entradas do perceiver. Pode ser qualquer coisa: imagens, texto, áudio, vídeo, etc.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para o cálculo da perda de classificação/regressão de imagem. Os índices devem estar em `[0, ..., config.num_labels - 1]`. Se `config.num_labels == 1`, uma perda de regressão é calculada (perda de erro quadrático médio). Se `config.num_labels > 1`, uma perda de classificação é calculada (entropia cruzada).
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [PerceiverImageProcessor](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverImageProcessor). Veja [PerceiverImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes (`processor_class` usa [PerceiverImageProcessor](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverImageProcessor) para processar imagens).
**Retorna:** [PerceiverClassifierOutput](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou `tuple(torch.Tensor)`
Um [PerceiverClassifierOutput](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) e das entradas.
O método forward de [PerceiverForImageClassificationFourier](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverForImageClassificationFourier) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação (ou de regressão se config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
Exemplos:
```python
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationFourier
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-fourier")
>>> model = PerceiverForImageClassificationFourier.from_pretrained("deepmind/vision-perceiver-fourier")
>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
```
## PerceiverForImageClassificationConvProcessing[[transformers.PerceiverForImageClassificationConvProcessing]]
#### transformers.PerceiverForImageClassificationConvProcessing[[transformers.PerceiverForImageClassificationConvProcessing]]
```python
transformers.PerceiverForImageClassificationConvProcessing(config: PerceiverConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1310)
**Parâmetros:**
config ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Exemplo de uso do Perceiver para classificação de imagens, em tarefas como ImageNet.
Este modelo utiliza uma rede de pré-processamento conv2D+maxpool. Conforme mostrado no artigo, este modelo pode alcançar uma precisão top-1 de 82,1 no ImageNet.
[PerceiverForImageClassificationLearned](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned) usa [PerceiverImagePreprocessor](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor) (com `prep_type="conv"`) para pré-processar as imagens de entrada e [PerceiverClassificationDecoder](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder) para decodificar a representação latente de [PerceiverModel](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverModel) em logits de classificação.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.PerceiverForImageClassificationConvProcessing.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, pixel_values: typing.Optional[torch.Tensor] = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1343)
**Parâmetros:**
inputs (`torch.Tensor`, *opcional*) : Entradas do perceiver. Pode ser qualquer coisa: imagens, texto, áudio, vídeo, etc.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para o cálculo da perda de classificação/regressão de imagem. Os índices devem estar em `[0, ..., config.num_labels - 1]`. Se `config.num_labels == 1`, uma perda de regressão é calculada (perda de erro quadrático médio). Se `config.num_labels > 1`, uma perda de classificação é calculada (entropia cruzada).
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [PerceiverImageProcessor](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverImageProcessor). Veja [PerceiverImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes (`processor_class` usa [PerceiverImageProcessor](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverImageProcessor) para processar imagens).
**Retorna:** [PerceiverClassifierOutput](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou `tuple(torch.Tensor)`
Um [PerceiverClassifierOutput](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) e das entradas.
O método forward de [PerceiverForImageClassificationConvProcessing](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverForImageClassificationConvProcessing) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação (ou de regressão se config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
Exemplos:
```python
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationConvProcessing
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-conv")
>>> model = PerceiverForImageClassificationConvProcessing.from_pretrained("deepmind/vision-perceiver-conv")
>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
```
## PerceiverForOpticalFlow[[transformers.PerceiverForOpticalFlow]]
#### transformers.PerceiverForOpticalFlow[[transformers.PerceiverForOpticalFlow]]
```python
transformers.PerceiverForOpticalFlow(config: PerceiverConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1434)
**Parâmetros:**
config ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Exemplo de uso do Perceiver para fluxo óptico, em tarefas como Sintel e KITTI. [PerceiverForOpticalFlow](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverForOpticalFlow) usa [PerceiverImagePreprocessor](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor) (com *prep_type="patches"*) para pré-processar as imagens de entrada e [PerceiverOpticalFlowDecoder](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder) para decodificar a representação latente de [PerceiverModel](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverModel).
Como entrada, concatenam-se 2 quadros subsequentes ao longo da dimensão de canal e extrai-se um patch de 3 x 3 ao redor de cada pixel (resultando em 3 x 3 x 3 x 2 = 54 valores para cada pixel). Codificações de posição de Fourier fixas são usadas para codificar a posição de cada pixel no patch. Em seguida, aplica-se o codificador Perceiver. Para decodificar, consulta-se a representação latente usando a mesma codificação utilizada para a entrada.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.PerceiverForOpticalFlow.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1484)
**Parâmetros:**
inputs (`torch.Tensor`, *opcional*) : Entradas do perceiver. Pode ser qualquer coisa: imagens, texto, áudio, vídeo, etc.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para calcular a perda de fluxo óptico. Os índices devem estar em `[0, ..., config.num_labels - 1]`.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** [PerceiverClassifierOutput](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou `tuple(torch.Tensor)`
Um [PerceiverClassifierOutput](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) e das entradas.
O método forward de [PerceiverForOpticalFlow](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverForOpticalFlow) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação (ou de regressão se config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
Exemplos:
```python
>>> from transformers import PerceiverForOpticalFlow
>>> import torch
>>> model = PerceiverForOpticalFlow.from_pretrained("deepmind/optical-flow-perceiver")
>>> # in the Perceiver IO paper, the authors extract a 3 x 3 patch around each pixel,
>>> # leading to 3 x 3 x 3 = 27 values for each pixel (as each pixel also has 3 color channels)
>>> # patches have shape (batch_size, num_frames, num_channels, height, width)
>>> # the authors train on resolutions of 368 x 496
>>> patches = torch.randn(1, 2, 27, 368, 496)
>>> outputs = model(inputs=patches)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 368, 496, 2]
```
## PerceiverForMultimodalAutoencoding[[transformers.PerceiverForMultimodalAutoencoding]]
#### transformers.PerceiverForMultimodalAutoencoding[[transformers.PerceiverForMultimodalAutoencoding]]
```python
transformers.PerceiverForMultimodalAutoencoding(config: PerceiverConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1576)
**Parâmetros:**
config ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Exemplo de uso do Perceiver para autoencoding multimodal (vídeo), para tarefas como Kinetics-700.
[PerceiverForMultimodalAutoencoding](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverForMultimodalAutoencoding) usa [PerceiverMultimodalPreprocessor](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor) para pré-processar as 3 modalidades: imagens, áudio e rótulos de classe. Este pré-processador usa pré-processadores específicos de cada modalidade para pré-processar cada uma separadamente, após o que são concatenadas. Embeddings de posição treináveis são usados para preencher cada modalidade até o mesmo número de canais, tornando possível a concatenação ao longo da dimensão do tempo. Em seguida, aplica-se o codificador Perceiver.
[PerceiverMultimodalDecoder](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder) é usado para decodificar a representação latente de [PerceiverModel](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverModel). Este decodificador usa cada decodificador específico de modalidade para construir consultas. As consultas do decodificador são criadas com base nas entradas após o pré-processamento. No entanto, auto-encodar um vídeo inteiro em uma única passagem de frente é computacionalmente inviável, portanto, usa-se apenas partes das consultas do decodificador para realizar atenção cruzada com a representação latente. Isso é determinado pelos índices subsampleados para cada modalidade, que podem ser fornecidos como entrada adicional para a passagem de frente de [PerceiverForMultimodalAutoencoding](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverForMultimodalAutoencoding).
[PerceiverMultimodalDecoder](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder) também aplica padding às queries do decodificador das diferentes modalidades para que tenham o mesmo número de canais, a fim de concatená-las ao longo da dimensão do tempo. Em seguida, é realizada a atenção cruzada com a representação latente de [PerceiverModel](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverModel).
Por fim, `~models.perceiver.modeling_perceiver.PerceiverMultiModalPostprocessor` é usado para transformar esse tensor em um vídeo real. Primeiro, ele divide a saída nas diferentes modalidades e, em seguida, aplica o postprocessor respectivo para cada modalidade.
Observe que, ao mascarar o rótulo de classificação durante a avaliação (ou seja, fornecendo simplesmente um tensor de zeros para a modalidade "label"), este modelo de auto-encodimento se torna um classificador de vídeos Kinetics 700.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.PerceiverForMultimodalAutoencoding.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, subsampled_output_points: dict[str, torch.Tensor] | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1692)
**Parâmetros:**
inputs (`torch.Tensor`, *opcional*) : Entradas do perceiver. Pode ser qualquer coisa: imagens, texto, áudio, vídeo, etc.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
subsampled_output_points (`dict[str, torch.Tensor]`, *opcional*) : Dicionário de tensores usados como consultas para o decodificador. O decodificador mapeia essas consultas para a representação latente do modelo. Usado para decodificação subsampleada, por exemplo, quando apenas certos patches de imagem são decodificados.
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para o cálculo da perda de classificação/regressão de imagem. Os índices devem estar em `[0, ..., config.num_labels - 1]`. Se `config.num_labels == 1`, uma perda de regressão é calculada (perda de erro quadrático médio). Se `config.num_labels > 1`, uma perda de classificação é calculada (entropia cruzada).
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** [PerceiverClassifierOutput](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou `tuple(torch.Tensor)`
Um [PerceiverClassifierOutput](/docs/transformers/main/pt/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([PerceiverConfig](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverConfig)) e das entradas.
O método forward de [PerceiverForMultimodalAutoencoding](/docs/transformers/main/pt/model_doc/perceiver#transformers.PerceiverForMultimodalAutoencoding) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação (ou de regressão se config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
Exemplos:
```python
>>> from transformers import PerceiverForMultimodalAutoencoding
>>> import torch
>>> import numpy as np
>>> # create multimodal inputs
>>> images = torch.randn((1, 16, 3, 224, 224))
>>> audio = torch.randn((1, 30720, 1))
>>> inputs = dict(image=images, audio=audio, label=torch.zeros((images.shape[0], 700)))
>>> model = PerceiverForMultimodalAutoencoding.from_pretrained("deepmind/multimodal-perceiver")
>>> # in the Perceiver IO paper, videos are auto-encoded in chunks
>>> # each chunk subsamples different index dimensions of the image and audio modality decoder queries
>>> nchunks = 128
>>> image_chunk_size = np.prod((16, 224, 224)) // nchunks
>>> audio_chunk_size = audio.shape[1] // model.config.samples_per_patch // nchunks
>>> # process the first chunk
>>> chunk_idx = 0
>>> subsampling = {
... "image": torch.arange(image_chunk_size * chunk_idx, image_chunk_size * (chunk_idx + 1)),
... "audio": torch.arange(audio_chunk_size * chunk_idx, audio_chunk_size * (chunk_idx + 1)),
... "label": None,
... }
>>> outputs = model(inputs=inputs, subsampled_output_points=subsampling)
>>> logits = outputs.logits
>>> list(logits["audio"].shape)
[1, 240]
>>> list(logits["image"].shape)
[1, 6272, 3]
>>> list(logits["label"].shape)
[1, 700]
```