# SAM
## Visão geral
SAM (Segment Anything Model) foi proposto em [Segment Anything](https://huggingface.co/papers/2304.02643) por Alexander Kirillov, Eric Mintun, Nikhila Ravi, Hanzi Mao, Chloe Rolland, Laura Gustafson, Tete Xiao, Spencer Whitehead, Alex Berg, Wan-Yen Lo, Piotr Dollar, Ross Girshick.
O modelo pode ser usado para prever máscaras de segmentação de qualquer objeto de interesse, dado uma imagem de entrada.
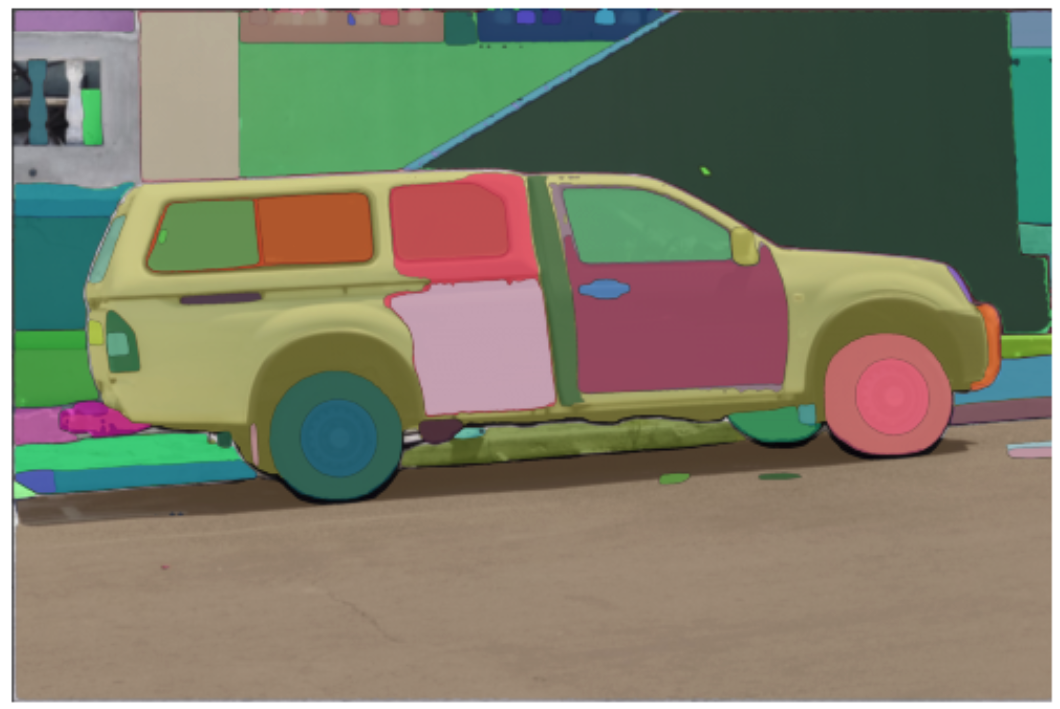
O resumo do artigo é o seguinte:
*Apresentamos o projeto Segment Anything (SA): uma nova tarefa, modelo e conjunto de dados para segmentação de imagens. Utilizando nosso modelo eficiente em um loop de coleta de dados, construímos o maior conjunto de dados de segmentação até o momento (de longe), com mais de 1 bilhão de máscaras em 11M de imagens licenciadas e que respeitam a privacidade. O modelo é projetado e treinado para ser acionável por prompts, permitindo que ele se transfira de forma zero-shot para novas distribuições e tarefas de imagens. Avaliamos suas capacidades em diversas tarefas e constatamos que seu desempenho zero-shot é impressionante — frequentemente competitivo ou até superior a resultados totalmente supervisionados anteriores. Estamos liberando o Segment Anything Model (SAM) e o conjunto de dados correspondente (SA-1B), com 1 bilhão de máscaras e 11M de imagens, em [https://segment-anything.com](https://segment-anything.com) para fomentar a pesquisa em modelos de fundação para visão computacional.*
Dicas:
- O modelo prevê máscaras binárias que indicam a presença ou não do objeto de interesse a partir de uma imagem.
- O modelo prevê resultados muito melhores se pontos 2D de entrada e/ou caixas delimitadoras de entrada forem fornecidos
- Você pode inserir múltiplos pontos para a mesma imagem e prever uma única máscara.
- O ajuste fino do modelo ainda não é suportado
- De acordo com o artigo, a entrada textual também deveria ser suportada. No entanto, no momento da redação deste texto, isso não parece ser suportado, conforme [o repositório oficial](https://github.com/facebookresearch/segment-anything/issues/4#issuecomment-1497626844).
Este modelo foi contribuído por [ybelkada](https://huggingface.co/ybelkada) e [ArthurZ](https://huggingface.co/ArthurZ). O código original pode ser encontrado [aqui](https://github.com/facebookresearch/segment-anything).
Abaixo, há um exemplo de como executar a geração de máscaras a partir de uma imagem e de um ponto 2D:
```python
import requests
import torch
from PIL import Image
from transformers import SamModel, SamProcessor
model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")
img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
input_points = [[[450, 600]]] # 2D location of a window in the image
inputs = processor(raw_image, input_points=input_points, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
masks = processor.image_processor.post_process_masks(
outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
```
Você também pode processar suas próprias máscaras junto com as imagens de entrada no processador, para que sejam passadas ao modelo.
```python
import requests
import torch
from PIL import Image
from transformers import SamModel, SamProcessor
model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")
img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
mask_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
segmentation_map = Image.open(requests.get(mask_url, stream=True).raw).convert("1")
input_points = [[[450, 600]]] # 2D location of a window in the image
inputs = processor(raw_image, input_points=input_points, segmentation_maps=segmentation_map, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
masks = processor.image_processor.post_process_masks(
outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
```
## Recursos
Uma lista de recursos oficiais da Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o SAM.
- [Nota de demonstração](https://github.com/huggingface/notebooks/blob/main/examples/segment_anything.ipynb) para usar o modelo.
- [Nota de demonstração](https://github.com/huggingface/notebooks/blob/main/examples/automatic_mask_generation.ipynb) para usar o pipeline de geração automática de máscaras.
- [Nota de demonstração](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/SAM/Run_inference_with_MedSAM_using_HuggingFace_Transformers.ipynb) para inferência com MedSAM, uma versão ajustada do SAM no domínio médico. 🌎
- [Nota de demonstração](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/SAM/Fine_tune_SAM_(segment_anything)_on_a_custom_dataset.ipynb) para ajuste fino do modelo em dados personalizados. 🌎
## SlimSAM
SlimSAM, uma versão podada do SAM, foi proposta em [0.1% Data Makes Segment Anything Slim](https://huggingface.co/papers/2312.05284) por Zigeng Chen et al. O SlimSAM reduz consideravelmente o tamanho dos modelos SAM, mantendo o mesmo desempenho.
Os checkpoints podem ser encontrados no [hub](https://huggingface.co/models?other=slimsam) e podem ser usados como substituto direto do SAM.
## Grounded SAM
É possível combinar [Grounding DINO](grounding-dino) com SAM para geração de máscaras baseadas em texto, conforme introduzido em [Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks](https://huggingface.co/papers/2401.14159). Consulte este [notebook de demonstração](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/Grounding%20DINO/GroundingDINO_with_Segment_Anything.ipynb) 🌍 para mais detalhes.
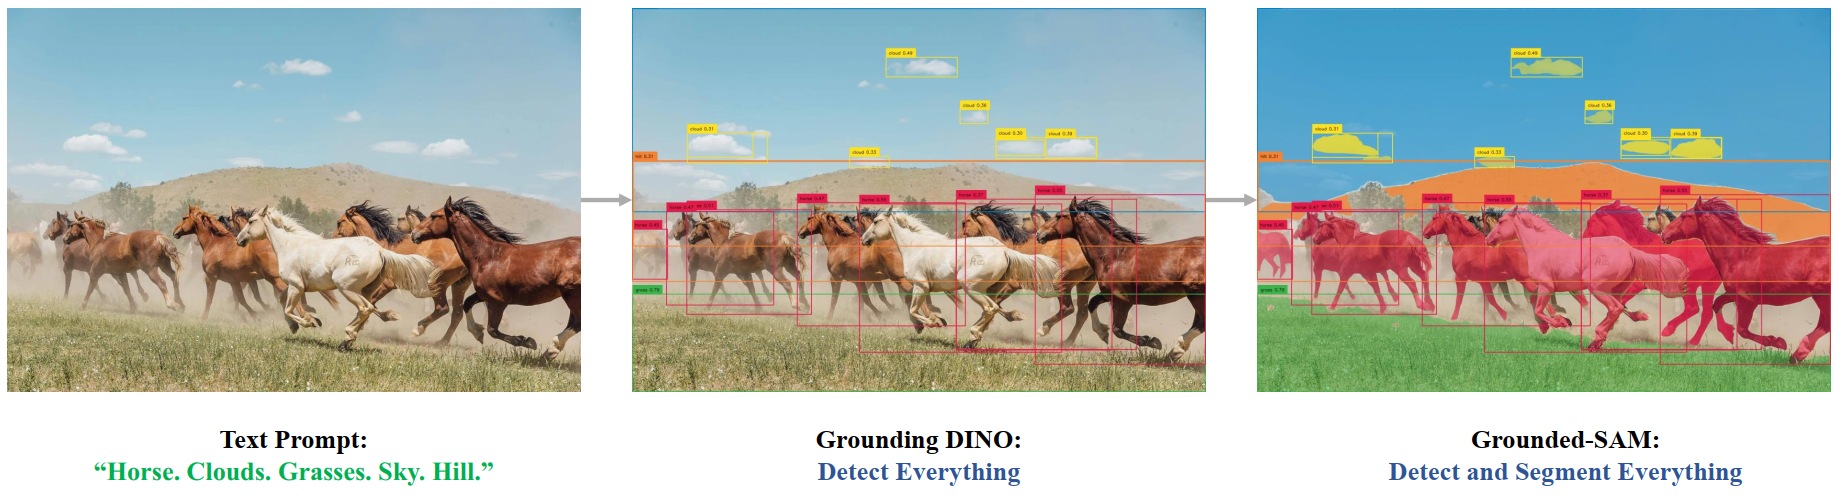 Visão geral do Grounded SAM. Retirado do repositório original.
## SamConfig[[transformers.SamConfig]]
#### transformers.SamConfig[[transformers.SamConfig]]
```python
transformers.SamConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, prompt_encoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, mask_decoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, initializer_range: float = 0.02, tie_word_embeddings: bool = True)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/configuration_sam.py#L146)
**Parâmetros:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : O objeto de configuração ou dicionário do backbone de visão.
prompt_encoder_config (Union[`dict`, `SamPromptEncoderConfig`], *opcional*) : Dicionário de opções de configuração usadas para inicializar [SamPromptEncoderConfig](/docs/transformers/main/pt/model_doc/sam#transformers.SamPromptEncoderConfig).
mask_decoder_config (Union[`dict`, `SamMaskDecoderConfig`], *opcional*) : Dicionário de opções de configuração usadas para inicializar [SamMaskDecoderConfig](/docs/transformers/main/pt/model_doc/sam#transformers.SamMaskDecoderConfig).
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
tie_word_embeddings (`bool`, *opcional*, padrão `True`) : Se deve vincular as embeddings de pesos de acordo com o mapeamento `tied_weights_keys` do modelo.
Esta é a classe de configuração para armazenar a configuração de um SamModel. Ela é usada para instanciar um modelo Sam de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import (
... SamVisionConfig,
... SamPromptEncoderConfig,
... SamMaskDecoderConfig,
... SamModel,
... )
>>> # Initializing a SamConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamConfig()
>>> # Initializing a SamModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a SamConfig from a SamVisionConfig, SamPromptEncoderConfig, and SamMaskDecoderConfig
>>> # Initializing SAM vision, SAM Q-Former and language model configurations
>>> vision_config = SamVisionConfig()
>>> prompt_encoder_config = SamPromptEncoderConfig()
>>> mask_decoder_config = SamMaskDecoderConfig()
>>> config = SamConfig(vision_config, prompt_encoder_config, mask_decoder_config)
```
## SamVisionConfig[[transformers.SamVisionConfig]]
#### transformers.SamVisionConfig[[transformers.SamVisionConfig]]
```python
transformers.SamVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, output_channels: int = 256, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 1024, patch_size: int | list[int] | tuple[int, int] = 16, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06, attention_dropout: float | int = 0.0, initializer_range: float = 1e-10, qkv_bias: bool = True, mlp_ratio: float = 4.0, use_abs_pos: bool = True, use_rel_pos: bool = True, window_size: int = 14, global_attn_indexes: list[int] | tuple[int, ...] = (2, 5, 8, 11), num_pos_feats: int = 128, mlp_dim: int | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/configuration_sam.py#L81)
**Parâmetros:**
hidden_size (`int`, *opcional*, padrão `768`) : Dimensão das representações ocultas.
output_channels (`int`, *opcional*, padrão 256) : Dimensionalidade dos canais de saída no Patch Encoder.
num_hidden_layers (`int`, *opcional*, padrão `12`) : Número de camadas ocultas no decodificador do Transformer.
num_attention_heads (`int`, *opcional*, padrão `12`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
num_channels (`int`, *opcional*, padrão `3`) : O número de canais de entrada.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `1024`) : O tamanho (resolução) de cada imagem.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `16`) : O tamanho (resolução) de cada patch.
hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *opcional*, padrão `1e-06`) : O epsilon usado pelas camadas de normalização de camada.
attention_dropout (`Union[float, int]`, *opcional*, padrão `0.0`) : A taxa de dropout para as probabilidades de atenção.
initializer_range (`float`, *opcional*, padrão `1e-10`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
qkv_bias (`bool`, *opcional*, padrão `True`) : Se deve adicionar um viés às queries, keys e values.
mlp_ratio (`float`, *opcional*, padrão `4.0`) : Razão entre a dimensão oculta do MLP e a dimensão de incorporação.
use_abs_pos (`bool`, *opcional*, padrão `True`) : Se deve usar embeddings de posição absoluta.
use_rel_pos (`bool`, *opcional*, padrão `True`) : Se deve usar incorporação de posição relativa.
window_size (`int`, *opcional*, padrão 14) : Tamanho da janela para posição relativa.
global_attn_indexes (`list[int]`, *opcional*, padrão `[2, 5, 8, 11]`) : Os índices das camadas de atenção global.
num_pos_feats (`int`, *opcional*, padrão 128) : A dimensionalidade do embedding de posição.
mlp_dim (`int`, *opcional*) : A dimensionalidade da camada MLP no codificador do Transformer. Se `None`, o valor padrão é `mlp_ratio * hidden_size`.
Esta é a classe de configuração para armazenar a configuração de um SamModel. Ela é usada para instanciar um modelo Sam de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import (
... SamVisionConfig,
... SamVisionModel,
... )
>>> # Initializing a SamVisionConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamVisionConfig()
>>> # Initializing a SamVisionModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## SamMaskDecoderConfig[[transformers.SamMaskDecoderConfig]]
#### transformers.SamMaskDecoderConfig[[transformers.SamMaskDecoderConfig]]
```python
transformers.SamMaskDecoderConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 256, hidden_act: str = 'relu', mlp_dim: int = 2048, num_hidden_layers: int = 2, num_attention_heads: int = 8, attention_downsample_rate: int = 2, num_multimask_outputs: int = 3, iou_head_depth: int = 3, iou_head_hidden_dim: int = 256, layer_norm_eps: float = 1e-06)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/configuration_sam.py#L50)
**Parâmetros:**
hidden_size (`int`, *opcional*, padrão `256`) : Dimensão das representações ocultas.
hidden_act (`str`, *opcional*, padrão `relu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
mlp_dim (`int`, *opcional*, padrão 2048) : Dimensionalidade da camada "intermediária" (ou seja, feed-forward) no codificador do Transformer.
num_hidden_layers (`int`, *opcional*, padrão `2`) : Número de camadas ocultas no decodificador do Transformer.
num_attention_heads (`int`, *opcional*, padrão `8`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
attention_downsample_rate (`int`, *opcional*, padrão 2) : A taxa de redução de amostragem da camada de atenção.
num_multimask_outputs (`int`, *opcional*, padrão 3) : O número de saídas do módulo `SamMaskDecoder`. No paper Segment Anything, esse valor é definido como 3.
iou_head_depth (`int`, *opcional*, padrão 3) : O número de camadas no módulo de cabeça de IoU.
iou_head_hidden_dim (`int`, *opcional*, padrão 256) : A dimensionalidade dos estados ocultos no módulo de cabeça de IoU.
layer_norm_eps (`float`, *opcional*, padrão `1e-06`) : O epsilon usado pelas camadas de normalização de camada.
Esta é a classe de configuração para armazenar a configuração de um SamModel. Ela é usada para instanciar um modelo Sam de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
## SamPromptEncoderConfig[[transformers.SamPromptEncoderConfig]]
#### transformers.SamPromptEncoderConfig[[transformers.SamPromptEncoderConfig]]
```python
transformers.SamPromptEncoderConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 256, image_size: int | list[int] | tuple[int, int] = 1024, patch_size: int | list[int] | tuple[int, int] = 16, mask_input_channels: int = 16, num_point_embeddings: int = 4, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/configuration_sam.py#L24)
**Parâmetros:**
hidden_size (`int`, *opcional*, padrão `256`) : Dimensão das representações ocultas.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `1024`) : O tamanho (resolução) de cada imagem.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `16`) : O tamanho (resolução) de cada patch.
mask_input_channels (`int`, *opcional*, padrão 16) : O número de canais a serem enviados para o módulo `MaskDecoder`.
num_point_embeddings (`int`, *opcional*, padrão 4) : O número de embeddings de pontos a serem usados.
hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *opcional*, padrão `1e-06`) : O epsilon usado pelas camadas de normalização de camada.
Esta é a classe de configuração para armazenar a configuração de um SamModel. Ela é usada para instanciar um modelo Sam de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
## SamProcessor[[transformers.SamProcessor]]
#### transformers.SamProcessor[[transformers.SamProcessor]]
```python
transformers.SamProcessor(image_processor)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/processing_sam.py#L82)
**Parâmetros:**
image_processor (`SamImageProcessor`) : O processador de imagem é uma entrada obrigatória.
Constrói um SamProcessor que encapsula um processador de imagem em um único processador.
[SamProcessor](/docs/transformers/main/pt/model_doc/sam#transformers.SamProcessor) oferece todas as funcionalidades de [SamImageProcessor](/docs/transformers/main/pt/model_doc/sam#transformers.SamImageProcessor). Consulte [~SamImageProcessor](/docs/transformers/main/pt/model_doc/sam#transformers.SamImageProcessor) para mais informações.
#### __call__[[transformers.SamProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/processing_sam.py#L87)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opcional*) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *opcional*) : A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se você passar uma entrada pretokenizada, defina `is_split_into_words=True` para evitar ambiguidade com entradas em lote.
return_tensors (`str` ou [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *opcional*) : Se definido, retornará tensores de um framework específico. Os valores aceitos são: - `'pt'`: Retorna objetos `torch.Tensor` do PyTorch. - `'np'`: Retorna objetos `np.ndarray` do NumPy.
**Retorna:** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`, *opcional*) -- Dicionário de listas/arrays/tensors retornados pelos métodos `__call__`/`encode_plus`/`batch_encode_plus` ('input_ids', 'attention_mask', etc.).
- **encoding** (`tokenizers.Encoding` ou `Sequence[tokenizers.Encoding]`, *opcional*) -- Se o tokenizer for um fast tokenizer que fornece informações adicionais, como o mapeamento do espaço de palavras/caracteres para o espaço de tokens, a instância de `tokenizers.Encoding` ou a lista de instâncias (para lotes) armazena essas informações.
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
- **prepend_batch_axis** (`bool`, *opcional*, padrão `False`) -- Indica se deve ou não adicionar um eixo de lote ao converter para tensores (veja `tensor_type` acima). Observe que este parâmetro tem efeito se o parâmetro `tensor_type` estiver definido, *caso contrário, não tem efeito*.
- **n_sequences** (`int`, *opcional*) -- O número de sequências de entrada representadas por cada codificação (`None` para desconhecido, `1` para uma única sequência e `2` para um par de sequências).
## SamImageProcessor[[transformers.SamImageProcessor]]
#### transformers.SamImageProcessor[[transformers.SamImageProcessor]]
```python
transformers.SamImageProcessor(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/image_processing_sam.py#L61)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'longest_edge' : 1024}`): Descreve as dimensões de entrada máximas para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `2`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.485, 0.456, 0.406]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.229, 0.224, 0.225]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*, padrão `True`) : Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 1024, 'width': 1024}`): O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que qualquer tamanho de imagem fornecido para pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
mask_size (`dict[str, *kwargs*, int]`, *opcional*) : O tamanho `{"longest_edge": int}` para redimensionar os mapas de segmentação.
mask_pad_size (`dict[str, *kwargs*, int]`, *opcional*) : O tamanho `{"height": int, "width": int}` para preencher os mapas de segmentação. Deve ser maior que o tamanho de qualquer mapa de segmentação fornecido para pré-processamento.
Constrói um processador de imagem SamImageProcessor.
#### preprocess[[transformers.SamImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/image_processing_sam.py#L79)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
segmentation_maps (`ImageInput`, *opcional*) : Os mapas de segmentação a serem pré-processados.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
mask_size (`dict[str, *kwargs*, int]`, *opcional*) : O tamanho `{"longest_edge": int}` para redimensionar os mapas de segmentação.
mask_pad_size (`dict[str, *kwargs*, int]`, *opcional*) : O tamanho `{"height": int, "width": int}` para preencher os mapas de segmentação. Deve ser maior que o tamanho de qualquer mapa de segmentação fornecido para pré-processamento.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
## SamImageProcessorPil[[transformers.SamImageProcessorPil]]
#### transformers.SamImageProcessorPil[[transformers.SamImageProcessorPil]]
```python
transformers.SamImageProcessorPil(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/image_processing_pil_sam.py#L82)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'longest_edge' : 1024}`): Descreve as dimensões de entrada máximas para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `2`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.485, 0.456, 0.406]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.229, 0.224, 0.225]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*, padrão `True`) : Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 1024, 'width': 1024}`): O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que qualquer tamanho de imagem fornecido para pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
mask_size (`dict[str, *kwargs*, int]`, *opcional*) : O tamanho `{"longest_edge": int}` para redimensionar os mapas de segmentação.
mask_pad_size (`dict[str, *kwargs*, int]`, *opcional*) : O tamanho `{"height": int, "width": int}` para preencher os mapas de segmentação. Deve ser maior que o tamanho de qualquer mapa de segmentação fornecido para pré-processamento.
Constrói um processador de imagem SamImageProcessor.
#### preprocess[[transformers.SamImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/image_processing_pil_sam.py#L100)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
segmentation_maps (`ImageInput`, *opcional*) : Os mapas de segmentação a serem pré-processados.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
mask_size (`dict[str, *kwargs*, int]`, *opcional*) : O tamanho `{"longest_edge": int}` para redimensionar os mapas de segmentação.
mask_pad_size (`dict[str, *kwargs*, int]`, *opcional*) : O tamanho `{"height": int, "width": int}` para preencher os mapas de segmentação. Deve ser maior que o tamanho de qualquer mapa de segmentação fornecido para pré-processamento.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
## SamVisionModel[[transformers.SamVisionModel]]
#### transformers.SamVisionModel[[transformers.SamVisionModel]]
```python
transformers.SamVisionModel(config: SamVisionConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/modeling_sam.py#L1081)
**Parâmetros:**
config ([SamVisionConfig](/docs/transformers/main/pt/model_doc/sam#transformers.SamVisionConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo de visão do Sam, sem nenhum cabeçalho ou projeção no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.SamVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/modeling_sam.py#L1093)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [SamImageProcessor](/docs/transformers/main/pt/model_doc/sam#transformers.SamImageProcessor). Veja [SamImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([SamProcessor](/docs/transformers/main/pt/model_doc/sam#transformers.SamProcessor) usa [SamImageProcessor](/docs/transformers/main/pt/model_doc/sam#transformers.SamImageProcessor) para processar imagens).
**Retorna:** `SamVisionEncoderOutput` ou `tuple(torch.Tensor)`
Um `SamVisionEncoderOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([SamConfig](/docs/transformers/main/pt/model_doc/sam#transformers.SamConfig)) e das entradas.
O método forward do [SamVisionModel](/docs/transformers/main/pt/model_doc/sam#transformers.SamVisionModel) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **image_embeds** (`torch.Tensor` de forma `(batch_size, output_dim)` *opcional* retornado quando o modelo é inicializado com `with_projection=True`) -- Os embeddings de imagem obtidos ao aplicar a camada de projeção ao pooler_output.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) -- Sequência de hidden-states na saída da última camada do modelo.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (uma para a saída dos embeddings, se o modelo tiver uma camada de embedding, + uma para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple[torch.Tensor, ...]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
## SamModel[[transformers.SamModel]]
#### transformers.SamModel[[transformers.SamModel]]
```python
transformers.SamModel(config: SamConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/modeling_sam.py#L1108)
**Parâmetros:**
config ([SamConfig](/docs/transformers/main/pt/model_doc/sam#transformers.SamConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. Inicializar com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Segment Anything Model (SAM) para gerar máscaras de segmentação, dado uma imagem de entrada e pontos e rótulos de entrada, caixas ou máscaras.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.SamModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, input_points: typing.Optional[torch.Tensor] = None, input_labels: typing.Optional[torch.LongTensor] = None, input_boxes: typing.Optional[torch.Tensor] = None, input_masks: typing.Optional[torch.LongTensor] = None, image_embeddings: typing.Optional[torch.Tensor] = None, multimask_output: bool = True, attention_similarity: typing.Optional[torch.Tensor] = None, target_embedding: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/modeling_sam.py#L1191)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [SamImageProcessor](/docs/transformers/main/pt/model_doc/sam#transformers.SamImageProcessor). Veja [SamImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([SamProcessor](/docs/transformers/main/pt/model_doc/sam#transformers.SamProcessor) usa [SamImageProcessor](/docs/transformers/main/pt/model_doc/sam#transformers.SamImageProcessor) para processar imagens).
input_points (`torch.Tensor` de forma `(batch_size, num_points, 2)`) : Pontos espaciais 2D de entrada, usados pelo codificador de prompt para codificar o prompt. Geralmente, isso resulta em muito melhores resultados. Os pontos podem ser obtidos passando uma lista de listas de listas para o processador, que criará os correspondentes `torch` tensores de dimensão 4. A primeira dimensão é o tamanho do lote de imagens, a segunda dimensão é o tamanho do lote de pontos (ou seja, quantas máscaras de segmentação queremos que o modelo preveja por ponto de entrada), a terceira dimensão é o número de pontos por máscara de segmentação (é possível passar múltiplos pontos para uma única máscara) e a última dimensão são as coordenadas x (vertical) e y (horizontal) do ponto. Se um número diferente de pontos for passado para cada imagem ou para cada máscara, o processador criará pontos "PAD" que corresponderão à coordenada (0, 0), e o cálculo do embedding será ignorado para esses pontos usando os rótulos.
input_labels (`torch.LongTensor` de forma `(batch_size, point_batch_size, num_points)`) : Rótulos de entrada para os pontos, usados pelo codificador de prompt para codificar o prompt. De acordo com a implementação oficial, existem 3 tipos de rótulos - `1`: o ponto contém o objeto de interesse - `0`: o ponto não contém o objeto de interesse - `-1`: o ponto corresponde ao fundo Adicionamos o rótulo: - `-10`: o ponto é um ponto de preenchimento (padding) e, portanto, deve ser ignorado pelo codificador de prompt Os rótulos de preenchimento devem ser aplicados automaticamente pelo processador.
input_boxes (`torch.Tensor` de forma `(batch_size, num_boxes, 4)`) : Caixas de entrada para os pontos, usadas pelo codificador de prompt para codificar o prompt. Geralmente resulta em máscaras geradas muito melhores. As caixas podem ser obtidas passando uma lista de listas de listas para o processador, que gerará um tensor `torch`, com cada dimensão correspondendo, respectivamente, ao tamanho do lote de imagens, ao número de caixas por imagem e às coordenadas do ponto superior esquerdo e do ponto inferior direito da caixa. Na ordem (`x1`, `y1`, `x2`, `y2`): - `x1`: a coordenada x do ponto superior esquerdo da caixa de entrada - `y1`: a coordenada y do ponto superior esquerdo da caixa de entrada - `x2`: a coordenada x do ponto inferior direito da caixa de entrada - `y2`: a coordenada y do ponto inferior direito da caixa de entrada
input_masks (`torch.Tensor` de forma `(batch_size, image_size, image_size)`) : O modelo SAM também aceita máscaras de segmentação como entrada. A máscara será incorporada pelo codificador de prompt para gerar uma incorporação correspondente, que será fornecida posteriormente ao decodificador de máscara. Essas máscaras precisam ser fornecidas manualmente pelo usuário e precisam ter a forma (`batch_size`, `image_size`, `image_size`).
image_embeddings (`torch.Tensor` de forma `(batch_size, output_channels, window_size, window_size)`) : Incorporações de imagem, usadas pelo decodificador de máscara para gerar máscaras e pontuações de iou. Para um cálculo mais eficiente em termos de memória, os usuários podem primeiro recuperar as incorporações de imagem usando o método `get_image_embeddings` e, em seguida, fornecê-las ao método `forward` em vez de fornecer os `pixel_values`.
multimask_output (`bool`, *opcional*) : Na implementação e no artigo originais, o modelo sempre produz 3 máscaras por imagem (ou por ponto / por bounding box, quando aplicável). No entanto, é possível produzir apenas uma única máscara, que corresponde à máscara "melhor", especificando `multimask_output=False`.
attention_similarity (`torch.Tensor`, *opcional*) : Tensor de similaridade de atenção, a ser fornecido ao decodificador de máscara para atenção guiada por alvo, caso o modelo seja usado para personalização, conforme introduzido em [PerSAM](https://huggingface.co/papers/2305.03048).
target_embedding (`torch.Tensor`, *opcional*) : Incorporação do conceito-alvo, a ser fornecida ao decodificador de máscara para prompting semântico-alvo, caso o modelo seja usado para personalização, conforme introduzido em [PerSAM](https://huggingface.co/papers/2305.03048).
**Retorna:** `SamImageSegmentationOutput` ou `tuple(torch.Tensor)`
Uma `SamImageSegmentationOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([SamConfig](/docs/transformers/main/pt/model_doc/sam#transformers.SamConfig)) e das entradas.
O método forward da [SamModel](/docs/transformers/main/pt/model_doc/sam#transformers.SamModel) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **iou_scores** (`torch.Tensor` de forma `(batch_size, num_masks)`) -- As pontuações de iou das máscaras previstas.
- **pred_masks** (`torch.Tensor` de forma `(batch_size, num_masks, height, width)`) -- As máscaras de baixa resolução previstas. Precisam ser pós-processadas pelo processador
- **vision_hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo de visão na saída de cada camada, além das saídas opcionais do embedding inicial.
- **vision_attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **mask_decoder_attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplo:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoModel, AutoProcessor
>>> model = AutoModel.from_pretrained("facebook/sam-vit-base")
>>> processor = AutoProcessor.from_pretrained("facebook/sam-vit-base")
>>> url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/transformers/model_doc/sam-car.png"
>>> with httpx.stream("GET", url) as response:
... raw_image = Image.open(BytesIO(response.read())).convert("RGB")
>>> input_points = [[[400, 650]]] # 2D location of a window on the car
>>> inputs = processor(images=raw_image, input_points=input_points, return_tensors="pt")
>>> # Get segmentation mask
>>> outputs = model(**inputs)
>>> # Postprocess masks
>>> masks = processor.post_process_masks(
... outputs.pred_masks, inputs["original_sizes"], inputs["reshaped_input_sizes"]
... )
```