# TrOCR
[TrOCR](https://huggingface.co/papers/2109.10282) é um modelo de reconhecimento de texto para compreensão de imagens e geração de texto. Ele não requer modelos separados para processamento de imagens ou geração de caracteres. O TrOCR é um sistema simples e end-to-end que usa um transformer para lidar com a compreensão visual e a geração de texto.
Você pode encontrar todos os checkpoints originais do TrOCR na organização [Microsoft](https://huggingface.co/microsoft/models?search=trocr).
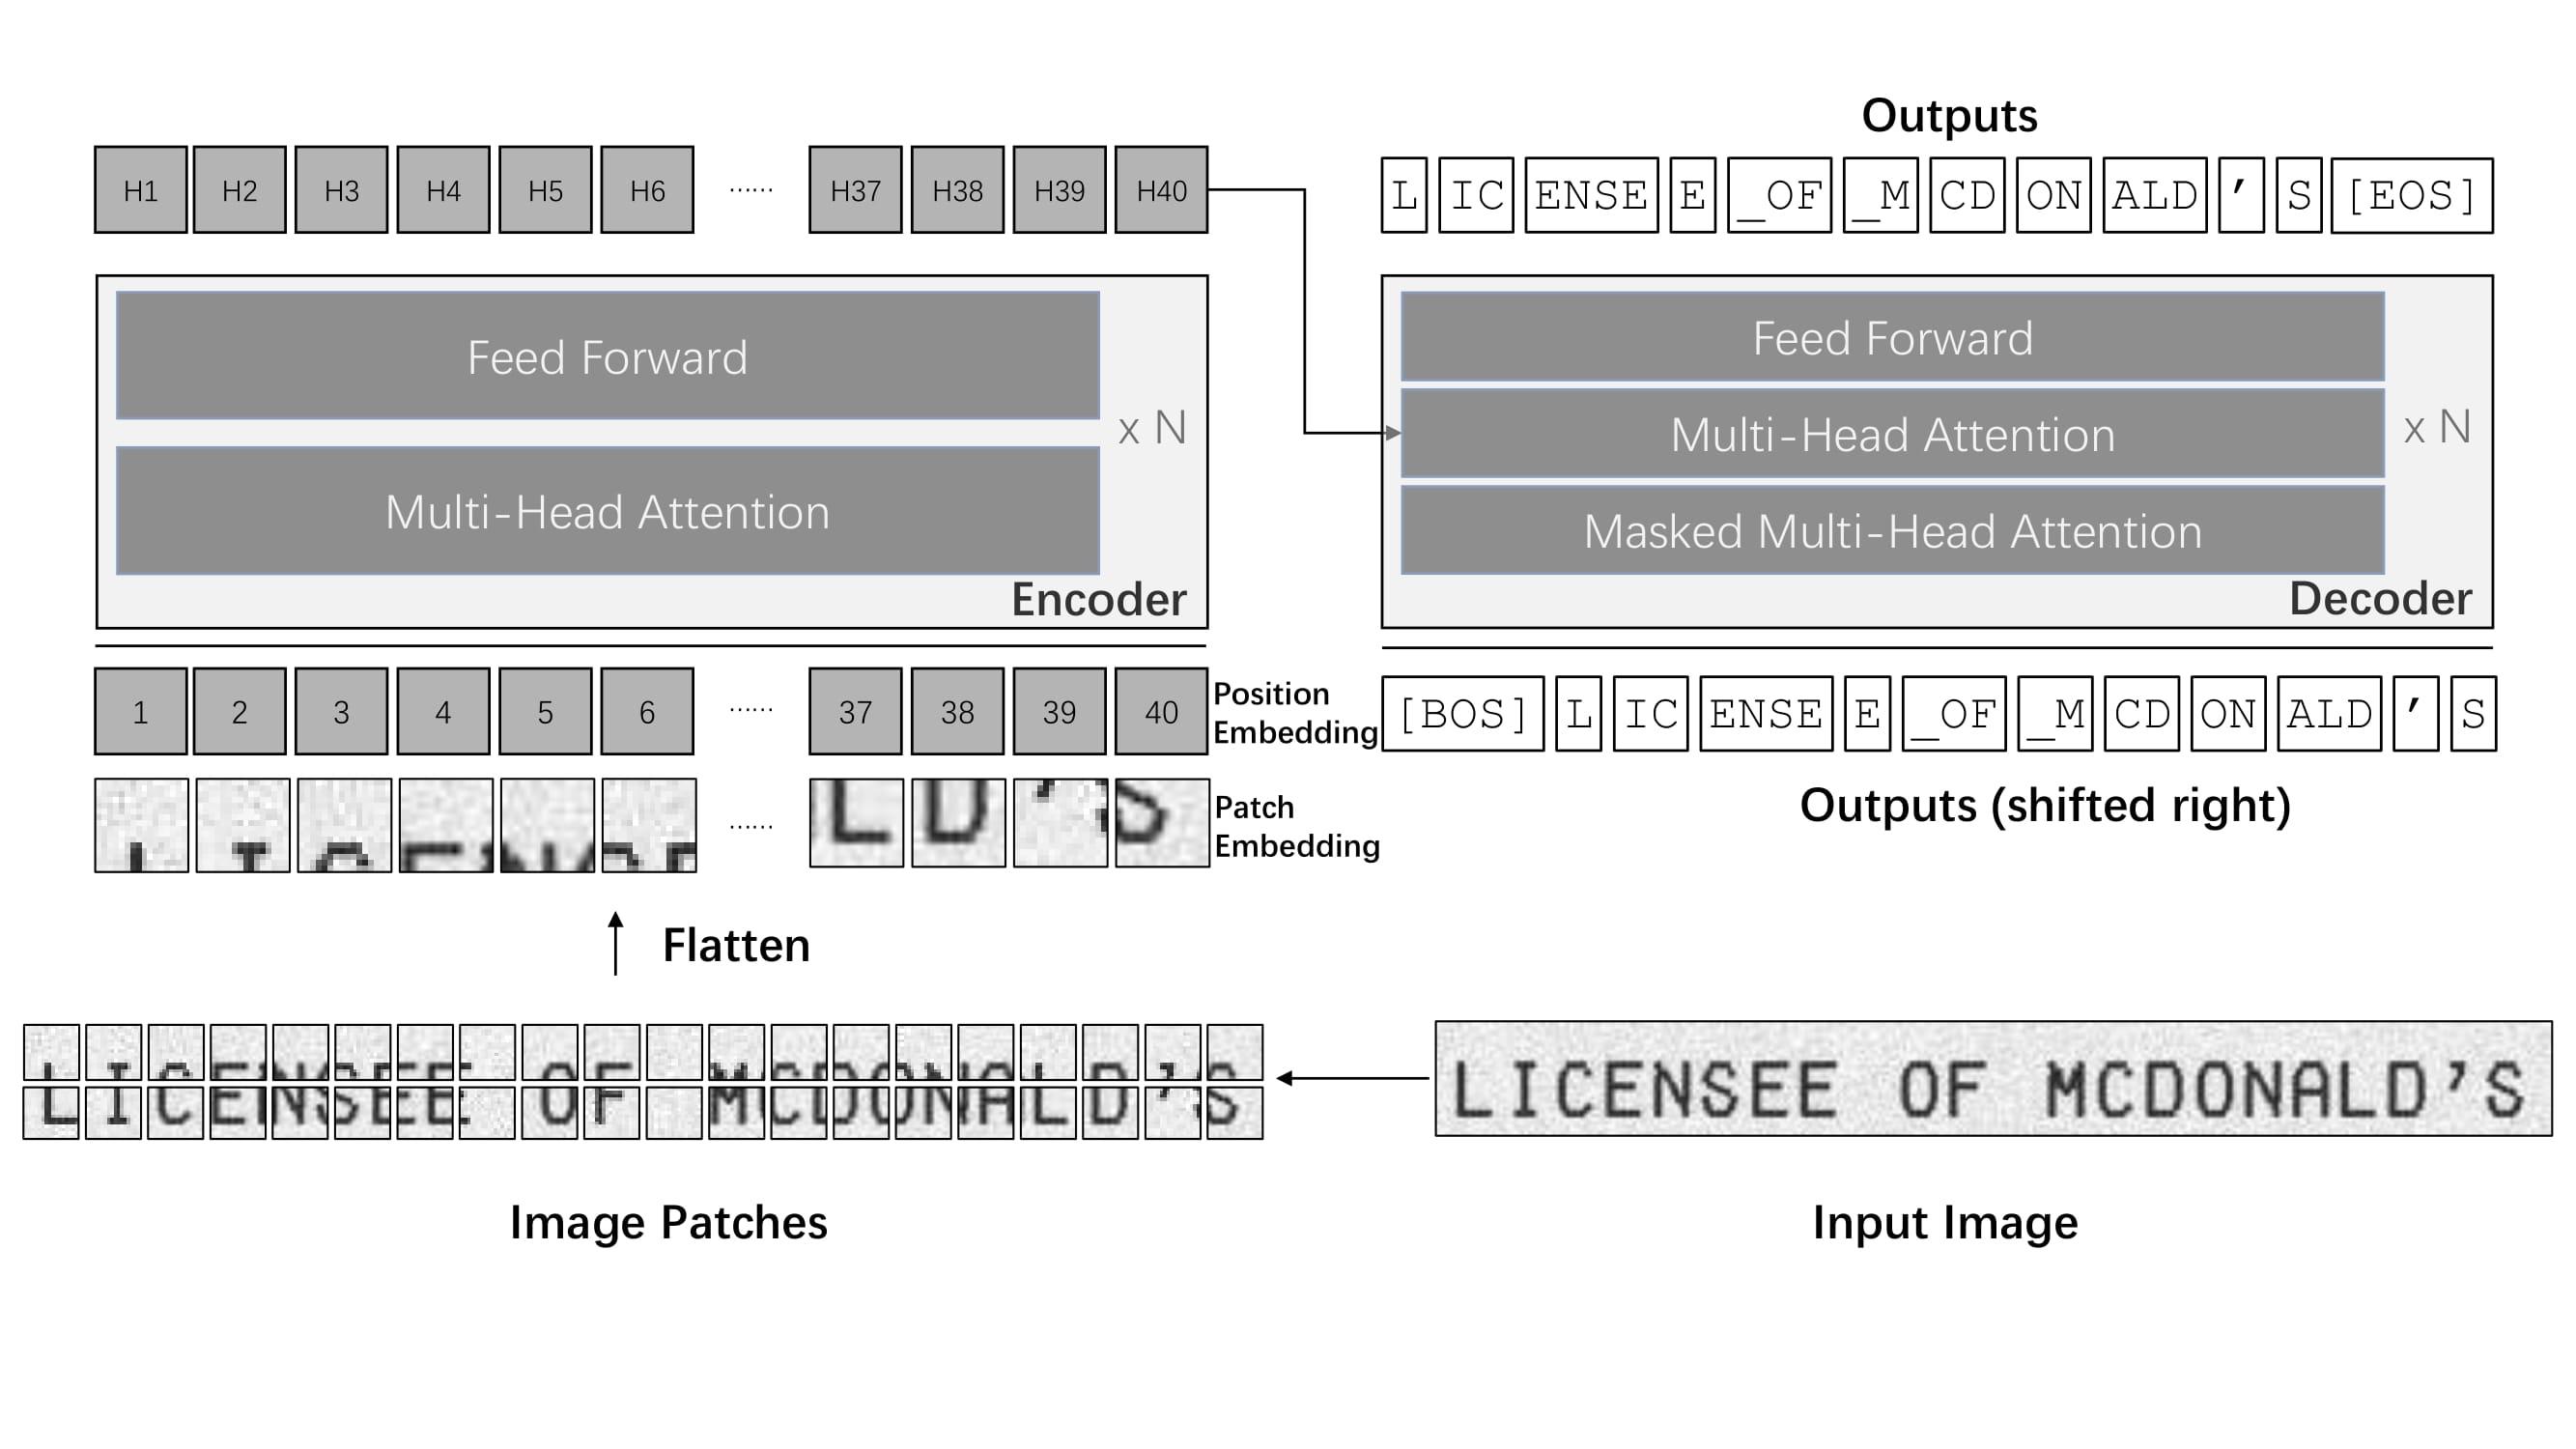 Arquitetura do TrOCR. Retirada do artigo original.
> [!TIP]
> Este modelo foi contribuído por [nielsr](https://huggingface.co/nielsr).
>
> Clique nos modelos TrOCR na barra lateral à direita para ver mais exemplos de como aplicar o TrOCR a diferentes tarefas de imagem e texto.
O exemplo abaixo demonstra como executar o reconhecimento óptico de caracteres (OCR) com a classe [AutoModel](/docs/transformers/main/pt/model_doc/auto#transformers.AutoModel).
```python
import requests
from PIL import Image
from transformers import TrOCRProcessor, VisionEncoderDecoderModel
processor = TrOCRProcessor.from_pretrained("microsoft/trocr-base-handwritten")
model = VisionEncoderDecoderModel.from_pretrained("microsoft/trocr-base-handwritten", device_map="auto")
# load image from the IAM dataset
url = "https://fki.tic.heia-fr.ch/static/img/a01-122-02.jpg"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
pixel_values = processor(image, return_tensors="pt").to(model.device).pixel_values
generated_ids = model.generate(pixel_values)
generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
print(generated_text)
```
## Quantização
A quantização reduz a carga de memória de modelos grandes ao representar os pesos em uma precisão menor. Consulte a visão geral de [Quantização](../quantization/overview) para mais backends de quantização disponíveis.
O exemplo abaixo usa [bitsandbytes](../quantization/bitsandbytes) para quantizar os pesos em 8 bits.
```python
# pip install bitsandbytes accelerate
from transformers import TrOCRProcessor, VisionEncoderDecoderModel, BitsandBytesConfig
import requests
from PIL import Image
# Set up the quantization configuration
quantization_config = BitsandBytesConfig(load_in_8bit=True)
# Use a large checkpoint for a more noticeable impact
processor = TrOCRProcessor.from_pretrained("microsoft/trocr-large-handwritten")
model = VisionEncoderDecoderModel.from_pretrained(
"microsoft/trocr-large-handwritten",
quantization_config=quantization_config
device_map="auto")
# load image from the IAM dataset
url = "[https://fki.tic.heia-fr.ch/static/img/a01-122-02.jpg](https://fki.tic.heia-fr.ch/static/img/a01-122-02.jpg)"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
pixel_values = processor(image, return_tensors="pt").to(model.device).pixel_values
generated_ids = model.generate(pixel_values)
generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
print(generated_text)
```
## Observações
- O TrOCR encapsula [ViTImageProcessor](/docs/transformers/main/pt/model_doc/vit#transformers.ViTImageProcessor)/[DeiTImageProcessor](/docs/transformers/main/pt/model_doc/deit#transformers.DeiTImageProcessor) e [RobertaTokenizer](/docs/transformers/main/pt/model_doc/led#transformers.RobertaTokenizer)/[XLMRobertaTokenizer](/docs/transformers/main/pt/model_doc/xlm-roberta#transformers.XLMRobertaTokenizer) em uma única instância de [TrOCRProcessor](/docs/transformers/main/pt/model_doc/trocr#transformers.TrOCRProcessor) para processar imagens e texto.
- O TrOCR é sempre utilizado dentro do framework [VisionEncoderDecoder](vision-encoder-decoder).
## Recursos
- Um post de blog sobre [Aceleração de Document AI](https://huggingface.co/blog/document-ai) com TrOCR.
- Um post de blog sobre como fazer [Document AI](https://github.com/philschmid/document-ai-transformers) com TrOCR.
- Um notebook sobre como [ajustar o TrOCR no Banco de Dados de Manuscritos IAM usando o Seq2SeqTrainer](https://colab.research.google.com/github/NielsRogge/Transformers-Tutorials/blob/master/TrOCR/Fine_tune_TrOCR_on_IAM_Handwriting_Database_using_Seq2SeqTrainer.ipynb).
- Uma demonstração interativa sobre [reconhecimento de caracteres manuscritos com TrOCR](https://huggingface.co/spaces/nielsr/TrOCR-handwritten).
- Um notebook sobre [inferência com TrOCR](https://colab.research.google.com/github/NielsRogge/Transformers-Tutorials/blob/master/TrOCR/Inference_with_TrOCR_%2B_Gradio_demo.ipynb) e um demo do Gradio.
- Um notebook sobre [avaliação do TrOCR no conjunto de teste IAM](https://colab.research.google.com/github/NielsRogge/Transformers-Tutorials/blob/master/TrOCR/Evaluating_TrOCR_base_handwritten_on_the_IAM_test_set.ipynb).
## TrOCRConfig[[transformers.TrOCRConfig]]
#### transformers.TrOCRConfig[[transformers.TrOCRConfig]]
```python
transformers.TrOCRConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 50265, d_model: int = 1024, decoder_layers: int = 12, decoder_attention_heads: int = 16, decoder_ffn_dim: int = 4096, activation_function: str = 'gelu', max_position_embeddings: int = 512, dropout: float | int = 0.1, attention_dropout: float | int = 0.0, activation_dropout: float | int = 0.0, decoder_start_token_id: int = 2, init_std: float = 0.02, decoder_layerdrop: float | int = 0.0, use_cache: bool = True, scale_embedding: bool = False, use_learned_position_embeddings: bool = True, layernorm_embedding: bool = True, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, cross_attention_hidden_size: int | None = None, is_decoder: bool = False, tie_word_embeddings: bool = True)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/trocr/configuration_trocr.py#L24)
**Parâmetros:**
vocab_size (`int`, *opcional*, padrão `50265`) : Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelos `input_ids`.
d_model (`int`, *opcional*, padrão `1024`) : Tamanho das camadas do codificador e da camada pooler.
decoder_layers (`int`, *opcional*, padrão `12`) : Número de camadas ocultas no decodificador do Transformer. Usará o mesmo valor de `num_layers` se não for definido.
decoder_attention_heads (`int`, *opcional*, padrão `16`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
decoder_ffn_dim (`int`, *opcional*, padrão `4096`) : Dimensionalidade da camada "intermediária" (frequentemente chamada de feed-forward) no decodificador.
activation_function (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
max_position_embeddings (`int`, *opcional*, padrão `512`) : O comprimento máximo de sequência com o qual este modelo pode ser utilizado.
dropout (`Union[float, int]`, *opcional*, padrão `0.1`) : A proporção para todas as camadas de dropout.
attention_dropout (`Union[float, int]`, *opcional*, padrão `0.0`) : A taxa de dropout para as probabilidades de atenção.
activation_dropout (`Union[float, int]`, *opcional*, padrão `0.0`) : A taxa de dropout para as ativações dentro da camada totalmente conectada.
decoder_start_token_id (`int`, *opcional*, padrão `2`) : Se um modelo encoder-decoder inicia a decodificação com um token diferente de `bos`, o id desse token.
init_std (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
decoder_layerdrop (`Union[float, int]`, *opcional*, padrão `0.0`) : A probabilidade de LayerDrop para o decodificador. Consulte o [artigo LayerDrop](see https://huggingface.co/papers/1909.11556) para mais detalhes.
use_cache (`bool`, *opcional*, padrão `True`) : Indica se o modelo deve retornar as últimas atenções de chave/valor (não utilizado por todos os modelos). Relevante apenas se `config.is_decoder=True` ou quando o modelo for um modelo generativo somente de decodificador.
scale_embedding (`bool`, *opcional*, padrão `False`) : Se as embeddings devem ser escalonadas dividindo por sqrt(d_model).
use_learned_position_embeddings (`bool`, *opcional*, padrão `True`) : Se deve ou não usar embeddings de posição aprendidos. Caso contrário, embeddings de posição sinusoidais serão usados.
layernorm_embedding (`bool`, *opcional*, padrão `True`) : Se deve ou não usar um layernorm após os embeddings de palavra + posição.
pad_token_id (`int`, *opcional*, padrão `1`) : ID do token usado para preenchimento no vocabulário.
bos_token_id (`int`, *opcional*, padrão `0`) : ID do token usado para o início do fluxo no vocabulário.
eos_token_id (`Union[int, list[int]]`, *opcional*, padrão `2`) : ID do token usado para o fim do fluxo no vocabulário.
cross_attention_hidden_size (`int`, *opcional*) : Tamanho oculto das saídas do codificador projetado no espaço de chave/valor da atenção cruzada do decodificador. Usado quando o codificador e o decodificador têm tamanhos ocultos diferentes.
is_decoder (`bool`, *opcional*, padrão `False`) : Indica se o modelo é usado como decodificador ou não. Se `False`, o modelo é usado como codificador.
tie_word_embeddings (`bool`, *opcional*, padrão `True`) : Se deve vincular as embeddings de pesos de acordo com o mapeamento `tied_weights_keys` do modelo.
Esta é a classe de configuração para armazenar a configuração de um TrocrModel. Ela é usada para instanciar um modelo Trocr de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [microsoft/trocr-base-handwritten](https://huggingface.co/microsoft/trocr-base-handwritten)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import TrOCRConfig, TrOCRForCausalLM
>>> # Initializing a TrOCR-base style configuration
>>> configuration = TrOCRConfig()
>>> # Initializing a model (with random weights) from the TrOCR-base style configuration
>>> model = TrOCRForCausalLM(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## TrOCRProcessor[[transformers.TrOCRProcessor]]
#### transformers.TrOCRProcessor[[transformers.TrOCRProcessor]]
```python
transformers.TrOCRProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/trocr/processing_trocr.py#L30)
**Parâmetros:**
image_processor (`ViTImageProcessor`) : O processador de imagem é uma entrada obrigatória.
tokenizer (`XLMRobertaTokenizer`) : O tokenizer é uma entrada obrigatória.
Constrói um TrOCRProcessor que encapsula um processador de imagem e um tokenizador em um único processador.
[TrOCRProcessor](/docs/transformers/main/pt/model_doc/trocr#transformers.TrOCRProcessor) oferece todas as funcionalidades de [ViTImageProcessor](/docs/transformers/main/pt/model_doc/vit#transformers.ViTImageProcessor) e [XLMRobertaTokenizer](/docs/transformers/main/pt/model_doc/xlm-roberta#transformers.XLMRobertaTokenizer). Consulte [~ViTImageProcessor](/docs/transformers/main/pt/model_doc/vit#transformers.ViTImageProcessor) e [~XLMRobertaTokenizer](/docs/transformers/main/pt/model_doc/xlm-roberta#transformers.XLMRobertaTokenizer) para mais informações.
#### __call__[[transformers.TrOCRProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/trocr/processing_trocr.py#L34)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opcional*) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *opcional*) : A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se você passar uma entrada pretokenizada, defina `is_split_into_words=True` para evitar ambiguidade com entradas em lote.
return_tensors (`str` ou [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *opcional*) : Se definido, retornará tensores de um framework específico. Os valores aceitos são: - `'pt'`: Retorna objetos `torch.Tensor` do PyTorch. - `'np'`: Retorna objetos `np.ndarray` do NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/pt/main_classes/processors#transformers.ProcessingKwargs), *opcional*) : Opções de processamento adicionais para cada modalidade (texto, imagens, vídeos, áudio). Os parâmetros específicos do modelo estão listados acima; consulte a classe TypedDict para a lista completa de argumentos suportados.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
#### from_pretrained[[transformers.TrOCRProcessor.from_pretrained]]
```python
from_pretrained(pretrained_model_name_or_path: str | os.PathLike, cache_dir: str | os.PathLike | None = None, force_download: bool = False, local_files_only: bool = False, token: str | bool | None = None, revision: str = 'main', **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L1750)
**Parâmetros:**
pretrained_model_name_or_path (`str` or `os.PathLike`) : This can be either: - a string, the *model id* of a pretrained feature_extractor hosted inside a model repo on huggingface.co. - a path to a *directory* containing a feature extractor file saved using the [save_pretrained()](/docs/transformers/main/pt/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained) method, e.g., `./my_model_directory/`. - a path to a saved feature extractor JSON *file*, e.g., `./my_model_directory/preprocessor_config.json`.
- ****kwargs** : Argumentos de palavra-chave adicionais passados tanto para [from_pretrained()](/docs/transformers/main/pt/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained) quanto para `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained`.
Instancie um processador associado a um modelo pré-treinado.
Este método de classe simplesmente chama o método [from_pretrained()](/docs/transformers/main/pt/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained) do extrator de recursos, o método [ImageProcessingMixin](/docs/transformers/main/pt/internal/image_processing_utils#transformers.ImageProcessingMixin) do processador de imagem e o método `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained` do tokenizador. Consulte as docstrings dos métodos acima para mais informações.
#### save_pretrained[[transformers.TrOCRProcessor.save_pretrained]]
```python
save_pretrained(save_directory, push_to_hub: bool = False, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L1165)
**Parâmetros:**
save_directory (`str` ou `os.PathLike`) : Diretório onde o arquivo JSON do extrator de recursos e os arquivos do tokenizer serão salvos (o diretório será criado caso não exista).
push_to_hub (`bool`, *opcional*, padrão `False`) : Indica se o modelo deve ser enviado para o Hugging Face model hub após ser salvo. Você pode especificar o repositório de destino com `repo_id` (por padrão, será usado o nome de `save_directory` no seu namespace).
kwargs (`dict[str, Any]`, *opcional*) : Argumentos de palavra-chave adicionais passados ao método [push_to_hub()](/docs/transformers/main/pt/main_classes/model#transformers.utils.PushToHubMixin.push_to_hub).
Salva os atributos deste processador (feature extractor, tokenizer...) no diretório especificado para que ele possa ser recarregado usando o método [from_pretrained()](/docs/transformers/main/pt/model_doc/wav2vec2#transformers.Wav2Vec2Processor.from_pretrained).
Este método de classe simplesmente chama [save_pretrained()](/docs/transformers/main/pt/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained) e [save_pretrained()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.save_pretrained). Consulte as docstrings dos métodos acima para mais informações.
#### batch_decode[[transformers.TrOCRProcessor.batch_decode]]
```python
batch_decode(*args, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L2005)
Este método encaminha todos os seus argumentos para o [batch_decode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.batch_decode) do PreTrainedTokenizer. Consulte a docstring deste método para obter mais informações.
#### decode[[transformers.TrOCRProcessor.decode]]
```python
decode(*args, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L2014)
Este método encaminha todos os seus argumentos para o [decode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.decode) do PreTrainedTokenizer. Consulte a docstring deste método para obter mais informações.
## TrOCRForCausalLM[[transformers.TrOCRForCausalLM]]
#### transformers.TrOCRForCausalLM[[transformers.TrOCRForCausalLM]]
```python
transformers.TrOCRForCausalLM(config: TrOCRConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/trocr/modeling_trocr.py#L639)
**Parâmetros:**
config ([TrOCRConfig](/docs/transformers/main/pt/model_doc/trocr#transformers.TrOCRConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O TrOCR Decoder com uma cabeça de modelagem de linguagem. Pode ser usado como a parte decodificadora de [EncoderDecoderModel](/docs/transformers/main/pt/model_doc/encoder-decoder#transformers.EncoderDecoderModel) e
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.TrOCRForCausalLM.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.LongTensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/trocr/modeling_trocr.py#L665)
**Parâmetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
encoder_hidden_states (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Sequência de hidden-states na saída da última camada do encoder. Usada na cross-attention se o modelo estiver configurado como um decoder.
encoder_attention_mask (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento da entrada do codificador. Esta máscara é usada na atenção cruzada se o modelo estiver configurado como um decodificador. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**.
past_key_values (`~cache_utils.Cache`, *opcional*) : hidden-states pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nos `past_key_values` retornados pelo modelo em uma etapa anterior da decodificação, quando `use_cache=True` ou `config.use_cache=True`. Apenas uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache) é permitida como entrada, consulte nosso [guia de kv cache](https://huggingface.co/docs/transformers/en/kv_cache). Se nenhum `past_key_values` for passado, [DynamicCache](/docs/transformers/main/pt/internal/generation_utils#transformers.DynamicCache) será inicializado por padrão. O modelo sairá no mesmo formato de cache que foi fornecido como entrada. Se `past_key_values` forem usados, espera-se que o usuário insira apenas `input_ids` não processados (aqueles que não têm seus estados de chave e valor passados para este modelo) com a forma `(batch_size, unprocessed_length)` em vez de todos os `input_ids` com a forma `(batch_size, sequence_length)`.
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
labels (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Rótulos para calcular a perda de modelagem de linguagem mascarada. Os índices devem estar em `[0, ..., config.vocab_size]` ou ser -100 (veja a docstring de `input_ids`). Tokens com índices definidos como `-100` são ignorados (mascarados); a perda é calculada apenas para os tokens com rótulos em `[0, ..., config.vocab_size]`.
use_cache (`bool`, *opcional*) : Se definido como `True`, os estados de chave-valor de `past_key_values` são retornados e podem ser usados para acelerar a decodificação (veja `past_key_values`).
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** [CausalLMOutputWithCrossAttentions](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) ou `tuple(torch.Tensor)`
Um [CausalLMOutputWithCrossAttentions](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([TrOCRConfig](/docs/transformers/main/pt/model_doc/trocr#transformers.TrOCRConfig)) e das entradas.
O método forward de [TrOCRForCausalLM](/docs/transformers/main/pt/model_doc/trocr#transformers.TrOCRForCausalLM) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de modelagem de linguagem (para previsão do próximo token).
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos das atenções cruzadas após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
- **past_key_values** (`Cache`, *opcional*, retornado quando `use_cache=True` é passado ou quando `config.use_cache=True`) -- Trata-se de uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache). Para mais detalhes, consulte nosso [guia de cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contém estados ocultos pré-computados (chaves e valores nos blocos de atenção) que podem ser usados (veja a entrada `past_key_values`) para acelerar a decodificação sequencial.
Exemplo:
```python
>>> from transformers import (
... TrOCRConfig,
... TrOCRProcessor,
... TrOCRForCausalLM,
... ViTConfig,
... ViTModel,
... VisionEncoderDecoderModel,
... )
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> # TrOCR is a decoder model and should be used within a VisionEncoderDecoderModel
>>> # init vision2text model with random weights
>>> encoder = ViTModel(ViTConfig())
>>> decoder = TrOCRForCausalLM(TrOCRConfig())
>>> model = VisionEncoderDecoderModel(encoder=encoder, decoder=decoder)
>>> # If you want to start from the pretrained model, load the checkpoint with `VisionEncoderDecoderModel`
>>> processor = TrOCRProcessor.from_pretrained("microsoft/trocr-base-handwritten")
>>> model = VisionEncoderDecoderModel.from_pretrained("microsoft/trocr-base-handwritten")
>>> # load image from the IAM dataset
>>> url = "https://fki.tic.heia-fr.ch/static/img/a01-122-02.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> pixel_values = processor(image, return_tensors="pt").pixel_values
>>> text = "industry, ' Mr. Brown commented icily. ' Let us have a"
>>> # training
>>> model.config.decoder_start_token_id = processor.tokenizer.eos_token_id
>>> model.config.pad_token_id = processor.tokenizer.pad_token_id
>>> model.config.vocab_size = model.config.decoder.vocab_size
>>> labels = processor.tokenizer(text, return_tensors="pt").input_ids
>>> outputs = model(pixel_values, labels=labels)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
5.30
>>> # inference
>>> generated_ids = model.generate(pixel_values)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
>>> generated_text
'industry, " Mr. Brown commented icily. " Let us have a'
```