# TVP
## Visão geral
O framework de prompting texto-visual (TVP) foi proposto no artigo [Text-Visual Prompting for Efficient 2D Temporal Video Grounding](https://huggingface.co/papers/2303.04995), de Yimeng Zhang, Xin Chen, Jinghan Jia, Sijia Liu e Ke Ding.
O resumo do artigo é o seguinte:
*Neste artigo, estudamos o problema de localização temporal de vídeos (TVG), que visa prever os pontos de início e término dos momentos descritos por uma frase de texto dentro de um vídeo longo e não editado. Beneficiando-se de recursos visuais 3D de alto nível de detalhe, as técnicas de TVG alcançaram progresso notável nos últimos anos. No entanto, a alta complexidade das redes neurais convolucionais 3D (CNNs) torna a extração de recursos visuais 3D densos demorada, o que exige recursos intensivos de memória e computação. Em direção a um TVG eficiente, propomos um novo framework de prompting texto-visual (TVP), que incorpora padrões de perturbação otimizados (que chamamos de ‘prompts’) tanto nas entradas visuais quanto nos recursos textuais de um modelo de TVG. Em nítido contraste com as CNNs 3D, demonstramos que o TVP nos permite co-treinar efetivamente o codificador de visão e o codificador de linguagem em um modelo de TVG 2D e melhora o desempenho da fusão de recursos entre modalidades usando apenas recursos visuais 2D esparsos de baixa complexidade. Além disso, propomos uma perda Temporal-Distance IoU (TDIoU) para o aprendizado eficiente de TVG. Experimentos em dois conjuntos de dados de referência, Charades-STA e ActivityNet Captions, mostram empiricamente que o TVP proposto melhora significativamente o desempenho do TVG 2D (por exemplo, uma melhoria de 9,79% no Charades-STA e de 30,77% no ActivityNet Captions) e alcança uma aceleração de inferência de 5× em comparação com o TVG que usa recursos visuais 3D.*
Esta pesquisa aborda o enquadramento temporal de vídeo (TVG), que é o processo de identificar os tempos de início e fim de eventos específicos em um vídeo longo, conforme descrito por uma frase textual. O prompt textual-visual (TVP) é proposto para aprimorar o TVG. O TVP envolve a integração de padrões especialmente projetados, conhecidos como 'prompts', em ambos os componentes de entrada visual (baseado em imagens) e textual (baseado em palavras) de um modelo de TVG. Esses prompts fornecem contexto espaço-temporal adicional, melhorando a capacidade do modelo de determinar com precisão os tempos dos eventos no vídeo. A abordagem emprega entradas visuais 2D em vez de 3D. Embora as entradas 3D ofereçam mais detalhes espaço-temporais, elas também são mais demoradas para processar. O uso de entradas 2D com o método de prompting visa fornecer níveis semelhantes de contexto e precisão de forma mais eficiente.
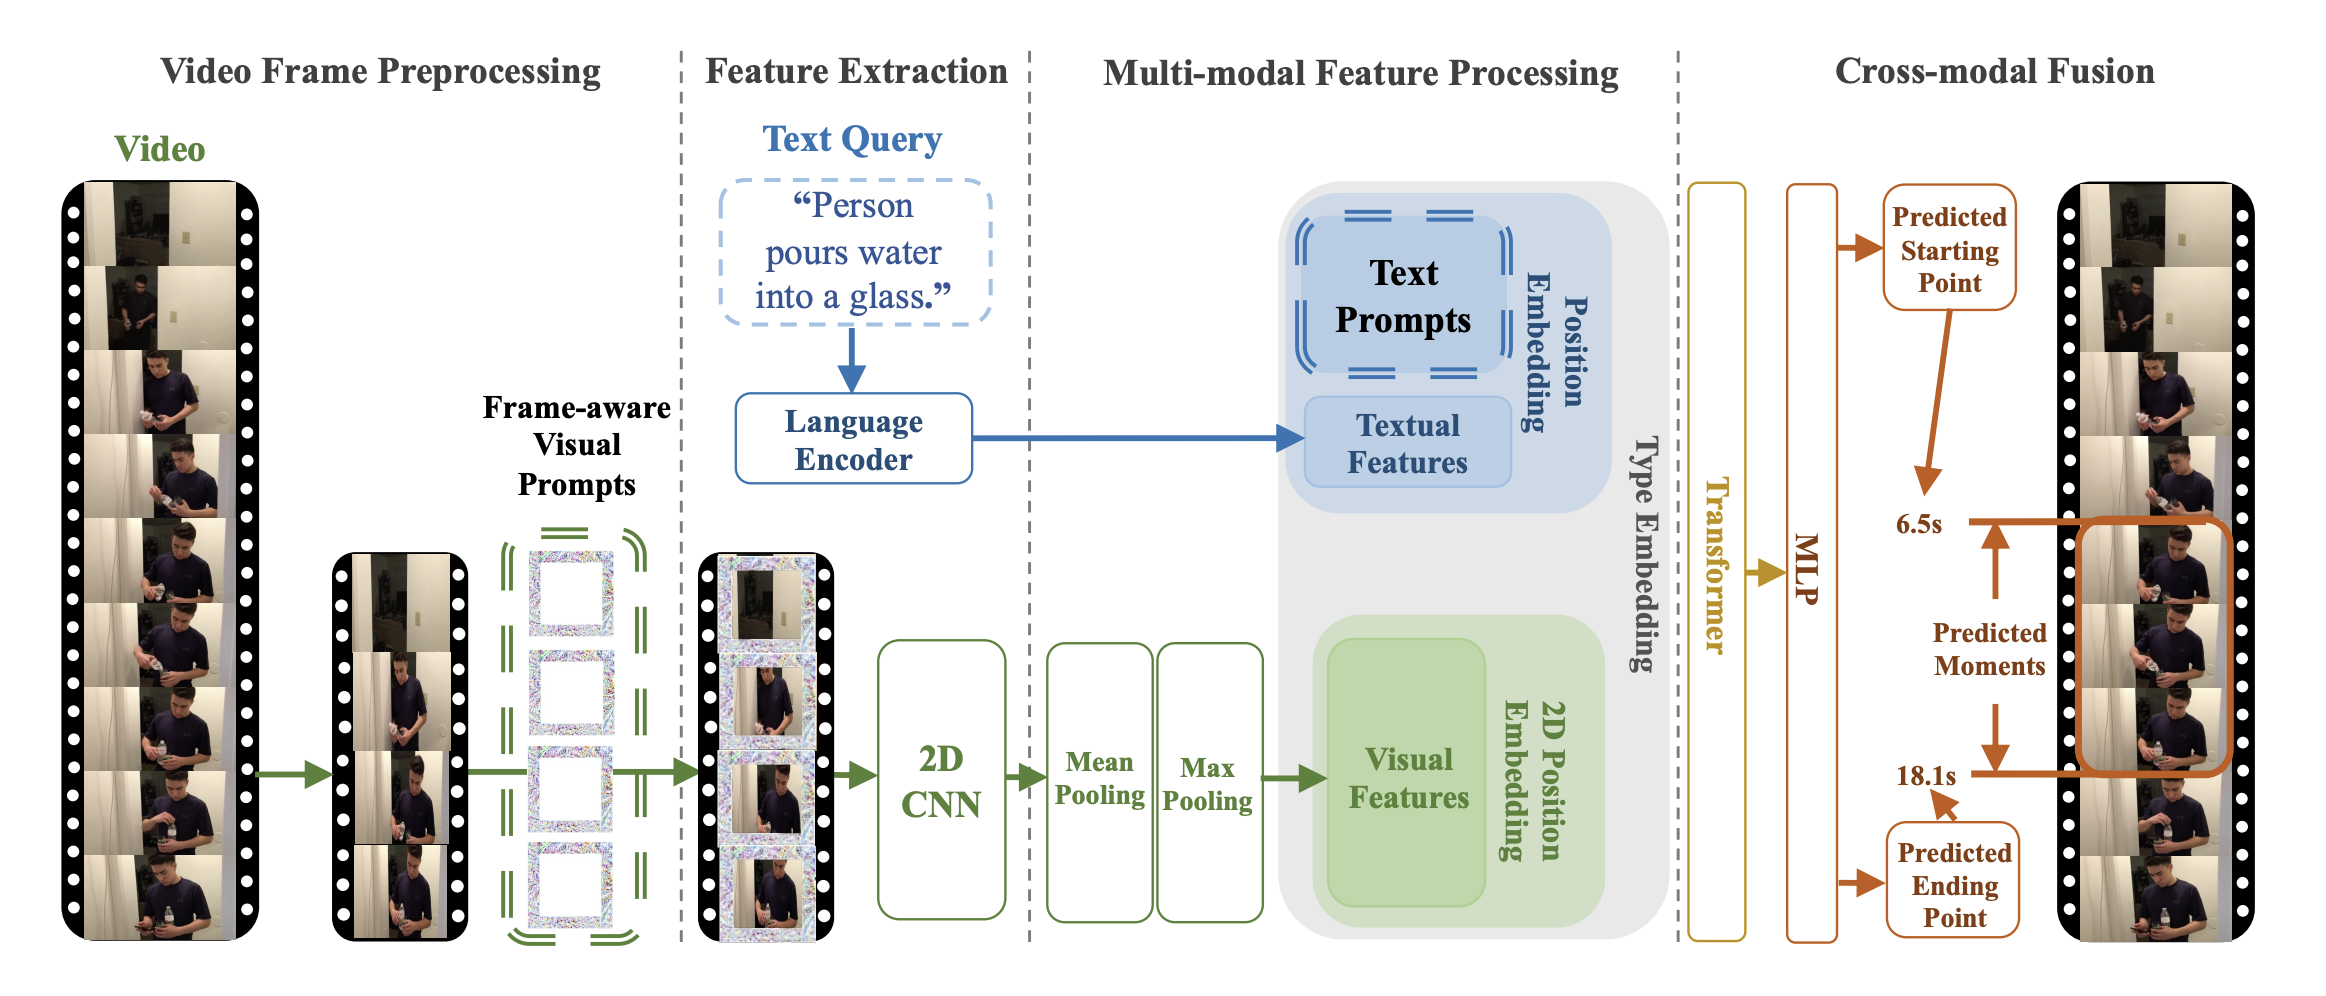 Arquitetura do TVP. Retirada do artigo original.
Este modelo foi contribuído por [Jiqing Feng](https://huggingface.co/Jiqing). O código original pode ser encontrado [aqui](https://github.com/intel/TVP).
## Dicas e exemplos de uso
Prompts são padrões de perturbação otimizados, que seriam adicionados aos quadros de vídeo de entrada ou às características de texto. O conjunto universal refere-se ao uso do mesmo conjunto exato de prompts para qualquer entrada, o que significa que esses prompts são adicionados de forma consistente a todos os quadros de vídeo e características de texto, independentemente do conteúdo da entrada.
O TVP consiste em um codificador visual e um codificador multimodal. Um conjunto universal de prompts visuais e de texto a serem integrados, respectivamente, aos quadros de vídeo amostrados e às características textuais. Especificamente, um conjunto de diferentes prompts visuais é aplicado, em ordem, aos quadros amostrados uniformemente de um único vídeo sem cortes.
O objetivo deste modelo é incorporar prompts treináveis tanto nas entradas visuais quanto nos recursos textuais para problemas de localização temporal de vídeo (TVG). Em princípio, é possível aplicar qualquer codificador visual ou multimodal na arquitetura proposta.
O [TvpProcessor](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpProcessor) encapsula o [BertTokenizer](/docs/transformers/main/pt/model_doc/lxmert#transformers.BertTokenizer) e o [TvpImageProcessor](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpImageProcessor) em uma única instância para codificar o texto e preparar as imagens, respectivamente.
O exemplo a seguir mostra como executar o grounding temporal de vídeo usando [TvpProcessor](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpProcessor) e [TvpForVideoGrounding](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpForVideoGrounding).
```python
import av
import cv2
import numpy as np
from huggingface_hub import hf_hub_download
from transformers import AutoProcessor, TvpForVideoGrounding
def pyav_decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps):
'''
Convert the video from its original fps to the target_fps and decode the video with PyAV decoder.
Args:
container (container): pyav container.
sampling_rate (int): frame sampling rate (interval between two sampled frames).
num_frames (int): number of frames to sample.
clip_idx (int): if clip_idx is -1, perform random temporal sampling.
If clip_idx is larger than -1, uniformly split the video to num_clips
clips, and select the clip_idx-th video clip.
num_clips (int): overall number of clips to uniformly sample from the given video.
target_fps (int): the input video may have different fps, convert it to
the target video fps before frame sampling.
Returns:
frames (tensor): decoded frames from the video. Return None if the no
video stream was found.
fps (float): the number of frames per second of the video.
'''
video = container.streams.video[0]
fps = float(video.average_rate)
clip_size = sampling_rate * num_frames / target_fps * fps
delta = max(num_frames - clip_size, 0)
start_idx = delta * clip_idx / num_clips
end_idx = start_idx + clip_size - 1
timebase = video.duration / num_frames
video_start_pts = int(start_idx * timebase)
video_end_pts = int(end_idx * timebase)
seek_offset = max(video_start_pts - 1024, 0)
container.seek(seek_offset, any_frame=False, backward=True, stream=video)
frames = {}
for frame in container.decode(video=0):
if frame.pts < video_start_pts:
continue
frames[frame.pts] = frame
if frame.pts > video_end_pts:
break
frames = [frames[pts] for pts in sorted(frames)]
return frames, fps
def decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps):
'''
Decode the video and perform temporal sampling.
Args:
container (container): pyav container.
sampling_rate (int): frame sampling rate (interval between two sampled frames).
num_frames (int): number of frames to sample.
clip_idx (int): if clip_idx is -1, perform random temporal sampling.
If clip_idx is larger than -1, uniformly split the video to num_clips
clips, and select the clip_idx-th video clip.
num_clips (int): overall number of clips to uniformly sample from the given video.
target_fps (int): the input video may have different fps, convert it to
the target video fps before frame sampling.
Returns:
frames (tensor): decoded frames from the video.
'''
assert clip_idx >= -2, f"Not a valid clip_idx {clip_idx}"
frames, fps = pyav_decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps)
clip_size = sampling_rate * num_frames / target_fps * fps
index = np.linspace(0, clip_size - 1, num_frames)
index = np.clip(index, 0, len(frames) - 1).astype(np.int64)
frames = np.array([frames[idx].to_rgb().to_ndarray() for idx in index])
frames = frames.transpose(0, 3, 1, 2)
return frames
file = hf_hub_download(repo_id="Intel/tvp_demo", filename="AK2KG.mp4", repo_type="dataset")
model = TvpForVideoGrounding.from_pretrained("Intel/tvp-base", device_map="auto")
decoder_kwargs = dict(
container=av.open(file, metadata_errors="ignore"),
sampling_rate=1,
num_frames=model.config.num_frames,
clip_idx=0,
num_clips=1,
target_fps=3,
)
raw_sampled_frms = decode(**decoder_kwargs)
text = "a person is sitting on a bed."
processor = AutoProcessor.from_pretrained("Intel/tvp-base")
model_inputs = processor(
text=[text], videos=list(raw_sampled_frms), return_tensors="pt", max_text_length=100#, size=size
)
model_inputs["pixel_values"] = model_inputs["pixel_values"].to(model.dtype)
output = model(**model_inputs)
def get_video_duration(filename):
cap = cv2.VideoCapture(filename)
if cap.isOpened():
rate = cap.get(5)
frame_num = cap.get(7)
duration = frame_num/rate
return duration
return -1
duration = get_video_duration(file)
start, end = processor.post_process_video_grounding(output.logits, duration)
print(f"The time slot of the video corresponding to the text \"{text}\" is from {start}s to {end}s")
```
Dicas:
- Esta implementação do TVP usa [BertTokenizer](/docs/transformers/main/pt/model_doc/lxmert#transformers.BertTokenizer) para gerar embeddings de texto e o modelo Resnet-50 para calcular embeddings visuais.
- Os checkpoints do [tvp-base](https://huggingface.co/Intel/tvp-base) pré-treinado foram liberados.
- Consulte a [Tabela 2](https://huggingface.co/papers/2303.04995) para o desempenho do TVP na tarefa de Temporal Video Grounding.
## TvpConfig[[transformers.TvpConfig]]
#### transformers.TvpConfig[[transformers.TvpConfig]]
```python
transformers.TvpConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, distance_loss_weight: float = 1.0, duration_loss_weight: float = 0.1, visual_prompter_type: str = 'framepad', visual_prompter_apply: str = 'replace', visual_prompt_size: int = 96, max_img_size: int = 448, num_frames: int = 48, vocab_size: int = 30522, type_vocab_size: int = 2, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, max_position_embeddings: int = 512, max_grid_col_position_embeddings: int = 100, max_grid_row_position_embeddings: int = 100, hidden_dropout_prob: float | int = 0.1, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-12, initializer_range: float = 0.02, attention_probs_dropout_prob: float | int = 0.1, pad_token_id: int | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/tvp/configuration_tvp.py#L25)
**Parâmetros:**
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : A configuração do modelo backbone.
distance_loss_weight (`float`, *opcional*, padrão 1.0) : O peso da perda de distância.
duration_loss_weight (`float`, *opcional*, padrão 0.1) : O peso da perda de duração.
visual_prompter_type (`str`, *opcional*, padrão `"framepad"`) : Tipo de prompt visual. O tipo de preenchimento. Framepad significa preenchimento em cada quadro. Deve ser um dos valores "framepad" ou "framedownpad"
visual_prompter_apply (`str`, *opcional*, padrão `"replace"`) : A forma de aplicar o prompt visual. Replace significa usar o valor do prompt para alterar o valor original nas entradas visuais. Deve ser um dos valores "replace", "add" ou "remove".
visual_prompt_size (`int`, *opcional*, padrão 96) : O tamanho do prompt visual.
max_img_size (`int`, *opcional*, padrão 448) : O tamanho máximo do quadro.
num_frames (`int`, *opcional*, padrão 48) : O número de quadros extraídos de um vídeo.
vocab_size (`int`, *opcional*, padrão `30522`) : Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelos `input_ids`.
type_vocab_size (`int`, *opcional*, padrão `2`) : O tamanho do vocabulário dos `token_type_ids`.
hidden_size (`int`, *opcional*, padrão `768`) : Dimensão das representações ocultas.
intermediate_size (`int`, *opcional*, padrão `3072`) : Dimensão das representações do MLP.
num_hidden_layers (`int`, *opcional*, padrão `12`) : Número de camadas ocultas no decodificador do Transformer.
num_attention_heads (`int`, *opcional*, padrão `12`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
max_position_embeddings (`int`, *opcional*, padrão 512) : O comprimento máximo da sequência com o qual este modelo pode ser usado. Normalmente, defina este valor para algo grande, apenas por precaução (por exemplo, 512, 1024 ou 2048).
max_grid_col_position_embeddings (`int`, *opcional*, padrão 100) : O maior número de patches horizontais de um quadro de vídeo.
max_grid_row_position_embeddings (`int`, *opcional*, padrão 100) : O maior número de patches verticais de um quadro de vídeo.
hidden_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.1`) : A probabilidade de dropout para todas as camadas totalmente conectadas nos embeddings, encoder e pooler.
hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *opcional*, padrão `1e-12`) : O epsilon usado pelas camadas de normalização de camada.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.1`) : A taxa de dropout para as probabilidades de atenção.
pad_token_id (`int`, *opcional*) : ID do token usado para preenchimento (padding) no vocabulário.
Esta é a classe de configuração para armazenar a configuração de um TvpModel. Ela é usada para instanciar um modelo Tvp de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [Intel/tvp-base](https://huggingface.co/Intel/tvp-base)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
## TvpImageProcessor[[transformers.TvpImageProcessor]]
#### transformers.TvpImageProcessor[[transformers.TvpImageProcessor]]
```python
transformers.TvpImageProcessor(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/tvp/image_processing_tvp.py#L50)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'longest_edge' : 448}`): Descreve as dimensões de entrada máximas para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 448, 'width': 448}`): Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `2`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.5, 0.5, 0.5]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.5, 0.5, 0.5]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*, padrão `True`) : Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 448, 'width': 448}`): O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que qualquer tamanho de imagem fornecido para pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve aplicar um recorte centralizado na imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
do_flip_channel_order (`bool`, *kwargs*, *opcional*, padrão é `self.do_flip_channel_order`) : Se deve inverter a ordem dos canais da imagem de RGB para BGR.
constant_values (`float`, *kwargs* ou `List[float]`, *opcional*, padrão `self.constant_values`) : Valor usado para preencher a área de padding quando `pad_mode` é `'constant'`.
pad_mode (`str`, *kwargs*, *opcional*, padrão é `self.pad_mode`) : Modo de preenchimento a ser usado — `'constant'`, `'edge'`, `'reflect'` ou `'symmetric'`.
Constrói um processador de imagens TvpImageProcessor.
#### preprocess[[transformers.TvpImageProcessor.preprocess]]
```python
preprocess(videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]], list[list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]]]], **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/tvp/image_processing_tvp.py#L72)
**Parâmetros:**
videos (`ImageInput` ou `list[ImageInput]` ou `list[list[ImageInput]]`) : Quadros para pré-processar.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
do_flip_channel_order (`bool`, *kwargs*, *opcional*, padrão é `self.do_flip_channel_order`) : Se deve inverter a ordem dos canais da imagem de RGB para BGR.
constant_values (`float`, *kwargs* ou `List[float]`, *opcional*, padrão `self.constant_values`) : Valor usado para preencher a área de padding quando `pad_mode` é `'constant'`.
pad_mode (`str`, *kwargs*, *opcional*, padrão é `self.pad_mode`) : Modo de preenchimento a ser usado — `'constant'`, `'edge'`, `'reflect'` ou `'symmetric'`.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
## TvpImageProcessorPil[[transformers.TvpImageProcessorPil]]
#### transformers.TvpImageProcessorPil[[transformers.TvpImageProcessorPil]]
```python
transformers.TvpImageProcessorPil(**kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/tvp/image_processing_pil_tvp.py#L72)
**Parâmetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'longest_edge' : 448}`): Descreve as dimensões de entrada máximas para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*, padrão `False`) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 448, 'width': 448}`): Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, padrão `2`) : Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*, padrão `0.00392156862745098`) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*, padrão `True`) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.5, 0.5, 0.5]`) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, padrão `[0.5, 0.5, 0.5]`) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*, padrão `True`) : Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, padrão `{'height' : 448, 'width': 448}`): O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que qualquer tamanho de imagem fornecido para pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*, padrão `True`) : Se deve aplicar um recorte centralizado na imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
do_flip_channel_order (`bool`, *kwargs*, *opcional*, padrão é `self.do_flip_channel_order`) : Se deve inverter a ordem dos canais da imagem de RGB para BGR.
constant_values (`float`, *kwargs* ou `List[float]`, *opcional*, padrão `self.constant_values`) : Valor usado para preencher a área de padding quando `pad_mode` é `'constant'`.
pad_mode (`str`, *kwargs*, *opcional*, padrão é `self.pad_mode`) : Modo de preenchimento a ser usado — `'constant'`, `'edge'`, `'reflect'` ou `'symmetric'`.
Constrói um processador de imagens TvpImageProcessor.
#### preprocess[[transformers.TvpImageProcessorPil.preprocess]]
```python
preprocess(videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]], list[list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]]]], **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/tvp/image_processing_pil_tvp.py#L94)
**Parâmetros:**
videos (`ImageInput` ou `list[ImageInput]` ou `list[list[ImageInput]]`) : Quadros para pré-processar.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Se deve converter a imagem para RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Se deve redimensionar a imagem.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Descreve as dimensões máximas de entrada para o modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamanho da imagem de saída após aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeração `PILImageResampling`. Tem efeito apenas se `do_resize` estiver definido como `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Se deve reescalar a imagem.
rescale_factor (`float`, *kwargs*, *opcional*) : Fator de redimensionamento para redimensionar a imagem, caso `do_rescale` esteja definido como `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Se a imagem deve ser normalizada.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Média da imagem a ser usada para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas se `do_normalize` estiver definido como `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Se deve aplicar padding à imagem. O padding é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de padding depende do modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : O tamanho em `{"height": int, "width" int}` para preencher as imagens. Deve ser maior que o tamanho de qualquer imagem fornecida para o pré-processamento. Se `pad_size` não for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Se deve centralizar o recorte da imagem.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Apenas `ChannelDimension.FIRST` é suportado. Adicionado para compatibilidade com processadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : O formato da dimensão de canal para a imagem de entrada. Se não for definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes: - `"channels_first"` ou `ChannelDimension.FIRST`: imagem no formato (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST`: imagem no formato (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE`: imagem no formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : O dispositivo no qual os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Retorna tensores empilhados se definido como `'pt'`, caso contrário, retorna uma lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros.
do_flip_channel_order (`bool`, *kwargs*, *opcional*, padrão é `self.do_flip_channel_order`) : Se deve inverter a ordem dos canais da imagem de RGB para BGR.
constant_values (`float`, *kwargs* ou `List[float]`, *opcional*, padrão `self.constant_values`) : Valor usado para preencher a área de padding quando `pad_mode` é `'constant'`.
pad_mode (`str`, *kwargs*, *opcional*, padrão é `self.pad_mode`) : Modo de preenchimento a ser usado — `'constant'`, `'edge'`, `'reflect'` ou `'symmetric'`.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
## TvpProcessor[[transformers.TvpProcessor]]
#### transformers.TvpProcessor[[transformers.TvpProcessor]]
```python
transformers.TvpProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/tvp/processing_tvp.py#L34)
**Parâmetros:**
image_processor (`TvpImageProcessor`) : O processador de imagem é uma entrada obrigatória.
tokenizer (`BertTokenizer`) : O tokenizer é uma entrada obrigatória.
Constrói um TvpProcessor que encapsula um processador de imagem e um tokenizer em um único processador.
[TvpProcessor](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpProcessor) oferece todas as funcionalidades de [TvpImageProcessor](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpImageProcessor) e [BertTokenizer](/docs/transformers/main/pt/model_doc/lxmert#transformers.BertTokenizer). Consulte [~TvpImageProcessor](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpImageProcessor) e [~BertTokenizer](/docs/transformers/main/pt/model_doc/lxmert#transformers.BertTokenizer) para mais informações.
#### __call__[[transformers.TvpProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L659)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opcional*) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *opcional*) : A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se você passar uma entrada pretokenizada, defina `is_split_into_words=True` para evitar ambiguidade com entradas em lote.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *opcional*) : Vídeo para pré-processar. Espera um único vídeo ou um lote de vídeos com valores de pixel variando de 0 a 255. Se estiver passando vídeos com valores de pixel entre 0 e 1, defina `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *opcional*) : O áudio ou lote de áudios a ser preparado. Cada áudio pode ser um array NumPy ou um tensor PyTorch. No caso de um array NumPy/tensor PyTorch, cada áudio deve ter a forma (C, T), onde C é o número de canais e T é o comprimento de amostras do áudio.
return_tensors (`str` ou [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *opcional*) : Se definido, retornará tensores de um framework específico. Os valores aceitos são: - `'pt'`: Retorna objetos `torch.Tensor` do PyTorch. - `'np'`: Retorna objetos `np.ndarray` do NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/pt/main_classes/processors#transformers.ProcessingKwargs), *opcional*) : Opções de processamento adicionais para cada modalidade (texto, imagens, vídeos, áudio). Os parâmetros específicos do modelo estão listados acima; consulte a classe TypedDict para a lista completa de argumentos suportados.
## TvpModel[[transformers.TvpModel]]
#### transformers.TvpModel[[transformers.TvpModel]]
```python
transformers.TvpModel(config: TvpConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/tvp/modeling_tvp.py#L684)
**Parâmetros:**
config ([TvpConfig](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Tvp Model básico, um transformer que produz um objeto BaseModelOutputWithPooling sem nenhum head específico no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.TvpModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/tvp/modeling_tvp.py#L707)
**Parâmetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [TvpImageProcessor](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpImageProcessor). Veja [TvpImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([TvpProcessor](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpProcessor) usa [TvpImageProcessor](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpImageProcessor) para processar imagens).
attention_mask (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithPooling](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([TvpConfig](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpConfig)) e das entradas.
O método forward do [TvpModel](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpModel) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> import torch
>>> from transformers import AutoConfig, AutoTokenizer, TvpModel
>>> model = TvpModel.from_pretrained("Jiqing/tiny-random-tvp")
>>> tokenizer = AutoTokenizer.from_pretrained("Jiqing/tiny-random-tvp")
>>> pixel_values = torch.rand(1, 1, 3, 448, 448)
>>> text_inputs = tokenizer("This is an example input", return_tensors="pt")
>>> output = model(text_inputs.input_ids, pixel_values, text_inputs.attention_mask)
```
## TvpForVideoGrounding[[transformers.TvpForVideoGrounding]]
#### transformers.TvpForVideoGrounding[[transformers.TvpForVideoGrounding]]
```python
transformers.TvpForVideoGrounding(config: TvpConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/tvp/modeling_tvp.py#L801)
**Parâmetros:**
config ([TvpConfig](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo Tvp com uma cabeça de grounding de vídeo no topo, calculando as perdas de IoU, distância e duração.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.TvpForVideoGrounding.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, labels: tuple[torch.Tensor] | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/tvp/modeling_tvp.py#L810)
**Parâmetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [TvpImageProcessor](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpImageProcessor). Veja [TvpImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([TvpProcessor](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpProcessor) usa [TvpImageProcessor](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpImageProcessor) para processar imagens).
attention_mask (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
labels (`torch.Tensor` de forma `(batch_size, 3)`, *opcional*) : Os rótulos contêm a duração, o tempo de início e o tempo de término do vídeo correspondente ao texto.
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas.
**Retorna:** `TvpVideoGroundingOutput` ou `tuple(torch.Tensor)`
Um `TvpVideoGroundingOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([TvpConfig](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpConfig)) e das entradas.
O método forward de [TvpForVideoGrounding](/docs/transformers/main/pt/model_doc/tvp#transformers.TvpForVideoGrounding) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `return_loss` é `True`) -- Perda de IoU de distância temporal para grounding de vídeo.
- **logits** (`torch.Tensor` de forma `(batch_size, 2)`) -- Contém start_time/duration e end_time/duration. É o intervalo de tempo dos vídeos correspondentes aos textos de entrada.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (uma para a saída dos embeddings, se o modelo tiver uma camada de embedding, + uma para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Exemplos:
```python
>>> import torch
>>> from transformers import AutoConfig, AutoTokenizer, TvpForVideoGrounding
>>> model = TvpForVideoGrounding.from_pretrained("Jiqing/tiny-random-tvp")
>>> tokenizer = AutoTokenizer.from_pretrained("Jiqing/tiny-random-tvp")
>>> pixel_values = torch.rand(1, 1, 3, 448, 448)
>>> text_inputs = tokenizer("This is an example input", return_tensors="pt")
>>> output = model(text_inputs.input_ids, pixel_values, text_inputs.attention_mask)
```