# UDOP
## Visão geral
O modelo UDOP foi proposto em [Unifying Vision, Text, and Layout for Universal Document Processing](https://huggingface.co/papers/2212.02623) por Zineng Tang, Ziyi Yang, Guoxin Wang, Yuwei Fang, Yang Liu, Chenguang Zhu, Michael Zeng, Cha Zhang, Mohit Bansal. O UDOP adota uma arquitetura Transformer encoder-decoder baseada em [T5](t5) para tarefas de IA de documentos, como classificação de imagens de documentos, análise de documentos e resposta a perguntas visuais sobre documentos.
O resumo do artigo é o seguinte:
Propomos o Universal Document Processing (UDOP), um modelo de fundação de Document AI que unifica as modalidades de texto, imagem e layout, juntamente com formatos variados de tarefas, incluindo compreensão e geração de documentos. O UDOP aproveita a correlação espacial entre o conteúdo textual e a imagem do documento para modelar as modalidades de imagem, texto e layout com uma representação uniforme. Com um Vision-Text-Layout Transformer inovador, o UDOP unifica o pré-treinamento e as tarefas downstream de múltiplos domínios em um esquema de geração de sequências baseado em prompts. O UDOP é pré-treinado tanto em grandes corpora de documentos não rotulados, usando objetivos auto-supervisionados inovadores, quanto em dados rotulados diversos. O UDOP também aprende a gerar imagens de documentos a partir das modalidades de texto e layout por meio de reconstrução de imagem mascarada. Até onde temos conhecimento, esta é a primeira vez no campo de Document AI que um único modelo alcança simultaneamente edição neural de documentos de alta qualidade e personalização de conteúdo. Nosso método estabelece o estado da arte em 9 tarefas de Document AI, por exemplo, compreensão de documentos e QA, em diversos domínios de dados, como relatórios financeiros, artigos acadêmicos e sites. O UDOP ocupa a primeira posição no leaderboard do Document Understanding Benchmark (DUE).*
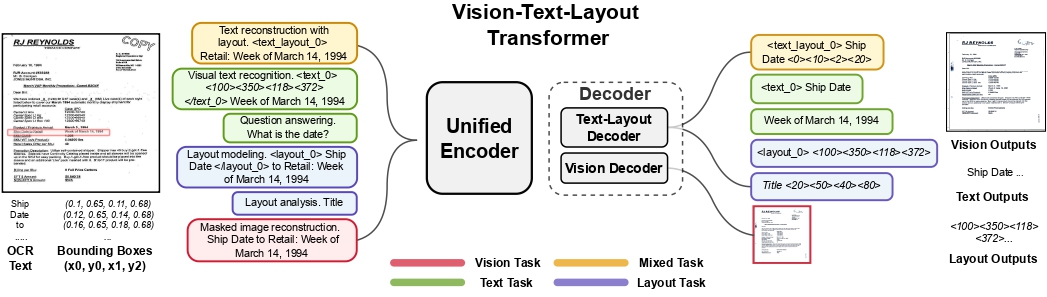 Arquitetura UDOP. Retirada do artigo original.
## Dicas de uso
- Além de *input_ids*, [UdopForConditionalGeneration](/docs/transformers/main/pt/model_doc/udop#transformers.UdopForConditionalGeneration) também espera a entrada `bbox`, que são as caixas delimitadoras (ou seja, posições 2D) dos tokens de entrada. Essas podem ser obtidas usando um mecanismo de OCR externo, como o [Tesseract](https://github.com/tesseract-ocr/tesseract) da Google (há um [Python wrapper](https://pypi.org/project/pytesseract/) disponível). Cada caixa delimitadora deve estar no formato (x0, y0, x1, y1), em que (x0, y0) corresponde à posição do canto superior esquerdo na caixa delimitadora e (x1, y1) representa a posição do canto inferior direito. Observe que primeiro é necessário normalizar as caixas delimitadoras para uma escala de 0 a 1000. Para normalizar, você pode usar a seguinte função:
```python
def normalize_bbox(bbox, width, height):
return [
int(1000 * (bbox[0] / width)),
int(1000 * (bbox[1] / height)),
int(1000 * (bbox[2] / width)),
int(1000 * (bbox[3] / height)),
]
```
Aqui, `width` e `height` correspondem à largura e à altura do documento original em que o token ocorre. Esses valores podem ser obtidos, por exemplo, usando a biblioteca Python Image Library (PIL), da seguinte forma:
```python
from PIL import Image
# Document can be a png, jpg, etc. PDFs must be converted to images.
image = Image.open(name_of_your_document).convert("RGB")
width, height = image.size
```
É possível usar [UdopProcessor](/docs/transformers/main/pt/model_doc/udop#transformers.UdopProcessor) para preparar imagens e texto para o modelo, que cuida de tudo isso. Por padrão, essa classe usa o mecanismo Tesseract para extrair uma lista de palavras e caixas (coordenadas) de um documento dado. Sua funcionalidade é equivalente à de [LayoutLMv3Processor](/docs/transformers/main/pt/model_doc/layoutlmv3#transformers.LayoutLMv3Processor), portanto, ela suporta a passagem de `apply_ocr=False` caso você prefira usar seu próprio mecanismo de OCR ou `apply_ocr=True` caso queira que o mecanismo de OCR padrão seja usado. Consulte o [guia de uso do LayoutLMv2](layoutlmv2#usage-layoutlmv2processor) em relação a todos os casos de uso possíveis (a funcionalidade de `UdopProcessor` é idêntica).
- Ao utilizar um motor de OCR próprio, uma recomendação é a [Read API](https://learn.microsoft.com/en-us/azure/ai-services/computer-vision/how-to/call-read-api) da Azure, que suporta os chamados segmentos de linha. O uso de embeddings de posição de segmento geralmente resulta em melhor desempenho.
- No momento da inferência, recomenda-se usar o método `generate` para gerar texto de forma autoregressiva a partir de uma imagem de documento.
- O modelo foi pré-treinado em objetivos tanto auto-supervisionados quanto supervisionados. É possível usar os vários prefixos de tarefa (prompts) utilizados durante o pré-treinamento para testar as capacidades nativas do modelo. Por exemplo, o modelo pode ser acionado com "Question answering. What is the date?", pois "Question answering." é o prefixo de tarefa usado durante o pré-treinamento para o DocVQA. Consulte o [paper](https://huggingface.co/papers/2212.02623) (tabela 1) para todos os prefixos de tarefa.
- Também é possível fazer o ajuste fino de [UdopEncoderModel](/docs/transformers/main/pt/model_doc/udop#transformers.UdopEncoderModel), que é a parte apenas de codificador do UDOP, que pode ser vista como um codificador Transformer semelhante ao LayoutLMv3. Para tarefas discriminativas, basta adicionar um classificador linear por cima e fazer o ajuste fino em um conjunto de dados rotulado.
Este modelo foi contribuído por [nielsr](https://huggingface.co/nielsr). O código original pode ser encontrado [aqui](https://github.com/microsoft/UDOP).
## Recursos
Uma lista de recursos oficiais do Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o UDOP. Se você tiver interesse em enviar um recurso para ser incluído aqui, sinta-se à vontade para abrir um Pull Request e faremos a revisão! O recurso deve, idealmente, demonstrar algo novo em vez de duplicar um recurso existente.
- Os notebooks de demonstração sobre UDOP podem ser encontrados [aqui](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/UDOP), mostrando como
para fazer o ajuste fino do UDOP em um conjunto de dados personalizado, bem como para inferência. 🌎
- [Guia da tarefa de resposta a perguntas em documentos](../tasks/document_question_answering)
## UdopConfig[[transformers.UdopConfig]]
#### transformers.UdopConfig[[transformers.UdopConfig]]
```python
transformers.UdopConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, vocab_size: int = 33201, d_model: int = 1024, d_kv: int = 64, d_ff: int = 4096, num_layers: int = 24, num_decoder_layers: int | None = None, num_heads: int = 16, relative_attention_num_buckets: int = 32, relative_attention_max_distance: int = 128, relative_bias_args: list[dict] | None = None, dropout_rate: float | int = 0.1, layer_norm_epsilon: float = 1e-06, initializer_factor: float = 1.0, feed_forward_proj: str = 'relu', use_cache: bool = True, pad_token_id: int | None = 0, eos_token_id: int | list[int] | None = 1, max_2d_position_embeddings: int = 1024, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, is_decoder: bool = False, add_cross_attention: bool = False, tie_word_embeddings: bool = True)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/configuration_udop.py#L24)
**Parâmetros:**
is_encoder_decoder (`bool`, *opcional*, padrão `True`) : Indica se o modelo é usado como codificador/decodificador ou não.
vocab_size (`int`, *opcional*, padrão `33201`) : Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelos `input_ids`.
d_model (`int`, *opcional*, padrão `1024`) : Tamanho das camadas do codificador e da camada pooler.
d_kv (`int`, *opcional*, padrão `64`) : Tamanho das projeções de chave, consulta e valor por cabeça de atenção. O `inner_dim` da camada de projeção será definido como `num_heads * d_kv`.
d_ff (`int`, *opcional*, padrão `4096`) : Dimensão das representações do MLP.
num_layers (`int`, *opcional*, padrão `24`) : Número de camadas ocultas no decodificador do Transformer.
num_decoder_layers (`int`, *opcional*) : Número de camadas ocultas no decodificador do Transformer. Usará o mesmo valor de `num_layers` se não for definido.
num_heads (`int`, *opcional*, padrão `16`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
relative_attention_num_buckets (`int`, *opcional*, padrão 32) : O número de buckets a serem usados em cada camada de atenção.
relative_attention_max_distance (`int`, *opcional*, padrão 128) : A distância máxima das sequências mais longas para a separação em buckets.
relative_bias_args (`list[dict]`, *opcional*, padrão `[{'type' : '1d'}, {'type': 'horizontal'}, {'type': 'vertical'}]`): Uma lista de dicionários contendo os argumentos para as camadas de viés relativo.
dropout_rate (`Union[float, int]`, *opcional*, padrão `0.1`) : A proporção para todas as camadas de dropout.
layer_norm_epsilon (`float`, *opcional*, padrão `1e-06`) : O epsilon usado pelas camadas de normalização de camada.
initializer_factor (`float`, *opcional*, padrão `1.0`) : Um fator para inicializar todas as matrizes de pesos (deve ser mantido em 1, usado internamente para testes de inicialização).
feed_forward_proj (`string`, *opcional*, padrão `"relu"`) : Tipo de camada feed forward a ser usada. Deve ser um dos valores `"relu"` ou `"gated-gelu"`. O Udopv1.1 usa a projeção feed forward `"gated-gelu"`. O Udop original usa `"relu"`.
use_cache (`bool`, *opcional*, padrão `True`) : Indica se o modelo deve retornar as últimas atenções de chave/valor (não utilizado por todos os modelos). Relevante apenas se `config.is_decoder=True` ou quando o modelo for um modelo generativo somente de decodificador.
pad_token_id (`int`, *opcional*, padrão `0`) : ID do token usado para preenchimento no vocabulário.
eos_token_id (`Union[int, list[int]]`, *opcional*, padrão `1`) : ID do token usado para o fim do fluxo no vocabulário.
max_2d_position_embeddings (`int`, *opcional*, padrão 1024) : Os embeddings de posição absoluta máximos para a codificação de posição relativa.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `224`) : O tamanho (resolução) de cada imagem.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `16`) : O tamanho (resolução) de cada patch.
num_channels (`int`, *opcional*, padrão `3`) : O número de canais de entrada.
is_decoder (`bool`, *opcional*, padrão `False`) : Indica se o modelo é usado como decodificador ou não. Se `False`, o modelo é usado como codificador.
add_cross_attention (`bool`, *opcional*, padrão `False`) : Se as camadas de atenção cruzada devem ser adicionadas ao modelo.
tie_word_embeddings (`bool`, *opcional*, padrão `True`) : Se deve vincular as embeddings de pesos de acordo com o mapeamento `tied_weights_keys` do modelo.
Esta é a classe de configuração para armazenar a configuração de um UdopModel. Ela é usada para instanciar um modelo Udop de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [microsoft/udop-large](https://huggingface.co/microsoft/udop-large)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
## UdopTokenizer[[transformers.UdopTokenizer]]
#### transformers.UdopTokenizer[[transformers.UdopTokenizer]]
```python
transformers.UdopTokenizer(vocab: str | list[tuple[str, float]] | None = None, eos_token = '', sep_token = '', unk_token = '', pad_token = '', sep_token_box = [1000, 1000, 1000, 1000], pad_token_box = [0, 0, 0, 0], pad_token_label = -100, only_label_first_subword = True, extra_special_tokens = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/tokenization_udop.py#L139)
**Parâmetros:**
eos_token (`str`, *opcional*, padrão `""`) : O token de fim de sequência. Ao construir uma sequência usando tokens especiais, este não é o token utilizado para o fim da sequência. O token utilizado é o `sep_token`.
sep_token (`str`, *opcional*, padrão `""`) : O token separador, usado ao montar uma sequência a partir de múltiplas sequências, por exemplo, duas sequências para classificação de sequência ou um texto e uma pergunta para resposta a perguntas. Também é usado como o último token de uma sequência montada com tokens especiais.
unk_token (`str`, *opcional*, padrão `""`) : O token desconhecido. Um token que não está no vocabulário não pode ser convertido em um ID e é definido como este token em vez disso.
pad_token (`str`, *opcional*, padrão `""`) : O token usado para preenchimento, por exemplo, ao agrupar sequências de comprimentos diferentes.
sep_token_box (`list[int]`, *opcional*, padrão `[1000, 1000, 1000, 1000]`) : A caixa delimitadora a ser usada para o token especial [SEP].
pad_token_box (`list[int]`, *opcional*, padrão `[0, 0, 0, 0]`) : A caixa delimitadora a ser usada para o token especial [PAD].
pad_token_label (`int`, *opcional*, padrão -100) : O rótulo a ser usado para tokens de preenchimento. O padrão é -100, que corresponde ao `ignore_index` do CrossEntropyLoss do PyTorch.
only_label_first_subword (`bool`, *opcional*, padrão `True`) : Indica se apenas o primeiro subtoken deve ser rotulado, caso rótulos de palavras sejam fornecidos.
extra_special_tokens (`list[str]`, *opcional*, padrão `["
NOTUSED", "NOTUSED"]`) : Tokens especiais extras usados pelo tokenizer.
Construa um tokenizador UDOP "rápido" (baseado na biblioteca *tokenizers* do HuggingFace). Adaptado de [LayoutXLMTokenizer](/docs/transformers/main/pt/model_doc/layoutxlm#transformers.LayoutXLMTokenizer) e [T5Tokenizer](/docs/transformers/main/pt/model_doc/t5#transformers.T5Tokenizer). Baseado em [BPE](https://huggingface.co/docs/tokenizers/python/latest/components.html?highlight=BPE#models).
Este tokenizer herda de [TokenizersBackend](/docs/transformers/main/pt/main_classes/tokenizer#transformers.TokenizersBackend), que contém a maioria dos métodos principais. Os usuários devem consultar essa superclasse para obter mais informações sobre esses métodos.
#### build_inputs_with_special_tokens[[transformers.UdopTokenizer.build_inputs_with_special_tokens]]
```python
build_inputs_with_special_tokens(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/tokenization_udop.py#L972)
**Parâmetros:**
token_ids_0 (`list[int]`) : Lista de IDs aos quais os tokens especiais serão adicionados.
token_ids_1 (`list[int]`, *opcional*) : Lista opcional de IDs para pares de sequências.
**Retorna:** `list[int]`
Lista de [IDs de entrada](../glossary#input-ids) com os tokens especiais apropriados.
Construa as entradas do modelo a partir de uma sequência ou de um par de sequências para tarefas de classificação de sequência, concatenando e adicionando tokens especiais. Uma sequência XLM-RoBERTa tem o seguinte formato:
- sequência única: ` X `
- par de sequências: ` A B `
#### get_special_tokens_mask[[transformers.UdopTokenizer.get_special_tokens_mask]]
```python
get_special_tokens_mask(token_ids_0: list[int], token_ids_1: list[int] | None = None, already_has_special_tokens: bool = False)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/tokenization_utils_base.py#L1338)
**Parâmetros:**
token_ids_0 : Lista de IDs da sequência (possivelmente já formatada).
token_ids_1 : Não utilizado quando `already_has_special_tokens=True`. Deve ser None nesse caso.
already_has_special_tokens : Indica se a sequência já está formatada com tokens especiais.
**Retorna:** Uma lista de inteiros no intervalo [0, 1]
1 para um token especial, 0 para um token de sequência.
Obter os ids de sequência de uma lista de tokens que não possui tokens especiais adicionados.
Para tokenizadores rápidos, os data collators chamam isso com `already_has_special_tokens=True` para construir uma máscara sobre uma sequência já formatada. Nesse caso, calculamos a máscara verificando a pertença em `all_special_ids`.
#### criar_ids_de_tipo_de_token_a_partir_de_sequências[[transformers.UdopTokenizer.create_token_type_ids_from_sequences]]
```python
create_token_type_ids_from_sequences(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/tokenization_udop.py#L997)
**Parâmetros:**
token_ids_0 (`list[int]`) : Lista de IDs.
token_ids_1 (`list[int]`, *opcional*) : Lista opcional de IDs para pares de sequências.
**Retorna:** `list[int]`
Lista de zeros.
Cria uma máscara a partir das duas sequências passadas para ser usada em uma tarefa de classificação de pares de sequências. O XLM-RoBERTa não faz uso de ids de tipo de token, portanto, uma lista de zeros é retornada.
#### save_vocabulary[[transformers.UdopTokenizer.save_vocabulary]]
```python
save_vocabulary(save_directory: str, filename_prefix: str | None = None)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/tokenization_udop.py#L1021)
Salve os arquivos de vocabulário do tokenizer. Para o TokenizersBackend, o arquivo tokenizer.json é salvo pela classe base. Este método retorna uma tupla vazia, pois usamos apenas o tokenizer.json.
## UdopProcessor[[transformers.UdopProcessor]]
#### transformers.UdopProcessor[[transformers.UdopProcessor]]
```python
transformers.UdopProcessor(image_processor, tokenizer)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/processing_udop.py#L53)
**Parâmetros:**
image_processor (`LayoutLMv3ImageProcessor`) : O processador de imagem é uma entrada obrigatória.
tokenizer (`UdopTokenizer`) : O tokenizer é uma entrada obrigatória.
Constrói um UdopProcessor que encapsula um processador de imagem e um tokenizer em um único processador.
[UdopProcessor](/docs/transformers/main/pt/model_doc/udop#transformers.UdopProcessor) oferece todas as funcionalidades de [LayoutLMv3ImageProcessor](/docs/transformers/main/pt/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor) e [UdopTokenizer](/docs/transformers/main/pt/model_doc/udop#transformers.UdopTokenizer). Consulte [~LayoutLMv3ImageProcessor](/docs/transformers/main/pt/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor) e [~UdopTokenizer](/docs/transformers/main/pt/model_doc/udop#transformers.UdopTokenizer) para mais informações.
#### __call__[[transformers.UdopProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/processing_udop.py#L72)
**Parâmetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opcional*) : Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se estiver passando imagens com valores de pixel entre 0 e 1, defina `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *opcional*) : A sequência ou lote de sequências a ser codificada. Cada sequência pode ser uma string ou uma lista de strings (string pretokenizada). Se você passar uma entrada pretokenizada, defina `is_split_into_words=True` para evitar ambiguidade com entradas em lote.
return_tensors (`str` ou [TensorType](/docs/transformers/main/pt/internal/file_utils#transformers.TensorType), *opcional*) : Se definido, retornará tensores de um framework específico. Os valores aceitos são: - `'pt'`: Retorna objetos `torch.Tensor` do PyTorch. - `'np'`: Retorna objetos `np.ndarray` do NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/pt/main_classes/processors#transformers.ProcessingKwargs), *opcional*) : Opções de processamento adicionais para cada modalidade (texto, imagens, vídeos, áudio). Os parâmetros específicos do modelo estão listados acima; consulte a classe TypedDict para a lista completa de argumentos suportados.
**Retorna:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dicionário de listas/arrays/tensors retornados pelo método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
## UdopModel[[transformers.UdopModel]]
#### transformers.UdopModel[[transformers.UdopModel]]
```python
transformers.UdopModel(config: UdopConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/modeling_udop.py#L1251)
**Parâmetros:**
config ([UdopConfig](/docs/transformers/main/pt/model_doc/udop#transformers.UdopConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Udop puro, que produz estados ocultos brutos sem nenhum cabeçalho específico no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.UdopModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, bbox: dict[str, typing.Any] | None = None, pixel_values: typing.Optional[torch.Tensor] = None, visual_bbox: dict[str, typing.Any] | None = None, decoder_input_ids: typing.Optional[torch.Tensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/modeling_udop.py#L1287)
**Parâmetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
bbox (`torch.LongTensor` de forma `({0}, 4)`, *opcional*) : Caixas delimitadoras dos tokens de cada sequência de entrada. Selecionadas no intervalo `[0, config.max_2d_position_embeddings-1]`. Cada caixa delimitadora deve ser uma versão normalizada no formato (x0, y0, x1, y1), onde (x0, y0) corresponde à posição do canto superior esquerdo na caixa delimitadora, e (x1, y1) representa a posição do canto inferior direito. Observe que `sequence_length = token_sequence_length + patch_sequence_length + 1`, onde `1` é para o token [CLS]. Veja `pixel_values` para `patch_sequence_length`.
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [LayoutLMv3ImageProcessor](/docs/transformers/main/pt/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor). Veja [LayoutLMv3ImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([UdopProcessor](/docs/transformers/main/pt/model_doc/udop#transformers.UdopProcessor) usa [LayoutLMv3ImageProcessor](/docs/transformers/main/pt/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor) para processar imagens).
visual_bbox (`torch.LongTensor` de forma `(batch_size, patch_sequence_length, 4)`, *opcional*) : Caixas delimitadoras de cada patch na imagem. Se não fornecidas, as caixas delimitadoras são criadas no modelo.
decoder_input_ids (`torch.LongTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada do decodificador no vocabulário. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Veja [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para detalhes. [O que são IDs de entrada do decodificador?](../glossary#decoder-input-ids) O T5 usa o `pad_token_id` como o token inicial para a geração de `decoder_input_ids`. Se `past_key_values` for usado, opcionalmente apenas os últimos `decoder_input_ids` precisam ser inseridos (veja `past_key_values`). Para saber mais sobre como preparar `decoder_input_ids` para pré-treinamento, dê uma olhada em [T5 Training](./t5#training).
decoder_attention_mask (`torch.BoolTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Comportamento padrão: gerar um tensor que ignora tokens de preenchimento em `decoder_input_ids`. A máscara causal também será usada por padrão.
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
encoder_outputs (`torch.Tensor`, *opcional*) : Tupla consiste em (`last_hidden_state`, *opcional*: `hidden_states`, *opcional*: `attentions`) `last_hidden_state` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) é uma sequência de hidden-states na saída da última camada do codificador. Usado na cross-attention do decodificador.
past_key_values (`~cache_utils.Cache`, *opcional*) : hidden-states pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nos `past_key_values` retornados pelo modelo em uma etapa anterior da decodificação, quando `use_cache=True` ou `config.use_cache=True`. Apenas uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache) é permitida como entrada, consulte nosso [guia de kv cache](https://huggingface.co/docs/transformers/en/kv_cache). Se nenhum `past_key_values` for passado, [DynamicCache](/docs/transformers/main/pt/internal/generation_utils#transformers.DynamicCache) será inicializado por padrão. O modelo sairá no mesmo formato de cache que foi fornecido como entrada. Se `past_key_values` forem usados, espera-se que o usuário insira apenas `input_ids` não processados (aqueles que não têm seus estados de chave e valor passados para este modelo) com a forma `(batch_size, unprocessed_length)` em vez de todos os `input_ids` com a forma `(batch_size, sequence_length)`.
decoder_inputs_embeds (`torch.Tensor` de forma `(batch_size, target_sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `decoder_input_ids`, você pode escolher passar diretamente uma representação incorporada. Se `past_key_values` for usado, opcionalmente apenas o último `decoder_inputs_embeds` precisa ser inserido (veja `past_key_values`). Isso é útil se você quiser ter mais controle sobre como converter os índices de `decoder_input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo. Se `decoder_input_ids` e `decoder_inputs_embeds` estiverem ambos não definidos, `decoder_inputs_embeds` assume o valor de `inputs_embeds`.
use_cache (`bool`, *opcional*) : Se definido como `True`, os estados de chave-valor de `past_key_values` são retornados e podem ser usados para acelerar a decodificação (veja `past_key_values`).
**Retorna:** [Seq2SeqModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.Seq2SeqModelOutput) ou `tuple(torch.Tensor)`
Um [Seq2SeqModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.Seq2SeqModelOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([UdopConfig](/docs/transformers/main/pt/model_doc/udop#transformers.UdopConfig)) e das entradas.
O método forward do [UdopModel](/docs/transformers/main/pt/model_doc/udop#transformers.UdopModel) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do decoder do modelo.
Se `past_key_values` for usado, apenas o último hidden-state das sequências, com forma `(batch_size, 1, hidden_size)`, é retornado.
- **past_key_values** (`EncoderDecoderCache`, *opcional*, retornado quando `use_cache=True` é passado ou quando `config.use_cache=True`) -- É uma instância de [EncoderDecoderCache](/docs/transformers/main/pt/internal/generation_utils#transformers.EncoderDecoderCache). Para mais detalhes, consulte nosso [guia de cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados (veja a entrada `past_key_values`) para acelerar a decodificação sequencial.
- **decoder_hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (uma para a saída dos embeddings, se o modelo tiver uma camada de embedding, + uma para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do decodificador na saída de cada camada, além das saídas opcionais do embedding inicial.
- **decoder_attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) com forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
- **encoder_last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) -- Sequência de estados ocultos na saída da última camada do encoder do modelo.
- **encoder_hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (uma para a saída dos embeddings, se o modelo tiver uma camada de embedding, + uma para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do codificador na saída de cada camada, além das saídas opcionais do embedding inicial.
- **encoder_attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção do codificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplo:
```python
>>> from transformers import AutoProcessor, AutoModel
>>> from datasets import load_dataset
>>> import torch
>>> # load model and processor
>>> # in this case, we already have performed OCR ourselves
>>> # so we initialize the processor with `apply_ocr=False`
>>> processor = AutoProcessor.from_pretrained("microsoft/udop-large", apply_ocr=False)
>>> model = AutoModel.from_pretrained("microsoft/udop-large")
>>> # load an example image, along with the words and coordinates
>>> # which were extracted using an OCR engine
>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> image = example["image"]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]
>>> inputs = processor(image, words, boxes=boxes, return_tensors="pt")
>>> decoder_input_ids = torch.tensor([[model.config.decoder_start_token_id]])
>>> # forward pass
>>> outputs = model(**inputs, decoder_input_ids=decoder_input_ids)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 1, 1024]
```
## UdopForConditionalGeneration[[transformers.UdopForConditionalGeneration]]
#### transformers.UdopForConditionalGeneration[[transformers.UdopForConditionalGeneration]]
```python
transformers.UdopForConditionalGeneration(config: UdopConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/modeling_udop.py#L1405)
**Parâmetros:**
config ([UdopConfig](/docs/transformers/main/pt/model_doc/udop#transformers.UdopConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O Transformer encoder-decoder UDOP com uma cabeça de modelagem de linguagem no topo, permitindo gerar texto a partir de imagens de documentos e um prompt opcional.
Esta classe é baseada em [T5ForConditionalGeneration](/docs/transformers/main/pt/model_doc/t5#transformers.T5ForConditionalGeneration), estendida para lidar com dados de imagens e layout (2D).
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.UdopForConditionalGeneration.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, bbox: dict[str, typing.Any] | None = None, pixel_values: typing.Optional[torch.Tensor] = None, visual_bbox: dict[str, typing.Any] | None = None, decoder_input_ids: typing.Optional[torch.Tensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/modeling_udop.py#L1447)
**Parâmetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
bbox (`torch.LongTensor` de forma `({0}, 4)`, *opcional*) : Caixas delimitadoras dos tokens de cada sequência de entrada. Selecionadas no intervalo `[0, config.max_2d_position_embeddings-1]`. Cada caixa delimitadora deve ser uma versão normalizada no formato (x0, y0, x1, y1), onde (x0, y0) corresponde à posição do canto superior esquerdo na caixa delimitadora, e (x1, y1) representa a posição do canto inferior direito. Observe que `sequence_length = token_sequence_length + patch_sequence_length + 1`, onde `1` é para o token [CLS]. Veja `pixel_values` para `patch_sequence_length`.
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [LayoutLMv3ImageProcessor](/docs/transformers/main/pt/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor). Veja [LayoutLMv3ImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([UdopProcessor](/docs/transformers/main/pt/model_doc/udop#transformers.UdopProcessor) usa [LayoutLMv3ImageProcessor](/docs/transformers/main/pt/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor) para processar imagens).
visual_bbox (`torch.LongTensor` de forma `(batch_size, patch_sequence_length, 4)`, *opcional*) : Caixas delimitadoras de cada patch na imagem. Se não fornecidas, as caixas delimitadoras são criadas no modelo.
decoder_input_ids (`torch.LongTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada do decodificador no vocabulário. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Veja [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para detalhes. [O que são IDs de entrada do decodificador?](../glossary#decoder-input-ids) O T5 usa o `pad_token_id` como o token inicial para a geração de `decoder_input_ids`. Se `past_key_values` for usado, opcionalmente apenas os últimos `decoder_input_ids` precisam ser inseridos (veja `past_key_values`). Para saber mais sobre como preparar `decoder_input_ids` para pré-treinamento, dê uma olhada em [T5 Training](./t5#training).
decoder_attention_mask (`torch.BoolTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Comportamento padrão: gerar um tensor que ignora tokens de preenchimento em `decoder_input_ids`. A máscara causal também será usada por padrão.
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
encoder_outputs (`torch.Tensor`, *opcional*) : Tupla consiste em (`last_hidden_state`, *opcional*: `hidden_states`, *opcional*: `attentions`) `last_hidden_state` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) é uma sequência de hidden-states na saída da última camada do codificador. Usado na cross-attention do decodificador.
past_key_values (`~cache_utils.Cache`, *opcional*) : hidden-states pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nos `past_key_values` retornados pelo modelo em uma etapa anterior da decodificação, quando `use_cache=True` ou `config.use_cache=True`. Apenas uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache) é permitida como entrada, consulte nosso [guia de kv cache](https://huggingface.co/docs/transformers/en/kv_cache). Se nenhum `past_key_values` for passado, [DynamicCache](/docs/transformers/main/pt/internal/generation_utils#transformers.DynamicCache) será inicializado por padrão. O modelo sairá no mesmo formato de cache que foi fornecido como entrada. Se `past_key_values` forem usados, espera-se que o usuário insira apenas `input_ids` não processados (aqueles que não têm seus estados de chave e valor passados para este modelo) com a forma `(batch_size, unprocessed_length)` em vez de todos os `input_ids` com a forma `(batch_size, sequence_length)`.
decoder_inputs_embeds (`torch.Tensor` de forma `(batch_size, target_sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `decoder_input_ids`, você pode escolher passar diretamente uma representação incorporada. Se `past_key_values` for usado, opcionalmente apenas o último `decoder_inputs_embeds` precisa ser inserido (veja `past_key_values`). Isso é útil se você quiser ter mais controle sobre como converter os índices de `decoder_input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo. Se `decoder_input_ids` e `decoder_inputs_embeds` estiverem ambos não definidos, `decoder_inputs_embeds` assume o valor de `inputs_embeds`.
use_cache (`bool`, *opcional*) : Se definido como `True`, os estados de chave-valor de `past_key_values` são retornados e podem ser usados para acelerar a decodificação (veja `past_key_values`).
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para o cálculo da perda de modelagem de linguagem. Os índices devem estar em `[-100, 0, ..., config.vocab_size - 1]`. Todos os rótulos definidos como `-100` são ignorados (mascarados); a perda é calculada apenas para os rótulos em `[0, ..., config.vocab_size]`.
**Retorna:** [Seq2SeqLMOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.Seq2SeqLMOutput) ou `tuple(torch.Tensor)`
Um [Seq2SeqLMOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.Seq2SeqLMOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([UdopConfig](/docs/transformers/main/pt/model_doc/udop#transformers.UdopConfig)) e das entradas.
O método forward de [UdopForConditionalGeneration](/docs/transformers/main/pt/model_doc/udop#transformers.UdopForConditionalGeneration) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de modelagem de linguagem.
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).
- **past_key_values** (`EncoderDecoderCache`, *opcional*, retornado quando `use_cache=True` é passado ou quando `config.use_cache=True`) -- É uma instância de [EncoderDecoderCache](/docs/transformers/main/pt/internal/generation_utils#transformers.EncoderDecoderCache). Para mais detalhes, consulte nosso [guia de cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados (veja a entrada `past_key_values`) para acelerar a decodificação sequencial.
- **decoder_hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (uma para a saída dos embeddings, se o modelo tiver uma camada de embedding, + uma para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do decodificador na saída de cada camada, além das saídas do embedding inicial.
- **decoder_attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) com forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
- **encoder_last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) -- Sequência de estados ocultos na saída da última camada do encoder do modelo.
- **encoder_hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (uma para a saída dos embeddings, se o modelo tiver uma camada de embedding, + uma para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do codificador na saída de cada camada, além das saídas do embedding inicial.
- **encoder_attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção do codificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> from transformers import AutoProcessor, UdopForConditionalGeneration
>>> from datasets import load_dataset
>>> # load model and processor
>>> # in this case, we already have performed OCR ourselves
>>> # so we initialize the processor with `apply_ocr=False`
>>> processor = AutoProcessor.from_pretrained("microsoft/udop-large", apply_ocr=False)
>>> model = UdopForConditionalGeneration.from_pretrained("microsoft/udop-large")
>>> # load an example image, along with the words and coordinates
>>> # which were extracted using an OCR engine
>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> image = example["image"]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]
>>> # one can use the various task prefixes (prompts) used during pre-training
>>> # e.g. the task prefix for DocVQA is "Question answering. "
>>> question = "Question answering. What is the date on the form?"
>>> encoding = processor(image, question, text_pair=words, boxes=boxes, return_tensors="pt")
>>> # autoregressive generation
>>> predicted_ids = model.generate(**encoding)
>>> print(processor.batch_decode(predicted_ids, skip_special_tokens=True)[0])
9/30/92
```
## UdopEncoderModel[[transformers.UdopEncoderModel]]
#### transformers.UdopEncoderModel[[transformers.UdopEncoderModel]]
```python
transformers.UdopEncoderModel(config: UdopConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/modeling_udop.py#L1579)
**Parâmetros:**
config ([UdopConfig](/docs/transformers/main/pt/model_doc/udop#transformers.UdopConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Udop puro, que produz estados ocultos brutos sem nenhum cabeçalho específico no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.UdopEncoderModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, bbox: dict[str, typing.Any] | None = None, attention_mask: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, visual_bbox: dict[str, typing.Any] | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/modeling_udop.py#L1610)
**Parâmetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`) : Índices dos tokens da sequência de entrada no vocabulário. O T5 é um modelo com embeddings de posição relativa, portanto, você deve poder preencher as entradas tanto à direita quanto à esquerda. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. Para saber mais sobre como preparar `input_ids` para pré-treinamento, veja [T5 Training](./t5#training).
bbox (`torch.LongTensor` de forma `({0}, 4)`, *opcional*) : Caixas delimitadoras dos tokens de cada sequência de entrada. Selecionadas no intervalo `[0, config.max_2d_position_embeddings-1]`. Cada caixa delimitadora deve ser uma versão normalizada no formato (x0, y0, x1, y1), onde (x0, y0) corresponde à posição do canto superior esquerdo na caixa delimitadora, e (x1, y1) representa a posição do canto inferior direito. Observe que `sequence_length = token_sequence_length + patch_sequence_length + 1`, onde `1` é para o token [CLS]. Veja `pixel_values` para `patch_sequence_length`.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [LayoutLMv3ImageProcessor](/docs/transformers/main/pt/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor). Veja [LayoutLMv3ImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para detalhes ([UdopProcessor](/docs/transformers/main/pt/model_doc/udop#transformers.UdopProcessor) usa [LayoutLMv3ImageProcessor](/docs/transformers/main/pt/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor) para processar imagens).
visual_bbox (`torch.LongTensor` de forma `(batch_size, patch_sequence_length, 4)`, *opcional*) : Caixas delimitadoras de cada patch na imagem. Se não fornecidas, as caixas delimitadoras são criadas no modelo.
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
**Retorna:** `BaseModelOutputWithAttentionMask` ou `tuple(torch.Tensor)`
Um `BaseModelOutputWithAttentionMask` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([UdopConfig](/docs/transformers/main/pt/model_doc/udop#transformers.UdopConfig)) e das entradas.
O método forward do [UdopEncoderModel](/docs/transformers/main/pt/model_doc/udop#transformers.UdopEncoderModel) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de hidden-states na saída da última camada do modelo. Se `past_key_values` for usado, apenas o último hidden-state das sequências, de forma `(batch_size, 1, hidden_size)`, é retornado.
- **attention_mask** (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) -- Máscara de atenção usada na passagem direta do modelo para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`:
- 1 para tokens que **não estão mascarados**,
- 0 para tokens que estão **mascarados**.
- **past_key_values** (`Cache`, *opcional*, retornado quando `use_cache=True` é passado ou quando `config.use_cache=True`) -- Trata-se de uma instância de [Cache](/docs/transformers/main/pt/internal/generation_utils#transformers.Cache). Para mais detalhes, consulte nosso [guia de cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e, opcionalmente, se `config.is_encoder_decoder=True`, nos blocos de atenção cruzada) que podem ser usados (veja a entrada `past_key_values`) para acelerar a decodificação sequencial.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`. Hidden-states do modelo na saída de cada camada, além das saídas iniciais opcionais de embedding.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`. Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
- **cross_attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` e `config.add_cross_attention=True` são passados ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`. Pesos de atenção da camada de cross-attention do decodificador, após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de cross-attention.
Exemplo:
```python
>>> from transformers import AutoProcessor, UdopEncoderModel
>>> from huggingface_hub import hf_hub_download
>>> from datasets import load_dataset
>>> # load model and processor
>>> # in this case, we already have performed OCR ourselves
>>> # so we initialize the processor with `apply_ocr=False`
>>> processor = AutoProcessor.from_pretrained("microsoft/udop-large", apply_ocr=False)
>>> model = UdopEncoderModel.from_pretrained("microsoft/udop-large")
>>> # load an example image, along with the words and coordinates
>>> # which were extracted using an OCR engine
>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> image = example["image"]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]
>>> encoding = processor(image, words, boxes=boxes, return_tensors="pt")
>>> outputs = model(**encoding)
>>> last_hidden_states = outputs.last_hidden_state
```