# ViTMAE
[ViTMAE](https://huggingface.co/papers/2111.06377) é um modelo de visão auto-supervisionado que é pré-treinado mascarando grandes porções de uma imagem (~75%). Um codificador processa os patches visíveis da imagem e um decodificador reconstrói os pixels ausentes a partir dos patches codificados e dos tokens de máscara. Após o pré-treinamento, o codificador pode ser reutilizado para tarefas de nível inferior, como classificação de imagens ou detecção de objetos — frequentemente superando modelos treinados com aprendizado supervisionado.
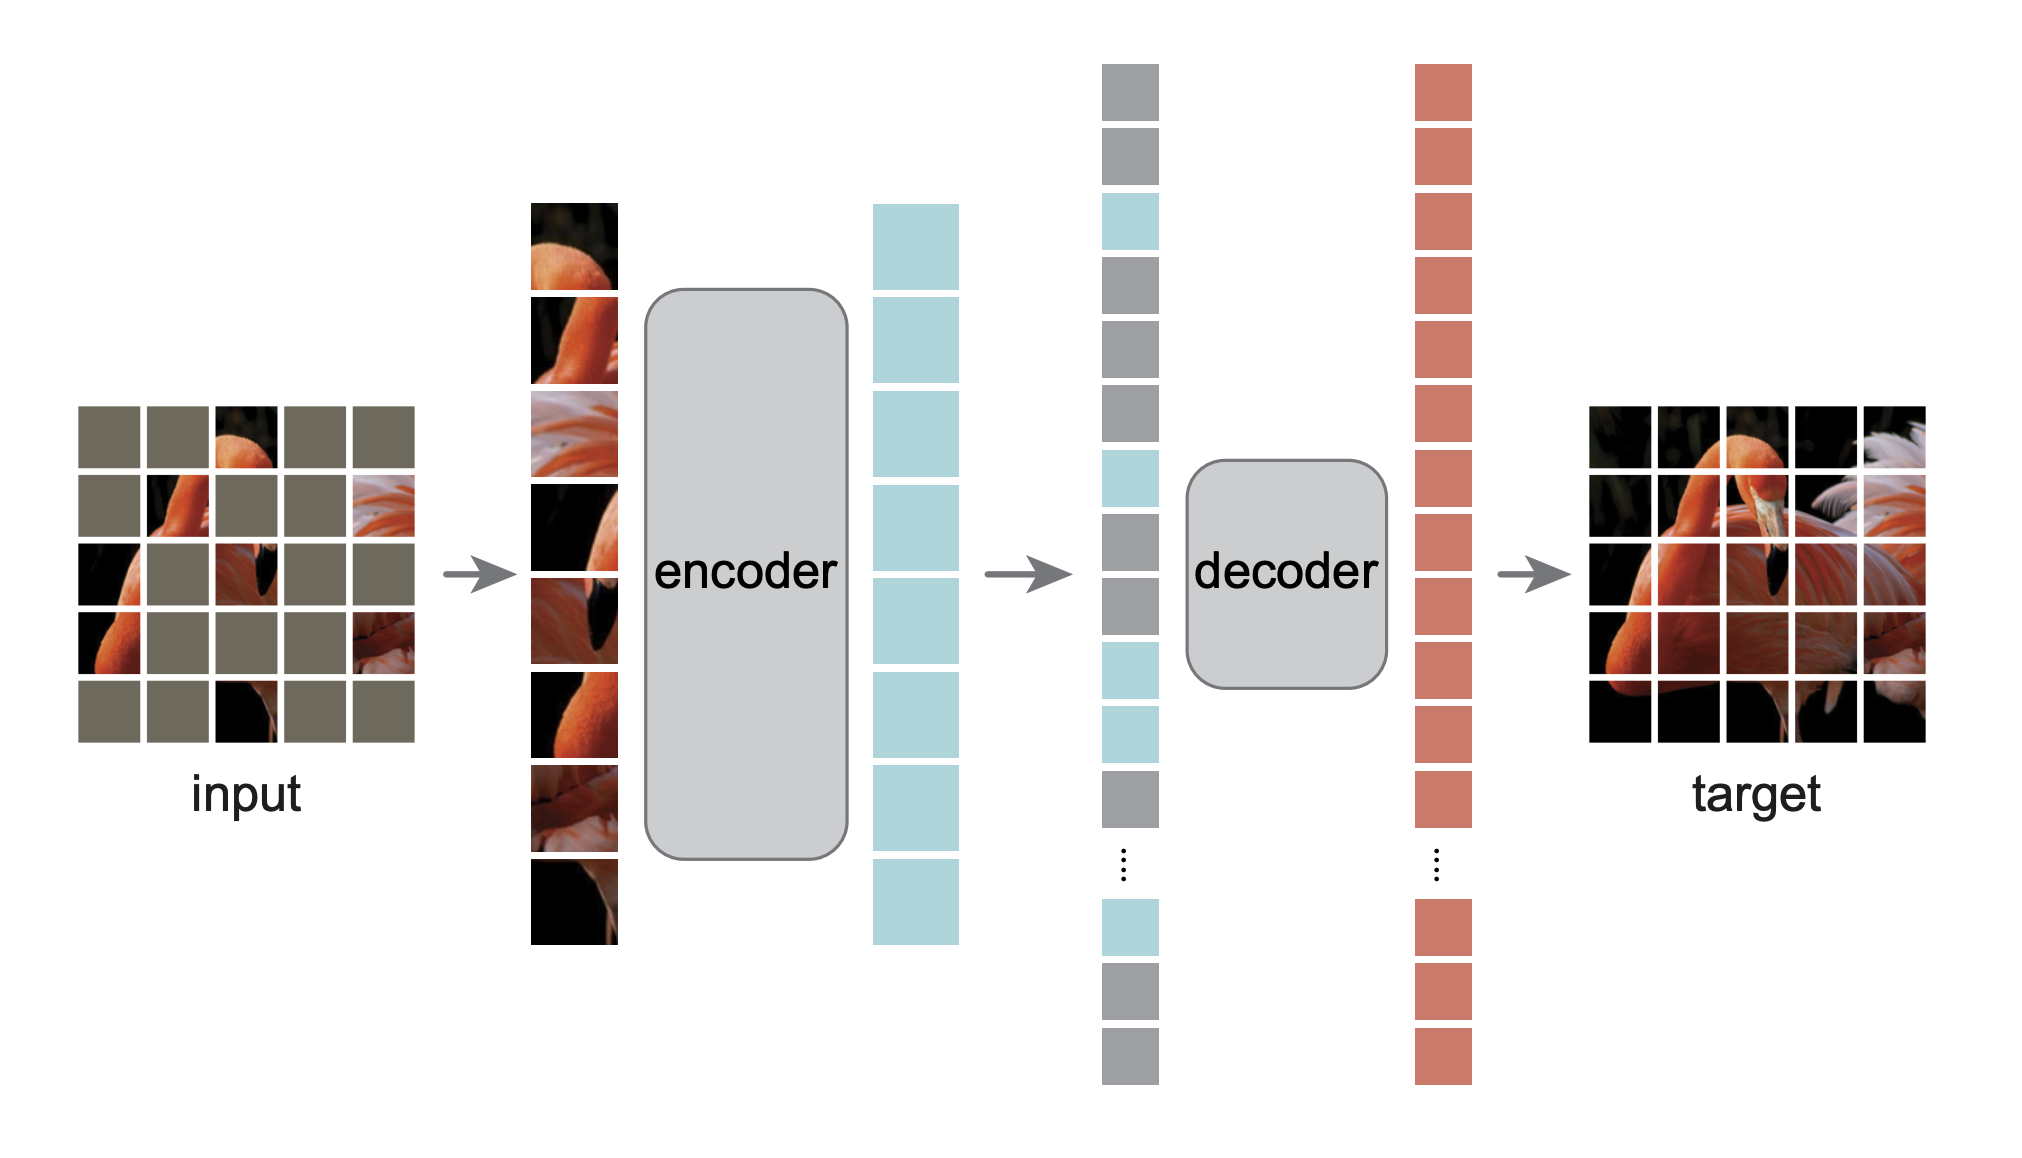 Você pode encontrar todos os checkpoints originais do ViTMAE na organização [AI at Meta](https://huggingface.co/facebook?search_models=vit-mae).
> [!TIP]
> Clique nos modelos ViTMAE na barra lateral à direita para ver mais exemplos de como aplicar o ViTMAE a tarefas de visão.
O exemplo abaixo demonstra como reconstruir os pixels ausentes com a classe [ViTMAEForPreTraining](/docs/transformers/main/pt/model_doc/vit_mae#transformers.ViTMAEForPreTraining).
```python
import requests
import torch
from PIL import Image
from transformers import ViTImageProcessor, ViTMAEForPreTraining
url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"
image = Image.open(requests.get(url, stream=True).raw)
processor = ViTImageProcessor.from_pretrained("facebook/vit-mae-base")
inputs = processor(image, return_tensors="pt").to(model.device)
inputs = {k: v.to(model.device) for k, v in inputs.items()}
model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base", attn_implementation="sdpa", device_map="auto")
with torch.no_grad():
outputs = model(**inputs)
reconstruction = outputs.logits
```
## Observações
- O ViTMAE é tipicamente utilizado em duas etapas. Primeiro, o pré-treinamento auto-supervisionado com [ViTMAEForPreTraining](/docs/transformers/main/pt/model_doc/vit_mae#transformers.ViTMAEForPreTraining) e, em seguida, o descarte do decodificador e o ajuste fino do codificador. Após o ajuste fino, os pesos podem ser inseridos em um modelo como [ViTForImageClassification](/docs/transformers/main/pt/model_doc/vit#transformers.ViTForImageClassification).
- Use [ViTImageProcessor](/docs/transformers/main/pt/model_doc/vit#transformers.ViTImageProcessor) para a preparação da entrada.
## Recursos
- Consulte este [notebook](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/ViTMAE/ViT_MAE_visualization_demo.ipynb) para aprender a visualizar os pixels reconstruídos a partir do [ViTMAEForPreTraining](/docs/transformers/main/pt/model_doc/vit_mae#transformers.ViTMAEForPreTraining).
## ViTMAEConfig[[transformers.ViTMAEConfig]]
#### transformers.ViTMAEConfig[[transformers.ViTMAEConfig]]
```python
transformers.ViTMAEConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, qkv_bias: bool = True, decoder_num_attention_heads: int = 16, decoder_hidden_size: int = 512, decoder_num_hidden_layers: int = 8, decoder_intermediate_size: int = 2048, mask_ratio: float = 0.75, norm_pix_loss: bool = False)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/configuration_vit_mae.py#L24)
**Parâmetros:**
hidden_size (`int`, *opcional*, padrão `768`) : Dimensão das representações ocultas.
num_hidden_layers (`int`, *opcional*, padrão `12`) : Número de camadas ocultas no decodificador do Transformer.
num_attention_heads (`int`, *opcional*, padrão `12`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
intermediate_size (`int`, *opcional*, padrão `3072`) : Dimensão das representações do MLP.
hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.0`) : A probabilidade de dropout para todas as camadas totalmente conectadas nos embeddings, no encoder e no pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.0`) : A taxa de dropout para as probabilidades de atenção.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
layer_norm_eps (`float`, *opcional*, padrão `1e-12`) : O epsilon usado pelas camadas de normalização de camada.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `224`) : O tamanho (resolução) de cada imagem.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, padrão `16`) : O tamanho (resolução) de cada patch.
num_channels (`int`, *opcional*, padrão `3`) : O número de canais de entrada.
qkv_bias (`bool`, *opcional*, padrão `True`) : Se deve adicionar um viés às queries, keys e values.
decoder_num_attention_heads (`int`, *opcional*, padrão `16`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
decoder_hidden_size (`int`, *opcional*, padrão `512`) : Dimensão das representações ocultas.
decoder_num_hidden_layers (`int`, *opcional*, padrão 8) : Número de camadas ocultas no decodificador.
decoder_intermediate_size (`int`, *opcional*, padrão `2048`) : Dimensão das representações do MLP.
mask_ratio (`float`, *opcional*, padrão 0.75) : A proporção do número de tokens mascarados na sequência de entrada.
norm_pix_loss (`bool`, *opcional*, padrão `False`) : Se deve ou não treinar com pixels normalizados (veja a Tabela 3 no artigo). O uso de pixels normalizados melhorou a qualidade da representação nos experimentos dos autores.
Esta é a classe de configuração para armazenar a configuração de um ViTMAEModel. Ela é usada para instanciar um modelo Vit Mae de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [facebook/vit-mae-base](https://huggingface.co/facebook/vit-mae-base)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import ViTMAEConfig, ViTMAEModel
>>> # Initializing a ViT MAE vit-mae-base style configuration
>>> configuration = ViTMAEConfig()
>>> # Initializing a model (with random weights) from the vit-mae-base style configuration
>>> model = ViTMAEModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ViTMAEModel[[transformers.ViTMAEModel]]
#### transformers.ViTMAEModel[[transformers.ViTMAEModel]]
```python
transformers.ViTMAEModel(config: ViTMAEConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/modeling_vit_mae.py#L614)
**Parâmetros:**
config ([ViTMAEConfig](/docs/transformers/main/pt/model_doc/vit_mae#transformers.ViTMAEConfig)) : Configuração do modelo.
O modelo Vit Mae básico que gera estados ocultos brutos, sem nenhum cabeçalho específico no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.ViTMAEModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, noise: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool | None = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/modeling_vit_mae.py#L628)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [ViTImageProcessor](/docs/transformers/main/pt/model_doc/vit#transformers.ViTImageProcessor). Consulte [ViTImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para obter detalhes (`processor_class` usa [ViTImageProcessor](/docs/transformers/main/pt/model_doc/vit#transformers.ViTImageProcessor) para processar imagens).
noise (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Usado principalmente para fins de teste, para controlar a aleatoriedade e manter a reprodutibilidade
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas. Isso é usado principalmente para utilizar o modelo em imagens de resolução mais alta.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
**Retorna:** `ViTMAEModelOutput` ou `tuple(torch.Tensor)`
Um `ViTMAEModelOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos, dependendo da configuração ([ViTMAEConfig](/docs/transformers/main/pt/model_doc/vit_mae#transformers.ViTMAEConfig)) e das entradas.
O método forward do [ViTMAEModel](/docs/transformers/main/pt/model_doc/vit_mae#transformers.ViTMAEModel) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) -- Sequência de hidden-states na saída da última camada do modelo.
- **mask** (`torch.Tensor` de forma `(batch_size, sequence_length)`) -- Tensor que indica quais patches estão mascarados (1) e quais não estão (0).
- **ids_restore** (`torch.LongTensor` de forma `(batch_size, sequence_length)`) -- Tensor contendo o índice original dos patches mascarados (embaralhados).
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> from transformers import AutoImageProcessor, ViTMAEModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEModel.from_pretrained("facebook/vit-mae-base")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
```
## ViTMAEForPreTraining[[transformers.ViTMAEForPreTraining]]
#### transformers.ViTMAEForPreTraining[[transformers.ViTMAEForPreTraining]]
```python
transformers.ViTMAEForPreTraining(config: ViTMAEConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/modeling_vit_mae.py#L691)
**Parâmetros:**
config ([ViTMAEConfig](/docs/transformers/main/pt/model_doc/vit_mae#transformers.ViTMAEConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. Inicializar com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O transformer do modelo ViTMAE com o decodificador no topo para pré-treinamento auto-supervisionado.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.ViTMAEForPreTraining.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, noise: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool | None = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/modeling_vit_mae.py#L790)
**Parâmetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando [ViTImageProcessor](/docs/transformers/main/pt/model_doc/vit#transformers.ViTImageProcessor). Consulte [ViTImageProcessor.__call__()](/docs/transformers/main/pt/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para obter detalhes (`processor_class` usa [ViTImageProcessor](/docs/transformers/main/pt/model_doc/vit#transformers.ViTImageProcessor) para processar imagens).
noise (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Usado principalmente para fins de teste, para controlar a aleatoriedade e manter a reprodutibilidade
interpolate_pos_encoding (`bool`, *opcional*, padrão `False`) : Se deve interpolar as codificações de posição pré-treinadas. Isso é usado principalmente para utilizar o modelo em imagens de resolução mais alta.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
**Retorna:** `ViTMAEForPreTrainingOutput` ou `tuple(torch.Tensor)`
Um `ViTMAEForPreTrainingOutput` ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([ViTMAEConfig](/docs/transformers/main/pt/model_doc/vit_mae#transformers.ViTMAEConfig)) e das entradas.
O método forward de [ViTMAEForPreTraining](/docs/transformers/main/pt/model_doc/vit_mae#transformers.ViTMAEForPreTraining) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`) -- Perda de reconstrução de pixels.
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, patch_size ** 2 * num_channels)`) -- Logits de reconstrução de pixels.
- **mask** (`torch.Tensor` de forma `(batch_size, sequence_length)`) -- Tensor que indica quais patches estão mascarados (1) e quais não estão (0).
- **ids_restore** (`torch.LongTensor` de forma `(batch_size, sequence_length)`) -- Tensor contendo o índice original dos patches mascarados (embaralhados).
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple[torch.Tensor]`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplos:
```python
>>> from transformers import AutoImageProcessor, ViTMAEForPreTraining
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> loss = outputs.loss
>>> mask = outputs.mask
>>> ids_restore = outputs.ids_restore
```