# YOSO
## Visão geral
O modelo YOSO foi proposto em [You Only Sample (Almost) Once: Linear Cost Self-Attention Via Bernoulli Sampling](https://huggingface.co/papers/2111.09714) por Zhanpeng Zeng, Yunyang Xiong, Sathya N. Ravi, Shailesh Acharya, Glenn Fung, Vikas Singh. O YOSO aproxima o self-attention softmax padrão por meio de um esquema de amostragem de Bernoulli baseado em Locality Sensitive Hashing (LSH). Em princípio, todas as variáveis aleatórias de Bernoulli podem ser amostradas com um único hash.
O resumo do artigo é o seguinte:
*Modelos baseados em Transformer são amplamente utilizados no processamento de linguagem natural (NLP). Central para o modelo Transformer está o mecanismo de autoatenção, que captura as interações dos pares de tokens nas sequências de entrada e depende quadraticamente do comprimento da sequência. Treinar esses modelos em sequências mais longas é caro. Neste artigo, mostramos que um mecanismo de amostragem de atenção baseado em Bernoulli, fundamentado em Locality Sensitive Hashing (LSH), reduz a complexidade quadrática desses modelos para linear. Contornamos o custo quadrático ao considerar a autoatenção como uma soma de tokens individuais associados a variáveis aleatórias de Bernoulli que, em princípio, podem ser amostradas de uma vez por um único hash (embora, na prática, esse número possa ser uma constante pequena). Isso leva a um esquema de amostragem eficiente para estimar a autoatenção, que depende de modificações específicas do LSH (para permitir a implantação em arquiteturas de GPU). Avaliamos nosso algoritmo no benchmark GLUE com o comprimento de sequência padrão de 512, onde observamos desempenho favorável em relação a um Transformer pré-treinado padrão. No benchmark Long Range Arena (LRA), para avaliar o desempenho em sequências longas, nosso método alcança resultados consistentes com a autoatenção softmax, mas com acelerações significativas e economias de memória, e frequentemente supera outros métodos eficientes de autoatenção. Nosso código está disponível neste https URL*
Este modelo foi contribuído por [novice03](https://huggingface.co/novice03). O código original pode ser encontrado [aqui](https://github.com/mlpen/YOSO).
## Dicas de uso
- O algoritmo de atenção YOSO é implementado por meio de kernels CUDA personalizados, funções escritas em CUDA C++ que podem ser executadas várias vezes
em paralelo em uma GPU.
- Os kernels fornecem uma função `fast_hash`, que aproxima as projeções aleatórias das queries e das keys usando a Fast Hadamard Transform. Usando esses
códigos de hash, a função `lsh_cumulation` aproxima a autoatenção por meio de amostragem de Bernoulli baseada em LSH.
- Para usar os kernels personalizados, o usuário deve definir `config.use_expectation = False`. Para garantir que os kernels sejam compilados com sucesso,
o usuário deve instalar a versão correta do PyTorch e do cudatoolkit. Por padrão, `config.use_expectation = True`, o que usa YOSO-E e não requer a compilação de kernels CUDA.
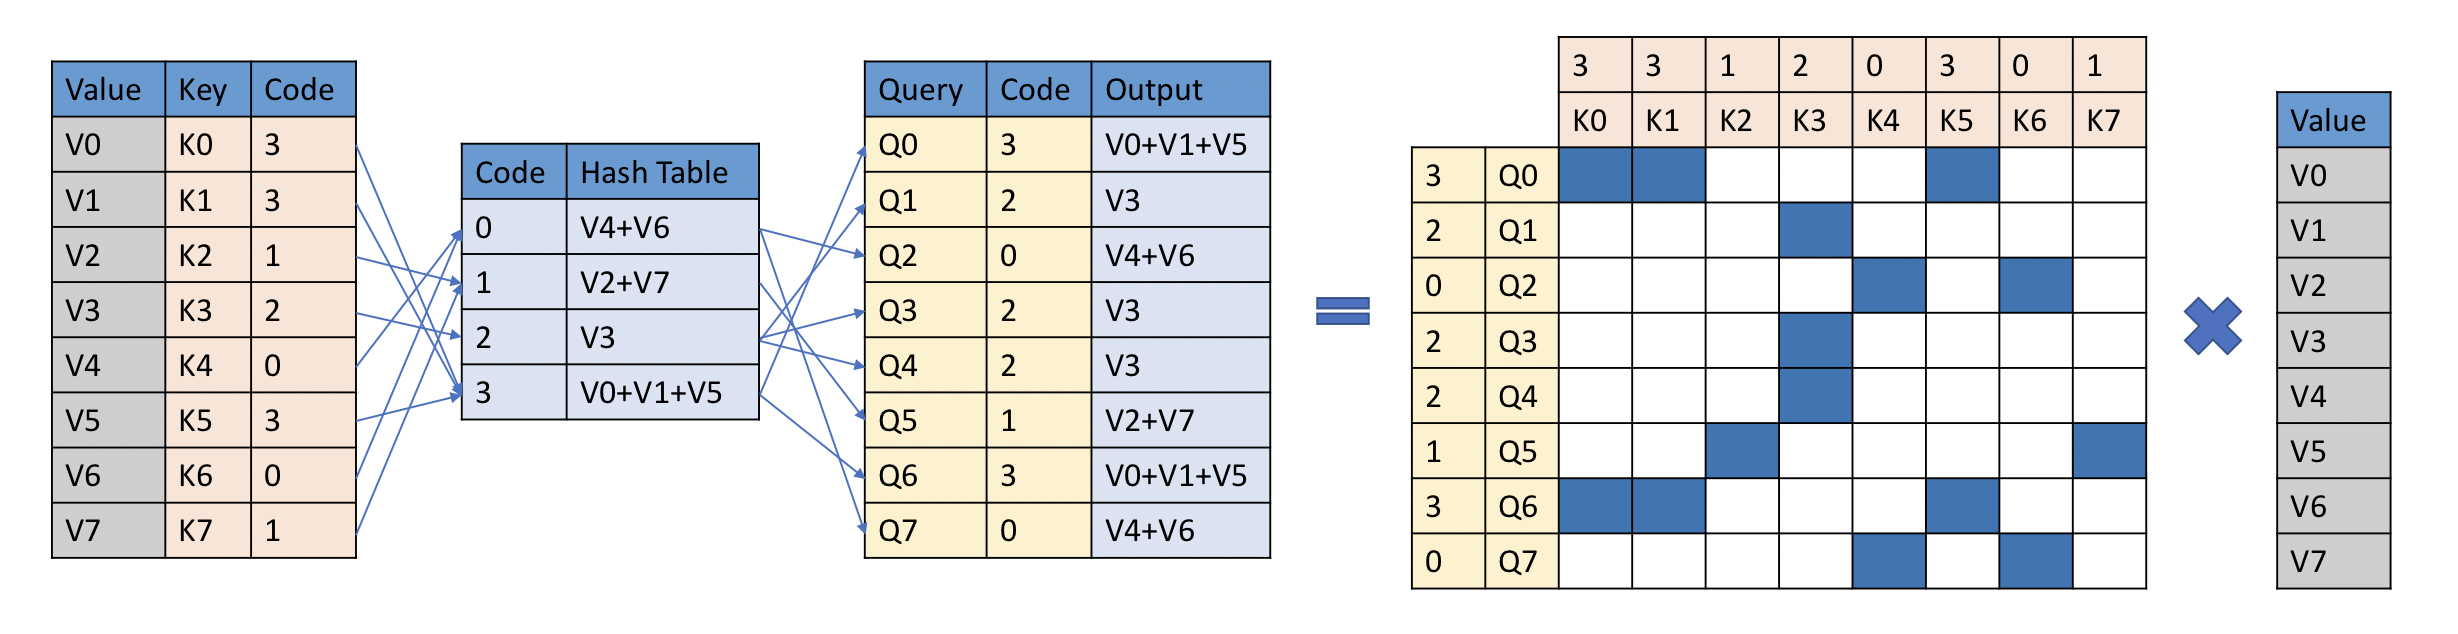 Algoritmo de Atenção YOSO. Retirado do artigo original.
## Recursos
- [Guia da tarefa de classificação de texto](../tasks/sequence_classification)
- [Guia de tarefas de classificação de tokens](../tasks/token_classification)
- [Guia da tarefa de resposta a perguntas](../tasks/question_answering)
- [Guia da tarefa de modelagem de linguagem mascarada](../tasks/masked_language_modeling)
- [Guia de tarefas de múltipla escolha](../tasks/multiple_choice)
## YosoConfig[[transformers.YosoConfig]]
#### transformers.YosoConfig[[transformers.YosoConfig]]
```python
transformers.YosoConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 50265, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 4096, type_vocab_size: int = 1, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, use_expectation: bool = True, hash_code_len: int = 9, num_hash: int = 64, conv_window: int | None = None, use_fast_hash: bool = True, lsh_backward: bool = True, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, add_cross_attention: bool = False, tie_word_embeddings: bool = True)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/configuration_yoso.py#L24)
**Parâmetros:**
vocab_size (`int`, *opcional*, padrão `50265`) : Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelos `input_ids`.
hidden_size (`int`, *opcional*, padrão `768`) : Dimensão das representações ocultas.
num_hidden_layers (`int`, *opcional*, padrão `12`) : Número de camadas ocultas no decodificador do Transformer.
num_attention_heads (`int`, *opcional*, padrão `12`) : Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer.
intermediate_size (`int`, *opcional*, padrão `3072`) : Dimensão das representações do MLP.
hidden_act (`str`, *opcional*, padrão `gelu`) : A função de ativação não linear (função ou string) no decodificador. Por exemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.1`) : A probabilidade de dropout para todas as camadas totalmente conectadas nos embeddings, encoder e pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, padrão `0.1`) : A taxa de dropout para as probabilidades de atenção.
max_position_embeddings (`int`, *opcional*, padrão `4096`) : O comprimento máximo de sequência com o qual este modelo pode ser utilizado.
type_vocab_size (`int`, *opcional*, padrão `1`) : O tamanho do vocabulário dos `token_type_ids`.
initializer_range (`float`, *opcional*, padrão `0.02`) : O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos.
layer_norm_eps (`float`, *opcional*, padrão `1e-12`) : O epsilon usado pelas camadas de normalização de camada.
use_expectation (`bool`, *opcional*, padrão `True`) : Indica se deve ou não usar a Expectação YOSO. Sobrescreve qualquer efeito de num_hash.
hash_code_len (`int`, *opcional*, padrão 9) : O comprimento dos hashes gerados pelas funções de hash.
num_hash (`int`, *opcional*, padrão 64) : Número de funções de hash usadas em `YosoSelfAttention`.
conv_window (`int`, *opcional*) : Tamanho do kernel da convolução depth-wise.
use_fast_hash (`bool`, *opcional*, padrão `False`) : Se deve ou não usar kernels cuda personalizados que realizam projeção aleatória rápida via transformada de hadamard.
lsh_backward (`bool`, *opcional*, padrão `True`) : Se deve ou não executar a retropropagação usando Locality Sensitive Hashing.
pad_token_id (`int`, *opcional*, padrão `1`) : ID do token usado para preenchimento no vocabulário.
bos_token_id (`int`, *opcional*, padrão `0`) : ID do token usado para o início do fluxo no vocabulário.
eos_token_id (`Union[int, list[int]]`, *opcional*, padrão `2`) : ID do token usado para o fim do fluxo no vocabulário.
add_cross_attention (`bool`, *opcional*, padrão `False`) : Se as camadas de atenção cruzada devem ser adicionadas ao modelo.
tie_word_embeddings (`bool`, *opcional*, padrão `True`) : Se deve vincular as embeddings de pesos de acordo com o mapeamento `tied_weights_keys` do modelo.
Esta é a classe de configuração para armazenar a configuração de um YosoModel. Ela é usada para instanciar um modelo Yoso de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do [uw-madison/yoso-4096](https://huggingface.co/uw-madison/yoso-4096)
Os objetos de configuração herdam de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) e podem ser usados para controlar as saídas do modelo. Leia a documentação de [PreTrainedConfig](/docs/transformers/main/pt/main_classes/configuration#transformers.PreTrainedConfig) para mais informações.
Exemplo:
```python
>>> from transformers import YosoConfig, YosoModel
>>> # Initializing a YOSO uw-madison/yoso-4096 style configuration
>>> configuration = YosoConfig()
>>> # Initializing a model (with random weights) from the uw-madison/yoso-4096 style configuration
>>> model = YosoModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## YosoModel[[transformers.YosoModel]]
#### transformers.YosoModel[[transformers.YosoModel]]
```python
transformers.YosoModel(config: YosoConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L616)
**Parâmetros:**
config ([YosoConfig](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O modelo Yoso puro, que produz estados ocultos brutos sem nenhum cabeçalho específico no topo.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.YosoModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L633)
**Parâmetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em `[0, 1]`: - 0 corresponde a um token de *frase A*, - 1 corresponde a um token de *frase B*. [O que são IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** [BaseModelOutputWithCrossAttentions](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithCrossAttentions) ou `tuple(torch.Tensor)`
Um [BaseModelOutputWithCrossAttentions](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithCrossAttentions) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([YosoConfig](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoConfig)) e das entradas.
O método forward do [YosoModel](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoModel) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Sequência de estados ocultos na saída da última camada do modelo.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
- **cross_attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` e `config.add_cross_attention=True` são passados, ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (uma para cada camada) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção da camada de atenção cruzada do decodificador, após o softmax de atenção, usados para calcular a média ponderada nas cabeças de atenção cruzada.
## YosoForMaskedLM[[transformers.YosoForMaskedLM]]
#### transformers.YosoForMaskedLM[[transformers.YosoForMaskedLM]]
```python
transformers.YosoForMaskedLM(config: YosoConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L703)
**Parâmetros:**
config ([YosoConfig](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O Modelo Yoso com uma cabeça de `language modeling` no topo."
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.YosoForMaskedLM.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L725)
**Parâmetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em `[0, 1]`: - 0 corresponde a um token de *frase A*, - 1 corresponde a um token de *frase B*. [O que são IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
labels (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Rótulos para calcular a perda de modelagem de linguagem mascarada. Os índices devem estar em `[-100, 0, ..., config.vocab_size]` (veja a docstring de `input_ids`). Tokens com índices definidos como `-100` são ignorados (mascarados); a perda é calculada apenas para os tokens com rótulos em `[0, ..., config.vocab_size]`.
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** [MaskedLMOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) ou `tuple(torch.Tensor)`
Um [MaskedLMOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([YosoConfig](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoConfig)) e das entradas.
O método forward de [YosoForMaskedLM](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoForMaskedLM) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de modelagem de linguagem mascarada (MLM).
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplo:
```python
>>> from transformers import AutoTokenizer, YosoForMaskedLM
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForMaskedLM.from_pretrained("uw-madison/yoso-4096")
>>> inputs = tokenizer("The capital of France is .", return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # retrieve index of
>>> mask_token_index = (inputs.input_ids == tokenizer.mask_token_id)[0].nonzero(as_tuple=True)[0]
>>> predicted_token_id = logits[0, mask_token_index].argmax(axis=-1)
>>> tokenizer.decode(predicted_token_id)
...
>>> labels = tokenizer("The capital of France is Paris.", return_tensors="pt")["input_ids"]
>>> # mask labels of non- tokens
>>> labels = torch.where(inputs.input_ids == tokenizer.mask_token_id, labels, -100)
>>> outputs = model(**inputs, labels=labels)
>>> round(outputs.loss.item(), 2)
...
```
## YosoForSequenceClassification[[transformers.YosoForSequenceClassification]]
#### transformers.YosoForSequenceClassification[[transformers.YosoForSequenceClassification]]
```python
transformers.YosoForSequenceClassification(config: YosoConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L799)
**Parâmetros:**
config ([YosoConfig](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
Modelo transformer YOSO com uma cabeça de classificação/regressão de sequência no topo (uma camada linear no topo da saída agregada), por exemplo, para tarefas GLUE.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.YosoForSequenceClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L809)
**Parâmetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em `[0, 1]`: - 0 corresponde a um token de *frase A*, - 1 corresponde a um token de *frase B*. [O que são IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para o cálculo da perda de classificação/regressão de sequência. Os índices devem estar em `[0, ..., config.num_labels - 1]`. Se `config.num_labels == 1`, uma perda de regressão é calculada (perda de erro quadrático médio). Se `config.num_labels > 1`, uma perda de classificação é calculada (entropia cruzada).
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** [SequenceClassifierOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) ou `tuple(torch.Tensor)`
Um [SequenceClassifierOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([YosoConfig](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoConfig)) e das entradas.
O método forward de [YosoForSequenceClassification](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoForSequenceClassification) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação (ou de regressão se config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplo de classificação de rótulo único:
```python
>>> import torch
>>> from transformers import AutoTokenizer, YosoForSequenceClassification
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForSequenceClassification.from_pretrained("uw-madison/yoso-4096")
>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_class_id = logits.argmax().item()
>>> model.config.id2label[predicted_class_id]
...
>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = YosoForSequenceClassification.from_pretrained("uw-madison/yoso-4096", num_labels=num_labels)
>>> labels = torch.tensor([1])
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
```
Exemplo de classificação multirótulo:
```python
>>> import torch
>>> from transformers import AutoTokenizer, YosoForSequenceClassification
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForSequenceClassification.from_pretrained("uw-madison/yoso-4096", problem_type="multi_label_classification")
>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_class_ids = torch.arange(0, logits.shape[-1])[torch.sigmoid(logits).squeeze(dim=0) > 0.5]
>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = YosoForSequenceClassification.from_pretrained(
... "uw-madison/yoso-4096", num_labels=num_labels, problem_type="multi_label_classification"
... )
>>> labels = torch.sum(
... torch.nn.functional.one_hot(predicted_class_ids[None, :].clone(), num_classes=num_labels), dim=1
... ).to(torch.float)
>>> loss = model(**inputs, labels=labels).loss
```
## YosoForMultipleChoice[[transformers.YosoForMultipleChoice]]
#### transformers.YosoForMultipleChoice[[transformers.YosoForMultipleChoice]]
```python
transformers.YosoForMultipleChoice(config: YosoConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L874)
**Parâmetros:**
config ([YosoConfig](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O Modelo Yoso com uma cabeça de classificação de múltipla escolha no topo (uma camada linear no topo da saída agregada e um softmax), por exemplo, para as tarefas RocStories/SWAG.
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.YosoForMultipleChoice.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L885)
**Parâmetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, num_choices, sequence_length)`) : Índices dos tokens da sequência de entrada no vocabulário. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` de forma `(batch_size, num_choices, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em `[0, 1]`: - 0 corresponde a um token de *frase A*, - 1 corresponde a um token de *frase B*. [O que são IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.LongTensor` de forma `(batch_size, num_choices, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.max_position_embeddings - 1]`. [O que são IDs de posição?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, num_choices, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação de embedding. Isso é útil se você quiser ter mais controle sobre como converter os índices de *input_ids* em vetores associados do que a matriz de busca de embedding interna do modelo.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Rótulos para calcular a perda de classificação de múltipla escolha. Os índices devem estar em `[0, ..., num_choices-1]`, onde `num_choices` é o tamanho da segunda dimensão dos tensores de entrada. (Veja `input_ids` acima)
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** [MultipleChoiceModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.MultipleChoiceModelOutput) ou `tuple(torch.Tensor)`
Um [MultipleChoiceModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.MultipleChoiceModelOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([YosoConfig](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoConfig)) e das entradas.
O método forward de [YosoForMultipleChoice](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoForMultipleChoice) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma *(1,)*, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação.
- **logits** (`torch.Tensor` de forma `(batch_size, num_choices)`) -- *num_choices* é a segunda dimensão dos tensors de entrada. (veja *input_ids* acima).
Pontuações de classificação (antes do SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplo:
```python
>>> from transformers import AutoTokenizer, YosoForMultipleChoice
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForMultipleChoice.from_pretrained("uw-madison/yoso-4096")
>>> prompt = "In Italy, pizza served in formal settings, such as at a restaurant, is presented unsliced."
>>> choice0 = "It is eaten with a fork and a knife."
>>> choice1 = "It is eaten while held in the hand."
>>> labels = torch.tensor(0).unsqueeze(0) # choice0 is correct (according to Wikipedia ;)), batch size 1
>>> encoding = tokenizer([prompt, prompt], [choice0, choice1], return_tensors="pt", padding=True)
>>> outputs = model(**{k: v.unsqueeze(0) for k, v in encoding.items()}, labels=labels) # batch size is 1
>>> # the linear classifier still needs to be trained
>>> loss = outputs.loss
>>> logits = outputs.logits
```
## YosoForTokenClassification[[transformers.YosoForTokenClassification]]
#### transformers.YosoForTokenClassification[[transformers.YosoForTokenClassification]]
```python
transformers.YosoForTokenClassification(config: YosoConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L975)
**Parâmetros:**
config ([YosoConfig](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O transformador Yoso com uma cabeça de classificação de tokens no topo (uma camada linear no topo da saída dos estados ocultos), por exemplo, para tarefas de Reconhecimento de Entidades Nomeadas (NER).
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.YosoForTokenClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L987)
**Parâmetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em `[0, 1]`: - 0 corresponde a um token de *frase A*, - 1 corresponde a um token de *frase B*. [O que são IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
labels (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Rótulos para calcular a perda de classificação de tokens. Os índices devem estar em `[0, ..., config.num_labels - 1]`.
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** [TokenClassifierOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.TokenClassifierOutput) ou `tuple(torch.Tensor)`
Um [TokenClassifierOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.TokenClassifierOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([YosoConfig](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoConfig)) e das entradas.
O método forward de [YosoForTokenClassification](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoForTokenClassification) sobrescreve o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecido) -- Perda de classificação.
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.num_labels)`) -- Pontuações de classificação (antes do SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplo:
```python
>>> from transformers import AutoTokenizer, YosoForTokenClassification
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForTokenClassification.from_pretrained("uw-madison/yoso-4096")
>>> inputs = tokenizer(
... "HuggingFace is a company based in Paris and New York", add_special_tokens=False, return_tensors="pt"
... )
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_token_class_ids = logits.argmax(-1)
>>> # Note that tokens are classified rather then input words which means that
>>> # there might be more predicted token classes than words.
>>> # Multiple token classes might account for the same word
>>> predicted_tokens_classes = [model.config.id2label[t.item()] for t in predicted_token_class_ids[0]]
>>> predicted_tokens_classes
...
>>> labels = predicted_token_class_ids
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
```
## YosoForQuestionAnswering[[transformers.YosoForQuestionAnswering]]
#### transformers.YosoForQuestionAnswering[[transformers.YosoForQuestionAnswering]]
```python
transformers.YosoForQuestionAnswering(config: YosoConfig)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L1046)
**Parâmetros:**
config ([YosoConfig](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoConfig)) : Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método [from_pretrained()](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel.from_pretrained) para carregar os pesos do modelo.
O transformador Yoso com uma cabeça de classificação de spans no topo para tarefas de question-answering extrativo como SQuAD (uma camada linear no topo da saída dos hidden-states para calcular `span start logits` e `span end logits`).
Este modelo herda de [PreTrainedModel](/docs/transformers/main/pt/main_classes/model#transformers.PreTrainedModel). Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.).
Este modelo também é uma subclasse de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso e comportamento gerais.
#### forward[[transformers.YosoForQuestionAnswering.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, start_positions: typing.Optional[torch.Tensor] = None, end_positions: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Origem](https://github.com/huggingface/transformers/blob/main/src/transformers/models/yoso/modeling_yoso.py#L1059)
**Parâmetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão. Os índices podem ser obtidos usando [AutoTokenizer](/docs/transformers/main/pt/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) e [PreTrainedTokenizer.__call__()](/docs/transformers/main/pt/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para mais detalhes. [O que são IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em `[0, 1]`: - 1 para tokens que **não estão mascarados**, - 0 para tokens que **estão mascarados**. [O que são máscaras de atenção?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar as primeiras e segundas partes das entradas. Os índices são selecionados em `[0, 1]`: - 0 corresponde a um token de *frase A*, - 1 corresponde a um token de *frase B*. [O que são IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo `[0, config.n_positions - 1]`. [O que são IDs de posição?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, em vez de passar `input_ids`, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices de `input_ids` nos vetores associados do que a matriz de busca de incorporação interna do modelo.
start_positions (`torch.Tensor` de forma `(batch_size,)`, *opcional*) : Rótulos para a posição (índice) do início do trecho rotulado para o cálculo da perda de classificação de tokens. As posições são limitadas ao comprimento da sequência (`sequence_length`). Posições fora da sequência não são consideradas no cálculo da perda.
end_positions (`torch.Tensor` de forma `(batch_size,)`, *opcional*) : Rótulos para a posição (índice) do final do trecho rotulado para o cálculo da perda de classificação de tokens. As posições são limitadas ao comprimento da sequência (`sequence_length`). Posições fora da sequência não são consideradas no cálculo da perda.
output_attentions (`bool`, *opcional*) : Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulte `attentions` nos tensores retornados para mais detalhes.
output_hidden_states (`bool`, *opcional*) : Indica se os estados ocultos de todas as camadas devem ser retornados. Consulte `hidden_states` em tensores retornados para mais detalhes.
return_dict (`bool`, *opcional*) : Se deve ou não retornar um [ModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.utils.ModelOutput) em vez de uma tupla simples.
**Retorna:** [QuestionAnsweringModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) ou `tuple(torch.Tensor)`
Um [QuestionAnsweringModelOutput](/docs/transformers/main/pt/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) ou uma tupla de `torch.Tensor` (se `return_dict=False` for passado ou quando `config.return_dict=False`) contendo vários elementos dependendo da configuração ([YosoConfig](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoConfig)) e das entradas.
O método forward de [YosoForQuestionAnswering](/docs/transformers/main/pt/model_doc/yoso#transformers.YosoForQuestionAnswering) substitui o método especial `__call__`.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de `Module` em seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, retornado quando `labels` é fornecida) -- A perda total de extração de spans é a soma de uma Cross-Entropy para as posições de início e fim.
- **start_logits** (`torch.Tensor` de forma `(batch_size, sequence_length)`) -- Pontuações de início de span (antes do SoftMax).
- **end_logits** (`torch.Tensor` de forma `(batch_size, sequence_length)`) -- Pontuações de fim de span (antes do SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_hidden_states=True` é passado ou quando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com a forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, retornado quando `output_attentions=True` é passado ou quando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (um para cada camada) com a forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nas cabeças de autoatenção.
Exemplo:
```python
>>> from transformers import AutoTokenizer, YosoForQuestionAnswering
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForQuestionAnswering.from_pretrained("uw-madison/yoso-4096")
>>> question, text = "Who was Jim Henson?", "Jim Henson was a nice puppet"
>>> inputs = tokenizer(question, text, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> answer_start_index = outputs.start_logits.argmax()
>>> answer_end_index = outputs.end_logits.argmax()
>>> predict_answer_tokens = inputs.input_ids[0, answer_start_index : answer_end_index + 1]
>>> tokenizer.decode(predict_answer_tokens, skip_special_tokens=True)
...
>>> # target is "nice puppet"
>>> target_start_index = torch.tensor([14])
>>> target_end_index = torch.tensor([15])
>>> outputs = model(**inputs, start_positions=target_start_index, end_positions=target_end_index)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
...
```