
Upload folder using huggingface_hub
Browse files- .gitattributes +59 -0
- README.md +45 -0
- Russian Speech Recognition Dataset.csv +7 -0
.gitattributes
ADDED
|
@@ -0,0 +1,59 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
*.7z filter=lfs diff=lfs merge=lfs -text
|
| 2 |
+
*.arrow filter=lfs diff=lfs merge=lfs -text
|
| 3 |
+
*.bin filter=lfs diff=lfs merge=lfs -text
|
| 4 |
+
*.bz2 filter=lfs diff=lfs merge=lfs -text
|
| 5 |
+
*.ckpt filter=lfs diff=lfs merge=lfs -text
|
| 6 |
+
*.ftz filter=lfs diff=lfs merge=lfs -text
|
| 7 |
+
*.gz filter=lfs diff=lfs merge=lfs -text
|
| 8 |
+
*.h5 filter=lfs diff=lfs merge=lfs -text
|
| 9 |
+
*.joblib filter=lfs diff=lfs merge=lfs -text
|
| 10 |
+
*.lfs.* filter=lfs diff=lfs merge=lfs -text
|
| 11 |
+
*.lz4 filter=lfs diff=lfs merge=lfs -text
|
| 12 |
+
*.mds filter=lfs diff=lfs merge=lfs -text
|
| 13 |
+
*.mlmodel filter=lfs diff=lfs merge=lfs -text
|
| 14 |
+
*.model filter=lfs diff=lfs merge=lfs -text
|
| 15 |
+
*.msgpack filter=lfs diff=lfs merge=lfs -text
|
| 16 |
+
*.npy filter=lfs diff=lfs merge=lfs -text
|
| 17 |
+
*.npz filter=lfs diff=lfs merge=lfs -text
|
| 18 |
+
*.onnx filter=lfs diff=lfs merge=lfs -text
|
| 19 |
+
*.ot filter=lfs diff=lfs merge=lfs -text
|
| 20 |
+
*.parquet filter=lfs diff=lfs merge=lfs -text
|
| 21 |
+
*.pb filter=lfs diff=lfs merge=lfs -text
|
| 22 |
+
*.pickle filter=lfs diff=lfs merge=lfs -text
|
| 23 |
+
*.pkl filter=lfs diff=lfs merge=lfs -text
|
| 24 |
+
*.pt filter=lfs diff=lfs merge=lfs -text
|
| 25 |
+
*.pth filter=lfs diff=lfs merge=lfs -text
|
| 26 |
+
*.rar filter=lfs diff=lfs merge=lfs -text
|
| 27 |
+
*.safetensors filter=lfs diff=lfs merge=lfs -text
|
| 28 |
+
saved_model/**/* filter=lfs diff=lfs merge=lfs -text
|
| 29 |
+
*.tar.* filter=lfs diff=lfs merge=lfs -text
|
| 30 |
+
*.tar filter=lfs diff=lfs merge=lfs -text
|
| 31 |
+
*.tflite filter=lfs diff=lfs merge=lfs -text
|
| 32 |
+
*.tgz filter=lfs diff=lfs merge=lfs -text
|
| 33 |
+
*.wasm filter=lfs diff=lfs merge=lfs -text
|
| 34 |
+
*.xz filter=lfs diff=lfs merge=lfs -text
|
| 35 |
+
*.zip filter=lfs diff=lfs merge=lfs -text
|
| 36 |
+
*.zst filter=lfs diff=lfs merge=lfs -text
|
| 37 |
+
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
| 38 |
+
# Audio files - uncompressed
|
| 39 |
+
*.pcm filter=lfs diff=lfs merge=lfs -text
|
| 40 |
+
*.sam filter=lfs diff=lfs merge=lfs -text
|
| 41 |
+
*.raw filter=lfs diff=lfs merge=lfs -text
|
| 42 |
+
# Audio files - compressed
|
| 43 |
+
*.aac filter=lfs diff=lfs merge=lfs -text
|
| 44 |
+
*.flac filter=lfs diff=lfs merge=lfs -text
|
| 45 |
+
*.mp3 filter=lfs diff=lfs merge=lfs -text
|
| 46 |
+
*.ogg filter=lfs diff=lfs merge=lfs -text
|
| 47 |
+
*.wav filter=lfs diff=lfs merge=lfs -text
|
| 48 |
+
# Image files - uncompressed
|
| 49 |
+
*.bmp filter=lfs diff=lfs merge=lfs -text
|
| 50 |
+
*.gif filter=lfs diff=lfs merge=lfs -text
|
| 51 |
+
*.png filter=lfs diff=lfs merge=lfs -text
|
| 52 |
+
*.tiff filter=lfs diff=lfs merge=lfs -text
|
| 53 |
+
# Image files - compressed
|
| 54 |
+
*.jpg filter=lfs diff=lfs merge=lfs -text
|
| 55 |
+
*.jpeg filter=lfs diff=lfs merge=lfs -text
|
| 56 |
+
*.webp filter=lfs diff=lfs merge=lfs -text
|
| 57 |
+
# Video files - compressed
|
| 58 |
+
*.mp4 filter=lfs diff=lfs merge=lfs -text
|
| 59 |
+
*.webm filter=lfs diff=lfs merge=lfs -text
|
README.md
ADDED
|
@@ -0,0 +1,45 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
---
|
| 2 |
+
license: cc-by-nc-nd-4.0
|
| 3 |
+
tags:
|
| 4 |
+
- speech recognition
|
| 5 |
+
- machine learning
|
| 6 |
+
- NLP
|
| 7 |
+
- ASR
|
| 8 |
+
- audio
|
| 9 |
+
- speech
|
| 10 |
+
size_categories:
|
| 11 |
+
- 1K<n<10K
|
| 12 |
+
---
|
| 13 |
+
# Russian Speech Dataset for recognition task
|
| 14 |
+
|
| 15 |
+
Dataset comprises **338** hours of telephone dialogues in Russian, collected from **460** native speakers across various topics and domains, with an impressive **98%** Word Accuracy Rate. It is designed for research in **speech recognition**, focusing on various **recognition models**, primarily aimed at meeting the requirements for **automatic speech recognition (ASR)** systems.
|
| 16 |
+
|
| 17 |
+
By utilizing this dataset, researchers and developers can advance their understanding and capabilities in **automatic speech recognition** (ASR) systems, **transcribing audio**, and **natural language processing** (NLP). - **[Get the data](https://unidata.pro/datasets/russian-speech-recognition-dataset/?utm_source=huggingface&utm_medium=referral&utm_campaign=russian-speech-recognition-dataset)**
|
| 18 |
+
|
| 19 |
+
|
| 20 |
+
# 💵 Buy the Dataset: This is a limited preview of the data. To access the full dataset, please contact us at [https://unidata.pro](https://unidata.pro/datasets/russian-speech-recognition-dataset/?utm_source=huggingface&utm_medium=referral&utm_campaign=russian-speech-recognition-dataset) to discuss your requirements and pricing options.
|
| 21 |
+
|
| 22 |
+
## Metadata for the dataset
|
| 23 |
+
|
| 24 |
+
- **Audio files:** High-quality recordings in **WAV** format
|
| 25 |
+
- **Text transcriptions:** Accurate and detailed **transcripts** for each audio segment
|
| 26 |
+
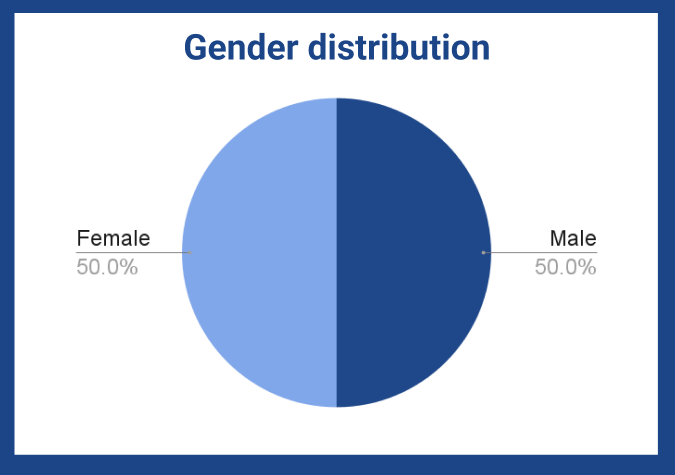
- **Speaker information:** Metadata on **native speakers**, including **gender** and etc
|
| 27 |
+
- **Topics:** Diverse domains such as **general conversations**, **business** and etc
|
| 28 |
+
|
| 29 |
+
# Frequently Asked Questions
|
| 30 |
+
|
| 31 |
+
## What types of conversations are included in this Russian speech dataset?
|
| 32 |
+
|
| 33 |
+
The dataset contains real-world telephone conversations between native Russian speakers. The recordings capture natural dialogue patterns and spontaneous speech, making them suitable for training AI systems that need to understand everyday Russian communication rather than only isolated words or scripted commands.
|
| 34 |
+
|
| 35 |
+
## How was the Russian speech data collected?
|
| 36 |
+
|
| 37 |
+
The recordings were collected through crowdsourcing platforms, allowing the dataset to include authentic speech from multiple participants.
|
| 38 |
+
|
| 39 |
+
## Who can benefit from this Russian speech recognition dataset?
|
| 40 |
+
|
| 41 |
+
The dataset is valuable for speech AI researchers, universities, conversational AI developers, voice assistant companies, call center technology providers, and organizations developing Russian-language speech applications. It can support projects involving transcription, speech analytics, voice interfaces, and natural language processing."
|
| 42 |
+
|
| 43 |
+
The native speakers and various topics and domains covered in the dataset make it an ideal resource for research community, allowing researchers to study spoken languages, dialects, and language patterns.
|
| 44 |
+
|
| 45 |
+
# 🌐 [UniData](https://unidata.pro/datasets/russian-speech-recognition-dataset/?utm_source=huggingface&utm_medium=referral&utm_campaign=russian-speech-recognition-dataset) provides high-quality datasets, content moderation, data collection and annotation for your AI/ML projects
|
Russian Speech Recognition Dataset.csv
ADDED
|
@@ -0,0 +1,7 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
ID,Audio,Text
|
| 2 |
+
1,audio/1.wav,text/1.txt
|
| 3 |
+
2,audio/2.wav,text/2.txt
|
| 4 |
+
3,audio/3.wav,text/3.txt
|
| 5 |
+
4,audio/4.wav,text/4.txt
|
| 6 |
+
5,audio/5.wav,text/5.txt
|
| 7 |
+
6,audio/6.wav,text/6.txt
|