
model documentation
#4
by nazneen - opened
README.md
CHANGED
|
@@ -1,217 +1,237 @@
|
|
|
|
|
| 1 |
---
|
| 2 |
-
language:
|
| 3 |
-
|
| 4 |
-
|
|
|
|
| 5 |
tags:
|
| 6 |
- electra
|
| 7 |
- korean
|
| 8 |
-
license: "mit"
|
| 9 |
---
|
| 10 |
|
| 11 |
-
|
| 12 |
-
|
| 13 |
-
|
|
|
|
|
|
|
|
|
|
|
|
|
| 14 |
** Updates on 2022.10.08 **
|
| 15 |
-
|
| 16 |
- KcELECTRA-base-v2022 (구 v2022-dev) 모델 이름이 변경되었습니다.
|
| 17 |
- 위 모델의 세부 스코어를 추가하였습니다.
|
| 18 |
- 기존 KcELECTRA-base(v2021) 대비 대부분의 downstream task에서 ~1%p 수준의 성능 향상이 있습니다.
|
| 19 |
-
|
| 20 |
---
|
| 21 |
-
|
| 22 |
공개된 한국어 Transformer 계열 모델들은 대부분 한국어 위키, 뉴스 기사, 책 등 잘 정제된 데이터를 기반으로 학습한 모델입니다. 한편, 실제로 NSMC와 같은 User-Generated Noisy text domain 데이터셋은 정제되지 않았고 구어체 특징에 신조어가 많으며, 오탈자 등 공식적인 글쓰기에서 나타나지 않는 표현들이 빈번하게 등장합니다.
|
| 23 |
-
|
| 24 |
KcELECTRA는 위와 같은 특성의 데이터셋에 적용하기 위해, 네이버 뉴스에서 댓글과 대댓글을 수집해, 토크나이저와 ELECTRA모델을 처음부터 학습한 Pretrained ELECTRA 모델입니다.
|
| 25 |
-
|
| 26 |
기존 KcBERT 대비 데이터셋 증가 및 vocab 확장을 통해 상당한 수준으로 성능이 향상되었습니다.
|
| 27 |
-
|
| 28 |
KcELECTRA는 Huggingface의 Transformers 라이브러리를 통해 간편히 불러와 사용할 수 있습니다. (별도의 파일 다운로드가 필요하지 않습니다.)
|
| 29 |
-
|
| 30 |
-
|
| 31 |
-
|
| 32 |
-
|
| 33 |
-
|
| 34 |
-
|
| 35 |
-
|
| 36 |
-
|
| 37 |
-
|
| 38 |
-
-
|
| 39 |
-
-
|
| 40 |
-
|
| 41 |
-
|
| 42 |
-
|
| 43 |
-
|
| 44 |
-
|
| 45 |
-
|
| 46 |
-
|
| 47 |
-
|
| 48 |
-
|
| 49 |
-
|
| 50 |
-
|
| 51 |
-
|
| 52 |
-
|
| 53 |
-
|
| 54 |
-
|
| 55 |
-
|
| 56 |
-
|
| 57 |
-
|
| 58 |
-
|
| 59 |
-
|
| 60 |
-
|
| 61 |
-
|
| 62 |
-
|
| 63 |
-
|
| 64 |
-
|
| 65 |
-
|
| 66 |
-
|
| 67 |
-
|
| 68 |
-
|
| 69 |
-
|
| 70 |
-
|
| 71 |
-
|
| 72 |
-
|
| 73 |
-
|
| 74 |
-
|
| 75 |
-
|
| 76 |
-
|
| 77 |
-
|
| 78 |
-
|
| 79 |
-
|
| 80 |
-
|
| 81 |
-
|
| 82 |
-
#### Pretrain Data
|
| 83 |
-
|
| 84 |
-
- KcBERT학습에 사용한 데이터 + 이후 2021.03월 초까지 수집한 댓글
|
| 85 |
-
- 약 17GB
|
| 86 |
-
- 댓글-대댓글을 묶은 기반으로 Document 구성
|
| 87 |
-
|
| 88 |
-
#### Pretrain Code
|
| 89 |
-
|
| 90 |
-
- https://github.com/KLUE-benchmark/KLUE-ELECTRA Repo를 통한 Pretrain
|
| 91 |
-
|
| 92 |
-
#### Finetune Code
|
| 93 |
-
|
| 94 |
-
- https://github.com/Beomi/KcBERT-finetune Repo를 통한 Finetune 및 스코어 비교
|
| 95 |
-
|
| 96 |
#### Finetune Samples
|
| 97 |
-
|
| 98 |
- NSMC with PyTorch-Lightning 1.3.0, GPU, Colab <a href="https://colab.research.google.com/drive/1Hh63kIBAiBw3Hho--BvfdUWLu-ysMFF0?usp=sharing">
|
| 99 |
<img src="https://colab.research.google.com/assets/colab-badge.svg" alt="Open In Colab"/>
|
| 100 |
</a>
|
| 101 |
-
|
| 102 |
-
|
| 103 |
-
|
| 104 |
-
|
| 105 |
-
|
| 106 |
-
|
| 107 |
-
학습 데이터는 2019.01.01 ~ 2021.03.09 사이에 작성된 **댓글 많은 뉴스/혹은 전체 뉴스** 기사들의 **댓글과 대댓글**을 모두 수집한 데이터입니다.
|
| 108 |
-
|
| 109 |
-
데이터 사이즈는 텍스트만 추출시 **약 17.3GB이며, 1억8천만개 이상의 문장**으로 이뤄져 있습니다.
|
| 110 |
-
|
| 111 |
-
> KcBERT는 2019.01-2020.06의 텍스트로, 정제 후 약 9천만개 문장으로 학습을 진행했습니다.
|
| 112 |
-
|
| 113 |
### Preprocessing
|
| 114 |
-
|
| 115 |
PLM 학습을 위해서 전처리를 진행한 과정은 다음과 같습니다.
|
| 116 |
-
|
| 117 |
1. 한글 및 영어, 특수문자, 그리고 이모지(🥳)까지!
|
| 118 |
-
|
| 119 |
정규표현식을 통해 한글, 영어, 특수문자를 포함해 Emoji까지 학습 대상에 포함했습니다.
|
| 120 |
-
|
| 121 |
한편, 한글 범위를 `ㄱ-ㅎ가-힣` 으로 지정해 `ㄱ-힣` 내의 한자를 제외했습니다.
|
| 122 |
-
|
| 123 |
2. 댓글 내 중복 문자열 축약
|
| 124 |
-
|
| 125 |
`ㅋㅋㅋㅋㅋ`와 같이 중복된 글자를 `ㅋㅋ`와 같은 것으로 합쳤습니다.
|
| 126 |
-
|
| 127 |
3. Cased Model
|
| 128 |
-
|
| 129 |
KcBERT는 영문에 대해서는 대소문자를 유지하는 Cased model입니다.
|
| 130 |
-
|
| 131 |
4. 글자 단위 10글자 이하 제거
|
| 132 |
-
|
| 133 |
10글자 미만의 텍스트는 단일 단어로 이뤄진 경우가 많아 해당 부분을 제외했습니다.
|
| 134 |
-
|
| 135 |
5. 중복 제거
|
| 136 |
-
|
| 137 |
중복적으로 쓰인 댓글을 제거하기 위해 완전히 일치하는 중복 댓글을 하나로 합쳤습니다.
|
| 138 |
-
|
| 139 |
6. `OOO` 제거
|
| 140 |
-
|
| 141 |
네이버 댓글의 경우, 비속어는 자체 필터링을 통해 `OOO` 로 표시합니다. 이 부분을 공백으로 제거하였습니다.
|
| 142 |
-
|
| 143 |
-
|
| 144 |
-
|
| 145 |
-
|
| 146 |
-
|
| 147 |
-
|
| 148 |
-
|
| 149 |
-
|
| 150 |
-
|
| 151 |
-
|
| 152 |
-
|
| 153 |
-
|
| 154 |
-
|
| 155 |
-
|
| 156 |
-
|
| 157 |
-
|
| 158 |
-
|
| 159 |
-
|
| 160 |
-
|
| 161 |
-
import re
|
| 162 |
-
import emoji
|
| 163 |
-
from soynlp.normalizer import repeat_normalize
|
| 164 |
-
|
| 165 |
-
pattern = re.compile(f'[^ .,?!/@$%~%·∼()\x00-\x7Fㄱ-ㅣ가-힣]+')
|
| 166 |
-
url_pattern = re.compile(
|
| 167 |
-
r'https?:\/\/(www\.)?[-a-zA-Z0-9@:%._\+~#=]{1,256}\.[a-zA-Z0-9()]{1,6}\b([-a-zA-Z0-9()@:%_\+.~#?&//=]*)')
|
| 168 |
-
|
| 169 |
-
def clean(x):
|
| 170 |
-
x = pattern.sub(' ', x)
|
| 171 |
-
x = emoji.replace_emoji(x, replace='') #emoji 삭제
|
| 172 |
-
x = url_pattern.sub('', x)
|
| 173 |
-
x = x.strip()
|
| 174 |
-
x = repeat_normalize(x, num_repeats=2)
|
| 175 |
-
return x
|
| 176 |
-
```
|
| 177 |
-
|
| 178 |
-
> 💡 Finetune Score에서는 위 `clean` 함수를 적용하지 않았습니다.
|
| 179 |
-
|
| 180 |
-
### Cleaned Data
|
| 181 |
-
|
| 182 |
- KcBERT 외 추가 데이터는 정리 후 공개 예정입니다.
|
| 183 |
-
|
| 184 |
-
|
| 185 |
-
##
|
| 186 |
-
|
| 187 |
-
|
| 188 |
-
|
| 189 |
-
|
| 190 |
-
|
| 191 |
-
|
| 192 |
-
|
| 193 |
-
|
| 194 |
-
|
| 195 |
(100k step별 Checkpoint를 통해 성능 평가를 진행하였습니다. 해당 부분은 `KcBERT-finetune` repo를 참고해주세요.)
|
| 196 |
-
|
| 197 |
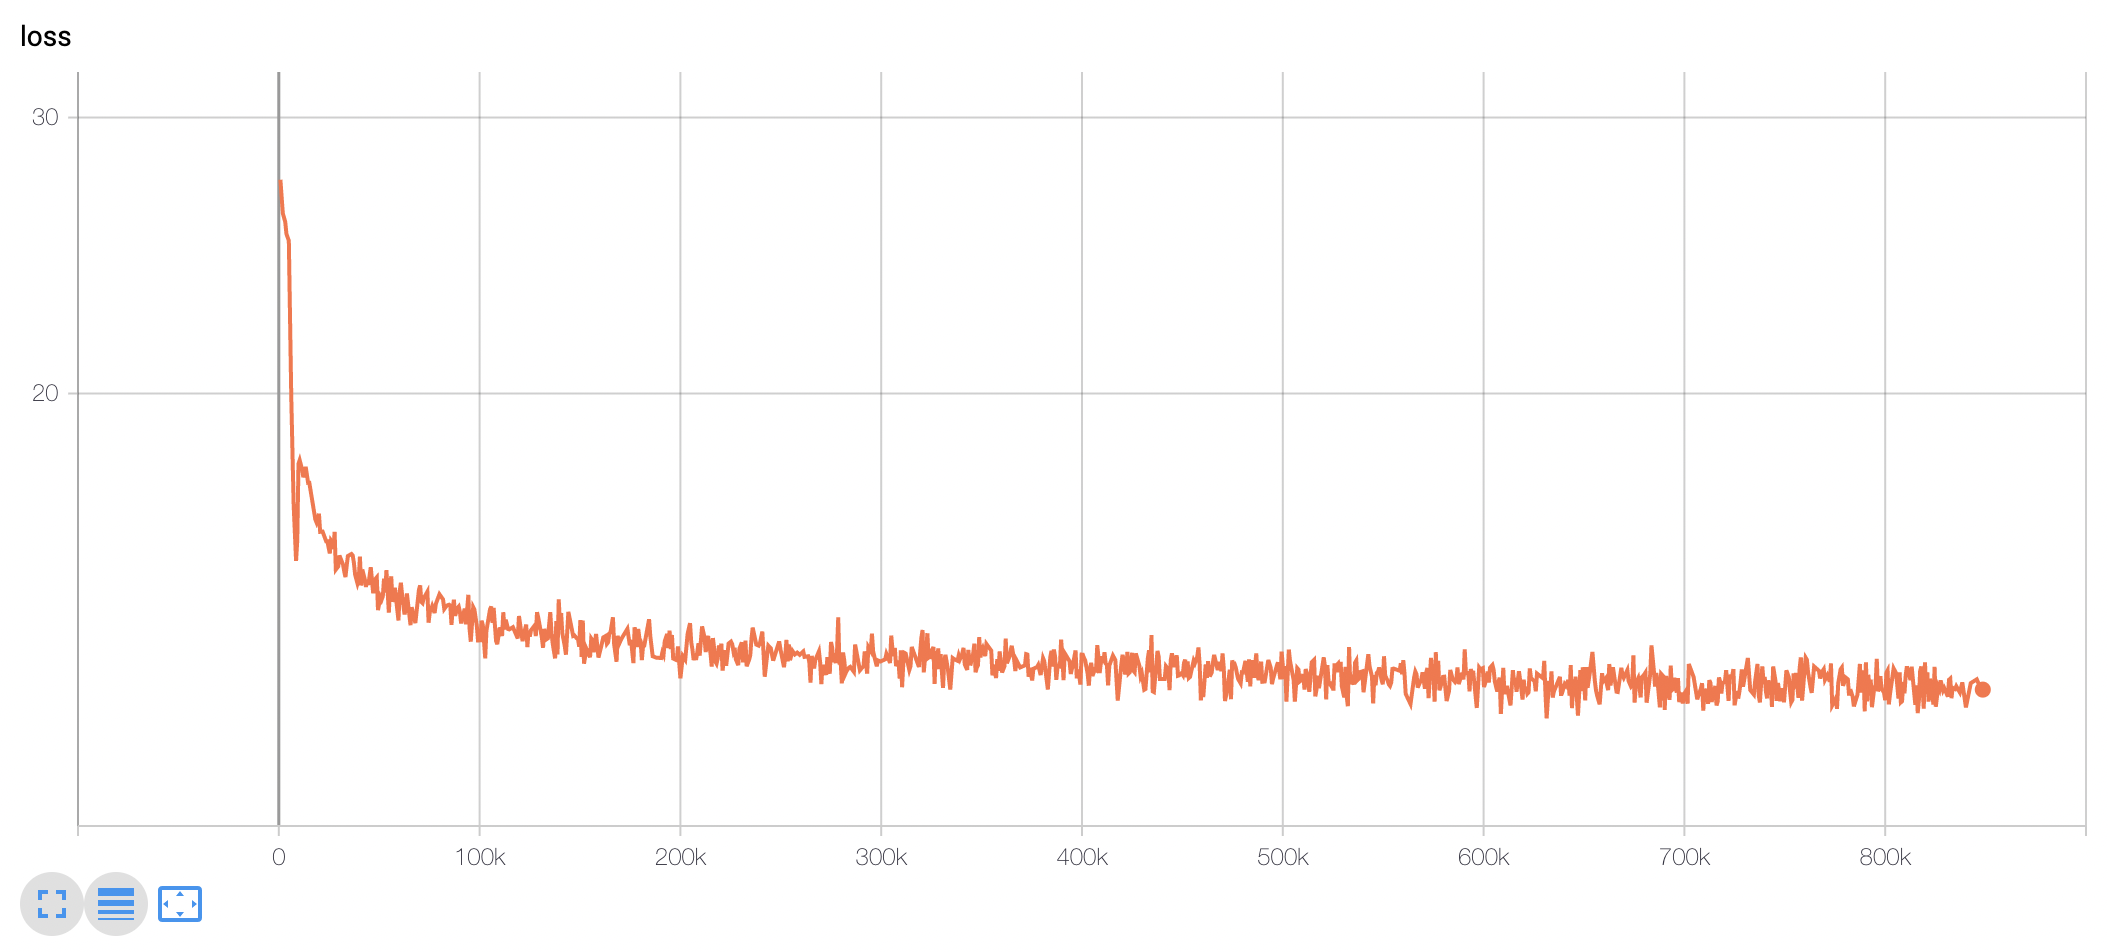
모델 학습 Loss는 Step에 따라 초기 100-200k 사이에 급격히 Loss가 줄어들다 학습 종료까지도 지속적으로 loss가 감소하는 것을 볼 수 있습니다.
|
| 198 |
-
|
| 199 |
|
| 200 |
-
|
| 201 |
### KcELECTRA Pretrain Step별 Downstream task 성능 비교
|
| 202 |
-
|
| 203 |
> 💡 아래 표는 전체 ckpt가 아닌 일부에 대해서만 테스트를 진행한 결과입니다.
|
| 204 |
-
|
| 205 |
|
| 206 |
-
|
| 207 |
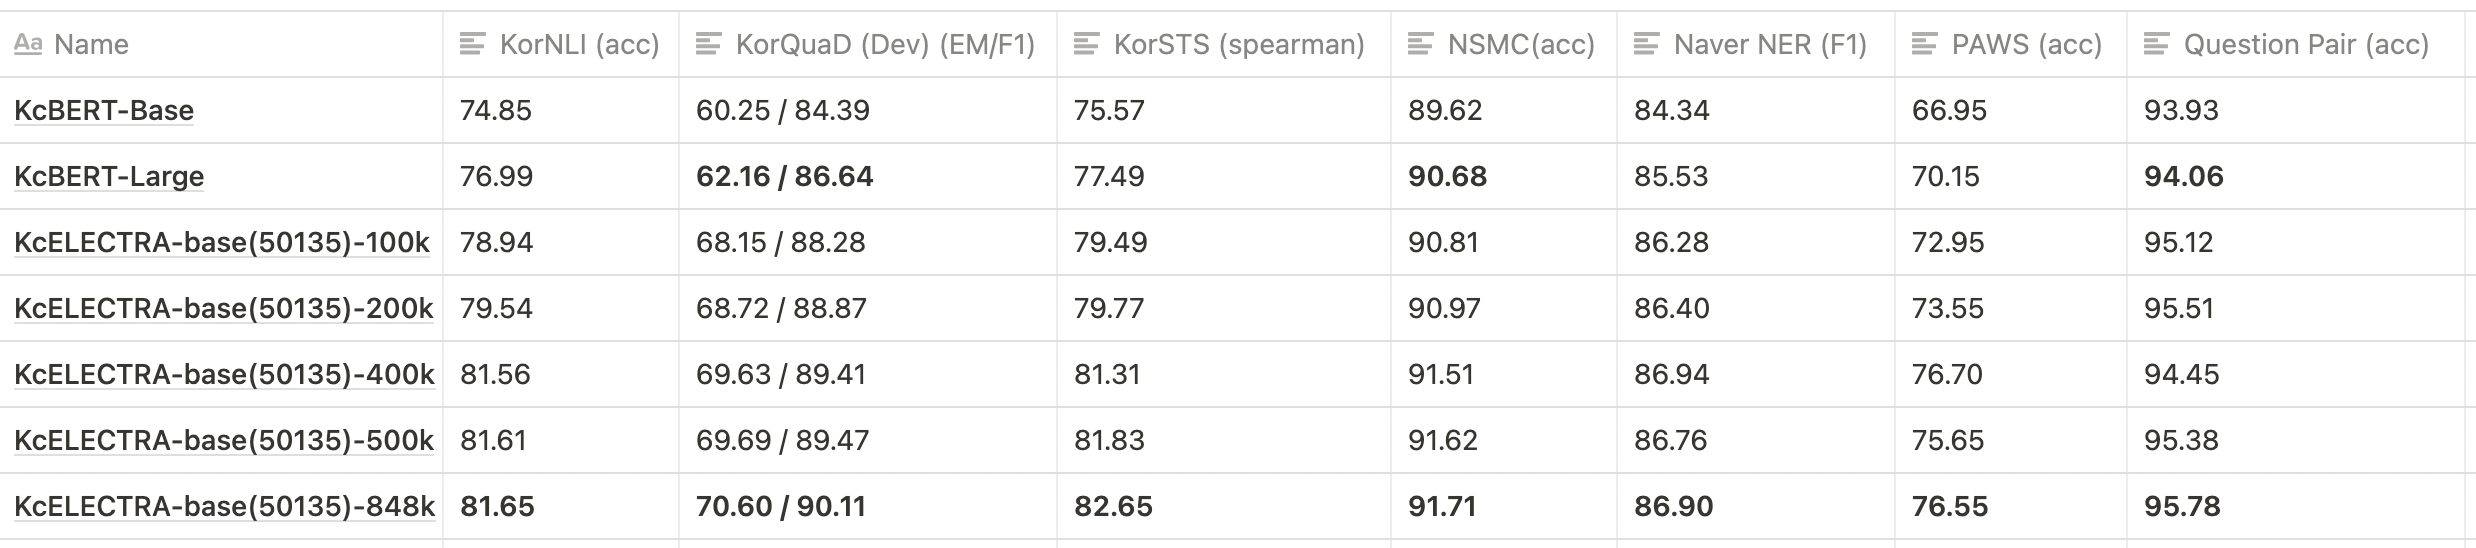
- 위와 같이 KcBERT-base, KcBERT-large 대비 **모든 데이터셋에 대해** KcELECTRA-base가 더 높은 성능을 보입니다.
|
| 208 |
- KcELECTRA pretrain에서도 Train step이 늘어감에 따라 점진적으로 성능이 향상되는 것을 볼 수 있습니다.
|
| 209 |
-
|
| 210 |
-
|
| 211 |
-
|
| 212 |
-
|
| 213 |
-
|
| 214 |
-
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 215 |
@misc{lee2021kcelectra,
|
| 216 |
author = {Junbum Lee},
|
| 217 |
title = {KcELECTRA: Korean comments ELECTRA},
|
|
@@ -220,20 +240,29 @@ KcELECTRA를 인용하실 때는 아래 양식을 통해 인용해주세요.
|
|
| 220 |
journal = {GitHub repository},
|
| 221 |
howpublished = {\url{https://github.com/Beomi/KcELECTRA}}
|
| 222 |
}
|
|
|
|
| 223 |
```
|
| 224 |
-
|
| 225 |
논문을 통한 사용 외에는 MIT 라이센스를 표기해주세요. ☺️
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 226 |
|
| 227 |
## Acknowledgement
|
| 228 |
-
|
| 229 |
KcELECTRA Model을 학습하는 GCP/TPU 환경은 [TFRC](https://www.tensorflow.org/tfrc?hl=ko) 프로그램의 지원을 받았습니다.
|
| 230 |
-
|
| 231 |
모델 학습 과정에서 많은 조언을 주신 [Monologg](https://github.com/monologg/) 님 감사합니다 :)
|
| 232 |
-
|
| 233 |
-
## Reference
|
| 234 |
-
|
| 235 |
### Github Repos
|
| 236 |
-
|
| 237 |
- [KcBERT by Beomi](https://github.com/Beomi/KcBERT)
|
| 238 |
- [BERT by Google](https://github.com/google-research/bert)
|
| 239 |
- [KoBERT by SKT](https://github.com/SKTBrain/KoBERT)
|
|
@@ -241,8 +270,57 @@ KcELECTRA Model을 학습하는 GCP/TPU 환경은 [TFRC](https://www.tensorflow.
|
|
| 241 |
- [Transformers by Huggingface](https://github.com/huggingface/transformers)
|
| 242 |
- [Tokenizers by Hugginface](https://github.com/huggingface/tokenizers)
|
| 243 |
- [ELECTRA train code by KLUE](https://github.com/KLUE-benchmark/KLUE-ELECTRA)
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 244 |
|
| 245 |
-
### Blogs
|
| 246 |
-
|
| 247 |
-
- [Monologg님의 KoELECTRA 학습기](https://monologg.kr/categories/NLP/ELECTRA/)
|
| 248 |
-
- [Colab에서 TPU로 BERT 처음부터 학습시키기 - Tensorflow/Google ver.](https://beomi.github.io/2020/02/26/Train-BERT-from-scratch-on-colab-TPU-Tensorflow-ver/)
|
|
|
|
| 1 |
+
|
| 2 |
---
|
| 3 |
+
language:
|
| 4 |
+
- ko
|
| 5 |
+
- en
|
| 6 |
+
license: mit
|
| 7 |
tags:
|
| 8 |
- electra
|
| 9 |
- korean
|
|
|
|
| 10 |
---
|
| 11 |
|
| 12 |
+
# Model Card for KcELECTRA: Korean comments ELECTRA
|
| 13 |
+
|
| 14 |
+
|
| 15 |
+
# Model Details
|
| 16 |
+
|
| 17 |
+
## Model Description
|
| 18 |
+
|
| 19 |
** Updates on 2022.10.08 **
|
| 20 |
+
|
| 21 |
- KcELECTRA-base-v2022 (구 v2022-dev) 모델 이름이 변경되었습니다.
|
| 22 |
- 위 모델의 세부 스코어를 추가하였습니다.
|
| 23 |
- 기존 KcELECTRA-base(v2021) 대비 대부분의 downstream task에서 ~1%p 수준의 성능 향상이 있습니다.
|
| 24 |
+
|
| 25 |
---
|
| 26 |
+
|
| 27 |
공개된 한국어 Transformer 계열 모델들은 대부분 한국어 위키, 뉴스 기사, 책 등 잘 정제된 데이터를 기반으로 학습한 모델입니다. 한편, 실제로 NSMC와 같은 User-Generated Noisy text domain 데이터셋은 정제되지 않았고 구어체 특징에 신조어가 많으며, 오탈자 등 공식적인 글쓰기에서 나타나지 않는 표현들이 빈번하게 등장합니다.
|
| 28 |
+
|
| 29 |
KcELECTRA는 위와 같은 특성의 데이터셋에 적용하기 위해, 네이버 뉴스에서 댓글과 대댓글을 수집해, 토크나이저와 ELECTRA모델을 처음부터 학습한 Pretrained ELECTRA 모델입니다.
|
| 30 |
+
|
| 31 |
기존 KcBERT 대비 데이터셋 증가 및 vocab 확장을 통해 상당한 수준으로 성능이 향상되었습니다.
|
| 32 |
+
|
| 33 |
KcELECTRA는 Huggingface의 Transformers 라이브러리를 통해 간편히 불러와 사용할 수 있습니다. (별도의 파일 다운로드가 필요하지 않습니다.)
|
| 34 |
+
|
| 35 |
+
|
| 36 |
+
|
| 37 |
+
|
| 38 |
+
|
| 39 |
+
- **Developed by:** Junbum Lee
|
| 40 |
+
- **Shared by [Optional]:** Hugging Face
|
| 41 |
+
- **Model type:** electra
|
| 42 |
+
- **Language(s) (NLP):** en
|
| 43 |
+
- **License:** MIT
|
| 44 |
+
- **Related Models:**
|
| 45 |
+
- **Parent Model:** Electra
|
| 46 |
+
- **Resources for more information:**
|
| 47 |
+
- [GitHub Repo](https://github.com/Beomi/KcBERT-finetune )
|
| 48 |
+
- [Model Space](https://huggingface.co/spaces/BeMerciless/korean_malicious_comment)
|
| 49 |
+
- [Blog Post](ttps://monologg.kr/categories/NLP/ELECTRA/)
|
| 50 |
+
|
| 51 |
+
# Uses
|
| 52 |
+
|
| 53 |
+
|
| 54 |
+
## Direct Use
|
| 55 |
+
|
| 56 |
+
This model can be used for the task of
|
| 57 |
+
|
| 58 |
+
## Downstream Use [Optional]
|
| 59 |
+
|
| 60 |
+
More information needed
|
| 61 |
+
|
| 62 |
+
## Out-of-Scope Use
|
| 63 |
+
|
| 64 |
+
The model should not be used to intentionally create hostile or alienating environments for people.
|
| 65 |
+
|
| 66 |
+
# Bias, Risks, and Limitations
|
| 67 |
+
|
| 68 |
+
Significant research has explored bias and fairness issues with language models (see, e.g., [Sheng et al. (2021)](https://aclanthology.org/2021.acl-long.330.pdf) and [Bender et al. (2021)](https://dl.acm.org/doi/pdf/10.1145/3442188.3445922)). Predictions generated by the model may include disturbing and harmful stereotypes across protected classes; identity characteristics; and sensitive, social, and occupational groups.
|
| 69 |
+
|
| 70 |
+
|
| 71 |
+
## Recommendations
|
| 72 |
+
|
| 73 |
+
Users (both direct and downstream) should be made aware of the risks, biases and limitations of the model. More information needed for further recommendations.
|
| 74 |
+
|
| 75 |
+
|
| 76 |
+
# Training Details
|
| 77 |
+
|
| 78 |
+
## Training Data
|
| 79 |
+
|
| 80 |
+
학습 데이터는 2019.01.01 ~ 2021.03.09 사이에 작성된 **댓글 많은 뉴스/혹은 전체 뉴스** 기사들의 **댓글과 대댓글**을 모두 수집한 데이터입니다.
|
| 81 |
+
|
| 82 |
+
데이터 사이즈는 텍스트만 추출시 **약 17.3GB이며, 1억8천만개 이상의 문장**으로 이뤄져 있습니다.
|
| 83 |
+
|
| 84 |
+
> KcBERT는 2019.01-2020.06의 텍스트로, 정제 후 약 9천만개 문장으로 학습을 진행했습니다.
|
| 85 |
+
|
| 86 |
+
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 87 |
#### Finetune Samples
|
| 88 |
+
|
| 89 |
- NSMC with PyTorch-Lightning 1.3.0, GPU, Colab <a href="https://colab.research.google.com/drive/1Hh63kIBAiBw3Hho--BvfdUWLu-ysMFF0?usp=sharing">
|
| 90 |
<img src="https://colab.research.google.com/assets/colab-badge.svg" alt="Open In Colab"/>
|
| 91 |
</a>
|
| 92 |
+
|
| 93 |
+
|
| 94 |
+
|
| 95 |
+
## Training Procedure
|
| 96 |
+
|
| 97 |
+
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 98 |
### Preprocessing
|
| 99 |
+
|
| 100 |
PLM 학습을 위해서 전처리를 진행한 과정은 다음과 같습니다.
|
| 101 |
+
|
| 102 |
1. 한글 및 영어, 특수문자, 그리고 이모지(🥳)까지!
|
| 103 |
+
|
| 104 |
정규표현식을 통해 한글, 영어, 특수문자를 포함해 Emoji까지 학습 대상에 포함했습니다.
|
| 105 |
+
|
| 106 |
한편, 한글 범위를 `ㄱ-ㅎ가-힣` 으로 지정해 `ㄱ-힣` 내의 한자를 제외했습니다.
|
| 107 |
+
|
| 108 |
2. 댓글 내 중복 문자열 축약
|
| 109 |
+
|
| 110 |
`ㅋㅋㅋㅋㅋ`와 같이 중복된 글자를 `ㅋㅋ`와 같은 것으로 합쳤습니다.
|
| 111 |
+
|
| 112 |
3. Cased Model
|
| 113 |
+
|
| 114 |
KcBERT는 영문에 대해서는 대소문자를 유지하는 Cased model입니다.
|
| 115 |
+
|
| 116 |
4. 글자 단위 10글자 이하 제거
|
| 117 |
+
|
| 118 |
10글자 미만의 텍스트는 단일 단어로 이뤄진 경우가 많아 해당 부분을 제외했습니다.
|
| 119 |
+
|
| 120 |
5. 중복 제거
|
| 121 |
+
|
| 122 |
중복적으로 쓰인 댓글을 제거하기 위해 완전히 일치하는 중복 댓글을 하나로 합쳤습니다.
|
| 123 |
+
|
| 124 |
6. `OOO` 제거
|
| 125 |
+
|
| 126 |
네이버 댓글의 경우, 비속어는 자체 필터링을 통해 `OOO` 로 표시합니다. 이 부분을 공백으로 제거하였습니다.
|
| 127 |
+
|
| 128 |
+
|
| 129 |
+
|
| 130 |
+
|
| 131 |
+
|
| 132 |
+
### Speeds, Sizes, Times
|
| 133 |
+
|
| 134 |
+
More information needed
|
| 135 |
+
|
| 136 |
+
# Evaluation
|
| 137 |
+
|
| 138 |
+
|
| 139 |
+
## Testing Data, Factors & Metrics
|
| 140 |
+
|
| 141 |
+
### Testing Data
|
| 142 |
+
|
| 143 |
+
#### Cleaned Data
|
| 144 |
+
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 145 |
- KcBERT 외 추가 데이터는 정리 후 공개 예정입니다.
|
| 146 |
+
|
| 147 |
+
|
| 148 |
+
### Factors
|
| 149 |
+
|
| 150 |
+
|
| 151 |
+
### Metrics
|
| 152 |
+
|
| 153 |
+
More information needed
|
| 154 |
+
## Results
|
| 155 |
+
|
| 156 |
+
|
|
|
|
| 157 |
(100k step별 Checkpoint를 통해 성능 평가를 진행하였습니다. 해당 부분은 `KcBERT-finetune` repo를 참고해주세요.)
|
| 158 |
+
|
| 159 |
모델 학습 Loss는 Step에 따라 초기 100-200k 사이에 급격히 Loss가 줄어들다 학습 종료까지도 지속적으로 loss가 감소하는 것을 볼 수 있습니다.
|
| 160 |
+
|
| 161 |

|
| 162 |
+
|
| 163 |
### KcELECTRA Pretrain Step별 Downstream task 성능 비교
|
| 164 |
+
|
| 165 |
> 💡 아래 표는 전체 ckpt가 아닌 일부에 대해서만 테스트를 진행한 결과입니다.
|
| 166 |
+
|
| 167 |

|
| 168 |
+
|
| 169 |
- 위와 같이 KcBERT-base, KcBERT-large 대비 **모든 데이터셋에 대해** KcELECTRA-base가 더 높은 성능을 보입니다.
|
| 170 |
- KcELECTRA pretrain에서도 Train step이 늘어감에 따라 점진적으로 성능이 향상되는 것을 볼 수 있습니다.
|
| 171 |
+
|
| 172 |
+
|
| 173 |
+
|
| 174 |
+
\***config의 세팅을 그대로 하여 돌린 결과이며, hyperparameter tuning을 추가적으로 할 시 더 좋은 성능이 나올 수 있습니다.**
|
| 175 |
+
|
| 176 |
+
|
| 177 |
+
| | Size<br/>(용량) | **NSMC**<br/>(acc) | **Naver NER**<br/>(F1) | **PAWS**<br/>(acc) | **KorNLI**<br/>(acc) | **KorSTS**<br/>(spearman) | **Question Pair**<br/>(acc) | **KorQuaD (Dev)**<br/>(EM/F1) |
|
| 178 |
+
| :----------------- | :-------------: | :----------------: | :--------------------: | :----------------: | :------------------: | :-----------------------: | :-------------------------: | :---------------------------: |
|
| 179 |
+
| **KcELECTRA-base-v2022** | 475M | **91.97** | 87.35 | 76.50 | 82.12 | 83.67 | 95.12 | 69.00 / 90.40 |
|
| 180 |
+
| **KcELECTRA-base** | 475M | 91.71 | 86.90 | 74.80 | 81.65 | 82.65 | **95.78** | 70.60 / 90.11 |
|
| 181 |
+
| KcBERT-Base | 417M | 89.62 | 84.34 | 66.95 | 74.85 | 75.57 | 93.93 | 60.25 / 84.39 |
|
| 182 |
+
| KcBERT-Large | 1.2G | 90.68 | 85.53 | 70.15 | 76.99 | 77.49 | 94.06 | 62.16 / 86.64 |
|
| 183 |
+
| KoBERT | 351M | 89.63 | 86.11 | 80.65 | 79.00 | 79.64 | 93.93 | 52.81 / 80.27 |
|
| 184 |
+
| XLM-Roberta-Base | 1.03G | 89.49 | 86.26 | 82.95 | 79.92 | 79.09 | 93.53 | 64.70 / 88.94 |
|
| 185 |
+
| HanBERT | 614M | 90.16 | 87.31 | 82.40 | 80.89 | 83.33 | 94.19 | 78.74 / 92.02 |
|
| 186 |
+
| KoELECTRA-Base | 423M | 90.21 | 86.87 | 81.90 | 80.85 | 83.21 | 94.20 | 61.10 / 89.59 |
|
| 187 |
+
| KoELECTRA-Base-v2 | 423M | 89.70 | 87.02 | 83.90 | 80.61 | 84.30 | 94.72 | 84.34 / 92.58 |
|
| 188 |
+
| KoELECTRA-Base-v3 | 423M | 90.63 | **88.11** | **84.45** | **82.24** | **85.53** | 95.25 | **84.83 / 93.45** |
|
| 189 |
+
| DistilKoBERT | 108M | 88.41 | 84.13 | 62.55 | 70.55 | 73.21 | 92.48 | 54.12 / 77.80 |
|
| 190 |
+
|
| 191 |
+
|
| 192 |
+
|
| 193 |
+
# Model Examination
|
| 194 |
+
|
| 195 |
+
More information needed
|
| 196 |
+
|
| 197 |
+
# Environmental Impact
|
| 198 |
+
|
| 199 |
+
|
| 200 |
+
Carbon emissions can be estimated using the [Machine Learning Impact calculator](https://mlco2.github.io/impact#compute) presented in [Lacoste et al. (2019)](https://arxiv.org/abs/1910.09700).
|
| 201 |
+
|
| 202 |
+
- **Hardware Type:** TPU `v3-8`
|
| 203 |
+
- **Hours used:** 240 (10 days)
|
| 204 |
+
- **Cloud Provider:** More information needed
|
| 205 |
+
- **Compute Region:** More information needed
|
| 206 |
+
- **Carbon Emitted:** More information needed
|
| 207 |
+
|
| 208 |
+
# Technical Specifications [optional]
|
| 209 |
+
|
| 210 |
+
## Model Architecture and Objective
|
| 211 |
+
|
| 212 |
+
More information needed
|
| 213 |
+
|
| 214 |
+
## Compute Infrastructure
|
| 215 |
+
|
| 216 |
+
More information needed
|
| 217 |
+
|
| 218 |
+
### Hardware
|
| 219 |
+
|
| 220 |
+
TPU `v3-8` 을 이용해 약 10일 학습을 진행했고, 현재 Huggingface에 공개된 모델은 848k step을 학습한 모델 weight가 업로드 되어있습니다.
|
| 221 |
+
|
| 222 |
+
### Software
|
| 223 |
+
- `pytorch ~= 1.8.0`
|
| 224 |
+
- `transformers ~= 4.11.3`
|
| 225 |
+
- `emoji ~= 0.6.0`
|
| 226 |
+
- `soynlp ~= 0.0.493`
|
| 227 |
+
|
| 228 |
+
|
| 229 |
+
# Citation
|
| 230 |
+
|
| 231 |
+
|
| 232 |
+
**BibTeX:**
|
| 233 |
+
```
|
| 234 |
+
|
| 235 |
@misc{lee2021kcelectra,
|
| 236 |
author = {Junbum Lee},
|
| 237 |
title = {KcELECTRA: Korean comments ELECTRA},
|
|
|
|
| 240 |
journal = {GitHub repository},
|
| 241 |
howpublished = {\url{https://github.com/Beomi/KcELECTRA}}
|
| 242 |
}
|
| 243 |
+
|
| 244 |
```
|
|
|
|
| 245 |
논문을 통한 사용 외에는 MIT 라이센스를 표기해주세요. ☺️
|
| 246 |
+
|
| 247 |
+
# Glossary [optional]
|
| 248 |
+
More information needed
|
| 249 |
+
|
| 250 |
+
# More Information [optional]
|
| 251 |
+
|
| 252 |
+
```
|
| 253 |
+
💡 NOTE 💡
|
| 254 |
+
General Corpus로 학습한 KoELECTRA가 보편적인 task에서는 성능이 더 잘 나올 가능성이 높습니다.
|
| 255 |
+
KcBERT/KcELECTRA는 User genrated, Noisy text에 대해서 보다 잘 동작하는 PLM입니다.
|
| 256 |
+
```
|
| 257 |
|
| 258 |
## Acknowledgement
|
| 259 |
+
|
| 260 |
KcELECTRA Model을 학습하는 GCP/TPU 환경은 [TFRC](https://www.tensorflow.org/tfrc?hl=ko) 프로그램의 지원을 받았습니다.
|
| 261 |
+
|
| 262 |
모델 학습 과정에서 많은 조언을 주신 [Monologg](https://github.com/monologg/) 님 감사합니다 :)
|
| 263 |
+
|
|
|
|
|
|
|
| 264 |
### Github Repos
|
| 265 |
+
|
| 266 |
- [KcBERT by Beomi](https://github.com/Beomi/KcBERT)
|
| 267 |
- [BERT by Google](https://github.com/google-research/bert)
|
| 268 |
- [KoBERT by SKT](https://github.com/SKTBrain/KoBERT)
|
|
|
|
| 270 |
- [Transformers by Huggingface](https://github.com/huggingface/transformers)
|
| 271 |
- [Tokenizers by Hugginface](https://github.com/huggingface/tokenizers)
|
| 272 |
- [ELECTRA train code by KLUE](https://github.com/KLUE-benchmark/KLUE-ELECTRA)
|
| 273 |
+
|
| 274 |
+
|
| 275 |
+
# Model Card Authors [optional]
|
| 276 |
+
|
| 277 |
+
|
| 278 |
+
Junbum Lee in collaboration with Ezi Ozoani and the Hugging Face team
|
| 279 |
+
|
| 280 |
+
# Model Card Contact
|
| 281 |
+
|
| 282 |
+
More information needed
|
| 283 |
+
|
| 284 |
+
# How to Get Started with the Model
|
| 285 |
+
|
| 286 |
+
Use the code below to get started with the model.
|
| 287 |
+
|
| 288 |
+
<details>
|
| 289 |
+
<summary> Click to expand </summary>
|
| 290 |
+
|
| 291 |
+
```bash
|
| 292 |
+
pip install soynlp emoji
|
| 293 |
+
```
|
| 294 |
+
|
| 295 |
+
아래 `clean` 함수를 Text data에 사용해주세요.
|
| 296 |
+
|
| 297 |
+
```python
|
| 298 |
+
import re
|
| 299 |
+
import emoji
|
| 300 |
+
from soynlp.normalizer import repeat_normalize
|
| 301 |
+
|
| 302 |
+
emojis = ''.join(emoji.UNICODE_EMOJI.keys())
|
| 303 |
+
pattern = re.compile(f'[^ .,?!/@$%~%·∼()\x00-\x7Fㄱ-ㅣ가-힣{emojis}]+')
|
| 304 |
+
url_pattern = re.compile(
|
| 305 |
+
r'https?:\/\/(www\.)?[-a-zA-Z0-9@:%._\+~#=]{1,256}\.[a-zA-Z0-9()]{1,6}\b([-a-zA-Z0-9()@:%_\+.~#?&//=]*)')
|
| 306 |
+
|
| 307 |
+
import re
|
| 308 |
+
import emoji
|
| 309 |
+
from soynlp.normalizer import repeat_normalize
|
| 310 |
+
|
| 311 |
+
pattern = re.compile(f'[^ .,?!/@$%~%·∼()\x00-\x7Fㄱ-ㅣ가-힣]+')
|
| 312 |
+
url_pattern = re.compile(
|
| 313 |
+
r'https?:\/\/(www\.)?[-a-zA-Z0-9@:%._\+~#=]{1,256}\.[a-zA-Z0-9()]{1,6}\b([-a-zA-Z0-9()@:%_\+.~#?&//=]*)')
|
| 314 |
+
|
| 315 |
+
def clean(x):
|
| 316 |
+
x = pattern.sub(' ', x)
|
| 317 |
+
x = emoji.replace_emoji(x, replace='') #emoji 삭제
|
| 318 |
+
x = url_pattern.sub('', x)
|
| 319 |
+
x = x.strip()
|
| 320 |
+
x = repeat_normalize(x, num_repeats=2)
|
| 321 |
+
return x
|
| 322 |
+
```
|
| 323 |
+
|
| 324 |
+
|
| 325 |
+
</details>
|
| 326 |
|
|
|
|
|
|
|
|
|
|
|
|