
Buckets:


خطوط أنابيب Stable Diffusion
Stable Diffusion هو نموذج انتشار كامن لتحويل النص إلى صورة، أنشأه الباحثون والمهندسون من CompVis وStability AI وLAION. يطبّق الانتشار الكامن عملية الانتشار على فضاء كامن ذي أبعاد أقل لتقليل تعقيد الذاكرة والحوسبة. وقد اقترح هذا النوع المحدد من نماذج الانتشار في High-Resolution Image Synthesis with Latent Diffusion Models بواسطة Robin Rombach وAndreas Blattmann وDominik Lorenz وPatrick Esser وBjörn Ommer.
يتم تدريب Stable Diffusion على صور بأبعاد 512x512 من مجموعة فرعية من مجموعة بيانات LAION-5B. يستخدم هذا النموذج مُشفِّر نصوص CLIP ViT-L/14 مجمّدًا لتكييف النموذج على أوامر النص. ومع وجود UNet بحجم 860 مليون ومُشفِّر نصوص بحجم 123 مليون، يُعد النموذج خفيفًا نسبيًا ويمكن تشغيله على وحدات معالجة الرسومات المخصصة للمستهلكين.
لمزيد من التفاصيل حول كيفية عمل Stable Diffusion وكيف يختلف عن نموذج الانتشار الكامن الأساسي، راجع الإعلان الخاص بـ Stability AI ومنشورنا على المدونة للحصول على تفاصيل تقنية أكثر.
يمكنك العثور على قاعدة الكود الأصلية لنموذج Stable Diffusion v1.0 في CompVis/stable-diffusion ونموذج Stable Diffusion v2.0 في Stability-AI/stablediffusion، بالإضافة إلى سكربتاتهم الأصلية لمهام مختلفة. كما يمكن العثور على نقاط تحقق رسمية إضافية للإصدارات والمهام المختلفة من Stable Diffusion في منظمات CompVis وStability AI على Hub. استكشف هذه المنظمات للعثور على نقطة التحقق الأنسب لحالتك!
تلخص الجدول أدناه خطوط أنابيب Stable Diffusion المتاحة، والمهام المدعومة، وعرضًا تفاعليًا:
        خط أنابيب


        المهام المدعومة


        🤗 مساحة


        StableDiffusion

        النص إلى صورة


        StableDiffusionImg2Img

        صورة إلى صورة


        StableDiffusionInpaint

        التلوين


        StableDiffusionDepth2Img

        depth-to-image


        StableDiffusionImageVariation

        تباين الصورة


        StableDiffusionPipelineSafe (مُتقادم؛ لا توجد صفحة توثيق)

        نص إلى صورة مُرشّح


        StableDiffusion2

        نص إلى صورة، إعادة رسم، عمق إلى صورة، دقة فائقة


        StableDiffusionXL

        نص إلى صورة، صورة إلى صورة


        StableDiffusionLatentUpscale

        دقة فائقة


        StableDiffusionUpscale

        دقة فائقة


        StableDiffusionLDM3D

        نص إلى RGB، نص إلى عمق، نص إلى بانوراما


        StableDiffusionUpscaleLDM3D

        ldm3d رفع الدقة
نصائح
لمساعدتك على الاستفادة القصوى من خطوط أنابيب Stable Diffusion، إليك بعض النصائح لتحسين الأداء وسهولة الاستخدام. تنطبق هذه النصائح على جميع خطوط أنابيب Stable Diffusion.
استكشف التوازن بين السرعة والجودة
يستخدم StableDiffusionPipeline جدولة PNDMScheduler افتراضيًا، لكن 🤗 Diffusers يوفر العديد من الجداول الأخرى المتوافقة (بعضها أسرع أو يُخرج جودة أفضل). على سبيل المثال، إذا كنت ترغب في استخدام EulerDiscreteScheduler بدلاً من الجدولة الافتراضية:
from diffusers import StableDiffusionPipeline, EulerDiscreteScheduler

pipeline = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")
pipeline.scheduler = EulerDiscreteScheduler.from_config(pipeline.scheduler.config)

# or
euler_scheduler = EulerDiscreteScheduler.from_pretrained("CompVis/stable-diffusion-v1-4", subfolder="scheduler")
pipeline = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4", scheduler=euler_scheduler)
إعادة استخدام مكونات خط الأنابيب لتوفير الذاكرة
لحفظ الذاكرة واستخدام نفس المكونات عبر خطوط أنابيب متعددة، استخدم طريقة .components لتجنب تحميل الأوزان إلى ذاكرة الوصول العشوائي أكثر من مرة.
from diffusers import (
    StableDiffusionPipeline,
    StableDiffusionImg2ImgPipeline,
    StableDiffusionInpaintPipeline,
)

text2img = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")
img2img = StableDiffusionImg2ImgPipeline(**text2img.components)
inpaint = StableDiffusionInpaintPipeline(**text2img.components)

# now you can use text2img(...), img2img(...), inpaint(...) just like the call methods of each respective pipeline
إنشاء عروض توضيحية ويب باستخدام gradio
تُستَخدم خطوط أنابيب Stable Diffusion تلقائيًا في Gradio، وهي مكتبة تُسهّل إنشاء تطبيقات تعلّم آلي جميلة وسهلة الاستخدام على الويب. أولًا، تأكد من تثبيت Gradio:
pip install -U gradio
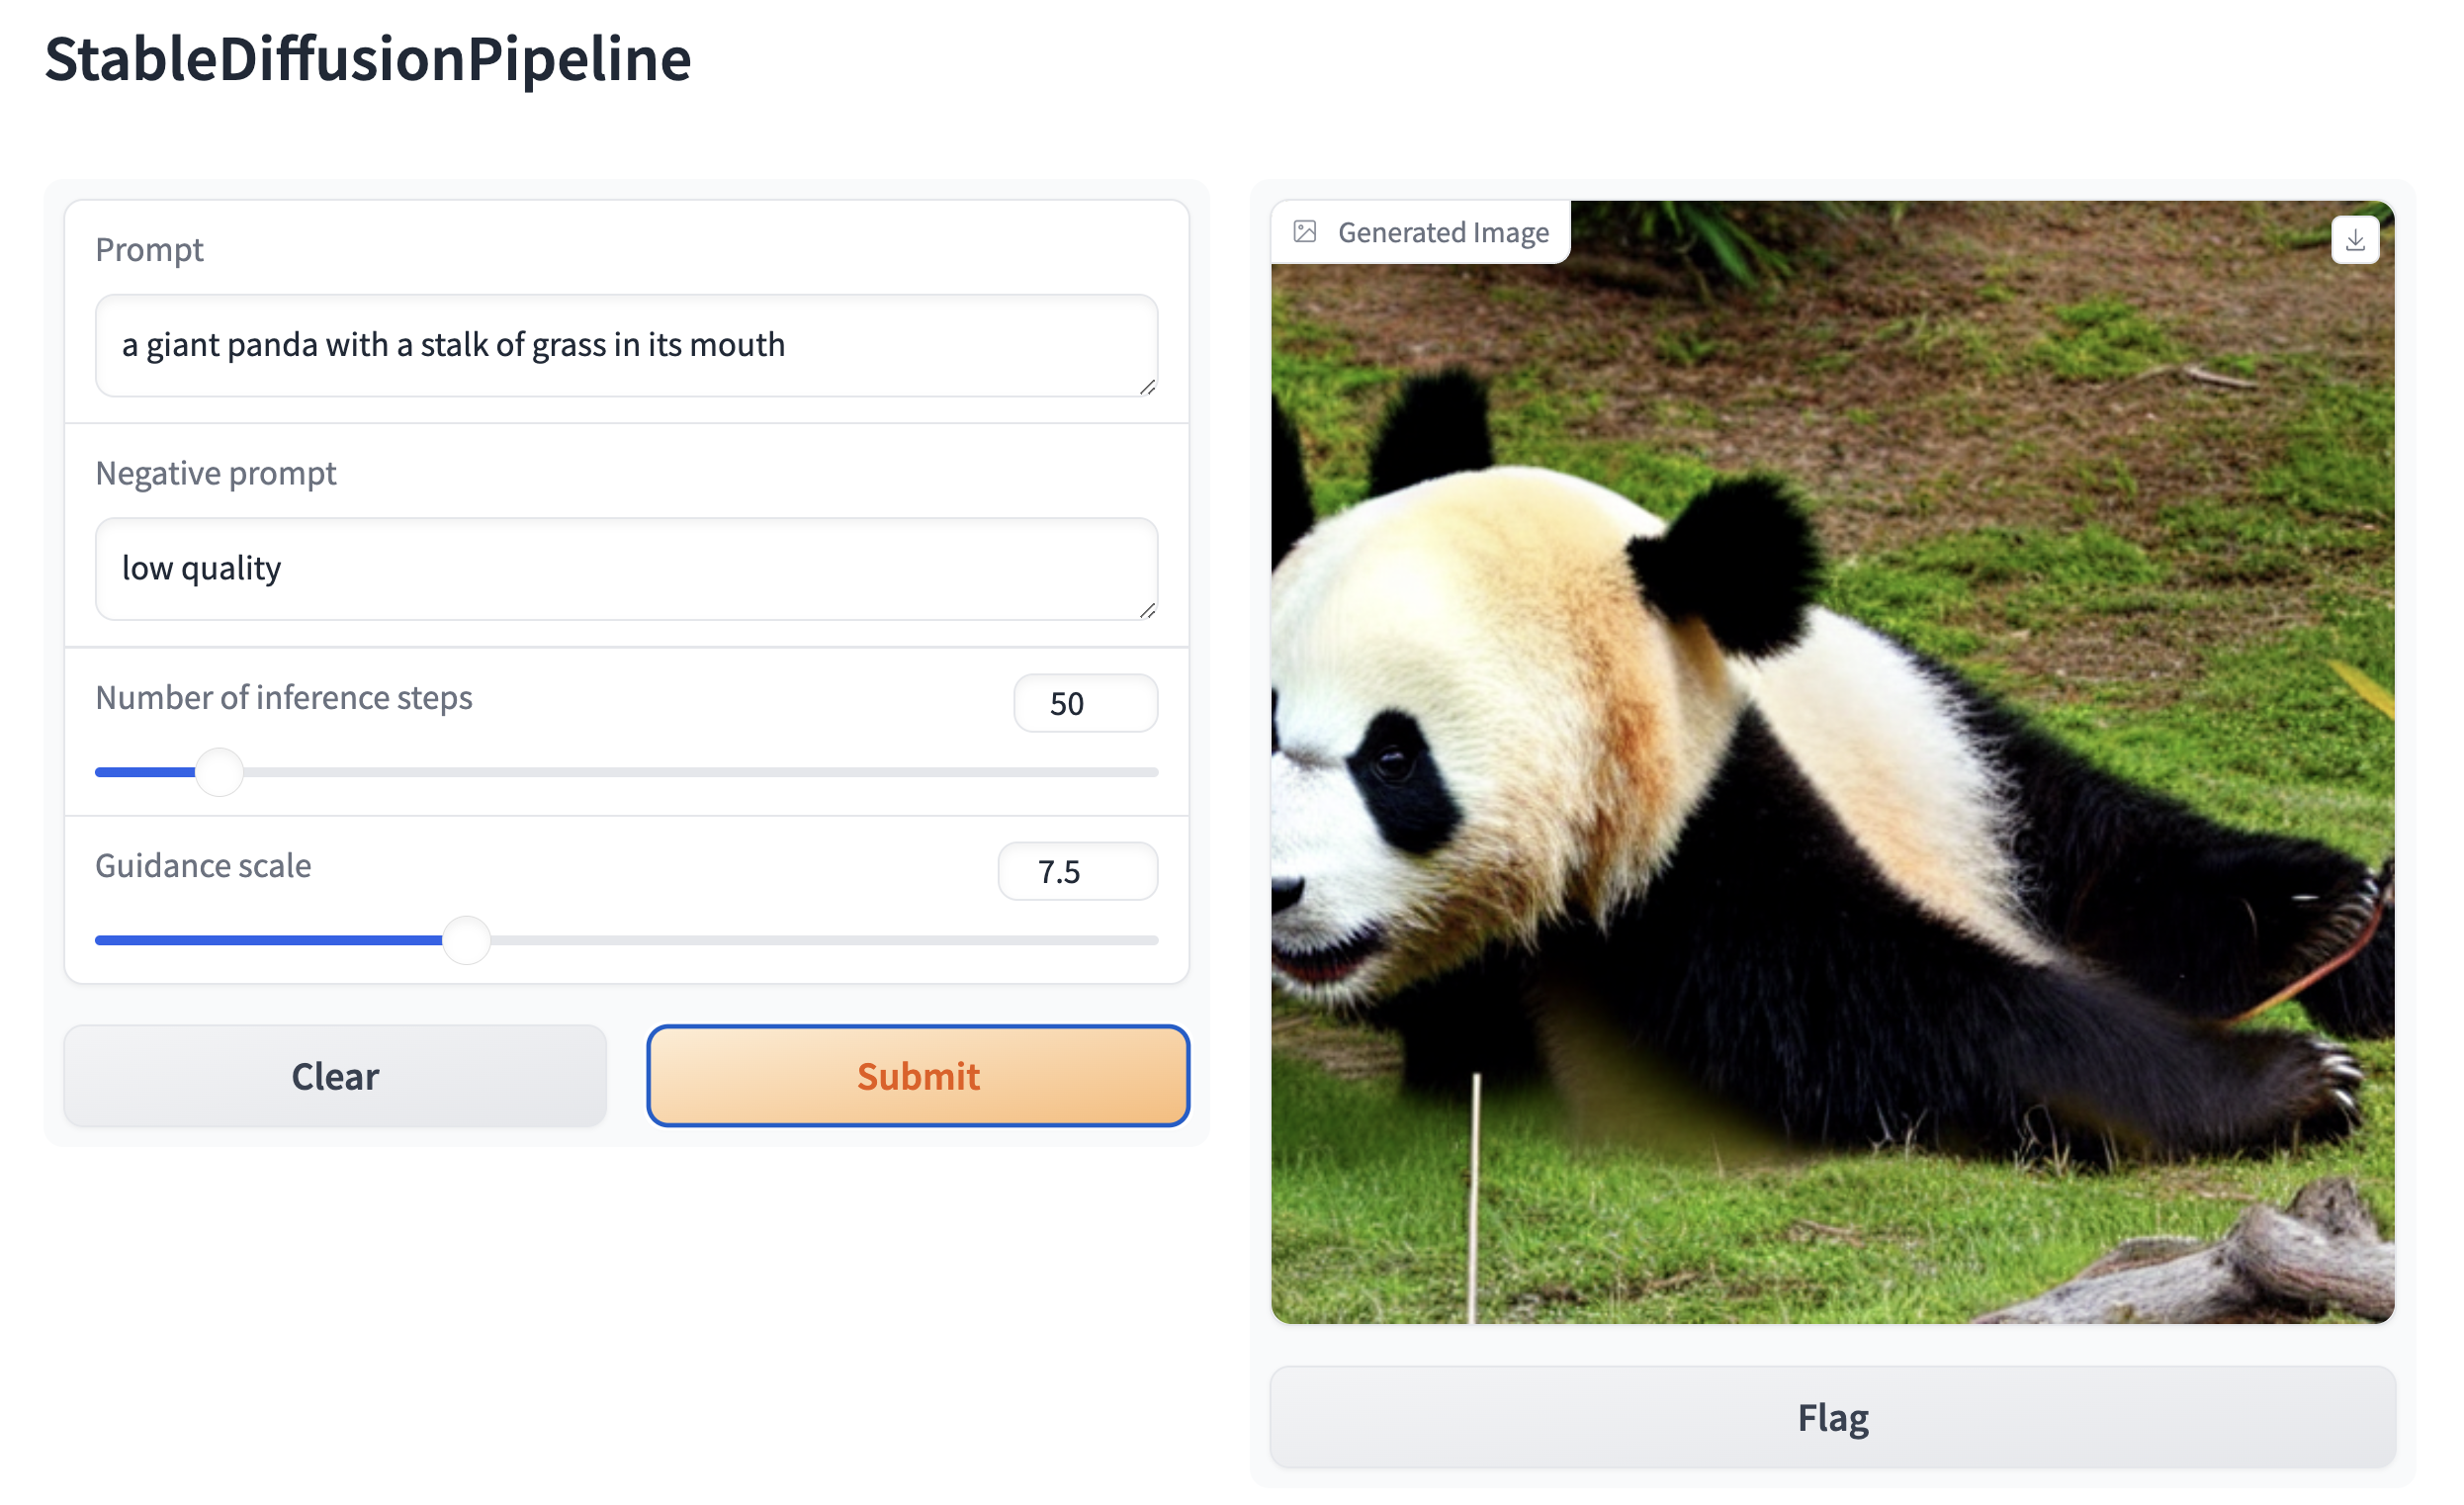
ثم، أنشئ عرضًا توضيحيًا على الويب حول أي خط أنابيب يعتمد على Stable Diffusion. على سبيل المثال، يمكنك إنشاء خط أنابيب لتوليد الصور في سطر واحد من الشيفرة باستخدام دالة Interface.from_pipeline في Gradio:
from diffusers import StableDiffusionPipeline
import gradio as gr

pipe = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")

gr.Interface.from_pipeline(pipe).launch()
الذي يفتح واجهة سحب وإفلات بديهية في متصفحك:
وبالمثل، يمكنك إنشاء عرض توضيحي لخط أنابيب من صورة إلى صورة باستخدام:
from diffusers import StableDiffusionImg2ImgPipeline
import gradio as gr

pipe = StableDiffusionImg2ImgPipeline.from_pretrained("stable-diffusion-v1-5/stable-diffusion-v1-5")

gr.Interface.from_pipeline(pipe).launch()
بشكل افتراضي، يعمل العرض التوضيحي على الويب على خادم محلي. إذا كنت ترغب في مشاركته مع الآخرين، يمكنك إنشاء رابط عام مؤقت من خلال تعيين share=True في launch(). أو يمكنك استضافة عرضك التوضيحي على Hugging Face Spaceshttps://huggingface.co/spaces للحصول على رابط دائم.
Xet Storage Details
- Size:
- 9.01 kB
- Xet hash:
- 12039f9f74a548f29ac42b84383550bb51e725f12605503a896e78d36784598d
Xet efficiently stores files, intelligently splitting them into unique chunks and accelerating uploads and downloads. More info.