
Buckets:


| # Stable Video Diffusion | |
| قُدم Stable Video Diffusion في [Stable Video Diffusion: Scaling Latent Video Diffusion Models to Large Datasets](https://hf.co/papers/2311.15127) بواسطة Andreas Blattmann وTim Dockhorn وSumith Kulal وDaniel Mendelevitch وMaciej Kilian وDominik Lorenz وYam Levi وZion English وVikram Voleti وAdam Letts وVarun Jampani وRobin Rombach. | |
| ملخص الورقة البحثية هو: | |
| *نقدّم Stable Video Diffusion - وهو نموذج انتشار فيديو كامن لتوليد فيديو عالي الدقة من نص إلى فيديو ومن صورة إلى فيديو بأداء متقدم. مؤخراً، تم تحويل نماذج الانتشار الكامنة المدرّبة على تركيب الصور ثنائية الأبعاد إلى نماذج فيديو توليدية عن طريق إدراج طبقات زمنية وضبطها الدقيق على مجموعات بيانات فيديو صغيرة عالية الجودة. ومع ذلك، تتفاوت طرق التدريب في الأدبيات بشكل كبير، ولم يتفق المجال بعد على استراتيجية موحدة لتجهيز بيانات الفيديو. في هذه الورقة، نحدد ونقيّم ثلاث مراحل مختلفة للتدريب الناجح لنماذج LDM للفيديو: التدريب المسبق من نص إلى صورة، والتدريب المسبق للفيديو، والضبط الدقيق على فيديو عالي الجودة. علاوة على ذلك، نوضح ضرورة وجود مجموعة بيانات تدريب مسبق مُجهزة جيداً لتوليد فيديوهات عالية الجودة، ونقدّم عملية تجهيز منهجية لتدريب نموذج أساسي قوي، تشمل استراتيجيات التسمية والتصفية. ثم نستكشف تأثير الضبط الدقيق لنموذجنا الأساسي على بيانات عالية الجودة، وندرّب نموذجاً لتوليد الفيديو من نص يكون تنافسياً مع توليد الفيديو المغلق المصدر. كما نوضح أن نموذجنا الأساسي يوفر تمثيلاً حركياً قوياً للمهام اللاحقة مثل توليد الفيديو من صورة، وقابلية للتكيف مع وحدات LoRA المحددة لحركة الكاميرا. أخيراً، نثبت أن نموذجنا يوفر مسبقاً ثلاثي الأبعاد متعدد الزوايا قوياً، ويمكن أن يعمل كقاعدة لضبط نموذج انتشار متعدد الزوايا بدقة، يولّد عدة زوايا للكائنات بشكل متقدم، متفوقاً على الطرق القائمة على الصور بميزانية حسابية أقل بكثير. ننشر الكود وأوزان النموذج في هذا الرابط.* | |
| > [!TIP] | |
| > اطّلع على منظمة [Stability AI](https://huggingface.co/stabilityai) على Hub للحصول على نقاط التفتيش [base](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid) و[extended frame](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid-xt)! | |
| تأكد من تثبيت المكتبات التالية. | |
| ```py | |
| # Uncomment to install the necessary libraries in Colab | |
| !pip install -q -U diffusers transformers accelerate | |
| ``` | |
| يوجد نوعان من هذا النموذج، هما [SVD](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid) و[SVD-XT](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid-xt). تم تدريب نقطة التفتيش SVD لتوليد 14 إطارًا، بينما خضعت نقطة التفتيش SVD-XT لضبط إضافي لتوليد 25 إطارًا. | |
| ستستخدم نقطة التفتيش SVD-XT لهذا الدليل. | |
| ```python | |
| import torch | |
| from diffusers import StableVideoDiffusionPipeline | |
| from diffusers.utils import load_image, export_to_video | |
| pipe = StableVideoDiffusionPipeline.from_pretrained( | |
| "stabilityai/stable-video-diffusion-img2vid-xt", dtype=torch.float16, variant="fp16" | |
| ) | |
| pipe.enable_model_cpu_offload() | |
| # Load the conditioning image | |
| image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/svd/rocket.png") | |
| image = image.resize((1024, 576)) | |
| generator = torch.manual_seed(42) | |
| frames = pipe(image, decode_chunk_size=8, generator=generator).frames[0] | |
| export_to_video(frames, "generated.mp4", fps=7) | |
| ``` | |
| "صورة مصدر لصاروخ" | |
| "فيديو مُولَّد من صورة المصدر" | |
| ## torch.compile | |
| يمكنك تحقيق تسريع بنسبة 20-25% مقابل زيادة طفيفة في الذاكرة من خلال [تجميع](../../../optimization/fp16#torchcompile) UNet. | |
| ```diff | |
| - pipe.enable_model_cpu_offload() | |
| + pipe.to("cuda") # or "mps", "xpu", "cpu" | |
| + pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True) | |
| ``` | |
| ## تقليل استهلاك الذاكرة | |
| تتطلب توليد الفيديو ذاكرة كبيرة جداً لأنك في الأساس تولّد `num_frames` دفعة واحدة، على غرار توليد الصور من النص مع حجم دفعة عالٍ. لتقليل متطلبات الذاكرة، هناك عدة خيارات تقوم بتضحية بسرعة الاستدلال مقابل تقليل متطلبات الذاكرة: | |
| - تفعيل نقل النموذج: يتم نقل كل مكوّن من مكوّنات خط المعالجة إلى وحدة المعالجة المركزية (CPU) بمجرد انتهاء الحاجة إليه. | |
| - تفعيل تقطيع الطبقة الأمامية: تعمل طبقة الأمامية في حلقة بدلاً من تنفيذ عملية أمامية واحدة بحجم دفعة ضخم. | |
| - تقليل `decode_chunk_size`: يقوم VAE بفك ترميز الإطارات على شكل مجموعات بدلاً من فك ترميزها جميعاً معاً. عند ضبط `decode_chunk_size=1` يتم فك ترميز إطار واحد في كل مرة ويستخدم أقل قدر من الذاكرة (ننصح بضبط هذه القيمة بناءً على ذاكرة وحدة معالجة الرسوميات لديك) لكن قد يعاني الفيديو من بعض الوميض. | |
| ```diff | |
| - pipe.enable_model_cpu_offload() | |
| - frames = pipe(image, decode_chunk_size=8, generator=generator).frames[0] | |
| + pipe.enable_model_cpu_offload() | |
| + pipe.unet.enable_forward_chunking() | |
| + frames = pipe(image, decode_chunk_size=2, generator=generator, num_frames=25).frames[0] | |
| ``` | |
| يجب أن يؤدي استخدام جميع هذه الحيل معًا إلى خفض متطلبات الذاكرة إلى أقل من 8 جيجابايت من ذاكرة الفيديو (VRAM). | |
| ## التكييف الدقيق | |
| يقبل Stable Diffusion Video أيضًا التكييف الدقيق (micro-conditioning)، بالإضافة إلى صورة التكييف، مما يتيح مزيدًا من التحكم في الفيديو المولّد: | |
| - `fps`: عدد الإطارات في الثانية للفيديو المولّد. | |
| - `motion_bucket_id`: معرّف دلو الحركة الذي سيُستخدم للفيديو المولّد. يمكن استخدام هذا المعرّف للتحكم في حركة الفيديو المولّد. فزيادة معرّف دلو الحركة تزيد من حركة الفيديو المولّد. | |
| - `noise_aug_strength`: مقدار الضوضاء المضافة إلى صورة التكييف. كلما ارتفعت القيم قلّت تشابه الصورة الناتجة مع صورة التكييف. كما يؤدي رفع هذه القيمة إلى زيادة الحركة في الفيديو المولّد. | |
| على سبيل المثال، لتوليد فيديو يحتوي على حركة أكثر، استخدم معاملات التكييف الدقيق `motion_bucket_id` و`noise_aug_strength`: | |
| ```python | |
| import torch | |
| from diffusers import StableVideoDiffusionPipeline | |
| from diffusers.utils import load_image, export_to_video | |
| pipe = StableVideoDiffusionPipeline.from_pretrained( | |
| "stabilityai/stable-video-diffusion-img2vid-xt", dtype=torch.float16, variant="fp16" | |
| ) | |
| pipe.enable_model_cpu_offload() | |
| # Load the conditioning image | |
| image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/svd/rocket.png") | |
| image = image.resize((1024, 576)) | |
| generator = torch.manual_seed(42) | |
| frames = pipe(image, decode_chunk_size=8, generator=generator, motion_bucket_id=180, noise_aug_strength=0.1).frames[0] | |
| export_to_video(frames, "generated.mp4", fps=7) | |
| ``` | |
| 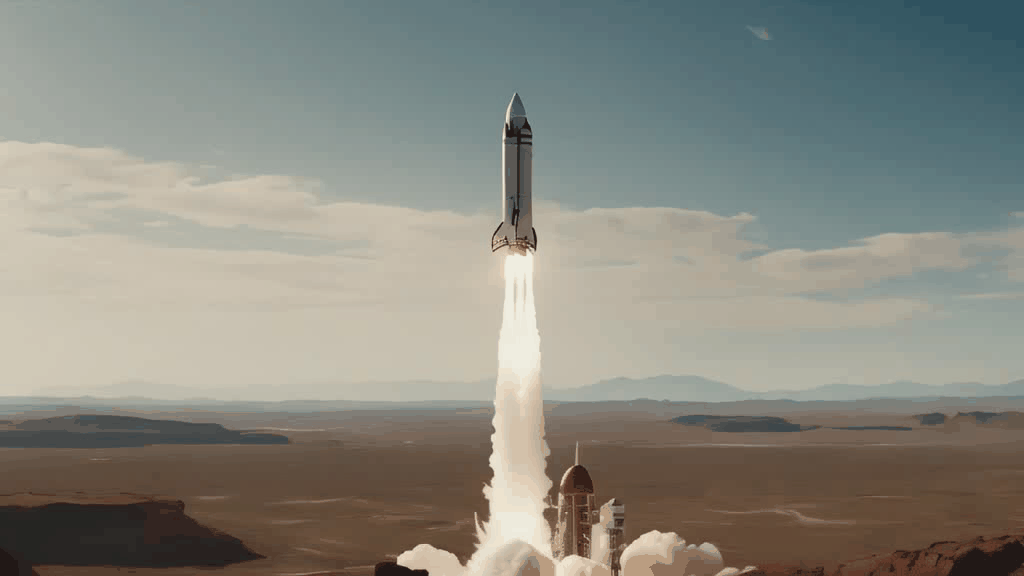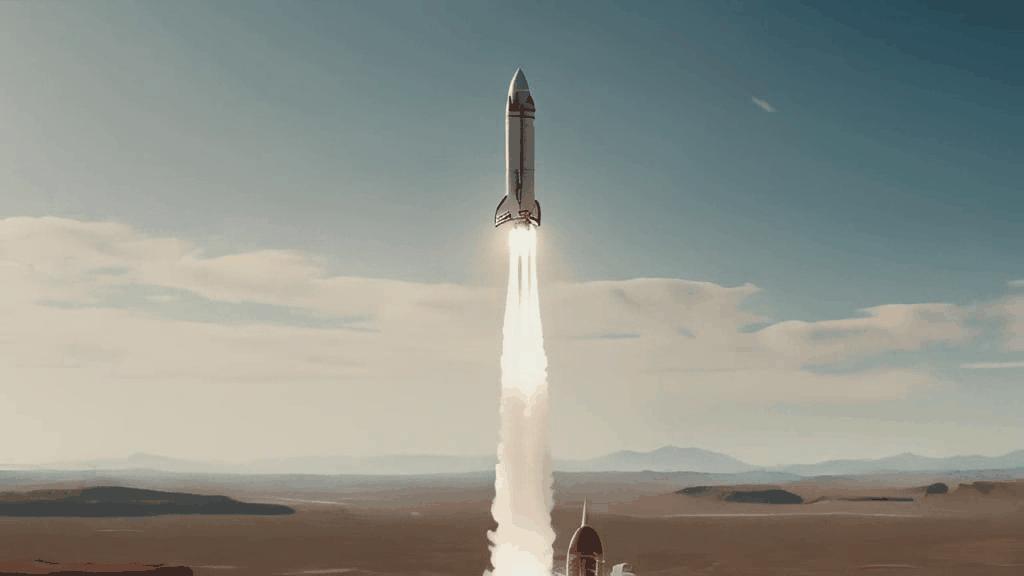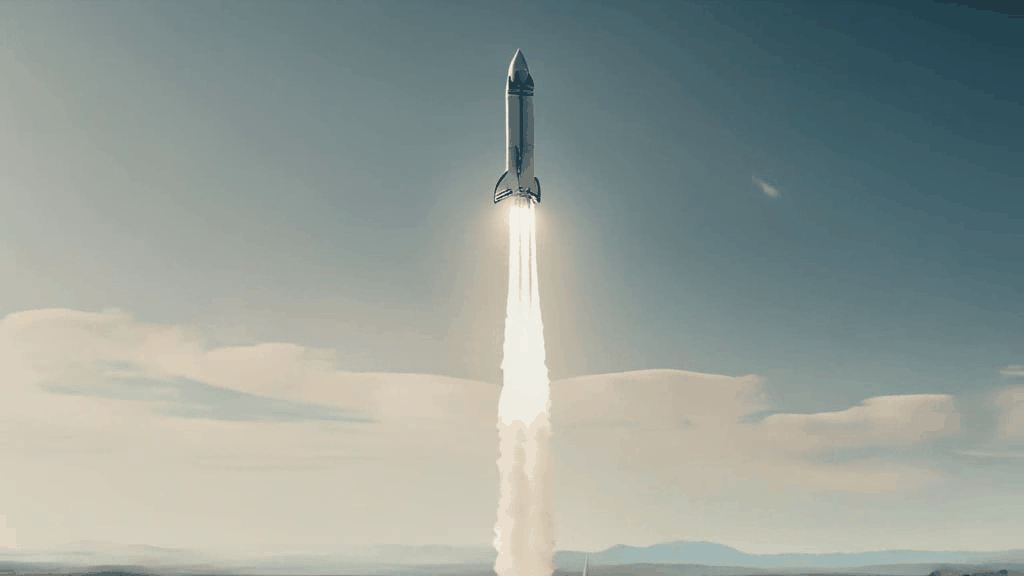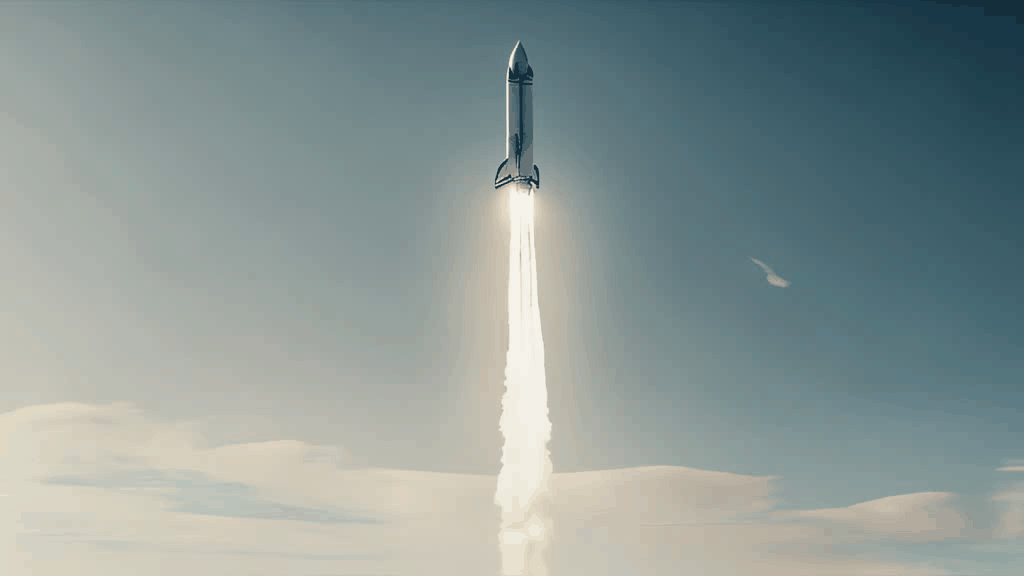 | |
| ## StableVideoDiffusionPipeline[[diffusers.StableVideoDiffusionPipeline]] | |
| #### diffusers.StableVideoDiffusionPipeline[[diffusers.StableVideoDiffusionPipeline]] | |
| ```python | |
| diffusers.StableVideoDiffusionPipeline(vae: AutoencoderKLTemporalDecoder, image_encoder: CLIPVisionModelWithProjection, unet: UNetSpatioTemporalConditionModel, scheduler: EulerDiscreteScheduler, feature_extractor: CLIPImageProcessorPil) | |
| ``` | |
| [المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/stable_video_diffusion/pipeline_stable_video_diffusion.py#L147) | |
| **المعاملات:** | |
| vae (`AutoencoderKLTemporalDecoder`) : نموذج الترميز التحويلي التلقائي (VAE) لتشفير الصور وفك تشفيرها إلى التمثيلات الكامنة ومنها. | |
| image_encoder ([CLIPVisionModelWithProjection](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPVisionModelWithProjection)) : مُشفِّر صور CLIP مجمّد ([laion/CLIP-ViT-H-14-laion2B-s32B-b79K](https://huggingface.co/laion/CLIP-ViT-H-14-laion2B-s32B-b79K)). | |
| unet (`UNetSpatioTemporalConditionModel`) : نموذج `UNetSpatioTemporalConditionModel` لإزالة الضوضاء من الكامنات المرمّزة للصور. | |
| scheduler ([EulerDiscreteScheduler](/docs/diffusers/main/ar/api/schedulers/euler#diffusers.EulerDiscreteScheduler)) : مُجدول يُستخدم بالاقتران مع `unet` لإزالة الضوضاء من كامنات الصورة المُرمّزة. | |
| feature_extractor ([CLIPImageProcessor](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPImageProcessor)) : مُعالج صور `CLIPImageProcessor` لاستخراج الميزات من الصور المولّدة. | |
| خط أنابيب لتوليد فيديو من صورة مدخلة باستخدام Stable Video Diffusion. | |
| يرث هذا النموذج من [DiffusionPipeline](/docs/diffusers/main/ar/api/pipelines/overview#diffusers.DiffusionPipeline). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة المُنفَّذة لجميع خطوط الأنابيب (التنزيل، الحفظ، التشغيل على جهاز معين، إلخ). | |
| ## StableVideoDiffusionPipelineOutput[[diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput]] | |
| #### diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput[[diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput]] | |
| ```python | |
| diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput(frames: typing.Union[list[list[PIL.Image.Image]], numpy.ndarray, torch.Tensor]) | |
| ``` | |
| [المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/stable_video_diffusion/pipeline_stable_video_diffusion.py#L134) | |
| **المعاملات:** | |
| frames (`[list[list[PIL.Image.Image]]`, `np.ndarray`, `torch.Tensor`]) : قائمة من صور PIL منزوعة الضوضاء بطول `batch_size` أو مصفوفة numpy أو tensor من torch بأبعاد `(batch_size, num_frames, height, width, num_channels)`. | |
| فئة الإخراج لخط أنابيب Stable Video Diffusion. | |
Xet Storage Details
- Size:
- 12 kB
- Xet hash:
- 50aa32a442f07e64a0f340f69fdb70ee83835167c8ede8b836dedb8a5abe3ff1
·
Xet efficiently stores files, intelligently splitting them into unique chunks and accelerating uploads and downloads. More info.