
Buckets:


| # Pipeline Stable Diffusion | |
| Stable Diffusion adalah model difusi laten dari teks ke gambar yang dibuat oleh peneliti dan insinyur dari [CompVis](https://github.com/CompVis), [Stability AI](https://stability.ai/), dan [LAION](https://laion.ai/). Difusi laten menerapkan proses difusi pada ruang laten berdimensi lebih rendah untuk mengurangi kompleksitas memori dan komputasi. Jenis model difusi spesifik ini diusulkan dalam [High-Resolution Image Synthesis with Latent Diffusion Models](https://huggingface.co/papers/2112.10752) oleh Robin Rombach, Andreas Blattmann, Dominik Lorenz, Patrick Esser, dan Björn Ommer. | |
| Stable Diffusion dilatih pada gambar 512x512 dari subset dataset LAION-5B. Model ini menggunakan text encoder CLIP ViT-L/14 yang dibekukan untuk mengondisikan model berdasarkan prompt teks. Dengan UNet 860M dan text encoder 123M, model ini relatif ringan dan dapat dijalankan pada GPU konsumen. | |
| Untuk detail lebih lanjut tentang cara kerja Stable Diffusion dan bagaimana perbedaannya dengan model latent diffusion dasar, lihat [pengumuman](https://stability.ai/blog/stable-diffusion-announcement) Stability AI dan [artikel blog](https://huggingface.co/blog/stable_diffusion#how-does-stable-diffusion-work) kami untuk detail teknis lebih lanjut. | |
| Anda dapat menemukan kodebase asli untuk Stable Diffusion v1.0 di [CompVis/stable-diffusion](https://github.com/CompVis/stable-diffusion) dan Stable Diffusion v2.0 di Stability-AI/stablediffusion, serta skrip asli mereka untuk berbagai tugas. Checkpoint resmi tambahan untuk berbagai versi dan tugas Stable Diffusion dapat ditemukan di organisasi [CompVis](https://huggingface.co/CompVis) dan [Stability AI](https://huggingface.co/stabilityai) di Hub. Jelajahi organisasi-organisasi ini untuk menemukan checkpoint terbaik untuk kasus penggunaan Anda! | |
| Tabel di bawah ini merangkum pipeline Stable Diffusion yang tersedia, tugas yang didukung, dan demo interaktif: | |
| Pipeline | |
| Tugas yang didukung | |
| 🤗 Space | |
| StableDiffusion | |
| teks-ke-gambar | |
| StableDiffusionImg2Img | |
| image-to-image | |
| StableDiffusionInpaint | |
| inpainting | |
| StableDiffusionDepth2Img | |
| depth-to-image | |
| StableDiffusionImageVariation | |
| variasi gambar | |
| StableDiffusionPipelineSafe (kadaluarsa; tidak ada halaman dokumentasi) | |
| teks-ke-gambar terfilter | |
| StableDiffusion2 | |
| teks-ke-gambar, inpainting, kedalaman-ke-gambar, super-resolusi | |
| StableDiffusionXL | |
| teks-ke-gambar, gambar-ke-gambar | |
| StableDiffusionLatentUpscale | |
| super-resolution | |
| StableDiffusionUpscale | |
| super-resolution | |
| StableDiffusionLDM3D | |
| teks-ke-rgb, teks-ke-kedalaman, teks-ke-pano | |
| StableDiffusionUpscaleLDM3D | |
| ldm3d super-resolution | |
| ## Tips | |
| Untuk membantu Anda memaksimalkan penggunaan pipeline Stable Diffusion, berikut adalah beberapa tips untuk meningkatkan kinerja dan kemudahan penggunaan. Tips ini berlaku untuk semua pipeline Stable Diffusion. | |
| ### Jelajahi tradeoff antara kecepatan dan kualitas | |
| [StableDiffusionPipeline](/docs/diffusers/main/id/api/pipelines/stable_diffusion/text2img#diffusers.StableDiffusionPipeline) menggunakan [PNDMScheduler](/docs/diffusers/main/id/api/schedulers/pndm#diffusers.PNDMScheduler) secara default, tetapi 🤗 Diffusers menyediakan banyak scheduler lain (beberapa di antaranya lebih cepat atau menghasilkan kualitas lebih baik) yang kompatibel. Misalnya, jika Anda ingin menggunakan [EulerDiscreteScheduler](/docs/diffusers/main/id/api/schedulers/euler#diffusers.EulerDiscreteScheduler) alih-alih default: | |
| ```py | |
| from diffusers import StableDiffusionPipeline, EulerDiscreteScheduler | |
| pipeline = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4") | |
| pipeline.scheduler = EulerDiscreteScheduler.from_config(pipeline.scheduler.config) | |
| # or | |
| euler_scheduler = EulerDiscreteScheduler.from_pretrained("CompVis/stable-diffusion-v1-4", subfolder="scheduler") | |
| pipeline = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4", scheduler=euler_scheduler) | |
| ``` | |
| ### Gunakan ulang komponen pipeline untuk menghemat memori | |
| Untuk menghemat memori dan menggunakan komponen yang sama di beberapa pipeline, gunakan metode `.components` untuk menghindari pemuatan bobot ke RAM lebih dari sekali. | |
| ```py | |
| from diffusers import ( | |
| StableDiffusionPipeline, | |
| StableDiffusionImg2ImgPipeline, | |
| StableDiffusionInpaintPipeline, | |
| ) | |
| text2img = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4") | |
| img2img = StableDiffusionImg2ImgPipeline(**text2img.components) | |
| inpaint = StableDiffusionInpaintPipeline(**text2img.components) | |
| # now you can use text2img(...), img2img(...), inpaint(...) just like the call methods of each respective pipeline | |
| ``` | |
| ### Buat demo web menggunakan `gradio` | |
| Pipeline Stable Diffusion didukung secara otomatis di [Gradio](https://github.com/gradio-app/gradio/), sebuah pustaka yang memudahkan pembuatan aplikasi machine learning yang indah dan ramah pengguna di web. Pertama, pastikan Anda telah menginstal Gradio: | |
| ```sh | |
| pip install -U gradio | |
| ``` | |
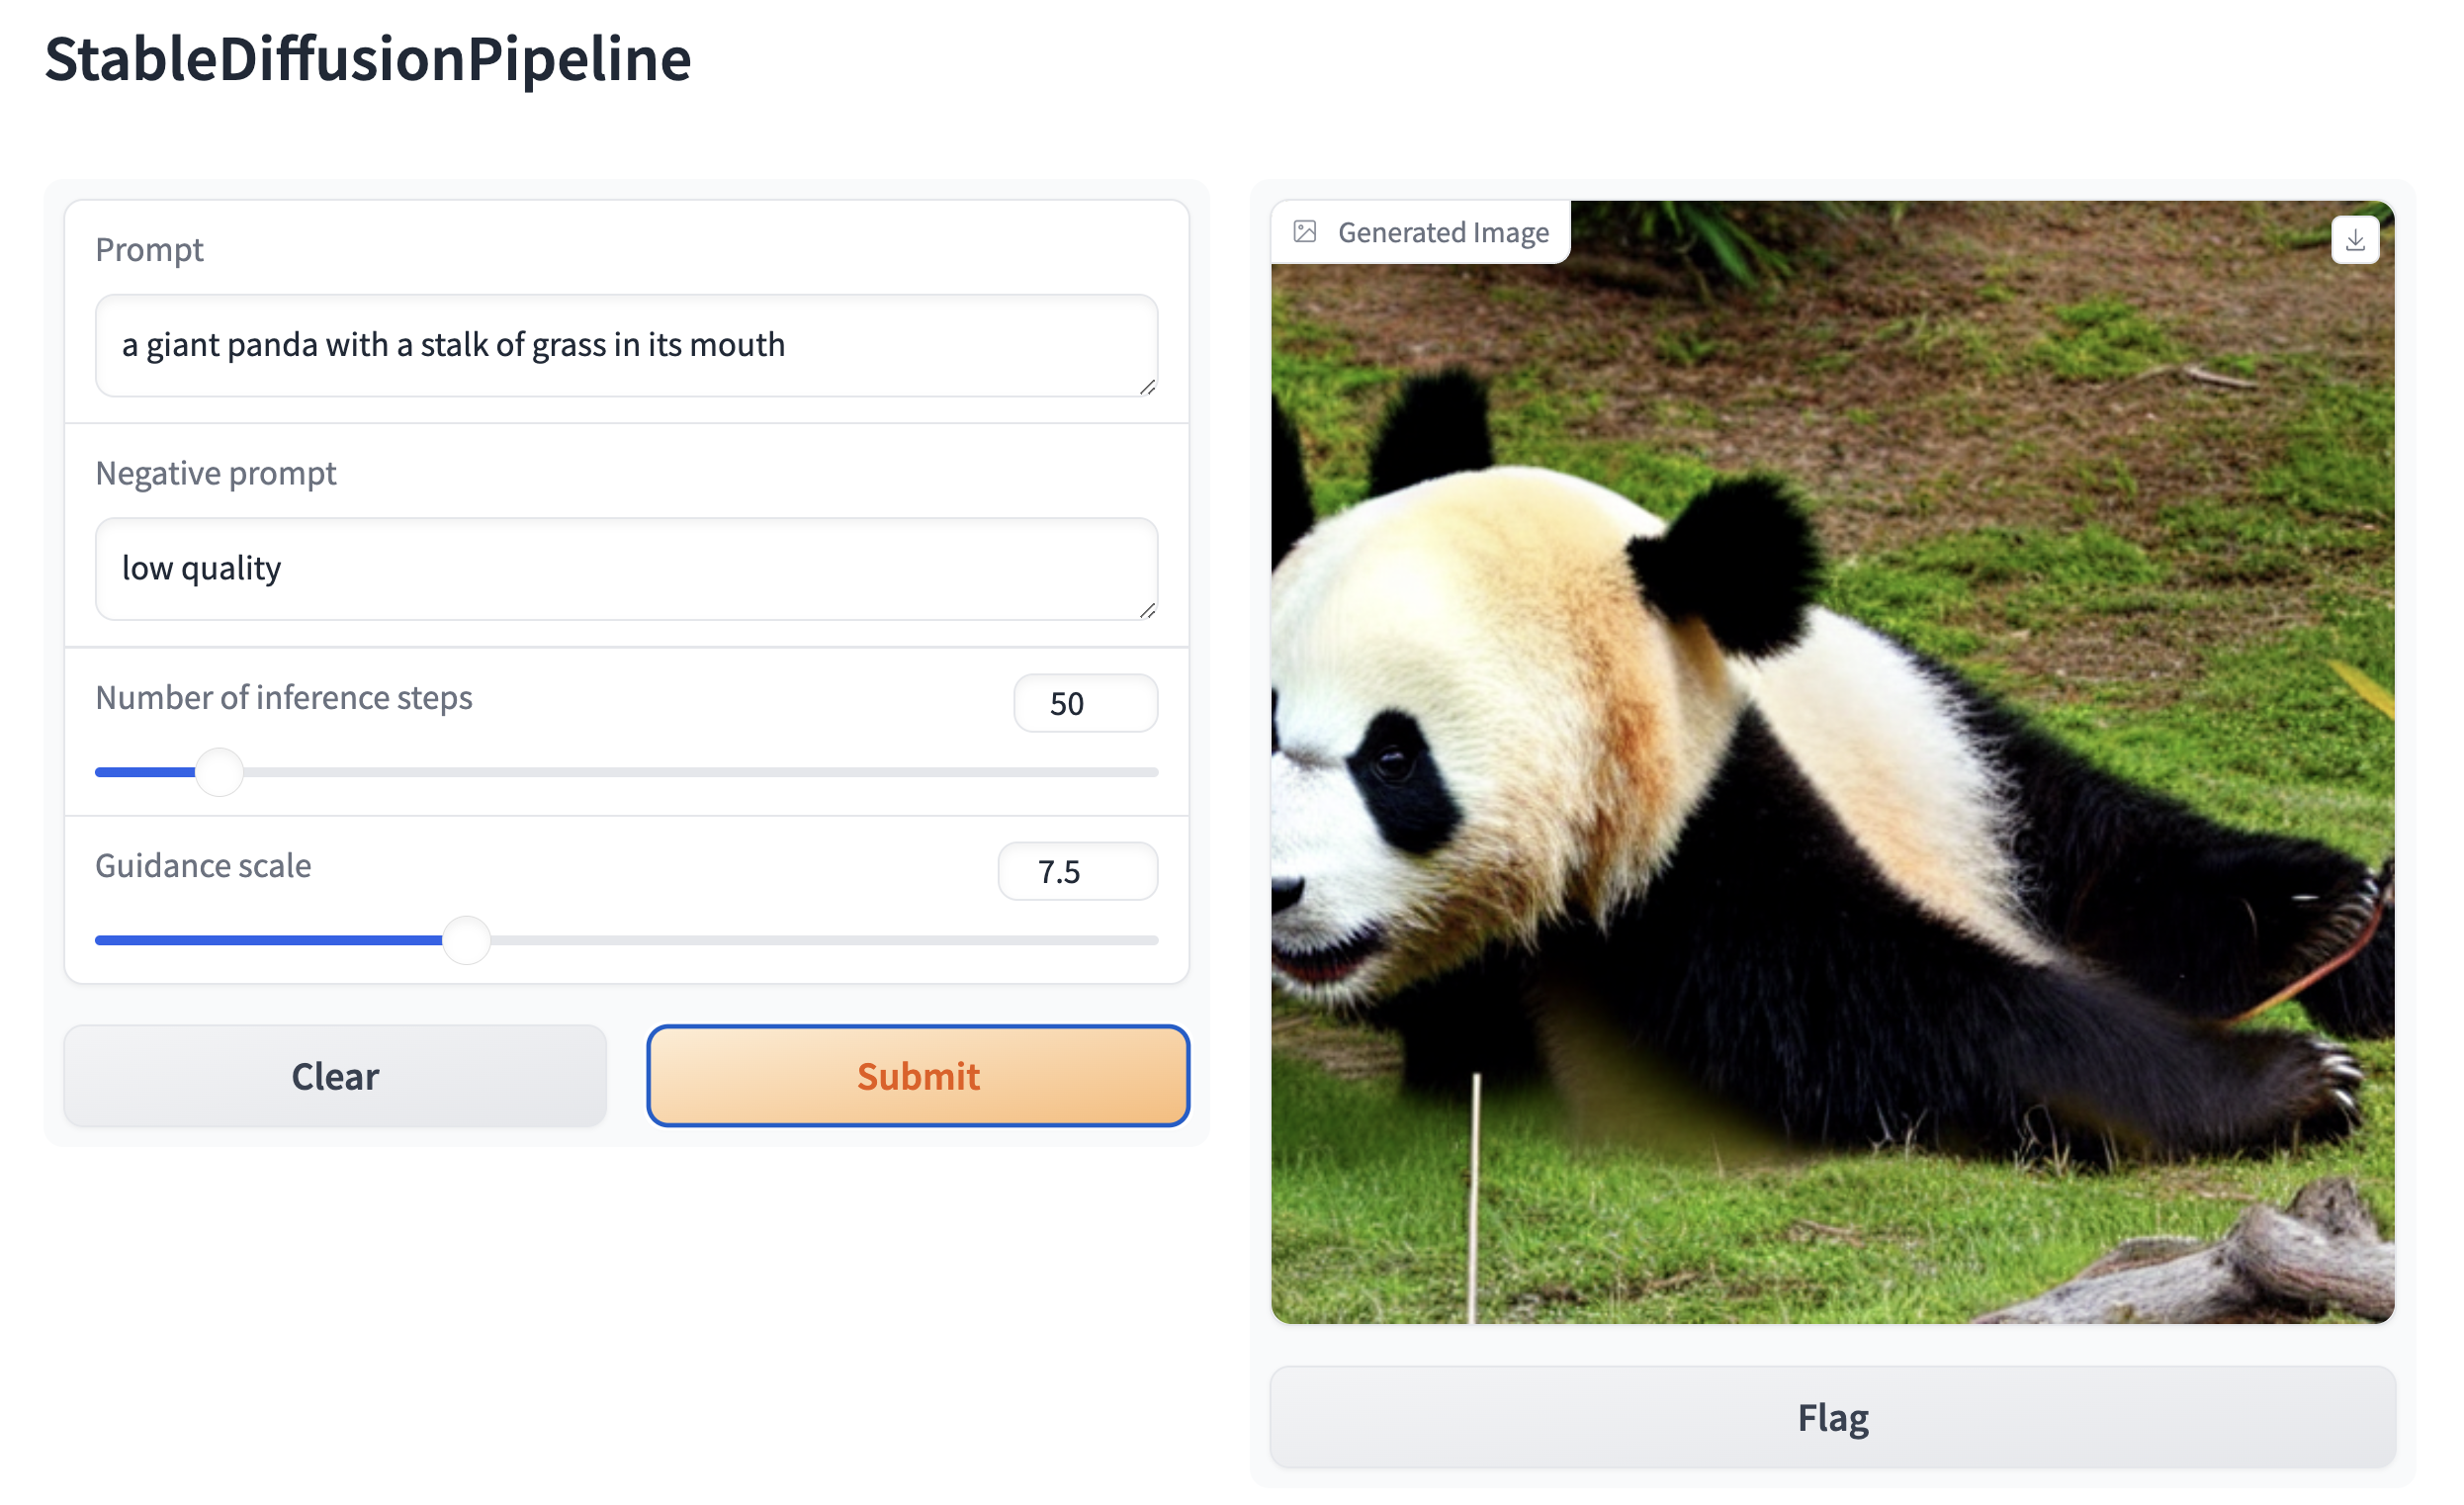
| Lalu, buat demo web di sekitar pipeline berbasis Stable Diffusion. Misalnya, Anda dapat membuat pipeline generasi gambar dalam satu baris kode dengan fungsi [`Interface.from_pipeline`](https://www.gradio.app/docs/interface#interface-from-pipeline) dari Gradio: | |
| ```py | |
| from diffusers import StableDiffusionPipeline | |
| import gradio as gr | |
| pipe = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4") | |
| gr.Interface.from_pipeline(pipe).launch() | |
| ``` | |
| yang membuka antarmuka drag-and-drop yang intuitif di browser Anda: | |
|  | |
| Demikian pula, Anda dapat membuat demo untuk pipeline image-to-image dengan: | |
| ```py | |
| from diffusers import StableDiffusionImg2ImgPipeline | |
| import gradio as gr | |
| pipe = StableDiffusionImg2ImgPipeline.from_pretrained("stable-diffusion-v1-5/stable-diffusion-v1-5") | |
| gr.Interface.from_pipeline(pipe).launch() | |
| ``` | |
| Secara default, demo web berjalan di server lokal. Jika Anda ingin membagikannya dengan orang lain, Anda dapat membuat tautan publik sementara dengan mengatur `share=True` di `launch()`. Atau, Anda dapat meng-host demo Anda di [Hugging Face Spaces](https://huggingface.co/spaces)https://huggingface.co/spaces untuk mendapatkan tautan permanen. | |
Xet Storage Details
- Size:
- 7.48 kB
- Xet hash:
- f7b0afc242ab95db92c2fba193752e5cafa01e6ee8eab37d2885ba9234b707e1
·
Xet efficiently stores files, intelligently splitting them into unique chunks and accelerating uploads and downloads. More info.