
Buckets:


| # Stable Video Diffusion | |
| Stable Video Diffusion は、Andreas Blattmann、Tim Dockhorn、Sumith Kulal、Daniel Mendelevitch、Maciej Kilian、Dominik Lorenz、Yam Levi、Zion English、Vikram Voleti、Adam Letts、Varun Jampani、Robin Rombach による [Stable Video Diffusion: Scaling Latent Video Diffusion Models to Large Datasets](https://hf.co/papers/2311.15127) で提案されました。 | |
| 論文の抄録は以下の通りです: | |
| *本稿では、Stable Video Diffusion を紹介します。これは、高解像度で最先端のテキストから動画へ、および画像から動画への生成を行う潜在空間動画拡散モデルです。近年、2D 画像合成のために学習された潜在拡散モデルは、時間レイヤーを挿入し、小規模かつ高品質な動画データセットでファインチューニングすることで、生成型動画モデルへと転換されています。しかし、文献中の学習手法は大きく異なり、動画データのキュレーションに関する統一された戦略については、まだ分野内で合意が得られていません。本稿では、動画 LDM の成功した学習のための 3 つの異なる段階を特定し、評価します。それは、テキストから画像への事前学習、動画の事前学習、そして高品質動画でのファインチューニングです。さらに、高品質な動画を生成するには、適切にキュレーションされた事前学習データセットが不可欠であることを示し、キャプション付けやフィルタリング戦略を含む、強力なベースモデルを学習するための体系的なキュレーションプロセスを提示します。その後、高品質なデータでベースモデルをファインチューニングすることの影響を調査し、クローズドソースの動画生成と競争力のあるテキストから動画へのモデルを学習します。また、ベースモデルが、画像から動画への生成や、カメラモーションに特化した LoRA モジュールへの適応性といった下流タスクに対して強力なモーション表現を提供すること、および、フィードフォワード方式でオブジェクトの複数のビューを同時に生成するマルチビュー拡散モデルのファインチューニングのベースとして機能し、計算予算のわずか一部で画像ベースの手法を上回ることを示します。コードとモデルの重みは、この https URL で公開しています。* | |
| > [!TIP] | |
| > [Stability AI](https://huggingface.co/stabilityai)のHub組織で、[base](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid)および[extended frame](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid-xt)のチェックポイントを確認してください! | |
| 以下のライブラリがインストールされていることを確認してください。 | |
| ```py | |
| # Uncomment to install the necessary libraries in Colab | |
| !pip install -q -U diffusers transformers accelerate | |
| ``` | |
| このモデルには、[SVD](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid)と[SVD-XT](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid-xt)という2つのバリアントがあります。SVDのチェックポイントは14フレームの生成用に学習されており、SVD-XTのチェックポイントは25フレームの生成用にさらにファインチューニングされています。 | |
| このガイドでは、SVD-XT チェックポイントを使用します。 | |
| ```python | |
| import torch | |
| from diffusers import StableVideoDiffusionPipeline | |
| from diffusers.utils import load_image, export_to_video | |
| pipe = StableVideoDiffusionPipeline.from_pretrained( | |
| "stabilityai/stable-video-diffusion-img2vid-xt", dtype=torch.float16, variant="fp16" | |
| ) | |
| pipe.enable_model_cpu_offload() | |
| # Load the conditioning image | |
| image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/svd/rocket.png") | |
| image = image.resize((1024, 576)) | |
| generator = torch.manual_seed(42) | |
| frames = pipe(image, decode_chunk_size=8, generator=generator).frames[0] | |
| export_to_video(frames, "generated.mp4", fps=7) | |
| ``` | |
| ロケットのソース画像 | |
| ソース画像から生成された動画 | |
| ## torch.compile | |
| UNetを[コンパイル](../../../optimization/fp16#torchcompile)することで、メモリ使用量がわずかに増加する代わりに、20〜25%の高速化が得られます。 | |
| ```diff | |
| - pipe.enable_model_cpu_offload() | |
| + pipe.to("cuda") # or "mps", "xpu", "cpu" | |
| + pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True) | |
| ``` | |
| ## メモリ使用量の削減 | |
| 動画生成は、`num_frames` を一度に生成するため、非常にメモリ集約的です。これは、大きなバッチサイズでテキストから画像を生成する場合に似ています。メモリ要件を削減するには、推論速度と引き換えにメモリ要件を下げる複数のオプションがあります。 | |
| - モデルのオフロードを有効化: パイプラインの各コンポーネントは、不要になった時点で CPU にオフロードされます。 | |
| - フィードフォワードチャンク分割を有効化します。これにより、巨大なバッチサイズで単一のフィードフォワードを実行する代わりに、フィードフォワード層がループ内で実行されます。 | |
| - `decode_chunk_size` を減らす: VAE は、すべてのフレームをまとめてデコードするのではなく、チャンク単位でフレームをデコードします。`decode_chunk_size=1` を設定すると、1 フレームずつデコードされ、メモリ使用量が最小になります(GPU メモリに応じてこの値を調整することをお勧めします)が、動画にちらつきが生じる可能性があります。 | |
| ```diff | |
| - pipe.enable_model_cpu_offload() | |
| - frames = pipe(image, decode_chunk_size=8, generator=generator).frames[0] | |
| + pipe.enable_model_cpu_offload() | |
| + pipe.unet.enable_forward_chunking() | |
| + frames = pipe(image, decode_chunk_size=2, generator=generator, num_frames=25).frames[0] | |
| ``` | |
| これらのテクニックをすべて組み合わせることで、VRAMの必要量は8GB未満に低下するはずです。 | |
| ## マイクロ条件付け | |
| Stable Diffusion Video は、条件付け画像に加えて、マイクロ条件付けも受け入れるため、生成される動画に対してより詳細な制御を行うことができます。 | |
| - `fps`: 生成される動画の秒あたりのフレーム数。 | |
| - `motion_bucket_id`: 生成される動画で使用するモーションバケットIDです。これにより、生成される動画の動きを制御できます。モーションバケットIDを大きくすると、生成される動画の動きが大きくなります。 | |
| - `noise_aug_strength`: 条件付け画像に追加されるノイズの量。値が大きいほど、生成される動画は条件付け画像に似なくなります。また、この値を上げると、生成される動画の動きも大きくなります。 | |
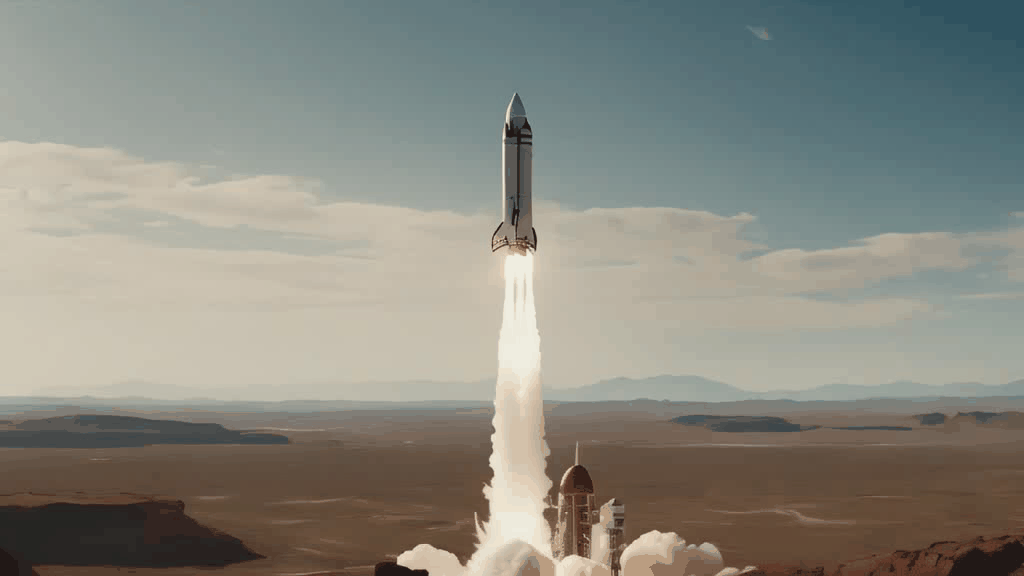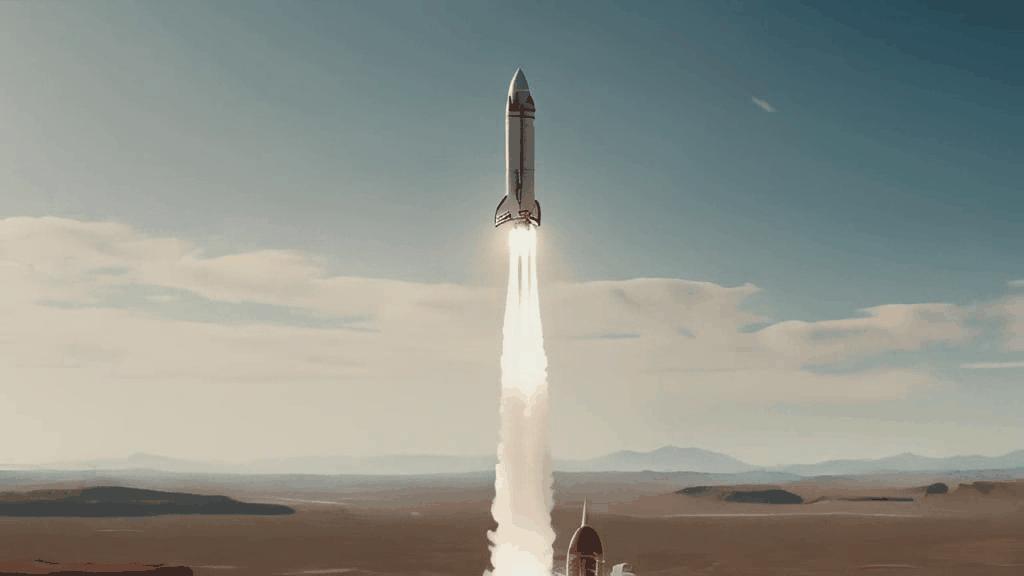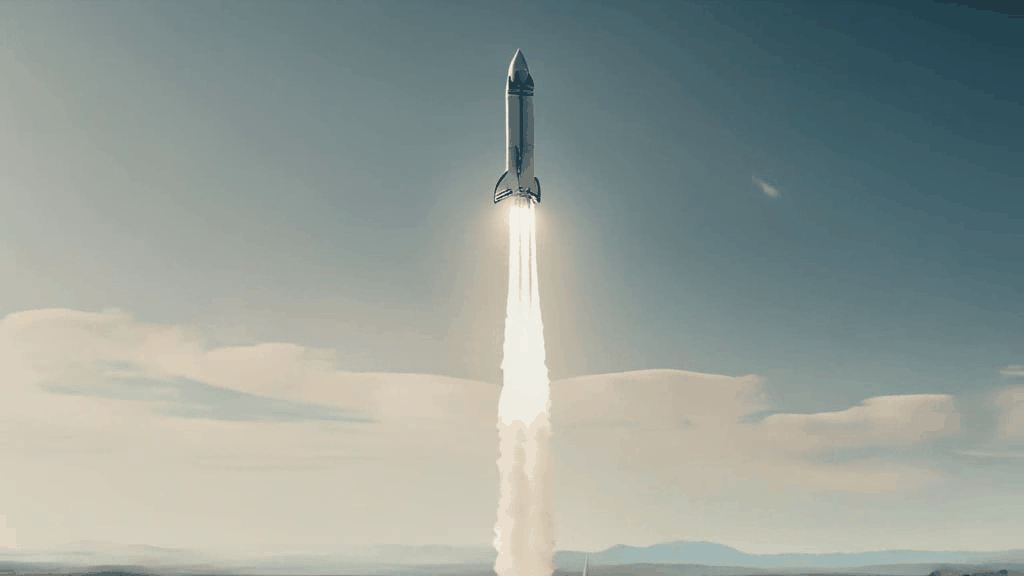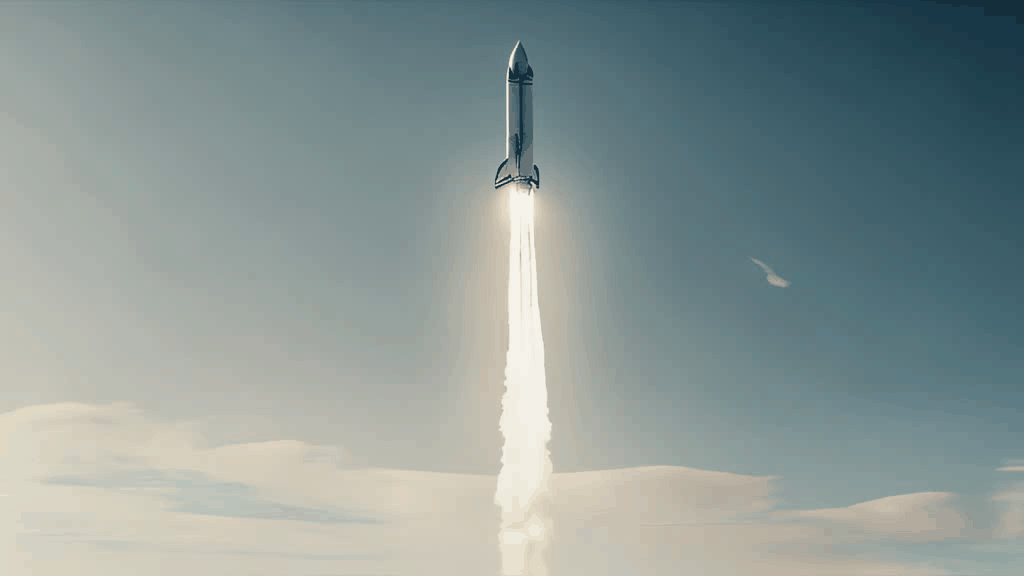
| 例えば、より動きのある動画を生成するには、`motion_bucket_id`および`noise_aug_strength`というマイクロ条件付けパラメータを使用します。 | |
| ```python | |
| import torch | |
| from diffusers import StableVideoDiffusionPipeline | |
| from diffusers.utils import load_image, export_to_video | |
| pipe = StableVideoDiffusionPipeline.from_pretrained( | |
| "stabilityai/stable-video-diffusion-img2vid-xt", dtype=torch.float16, variant="fp16" | |
| ) | |
| pipe.enable_model_cpu_offload() | |
| # Load the conditioning image | |
| image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/svd/rocket.png") | |
| image = image.resize((1024, 576)) | |
| generator = torch.manual_seed(42) | |
| frames = pipe(image, decode_chunk_size=8, generator=generator, motion_bucket_id=180, noise_aug_strength=0.1).frames[0] | |
| export_to_video(frames, "generated.mp4", fps=7) | |
| ``` | |
|  | |
| ## StableVideoDiffusionPipeline[[diffusers.StableVideoDiffusionPipeline]] | |
| #### diffusers.StableVideoDiffusionPipeline[[diffusers.StableVideoDiffusionPipeline]] | |
| ```python | |
| diffusers.StableVideoDiffusionPipeline(vae: AutoencoderKLTemporalDecoder, image_encoder: CLIPVisionModelWithProjection, unet: UNetSpatioTemporalConditionModel, scheduler: EulerDiscreteScheduler, feature_extractor: CLIPImageProcessorPil) | |
| ``` | |
| [ソース](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/stable_video_diffusion/pipeline_stable_video_diffusion.py#L147) | |
| **パラメータ:** | |
| vae (`AutoencoderKLTemporalDecoder`) : 画像を潜在表現にエンコードし、潜在表現からデコードするための変分オートエンコーダ(VAE)モデルです。 | |
| image_encoder ([CLIPVisionModelWithProjection](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPVisionModelWithProjection)) : 凍結された CLIP 画像エンコーダー ([laion/CLIP-ViT-H-14-laion2B-s32B-b79K](https://huggingface.co/laion/CLIP-ViT-H-14-laion2B-s32B-b79K))。 | |
| unet (`UNetSpatioTemporalConditionModel`) : エンコードされた画像の潜在変数をノイズ除去するための `UNetSpatioTemporalConditionModel` です。 | |
| scheduler ([EulerDiscreteScheduler](/docs/diffusers/main/ja/api/schedulers/euler#diffusers.EulerDiscreteScheduler)) : `unet`と組み合わせて、エンコードされた画像の潜在変数からノイズを除去するために使用するスケジューラ。 | |
| feature_extractor ([CLIPImageProcessor](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPImageProcessor)) : 生成された画像から特徴量を抽出するための`CLIPImageProcessor`。 | |
| Stable Video Diffusion を使用して入力画像から動画を生成するための Pipeline。 | |
| このモデルは [DiffusionPipeline](/docs/diffusers/main/ja/api/pipelines/overview#diffusers.DiffusionPipeline) を継承しています。すべてのパイプラインに実装されている汎用的なメソッド(ダウンロード、保存、特定のデバイスでの実行など)については、スーパークラスのドキュメントを参照してください。 | |
| ## StableVideoDiffusionPipelineOutput[[diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput]] | |
| #### diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput[[diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput]] | |
| ```python | |
| diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput(frames: typing.Union[list[list[PIL.Image.Image]], numpy.ndarray, torch.Tensor]) | |
| ``` | |
| [ソース](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/stable_video_diffusion/pipeline_stable_video_diffusion.py#L134) | |
| **パラメータ:** | |
| frames (`[list[list[PIL.Image.Image]]`, `np.ndarray`, `torch.Tensor`]) : 長さ`batch_size`のデノイズ済みPIL画像のリスト、または形状`(batch_size, num_frames, height, width, num_channels)`のnumpy配列またはtorchテンソル。 | |
| Stable Video Diffusion パイプライン用の出力クラスです。 | |
Xet Storage Details
- Size:
- 11.5 kB
- Xet hash:
- fb6aa71fcc53aaa89dbb85729bbf238a4ce7d1adcd1f887bf4b0b266056019b2
·
Xet efficiently stores files, intelligently splitting them into unique chunks and accelerating uploads and downloads. More info.