
Buckets:


| # Stable Video Diffusion | |
| Stable Video Diffusion foi proposto em [Stable Video Diffusion: Scaling Latent Video Diffusion Models to Large Datasets](https://hf.co/papers/2311.15127) por Andreas Blattmann, Tim Dockhorn, Sumith Kulal, Daniel Mendelevitch, Maciej Kilian, Dominik Lorenz, Yam Levi, Zion English, Vikram Voleti, Adam Letts, Varun Jampani, Robin Rombach. | |
| O resumo do artigo é: | |
| *Apresentamos o Stable Video Diffusion - um modelo de difusão latente para vídeo, voltado à geração de vídeos em alta resolução, com estado da arte, a partir de texto e de imagem. Recentemente, modelos de difusão latente treinados para síntese de imagens 2D foram convertidos em modelos generativos de vídeo por meio da inserção de camadas temporais e do ajuste fino em pequenos conjuntos de dados de vídeo de alta qualidade. No entanto, os métodos de treinamento na literatura variam amplamente e a área ainda não chegou a um consenso sobre uma estratégia unificada para a curadoria de dados de vídeo. Neste artigo, identificamos e avaliamos três estágios distintos para o treinamento bem-sucedido de LDMs de vídeo: pré-treino de texto para imagem, pré-treino de vídeo e ajuste fino em vídeos de alta qualidade. Além disso, demonstramos a necessidade de um conjunto de dados de pré-treino bem curado para gerar vídeos de alta qualidade e apresentamos um processo sistemático de curadoria para treinar um modelo base robusto, incluindo estratégias de legendagem e filtragem. Em seguida, exploramos o impacto do ajuste fino do nosso modelo base em dados de alta qualidade e treinamos um modelo de texto para vídeo que é competitivo com a geração de vídeo de código fechado. Também mostramos que nosso modelo base fornece uma representação de movimento poderosa para tarefas de nível inferior, como a geração de vídeo a partir de imagem, e adaptabilidade a módulos LoRA específicos para movimento de câmera. Por fim, demonstramos que nosso modelo fornece um forte prior 3D multiview e pode servir como base para ajustar um modelo de difusão multiview que gera simultaneamente múltiplas vistas de objetos de forma feedforward, superando métodos baseados em imagem com uma fração do seu orçamento de computação. Liberamos o código e os pesos do modelo neste https URL.* | |
| > [!TIP] | |
| > Confira a organização [Stability AI](https://huggingface.co/stabilityai) no Hub para os checkpoints de [base](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid) e [extended frame](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid-xt)! | |
| Certifique-se de que as seguintes bibliotecas estão instaladas. | |
| ```py | |
| # Uncomment to install the necessary libraries in Colab | |
| !pip install -q -U diffusers transformers accelerate | |
| ``` | |
| Existem duas variantes deste modelo, [SVD](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid) e [SVD-XT](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid-xt). O checkpoint SVD é treinado para gerar 14 quadros e o checkpoint SVD-XT é ajustado finamente para gerar 25 quadros. | |
| Você usará o checkpoint SVD-XT para este guia. | |
| ```python | |
| import torch | |
| from diffusers import StableVideoDiffusionPipeline | |
| from diffusers.utils import load_image, export_to_video | |
| pipe = StableVideoDiffusionPipeline.from_pretrained( | |
| "stabilityai/stable-video-diffusion-img2vid-xt", dtype=torch.float16, variant="fp16" | |
| ) | |
| pipe.enable_model_cpu_offload() | |
| # Load the conditioning image | |
| image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/svd/rocket.png") | |
| image = image.resize((1024, 576)) | |
| generator = torch.manual_seed(42) | |
| frames = pipe(image, decode_chunk_size=8, generator=generator).frames[0] | |
| export_to_video(frames, "generated.mp4", fps=7) | |
| ``` | |
| "imagem de origem de um foguete" | |
| "vídeo gerado a partir da imagem de origem" | |
| ## torch.compile | |
| Você pode obter um aumento de velocidade de 20-25% às custas de um leve aumento de memória ao [compilar](../../../optimization/fp16#torchcompile) o UNet. | |
| ```diff | |
| - pipe.enable_model_cpu_offload() | |
| + pipe.to("cuda") # or "mps", "xpu", "cpu" | |
| + pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True) | |
| ``` | |
| ## Reduzir o uso de memória | |
| A geração de vídeo é muito intensiva em memória, pois você está essencialmente gerando `num_frames` de uma só vez, semelhante à geração de imagem a partir de texto com um tamanho de lote alto. Para reduzir o requisito de memória, existem várias opções que trocam a velocidade de inferência por um menor requisito de memória: | |
| - ativar o offloading do modelo: cada componente do pipeline é transferido para a CPU assim que não for mais necessário. | |
| - ative o chunking do feed-forward: a camada feed-forward é executada em um loop, em vez de executar um único feed-forward com um tamanho de lote enorme. | |
| - reduza `decode_chunk_size`: o VAE decodifica os quadros em blocos, em vez de decodificá-los todos de uma vez. Definir `decode_chunk_size=1` decodifica um quadro de cada vez e usa a menor quantidade de memória (recomendamos ajustar esse valor com base na memória da sua GPU), mas o vídeo pode apresentar algum efeito de cintilação. | |
| ```diff | |
| - pipe.enable_model_cpu_offload() | |
| - frames = pipe(image, decode_chunk_size=8, generator=generator).frames[0] | |
| + pipe.enable_model_cpu_offload() | |
| + pipe.unet.enable_forward_chunking() | |
| + frames = pipe(image, decode_chunk_size=2, generator=generator, num_frames=25).frames[0] | |
| ``` | |
| Usar todos esses truques juntos deve reduzir o requisito de memória para menos de 8 GB de VRAM. | |
| ## Micro-condicionamento | |
| O Stable Diffusion Video também aceita micro-condicionamento, além da imagem de condicionamento, o que permite mais controle sobre o vídeo gerado: | |
| - `fps`: os quadros por segundo do vídeo gerado. | |
| - `motion_bucket_id`: o id do bucket de movimento a ser usado para o vídeo gerado. Isso pode ser usado para controlar o movimento do vídeo gerado. Aumentar o id do bucket de movimento aumenta o movimento do vídeo gerado. | |
| - `noise_aug_strength`: a quantidade de ruído adicionada à imagem de condicionamento. Quanto maiores os valores, menos o vídeo se assemelha à imagem de condicionamento. Aumentar esse valor também aumenta o movimento do vídeo gerado. | |
| Por exemplo, para gerar um vídeo com mais movimento, use os parâmetros de microcondicionamento `motion_bucket_id` e `noise_aug_strength`: | |
| ```python | |
| import torch | |
| from diffusers import StableVideoDiffusionPipeline | |
| from diffusers.utils import load_image, export_to_video | |
| pipe = StableVideoDiffusionPipeline.from_pretrained( | |
| "stabilityai/stable-video-diffusion-img2vid-xt", dtype=torch.float16, variant="fp16" | |
| ) | |
| pipe.enable_model_cpu_offload() | |
| # Load the conditioning image | |
| image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/svd/rocket.png") | |
| image = image.resize((1024, 576)) | |
| generator = torch.manual_seed(42) | |
| frames = pipe(image, decode_chunk_size=8, generator=generator, motion_bucket_id=180, noise_aug_strength=0.1).frames[0] | |
| export_to_video(frames, "generated.mp4", fps=7) | |
| ``` | |
| 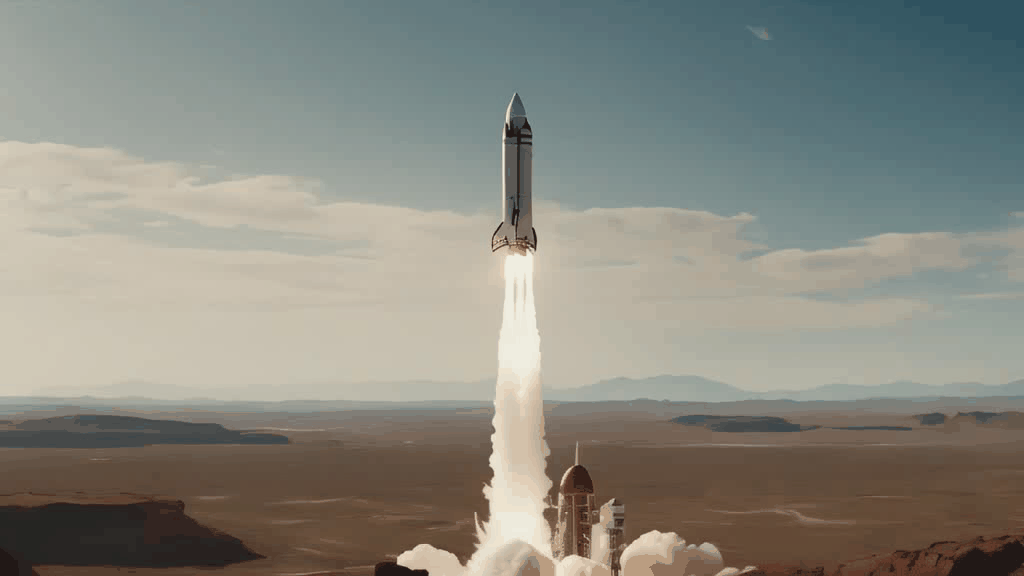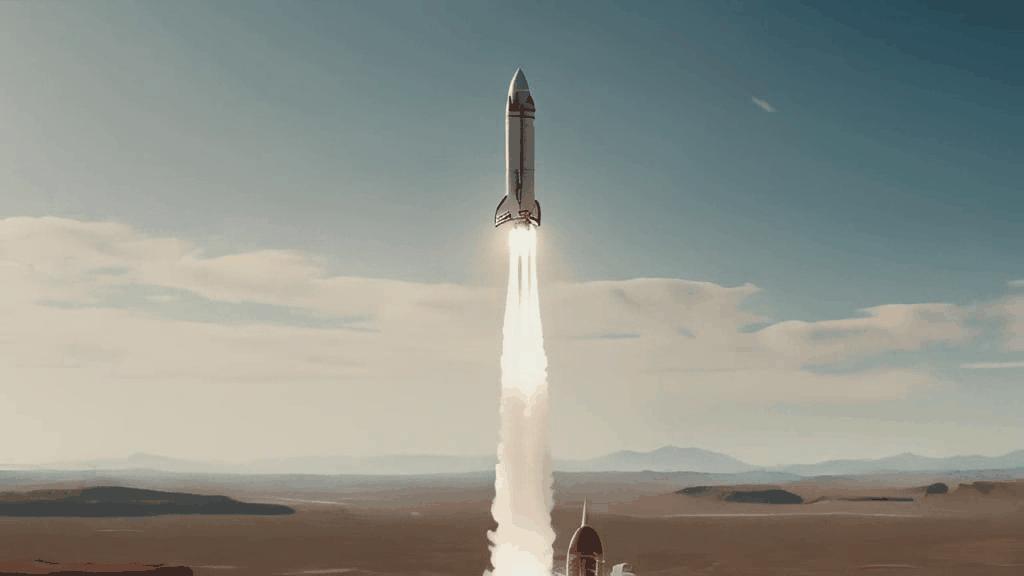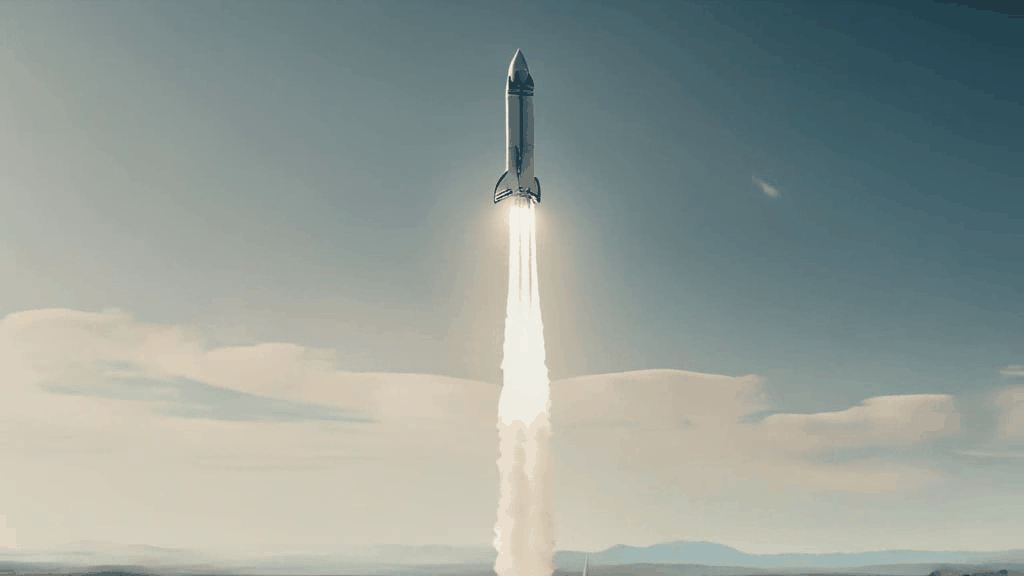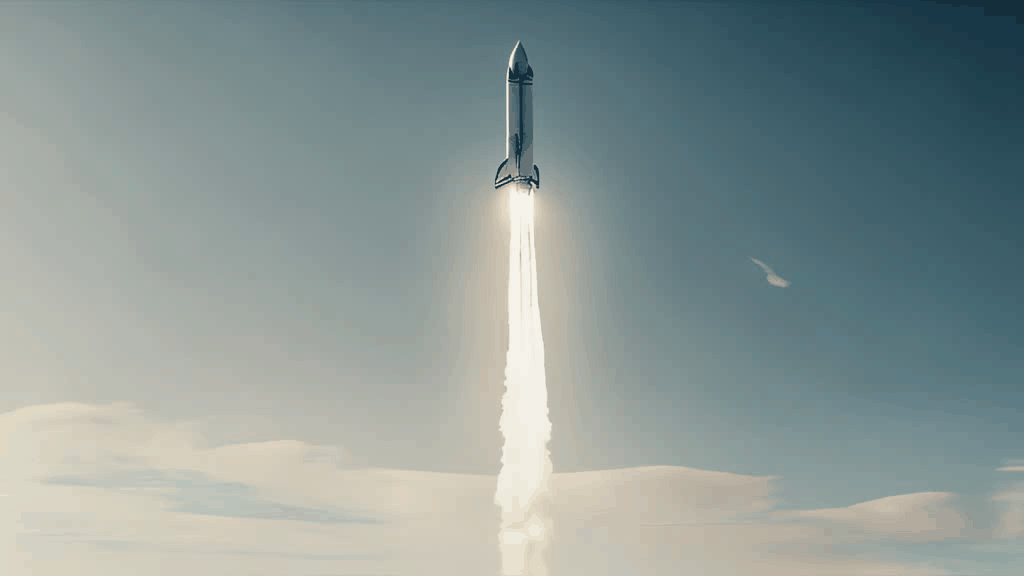 | |
| ## StableVideoDiffusionPipeline[[diffusers.StableVideoDiffusionPipeline]] | |
| #### diffusers.StableVideoDiffusionPipeline[[diffusers.StableVideoDiffusionPipeline]] | |
| ```python | |
| diffusers.StableVideoDiffusionPipeline(vae: AutoencoderKLTemporalDecoder, image_encoder: CLIPVisionModelWithProjection, unet: UNetSpatioTemporalConditionModel, scheduler: EulerDiscreteScheduler, feature_extractor: CLIPImageProcessorPil) | |
| ``` | |
| [Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/stable_video_diffusion/pipeline_stable_video_diffusion.py#L147) | |
| **Parâmetros:** | |
| vae (`AutoencoderKLTemporalDecoder`) : Modelo de Autoencoder Variacional (VAE) para codificar e decodificar imagens para e a partir de representações latentes. | |
| image_encoder ([CLIPVisionModelWithProjection](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPVisionModelWithProjection)) : codificador de imagem CLIP congelado ([laion/CLIP-ViT-H-14-laion2B-s32B-b79K](https://huggingface.co/laion/CLIP-ViT-H-14-laion2B-s32B-b79K)). | |
| unet (`UNetSpatioTemporalConditionModel`) : Um `UNetSpatioTemporalConditionModel` para desruidar os latentes de imagem codificados. | |
| scheduler ([EulerDiscreteScheduler](/docs/diffusers/main/pt/api/schedulers/euler#diffusers.EulerDiscreteScheduler)) : Um agendador a ser usado em combinação com `unet` para desruidar os latentes da imagem codificada. | |
| feature_extractor ([CLIPImageProcessor](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPImageProcessor)) : Um `CLIPImageProcessor` para extrair recursos de imagens geradas. | |
| Pipeline para gerar vídeo a partir de uma imagem de entrada usando Stable Video Diffusion. | |
| Este modelo herda de [DiffusionPipeline](/docs/diffusers/main/pt/api/pipelines/overview#diffusers.DiffusionPipeline). Consulte a documentação da superclasse para os métodos genéricos implementados para todos os pipelines (download, salvamento, execução em um dispositivo específico, etc.). | |
| ## StableVideoDiffusionPipelineOutput[[diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput]] | |
| #### diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput[[diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput]] | |
| ```python | |
| diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput(frames: typing.Union[list[list[PIL.Image.Image]], numpy.ndarray, torch.Tensor]) | |
| ``` | |
| [Fonte](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/stable_video_diffusion/pipeline_stable_video_diffusion.py#L134) | |
| **Parâmetros:** | |
| frames (`[list[list[PIL.Image.Image]]`, `np.ndarray`, `torch.Tensor`]) : lista de imagens PIL desruidas de comprimento `batch_size` ou array numpy ou tensor torch de forma `(batch_size, num_frames, height, width, num_channels)`. | |
| Classe de saída para o pipeline Stable Video Diffusion. | |
Xet Storage Details
- Size:
- 10.2 kB
- Xet hash:
- 56787024b0af976cde0ce1ae35c7c9282bf2ab19a88b1abb8ee98b561ae908d3
·
Xet efficiently stores files, intelligently splitting them into unique chunks and accelerating uploads and downloads. More info.