
Buckets:


PixArt-α
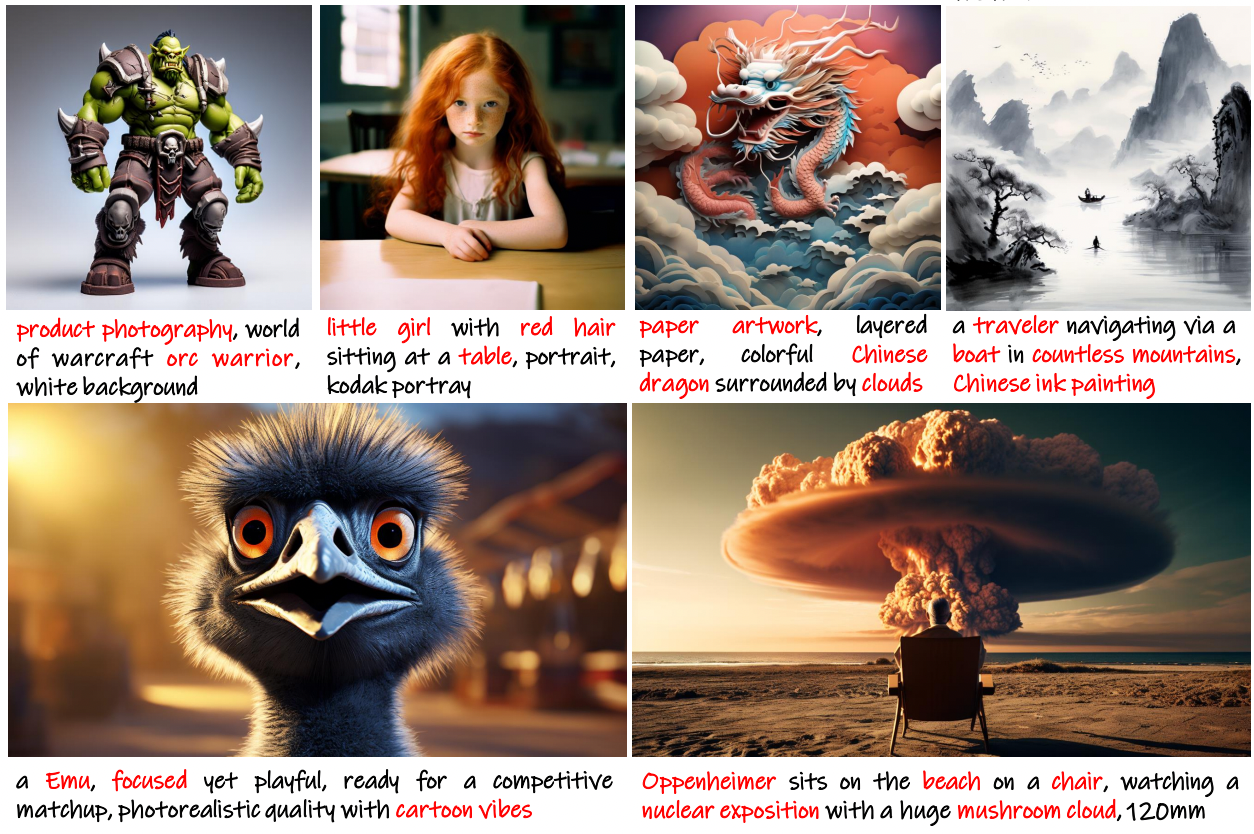
PixArt-α: Fast Training of Diffusion Transformer for Photorealistic Text-to-Image Synthesis, Junsong Chen, Jincheng Yu, Chongjian Ge, Lewei Yao, Enze Xie, Yue Wu, Zhongdao Wang, James Kwok, Ping Luo, Huchuan Lu ve Zhenguo Li tarafından kaleme alınmıştır.
Makalenin özeti şudur:
En gelişmiş metinden görüntüye (T2I) modelleri, önemli eğitim maliyetleri gerektirir (ör. milyonlarca GPU saati); bu durum, AIGC topluluğu için temel yenilikleri ciddi şekilde engellerken CO2 emisyonlarını da artırır. Bu makale, PIXART-α'yı tanıtır; bu, Transformer tabanlı bir T2I difüzyon modelidir ve görüntü üretim kalitesi, en son görüntü üreticileriyle (ör. Imagen, SDXL ve hatta Midjourney) rekabet edebilir, neredeyse ticari uygulama standartlarına ulaşır. Ayrıca, Şekil 1 ve 2'de gösterildiği gibi, düşük eğitim maliyetiyle 1024px çözünürlüğe kadar yüksek çözünürlüklü görüntü sentezini destekler. Bu hedefe ulaşmak için üç temel tasarım önerilmektedir: (1) Eğitim stratejisi ayrıştırması: Piksel bağımlılığını, metin-görüntü hizalamasını ve görüntü estetik kalitesini ayrı ayrı optimize eden üç ayrı eğitim adımı geliştiriyoruz; (2) Verimli T2I Transformer: Metin koşullarını enjekte etmek ve hesaplama yoğun sınıf koşullu dalı sadeleştirmek için Diffusion Transformer (DiT) içine çapraz dikkat modülleri entegre ediyoruz; (3) Yüksek bilgilendirici veri: Metin-görüntü çiftlerinde kavram yoğunluğunun önemini vurguluyor ve metin-görüntü hizalama öğrenmesine yardımcı olmak için yoğun sahte açıklamaları otomatik olarak etiketlemek için büyük bir Vision-Language modelinden yararlanıyoruz. Sonuç olarak, PIXART-α'nın eğitim hızı, mevcut büyük ölçekli T2I modellerini belirgin şekilde geride bırakır; örneğin, PIXART-α yalnızca Stable Diffusion v1.5'in eğitim süresinin %10,8'ini (675'e karşı 6.250 A100 GPU günü) alır, neredeyse 300.000 $ tasarruf sağlar (26.000 $'a karşı 320.000 $) ve %90 CO2 emisyonunu azaltır. Ayrıca, daha büyük bir SOTA modeli olan RAPHAEL ile karşılaştırıldığında, eğitim maliyetimiz yalnızca %1'dir. Kapsamlı deneyler, PIXART-α'nın görüntü kalitesi, sanatsallık ve semantik kontrolde üstün olduğunu göstermektedir. PIXART-α'nın, AIGC topluluğuna ve girişimcilere, sıfırdan kendi yüksek kaliteli ve düşük maliyetli üretken modellerini oluşturmalarını hızlandırmak için yeni içgörüler sağlayacağını umuyoruz.
Orijinal kod tabanını PixArt-alpha/PixArt-alpha adresinde ve kullanılabilir tüm kontrol noktalarını PixArt-alpha adresinde bulabilirsiniz.
Bu boru hattı hakkında bazı notlar:
- Gürültü azaltma için bir Transformer omurgası (UNet yerine) kullanır. Bu nedenle mimarisi DiT ile benzerdir.
- T5'ten hesaplanan metin koşulları kullanılarak eğitildi. Bu özellik, boru hattının karmaşık ve ince detaylara sahip metin istemlerini takip etme konusunda daha iyi olmasını sağlar.
- Farklı en-boy oranlarında yüksek çözünürlüklü görüntüler üretmede başarılıdır. En iyi sonuçları almak için yazarlar, burada bulunabilecek bazı boyut aralıklarını önermektedir.
- Bu sistem, Stable Diffusion XL, Imagen ve DALL-E 2 gibi (bu yazı kaleme alındığında) son teknoloji metinden görüntüye üretim sistemleriyle yarışan bir kaliteye sahipken onlardan daha verimlidir.
Scheduler'lar kılavuzunu inceleyerek scheduler hızı ve kalitesi arasındaki ödünleşimi nasıl keşfedebileceğinizi öğrenin ve aynı bileşenleri birden fazla pipeline'a nasıl verimli bir şekilde yükleyebileceğinizi öğrenmek için pipeline'lar arasında bileşenleri yeniden kullanma bölümüne göz atın.
8 GB'dan az GPU VRAM ile çıkarım
PixArtAlphaPipeline'yi, metin kodlayıcıyı 8-bit hassasiyette yükleyerek 8 GB'ın altındaki GPU VRAM ile çalıştırın. Tam kapsamlı bir örneğin üzerinden birlikte geçelim.
Öncelikle bitsandbytes kütüphanesini yükleyin:
pip install -U bitsandbytes
Ardından metin kodlayıcıyı 8-bit olarak yükleyin:
from transformers import T5EncoderModel
from diffusers import PixArtAlphaPipeline
import torch

text_encoder = T5EncoderModel.from_pretrained(
    "PixArt-alpha/PixArt-XL-2-1024-MS",
    subfolder="text_encoder",
    load_in_8bit=True,
    device_map="auto",

)
pipe = PixArtAlphaPipeline.from_pretrained(
    "PixArt-alpha/PixArt-XL-2-1024-MS",
    text_encoder=text_encoder,
    transformer=None,
    device_map="auto"
)
Şimdi, bir istemci kodlamak için pipe kullanın:
with torch.no_grad():
    prompt = "cute cat"
    prompt_embeds, prompt_attention_mask, negative_embeds, negative_prompt_attention_mask = pipe.encode_prompt(prompt)
Metin gömme değerleri hesaplandığından, text_encoder ve pipe nesnelerini bellekten kaldırın ve GPU VRAM'de yer açın:
import gc

def flush():
    gc.collect()
    torch.cuda.empty_cache()

del text_encoder
del pipe
flush()
Ardından, prompt gömme değerlerini girdi olarak kullanarak latentleri hesaplayın:
pipe = PixArtAlphaPipeline.from_pretrained(
    "PixArt-alpha/PixArt-XL-2-1024-MS",
    text_encoder=None,
    dtype=torch.float16,
).to("cuda")  # or "mps", "xpu", "cpu"

latents = pipe(
    negative_prompt=None,
    prompt_embeds=prompt_embeds,
    negative_prompt_embeds=negative_embeds,
    prompt_attention_mask=prompt_attention_mask,
    negative_prompt_attention_mask=negative_prompt_attention_mask,
    num_images_per_prompt=1,
    output_type="latent",
).images

del pipe.transformer
flush()
pipebaşlatılırken, yüklenmemesi içintext_encoder'inNoneolarak ayarlandığına dikkat edin.
Latentler hesaplandıktan sonra, bunları gerçek bir görüntüye dönüştürmek için VAE'ye iletin:
with torch.no_grad():
    image = pipe.vae.decode(latents / pipe.vae.config.scaling_factor, return_dict=False)[0]
image = pipe.image_processor.postprocess(image, output_type="pil")[0]
image.save("cat.png")
Kullanmadığınız bileşenleri silerek ve GPU VRAM'i boşaltarak, PixArtAlphaPipeline'ı 8GB'ın altındaki GPU VRAM ile çalıştırabileceksiniz.
Hafıza kullanımınızın bir raporunu istiyorsanız, bu betiği çalıştırın.
8-bit olarak hesaplanan metin gömlemleri, azaltılmış hassasiyetin temsil uzayında neden olduğu bilgi kaybı nedeniyle üretilen görüntülerin kalitesini etkileyebilir. 8-bit ile ve 8-bit olmadan çıktıları karşılaştırmak önerilir.
text_encoder yüklenirken load_in_8bit parametresini True olarak ayarladınız. Bellek gereksinimlerinizi 7GB'ın altına düşürmek için load_in_4bit parametresini de belirleyebilirsiniz.
PixArtAlphaPipeline[[diffusers.PixArtAlphaPipeline]]
diffusers.PixArtAlphaPipeline[[diffusers.PixArtAlphaPipeline]]
diffusers.PixArtAlphaPipeline(tokenizer: T5Tokenizer, text_encoder: T5EncoderModel, vae: AutoencoderKL, transformer: PixArtTransformer2DModel, scheduler: DPMSolverMultistepScheduler)
Parametreler:
vae (AutoencoderKL) : Görüntüleri gizil (latent) temsillere kodlamak ve bu temsillerden görüntülere çözmek için kullanılan Varyasyonel Oto-Kodlayıcı (VAE) Modeli.
text_encoder (T5EncoderModel) : Donmuş metin kodlayıcı. PixArt-Alpha, T5'i, özellikle de t5-v1_1-xxl varyantını kullanır.
tokenizer (T5Tokenizer) : T5Tokenizer sınıfının tokenizer'ı.
transformer (PixArtTransformer2DModel) : Kodlanmış görüntü latentlerini gürültüden arındırmak için metin koşullu bir PixArtTransformer2DModel. Yapılandırmada başlangıçta Transformer2DModel olarak yayınlandı, ancak bu uyumsuzluk göz ardı edilebilir.
scheduler (SchedulerMixin) : Kodlanmış görüntü latentlerini gürültüden arındırmak için transformer ile birlikte kullanılacak bir zamanlayıcı.
PixArt-Alpha kullanarak metinden görüntüye üretim için Pipeline.
Bu model DiffusionPipeline sınıfından devralır. Kütüphanenin tüm pipeline'lar için uyguladığı genel yöntemler (indirme veya kaydetme, belirli bir cihazda çalıştırma vb.) için üst sınıf belgelendirmesine bakın.
call[[diffusers.PixArtAlphaPipeline.call]]
__call__(prompt: str | list[str] = None, negative_prompt: str = '', num_inference_steps: int = 20, timesteps: list = None, sigmas: list = None, guidance_scale: float = 4.5, num_images_per_prompt: int | None = 1, height: int | None = None, width: int | None = None, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, prompt_attention_mask: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_attention_mask: typing.Optional[torch.Tensor] = None, output_type: str | None = 'pil', return_dict: bool = True, callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = None, callback_steps: int = 1, clean_caption: bool = True, use_resolution_binning: bool = True, max_sequence_length: int = 120, **kwargs)
Parametreler:
prompt (str veya list[str], isteğe bağlı) : Görsel üretimi yönlendirmek için istem veya istemler. Tanımlanmamışsa, bunun yerine prompt_embeds geçirilmelidir.
negative_prompt (str veya list[str], isteğe bağlı) : Görsel üretimi yönlendirmemek için kullanılan istem veya istemler. Tanımlanmazsa, bunun yerine negative_prompt_embeds parametresinin geçirilmesi gerekir. Yönlendirme kullanılmadığında (yani guidance_scale değeri 1'den küçükse) yok sayılır.
num_inference_steps (int, isteğe bağlı, varsayılan 100) : Gürültü azaltma adım sayısı. Daha fazla gürültü azaltma adımı genellikle daha yavaş çıkarım pahasına daha yüksek kaliteli bir görüntüye yol açar.
timesteps (list[int], isteğe bağlı) : set_timesteps metodunda timesteps argümanını destekleyen zamanlayıcılarla gürültü azaltma süreci için kullanılacak özel zaman adımları. Tanımlanmamışsa, num_inference_steps geçirildiğinde varsayılan davranış kullanılacaktır. Azalan sırada olmalıdır.
sigmas (list[float], isteğe bağlı) : set_timesteps metodunda sigmas argümanını destekleyen zamanlayıcılarla gürültü azaltma süreci için kullanılacak özel sigmalar. Tanımlanmamışsa, num_inference_steps geçirildiğinde varsayılan davranış kullanılacaktır.
guidance_scale (float, isteğe bağlı, varsayılan 4.5) : Classifier-Free Diffusion Guidance'de tanımlandığı gibi yönlendirme ölçeği. guidance_scale, Imagen Paper'deki 2. denklemindeki w olarak tanımlanır. Yönlendirme ölçeği, guidance_scale > 1 olarak ayarlanarak etkinleştirilir. Daha yüksek yönlendirme ölçeği, genellikle daha düşük görüntü kalitesi pahasına, prompt ile yakından ilişkili görüntülerin üretilmesini teşvik eder.
num_images_per_prompt (int, isteğe bağlı, varsayılan 1) : Her istem için üretilecek görsel sayısı.
height (int, isteğe bağlı, varsayılan: self.unet.config.sample_size) : Üretilen görüntünün piksel cinsinden yüksekliği.
width (int, isteğe bağlı, varsayılan: self.unet.config.sample_size) : Üretilen görüntünün piksel cinsinden genişliği.
eta (float, isteğe bağlı, varsayılan 0.0) : DDIM makalesindeki eta (η) parametresine karşılık gelir: https://huggingface.co/papers/2010.02502. Yalnızca schedulers.DDIMScheduler için geçerlidir, diğerlerinde yok sayılır.
generator (torch.Generator veya list[torch.Generator], isteğe bağlı) : Üretimi deterministik hale getirmek için bir veya torch üreteci(leri) listesi.
latents (torch.Tensor, isteğe bağlı) : Görsel üretimi için girdi olarak kullanılacak, Gauss dağılımından örneklenen önceden oluşturulmuş gürültülü latentler. Farklı istemlerle aynı üretimi ayarlamak için kullanılabilir. Sağlanmazsa, sağlanan rastgele generator kullanılarak örneklem yoluyla bir latent tensörü oluşturulur.
prompt_embeds (torch.Tensor, isteğe bağlı) : Ön oluşturulmuş metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, metin gömme değerleri prompt girdi argümanından oluşturulur.
prompt_attention_mask (torch.Tensor, isteğe bağlı) : Metin gömme (embedding) için önceden oluşturulmuş dikkat maskesi (attention mask).
negative_prompt_embeds (torch.Tensor, isteğe bağlı) : Önceden oluşturulmuş negatif metin gömme değerleri. PixArt-Alpha için bu negatif istem "" olmalıdır. Sağlanmazsa, negative_prompt_embeds, negative_prompt girdi argümanından oluşturulur.
negative_prompt_attention_mask (torch.Tensor, isteğe bağlı) : Negatif metin gömme vektörleri için önceden oluşturulmuş dikkat maskesi.
output_type (str, isteğe bağlı, varsayılan "pil") : Üretilen görüntünün çıktı biçimi. PIL: PIL.Image.Image veya np.array arasında seçim yapın.
return_dict (bool, isteğe bağlı, varsayılan True) : Düz bir tuple yerine ~pipelines.stable_diffusion.IFPipelineOutput döndürülecek mi?
callback (Callable, isteğe bağlı) : Çıkarım sırasında her callback_steps adımda çağrılacak bir işlev. İşlev aşağıdaki argümanlarla çağrılacaktır: callback(step: int, timestep: int, latents: torch.Tensor).
callback_steps (int, opsiyonel, varsayılan 1) : callback fonksiyonunun çağrılma sıklığı. Belirtilmezse, callback her adımda çağrılır.
clean_caption (bool, isteğe bağlı, varsayılan True) : Embedding oluşturulmadan önce başlığın temizlenip temizlenmeyeceğini belirtir. Bunun için beautifulsoup4 ve ftfy paketlerinin yüklü olması gerekir. Bağımlılıklar yüklü değilse, embedding'ler ham istemden oluşturulur.
use_resolution_binning (bool varsayılan olarak True) : True olarak ayarlanırsa, istenen yükseklik ve genişlik önce ASPECT_RATIO_1024_BIN kullanılarak en yakın çözünürlüklere eşlenir. Oluşturulan latentler görüntülere çözümlendikten sonra, istenen çözünürlüğe yeniden boyutlandırılır. Kare olmayan görüntüler üretmek için faydalıdır.
max_sequence_length (int varsayılan olarak 120'dir) : prompt ile kullanılacak maksimum dizi uzunluğu.
Dönüş: ImagePipelineOutput veya tuple
return_dict True ise ImagePipelineOutput döndürülür, aksi halde ilk öğesi üretilen görüntülerin listesini içeren bir tuple döndürülür
Üretim için pipeline çağrıldığında tetiklenen işlev.
Örnekler:
>>> import torch
>>> from diffusers import PixArtAlphaPipeline

>>> # You can replace the checkpoint id with "PixArt-alpha/PixArt-XL-2-512x512" too.
>>> pipe = PixArtAlphaPipeline.from_pretrained("PixArt-alpha/PixArt-XL-2-1024-MS", torch_dtype=torch.float16)
>>> # Enable memory optimizations.
>>> pipe.enable_model_cpu_offload()

>>> prompt = "A small cactus with a happy face in the Sahara desert."
>>> image = pipe(prompt).images[0]
encode_prompt[[diffusers.PixArtAlphaPipeline.encode_prompt]]
encode_prompt(prompt: str | list[str], do_classifier_free_guidance: bool = True, negative_prompt: str = '', num_images_per_prompt: int = 1, device: typing.Optional[torch.device] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, prompt_attention_mask: typing.Optional[torch.Tensor] = None, negative_prompt_attention_mask: typing.Optional[torch.Tensor] = None, clean_caption: bool = False, max_sequence_length: int = 120, **kwargs)
Parametreler:
prompt (str veya list[str], isteğe bağlı) : kodlanacak istem
negative_prompt (str veya list[str], isteğe bağlı) : Görsel üretimi yönlendirmemek için kullanılan istem. Tanımlanmadıysa bunun yerine negative_prompt_embeds parametresinin geçirilmesi gerekir. Yönlendirme kullanılmadığında (yani guidance_scale değeri 1'den küçükse) yok sayılır. PixArt-Alpha için bu değer "" olmalıdır.
do_classifier_free_guidance (bool, isteğe bağlı, varsayılan True) : sınıflandırıcı serbest yönlendirmenin (classifier free guidance) kullanılıp kullanılmayacağı
num_images_per_prompt (int, isteğe bağlı, varsayılan 1) : her istem için oluşturulacak görsel sayısı
device : (torch.device, isteğe bağlı): Sonuç olarak elde edilen gömme vektörlerinin yerleştirileceği torch cihazı
prompt_embeds (torch.Tensor, isteğe bağlı) : Ön oluşturulmuş metin gömme değerleri. Metin girdilerini kolayca ayarlamak için kullanılabilir, ör. istem ağırlıklandırması. Sağlanmazsa, metin gömme değerleri prompt girdi argümanından oluşturulur.
negative_prompt_embeds (torch.Tensor, isteğe bağlı) : Önceden oluşturulmuş negatif metin gömümlemeleri. PixArt-Alpha için, "" dizgisinin gömümlemeleri olmalıdır.
clean_caption (bool, varsayılan False) : True ise, fonksiyon kodlamadan önce sağlanan başlığı ön işler ve temizler.
max_sequence_length (int, varsayılan 120) : İstem için kullanılacak maksimum dizi uzunluğu.
İsteği metin kodlayıcı gizli durumlarına kodlar.
Xet Storage Details
- Size:
- 19.9 kB
- Xet hash:
- 93c0932c706c3948eba0a4756b0dbd07d2f103d18f8dcd8550b0b39c7ef4b16e
Xet efficiently stores files, intelligently splitting them into unique chunks and accelerating uploads and downloads. More info.