
Buckets:


| # Stable Video Diffusion | |
| Stable Video Diffusion, Andreas Blattmann, Tim Dockhorn, Sumith Kulal, Daniel Mendelevitch, Maciej Kilian, Dominik Lorenz, Yam Levi, Zion English, Vikram Voleti, Adam Letts, Varun Jampani ve Robin Rombach tarafından [Stable Video Diffusion: Scaling Latent Video Diffusion Models to Large Datasets](https://hf.co/papers/2311.15127) makalesinde önerilmiştir. | |
| Makalenin özeti şudur: | |
| *Stable Video Diffusion'u sunuyoruz: yüksek çözünürlüklü, en iyi düzeyde metinden videoya ve görüntüden videoya üretim için gizli video difüzyon modeli. Son zamanlarda, 2B görüntü sentezi için eğitilen gizli difüzyon modelleri, zaman katmanlarının eklenmesi ve küçük, yüksek kaliteli video veri kümeleri üzerinde ince ayar yapılmasıyla üretken video modellerine dönüştürüldü. Ancak, literatürdeki eğitim yöntemleri büyük ölçüde farklılık göstermekte ve alan, video verisi küratörlüğü için birleşik bir strateji üzerinde henüz uzlaşmaya varmamıştır. Bu makalede, video LDM'lerinin başarılı eğitimi için üç farklı aşamayı belirleyip değerlendiriyoruz: metinden görüntüye ön eğitim, video ön eğitimi ve yüksek kaliteli video ince ayarı. Ayrıca, yüksek kaliteli videolar üretmek için iyi küratörlük edilmiş bir ön eğitim veri kümesinin gerekliliğini gösteriyor ve güçlü bir temel model eğitmek için sistematik bir küratörlük süreci sunuyoruz; bu süreç, altyazılama ve filtreleme stratejilerini içermektedir. Ardından, temel modelimizi yüksek kaliteli veriler üzerinde ince ayar yapmanın etkisini inceliyor ve kapalı kaynak video üretimiyle rekabet edebilen bir metinden videoya model eğitiyoruz. Ayrıca, temel modelimizin görüntüden videoya üretim ve kamera hareketine özgü LoRA modüllerine uyumluluk gibi aşağı akış görevleri için güçlü bir hareket temsili sağladığını gösteriyoruz. Son olarak, modelimizin güçlü bir çoklu görünüm 3B-önceli sağladığını ve nesnelerin birden fazla görünümünü ileri besleme (feedforward) biçiminde birlikte üreten, görüntü tabanlı yöntemleri kendi hesaplama bütçelerinin küçük bir kısmıyla geride bırakan bir çoklu görünüm difüzyon modelini ince ayarlamak için bir temel olarak hizmet edebileceğini gösteriyoruz. Kodu ve model ağırlıklarını bu https URL adresinde yayınlıyoruz.* | |
| > [!TIP] | |
| > [Stability AI](https://huggingface.co/stabilityai) Hub organizasyonunu [base](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid) ve [extended frame](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid-xt) checkpoint'leri için inceleyin! | |
| Aşağıdaki kütüphanelerin yüklü olduğundan emin olun. | |
| ```py | |
| # Uncomment to install the necessary libraries in Colab | |
| !pip install -q -U diffusers transformers accelerate | |
| ``` | |
| Bu modelin [SVD](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid) ve [SVD-XT](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid-xt) olmak üzere iki varyantı vardır. SVD checkpoint'i 14 kare üretmek üzere eğitilirken SVD-XT checkpoint'i 25 kare üretmek üzere daha fazla ince ayarlanmıştır. | |
| Bu kılavuzda SVD-XT kontrol noktasını kullanacaksınız. | |
| ```python | |
| import torch | |
| from diffusers import StableVideoDiffusionPipeline | |
| from diffusers.utils import load_image, export_to_video | |
| pipe = StableVideoDiffusionPipeline.from_pretrained( | |
| "stabilityai/stable-video-diffusion-img2vid-xt", dtype=torch.float16, variant="fp16" | |
| ) | |
| pipe.enable_model_cpu_offload() | |
| # Load the conditioning image | |
| image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/svd/rocket.png") | |
| image = image.resize((1024, 576)) | |
| generator = torch.manual_seed(42) | |
| frames = pipe(image, decode_chunk_size=8, generator=generator).frames[0] | |
| export_to_video(frames, "generated.mp4", fps=7) | |
| ``` | |
| "bir roketin kaynak görüntüsü" | |
| kaynak görüntüden üretilen video | |
| ## torch.compile | |
| UNet'i [derleyerek](../../../optimization/fp16#torchcompile) hafif bir bellek artışı pahasına %20-25 hızlanma elde edebilirsiniz. | |
| ```diff | |
| - pipe.enable_model_cpu_offload() | |
| + pipe.to("cuda") # or "mps", "xpu", "cpu" | |
| + pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True) | |
| ``` | |
| ## Bellek kullanımını azaltın | |
| Video üretimi, yüksek bir batch boyutuyla metinden görüntüye üretimde olduğu gibi, `num_frames` değerindeki tüm kareleri aynı anda ürettiğiniz için çok fazla bellek gerektirir. Bellek gereksinimini azaltmak için, çıkarım hızından ödün vererek daha düşük bellek gereksinimi sağlayan birden fazla seçenek mevcuttur: | |
| - model offloading etkinleştirme: pipeline'ın her bileşeni, artık ihtiyaç duyulmadığında CPU'ya taşınır. | |
| - feed-forward chunking'i etkinleştirin: feed-forward katmanı, devasa bir batch boyutuyla tek bir feed-forward çalıştırmak yerine bir döngü içinde çalışır. | |
| - `decode_chunk_size` değerini azaltın: VAE, kareleri birlikte çözmek yerine parçalar halinde çözer. `decode_chunk_size=1` olarak ayarlamak, kareleri tek tek çözer ve en az belleği kullanır (GPU belleğinize göre bu değeri ayarlamanızı öneririz) ancak videoda bazı titremeler görülebilir. | |
| ```diff | |
| - pipe.enable_model_cpu_offload() | |
| - frames = pipe(image, decode_chunk_size=8, generator=generator).frames[0] | |
| + pipe.enable_model_cpu_offload() | |
| + pipe.unet.enable_forward_chunking() | |
| + frames = pipe(image, decode_chunk_size=2, generator=generator, num_frames=25).frames[0] | |
| ``` | |
| Tüm bu teknikleri birlikte kullanmak, bellek gereksinimini 8 GB VRAM'in altına indirmelidir. | |
| ## Mikro-konumlama | |
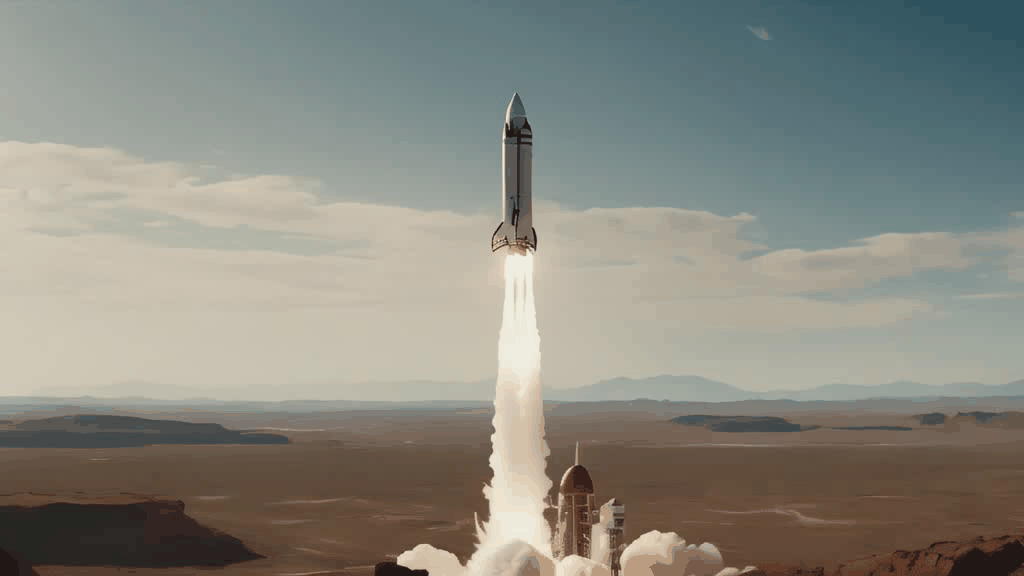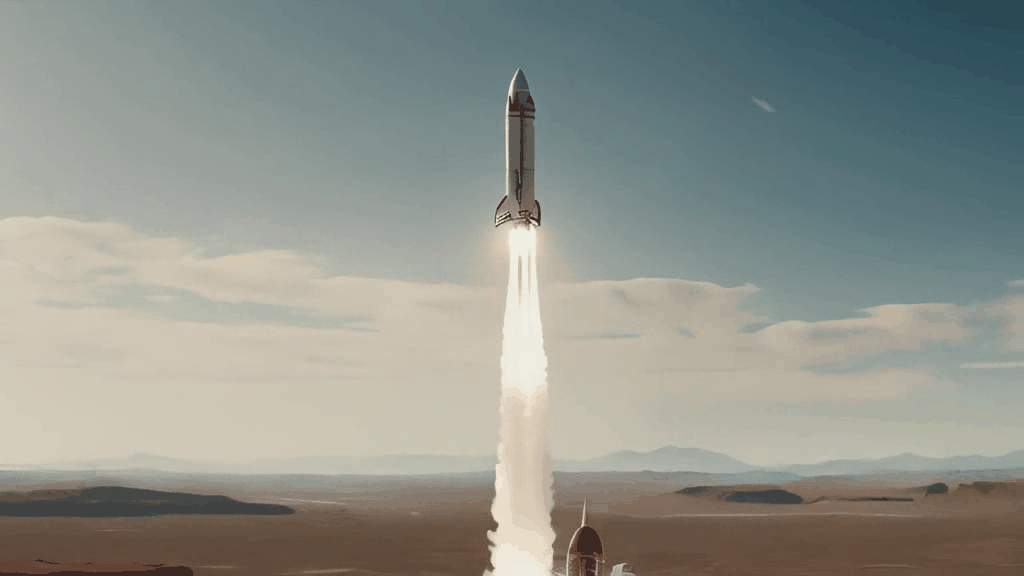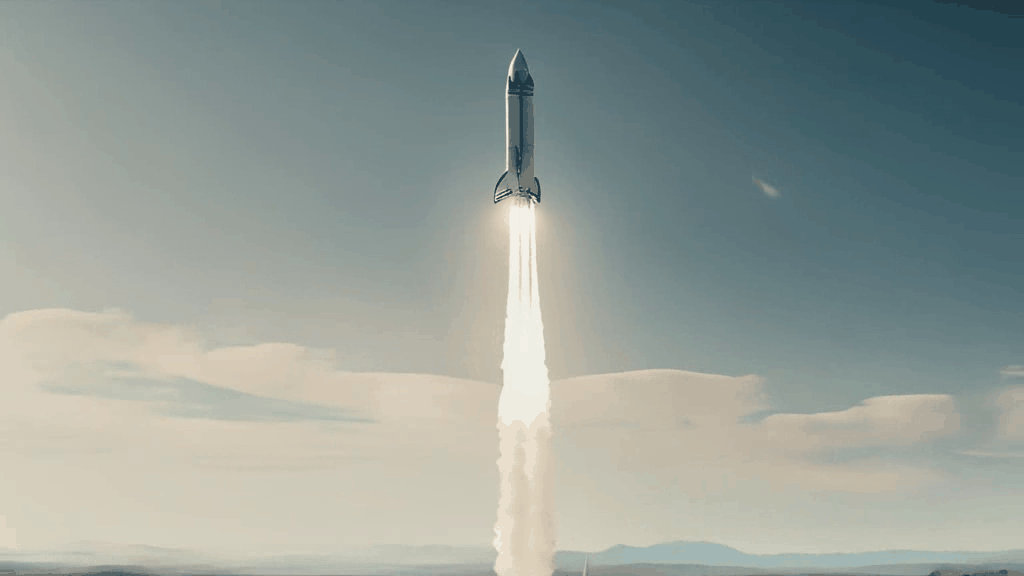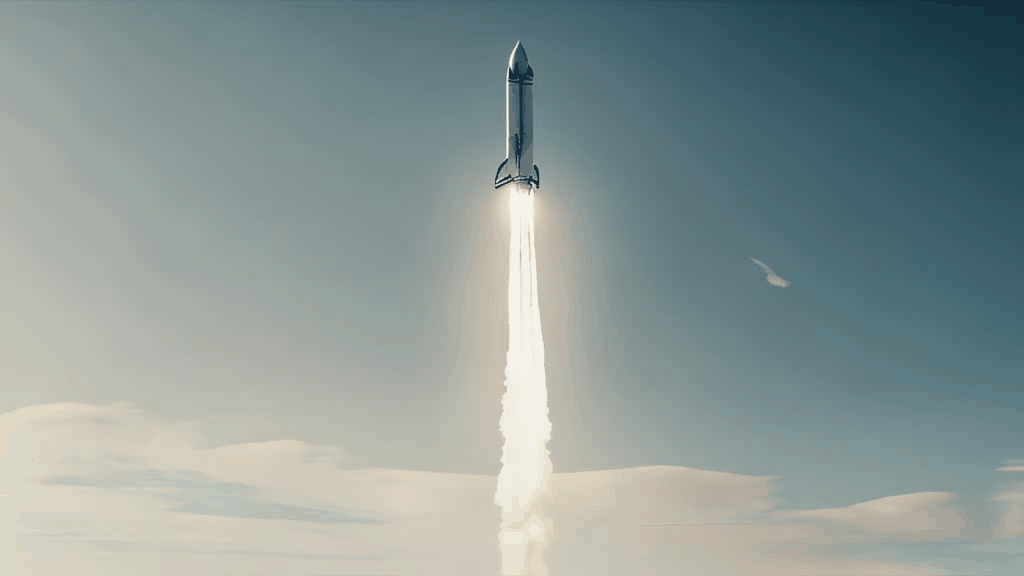
| Stable Diffusion Video, koşullandırma görselinin yanı sıra mikro-koşullandırmayı da kabul eder; bu, üretilen video üzerinde daha fazla kontrol sağlar: | |
| - `fps`: üretilen videonun saniyedeki kare sayısı. | |
| - `motion_bucket_id`: üretilen video için kullanılacak hareket kovası kimliği. Bu, üretilen videonun hareketini kontrol etmek için kullanılabilir. Hareket kovası kimliğini artırmak, üretilen videonun hareketini artırır. | |
| - `noise_aug_strength`: koşullandırma görüntüsüne eklenen gürültü miktarı. Değerler ne kadar yüksekse, video koşullandırma görüntüsüne o kadar az benzer. Bu değerin artırılması, üretilen videonun hareketini de artırır. | |
| Örneğin, daha fazla hareket içeren bir video oluşturmak için `motion_bucket_id` ve `noise_aug_strength` mikro-konumlama parametrelerini kullanın: | |
| ```python | |
| import torch | |
| from diffusers import StableVideoDiffusionPipeline | |
| from diffusers.utils import load_image, export_to_video | |
| pipe = StableVideoDiffusionPipeline.from_pretrained( | |
| "stabilityai/stable-video-diffusion-img2vid-xt", dtype=torch.float16, variant="fp16" | |
| ) | |
| pipe.enable_model_cpu_offload() | |
| # Load the conditioning image | |
| image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/svd/rocket.png") | |
| image = image.resize((1024, 576)) | |
| generator = torch.manual_seed(42) | |
| frames = pipe(image, decode_chunk_size=8, generator=generator, motion_bucket_id=180, noise_aug_strength=0.1).frames[0] | |
| export_to_video(frames, "generated.mp4", fps=7) | |
| ``` | |
|  | |
| ## StableVideoDiffusionPipeline[[diffusers.StableVideoDiffusionPipeline]] | |
| #### diffusers.StableVideoDiffusionPipeline[[diffusers.StableVideoDiffusionPipeline]] | |
| ```python | |
| diffusers.StableVideoDiffusionPipeline(vae: AutoencoderKLTemporalDecoder, image_encoder: CLIPVisionModelWithProjection, unet: UNetSpatioTemporalConditionModel, scheduler: EulerDiscreteScheduler, feature_extractor: CLIPImageProcessorPil) | |
| ``` | |
| [Kaynak](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/stable_video_diffusion/pipeline_stable_video_diffusion.py#L147) | |
| **Parametreler:** | |
| vae (`AutoencoderKLTemporalDecoder`) : Görüntüleri latent temsillere kodlamak ve latent temsillerden görüntülere çözmek için kullanılan Varyasyonel Oto-Kodlayıcı (VAE) modeli. | |
| image_encoder ([CLIPVisionModelWithProjection](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPVisionModelWithProjection)) : Donmuş CLIP görüntü kodlayıcısı ([laion/CLIP-ViT-H-14-laion2B-s32B-b79K](https://huggingface.co/laion/CLIP-ViT-H-14-laion2B-s32B-b79K)). | |
| unet (`UNetSpatioTemporalConditionModel`) : Kodlanmış görüntü latentlerini gürültüden arındırmak için kullanılan bir `UNetSpatioTemporalConditionModel`. | |
| scheduler ([EulerDiscreteScheduler](/docs/diffusers/main/tr/api/schedulers/euler#diffusers.EulerDiscreteScheduler)) : Kodlanmış görüntü latentlerini gürültüden arındırmak için `unet` ile birlikte kullanılacak bir zamanlayıcı. | |
| feature_extractor ([CLIPImageProcessor](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPImageProcessor)) : Üretilen görüntülerden özellik çıkarmak için bir `CLIPImageProcessor`. | |
| Stable Video Diffusion kullanarak girdi görüntüsünden video üretmek için Pipeline. | |
| Bu model [DiffusionPipeline](/docs/diffusers/main/tr/api/pipelines/overview#diffusers.DiffusionPipeline) sınıfından devralınmıştır. Tüm pipeline'lar için uygulanan genel yöntemlerin (indirme, kaydetme, belirli bir cihazda çalıştırma vb.) belgelerini üst sınıfın dokümantasyonunda bulabilirsiniz. | |
| ## StableVideoDiffusionPipelineOutput[[diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput]] | |
| #### diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput[[diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput]] | |
| ```python | |
| diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput(frames: typing.Union[list[list[PIL.Image.Image]], numpy.ndarray, torch.Tensor]) | |
| ``` | |
| [Kaynak](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/stable_video_diffusion/pipeline_stable_video_diffusion.py#L134) | |
| **Parametreler:** | |
| frames (`[list[list[PIL.Image.Image]]`, `np.ndarray`, `torch.Tensor`]) : `batch_size` uzunluğunda gürültüsü azaltılmış PIL görüntülerinin listesi veya `(batch_size, num_frames, height, width, num_channels)` biçiminde numpy dizisi veya torch tensörü. | |
| Stable Video Diffusion hattı için çıktı sınıfı. | |
Xet Storage Details
- Size:
- 10.5 kB
- Xet hash:
- 99ddc632a16b53b203360cd6d7f5420ae0ac9cad978d52aae20e1cfeb60e10a9
·
Xet efficiently stores files, intelligently splitting them into unique chunks and accelerating uploads and downloads. More info.