
Buckets:


Pipelines Stable Diffusion
Stable Diffusion est un modèle de diffusion latente de texte vers image créé par les chercheurs et ingénieurs de CompVis, Stability AI et LAION. La diffusion latente applique le processus de diffusion sur un espace latent de dimension inférieure afin de réduire la complexité mémoire et de calcul. Ce type spécifique de modèle de diffusion a été proposé dans High-Resolution Image Synthesis with Latent Diffusion Models par Robin Rombach, Andreas Blattmann, Dominik Lorenz, Patrick Esser, Björn Ommer.
Stable Diffusion est entraîné sur des images de 512x512 issues d'un sous-ensemble du jeu de données LAION-5B. Ce modèle utilise un encodeur de texte CLIP ViT-L/14 figé pour conditionner le modèle sur des invites textuelles. Avec son UNet de 860M et son encodeur de texte de 123M, le modèle est relativement léger et peut s'exécuter sur des GPU grand public.
Pour plus de détails sur le fonctionnement de Stable Diffusion et sur ce qui le distingue du modèle de diffusion latente de base, consultez l'annonce de Stability AI et notre propre article de blog pour des détails techniques supplémentaires.
Vous pouvez trouver le code source original de Stable Diffusion v1.0 sur CompVis/stable-diffusion et celui de Stable Diffusion v2.0 sur Stability-AI/stablediffusion, ainsi que leurs scripts originaux pour diverses tâches. Des points de contrôle officiels supplémentaires pour les différentes versions et tâches de Stable Diffusion sont disponibles sur les organisations CompVis et Stability AI du Hub. Explorez ces organisations pour trouver le point de contrôle le plus adapté à votre cas d’usage !
Le tableau ci-dessous résume les pipelines Stable Diffusion disponibles, les tâches qu’ils prennent en charge et une démo interactive :
        Pipeline


        Tâches prises en charge


        🤗 Space


        StableDiffusion

        texte-vers-image


        StableDiffusionImg2Img

        image-vers-image


        StableDiffusionInpaint

        inpainting


        StableDiffusionDepth2Img

        depth-to-image


        StableDiffusionImageVariation

        variation d'image


        StableDiffusionPipelineSafe (obsolète ; aucune page de documentation)

        texte-vers-image filtré


        StableDiffusion2

        texte-vers-image, inpainting, profondeur-vers-image, super-résolution


        StableDiffusionXL

        texte-vers-image, image-vers-image


        StableDiffusionLatentUpscale

        super-résolution


        StableDiffusionUpscale

        super-résolution


        StableDiffusionLDM3D

        texte-versus-rgb, texte-versus-profondeur, texte-versus-panorama


        StableDiffusionUpscaleLDM3D

        super-résolution ldm3d
Astuces
Pour vous aider à tirer le meilleur parti des pipelines Stable Diffusion, voici quelques conseils pour améliorer les performances et l’ergonomie. Ces conseils s’appliquent à tous les pipelines Stable Diffusion.
Explorer le compromis entre vitesse et qualité
StableDiffusionPipeline utilise par défaut le PNDMScheduler, mais 🤗 Diffusers propose de nombreux autres planificateurs (certains plus rapides ou offrant une meilleure qualité) qui sont compatibles. Par exemple, si vous souhaitez utiliser le EulerDiscreteScheduler à la place du planificateur par défaut :
from diffusers import StableDiffusionPipeline, EulerDiscreteScheduler

pipeline = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")
pipeline.scheduler = EulerDiscreteScheduler.from_config(pipeline.scheduler.config)

# or
euler_scheduler = EulerDiscreteScheduler.from_pretrained("CompVis/stable-diffusion-v1-4", subfolder="scheduler")
pipeline = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4", scheduler=euler_scheduler)
Réutiliser les composants du pipeline pour économiser de la mémoire
Pour économiser de la mémoire et réutiliser les mêmes composants dans plusieurs pipelines, utilisez la méthode .components afin d’éviter de charger les poids en RAM plus d’une fois.
from diffusers import (
    StableDiffusionPipeline,
    StableDiffusionImg2ImgPipeline,
    StableDiffusionInpaintPipeline,
)

text2img = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")
img2img = StableDiffusionImg2ImgPipeline(**text2img.components)
inpaint = StableDiffusionInpaintPipeline(**text2img.components)

# now you can use text2img(...), img2img(...), inpaint(...) just like the call methods of each respective pipeline
Créer des démos web à l'aide de gradio
Les pipelines Stable Diffusion sont automatiquement pris en charge dans Gradio, une bibliothèque qui facilite la création d’applications d’apprentissage automatique esthétiques et conviviales sur le web. Assurez-vous d’abord que Gradio est installé :
pip install -U gradio
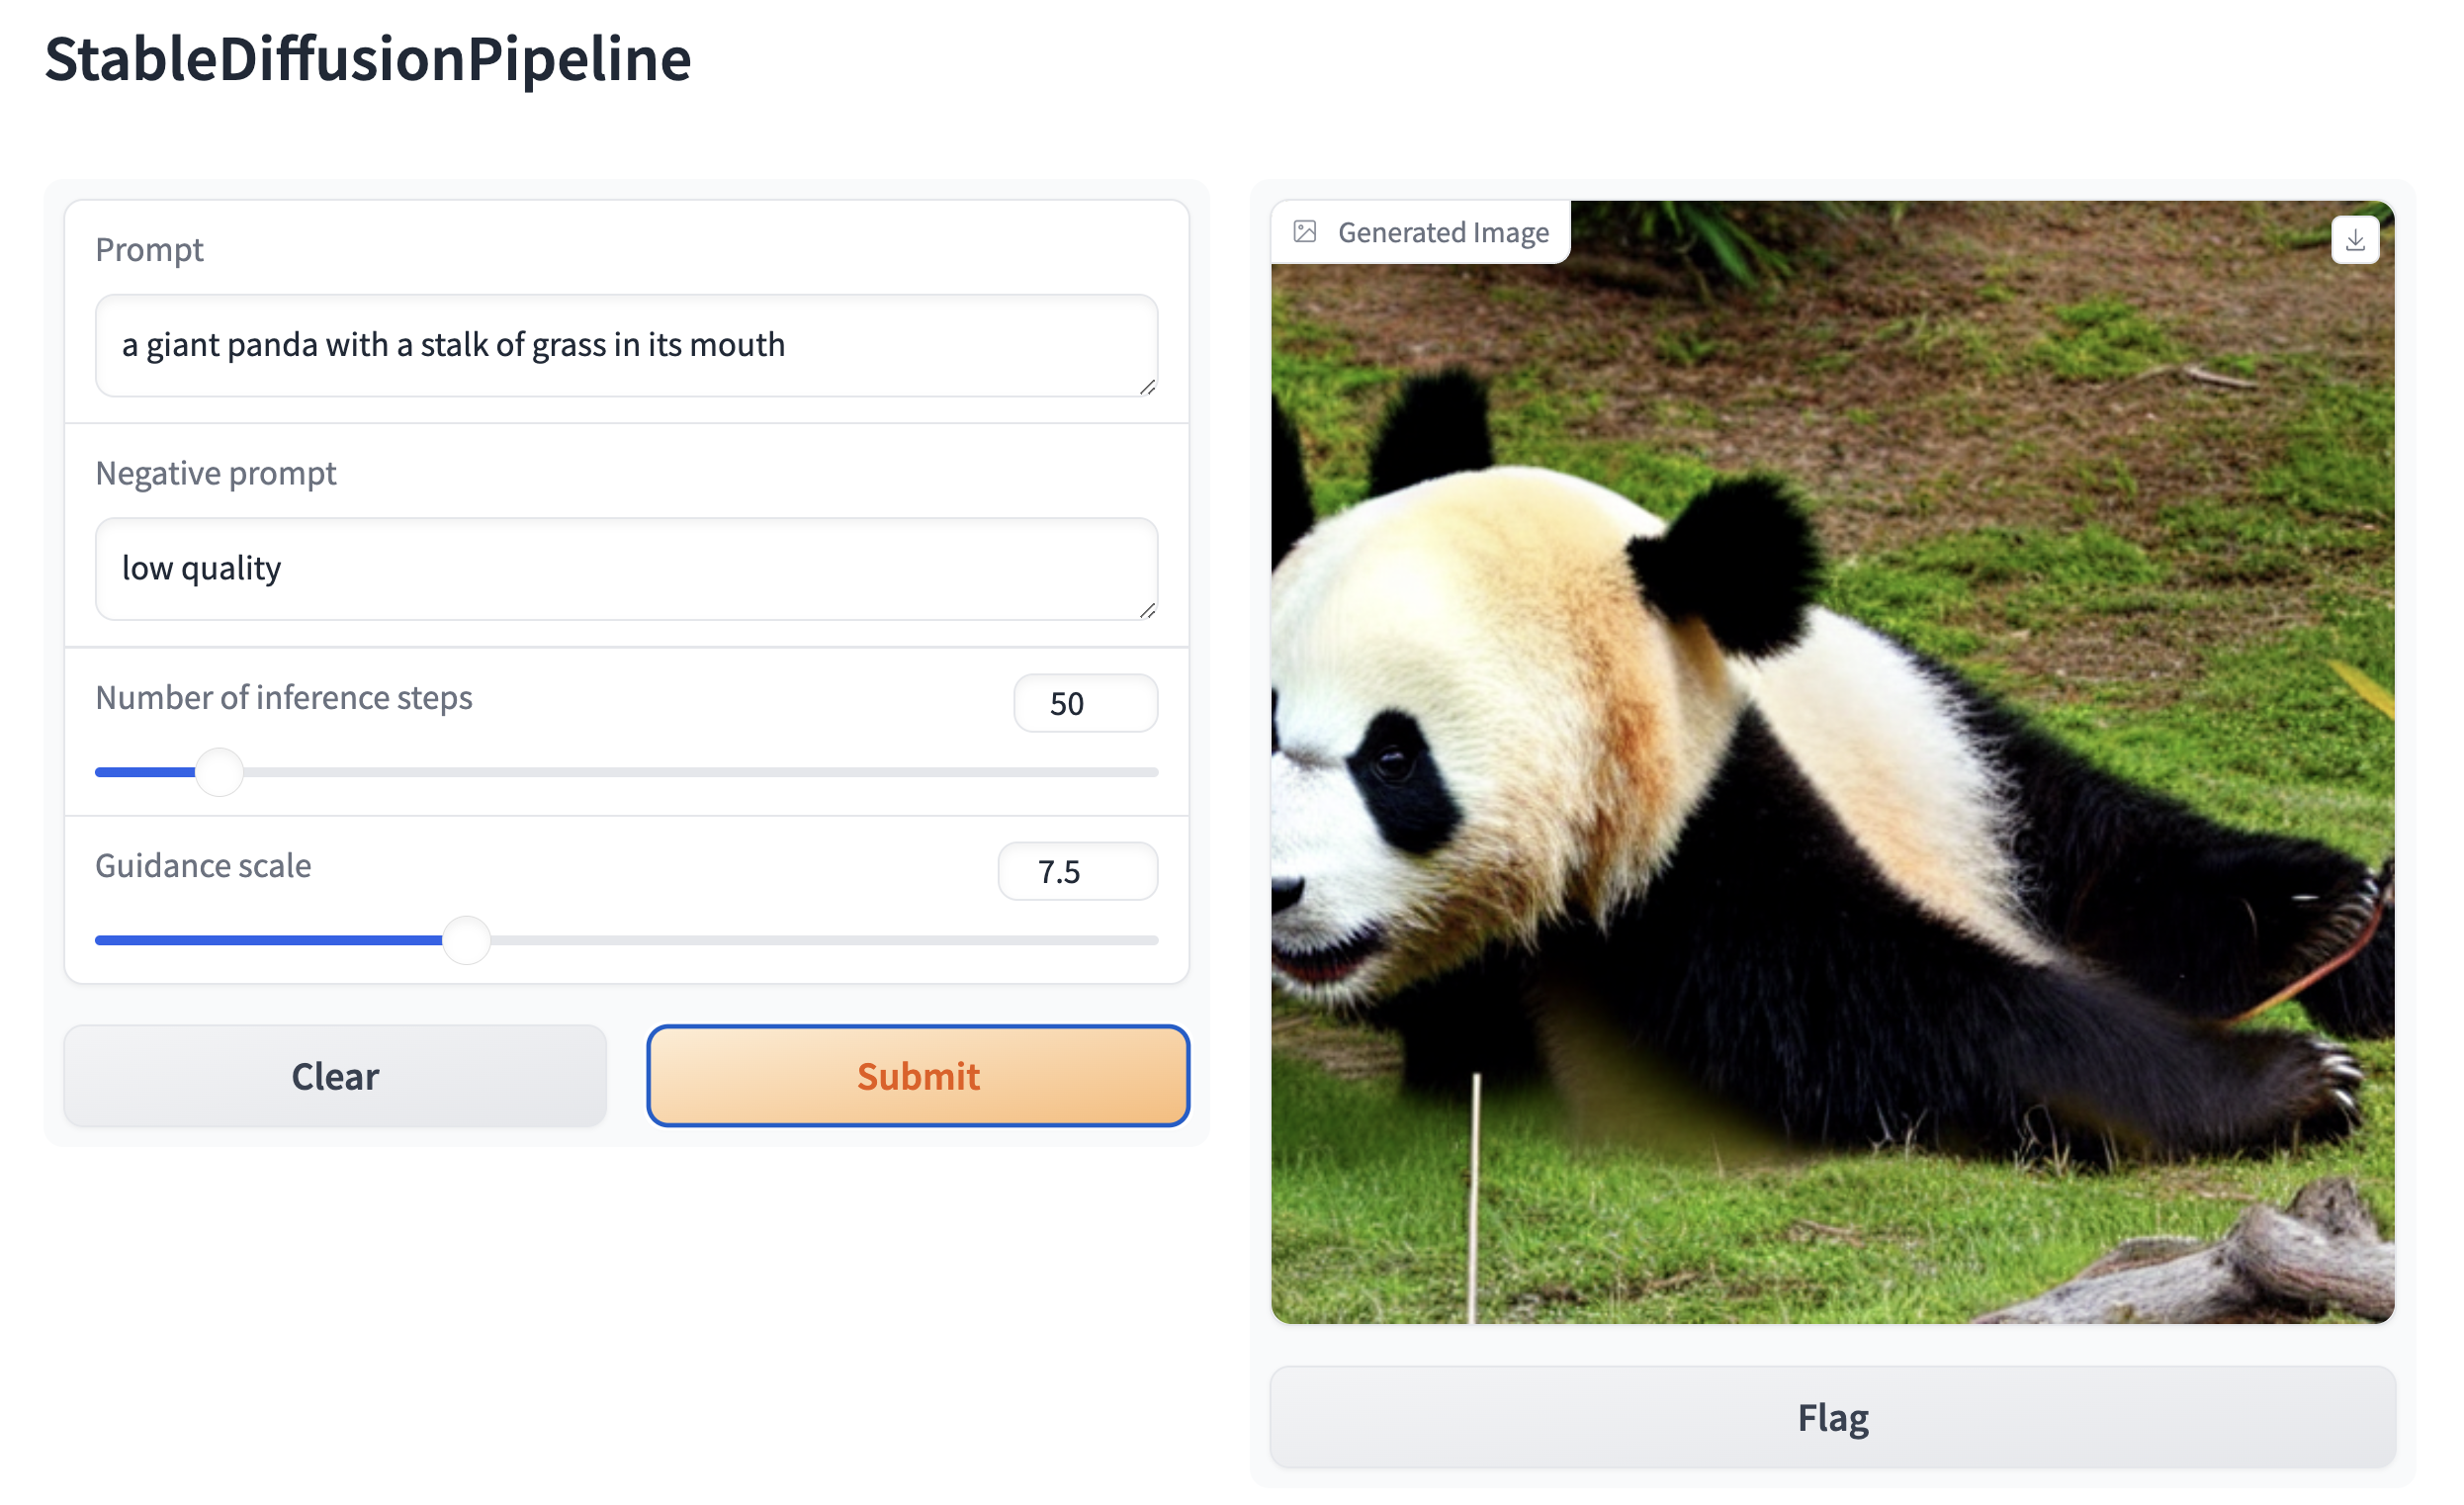
Ensuite, créez une démo web autour de n’importe quel pipeline basé sur Stable Diffusion. Par exemple, vous pouvez créer un pipeline de génération d’images en une seule ligne de code avec la fonction Interface.from_pipeline de Gradio :
from diffusers import StableDiffusionPipeline
import gradio as gr

pipe = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")

gr.Interface.from_pipeline(pipe).launch()
qui ouvre une interface intuitive de glisser-déposer dans votre navigateur :
De même, vous pourriez créer une démonstration pour un pipeline image-vers-image avec :
from diffusers import StableDiffusionImg2ImgPipeline
import gradio as gr

pipe = StableDiffusionImg2ImgPipeline.from_pretrained("stable-diffusion-v1-5/stable-diffusion-v1-5")

gr.Interface.from_pipeline(pipe).launch()
Par défaut, la démo web s’exécute sur un serveur local. Si vous souhaitez la partager avec d’autres personnes, vous pouvez générer un lien public temporaire en définissant share=True dans launch(). Sinon, vous pouvez héberger votre démo sur Hugging Face Spaceshttps://huggingface.co/spaces pour obtenir un lien permanent.
Xet Storage Details
- Size:
- 8.08 kB
- Xet hash:
- 1a0d54367e1eb61b4becc54f97f52c7d7de4d5fadadf7583de8222ae98936aa9
Xet efficiently stores files, intelligently splitting them into unique chunks and accelerating uploads and downloads. More info.