
Buckets:


Pipelines do Stable Diffusion
Stable Diffusion é um modelo de difusão latente de texto para imagem criado pelos pesquisadores e engenheiros do CompVis, Stability AI e LAION. A difusão latente aplica o processo de difusão em um espaço latente de dimensão inferior para reduzir a complexidade de memória e de computação. Esse tipo específico de modelo de difusão foi proposto em High-Resolution Image Synthesis with Latent Diffusion Models por Robin Rombach, Andreas Blattmann, Dominik Lorenz, Patrick Esser, Björn Ommer.
O Stable Diffusion é treinado em imagens de 512x512 de um subconjunto do conjunto de dados LAION-5B. Este modelo usa um codificador de texto CLIP ViT-L/14 congelado para condicionar o modelo em prompts de texto. Com seu UNet de 860M e codificador de texto de 123M, o modelo é relativamente leve e pode ser executado em GPUs de consumo.
Para mais detalhes sobre como o Stable Diffusion funciona e como ele difere do modelo base de difusão latente, confira o anúncio da Stability AI e nosso próprio post de blog para mais detalhes técnicos.
Você pode encontrar o código original do Stable Diffusion v1.0 em CompVis/stable-diffusion e do Stable Diffusion v2.0 em Stability-AI/stablediffusion, bem como seus scripts originais para diversas tarefas. Checkpoints oficiais adicionais para as diferentes versões e tarefas do Stable Diffusion podem ser encontrados nas organizações CompVis e Stability AI no Hub. Explore essas organizações para encontrar o melhor checkpoint para o seu caso de uso!
A tabela abaixo resume os pipelines do Stable Diffusion disponíveis, as tarefas suportadas e uma demonstração interativa:
        Pipeline


        Tarefas suportadas


        🤗 Space


        StableDiffusion

        texto-para-imagem


        StableDiffusionImg2Img

        imagem-para-imagem


        StableDiffusionInpaint

        inpainting


        StableDiffusionDepth2Img

        depth-to-image


        StableDiffusionImageVariation

        variação de imagem


        StableDiffusionPipelineSafe (Descontinuado; sem página de documentação)

        texto-para-imagem filtrado


        StableDiffusion2

        texto-para-imagem, inpainting, profundidade-para-imagem, super-resolução


        StableDiffusionXL

        texto-para-imagem, imagem-para-imagem


        StableDiffusionLatentUpscale

        super-resolução


        StableDiffusionUpscale

        super-resolução


        StableDiffusionLDM3D

        texto-para-rgb, texto-para-profundidade, texto-para-pano


        StableDiffusionUpscaleLDM3D

        super-resolução do ldm3d
Dicas
Para ajudar você a aproveitar ao máximo os pipelines do Stable Diffusion, aqui estão algumas dicas para melhorar o desempenho e a usabilidade. Essas dicas se aplicam a todos os pipelines do Stable Diffusion.
Explore o compromisso entre velocidade e qualidade
StableDiffusionPipeline usa o PNDMScheduler por padrão, mas o 🤗 Diffusers oferece muitos outros agendadores compatíveis (alguns mais rápidos ou com melhor qualidade de saída). Por exemplo, se você quiser usar o EulerDiscreteScheduler em vez do padrão:
from diffusers import StableDiffusionPipeline, EulerDiscreteScheduler

pipeline = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")
pipeline.scheduler = EulerDiscreteScheduler.from_config(pipeline.scheduler.config)

# or
euler_scheduler = EulerDiscreteScheduler.from_pretrained("CompVis/stable-diffusion-v1-4", subfolder="scheduler")
pipeline = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4", scheduler=euler_scheduler)
Reutilize componentes de pipeline para economizar memória
Para economizar memória e usar os mesmos componentes em vários pipelines, use o método .components para evitar carregar os pesos na RAM mais de uma vez.
from diffusers import (
    StableDiffusionPipeline,
    StableDiffusionImg2ImgPipeline,
    StableDiffusionInpaintPipeline,
)

text2img = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")
img2img = StableDiffusionImg2ImgPipeline(**text2img.components)
inpaint = StableDiffusionInpaintPipeline(**text2img.components)

# now you can use text2img(...), img2img(...), inpaint(...) just like the call methods of each respective pipeline
Crie demonstrações web usando gradio
Os pipelines do Stable Diffusion são suportados automaticamente no Gradio, uma biblioteca que facilita a criação de aplicativos de machine learning bonitos e fáceis de usar na web. Primeiro, verifique se o Gradio está instalado:
pip install -U gradio
Em seguida, crie uma demonstração web em torno de qualquer pipeline baseado em Stable Diffusion. Por exemplo, você pode criar um pipeline de geração de imagens em uma única linha de código com a função Interface.from_pipeline do Gradio:
from diffusers import StableDiffusionPipeline
import gradio as gr

pipe = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")

gr.Interface.from_pipeline(pipe).launch()
que abre uma interface intuitiva de arrastar e soltar no seu navegador:
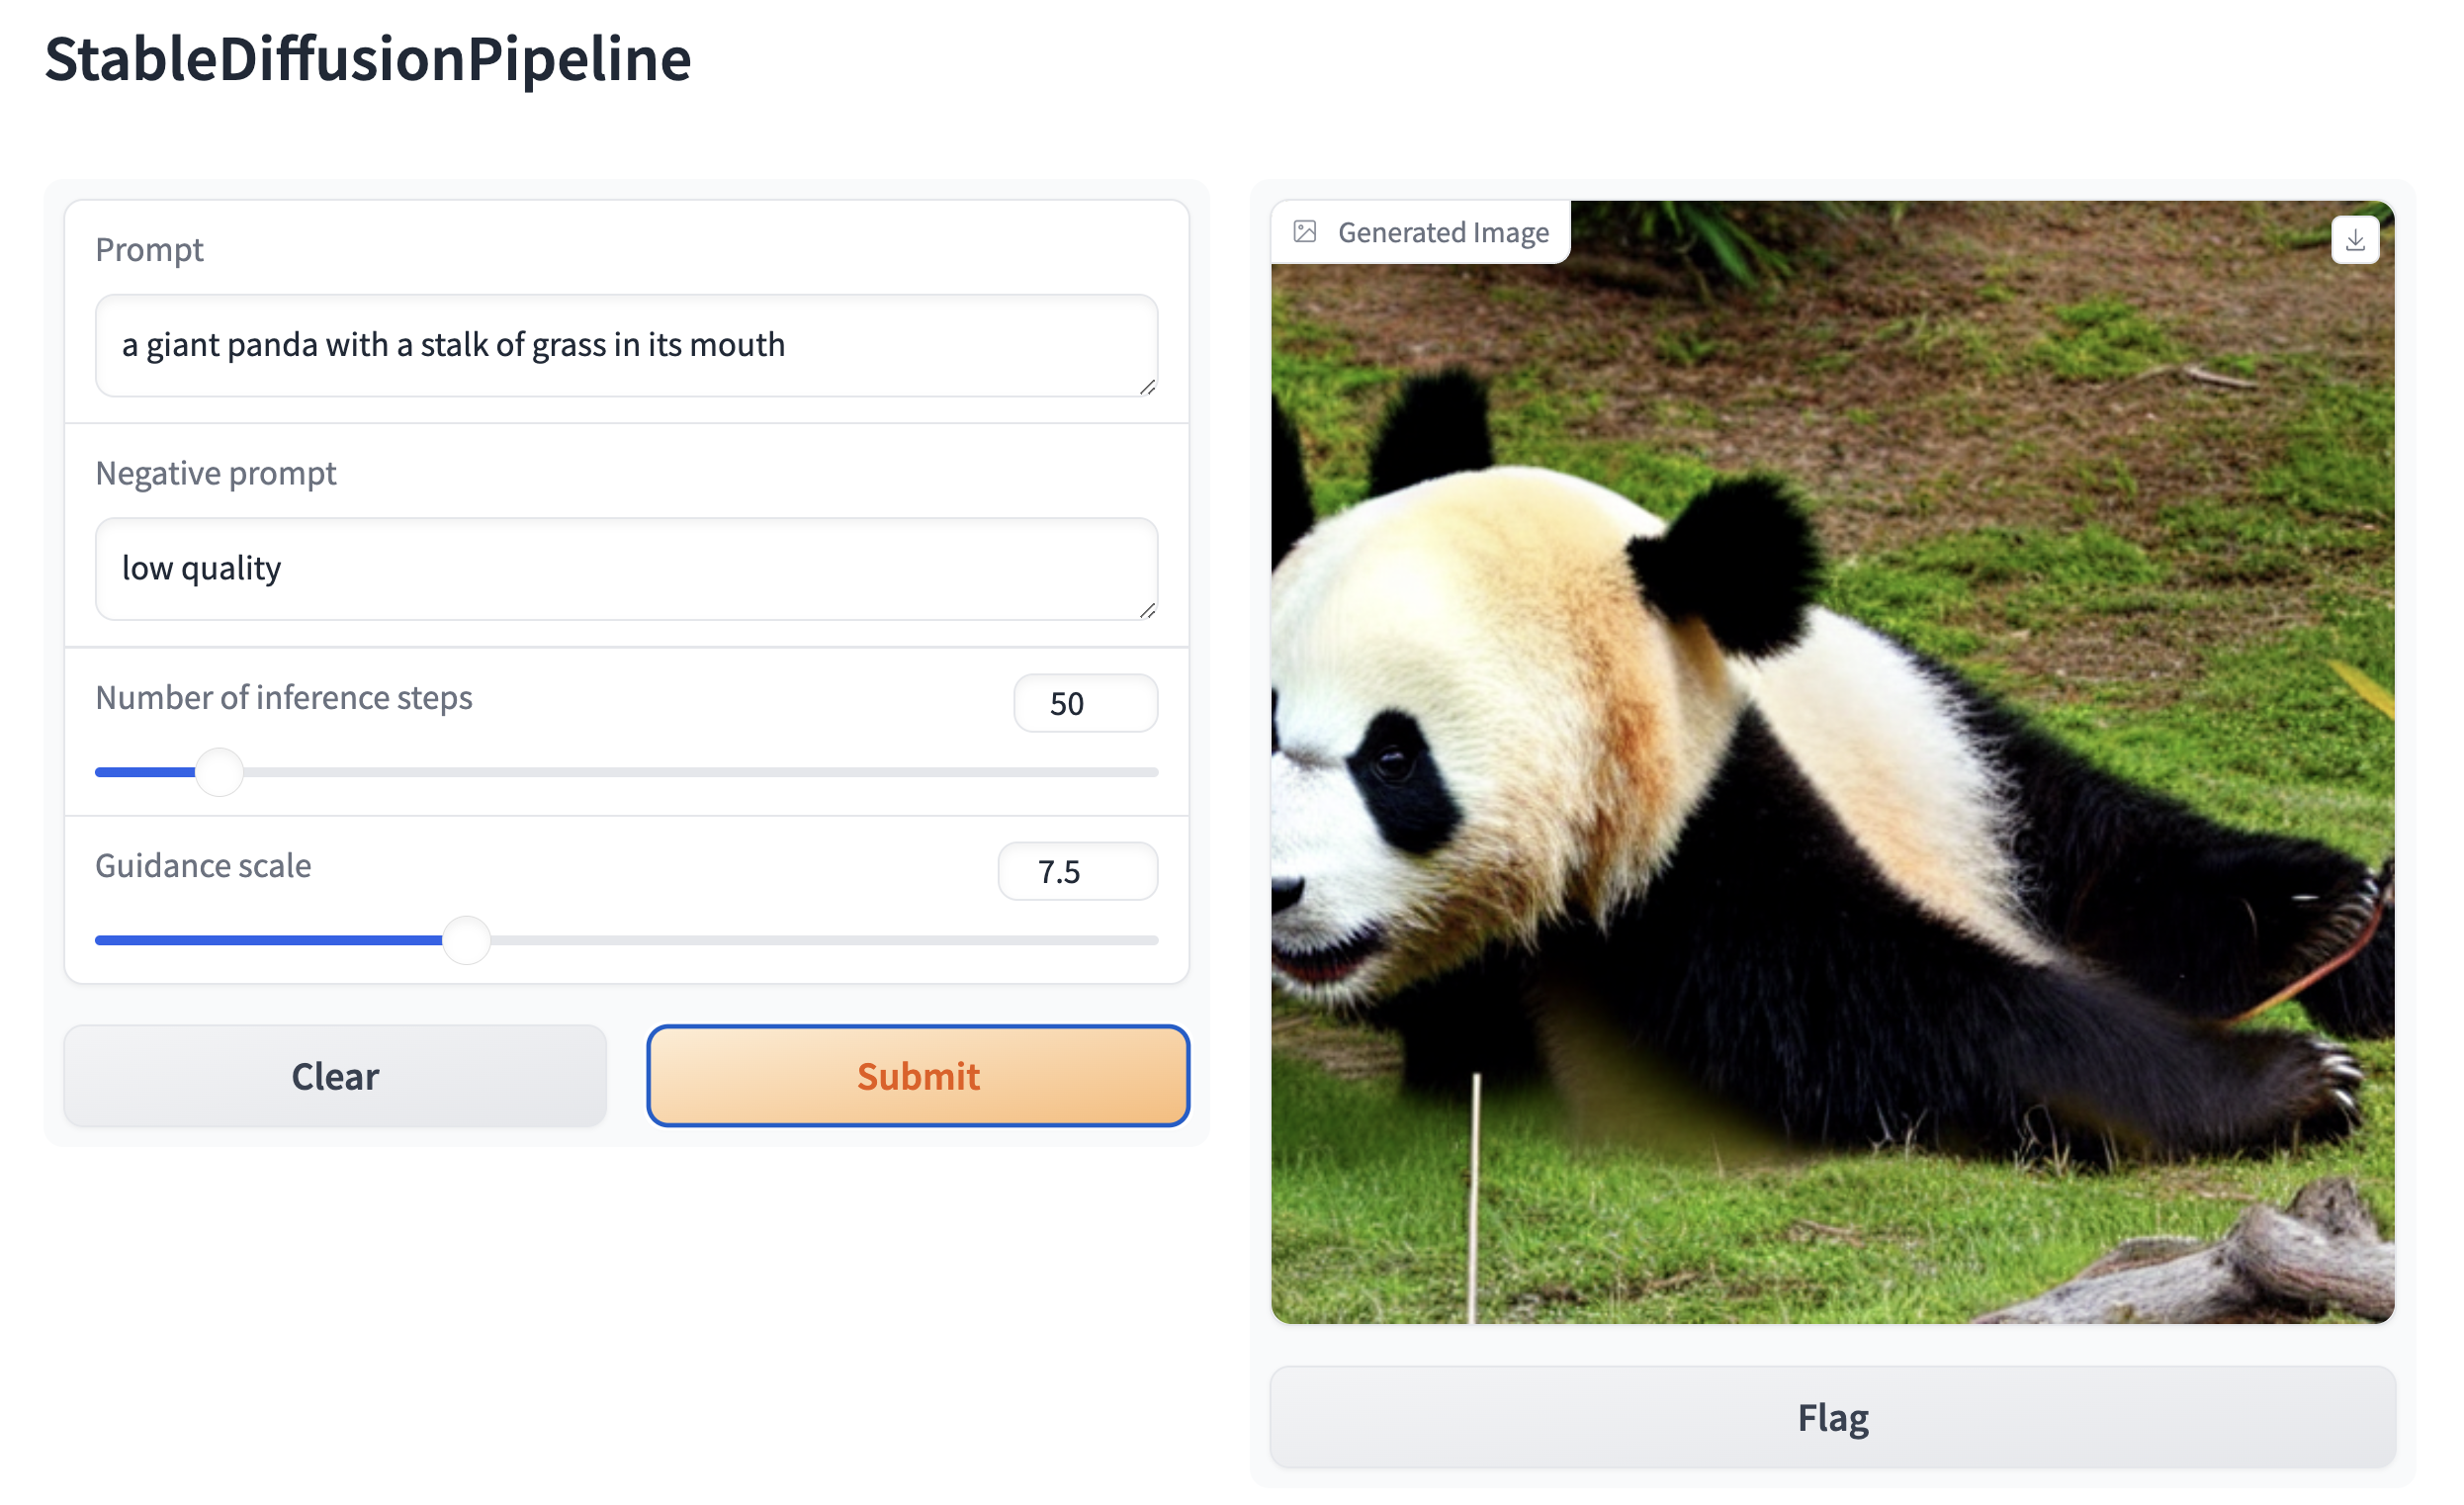
Da mesma forma, você poderia criar uma demonstração para um pipeline de imagem-para-imagem com:
from diffusers import StableDiffusionImg2ImgPipeline
import gradio as gr

pipe = StableDiffusionImg2ImgPipeline.from_pretrained("stable-diffusion-v1-5/stable-diffusion-v1-5")

gr.Interface.from_pipeline(pipe).launch()
Por padrão, a demonstração web é executada em um servidor local. Se você quiser compartilhá-la com outras pessoas, pode gerar um link público temporário definindo share=True em launch(). Ou, você pode hospedar sua demonstração no Hugging Face Spaceshttps://huggingface.co/spaces para obter um link permanente.
Xet Storage Details
- Size:
- 7.79 kB
- Xet hash:
- 0adbf67fd029ceaf19ad4acc34db36e0d7ce801e9c11c14a8bc6c1d664ca32f7
Xet efficiently stores files, intelligently splitting them into unique chunks and accelerating uploads and downloads. More info.