
Buckets:


Пайплайны Stable Diffusion
Stable Diffusion — это модель латентной диффузии для генерации изображений по текстовому описанию, созданная исследователями и инженерами из CompVis, Stability AI и LAION. Латентная диффузия применяет процесс диффузии в пространстве меньшей размерности, что снижает требования к памяти и вычислительным ресурсам. Этот конкретный тип диффузионной модели был предложен в работе High-Resolution Image Synthesis with Latent Diffusion Models Робина Ромбаха, Андреаса Блаттмана, Доминика Лоренца, Патрика Эссера и Бьёрна Оммера.
Stable Diffusion обучен на изображениях размером 512x512 из подмножества набора данных LAION-5B. Эта модель использует замороженный текстовый энкодер CLIP ViT-L/14 для условного формирования модели на основе текстовых запросов. Благодаря UNet с 860 млн параметров и текстовому энкодеру с 123 млн параметров, модель относительно легковесна и может работать на потребительских GPU.
Для получения подробной информации о том, как работает Stable Diffusion и чем он отличается от базовой модели латентного диффузионного процесса, ознакомьтесь с анонсом Stability AI и нашей собственной статьей в блоге с техническими деталями.
Исходный код Stable Diffusion v1.0 можно найти в репозитории CompVis/stable-diffusion, а Stable Diffusion v2.0 — в Stability-AI/stablediffusion, где также представлены исходные скрипты для различных задач. Дополнительные официальные контрольные точки для разных версий Stable Diffusion и задач доступны в организациях CompVis и Stability AI на Hub. Изучите эти организации, чтобы подобрать оптимальную контрольную точку для вашей задачи!
Таблица ниже обобщает доступные пайплайны Stable Diffusion, поддерживаемые ими задачи и интерактивную демонстрацию:
        Pipeline


        Поддерживаемые задачи


        🤗 Space


        StableDiffusion

        text-to-image


        StableDiffusionImg2Img

        image-to-image


        StableDiffusionInpaint

        inpainting


        StableDiffusionDepth2Img

        depth-to-image


        StableDiffusionImageVariation

        вариация изображения


        StableDiffusionPipelineSafe (устаревший; нет страницы документации)

        фильтрованный текст в изображение


        StableDiffusion2

        создание изображений по тексту, восстановление изображений, создание изображений по глубине, супер-разрешение


        StableDiffusionXL

        текст в изображение, изображение в изображение


        StableDiffusionLatentUpscale

        сверхразрешение


        StableDiffusionUpscale

        сверхразрешение


        StableDiffusionLDM3D

        текст в rgb, текст в глубину, текст в панораму


        StableDiffusionUpscaleLDM3D

        ldm3d супер-разрешение
Советы
Чтобы вы могли получить максимум от пайплайнов Stable Diffusion, ниже приведены несколько советов по улучшению производительности и удобства использования. Эти советы применимы ко всем пайплайнам Stable Diffusion.
Исследуйте компромисс между скоростью и качеством
StableDiffusionPipeline по умолчанию использует PNDMScheduler, но 🤗 Diffusers предоставляет множество других совместимых планировщиков (некоторые из них работают быстрее или обеспечивают лучшее качество). Например, если вы хотите использовать EulerDiscreteScheduler вместо планировщика по умолчанию:
from diffusers import StableDiffusionPipeline, EulerDiscreteScheduler

pipeline = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")
pipeline.scheduler = EulerDiscreteScheduler.from_config(pipeline.scheduler.config)

# or
euler_scheduler = EulerDiscreteScheduler.from_pretrained("CompVis/stable-diffusion-v1-4", subfolder="scheduler")
pipeline = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4", scheduler=euler_scheduler)
Повторное использование компонентов конвейера для экономии памяти
Чтобы сэкономить память и использовать одни и те же компоненты в нескольких конвейерах, применяйте метод .components, чтобы избежать повторной загрузки весов в оперативную память.
from diffusers import (
    StableDiffusionPipeline,
    StableDiffusionImg2ImgPipeline,
    StableDiffusionInpaintPipeline,
)

text2img = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")
img2img = StableDiffusionImg2ImgPipeline(**text2img.components)
inpaint = StableDiffusionInpaintPipeline(**text2img.components)

# now you can use text2img(...), img2img(...), inpaint(...) just like the call methods of each respective pipeline
Создание веб-демо с помощью gradio
Пайплайны Stable Diffusion автоматически поддерживаются в Gradio — библиотеке, которая позволяет легко создавать красивые и удобные веб-приложения для машинного обучения. Сначала убедитесь, что Gradio установлен:
pip install -U gradio
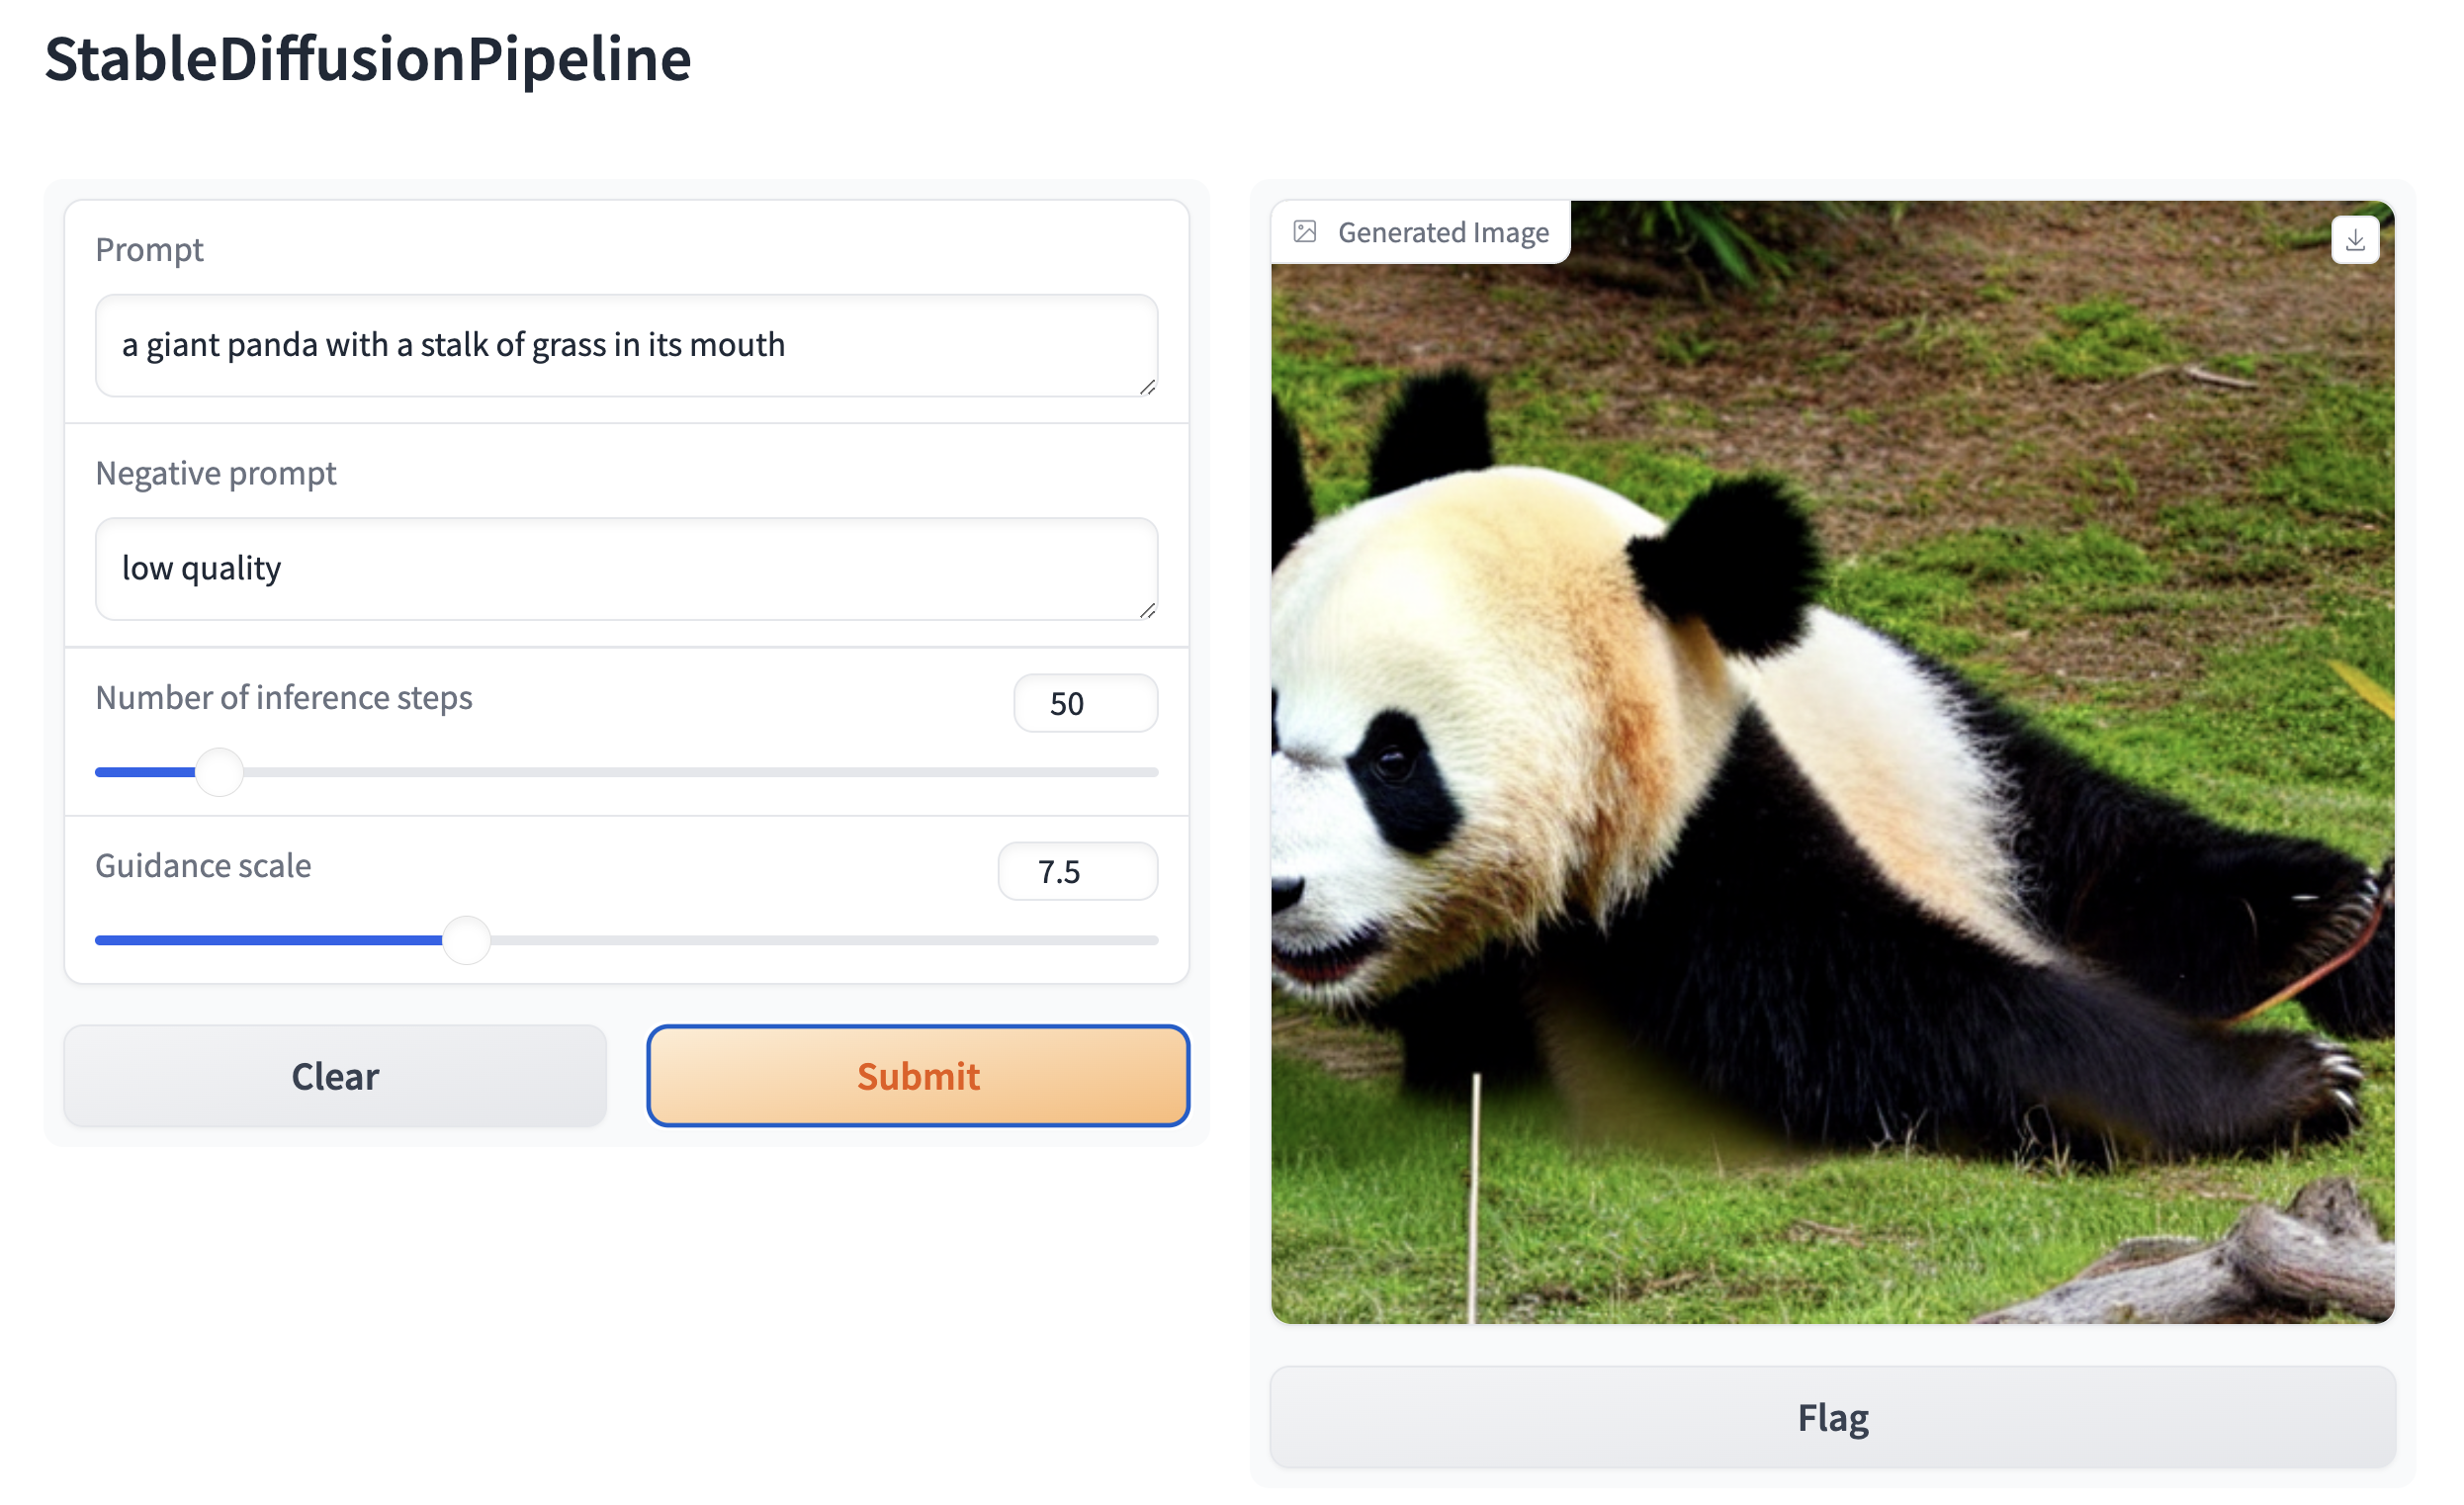
Затем создайте веб-демо на основе любого пайплайна Stable Diffusion. Например, с помощью функции Interface.from_pipeline в Gradio вы можете создать пайплайн генерации изображений одной строкой кода:
from diffusers import StableDiffusionPipeline
import gradio as gr

pipe = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4")

gr.Interface.from_pipeline(pipe).launch()
который открывает интуитивно понятный интерфейс с перетаскиванием элементов в вашем браузере:
Аналогично, вы можете создать демо для пайплайна image-to-image с помощью:
from diffusers import StableDiffusionImg2ImgPipeline
import gradio as gr

pipe = StableDiffusionImg2ImgPipeline.from_pretrained("stable-diffusion-v1-5/stable-diffusion-v1-5")

gr.Interface.from_pipeline(pipe).launch()
По умолчанию веб-демо работает на локальном сервере. Если вы хотите поделиться им с другими, вы можете сгенерировать временную публичную ссылку, установив share=True в launch(). Либо вы можете разместить ваше демо на Hugging Face Spaceshttps://huggingface.co/spaces для получения постоянной ссылки.
Xet Storage Details
- Size:
- 10.6 kB
- Xet hash:
- 7edb8a9be2d25cd6b8b0a88901eba676b0d7063fd58e61cf1a0f7ef4f15ae095
Xet efficiently stores files, intelligently splitting them into unique chunks and accelerating uploads and downloads. More info.