
Buckets:


| # Stable Video Diffusion | |
| Stable Video Diffusion была предложена в статье [Stable Video Diffusion: Scaling Latent Video Diffusion Models to Large Datasets](https://hf.co/papers/2311.15127) авторами Andreas Blattmann, Tim Dockhorn, Sumith Kulal, Daniel Mendelevitch, Maciej Kilian, Dominik Lorenz, Yam Levi, Zion English, Vikram Voleti, Adam Letts, Varun Jampani, Robin Rombach. | |
| Аннотация из статьи: | |
| *Мы представляем Stable Video Diffusion — латентную модель диффузии для видео, обеспечивающую генерацию видео высокого разрешения по тексту и изображению на уровне современных достижений. Недавно латентные диффузионные модели, обученные для синтеза 2D-изображений, были превращены в генеративные модели видео путем добавления временных слоев и дообучения на небольших наборах данных с высококачественным видео. Однако методы обучения, описанные в литературе, сильно различаются, и в области еще не выработан единый подход к формированию видеоданных. В данной статье мы выделяем и оцениваем три различных этапа успешного обучения видео-ЛДМ: предварительное обучение «текст-в-изображение», предварительное обучение на видео и дообучение на высококачественном видео. Кроме того, мы демонстрируем необходимость тщательно отобранного набора данных для предварительного обучения для генерации высококачественного видео и предлагаем систематический процесс формирования данных для обучения сильной базовой модели, включая стратегии подписывания и фильтрации. Затем мы исследуем влияние дообучения нашей базовой модели на высококачественных данных и обучаем модель «текст-в-видео», конкурентоспособную с закрытыми системами генерации видео. Мы также показываем, что наша базовая модель обеспечивает мощное представление движения для задач нижнего уровня, таких как генерация видео по изображению, и позволяет адаптироваться к модулям LoRA, специфичным для движения камеры. Наконец, мы демонстрируем, что наша модель предоставляет сильный многовидовой 3D-приор и может служить основой для дообучения многовидовой диффузионной модели, которая совместно генерирует несколько видов объектов в режиме прямого распространения, превосходя методы на основе изображений при значительно меньших вычислительных затратах. Мы публикуем код и веса модели по этой ссылке: https URL.* | |
| > [!TIP] | |
| > Ознакомьтесь с организацией [Stability AI](https://huggingface.co/stabilityai) на Hugging Face Hub, где доступны контрольные точки [base](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid) и [extended frame](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid-xt)! | |
| Убедитесь, что у вас установлены следующие библиотеки. | |
| ```py | |
| # Uncomment to install the necessary libraries in Colab | |
| !pip install -q -U diffusers transformers accelerate | |
| ``` | |
| Существуют два варианта этой модели: [SVD](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid) и [SVD-XT](https://huggingface.co/stabilityai/stable-video-diffusion-img2vid-xt). Чекпоинт SVD обучен генерировать 14 кадров, а чекпоинт SVD-XT дополнительно дообучен для генерации 25 кадров. | |
| Для этого руководства вы будете использовать контрольную точку SVD-XT. | |
| ```python | |
| import torch | |
| from diffusers import StableVideoDiffusionPipeline | |
| from diffusers.utils import load_image, export_to_video | |
| pipe = StableVideoDiffusionPipeline.from_pretrained( | |
| "stabilityai/stable-video-diffusion-img2vid-xt", dtype=torch.float16, variant="fp16" | |
| ) | |
| pipe.enable_model_cpu_offload() | |
| # Load the conditioning image | |
| image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/svd/rocket.png") | |
| image = image.resize((1024, 576)) | |
| generator = torch.manual_seed(42) | |
| frames = pipe(image, decode_chunk_size=8, generator=generator).frames[0] | |
| export_to_video(frames, "generated.mp4", fps=7) | |
| ``` | |
| "исходное изображение ракеты" | |
| "видео, сгенерированное из исходного изображения" | |
| ## torch.compile | |
| Вы можете получить ускорение на 20–25% за счёт незначительного увеличения потребления памяти, [скомпилировав](../../../optimization/fp16#torchcompile) UNet. | |
| ```diff | |
| - pipe.enable_model_cpu_offload() | |
| + pipe.to("cuda") # or "mps", "xpu", "cpu" | |
| + pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True) | |
| ``` | |
| ## Сокращение использования памяти | |
| Генерация видео требует значительных объёмов памяти, поскольку по сути вы генерируете `num_frames` кадров одновременно, что аналогично генерации изображений по тексту с большим размером батча. Для снижения требований к памяти существует несколько вариантов, которые жертвуют скоростью инференса ради уменьшения потребления памяти: | |
| - включить выгрузку модели: каждый компонент конвейера выгружается на CPU, когда в нём больше нет необходимости. | |
| - включить послойное разбиение (chunking) для полносвязных слоёв: полносвязный слой выполняется в цикле вместо одного прохода с очень большим размером батча. | |
| - reduce `decode_chunk_size`: VAE декодирует кадры по частям, а не все сразу. Установка `decode_chunk_size=1` декодирует по одному кадру за раз и использует минимальное количество памяти (мы рекомендуем подбирать это значение в зависимости от объёма памяти вашей GPU), но в видео может наблюдаться мерцание. | |
| ```diff | |
| - pipe.enable_model_cpu_offload() | |
| - frames = pipe(image, decode_chunk_size=8, generator=generator).frames[0] | |
| + pipe.enable_model_cpu_offload() | |
| + pipe.unet.enable_forward_chunking() | |
| + frames = pipe(image, decode_chunk_size=2, generator=generator, num_frames=25).frames[0] | |
| ``` | |
| Использование всех этих приёмов вместе должно снизить требования к памяти до менее чем 8 ГБ VRAM. | |
| ## Микроусловие | |
| Stable Diffusion Video также принимает микровоздействие (micro-conditioning) в дополнение к изображению-условию, что позволяет более точно управлять генерируемым видео: | |
| - `fps`: количество кадров в секунде в сгенерированном видео. | |
| - `motion_bucket_id`: идентификатор корзины движения, используемый для генерируемого видео. Этот параметр позволяет управлять степенью движения в видео. Увеличение значения идентификатора корзины движения приводит к увеличению динамики в генерируемом видео. | |
| - `noise_aug_strength`: количество шума, добавляемого к изображению-условию. Чем выше значение, тем меньше сгенерированное видео напоминает исходное изображение. Увеличение этого значения также усиливает движение в видео. | |
| Например, чтобы сгенерировать видео с большей динамикой, используйте параметры микроусловий `motion_bucket_id` и `noise_aug_strength`: | |
| ```python | |
| import torch | |
| from diffusers import StableVideoDiffusionPipeline | |
| from diffusers.utils import load_image, export_to_video | |
| pipe = StableVideoDiffusionPipeline.from_pretrained( | |
| "stabilityai/stable-video-diffusion-img2vid-xt", dtype=torch.float16, variant="fp16" | |
| ) | |
| pipe.enable_model_cpu_offload() | |
| # Load the conditioning image | |
| image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/svd/rocket.png") | |
| image = image.resize((1024, 576)) | |
| generator = torch.manual_seed(42) | |
| frames = pipe(image, decode_chunk_size=8, generator=generator, motion_bucket_id=180, noise_aug_strength=0.1).frames[0] | |
| export_to_video(frames, "generated.mp4", fps=7) | |
| ``` | |
| 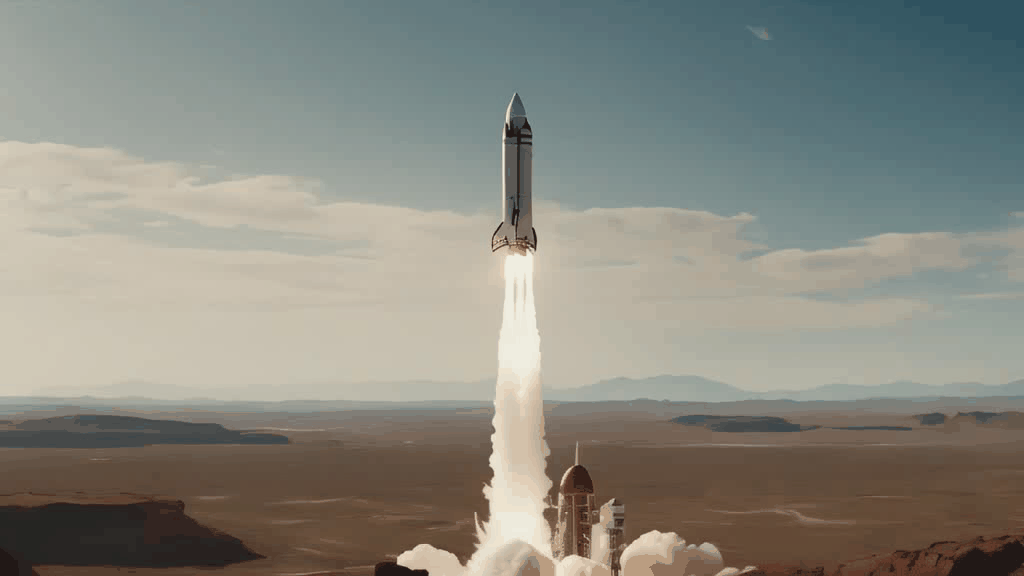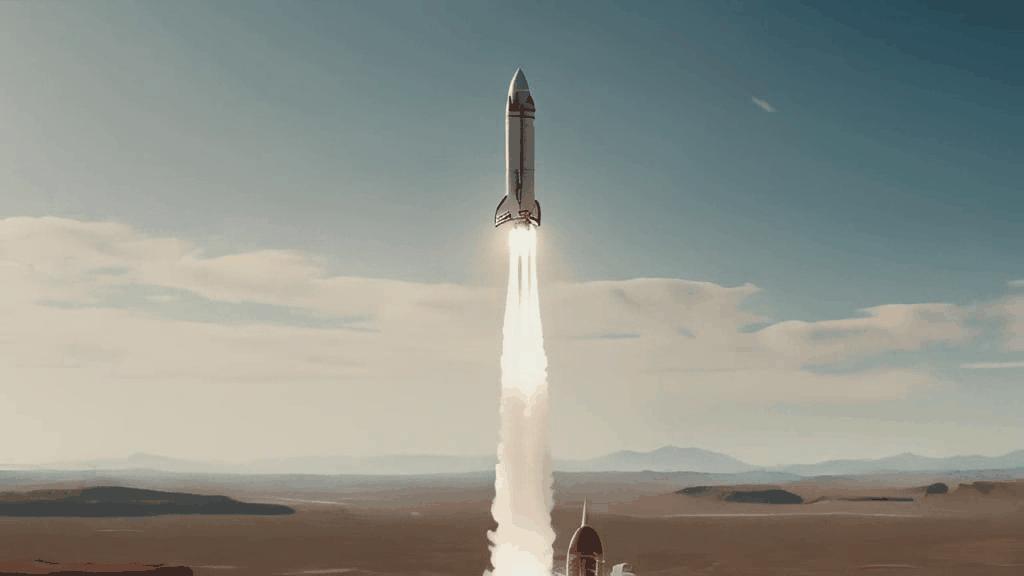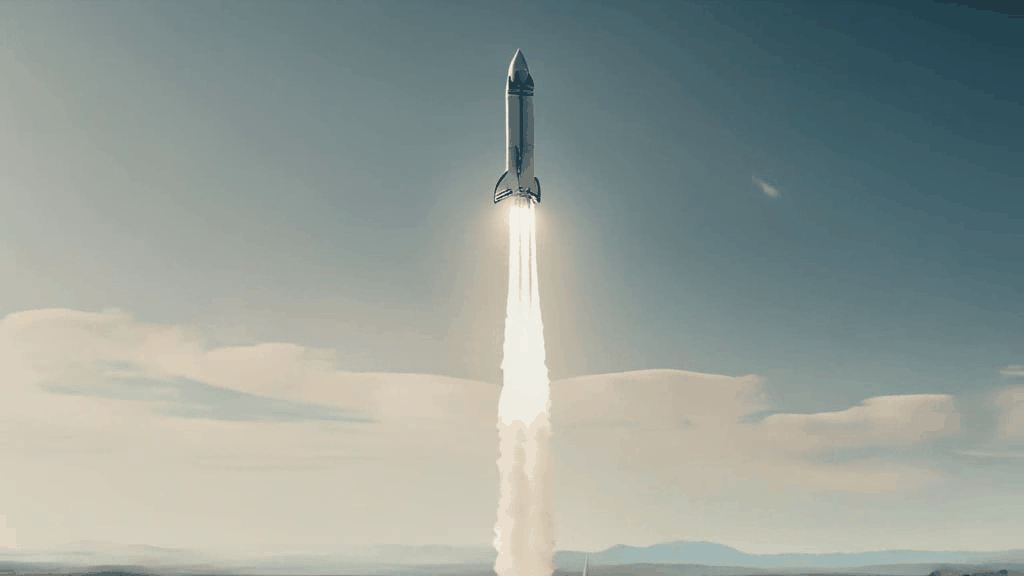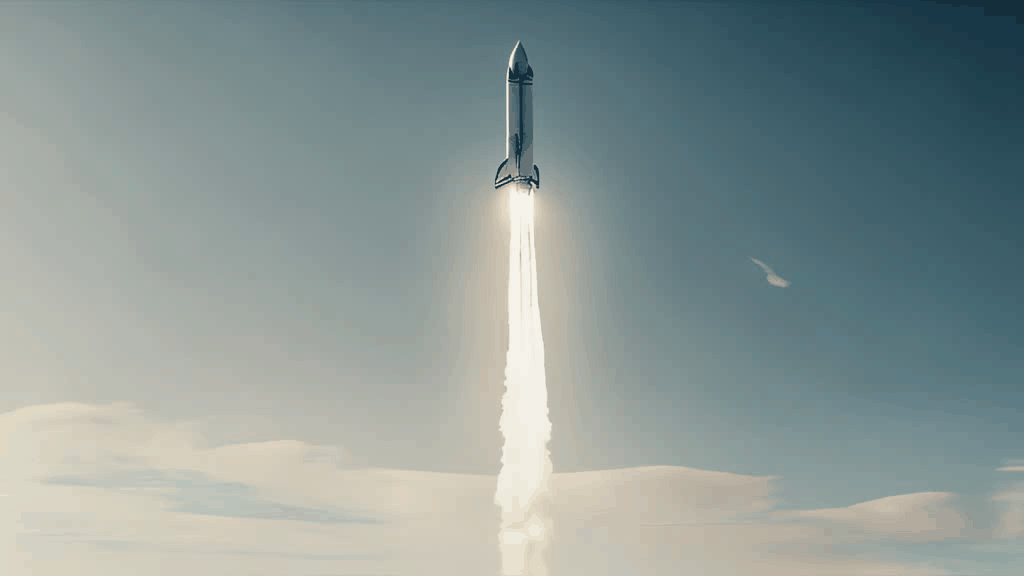 | |
| ## StableVideoDiffusionPipeline[[diffusers.StableVideoDiffusionPipeline]] | |
| #### diffusers.StableVideoDiffusionPipeline[[diffusers.StableVideoDiffusionPipeline]] | |
| ```python | |
| diffusers.StableVideoDiffusionPipeline(vae: AutoencoderKLTemporalDecoder, image_encoder: CLIPVisionModelWithProjection, unet: UNetSpatioTemporalConditionModel, scheduler: EulerDiscreteScheduler, feature_extractor: CLIPImageProcessorPil) | |
| ``` | |
| [Источник](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/stable_video_diffusion/pipeline_stable_video_diffusion.py#L147) | |
| **Параметры:** | |
| vae (`AutoencoderKLTemporalDecoder`) : вариационная автокодирующая модель (VAE) для кодирования изображений в латентные представления и декодирования из них. | |
| image_encoder ([CLIPVisionModelWithProjection](https://huggingface.co/docs/transformers/v5.22.2/en/model_doc/clip#transformers.CLIPVisionModelWithProjection)) : замороженный CLIP-кодировщик изображений ([laion/CLIP-ViT-H-14-laion2B-s32B-b79K](https://huggingface.co/laion/CLIP-ViT-H-14-laion2B-s32B-b79K)). | |
| unet (`UNetSpatioTemporalConditionModel`) : `UNetSpatioTemporalConditionModel` для удаления шума из закодированных латентов изображения. | |
| scheduler ([EulerDiscreteScheduler](/docs/diffusers/v0.43.0/ru/api/schedulers/euler#diffusers.EulerDiscreteScheduler)) : планировщик, используемый в связке с `unet` для удаления шума из закодированных латентов изображения. | |
| feature_extractor ([CLIPImageProcessor](https://huggingface.co/docs/transformers/v5.22.2/en/model_doc/clip#transformers.CLIPImageProcessor)) : `CLIPImageProcessor` для извлечения признаков из сгенерированных изображений. | |
| Pipeline для генерации видео из входного изображения с использованием Stable Video Diffusion. | |
| Эта модель наследуется от [DiffusionPipeline](/docs/diffusers/v0.43.0/ru/api/pipelines/overview#diffusers.DiffusionPipeline). Общую документацию по методам, реализованным для всех пайплайнов (загрузка, сохранение, запуск на конкретном устройстве и т. д.), см. в документации родительского класса. | |
| ## StableVideoDiffusionPipelineOutput[[diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput]] | |
| #### diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput[[diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput]] | |
| ```python | |
| diffusers.pipelines.stable_video_diffusion.StableVideoDiffusionPipelineOutput(frames: typing.Union[list[list[PIL.Image.Image]], numpy.ndarray, torch.Tensor]) | |
| ``` | |
| [Источник](https://github.com/huggingface/diffusers/blob/v0.43.0/src/diffusers/pipelines/stable_video_diffusion/pipeline_stable_video_diffusion.py#L134) | |
| **Параметры:** | |
| frames (`[list[list[PIL.Image.Image]]`, `np.ndarray`, `torch.Tensor`]) : список денойзированных изображений PIL длиной `batch_size` или массив numpy или тензор torch с формой `(batch_size, num_frames, height, width, num_channels)`. | |
| Класс вывода для конвейера Stable Video Diffusion. | |
Xet Storage Details
- Size:
- 14.3 kB
- Xet hash:
- 088a53a36037d6af6400024ac2a2e4aabdc9234124936999d7899402f0cb8a58
·
Xet efficiently stores files, intelligently splitting them into unique chunks and accelerating uploads and downloads. More info.