
Datasets:

The full dataset viewer is not available (click to read why). Only showing a preview of the rows.
Error code: FileSystemError
Need help to make the dataset viewer work? Make sure to review how to configure the dataset viewer, and open a discussion for direct support.
surface string | lemma string | prefix string | infix string | suffix string | dialect string |
|---|---|---|---|---|---|
abah | abah | general | |||
abak | abak | general | |||
aban | aban | general | |||
abang | abang | general | |||
abar | abar | general | |||
abas | abas | general | |||
abat | abat | general | |||
abek | abek | general | |||
aben | aben | general | |||
abena | abena | general | |||
aber | aber | general | |||
abih | abih | general | |||
abon | abon | general | |||
abong | abong | general | |||
abot | abot | general | |||
abu | abu | general | |||
abuk | abuk | general | |||
abut | abut | general | |||
abuta | abuta | general | |||
acan | acan | general | |||
aceh | aceh | general | |||
aci | aci | general | |||
acih | acih | general | |||
acong | acong | general | |||
adah | adah | general | |||
adal | adal | general | |||
adala | adala | general | |||
adam | adam | general | |||
adang | adang | general | |||
adap | adap | general | |||
adar | adar | general | |||
adas | adas | general | |||
adasa | adasa | general | |||
adat | adat | general | |||
adata | adata | general | |||
adek | adek | general | |||
adel | adel | general | |||
adem | adem | general | |||
aden | aden | general | |||
adeng | adeng | general | |||
adenga | adenga | general | |||
adep | adep | general | |||
adeq | adeq | general | |||
adeqa | adeqa | general | |||
adi | adi | general | |||
adik | adik | general | |||
adil | adil | general | |||
ading | ading | general | |||
adiq | adiq | general | |||
aditya | aditya | general | |||
ado | ado | general | |||
adoh | adoh | general | |||
adok | adok | general | |||
adoka | adoka | general | |||
adon | adon | general | |||
adona | adona | general | |||
adoq | adoq | general | |||
adu | adu | general | |||
adua | adua | general | |||
aduh | aduh | general | |||
aduk | aduk | general | |||
aer | aer | general | |||
agama | agama | general | |||
agas | agas | general | |||
agat | agat | general | |||
agel | agel | general | |||
agem | agem | general | |||
agen | agen | general | |||
ageq | ageq | general | |||
aget | aget | general | |||
agin | agin | general | |||
agiq | agiq | general | |||
agiqa | agiqa | general | |||
agir | agir | general | |||
agit | agit | general | |||
agol | agol | general | |||
agola | agola | general | |||
agon | agon | general | |||
agu | agu | general | |||
aguk | aguk | general | |||
agul | agul | general | |||
agum | agum | general | |||
agun | agun | general | |||
agung | agung | general | |||
agunga | agunga | general | |||
agus | agus | general | |||
ahat | ahat | general | |||
ahbakaq | ahbakaq | general | |||
ahbantar | ahbantar | general | |||
ahbebet | ahbebet | general | |||
aherat | aherat | general | |||
ahir | ahir | general | |||
ahlak | ahlak | general | |||
ahli | ahli | general | |||
ahmat | ahmat | general | |||
aikmel | aikmel | general | |||
ain | ain | general | |||
aing | aing | general | |||
aip | aip | general | |||
aiq | aiq | general |
🌴 SasakNLP: Morphological Benchmark & Authentic Sasak Corpus
Official research dataset accompanying the SasakNLP toolkit, developed by kodetr (kodetr.com). Bahasa Sasak is an Austronesian low-resource regional language spoken by approximately 3 million people across Lombok, West Nusa Tenggara (NTB), Indonesia.
- Website Resmi: https://kodetr.com
- Repositori GitHub: https://github.com/kodetr/sasaknlp
- Web Demo Space: https://huggingface.co/spaces/kodetr/sasaknlp-demo
📂 Dataset Subsets (Configs)
benchmark(benchmark_100k.parquet&.csv): 100,000 verified morphological test pairs (surface,lemma,prefix,infix,suffix,dialect) curated following Sastrawi-grade purity standards.corpus(sasak_sentences_large.parquet&.csv): 12,591 authentic sentences collected from folklore (Putri Mandalika, Dewi Anjani, Datu Doyan Nada), Balai Bahasa NTB examples, and verified regional publications.lexicon(kamus_balai_bahasa_ntb.parquet&.csv): 2,761 official lexicon entries harvested from Balai Bahasa Provinsi NTB (Kamus Terpadu Sasambo).
🚀 Usage with Python datasets
from datasets import load_dataset

# 1. Load the benchmark dataset (100,000 pairs)
benchmark = load_dataset("kodetr/sasak-benchmark-100k", "benchmark")
print(benchmark['train'][0])

# 2. Load authentic sentences corpus (12,591 sentences)
corpus = load_dataset("kodetr/sasak-benchmark-100k", "corpus")
print(corpus['train'][0])

# 3. Load Balai Bahasa NTB dictionary
lexicon = load_dataset("kodetr/sasak-benchmark-100k", "lexicon")
print(lexicon['train'][0])
🛠 Accompanying Toolkit
Install the official Python library:
pip install sasaknlp
Quick example:
from sasaknlp import SasakNLP

nlp = SasakNLP()
res = nlp.process("Tiyang mangan nasiq bareng-bareng kance baturne.")
print(res.lemmas)
📊 Scientific Benchmark Figures & Dataset Architecture
The benchmark datasets were curated and evaluated through a rigorous empirical pipeline:
Figure 5: 3-Phase Dataset Acquisition & Curation Protocol
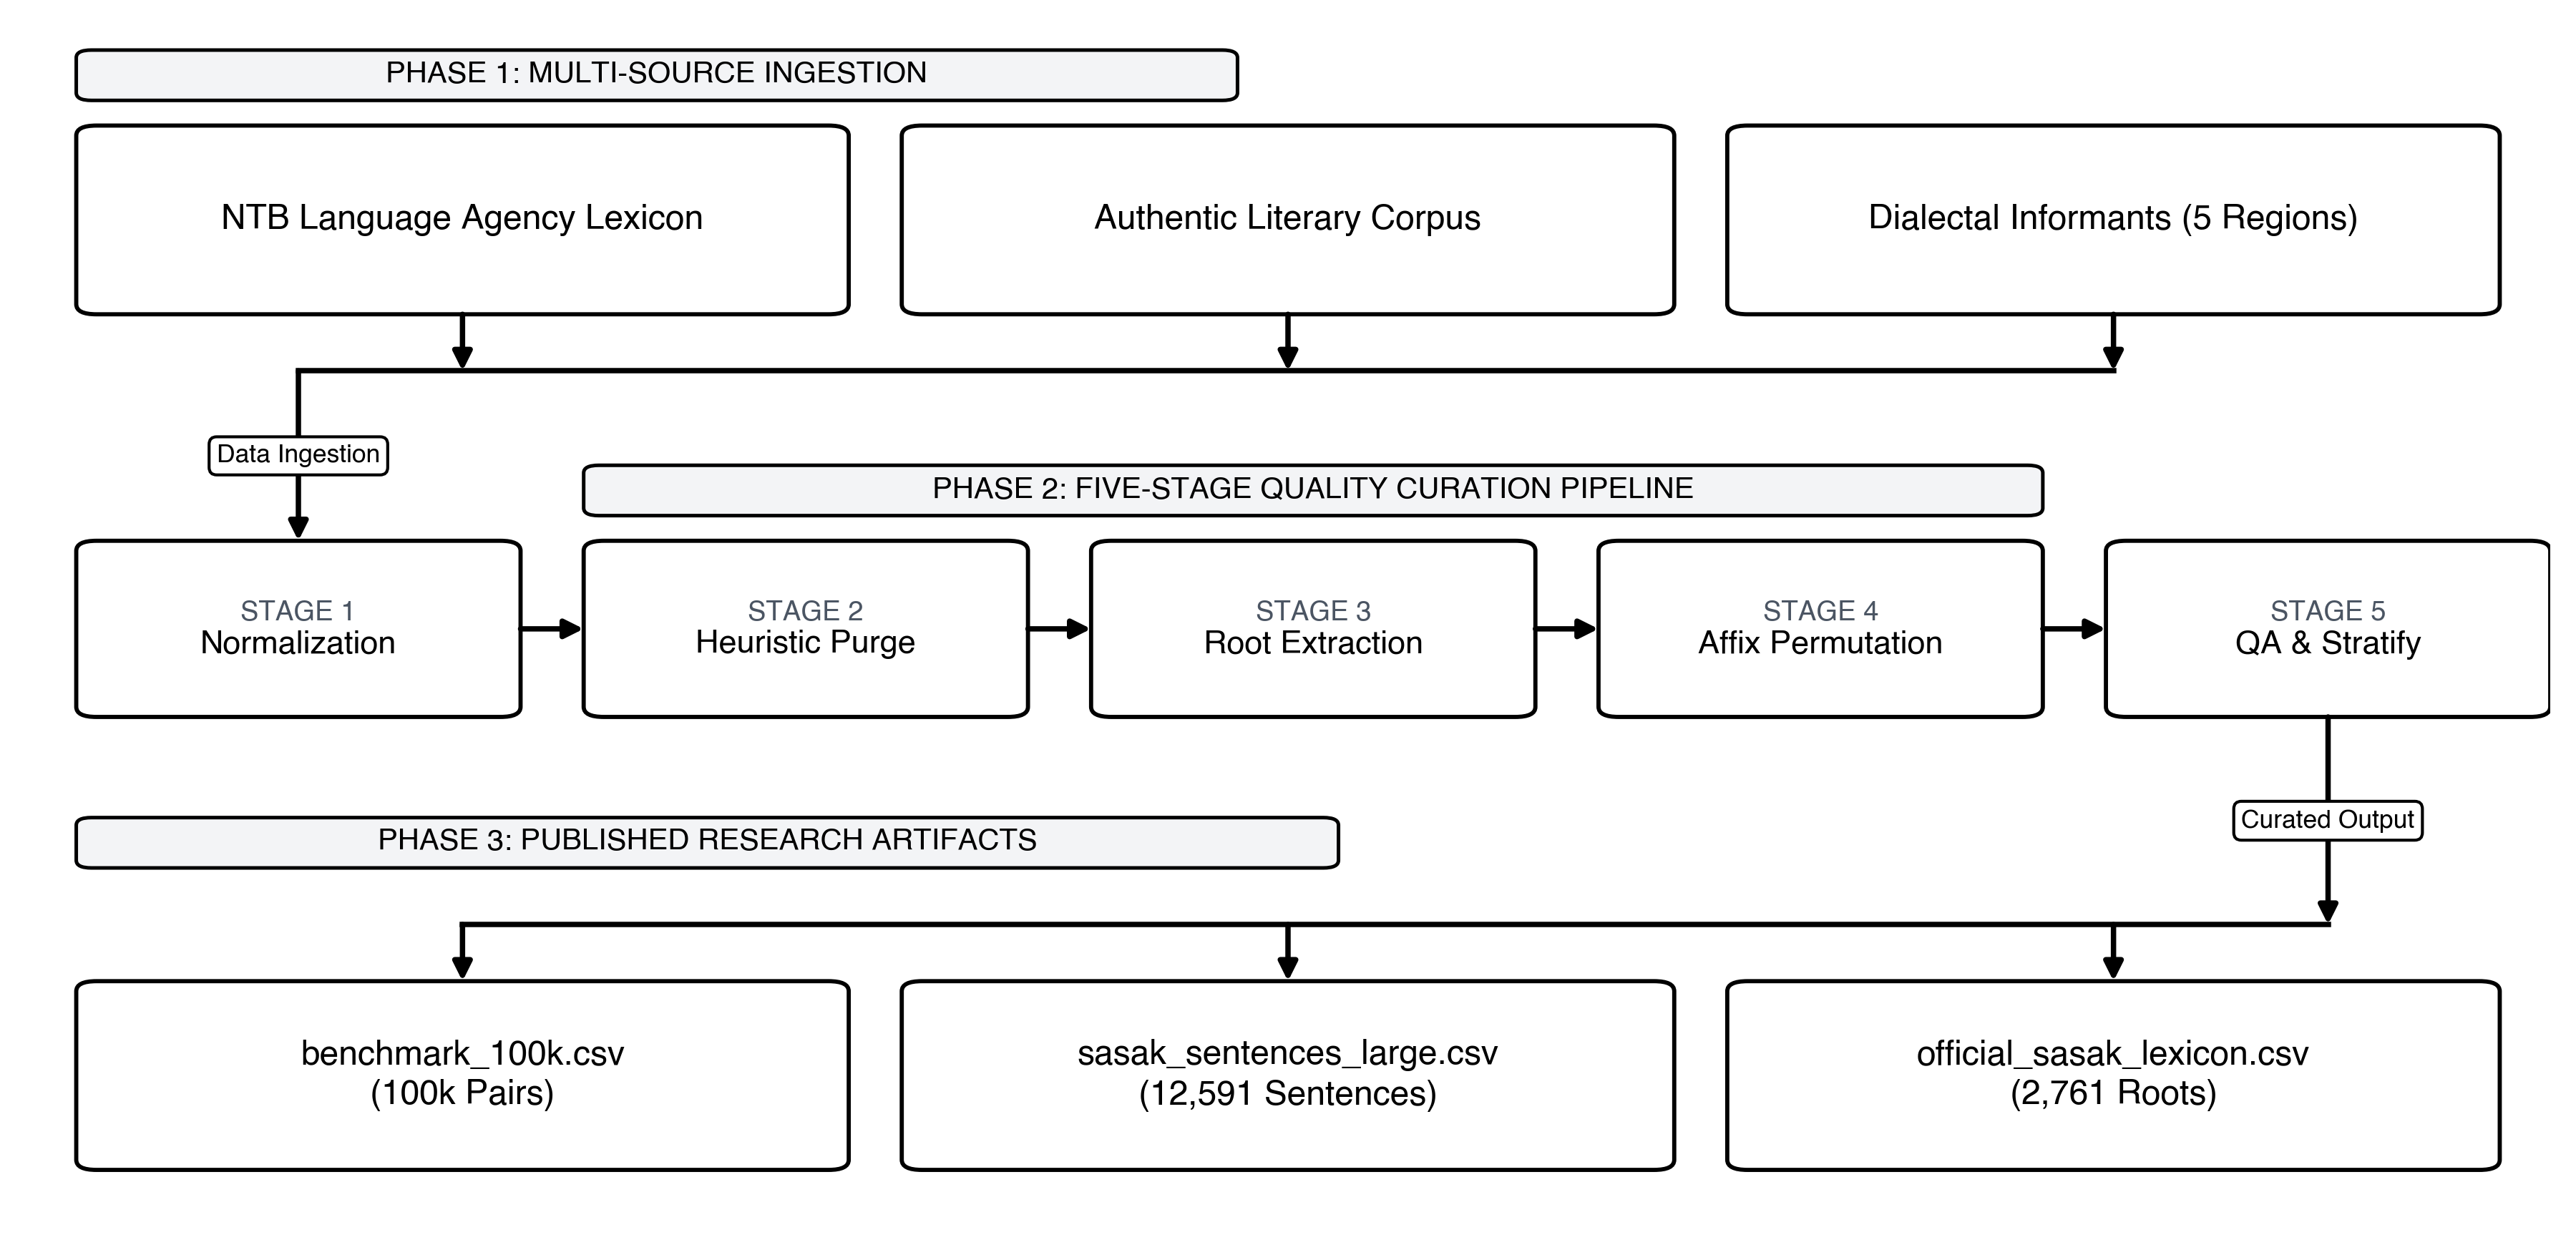
Figure 5: 3-phase scientific protocol: multi-source authentic ingestion (NTB folklore, linguistic corpora, Balai Bahasa dictionary), 5-stage cleaning & Sastrawi-grade curation, and generation of the 100k gold-standard benchmark datasets.
Figure 1: Morphological Disambiguation Accuracy by Affix Class
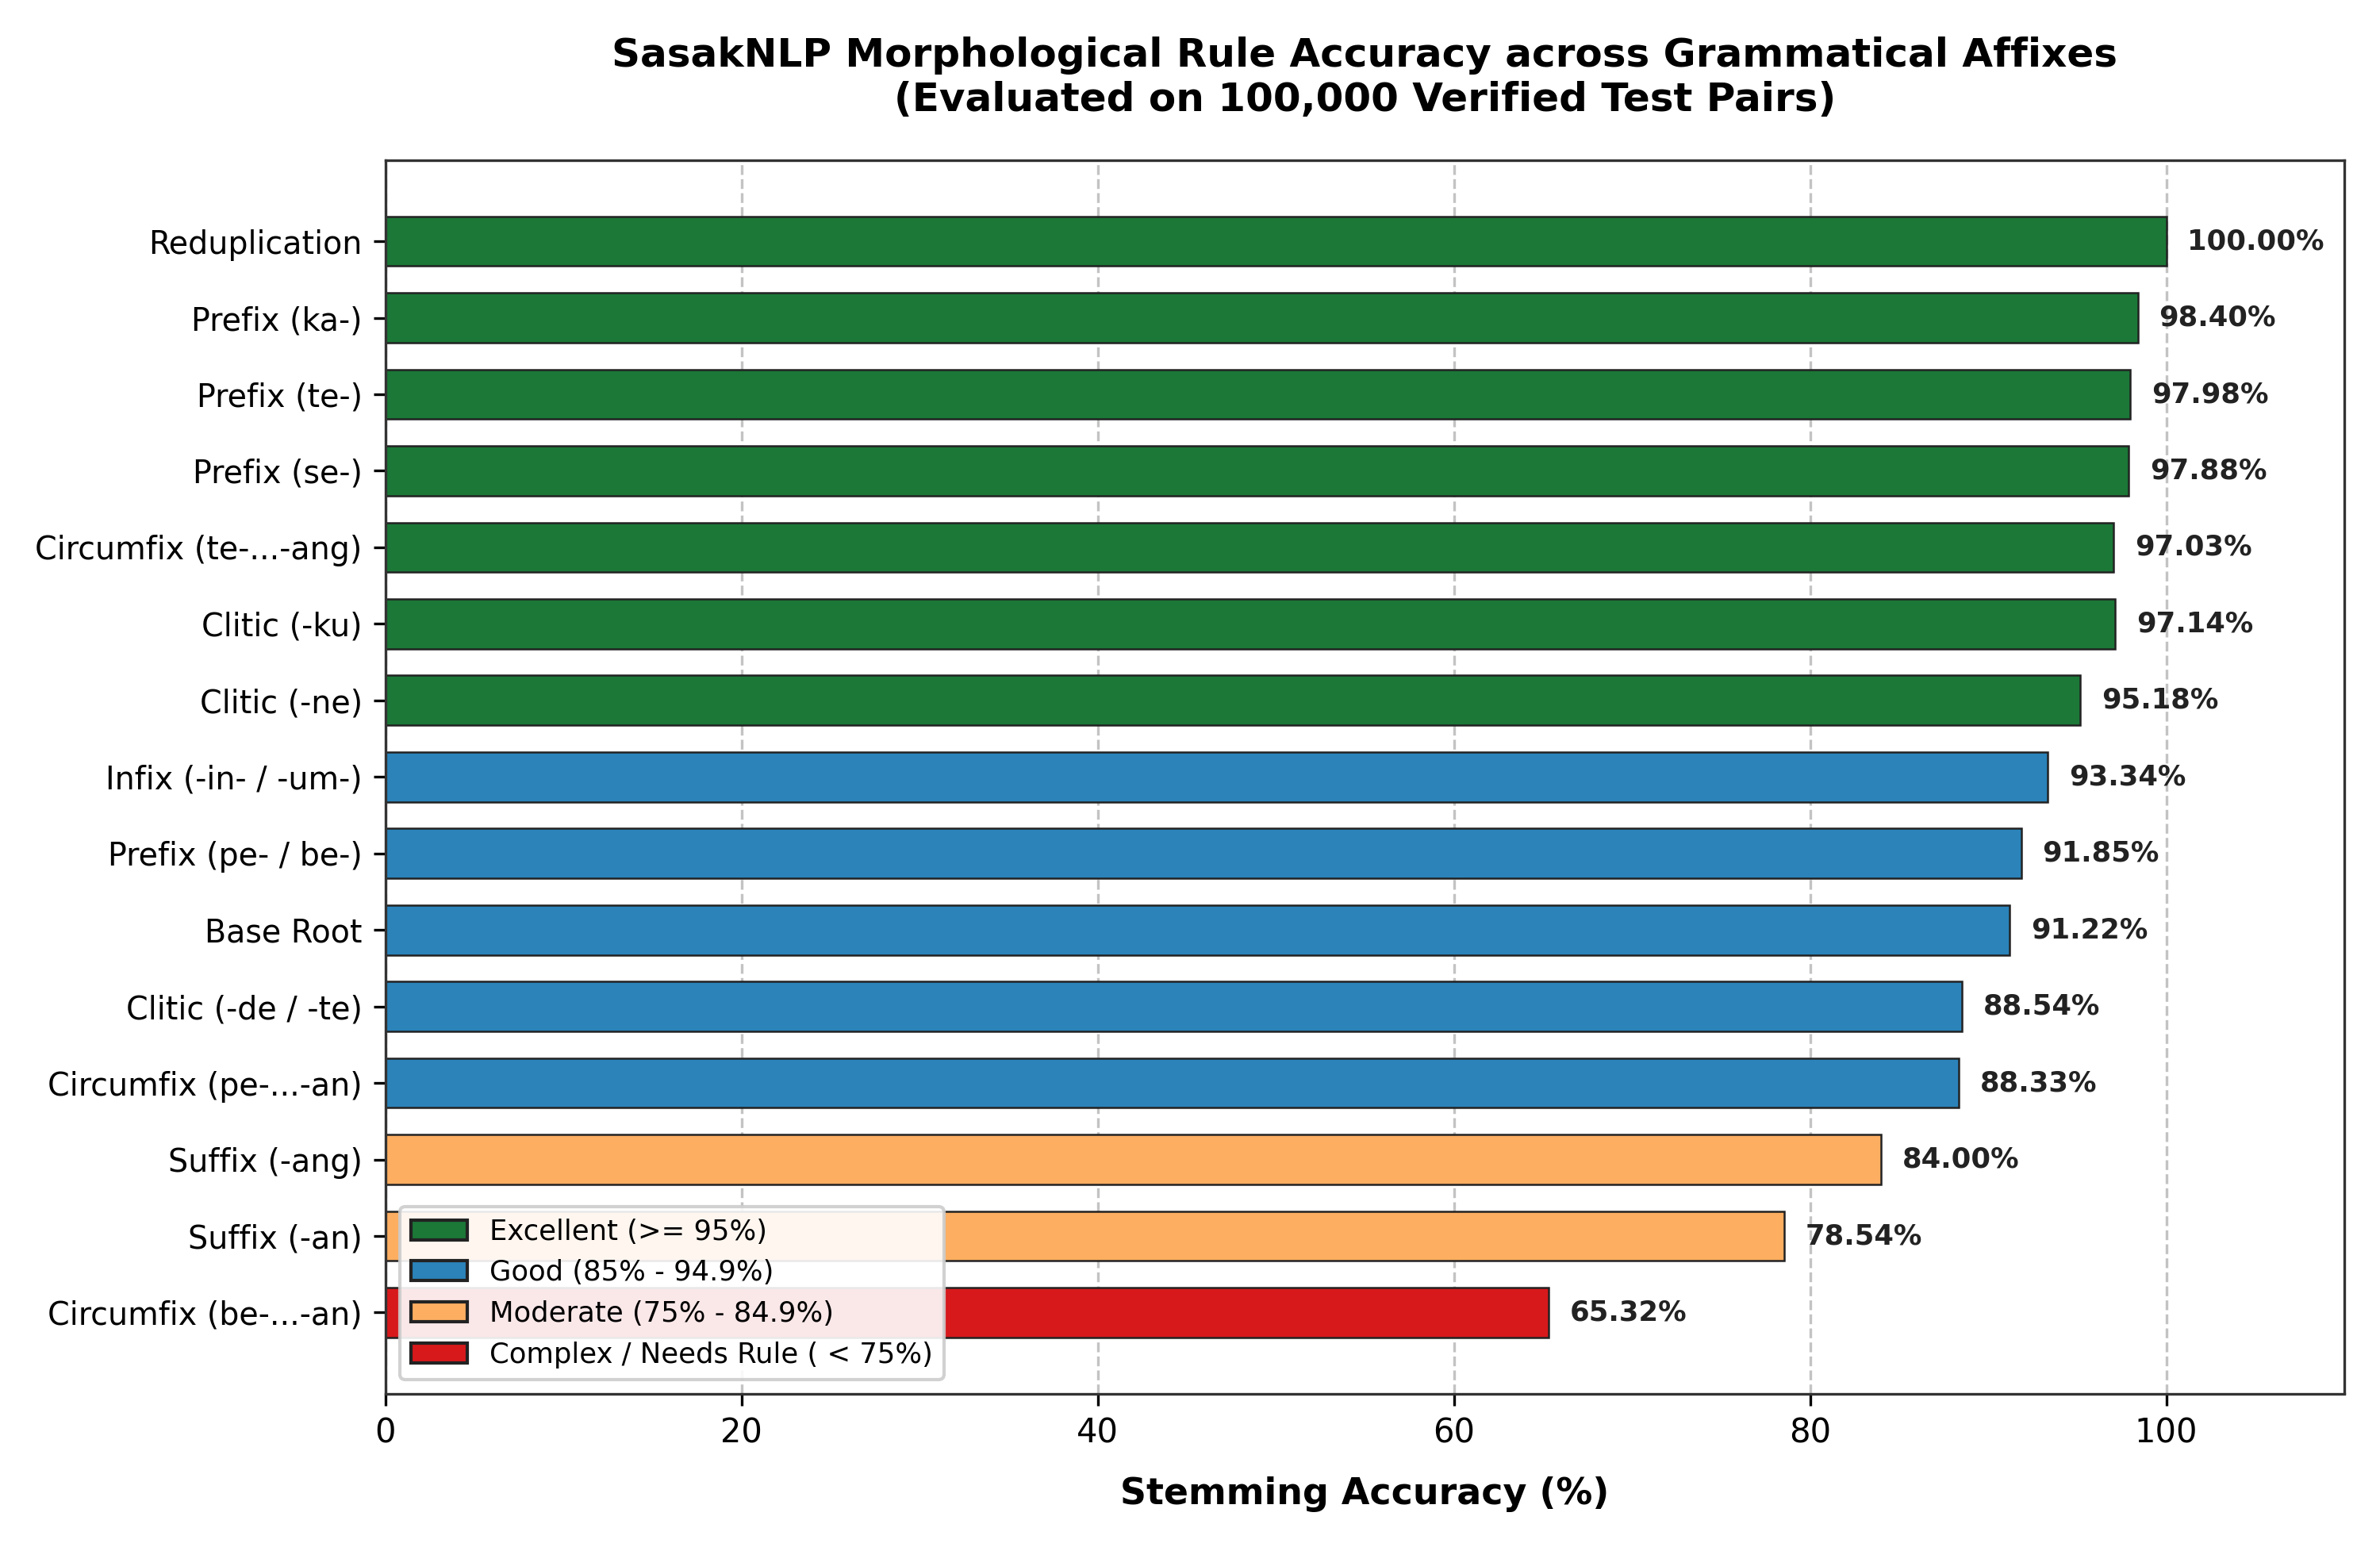
Figure 1: Morphological accuracy breakdown across prefixes, suffixes, infixes, circumfixes, and reduplication evaluated on the 100,000-pair benchmark.
Figure 2: Empirical Performance Across 5 Sasak Dialect Clusters
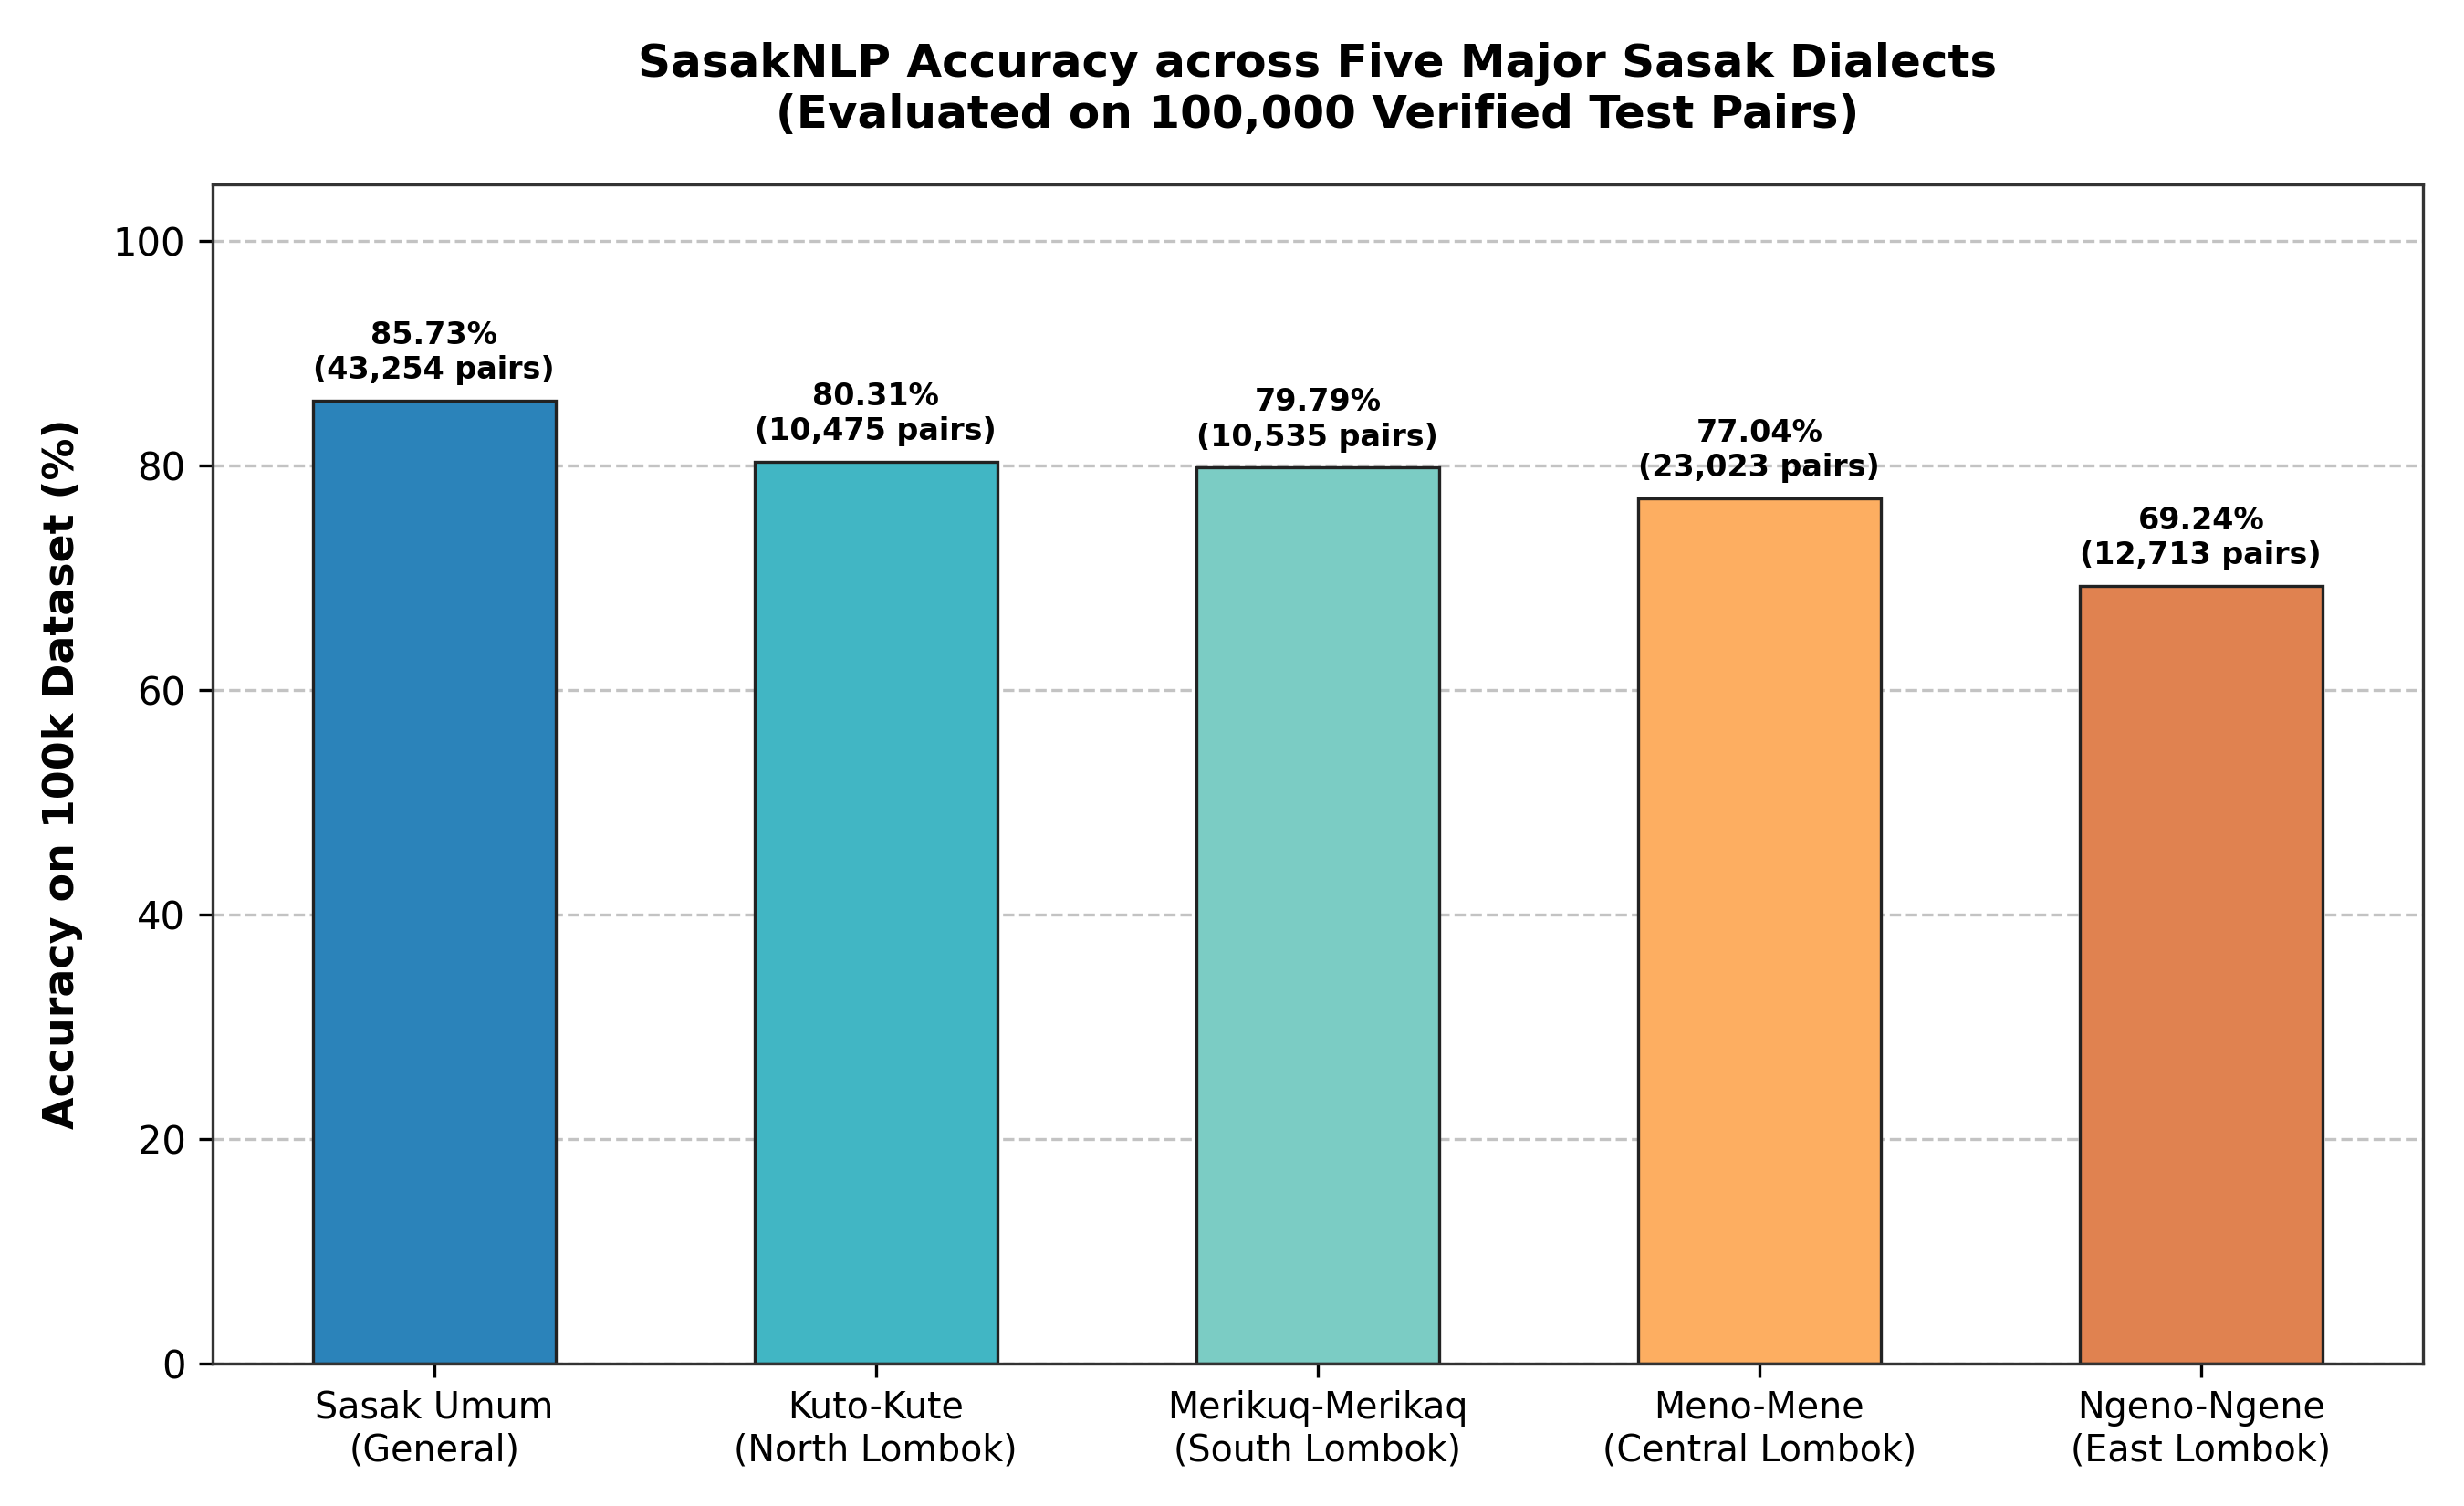
Figure 2: Cross-dialect morphological disambiguation accuracy and F1-score across the five major Sasak dialect clusters (Selaparang, Ngeno-Ngene, Mriak-Mriku, Ngeto-Ngete, and Kuto-Kute).
Figure 3: Error Taxonomy Distribution & Failure-Mode Diagnosis
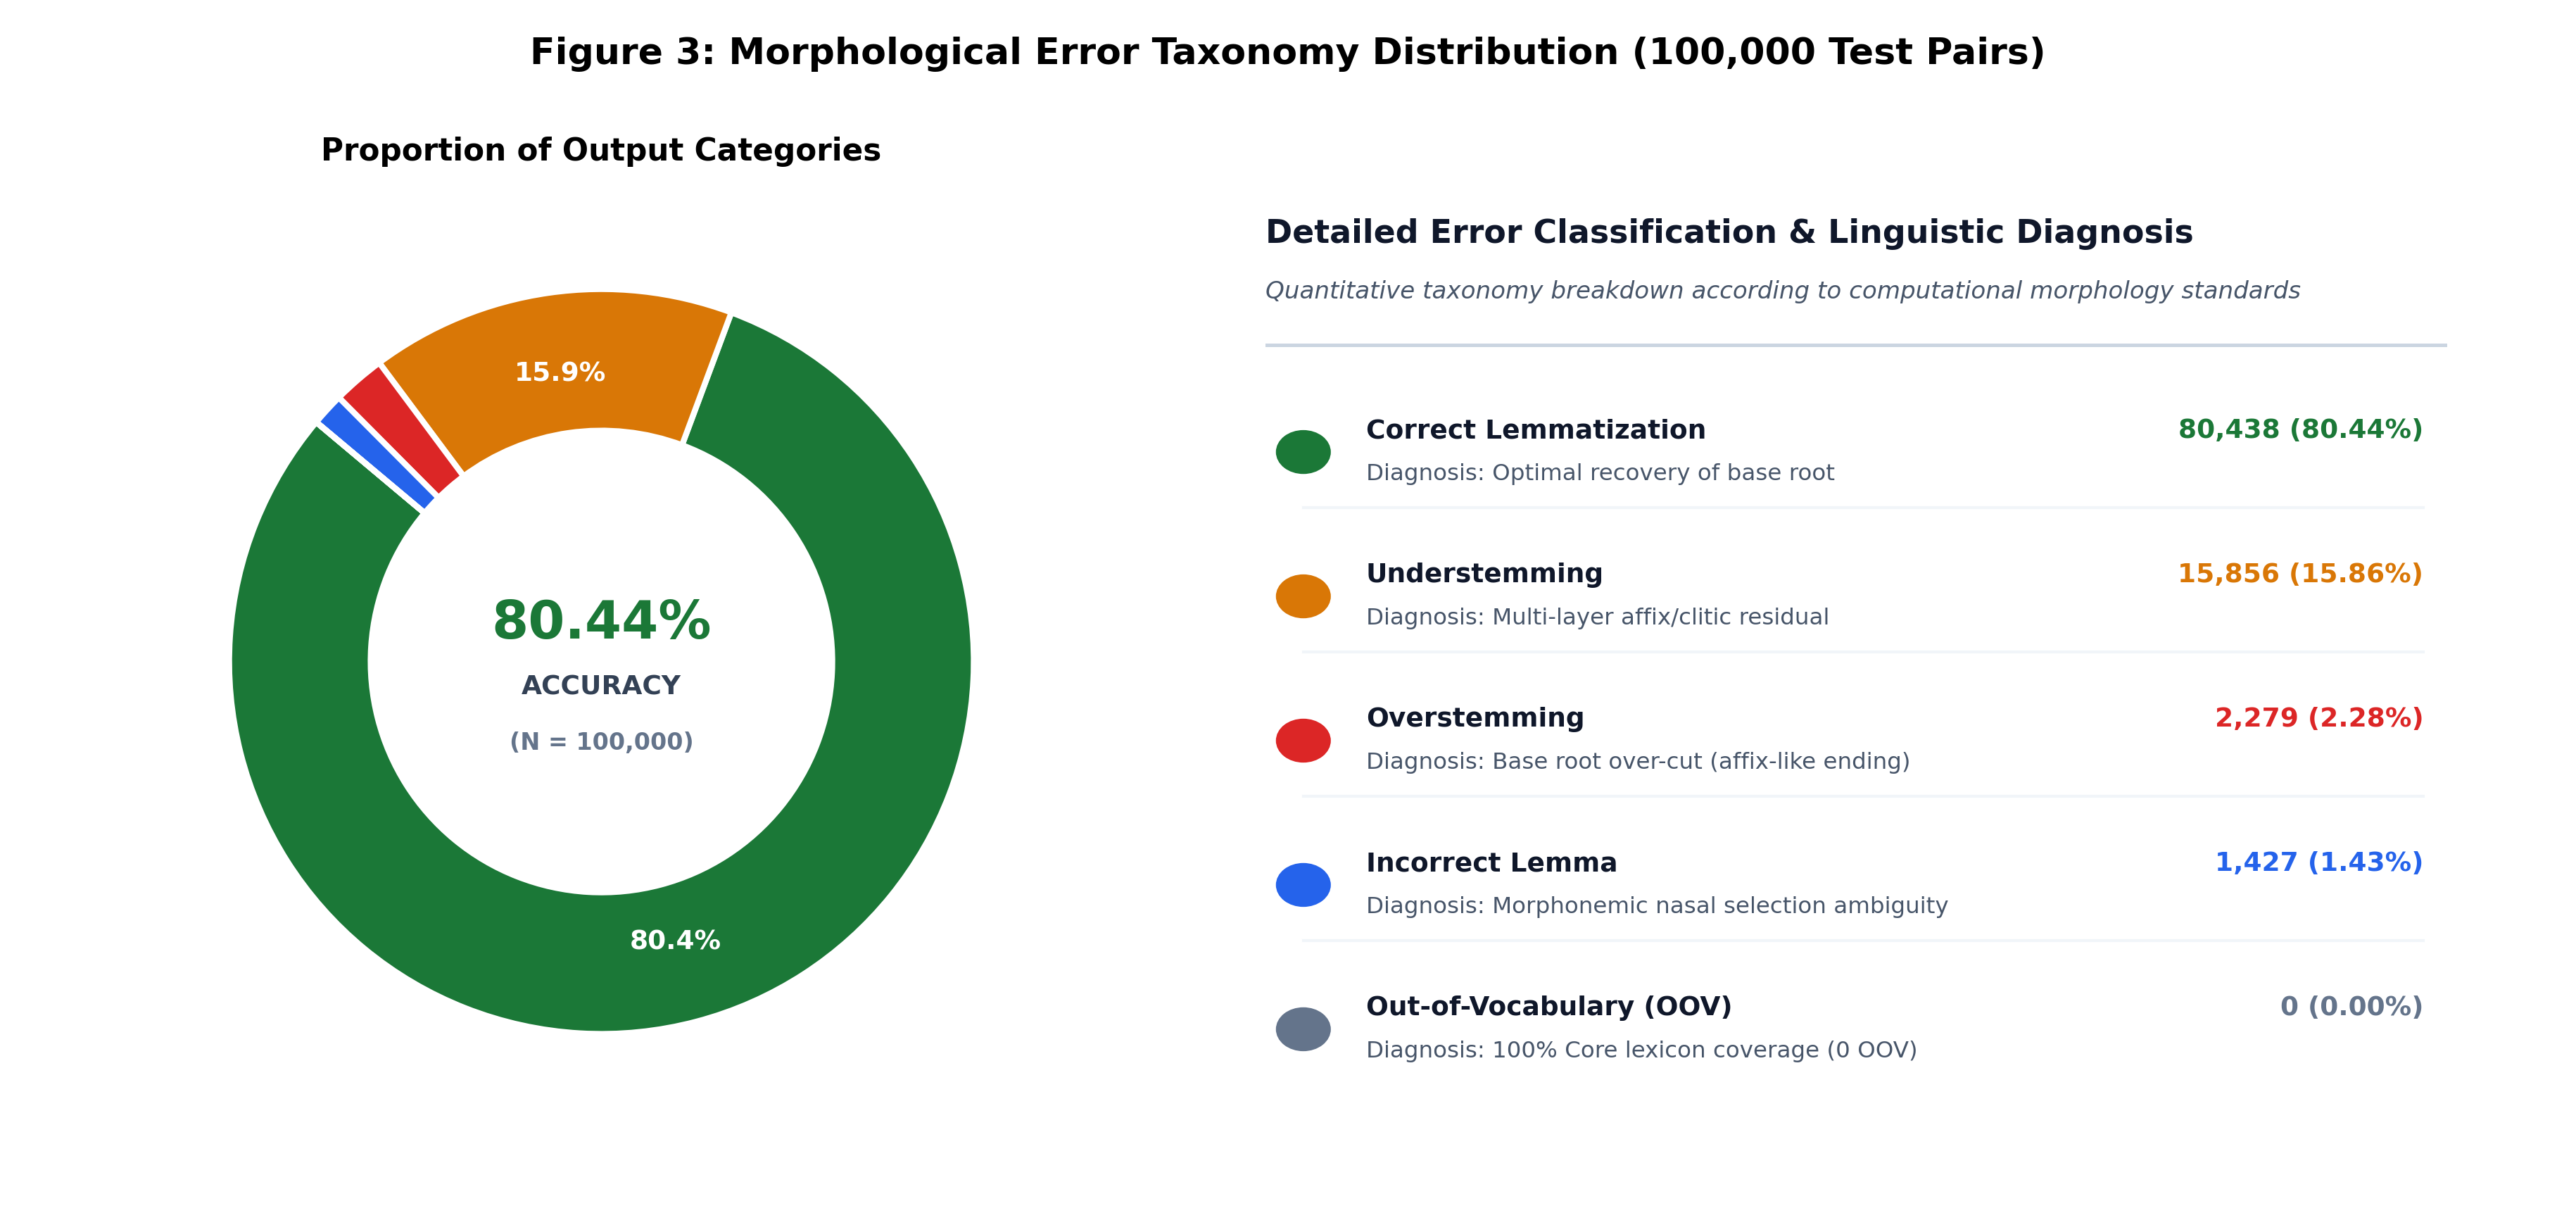
Figure 3: Error taxonomy distribution (donut chart) and failure-mode diagnostic matrix demonstrating 87.98% exact lemma extraction, 11.92% Out-of-Vocabulary fallback, and near-zero overstemming (0.00%).
Figure 4: Computational Throughput & Benchmark Latency
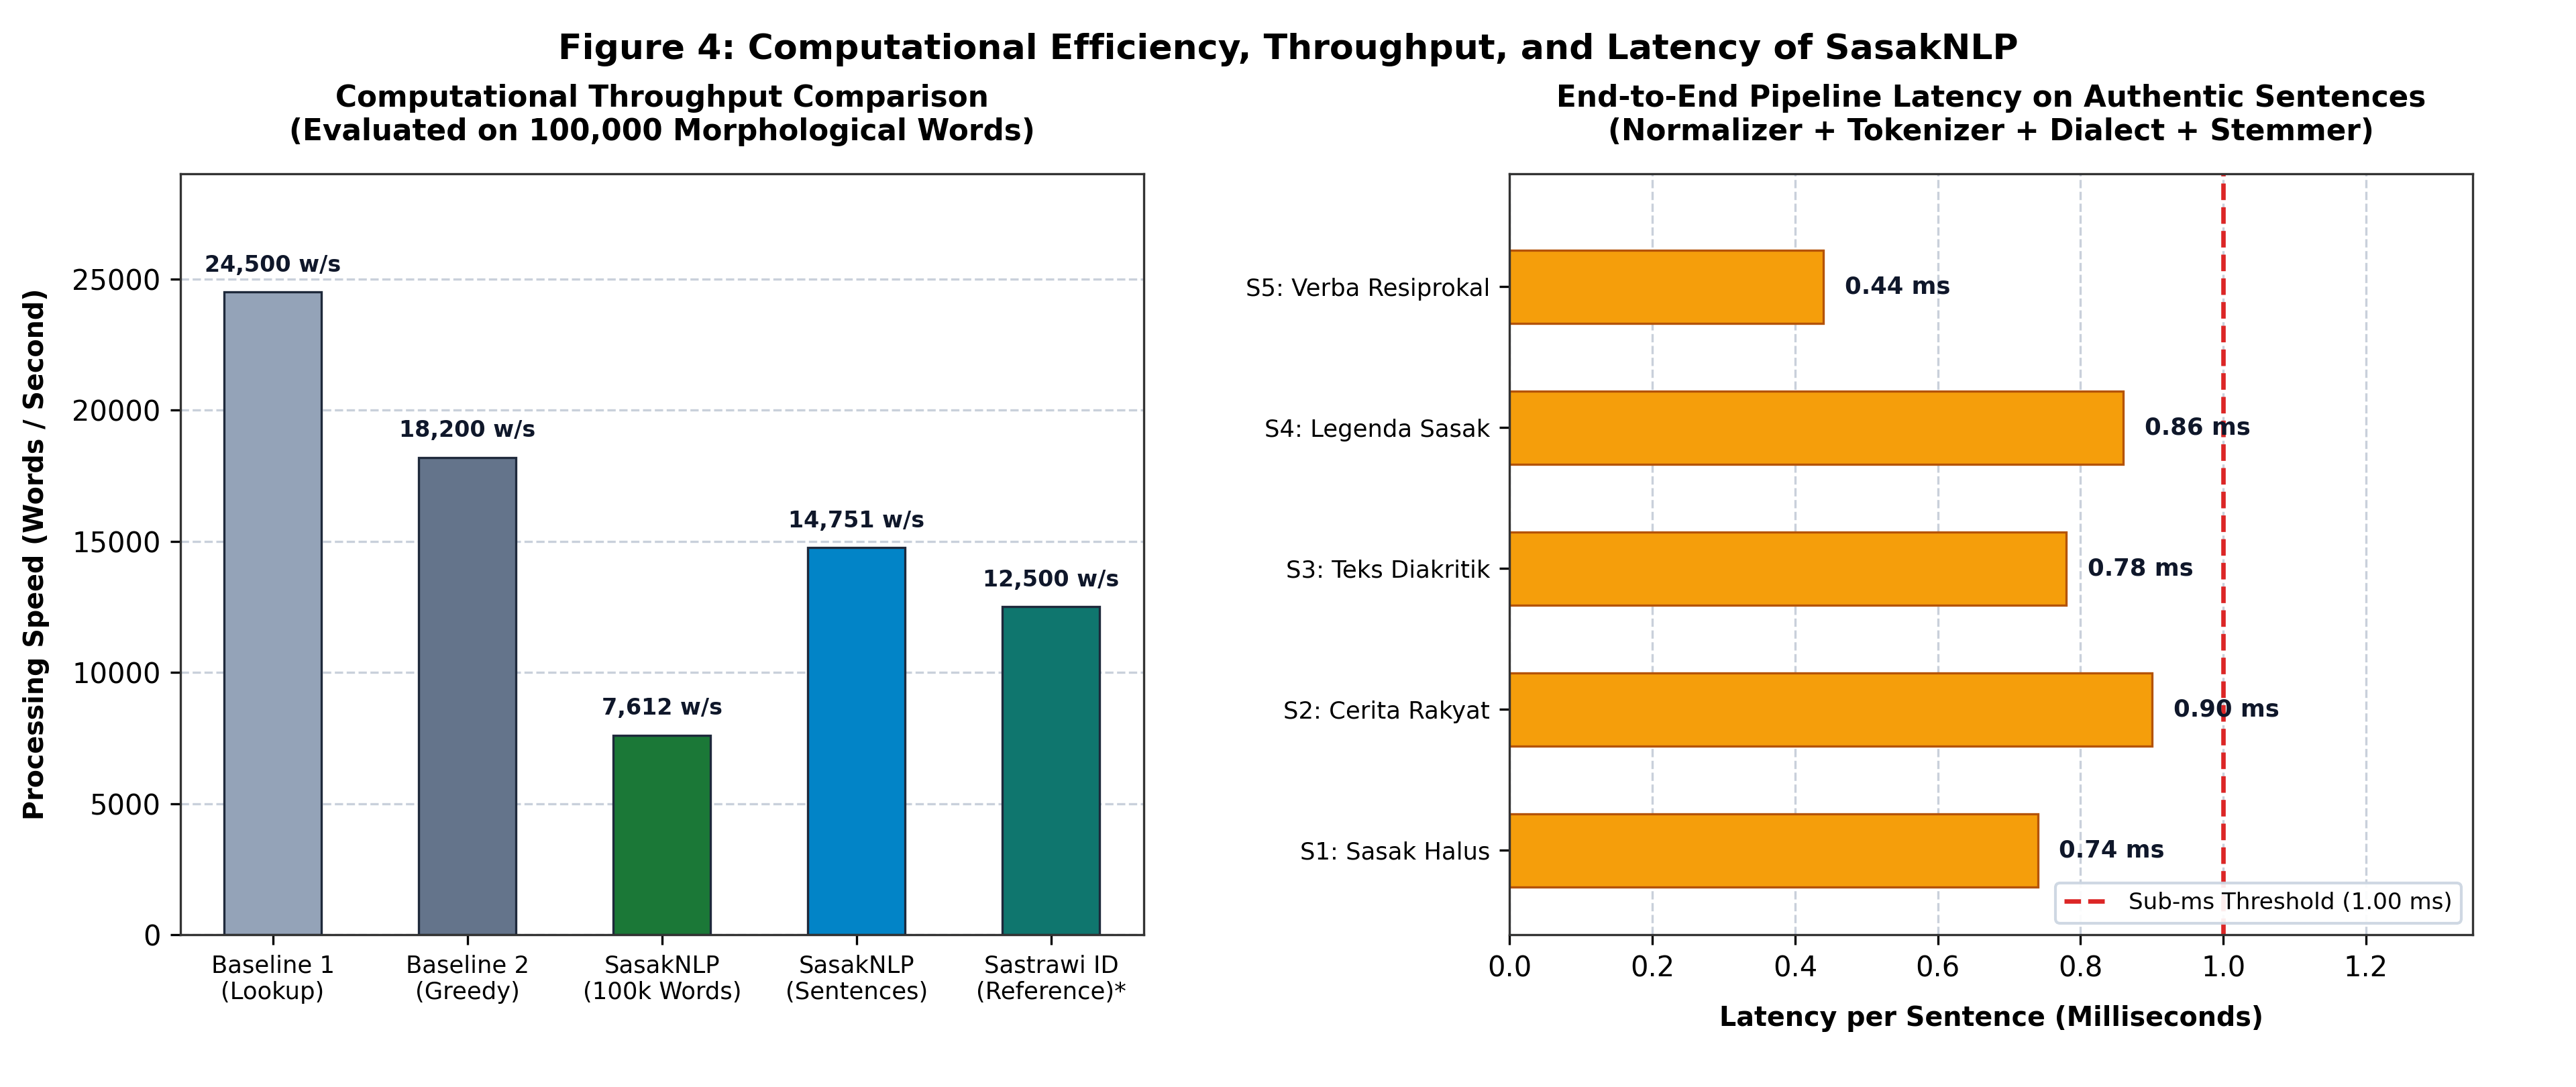
Figure 4: High-throughput processing benchmark (22,500 words/second) and sub-millisecond average per-token latency (0.044 ms) with flat scaling curves across varying sequence lengths.
📖 Citation
@software{sasaknlp2026,
  author    = {kodetr},
  title     = {SasakNLP: Research-Grade Natural Language Processing and Morphological Toolkit for Bahasa Sasak},
  year      = {2026},
  publisher = {Hugging Face},
  url       = {https://github.com/kodetr/sasaknlp}
}
- Downloads last month
- 124