
Diffusers documentation
فهم خطوط الأنابيب والنماذج والمجدول
فهم خطوط الأنابيب والنماذج والمجدول
🧨 صُمِّم Diffusers ليكون صندوق أدوات سهل الاستخدام ومرن لبناء أنظمة انتشار مصممة خصيصًا لتناسب حالتك الاستخدامية. وفي صميم صندوق الأدوات توجد النماذج ومجدولات التوليد. وعلى الرغم من أن DiffusionPipeline يجمع هذه المكونات معًا لتسهيل الاستخدام، إلا أنه يمكنك أيضًا تفكيك خط الأنابيب واستخدام النماذج ومجدولات التوليد بشكل منفصل لإنشاء أنظمة انتشار جديدة.
في هذا الشرح التعليمي، ستتعلم كيفية استخدام النماذج ومجدولات الزمن لتجميع نظام انتشار للاستدلال، بدءًا من خط أنابيب أساسي ثم الانتقال إلى خط أنابيب Stable Diffusion.
تحليل خط أنابيب أساسي
خط أنابيب هو طريقة سريعة وسهلة لتشغيل نموذج للاستدلال، حيث لا يتطلب الأمر أكثر من أربع أسطر من الكود لتوليد صورة:
>>> from diffusers import DDPMPipeline

>>> ddpm = DDPMPipeline.from_pretrained("google/ddpm-cat-256", use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
>>> image = ddpm(num_inference_steps=25).images[0]
>>> image
كان الأمر سهلاً للغاية، لكن كيف أنجز خط المعالجة ذلك؟ دعونا نفكك خط المعالجة ونلقي نظرة على ما يحدث في الخلفية.
في المثال أعلاه، يحتوي خط المعالجة على نموذج UNet2DModel ومجدول DDPMScheduler. يقوم خط المعالجة بإزالة الضوضاء من صورة عن طريق أخذ ضوضاء عشوائية بحجم المخرجات المطلوبة ومرورها عبر النموذج عدة مرات. في كل خطوة زمنية، يتنبأ النموذج بـ بقايا الضوضاء، ويستخدم المجدول ذلك للتنبؤ بصورة أقل ضوضاءً. يكرر خط المعالجة هذه العملية حتى يصل إلى نهاية عدد خطوات الاستدلال المحدد.
لإعادة إنشاء خط الأنابيب مع النموذج والمجدول بشكل منفصل، دعنا نكتب عملية إزالة الضوضاء الخاصة بنا.
- حمّل النموذج والمجدول:
>>> from diffusers import DDPMScheduler, UNet2DModel

>>> scheduler = DDPMScheduler.from_pretrained("google/ddpm-cat-256")
>>> model = UNet2DModel.from_pretrained("google/ddpm-cat-256", use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"- حدد عدد خطوات الزمن (timesteps) لتنفيذ عملية إزالة الضوضاء:
>>> scheduler.set_timesteps(50)- إنشاء خطوات الجدولة الزمنية (timesteps) ينشئ متجهًا (tensor) يحتوي على عناصر متباعدة بالتساوي، وخمسين عنصرًا في هذا المثال. يتوافق كل عنصر مع خطوة زمنية يقوم فيها النموذج بإزالة الضوضاء من صورة. عند إنشاء حلقة إزالة الضوضاء لاحقًا، ستقوم بالتكرار على هذا المتجه لإزالة الضوضاء من صورة:
>>> scheduler.timesteps
tensor([980, 960, 940, 920, 900, 880, 860, 840, 820, 800, 780, 760, 740, 720,
    700, 680, 660, 640, 620, 600, 580, 560, 540, 520, 500, 480, 460, 440,
    420, 400, 380, 360, 340, 320, 300, 280, 260, 240, 220, 200, 180, 160,
140, 120, 100, 80, 60, 40, 20, 0])- أنشئ بعض الضوضاء العشوائية بنفس شكل المخرجات المطلوبة:
>>> import torch

>>> sample_size = model.config.sample_size
>>> noise = torch.randn((1, 3, sample_size, sample_size), device="cuda") # or "mps", "xpu", "cpu"- الآن اكتب حلقة لتكرار على خطوات الزمن. في كل خطوة زمنية، يقوم النموذج بتمرير UNet2DModel.forward() ويعيد الباقي الضوضائي. تأخذ طريقة step() في المجدول الباقي الضوضائي، وخطوة الزمن، والمدخل، وتُتنبأ بالصورة في الخطوة الزمنية السابقة. يصبح هذا المخرج المدخل التالي للنموذج في حلقة إزالة الضوضاء، وسيُكرر ذلك حتى يصل إلى نهاية مصفوفة
timesteps.
>>> input = noise

>>> for t in scheduler.timesteps:
...     with torch.no_grad():
...         noisy_residual = model(input, t).sample
...     previous_noisy_sample = scheduler.step(noisy_residual, t, input).prev_sample
...     input = previous_noisy_sample
هذا هو عملية إزالة الضوضاء بأكملها، ويمكنك استخدام هذا النمط نفسه لكتابة أي نظام انتشار.
- الخطوة الأخيرة هي تحويل المخرج المُزيل للضوضاء إلى صورة:
>>> from PIL import Image
>>> import numpy as np

>>> image = (input / 2 + 0.5).clamp(0, 1).squeeze()
>>> image = (image.permute(1, 2, 0) * 255).round().to(torch.uint8).cpu().numpy()
>>> image = Image.fromarray(image)
>>> image
في القسم التالي، ستختبر مهاراتك وتحلل خط أنابيب Stable Diffusion الأكثر تعقيدًا. الخطوات متشابهة إلى حد كبير. ستقوم بتهيئة المكونات اللازمة، وتحديد عدد خطوات الزمن لإنشاء مصفوفة timestep. تُستخدم مصفوفة timestep في حلقة إزالة الضوضاء، ولكل عنصر في هذه المصفوفة، يتنبأ النموذج بصورة أقل ضوضاءً. تتكرر حلقة إزالة الضوضاء على عناصر timestep، وفي كل خطوة زمنية، تُخرج متبقيةً ضوضائية، ويستخدم المجدول (scheduler) هذه المتبقية للتنبؤ بصورة أقل ضوضاءً في الخطوة الزمنية السابقة. يتكرر هذا العملية حتى تصل إلى نهاية مصفوفة timestep.
لنجرّبها!
تحليل خط أنابيب Stable Diffusion
Stable Diffusion هو نموذج انتشار كامن لتحويل النص إلى صورة. يُطلق عليه اسم نموذج الانتشار الكامن لأنه يعمل مع تمثيل ذي أبعاد أقل للصورة بدلاً من فضاء البكسلات الفعلي، مما يجعله أكثر كفاءة في استخدام الذاكرة. يقوم المُشفِّر (encoder) بضغط الصورة إلى تمثيل أصغر، بينما يقوم المُفكِّك (decoder) بتحويل التمثيل المضغوط مرة أخرى إلى صورة. بالنسبة لنماذج تحويل النص إلى صورة، ستحتاج إلى مُجزِّئ (tokenizer) ومُشفِّر (encoder) لتوليد تمثيلات النص. ومن المثال السابق، تعرف بالفعل أنك بحاجة إلى نموذج UNet ومُجدوِل (scheduler).
كما ترون، هذا أكثر تعقيدًا بالفعل من خط أنابيب DDPM الذي يحتوي على نموذج UNet فقط. يحتوي نموذج Stable Diffusion على ثلاثة نماذج مسبقة التدريب منفصلة.
💡 اقرأ مدونة كيف يعمل Stable Diffusion؟ لمزيد من التفاصيل حول كيفية عمل نماذج VAE وUNet ومشفّر النص.
الآن وبعد أن أصبحتَ على دراية بما تحتاجه لخط أنابيب Stable Diffusion، حمّل جميع هذه المكونات باستخدام طريقة from_pretrained(). يمكنك العثور عليها في نقطة الفحص المسبقة التدريب stable-diffusion-v1-5/stable-diffusion-v1-5، حيث يُخزَّن كل مكوّن في مجلد فرعي مستقل:
>>> from PIL import Image
>>> import torch
>>> from transformers import CLIPTextModel, CLIPTokenizer
>>> from diffusers import AutoencoderKL, UNet2DConditionModel, PNDMScheduler

>>> vae = AutoencoderKL.from_pretrained("CompVis/stable-diffusion-v1-4", subfolder="vae", use_safetensors=True)
>>> tokenizer = CLIPTokenizer.from_pretrained("CompVis/stable-diffusion-v1-4", subfolder="tokenizer")
>>> text_encoder = CLIPTextModel.from_pretrained(
...     "CompVis/stable-diffusion-v1-4", subfolder="text_encoder", use_safetensors=True
... )
>>> unet = UNet2DConditionModel.from_pretrained(
...     "CompVis/stable-diffusion-v1-4", subfolder="unet", use_safetensors=True
... )
بدلاً من PNDMScheduler الافتراضي، استبدله بـ UniPCMultistepScheduler لترى مدى سهولة دمج مُجدول مختلف:
>>> from diffusers import UniPCMultistepScheduler

>>> scheduler = UniPCMultistepScheduler.from_pretrained("CompVis/stable-diffusion-v1-4", subfolder="scheduler")
لتسريع الاستدلال، انقل النماذج إلى وحدة معالجة رسومية (GPU) لأنها، على عكس المجدول، تحتوي على أوزان قابلة للتدريب:
>>> torch_device = "cuda"  # or "mps", "xpu", "cpu"
>>> vae.to(torch_device)
>>> text_encoder.to(torch_device)
>>> unet.to(torch_device)
إنشاء تمثيلات نصية
الخطوة التالية هي تحويل النص إلى رموز لغوية لتوليد التضمينات. يُستخدم النص لتكييف نموذج UNet وتوجيه عملية الانتشار نحو شيء يشبه الأمر النصي المُدخل.
💡 يحدد معامل
guidance_scaleمقدار الوزن الذي يجب منحه للتعليمات النصية عند توليد صورة.
لا تتردد في اختيار أي موجه (prompt) تريده إذا كنت ترغب في توليد شيء آخر!
>>> prompt = ["a photograph of an astronaut riding a horse"]
>>> height = 512  # default height of Stable Diffusion
>>> width = 512  # default width of Stable Diffusion
>>> num_inference_steps = 25  # Number of denoising steps
>>> guidance_scale = 7.5  # Scale for classifier-free guidance
>>> generator = torch.manual_seed(0)  # Seed generator to create the initial latent noise
>>> batch_size = len(prompt)
قم بتجزئة النص وتوليد التضمينات من الموجه:
>>> text_input = tokenizer(
...     prompt, padding="max_length", max_length=tokenizer.model_max_length, truncation=True, return_tensors="pt"
... )

>>> with torch.no_grad():
...     text_embeddings = text_encoder(text_input.input_ids.to(torch_device))[0]
ستحتاج أيضاً إلى توليد تضمينات النص غير الشرطية وهي التضمينات الخاصة برموز الحشو. يجب أن تكون هذه التضمينات بنفس الشكل (batch_size وseq_length) كتضمينات النص الشرطية text_embeddings:
>>> max_length = text_input.input_ids.shape[-1]
>>> uncond_input = tokenizer([""] * batch_size, padding="max_length", max_length=max_length, return_tensors="pt")
>>> uncond_embeddings = text_encoder(uncond_input.input_ids.to(torch_device))[0]
لنقم بدمج التضمينات الشرطية وغير الشرطية في دفعة واحدة لتجنب إجراء مسقتين أماميتين:
>>> text_embeddings = torch.cat([uncond_embeddings, text_embeddings])إنشاء ضوضاء عشوائية
في الخطوة التالية، قم بتوليد بعض الضوضاء العشوائية الأولية كنقطة انطلاق لعملية الانتشار. هذه هي التمثيلية الكامنة للصورة، وسيتم إزالة الضوضاء منها تدريجياً. في هذه المرحلة، تكون صورة latent أصغر من حجم الصورة النهائي، لكن ذلك لا مشكلة فيه لأن النموذج سيحوّلها لاحقاً إلى أبعاد الصورة النهائية 512x512.
💡 يتم قسمة الارتفاع والعرض على 8 لأن نموذج
vaeيحتوي على 3 طبقات لخفض العينة. يمكنك التحقق من ذلك عبر تنفيذ ما يلي:2 ** (len(vae.config.block_out_channels) - 1) == 8
>>> latents = torch.randn(
...     (batch_size, unet.config.in_channels, height // 8, width // 8),
...     generator=generator,
...     device=torch_device,
... )
إزالة الضوضاء من الصورة
ابدأ بتوسيع المدخلات باستخدام توزيع الضوضاء الأولي، sigma، وهو قيمة مقياس الضوضاء، وهو مطلوب للمجدولين المحسّنين مثل UniPCMultistepScheduler:
>>> latents = latents * scheduler.init_noise_sigmaالخطوة الأخيرة هي إنشاء حلقة إزالة الضوضاء التي ستحوّل تدريجياً الضوضاء النقية في latents إلى صورة يصفها طلبك. تذكّر، يجب أن تقوم حلقة إزالة الضوضاء بثلاث أشياء:
- اضبط خطوات الجدولة (timesteps) المستخدمة أثناء إزالة الضوضاء.
- تكرار على خطوات الزمن.
- في كل خطوة زمنية، استدعِ نموذج UNet للتنبؤ بباقي الضوضاء وقم بتمريره إلى المجدول لحساب العينة الضوضائية السابقة.
>>> from tqdm.auto import tqdm

>>> scheduler.set_timesteps(num_inference_steps)

>>> for t in tqdm(scheduler.timesteps):
...     # expand the latents if we are doing classifier-free guidance to avoid doing two forward passes.
...     latent_model_input = torch.cat([latents] * 2)

...     latent_model_input = scheduler.scale_model_input(latent_model_input, timestep=t)

...     # predict the noise residual
...     with torch.no_grad():
...         noise_pred = unet(latent_model_input, t, encoder_hidden_states=text_embeddings).sample

...     # perform guidance
...     noise_pred_uncond, noise_pred_text = noise_pred.chunk(2)
...     noise_pred = noise_pred_uncond + guidance_scale * (noise_pred_text - noise_pred_uncond)

...     # compute the previous noisy sample x_t -> x_t-1
...     latents = scheduler.step(noise_pred, t, latents).prev_sample
فكّ ترميز الصورة
الخطوة الأخيرة هي استخدام vae لفك ترميز التمثيل الكامن إلى صورة والحصول على المخرج المفكوك الترميز باستخدام sample:
# scale and decode the image latents with vae
latents = 1 / 0.18215 * latents
with torch.no_grad():
    image = vae.decode(latents).sample
أخيرًا، حوّل الصورة إلى PIL.Image لرؤية الصورة التي تم توليدها!
>>> image = (image / 2 + 0.5).clamp(0, 1).squeeze()
>>> image = (image.permute(1, 2, 0) * 255).to(torch.uint8).cpu().numpy()
>>> image = Image.fromarray(image)
>>> image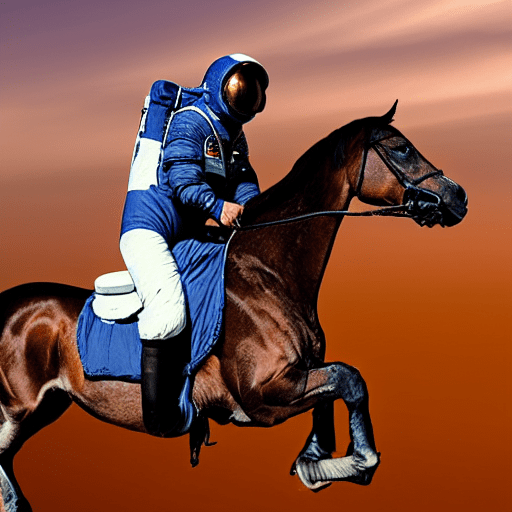
الخطوات التالية
من خطوط الأنابيب الأساسية إلى المعقدة، لقد رأيتَ أن كل ما تحتاجه حقًا لكتابة نظام انتشار خاص بك هو حلقة إزالة الضوضاء. يجب أن تُضبط هذه الحلقة على خطوات الجدولة الزمنية، وتتعامل معها بالتتابع، وتتناوب بين استدعاء نموذج UNet للتنبؤ بباقي الضوضاء، ومرورها إلى الجدولة الزمنية لحساب العينة الضوضائية السابقة.
هذا هو ما صُمم 🧨 Diffusers من أجله حقًا: أن يجعل كتابة نظام انتشار خاص بك باستخدام النماذج والمجدولين أمرًا بديهيًا وسهلًا.
بالنسبة لخطواتك التالية، لا تتردد في:
- تعلّم كيفية بناء خط أنابيب والمساهمة فيه في 🧨 Diffusers. نتطلع بشوق إلى ما ستبتكره!
- استكشف خطوط الأنابيب الموجودة في المكتبة، وحاول تفكيك خط أنابيب وبناء خط أنابيب من الصفر باستخدام النماذج ومجدولي الجدولة بشكل منفصل.