
Diffusers documentation
PixArt-α
PixArt-α
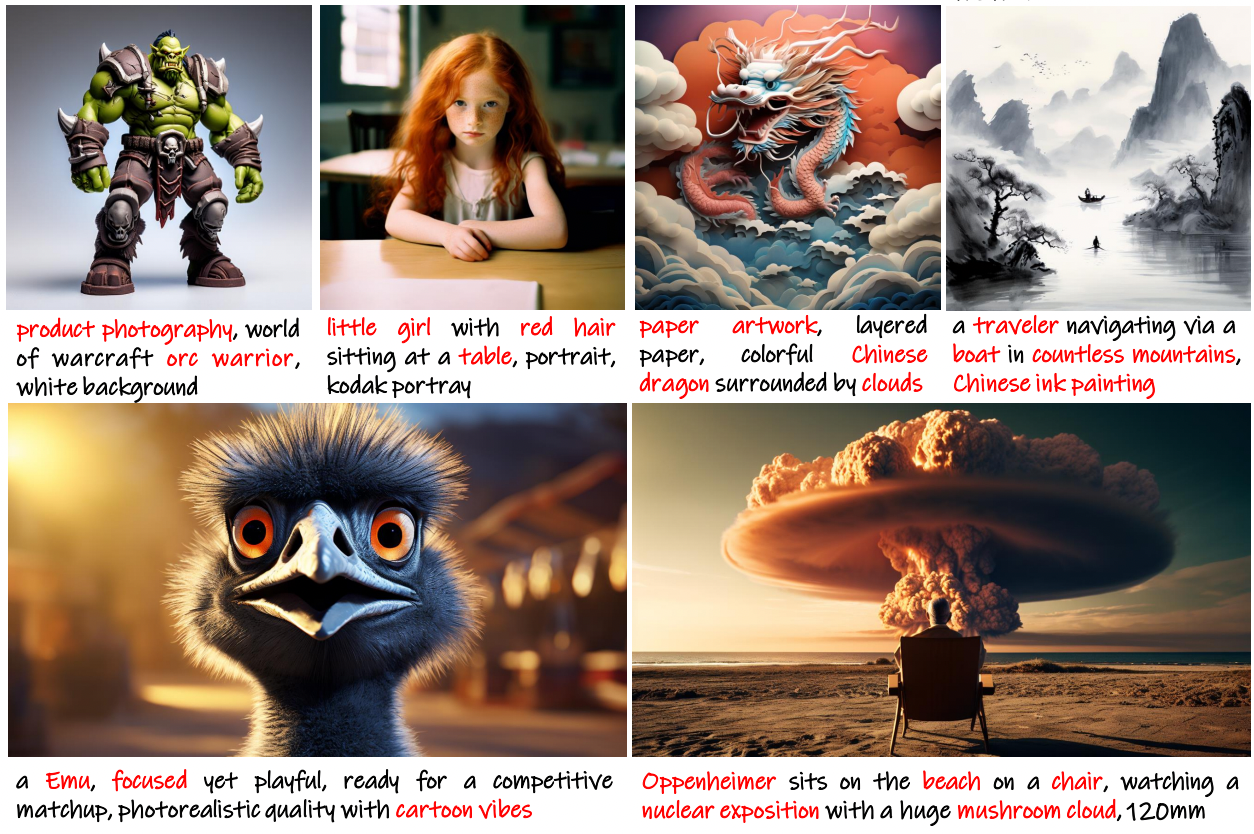
PixArt-α: Fast Training of Diffusion Transformer for Photorealistic Text-to-Image Synthesis es de Junsong Chen, Jincheng Yu, Chongjian Ge, Lewei Yao, Enze Xie, Yue Wu, Zhongdao Wang, James Kwok, Ping Luo, Huchuan Lu y Zhenguo Li.
El resumen del artículo es:
Los modelos de texto a imagen (T2I) más avanzados requieren costos de entrenamiento significativos (p. ej., millones de horas de GPU), lo que obstaculiza gravemente la innovación fundamental para la comunidad de AIGC y aumenta las emisiones de CO2. Este artículo presenta PIXART-α, un modelo de difusión T2I basado en Transformer cuya calidad de generación de imágenes es competitiva con los generadores de imágenes más avanzados (p. ej., Imagen, SDXL e incluso Midjourney), alcanzando estándares casi comerciales. Además, admite la síntesis de imágenes de alta resolución hasta 1024px con un bajo costo de entrenamiento, como se muestra en la Figura 1 y la Figura 2. Para lograr este objetivo, se proponen tres diseños centrales: (1) Descomposición de la estrategia de entrenamiento: Diseñamos tres pasos de entrenamiento distintos que optimizan por separado la dependencia de píxeles, la alineación texto-imagen y la calidad estética de la imagen; (2) T2I Transformer eficiente: Incorporamos módulos de atención cruzada en Diffusion Transformer (DiT) para inyectar condiciones de texto y simplificar la rama de condición de clase intensiva en computación; (3) Datos de alta información: Destacamos la importancia de la densidad de conceptos en los pares texto-imagen y aprovechamos un gran modelo de Visión-Lenguaje para etiquetar automáticamente descripciones pseudo-densas para asistir al aprendizaje de la alineación texto-imagen. Como resultado, la velocidad de entrenamiento de PIXART-α supera notablemente a los modelos T2I a gran escala existentes, p. ej., PIXART-α solo toma el 10.8% del tiempo de entrenamiento de Stable Diffusion v1.5 (675 vs. 6,250 días de GPU A100), ahorrando casi $300,000 ($26,000 vs. $320,000) y reduciendo las emisiones de CO2 en un 90%. Además, en comparación con un modelo SOTA más grande, RAPHAEL, nuestro costo de entrenamiento es apenas del 1%. Experimentos extensos demuestran que PIXART-α destaca en calidad de imagen, arte y control semántico. Esperamos que PIXART-α proporcione nuevas perspectivas a la comunidad de AIGC y a las startups para acelerar la construcción de sus propios modelos generativos de alta calidad y bajo costo desde cero.
Puedes encontrar el código original en PixArt-alpha/PixArt-alpha y todos los puntos de control disponibles en PixArt-alpha.
Algunas notas sobre este pipeline:
- Utiliza un backbone Transformer (en lugar de un UNet) para el desruido. En consecuencia, tiene una arquitectura similar a la de DiT.
- Se entrenó utilizando condiciones de texto calculadas a partir de T5. Este aspecto hace que el pipeline sea más eficaz a la hora de seguir prompts de texto complejos con detalles intrincados.
- Es bueno para generar imágenes de alta resolución en diferentes relaciones de aspecto. Para obtener los mejores resultados, los autores recomiendan algunos rangos de tamaño que se pueden encontrar aquí.
- Su calidad es comparable a la de los sistemas de generación de texto a imagen más avanzados (a fecha de esta redacción), como Stable Diffusion XL, Imagen y DALL-E 2, y además es más eficiente que ellos.
Asegúrate de consultar la guía de Schedulers para aprender a explorar el equilibrio entre la velocidad y la calidad del scheduler, y consulta la sección reutilizar componentes entre pipelines para aprender a cargar eficientemente los mismos componentes en múltiples pipelines.
Inferencia con menos de 8 GB de VRAM en la GPU
Ejecuta el PixArtAlphaPipeline con menos de 8 GB de VRAM en la GPU cargando el codificador de texto en precisión de 8 bits. Veamos un ejemplo completo.
Primero, instala la biblioteca bitsandbytes:
pip install -U bitsandbytes
Luego, cargue el codificador de texto en 8 bits:
from transformers import T5EncoderModel
from diffusers import PixArtAlphaPipeline
import torch

text_encoder = T5EncoderModel.from_pretrained(
    "PixArt-alpha/PixArt-XL-2-1024-MS",
    subfolder="text_encoder",
    load_in_8bit=True,
    device_map="auto",

)
pipe = PixArtAlphaPipeline.from_pretrained(
    "PixArt-alpha/PixArt-XL-2-1024-MS",
    text_encoder=text_encoder,
    transformer=None,
    device_map="auto"
)
Ahora, usa pipe para codificar un prompt:
with torch.no_grad():
    prompt = "cute cat"
    prompt_embeds, prompt_attention_mask, negative_embeds, negative_prompt_attention_mask = pipe.encode_prompt(prompt)
Dado que las incrustaciones de texto ya se han calculado, elimina text_encoder y pipe de la memoria y libera algo de VRAM de la GPU:
import gc

def flush():
    gc.collect()
    torch.cuda.empty_cache()

del text_encoder
del pipe
flush()
Luego, calcule los latentes utilizando los embeddings del prompt como entradas:
pipe = PixArtAlphaPipeline.from_pretrained(
    "PixArt-alpha/PixArt-XL-2-1024-MS",
    text_encoder=None,
    dtype=torch.float16,
).to("cuda")  # or "mps", "xpu", "cpu"

latents = pipe(
    negative_prompt=None,
    prompt_embeds=prompt_embeds,
    negative_prompt_embeds=negative_embeds,
    prompt_attention_mask=prompt_attention_mask,
    negative_prompt_attention_mask=negative_prompt_attention_mask,
    num_images_per_prompt=1,
    output_type="latent",
).images

del pipe.transformer
flush()
Tenga en cuenta que, al inicializar
pipe, establecetext_encoderenNonepara que no se cargue.
Una vez que se calculan los latentes, pásalos al VAE para decodificarlos en una imagen real:
with torch.no_grad():
    image = pipe.vae.decode(latents / pipe.vae.config.scaling_factor, return_dict=False)[0]
image = pipe.image_processor.postprocess(image, output_type="pil")[0]
image.save("cat.png")
Al eliminar los componentes que no estás utilizando y liberar la VRAM de la GPU, deberías poder ejecutar PixArtAlphaPipeline con menos de 8 GB de VRAM de GPU.
Si deseas un informe de tu uso de memoria, ejecuta este script.
Los embeddings de texto calculados en 8 bits pueden afectar la calidad de las imágenes generadas debido a la pérdida de información en el espacio de representación causada por la precisión reducida. Se recomienda comparar las salidas con y sin 8 bits.
Al cargar el text_encoder, estableces load_in_8bit en True. También podrías especificar load_in_4bit para reducir aún más los requisitos de memoria a menos de 7 GB.
PixArtAlphaPipeline
clase diffusers.PixArtAlphaPipeline
< source >( tokenizer: T5Tokenizertext_encoder: T5EncoderModelvae: AutoencoderKLtransformer: PixArtTransformer2DModelscheduler: DPMSolverMultistepScheduler )
Parámetros
- vae (AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar y decodificar imágenes a partir de y hacia representaciones latentes.
- text_encoder (
T5EncoderModel) — Codificador de texto congelado. PixArt-Alpha utiliza T5, específicamente la variante t5-v1_1-xxl. - tokenizer (
T5Tokenizer) — Tokenizer de la clase T5Tokenizer. - transformer (PixArtTransformer2DModel) —
Un
PixArtTransformer2DModelcondicionado por texto para desruidar los latentes de imagen codificados. Inicialmente publicado comoTransformer2DModelen la configuración, pero la discrepancia puede ignorarse. - scheduler (SchedulerMixin) —
Un scheduler para usar en combinación con
transformerpara desruidar los latentes de la imagen codificada.
Pipeline para la generación de imágenes a partir de texto usando PixArt-Alpha.
Este modelo hereda de DiffusionPipeline. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos los pipelines (como la descarga o el guardado, la ejecución en un dispositivo específico, etc.)
__call__
< source >( prompt: str | list[str] = Nonenegative_prompt: str = ''num_inference_steps: int = 20timesteps: list[int] = Nonesigmas: list[float] = Noneguidance_scale: float = 4.5num_images_per_prompt: int | None = 1height: int | None = Nonewidth: int | None = Noneeta: float = 0.0generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneprompt_embeds: typing.Optional[torch.Tensor] = Noneprompt_attention_mask: typing.Optional[torch.Tensor] = Nonenegative_prompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_prompt_attention_mask: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truecallback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1clean_caption: bool = Trueuse_resolution_binning: bool = Truemax_sequence_length: int = 120**kwargs ) → ImagePipelineOutput or tuple
Parámetros
- prompt (
strolist[str], opcional) — El prompt o los prompts para guiar la generación de la imagen. Si no se define, hay que pasarprompt_embedsen su lugar. - negative_prompt (
strolist[str], opcional) — El prompt o prompts que no deben guiar la generación de la imagen. Si no se define, se debe pasarnegative_prompt_embedsen su lugar. Se ignora cuando no se usa guía (es decir, se ignora siguidance_scalees menor que1). - num_inference_steps (
int, opcional, valor predeterminado 100) — El número de pasos de desruido. Más pasos de desruido suelen conducir a una imagen de mayor calidad a costa de una inferencia más lenta. - timesteps (
list[int], opcional) — Pasos de tiempo personalizados para usar en el proceso de desruido con programadores que admiten un argumentotimestepsen su métodoset_timesteps. Si no se define, se usará el comportamiento predeterminado cuando se pasenum_inference_steps. Debe estar en orden descendente. - sigmas (
list[float], opcional) — Sigmas personalizados para usar en el proceso de desruido con programadores que admiten un argumentosigmasen su métodoset_timesteps. Si no se define, se usará el comportamiento predeterminado cuando se pasenum_inference_steps. - guidance_scale (
float, opcional, valor predeterminado 4.5) — Escala de guía definida en Classifier-Free Diffusion Guidance.guidance_scalese define comowde la ecuación 2 del Imagen Paper. La escala de guía se habilita estableciendoguidance_scale > 1. Una escala de guía más alta fomenta la generación de imágenes estrechamente vinculadas alpromptde texto, generalmente a costa de una menor calidad de imagen. - num_images_per_prompt (
int, opcional, valor predeterminado 1) — El número de imágenes que se generarán por indicación. - height (
int, opcional, valor predeterminado: self.unet.config.sample_size) — La altura en píxeles de la imagen generada. - width (
int, opcional, predeterminado: self.unet.config.sample_size) — El ancho en píxeles de la imagen generada. - eta (
float, opcional, valor predeterminado 0.0) — Corresponde al parámetro eta (η) del artículo DDIM: https://huggingface.co/papers/2010.02502. Solo se aplica a schedulers.DDIMScheduler y se ignorará en los demás. - generator (
torch.Generatorolist[torch.Generator], opcional) — Un generador o una lista de generadores de torch para hacer la generación determinista. - latents (
torch.Tensor, opcional) — Latentes ruidosos pregenerados, muestreados de una distribución gaussiana, que se usarán como entradas para la generación de imágenes. Se pueden utilizar para ajustar la misma generación con diferentes prompts. Si no se proporcionan, se generará un tensor de latentes mediante muestreo usando elgeneratoraleatorio suministrado. - prompt_embeds (
torch.Tensor, opcional) — Incrustaciones de texto pregeneradas. Se pueden usar para ajustar fácilmente las entradas de texto, p. ej. ponderación de prompts. Si no se proporcionan, las incrustaciones de texto se generarán a partir del argumento de entradaprompt. - prompt_attention_mask (
torch.Tensor, opcional) — Máscara de atención pregenerada para las incrustaciones de texto. - negative_prompt_embeds (
torch.Tensor, opcional) — Incrustaciones de texto negativo pregeneradas. Para PixArt-Alpha, este prompt negativo debe ser "". Si no se proporciona, negative_prompt_embeds se generará a partir del argumento de entradanegative_prompt. - negative_prompt_attention_mask (
torch.Tensor, opcional) — Máscara de atención pregenerada para los embeddings de texto negativos. - output_type (
str, opcional, valor predeterminado"pil") — El formato de salida de la imagen generada. Elija entre PIL:PIL.Image.Imageonp.array. - return_dict (
bool, opcional, valor predeterminadoTrue) — Indica si se debe devolver un~pipelines.stable_diffusion.IFPipelineOutputen lugar de una tupla simple. - callback (
Callable, opcional) — Una función que se llamará cadacallback_stepspasos durante la inferencia. La función se llamará con los siguientes argumentos:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opcional, valor predeterminado 1) — La frecuencia con la que se llamará a la funcióncallback. Si no se especifica, la callback se llamará en cada paso. - clean_caption (
bool, opcional, valor predeterminadoTrue) — Indica si se debe limpiar la descripción antes de crear los embeddings. Requiere quebeautifulsoup4yftfyestén instalados. Si las dependencias no están instaladas, los embeddings se crearán a partir del prompt sin procesar. - use_resolution_binning (
boolpor defectoTrue) — Si se establece enTrue, la altura y el ancho solicitados se mapean primero a las resoluciones más cercanas usandoASPECT_RATIO_1024_BIN. Después de que los latentes generados se decodifican en imágenes, se redimensionan de nuevo a la resolución solicitada. Útil para generar imágenes que no son cuadradas. - max_sequence_length (
intpor defecto 120) — Longitud máxima de la secuencia para usar con elprompt.
Devuelve
ImagePipelineOutput o tuple
Si return_dict es True, se devuelve ImagePipelineOutput; en caso contrario, se devuelve una tuple cuyo primer elemento es una lista con las imágenes generadas
Función invocada al llamar a la pipeline para la generación.
Ejemplos:
>>> import torch
>>> from diffusers import PixArtAlphaPipeline

>>> # You can replace the checkpoint id with "PixArt-alpha/PixArt-XL-2-512x512" too.
>>> pipe = PixArtAlphaPipeline.from_pretrained("PixArt-alpha/PixArt-XL-2-1024-MS", torch_dtype=torch.float16)
>>> # Enable memory optimizations.
>>> pipe.enable_model_cpu_offload()

>>> prompt = "A small cactus with a happy face in the Sahara desert."
>>> image = pipe(prompt).images[0]
encode_prompt
< source >( prompt: str | list[str]do_classifier_free_guidance: bool = Truenegative_prompt: str = ''num_images_per_prompt: int = 1device: typing.Optional[torch.device] = Noneprompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_prompt_embeds: typing.Optional[torch.Tensor] = Noneprompt_attention_mask: typing.Optional[torch.Tensor] = Nonenegative_prompt_attention_mask: typing.Optional[torch.Tensor] = Noneclean_caption: bool = Falsemax_sequence_length: int = 120**kwargs )
Parámetros
- prompt (
strolist[str], opcional) — prompt a codificar - negative_prompt (
strolist[str], opcional) — El prompt que no debe guiar la generación de la imagen. Si no se define, se debe pasarnegative_prompt_embedsen su lugar. Se ignora cuando no se usa guía (es decir, se ignora siguidance_scalees menor que1). Para PixArt-Alpha, esto debería ser "". - do_classifier_free_guidance (
bool, opcional, valor predeterminadoTrue) — si se debe usar classifier free guidance o no - num_images_per_prompt (
int, opcional, valor predeterminado 1) — número de imágenes que deben generarse por indicación - device — (
torch.device, opcional): dispositivo de torch en el que colocar las incrustaciones resultantes - prompt_embeds (
torch.Tensor, opcional) — Incrustaciones de texto pregeneradas. Se pueden usar para ajustar fácilmente las entradas de texto, p. ej. ponderación de prompts. Si no se proporcionan, las incrustaciones de texto se generarán a partir del argumento de entradaprompt. - negative_prompt_embeds (
torch.Tensor, opcional) — Incrustaciones de texto negativo pregeneradas. Para PixArt-Alpha, debe ser la incrustación de la cadena "". - clean_caption (
bool, por defectoFalse) — Si esTrue, la función preprocesará y limpiará la descripción proporcionada antes de codificarla. - max_sequence_length (
int, por defecto 120) — Longitud máxima de la secuencia a utilizar para el prompt.
Codifica el prompt en estados ocultos del codificador de texto.